
Yelp má 330 milionů kumulativních recenzí a více než 8,4 milionu ověřených firemních profilů — a pokud jste se v poslední době pokusili některá z těchto dat získat, víte, že to není žádná procházka růžovým sadem. Mezi agresivními CAPTCHA, blokacemi IP adres a rozbitými Python skripty působí scraping Yelp v roce 2026 jako snaha proklouznout kolem vyhazovače, který už dávno zná vaši tvář.
Posledních pár týdnů jsem porovnával 10 nástrojů na scraping recenzí Yelp přímo proti sobě — od no-code Chrome rozšíření přes vývojářská API až po enterprise datové platformy. Můj cíl byl jednoduchý: zjistit, které nástroje dnes na Yelp opravdu fungují, které jsou spíš marketing než reálná hodnota a které si zaslouží váš čas i rozpočet.
Níže projdu každý nástroj, přidám přehlednou srovnávací tabulku a ukážu i praktické věci, o kterých se jinde moc nemluví — třeba práci s duplicity, využití dat z Yelp pro lead generation a jak vlastně vypadají exportovaná data z Yelp v praxi. Pokud jste obchodník, lokální marketér nebo člověk z operativy, který chce čistá Yelp data bez psaní jediného řádku kódu, tohle je pro vás.
Proč scrapovat recenze Yelp v roce 2026 (a proč je to těžší než dřív)
Yelp není jen web s recenzemi — je to živá databáze business intelligence. 82 % uživatelů Yelp si během týdne najde nebo koupí službu od firmy, kterou na platformě objevili, a více než 85 000 nových požadavků nebo zpráv je firmám odesláno denně. Pro firmy to znamená konkrétní využití:
- Analýza konkurence: Porovnávejte hodnocení, počet recenzí, kategorie, služby a pozici v okolí napříč trhem.
- Sledování sentimentu: V čase sledujte text recenzí, počet hvězdiček, data i odpovědi majitelů.
- Lead generation: Získávejte názvy firem, telefonní čísla, weby, adresy, kategorie a někdy i obsah spojený s profilem majitele.
- Výzkum pro lokální SEO: Sledujte tempo přibývání recenzí, štítky kategorií, fotografie a signály zapojení uživatelů.
Háček je v tom, že Yelp od roku 2024 scraping výrazně ztížil. Jejich Trust & Safety Report za rok 2025 ukazuje, že platforma zpracovala 22 milionů recenzí, zrušila přes 1,3 milionu uživatelských účtů a označila podezřelé chování spojené s jednotlivými IP adresami. Po technické stránce Yelp nyní používá TLS/JA3 fingerprinting, záměrně znepřehledněné CSS třídy a agresivní kontroly reputace IP adres. Benchmark AIMultiple z července 2026 pro scraping recenzí poslal 500 URL s recenzemi Yelp pěti komerčním poskytovatelům. Bright Data skončilo nejlepší s 77 % a Zyte dosáhlo 57 %, ale Nimble zvládl jen 31 % a Decodo i Oxylabs na Yelp nevrátily vůbec nic použitelného.
Stejně přímočaré jsou i zkušenosti uživatelů. Jeden uživatel na Redditu v říjnu 2024 uvedl, že jeho Beautiful Soup skript byl po nové CAPTCHA „zcela rozbitý“. Jiný na Stack Overflow popsal opakované chyby 503 při použití Scrapy. Běžné workflow requests + BeautifulSoup? Potvrzeně nefunkční. Staré Selenium skripty bez undetected-chromedriver? Stejný příběh.
Proto je dnes výběr správného nástroje důležitější než kdy dřív — a právě proto jsem otestoval 10 různých řešení za vás.
Co dělá nejlepší nástroj na scraping recenzí Yelp? (kritéria výběru)
Ne všechny nástroje na Yelp scraping jsou stejné. Každý z nich jsem hodnotil podle sedmi kritérií, která jsou důležitá bez ohledu na to, jestli jste vývojář, obchodník nebo majitel malé agentury:
| Kritérium | Proč je důležité |
|---|---|
| Jednoduchost použití (no-code vs. kód) | Většina lidí, kteří to řeší, chce obejít Python úplně, ne si platit někoho jiného, aby ho psal |
| Ochrana proti botům / CAPTCHA | Největší bolestivé místo — zásah Yelp v letech 2024–2026 rozhoduje o úspěchu nebo neúspěchu |
| Rozsah extrahovaných dat | Uživatelé chtějí recenze + jména majitelů + e-maily + telefon, ne jen počet hvězdiček |
| Formáty exportu | CSV, Google Sheets, Airtable, Notion — na integraci do reálných workflow záleží |
| Cena / bezplatný tarif | Hodně úloh na Yelp je tak malých, že se vejdou do free plánu — pokud je jeho limit jasně popsaný |
| Stránkování a škálování | Vyhýbání se duplicitám při větším objemu je opakující se a dosud nevyřešený problém |
| Obohacení přes podstránky | Umí nástroj automaticky přejít ze seznamu výsledků na detail firmy? |
Pro představu: firemní stránky na Yelp mohou obsahovat překvapivě bohatou sadu polí: název firmy, hodnocení, počet recenzí, kategorii, adresu, telefon, web, otevírací dobu, lokalitu, fotografie, text recenzí, data recenzí, jména recenzentů a někdy i odpověď majitele nebo obsah profilu firmy u ověřených stránek. Nejlepší nástroje vytáhnou většinu z toho; ty slabší jen zlomek.
Proč si i Chrome rozšíření zaslouží místo v tomhle seznamu
Při přípravě článku jsem si všiml jedné věci: přehledy Yelp scraperů na internetu se téměř vždy točí kolem SaaS platforem, API nebo Python knihoven. Browser rozšíření se zmiňují jen okrajově. Přitom poptávka je reálná — v tom samém redditovém vlákně z října 2024 uživatel, kterému po nové CAPTCHA na Yelp přestal fungovat Python scraper, napsal, že Instant Data Scraper stále fungoval, protože „prostě běží v prohlížeči“.
Scrapery založené na prohlížeči převádějí chování do více lidsky působícího kontextu: už existující session, normální JS vykonávání, běžné cookies a méně zřetelných otisků bota na serverové straně. Nejsou nezničitelné — podpora Yelp výslovně říká, že scraping přes browser rozšíření není povolený. Ale z čistě praktického pohledu proti botům vyvolává browser-based sběr méně problémů než čisté HTTP požadavky, zvlášť u listingů a jednodušších workflow.
Thunderbit a Instant Data Scraper si v tomhle seznamu místo zasloužily právě proto, že browser rozšíření bývají v těchto přehledech opomíjena — a přitom pro netechnické uživatele řeší skutečný problém.
Vyzkoušet Thunderbit pro scraping Yelp
1. Thunderbit — nejlepší scraper recenzí Yelp pro netechnické uživatele
 Thunderbit je nástroj, který jsme vyvinuli u nás ve firmě, takže to říkám rovnou — ale dávám ho na první místo, protože v tomhle srovnání skutečně nabízí nejsilnější no-code pokrytí Yelp. Thunderbit je AI Chrome rozšíření se speciálními šablonami pro firemní výsledky Yelp i stránky s recenzemi Yelp. Otevřete stránku, kliknete jednou a AI sama zjistí, která pole vytáhnout. Pokud už víte, co chcete, můžete to popsat a použije se vaše zadání.
Na Yelp je Thunderbit obzvlášť zajímavý díky dvěma režimům scrapingu. Browser scraping běží v rámci vašeho vlastního Chrome sezení, což se hodí, když je Yelp agresivnější vůči serverovým požadavkům — a to je v roce 2026 na katalogových stránkách většinou případ. Cloud scraping zvládne až 50 stránek současně u veřejných profilových stránek, kde je tlak proti botům slabší.
Funkce subpage scrapingu je to, kde se věci stávají zajímavé pro lead gen. Můžete začít na stránce s výsledky vyhledávání na Yelp, scrapovat seznamy a potom nechat Thunderbit automaticky navštívit každý detail firmy a přidat bohatší pole — jméno majitele, URL webu, e-mail (přes bezplatný email extractor Thunderbitu) a telefonní číslo (přes bezplatný phone extractor). Tohle je workflow, které jsem u jiného no-code nástroje na Yelp neviděl.
Klíčové funkce pro Yelp scraping
- Automatické nastavení polí: Jedním klikem vám AI Thunderbitu doplní seznam sloupců — Business Name, Rating, Review Count, Phone, Address, Category, Website — nebo jí jednoduše řeknete, co přesně chcete.
- Režim Browser + Cloud: Browser režim pro stránky s vysokou ochranou proti botům; cloud režim pro větší objem na veřejných profilových stránkách.
- Scraping podstránek: Přechod z výsledků vyhledávání na jednotlivé firemní stránky automaticky.
- AI čištění dat: Při scrapingu umí štítky, kategorizaci, přeformátování telefonních čísel do E.164 i překlad recenzí.
- Práce se stránkováním: Podporuje klikací stránkování i nekonečný scroll.
- Plánovaný scraping: Opakované scrapování můžete nastavit pomocí plánování v přirozeném jazyce pro monitoring.
- Exporty: Google Sheets, Airtable, Notion, Excel, CSV, JSON. Uložení do Sheets, Airtable nebo Notion nestojí extra kredity — samotné řádky ale kredity samozřejmě spotřebovávají.
Pole z Yelp, která Thunderbit umí vytáhnout
| Typ stránky Yelp | Pole |
|---|---|
| Vyhledávání / firemní listingy | Název firmy, URL, hodnocení, telefon, otevírací doba, adresa, počet recenzí, kategorie, služby, web, popis, cena, stav, zeměpisná šířka/délka, e-mail |
| Stránky s recenzemi | Uživatelské jméno recenzenta, URL profilu recenzenta, URL firmy, obsah recenze, číselné hodnocení, datum recenze, lokalita recenzenta, reakce |
Typický workflow pro Yelp v Thunderbit
- Otevřete v Chrome stránku s výsledky vyhledávání restaurací na Yelp.
- Klikněte jednou a nechte AI vybrat sloupce.
- Podle potřeby pole upravte (nebo jen použijte návrh AI).
- Nechte proces běžet, zatímco děláte něco jiného.
- Volitelně použijte scraping podstránek a doplňte ke každé firmě bohatší data.
- Exportujte přímo do Google Sheets, Airtable nebo do formátu, který používáte.
Základní Yelp scraping jsem v Thunderbit nastavil doslova na jeden klik. Workflow s obohacením přes podstránky přidá jeden krok navíc, ale pořád je to bez kódu.
Cena: Free plán zahrnuje 6 stránek měsíčně, až 30 kreditů na stránku. Placené plány začínají na 15 USD měsíčně za 500 kreditů. Účtování probíhá podle výsledných řádků: 1 řádek = 1 kredit, 2 kredity na řádek při zapnutém scrapingu podstránek a 30 kreditů za každé vyhledání doplnění osobních údajů.
Nejlepší pro: obchodní týmy pro lokální lead generation, lokální marketéry, kteří chtějí data z Yelp bez kódování, a operations týmy sledující recenze konkurence podle harmonogramu.
| Výhody | Nevýhody |
|---|---|
| Nejlepší no-code pokrytí Yelp (šablony pro firmy i recenze) | Kreditový model může být při vysokém počtu řádků drahý |
| Silné exporty a obohacení přes podstránky | Obohacení přes podstránky stojí 2 kredity na řádek místo 1 |
| Browser režim je užitečný na stránkách s agresivní ochranou proti botům | Cloud režim si na Yelp výsledcích vede hůř než browser režim |
| Vestavěný plánovaný scraping a AI formátování | Stránkování je na placených plánech omezeno na 200 stránek na běh |
2. Apify — nejlepší Yelp scraper pro škálovatelné cloudové běhy
 Apify je tržiště založené v Česku s komunitně vytvářenými „actory“ — a Yelp ekosystém je tady překvapivě hluboký. Najdete tu actory pro scraping firem Yelp, recenze Yelp a dokonce i lead scraping s obohacením o e-maily. Kompromisem je různá kvalita: některé actory jsou výborné, jiné zastaralé a veřejné hodnocení se pohybuje od 0,0 do 5,0.
Podle konkrétního actoru můžete získat název firmy, hodnocení, recenze, kategorie, cenu, adresu, telefon, web, otevírací dobu, fotografie, informace o majiteli, vybavení, text recenzí, údaje o autorovi, počty reakcí i odpovědi majitele.
Silnou stránkou Apify jsou exporty: datasety lze exportovat jako JSON, CSV, XML, Excel, HTML tabulku, RSS a JSONL.
Cena: Free plán obsahuje 5 USD v kreditech; Starter stojí 29 USD měsíčně; Scale 199 USD měsíčně. Některé actory se účtují samostatně podle výsledků.
Nejlepší pro: týmy, které chtějí cloudový sběr s plánováním a silnými možnostmi exportu.
| Výhody | Nevýhody |
|---|---|
| Nejlepší marketplace actorů pro Yelp | Kvalita závisí na autorovi actoru |
| Silná podpora exportů a plánování | Ochrana proti botům závisí na proxy konfiguraci |
| Existují i actory pro obohacení leadů | UI může být pro začátečníky nepřehledné |
3. SerpApi — nejlepší scraper recenzí Yelp pro vývojáře, kteří chtějí strukturovaný JSON
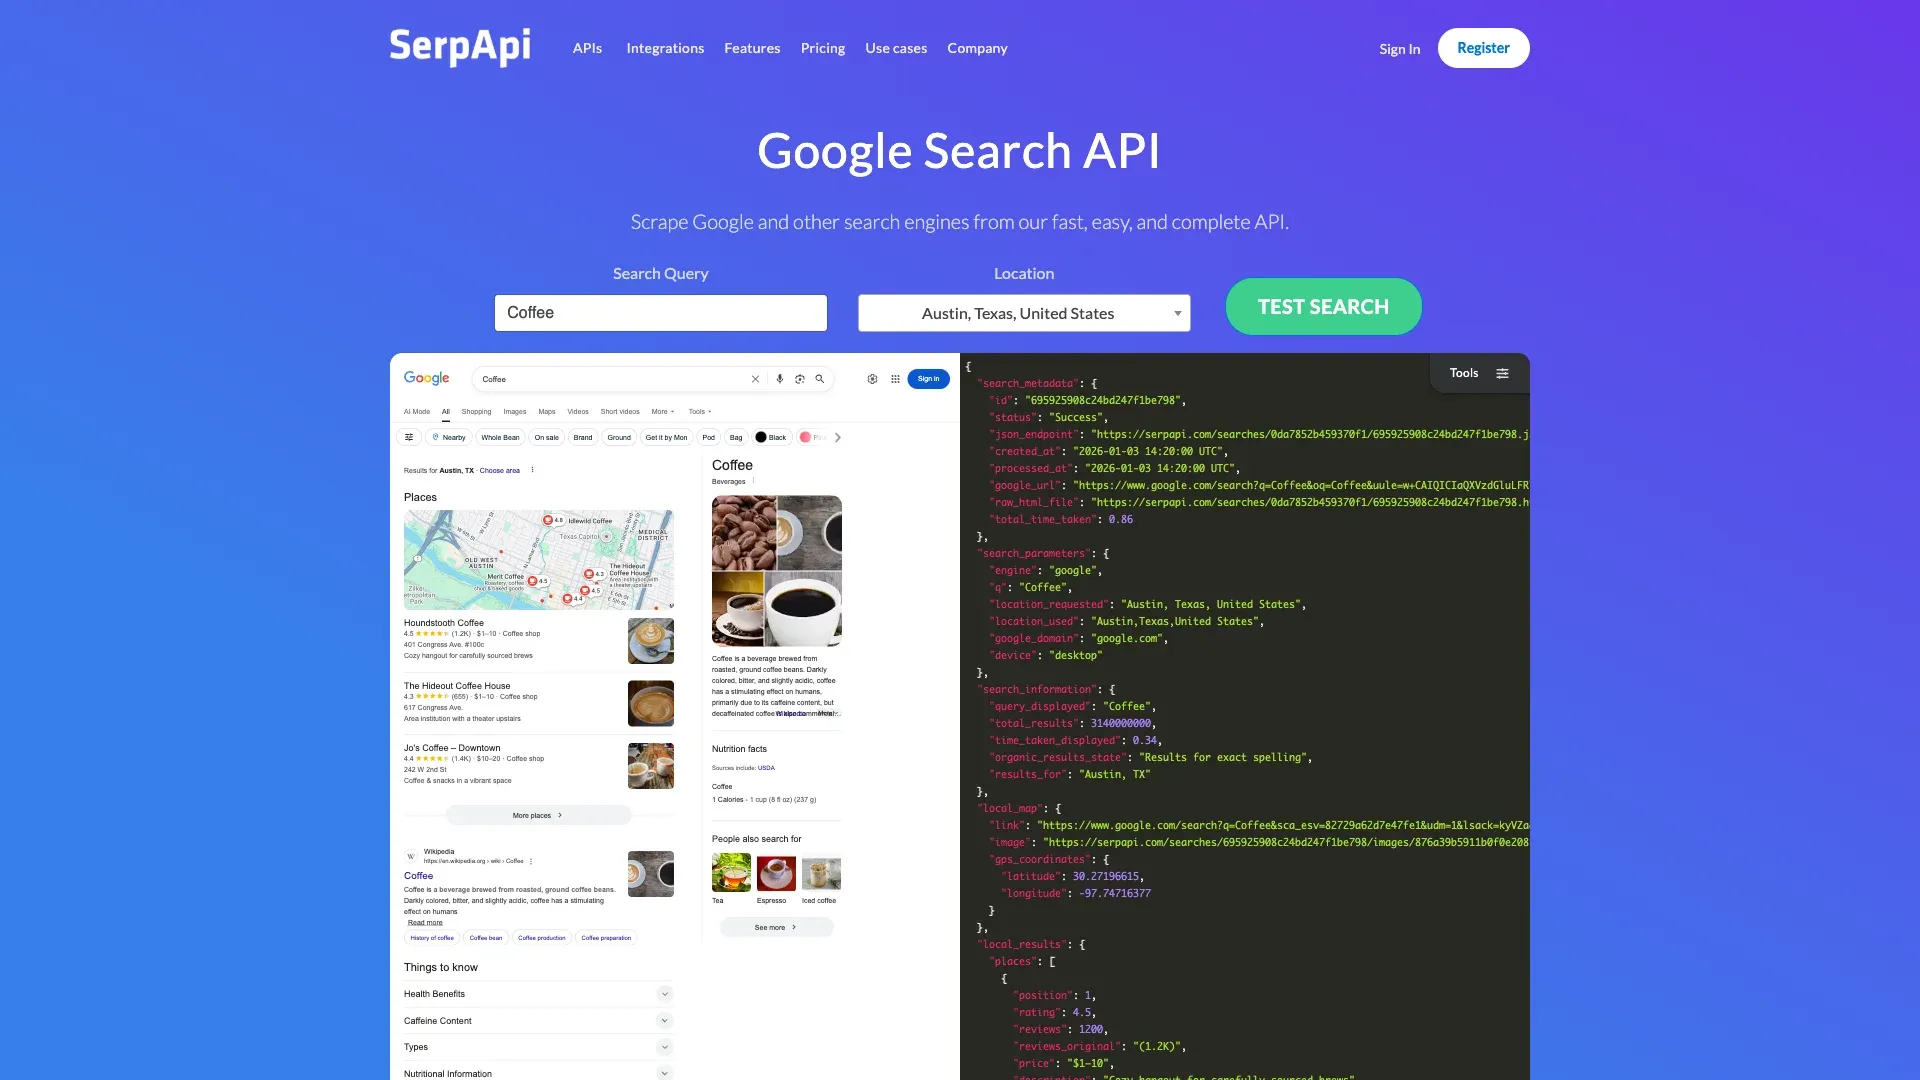 SerpApi je nejčistší API-first varianta pro Yelp. Nabízí dedikované endpointy pro Yelp search (
engine=yelp) i Yelp reviews (engine=yelp_reviews) a vrací dobře strukturovaný JSON místo surového HTML.
Na straně vyhledávání získáte pole jako place_ids, title, categories, price, rating, reviews, neighborhoods, snippet a service_options. Endpoint pro recenze vrací uživatelské jméno, ID uživatele, adresu uživatele, text recenze, jazyk, datum, hodnocení, počty reakcí i odpovědi majitele. Yelp Reviews API má limit 49 výsledků na stránku a cache expiruje po 1 hodině.
Cena: Free plán je 250 vyhledávání měsíčně; Starter 25 USD měsíčně za 1 000 vyhledávání; Developer 75 USD za 5 000; Production 150 USD za 15 000.
Nejlepší pro: vývojáře, kteří chtějí strukturované Yelp JSON pro analytické pipeline — bez nutnosti udržovat parser.
| Výhody | Nevýhody |
|---|---|
| Nejlepší strukturovaný Yelp JSON v tomhle přehledu | Vyžaduje kódování |
| Žádná údržba parseru | Žádné no-code UI |
| Skvěle sedí do analytických pipeline | Cena roste s objemem vyhledávání |
4. Octoparse — nejlepší Yelp scraper s vizuálním builderem workflow
 Octoparse je zde nejsilnější point-and-click nástroj pro tvorbu workflow, ale jeho současná šablona pro Yelp je zaměřená hlavně na stránku seznamu — ukazuje pole jako title, customer rating, number of recommended posts, categories, price class, address a opening time. Pro text recenzí byste pravděpodobně museli vytvořit vlastní workflow.
Octoparse podporuje cloud extraction, plánování úloh, stránkování i nekonečný scroll, rotaci IP adres, residential proxy a automatické řešení CAPTCHA. Vizuální builder je výkonný, ale u vlastních nastavení má reálnou učící křivku.
Cena: Free plán má 10 úloh, 1 zařízení, 2 souběžné lokální běhy a export až 50 tisíc řádků měsíčně. Standard — první plán s cloud běhy — stojí 83 USD měsíčně, nebo 69 USD při roční platbě; Professional je 299 USD měsíčně, nebo 249 USD při roční platbě. Doplňky jako residential proxy (3 USD/GB) a CAPTCHA solving (1–1,50 USD za tisíc) se účtují navíc.
Nejlepší pro: uživatele, kteří chtějí vizuální workflow builder a nevadí jim investovat čas do nastavení.
| Výhody | Nevýhody |
|---|---|
| Nejlepší vizuální workflow builder v tomto srovnání | Šablona pro Yelp je užší než u některých konkurentů |
| Silné exporty a plánování | Pokročilá nastavení mají učící křivku |
| Cloud scraping a podpora proxy | Menší týmy mohou kvůli doplňkům narazit na cenu |
5. ScraperAPI — nejlepší proxy vrstva pro vlastní Yelp scraper
 ScraperAPI není přímo Yelp scraper — je to proxy, renderingová a anti-bot vrstva pro vývojáře, kteří chtějí mít samotnou extrakci pod kontrolou. Jejich stránka s řešením pro Yelp i tutoriál ukazují, jak směrovat požadavky přes rotující proxy s JavaScript renderingem a řešením CAPTCHA, ale parser si stále píšete sami.
Kreditový systém je jasný: běžný požadavek stojí 1 kredit, render=true stojí 10 kreditů a premium + render 25. Na Yelp to naskakuje rychle, protože JS rendering je často nutný.
Cena: Free plán obsahuje 1 000 API kreditů a limit 5 připojení; 7denní trial nabízí 5 000 kreditů; Hobby stojí 49 USD měsíčně za 100 000 kreditů.
Nejlepší pro: vývojáře, kteří už scrapery píší a potřebují spolehlivou anti-bot vrstvu pro Yelp.
| Výhody | Nevýhody |
|---|---|
| Skvělá anti-bot vrstva pro vlastní workflow | Vyžaduje kódování |
| Funguje s jakýmkoli scraping skriptem | Žádné vizuální rozhraní přímo pro Yelp |
| JavaScript rendering a geo-targeting | Logiku extrakce i údržbu si nesete sami |
6. Lobstr.io — nejlepší hotový no-code scraper výsledků Yelp pro leady
 Lobstr.io je spíš jasně zaměřený produkt pro export leadů z Yelp než čistý scraper recenzí. Jeho stránka Yelp Search Export uvádí 30 datových atributů, 30 leadů za minutu a 0,50 USD za 1 000 leadů — i když tato reklamovaná sazba platí až na plánu za 500 USD měsíčně; na vstupním plánu to vychází zhruba na 2 USD za 1 000.
Publikovaná pole zahrnují URL, název, recenze (počet), skóre, zda je provozovna zavřená, zda je ověřená, cenu, kategorie, web, telefon, odkazy na menu, adresu, zeměpisnou šířku/délku, vybavení, e-mail, status inzerenta a zda jde o sponzorovaný výsledek. To je silná sada pro lead gen. Nepodařilo se mi ale najít aktuální důkaz, že Lobstr extrahuje i samotný text recenzí — proto je spíš lead scraper než nástroj na monitoring recenzí.
Cena: Free plán má 100 kreditů a exporty jsou omezené na 30 řádků na požadavek (1 kredit = 1 unikátní výsledek). Placené plány začínají na 20 USD měsíčně za 10 000 kreditů; 100 USD měsíčně koupí 100 000 a 500 USD měsíčně 1 000 000, což je zdroj té marketingové sazby 0,50 USD za 1 000.
Nejlepší pro: uživatele s omezeným rozpočtem, kteří potřebují firemní data z Yelp pro lead gen, ne analýzu recenzí.
| Výhody | Nevýhody |
|---|---|
| Velmi levné | Není ideální pro extrakci textu recenzí |
| Jednoduché no-code workflow | Méně přizpůsobitelné než univerzální platformy |
| Silná sada lead polí včetně obohacení o e-mail | Uváděná cena za lead platí jen u nejvyššího plánu |
7. Bright Data — nejlepší Yelp scraper pro enterprise sběr dat ve velkém měřítku
 Bright Data je tady nejvíc enterprise varianta, s vlastními nástroji jak pro Yelp scraper, tak pro produkt Yelp Reviews Dataset. Jejich Yelp dataset pokrývá více než 214,8 milionu záznamů ve dvou datasetech, s cenou až 0,0025 USD za záznam a minimální objednávkou 250 USD. Při této sazbě to vychází na vyšší cenu za záznam než spuštění jejich vlastního Yelp scraperu — kupujete už sesbíraná data místo cíleného exportu.
Bright Data uvádí více než 400 milionů měsíčních proxy IP ve 195 zemích, automatickou správu proxy, full browser rendering, řešení CAPTCHA, neomezenou souběžnost a plánování. Yelp scraper začíná na 1,50 USD za 1 000 záznamů pay-as-you-go, přičemž Scale plán stojí 499 USD měsíčně za 384 000 záznamů.
Cena: Free tier 5 000 záznamů měsíčně, bez nutnosti zadávat kartu; pay-as-you-go za 1,50 USD za 1 000 záznamů; Scale za 499 USD měsíčně včetně 384 000 záznamů.
Nejlepší pro: enterprise týmy, které potřebují obrovský objem Yelp dat nebo předpřipravené datasety.
| Výhody | Nevýhody |
|---|---|
| Nejsilnější enterprise doručení dat | Složitý a drahý pro malé týmy |
| Velmi rozsáhlý Yelp dataset produkt | Zbytečně robustní pro menší projekty |
| Silná anti-bot infrastruktura | Vyšší náročnost nastavení pro začátečníky |
8. PhantomBuster — nejlepší pro obchodní týmy, které ho už používají pro LinkedIn
 PhantomBuster je v tomhle přehledu nejslabší čistý fit pro Yelp, a chci to říct naprosto otevřeně. Aktuální oficiální dokumentace ukazuje dedikované Phantomy pro Google Maps a Yellow Pages, ale nenašel jsem jasně zdokumentovaný Phantom zaměřený přímo na Yelp tak, jak to často naznačují různé přehledové články.
PhantomBuster se ale pořád hodně používá v obchodních týmech pro vícekrokové cloudové automatizace, opakované běhy, exporty do CSV/JSON a workflow vhodné pro CRM. Pokud už váš tým používá PhantomBuster pro LinkedIn outbound a chcete k tomu přidat Yelp data, může to fungovat — ale není to nástroj navržený primárně pro scraping recenzí Yelp.
Cena: Free plán s exportem omezeným na 10 řádků; Start stojí 69 USD měsíčně nebo 56 USD při roční platbě; Grow 159 USD měsíčně nebo 128 USD ročně; 14denní zkušební verze zdarma.
Nejlepší pro: obchodní týmy, které už PhantomBuster používají pro outbound automatizaci a chtějí do workflow doplnit Yelp data.
| Výhody | Nevýhody |
|---|---|
| Dobré pro vícero platformové lead-gen workflow | Pokrytí Yelp je slabší, než naznačuje marketing |
| Užitečné pro řetězení workflow a předání do CRM | Není navržen přímo pro scraping recenzí |
| Cloud automations a plánování | Větší hodnotu má pro sales automatizaci než pro extrakci z Yelp |
9. Instant Data Scraper — nejlepší bezplatné Chrome rozšíření pro rychlé získání dat z Yelp
 Instant Data Scraper je bezplatná browserová varianta s více než 1 000 000 uživateli a hodnocením 4,9/5 v Chrome Web Storu. Nainstalujete ho, otevřete stránku na Yelp, kliknete na ikonu rozšíření a pomocí AI heuristik automaticky rozpozná data na stránce.
Důvod, proč na Yelp stále funguje, i když Python skripty ne, je ten, který jsem popsal výše: běží přímo v prohlížeči. Je to ale spíš hrubý nástroj — žádné obohacení přes podstránky, žádné AI přizpůsobení polí, žádné plánování a exporty jsou omezené na Excel nebo CSV. A když se session jednou označí jako podezřelá, není kam ustoupit: žádné cloud běhy, žádný proxy pool.
Uživatelské recenze také upozorňují, že se může zaseknout na stránkování, nečekaně se zastavit a mít problém s dynamickým načítáním na Yelp. Na rychlý jednorázový sběr je skvělý, ale pro produkční použití ne.
Cena: Úplně zdarma. Není potřeba účet.
Nejlepší pro: kohokoli, kdo potřebuje rychle a zdarma získat Yelp data a nepotřebuje škálování ani přizpůsobení.
| Výhody | Nevýhody |
|---|---|
| Zdarma a okamžitě | Žádné cloud běhy, plánování ani scraping podstránek |
| Není potřeba účet | Žádné AI přizpůsobení polí |
| Funguje na jednoduchých stránkách | Křehké u dynamických nebo rozsáhlejších flow na Yelp |
| Pouze CSV/Excel — žádné Sheets ani Airtable |
10. Webautomation.io — nejlepší Yelp scraper s předpřipravenými šablonami a cloud běhy
 Webautomation.io je něco mezi vizuálním nástrojem a hostovanou platformou pro extrakci dat. Jejich marketplace nabízí Yelp Business Data Extractor a platforma klade důraz na opakování pokusů, plánování, ochranu proti fingerprintingu a cloudové spouštění.
Veřejně uvedená výstupní pole zahrnují URL, title, location, address, image link, amenities, opening hours, phone, rating, reviews, website link a category. Stránka s extraktorem účtuje 25 kreditů za každý extrahovaný řádek, takže 1 000řádkový Yelp výstup stojí 25 000 kreditů — než začnete, vyplatí se to zkontrolovat vůči vašemu tarifu.
Cena: Free plán má podle FAQ 500 kreditů — stejná stránka ale v kartě plánu uvádí 10M, takže se na vyšší číslo nespoléhejte. Pay-as-you-go začíná na 1 USD za 1 000 kreditů, což při 25 kreditech na řádek znamená 25 USD za 1 000 Yelp řádků. Nejlevnější předplatné je 99 USD měsíčně za 400 000 kreditů, tedy přibližně 16 000 Yelp řádků.
Nejlepší pro: uživatele, kteří chtějí cloudový Yelp extractor s plánováním a logikou opakování.
| Výhody | Nevýhody |
|---|---|
| Cloudové řešení s plánováním a opakováním pokusů | Menší zastoupení na trhu |
| Existuje hotový Yelp extractor | Výstup je spíš o business metadatech než o textu recenzí |
| Vestavěná ochrana proti fingerprintingu | Ceny jsou méně přehledné než u plochých předplatných |
Všech 10 nejlepších Yelp scraperů v přehledné tabulce
Tady je tabulka, kterou jsem si přál mít na začátku výzkumu:
| Nástroj | Jednoduchost použití | Ochrana proti botům | Datová pole | Formáty exportu | Cena / free tier | Stránkování a škálování | Obohacení přes podstránky |
|---|---|---|---|---|---|---|---|
| Thunderbit | No-code (Chrome ext.) | Browser session + cloud běhy | Firemní i recenzní pole | Excel, Sheets, Airtable, Notion, CSV, JSON | 6 free stránek/měs.; od 15 USD/měs. | Ano (klik + scroll) | Ano |
| Apify | Low-code až medium | Záleží na actoru, přes proxy | Silná firemní + recenzní + lead data | JSON, CSV, XML, Excel, JSONL a další | 5 USD v kreditech zdarma; od 29 USD/měs. | Ano | Některé actory ano |
| SerpApi | Vyžaduje kód | Silná backendová vrstva | Čisté strukturované JSON | JSON | 250 free vyhledávání/měs.; od 25 USD/měs. | Ano (přes API) | Přes API workflow |
| Octoparse | No-code až medium | Silná na placeném cloudu | Dobrá firemní i listová data | CSV, JSON, HTML, XML, Excel, DB, Sheets | 10 free úloh, 50K řádků/měs.; od 83 USD/měs. | Ano | Ano |
| ScraperAPI | Vyžaduje kód | Silná proxy/render vrstva | Záleží na vašem parseru | HTML, JSON | 1K free kreditů; od 49 USD/měs. | Ano | Vlastní |
| Lobstr.io | No-code | Tvrdí, že obchází anti-bot | Silná lead pole, slabší na text recenzí | CSV, JSON, API | 100 free kreditů; od 20 USD/měs. | Přátelské pro škálování vyhledávání | Omezené |
| Bright Data | Středně náročné až náročné | Velmi silná | Komplexní firemní + recenze | JSON, CSV, Parquet, API | 5K free záznamů/měs.; 1,50 USD/1K | Výborné | API / dataset-driven |
| PhantomBuster | No-code | Cloud automatizace (ne Yelp-first) | Závislé na workflow | CSV, JSON | Free plán (10 řádků export); od 69 USD/měs. | Dobré pro automatizaci | Ne nativně pro Yelp |
| Instant Data Scraper | No-code (Chrome ext.) | Jen browser session | To, co je vidět na stránce | Excel, CSV | Zdarma | Omezené při škálování | Ne |
| Webautomation.io | No-code až low-code | Silná zveřejněná ochrana | Dobrá business metadata | CSV, Excel, JSON, JSONL, XML | 500 free kreditů; od 99 USD/měs. | Ano | Ano |
Krátká verze: Thunderbit vyhrává jako nejlepší no-code řešení, SerpApi pro vývojářská API, Octoparse pro vizuální workflow, Bright Data pro enterprise, Instant Data Scraper pro rychlé bezplatné sběry a Lobstr.io pro levný export leadů.
Kromě recenzí: využití Yelp scraperů pro lead generation
Většina článků o Yelp scrapers bere Yelp jen jako web s recenzemi. Podle mě tím míjí větší obrázek. Yelp je také databáze leadů — a v některých případech je pro lokální prospecting dokonce lepší než Google Maps.
Nejsilnější workflow pro lead gen není jen „stáhnout seznam“. Je to:
- Scrape výsledky vyhledávání Yelp pro konkrétní kategorii a lokaci.
- Přes scraping podstránek navštívit detail každé firmy.
- Doplňovat web, telefon, otevírací dobu, kategorie a obsah související s majitelem.
- Volitelně obohatit URL webu o e-mailové adresy.
Thunderbit se subpage scrapingem a bezplatným extraktorem e-mailů/telefonů byl navržen přesně pro tento workflow. Ale i nástroje jako Apify Yelp Leads & Business Scraper a Lobstr Yelp Search Export podporují extrakci zaměřenou na leady.
Jaká data lze z Yelp pro leady skutečně získat?
| Pole | Na stránce s výsledky vyhledávání? | Na detailu firmy? | Poznámky |
|---|---|---|---|
| Název firmy | Ano | Ano | Základní pole u všech nástrojů |
| Hodnocení | Ano | Ano | Užitečné pro lead scoring |
| Počet recenzí | Ano | Ano | Užitečné pro reputační scoring |
| Telefon | Často | Ano | Dobré pro sales/outreach |
| Adresa | Často | Ano | Přesnější na stránce firmy |
| Web | Někdy | Ano | Často vyžaduje scraping detailu |
| Otevírací doba | Omezeně | Ano | Obvykle vyžaduje detail stránky |
| Lokalita / čtvrť | Někdy | Někdy | SerpApi explicitně vrací neighborhoods |
| Informace o majiteli / z profilu firmy | Zřídka | Někdy | Vyžaduje obsah z ověřeného profilu |
| Text recenze | Náhled omezeně | Ano | Vyžaduje scraping recenzí nebo detailu firmy |
Yelp vs. Google Maps pro lokální lead gen
Google Maps je širší zdroj pro horní část funnelu — více než 2 miliardy uživatelů měsíčně a 81 % spotřebitelů používá Google k hledání recenzí. Yelp ale má pro lead gen několik unikátních výhod:
| Datový bod | Yelp | Google Maps |
|---|---|---|
| Jméno majitele firmy | Často uvedeno u ověřených profilů | Vzácně dostupné |
| Přímý e-mail | Někdy v profilu | Někdy v profilu |
| Telefonní číslo | Ano | Ano |
| Text recenzí | Ano | Ano |
| Menu / služby | Ano | Omezeně |
| Kategorie a vybavení | Bohaté | Omezenější |
Yelp je nejlepší chápat jako kvalitní sekundární zdroj s vysokým záměrem — obzvlášť užitečný tehdy, když potřebujete jméno majitele, detailní kategorie nebo údaje o vybavení, které Google Maps neukazuje konzistentně.
Jak řešit stránkování a vyhnout se duplicitám ve velkém
Tohle je problém, o kterém skoro nikdo nemluví, ale narazili na něj nezávisle tři různí uživatelé na fórech. Tutorial ScraperAPI pro Yelp potvrzuje, že stránkování recenzí Yelp používá parametr start (např. &start=10, &start=20). Vlastní vysvětlení rankingů na Yelp zase říká, že sponzorované výsledky se mohou zobrazovat před číslovanými výsledky a že pořadí závisí na více signálech — nejde o jednoduchý stabilní seznam.
Výsledek? Tři praktické problémy:
- Sponzorované výsledky se opakují nebo zkreslují počty řádků napříč stránkami.
- Překrývající se hledání mohou stáhnout stejnou firmu vícekrát.
- Opakované monitorovací úlohy znovu importují stejnou firmu, pokud nepoužijete stabilní ID nebo URL jako klíč.
Checklist DO / DON'T pro stránkování na Yelp
- DO používejte URL firmy nebo business ID jako klíč pro deduplikaci.
- DO nejdřív scrapujte a pak slučujte/deduplikujte v Google Sheets, Airtable nebo ve své databázi.
- DO počítejte s tím, že reklamy a sponzorované řádky na Yelp zkreslí jednoduché počítání stránek.
- DON'T věřte jen viditelnému počtu řádků jako skutečnému počtu unikátních firem.
- DON'T předpokládejte, že pořadí výsledků bude při každém běhu stejné.
Mezi testovanými nástroji Thunderbit zvládá klikací stránkování i nekonečný scroll a export do Google Sheets/Airtable dělá deduplikaci snadnou. Octoparse také podporuje stránkování a parent-child flow, ale logiku deduplikace si musí hlídat uživatel. Instant Data Scraper umí stránkování v jednodušších případech, ale na Yelp je z této trojice nejméně spolehlivý.
Pro monitoring workflow má Thunderbit plánovaný scraper, díky němuž můžete nastavit opakované scrapování pomocí přirozeného jazyka — hodí se to pro sledování nových firem nebo změn v recenzích v čase bez ručního spouštění.
Jak vlastně vypadají exportovaná data z Yelp v praxi (reálné příklady)
Jedna z největších mezer v přehledech scraperů je, že nikdy neukážou, jak export ve skutečnosti vypadá. Podle mě je to škoda — měli byste vědět, co kupujete, než se pro nástroj rozhodnete.
Realistický export Yelp restaurace z Thunderbit může obsahovat například sloupce:
Business Name | Rating | Review Count | Phone | Address | Category | Website URL | Hours | Reviewer Username | Review Content | Review Date | Reviewer Location
Takhle vypadá úplnost polí napříč několika nástroji pro stejný Yelp dotaz:
| Pole | Thunderbit | Apify | Instant Data Scraper | DIY Python |
|---|---|---|---|---|
| Název firmy | ✅ | ✅ | ✅ | ✅ |
| Jméno majitele | ✅ (přes subpage) | ⚠️ Záleží na actoru | ❌ | ✅ (ruční kód) |
| Telefon (v E.164 formátu) | ✅ Automaticky naformátováno | ✅ Surové | ✅ Surové | ✅ Surové |
| AI kategorizace | ✅ Vestavěná | ❌ | ❌ | ❌ (vyžaduje postprocessing) |
| Export do Sheets/Airtable | ✅ Zdarma | ✅ Placené tarify | ❌ jen CSV | ❌ ručně |
Rozdíl mezi surovým a AI-čištěným výstupem je důležitější, než se může zdát. Thunderbit Field AI Prompt umí firmy kategorizovat, přeformátovat telefonní čísla do E.164 a dokonce překládat recenze — a to přímo během scrapingu. API jako SerpApi a ScraperAPI vrací pro pipeline čistší strukturovaná data, ale následnou normalizaci si řešíte sami.
Krátká poznámka ke scrapingu Yelp a právním souvislostem
Budu stručný — není to hlavní téma článku, ale základy znát musíte.
Podmínky použití Yelp zakazují roboty, spideri, scrapery a vytváření prohledávatelné databáze obsahu Yelp, pokud k tomu nejste výslovně oprávněni. Jejich help centrum navíc samostatně uvádí, že scraping není povolen přes boty, browser pluginy ani browser rozšíření.
To ale neznamená totéž co „je to nezákonné“. Současné právní pozadí stále zahrnuje linii případů hiQ v. LinkedIn a komentáře k Meta v. Bright Data v roce 2024 nadále považují scraping veřejných dat za záležitost závislou na konkrétních okolnostech, nikoli automaticky protiprávní.
Moje doporučení: respektujte rate limity, nescrapujte soukromá nebo přihlášením chráněná data, dodržujte místní zákony o ochraně osobních údajů (GDPR, CCPA) a používejte data zodpovědně.
Yelp má také oficiální Fusion API — ale je omezené. Vyhledávání vrací maximálně 240 firem, endpoint pro recenze vrací jen až 3 výňatky z recenzí a rate limiting je přísný. Pro většinu use casů oficiální API nestačí — a přesně proto existují scraping nástroje.
Který scraper recenzí Yelp si vybrat?
Po otestování všech 10 je můj upřímný verdikt podle scénáře použití tento:
- Netechnický uživatel, který chce co nejjednodušší nastavení → Thunderbit. Jedno kliknutí ke scrapingu, silné Yelp šablony, export zdarma.
- Vývojář, který chce strukturovaná API data → SerpApi. Čistý JSON, žádná údržba parseru, dedikované endpointy pro Yelp.
- Tým, který potřebuje obrovské škálování → Bright Data. Enterprise proxy síť, předpřipravené Yelp datasety, neomezená souběžnost.
- Uživatel s omezeným rozpočtem, který chce bezplatnou možnost → Instant Data Scraper pro rychlé jednorázové sběry. Free plán Lobstr má jen 100 výsledků, takže pokud od něj chcete Yelp leady, ve skutečnosti míříte na plán za 20 USD měsíčně.
- Obchodní tým dělající lead gen napříč platformami → PhantomBuster, pokud ho už používáte pro LinkedIn, nebo Lobstr, pokud jde čistě o Yelp leady.
- Uživatel, který chce vizuální builder workflow → Octoparse.
Pokud je otázka „co na Yelp dnes skutečně funguje“, upřímná odpověď zní, že browser-led nebo na Yelp zaměřené produkty jsou lepší než generické scrapery. Nástroje s nejjasnějším současným využitím jsou Thunderbit pro netechnické uživatele, SerpApi pro vývojáře, Bright Data pro enterprise, Apify pro cloudovou flexibilitu a Octoparse pro fanoušky vizuálních workflow.
Chcete vidět, jak vypadá 1klikový scraping Yelp? Free plán Thunderbit vám dává šest stránek měsíčně na otestování — nebo se podívejte na YouTube kanál Thunderbit s návodnými videi. A pokud chcete jít ještě dál v tématu web scrapingu, tady je pár souvisejících článků z našeho blogu:
- Jak scrapovat Yelp pomocí Pythonu
- Nejlepší automatizované nástroje pro web scraping
- Scraping dat z webu do Excelu
- Nejlepší AI web scrapery
- Nejlepší postupy pro web scraping při lead generation
Příjemné scrapování — a ať máte exporty vždy čisté, duplicit co nejméně a CAPTCHA ideálně vůbec.
Vyzkoušet Thunderbit pro scraping Yelp
Vyzkoušet Thunderbit AI Web Scraper Get Started Free
Často kladené otázky
Lze recenze Yelp scrapovat zdarma?
Ano, ale jen v malém měřítku. Nejužitečnější free tarify v roce 2026: Instant Data Scraper je úplně zdarma a bez účtu; free plán Thunderbit má 6 stránek měsíčně; Apify dává 5 USD v kreditech; SerpApi umožňuje 250 vyhledávání měsíčně; ScraperAPI dává 1 000 API kreditů; Bright Data má free tier 5 000 záznamů měsíčně; free plán Lobstr nabízí 100 výsledků a exporty omezuje na 30 řádků. Každý z nich má reálná omezení na objem, automatizaci nebo hloubku polí — ale na otestování workflow a scrapnutí několika stránek stačí.
Jaká data lze z Yelp získat kromě recenzí?
Poměrně dost. Současné nástroje dokážou vytáhnout název firmy, hodnocení, počet recenzí, telefon, web, adresu, kategorii, otevírací dobu, lokalitu, fotografie, vybavení a někdy i obsah profilu související s majitelem nebo obohacená e-mailová pole. Nejúplnější sady polí přinášejí nástroje, které podporují scraping podstránek — tedy nejdřív scrape výsledků vyhledávání a potom návštěvu detailu každé firmy pro doplnění hlubších dat.
Blokuje Yelp scrapery?
Ano — velmi agresivně. Yelp výslovně zakazuje scraping v podmínkách použití i v help centru a nedávné technické důkazy ukazují na CAPTCHA, chyby 503, TLS/JA3 fingerprinting, záměrně znepřehledněné CSS třídy a silnější blokace na katalogových a vyhledávacích stránkách než na detailech jednotlivých firem. V roce 2026 mají nejlepší úspěšnost browserové nástroje a API s proxy podporou.
Jaký je rozdíl mezi browser scrapingem a cloud scrapingem na Yelp?
Browser scraping využívá Chrome session, ve které už jste, takže provoz vypadá jako normální používání webu. Cloud scraping běží na vzdálených serverech, je rychlejší a nezatěžuje váš počítač (Thunderbit v cloud režimu zpracuje 50 stránek najednou), ale při obcházení Yelp se opírá o kvalitu proxy. Obecně: browser režim pro vyhledávání a katalogové stránky, cloud režim pro jednotlivé firemní profily.
Stačí oficiální API Yelp pro většinu použití?
Pro většinu věcí, které v článku řeším, ne. Tři výňatky recenzí na firmu vám neřeknou nic moc o vývoji sentimentu v čase a limit 240 firem se v husté kategorii vyčerpá velmi rychle — na tomhle základě nepostavíte mapu trhu ani historii recenzí. Je to v pořádku pro jednoduché načtení hodnocení do vlastní aplikace, což je zhruba účel, pro který API vzniklo.
Zjistit více



