
Thunderbit هي إضافة Chrome لـ AI Web Scraper تساعد فرق الأعمال على سحب البيانات من المواقع باستخدام الذكاء الاصطناعي. جوهر المشكلة هنا بسيط: اللي يبان سعره مناسب في صفحة تسعير ScrapingBee ممكن يختلف تمامًا أول ما تبدأ تشغيله على نطاق حقيقي، وتكتشف إن الرصيد يطير بمعدل بين 5× و75× من السعر الأساسي. هذه المراجعة تغطي خمسة جوانب كثير من المقالات تتجاهلها: التكلفة الحقيقية عند التوسع، الفرق بين الاستخراج بالـ selectors والاستخراج بالذكاء الاصطناعي، سهولة الاستخدام لغير المطورين، سير العمل بعد الاستخراج، ومعايير الاعتمادية لعام 2026. إذا كنت تقيّم ScrapingBee لفريقك — سواء كنت مطورًا، أو مسؤولًا عن عمليات المبيعات، أو مؤسسًا — فهذا هو التحليل اللي تحتاجه.
ما هو ScrapingBee؟ نظرة سريعة
ScrapingBee هو API لاستخراج بيانات الويب يتكفّل بتدوير البروكسيات، وتشغيل JavaScript، وحل CAPTCHA، بحيث يقدر المطورون يسحبون البيانات من المواقع بدون ما يبنون بنية استخراج خاصة فيهم. أنت ترسل طلب HTTP مع بعض المعاملات، ويرجع لك HTML (أو JSON في بعض نقاط النهاية). ما فيه واجهة مرئية أو أداة بنقرة واحدة لبناء عمليات الاستخراج.
تشمل القدرات الأساسية:
- بروكسيات دوّارة ومميزة (classic، premium، stealth، residential)
- عرض الصفحة عبر متصفح headless (Chrome كامل، ومفعّل افتراضيًا)
- تجاوز CAPTCHA تلقائيًا
- Google Search API (JSON منظم: النتائج العضوية، الإعلانات، الخرائط، knowledge graph، People Also Ask، الصور، الأخبار)
- التقاط لقطات الشاشة (عادية، صفحة كاملة، أو حسب CSS selector محدد)
- استهداف جغرافي عبر country_code
- قواعد استخراج CSS/XPath (JSON وصفي يعيد JSON منظم)
- واجهات API مخصصة لاستخراج Amazon وWalmart وYouTube وChatGPT
- استخراج بالذكاء الاصطناعي (أُضيف تقريبًا بين 2024–2025): ai_query وai_extract_rules وai_selector (+5 رصيد لكل طلب)
- أداة CLI (أُطلقت تقريبًا بين 2025–2026): معالجة دفعات، الزحف، تحليل sitemap، إثراء CSV، مهام cron مجدولة، تصعيد البروكسي
تأسست ScrapingBee في فرنسا عام 2019، ونمت إلى نحو $5 مليون ARR بحلول أوائل 2026 مع أكثر من 2,500 عميل (SAP وZapier وDeloitte وZillow) — وكل هذا بتمويل ذاتي وفريق من 4 إلى 6 أشخاص. في يونيو 2025، استحوذت Oxylabs Group على ScrapingBee في صفقة بثمانية أرقام. ومع ذلك، ما زالت العلامة التجارية والقيادة مستقلتين، كما تضاعف فريق الدعم أكثر من مرة لتحسين تغطية المناطق الزمنية.
ملاحظة مهمة: ScrapingBee ما يزال لا يوفر منشئًا بصريًا أصليًا، ولا واجهة GUI بنقرة وتحديد، ولا جدولة مدمجة داخل لوحة تحكم ويب. الجدولة تتطلب أداة CLI أو مهام cron أو أتمتة خارجية (Zapier وMake وn8n). أما أدلة "no-code" التي ينشرونها فهي تشرح استخدام تكاملات Make وZapier — وليس واجهة no-code أصلية.
لمن صُمم ScrapingBee فعلًا؟
ScrapingBee مصمم للمطورين اللي يجيدون كتابة أوامر Python أو cURL، وقراءة HTML، وبناء CSS/XPath selectors. التوثيق نفسه ثقيل نسبيًا من ناحية الكود، ويعتمد كثيرًا على أمثلة Python وcURL. أحد المراجعين على Capterra أشار إلى أنهم "لا يقدمون أمثلة بلغة JavaScript"، بينما وصفه آخر بأنه "ضخم، ويستغرق من يوم إلى أسبوع لقراءته بالكامل".
لكن جمهور اللي يبحثون عن "ScrapingBee review" في 2026 أوسع من مجرد مهندسي الـ backend. فهو يشمل مديري التسويق اللي يبنون قوائم عملاء محتملين، وفرق عمليات المبيعات اللي تثري بيانات CRM، وفرق التجارة الإلكترونية اللي تراقب أسعار المنافسين، والمؤسسين اللي يقيمون الأدوات لفِرَقهم. في كل قسم أدناه، سأوضح هل الميزة أو القيد يهم المطورين أو المستخدمين التجاريين أو الاثنين معًا.
خطط تسعير ScrapingBee باختصار
إليك شرائح الخطط الحالية لدى ScrapingBee (حتى أبريل 2026):
| الخطة | السعر الشهري | رصيد API شهريًا | الطلبات المتزامنة |
|---|---|---|---|
| Freelance | $49 | 250,000 | 10 |
| Startup | $99 | 1,000,000 | 50 |
| Business | $249 | 3,000,000 | 100 |
| Business+ | $599 | 8,000,000 | 200 |
| Enterprise | تواصل مع المبيعات | 41M+ | مخصص |
الفوترة السنوية تمنح خصمًا 17%. كما توجد نسخة تجريبية مجانية تمنح 1,000 رصيد API بدون الحاجة إلى بطاقة ائتمان. وتم مؤخرًا خفض رصيد Google Search API من 25 إلى 15 لكل طلب بعد الاستحواذ.
هذه الأرقام شكلها سخي على الورق، لكنها ليست كما تبدو.
جدول مضاعف الرصيد
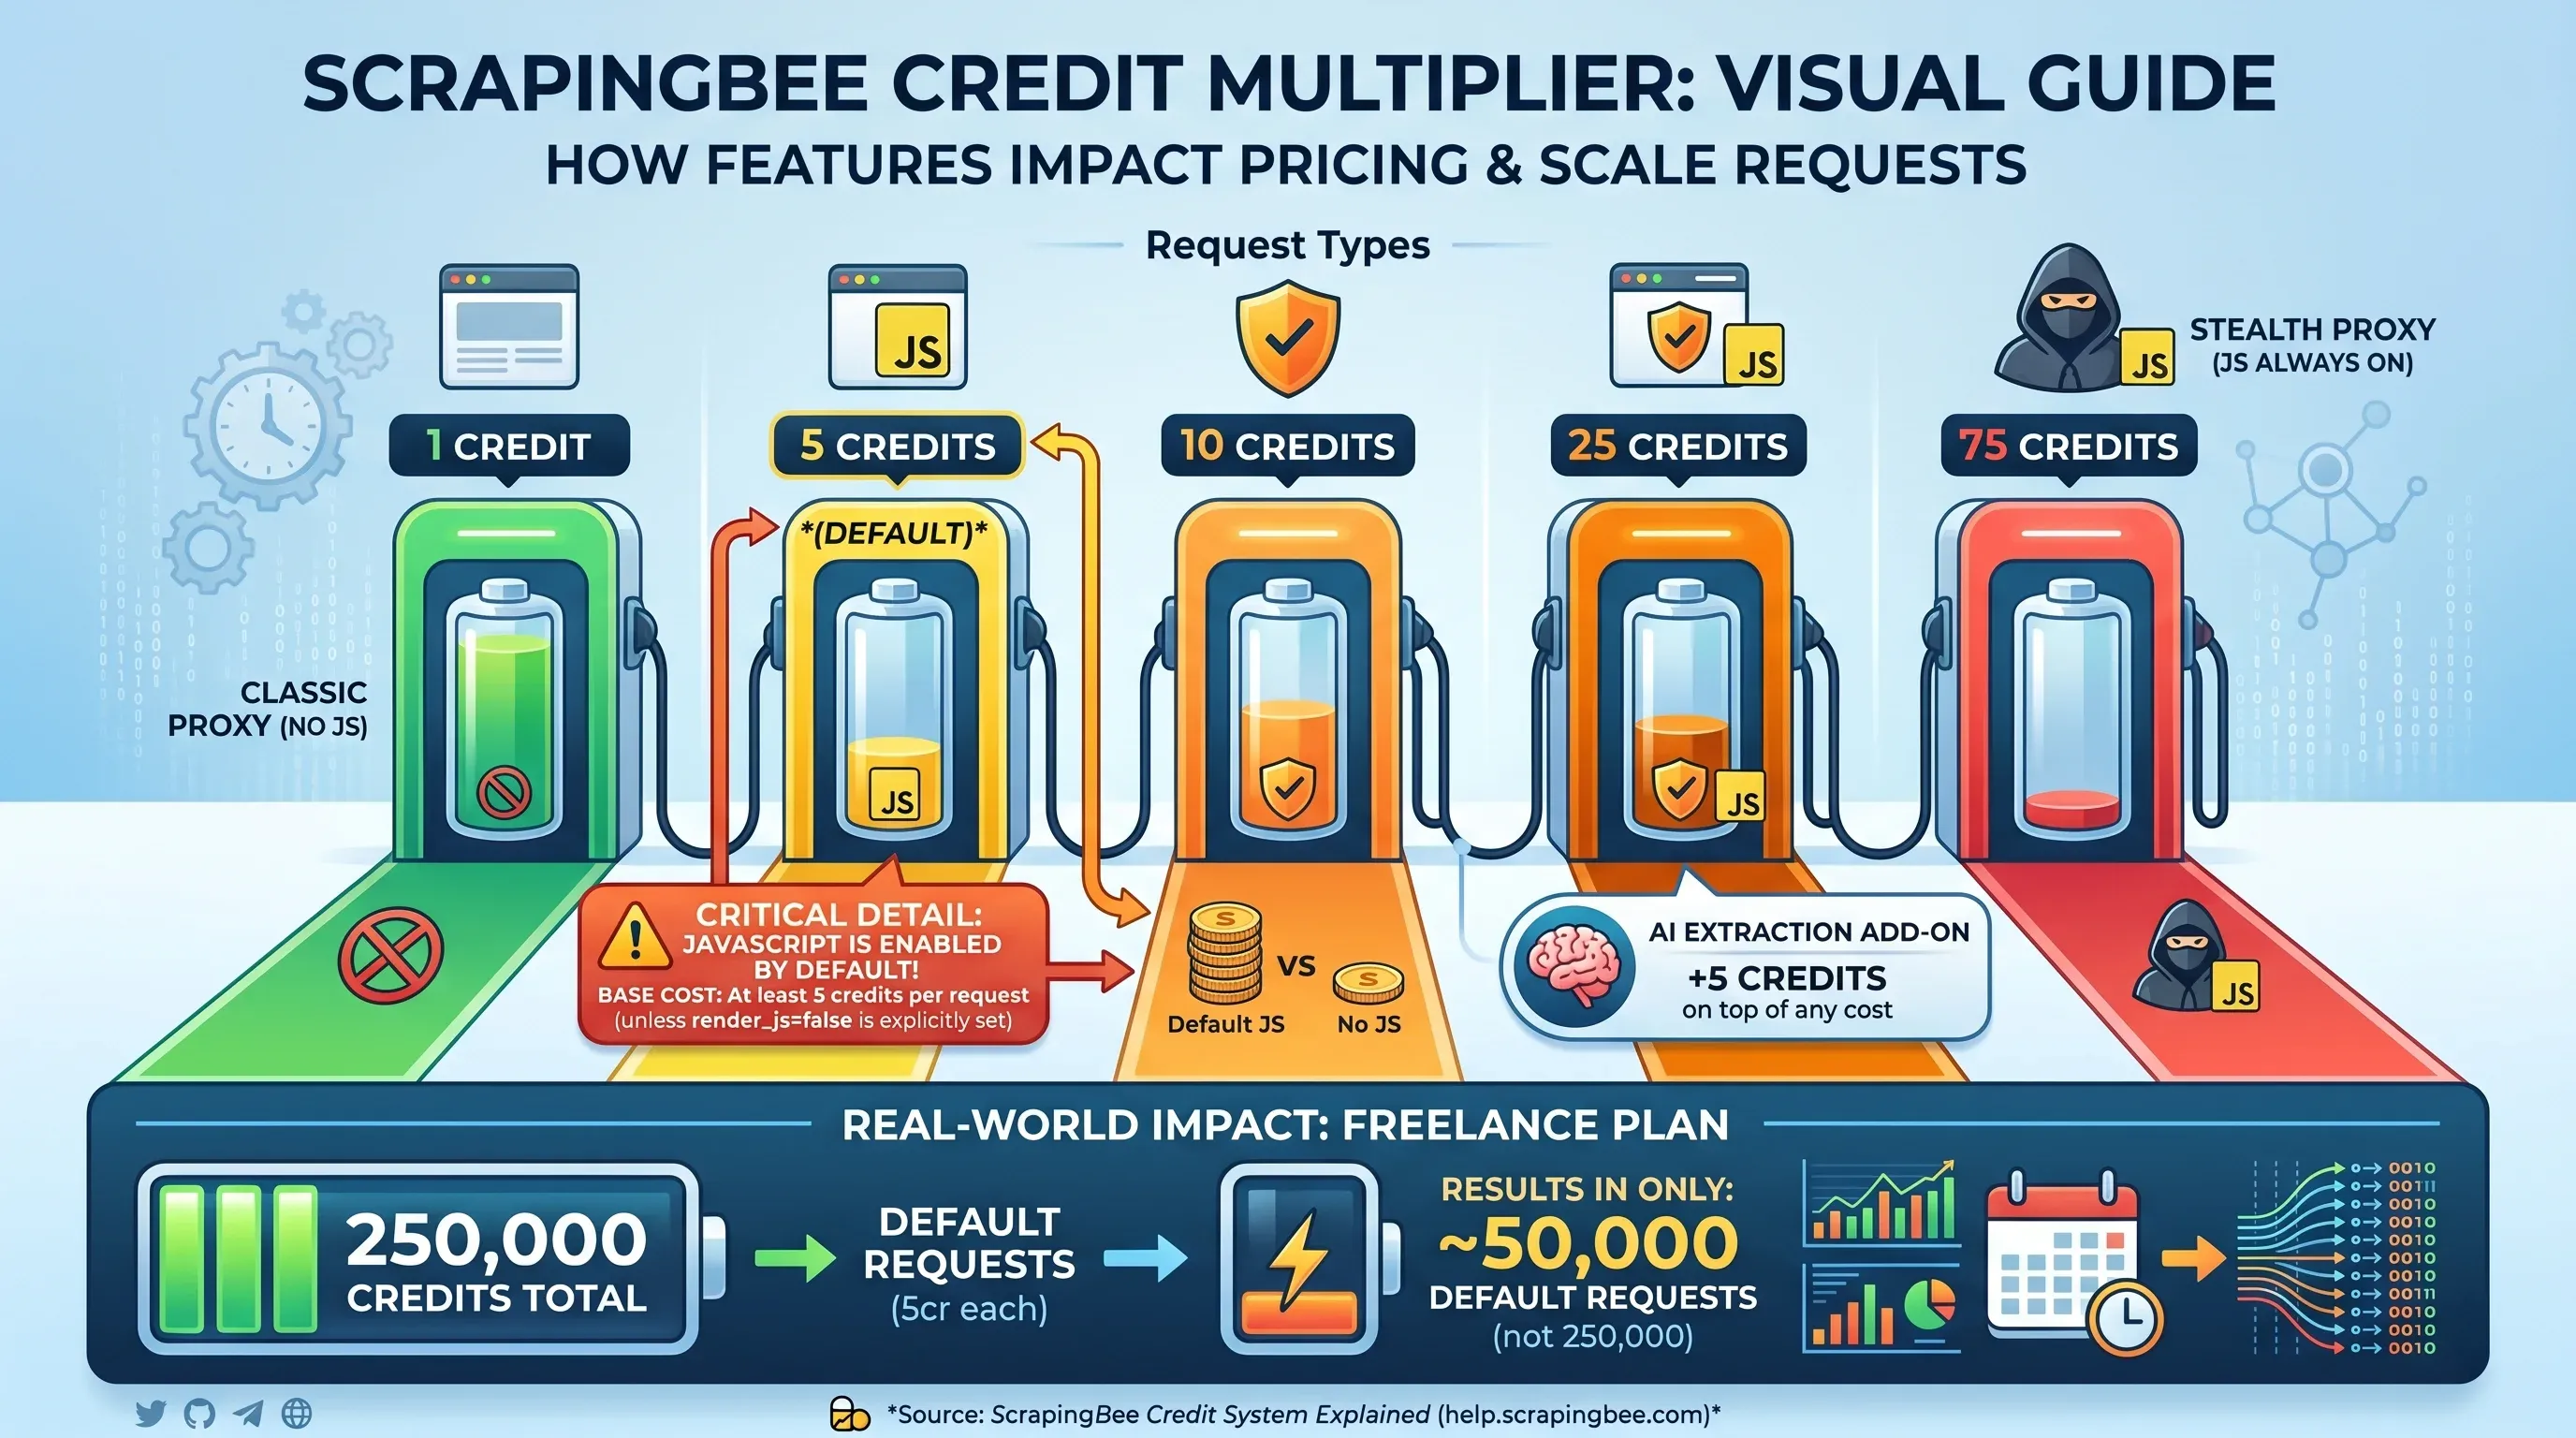
هنا تبدأ تسعيرة ScrapingBee تصير معقدة. عدد الأرصدة المعلن ليس هو عدد الصفحات اللي تقدر تستخرجها فعليًا — بل يعتمد على الميزات اللي تفعلها في كل طلب:
| نوع الطلب | الرصيد لكل طلب |
|---|---|
بروكسي classic، بدون عرض JavaScript (render_js=false) | 1 رصيد |
| بروكسي classic، مع عرض JavaScript (افتراضي) | 5 أرصدة |
| بروكسي premium، بدون عرض JavaScript | 10 أرصدة |
| بروكسي premium، مع عرض JavaScript | 25 رصيدًا |
| بروكسي stealth (JavaScript مفعّل دائمًا) | 75 رصيدًا |
| إضافة الاستخراج بالذكاء الاصطناعي | +5 أرصدة إضافية |
تفصيل مهم جدًا: عرض JavaScript مفعّل افتراضيًا. إذا ما حددت render_js=false بشكل صريح، فكل طلب يكلفك 5 أرصدة على الأقل. هذا يعني أن خطة Freelance اللي تعطيك 250,000 رصيد تغطي فعليًا فقط 50,000 طلب افتراضي — وليس 250,000.
حسابات الرصيد الخفية التي لا يعرضها أحد
إليك ما ستكلفه ScrapingBee فعليًا عند استخراج 10,000 صفحة في سيناريوهات وخطط مختلفة:
| السيناريو | الأرصدة المطلوبة | Freelance ($49/250K) | Startup ($99/1M) | Business ($249/3M) |
|---|---|---|---|---|
| 10K صفحات (HTML ثابت، 1 رصيد) | 10,000 | ✅ مشمولة ($0.20/1K) | ✅ مشمولة ($0.10/1K) | ✅ مشمولة ($0.08/1K) |
| 10K صفحات (عرض JS، 5 أرصدة) | 50,000 | ✅ مشمولة ($0.98/1K) | ✅ مشمولة ($0.50/1K) | ✅ مشمولة ($0.42/1K) |
| 10K صفحات (بروكسي premium + JS، 25 رصيدًا) | 250,000 | ⚠️ عند الحد تمامًا ($4.90/1K) | ✅ مشمولة ($2.48/1K) | ✅ مشمولة ($2.08/1K) |
| 10K صفحات (بروكسي stealth، 75 رصيدًا) | 750,000 | ❌ يتجاوز الحد بكثير | ✅ مشمولة بالكاد ($7.43/1K) | ✅ مشمولة ($6.23/1K) |
ممكن نفس 10,000 صفحة تكلف من $0.20 إلى $7.43 لكل ألف بحسب إعداد البروكسي وتهيئة العرض. وغالبًا ما راح تعرف الإعداد الصح إلا بعد التجربة.
سيناريو الميزانية: توليد العملاء المحتملين على 10,000 صفحة/شهر
فريق مبيعات يزحف إلى 10,000 صفحة شركات شهريًا لتوليد leads. معظم مواقع B2B الحديثة تستخدم React أو Vue، لذلك يلزم عرض JavaScript:
- الأرصدة المطلوبة: 50,000 (10K × 5 أرصدة)
- خطة Freelance ($49): تكفي مع بقاء 200K رصيد
- لكن إذا كانت المواقع تتطلب بروكسيات premium: 250,000 رصيد — أي كامل حصة خطة Freelance بدون أي هامش
- إذا كانت بروكسيات stealth مطلوبة: 750,000 رصيد — وهذا يتطلب خطة Startup بسعر $99/شهر
سيناريو الميزانية: مراقبة أسعار التجارة الإلكترونية على 100,000 صفحة/شهر
فريق تجارة إلكترونية يراقب 100,000 صفحة منتج في مواقع المنافسين:
| الإعداد | الأرصدة المطلوبة | الخطة المطلوبة | التكلفة الشهرية |
|---|---|---|---|
| HTML ثابت (1 رصيد) | 100,000 | Freelance | $49 |
| عرض JS (5 أرصدة) | 500,000 | Startup | $99 |
| بروكسي premium + JS (25 رصيدًا) | 2,500,000 | Business | $249 |
| بروكسي stealth (75 رصيدًا) | 7,500,000 | Business+ | $599 |
نفس الشغل ممكن يكلف من $49 إلى $599 شهريًا. هذا مو فرق بسيط — هذا فجوة تكلفة 12× حسب الإعداد.
"سعر الدخول 49 دولارًا هو الرقم الأكثر تضليلًا في سوق واجهات برمجة تطبيقات الاستخراج." — Prospeo
"الأرصدة تُستهلك بسرعة عند استخدام عرض JavaScript أو الميزات المتقدمة، مما يجعل تبريرها أصعب للمشاريع الصغيرة أو الفرق ذات أحجام الاستخراج غير المتوقعة." — Nick S، مدير، برمجيات الحاسوب، Capterra
كما أن الأرصدة غير المستخدمة لا تنتقل من شهر إلى آخر.
مقارنة تكاليف ScrapingBee مع المنافسين
باستخدام الخطط المتوسطة للمقارنة العادلة:
| السيناريو (لكل 1K صفحة) | ScrapingBee ($99/1M) | ScraperAPI ($149/1M) | Scrapfly ($100/1M) |
|---|---|---|---|
| HTML ثابت | $0.10 | $0.15 | $0.10 |
| صفحات مع عرض JS | $0.50 | $1.64 | $0.60 |
| Premium + JS | $2.48 | $3.73 | $3.00 |
| Stealth/ultra premium + JS | $7.43 | $11.18 | N/A |
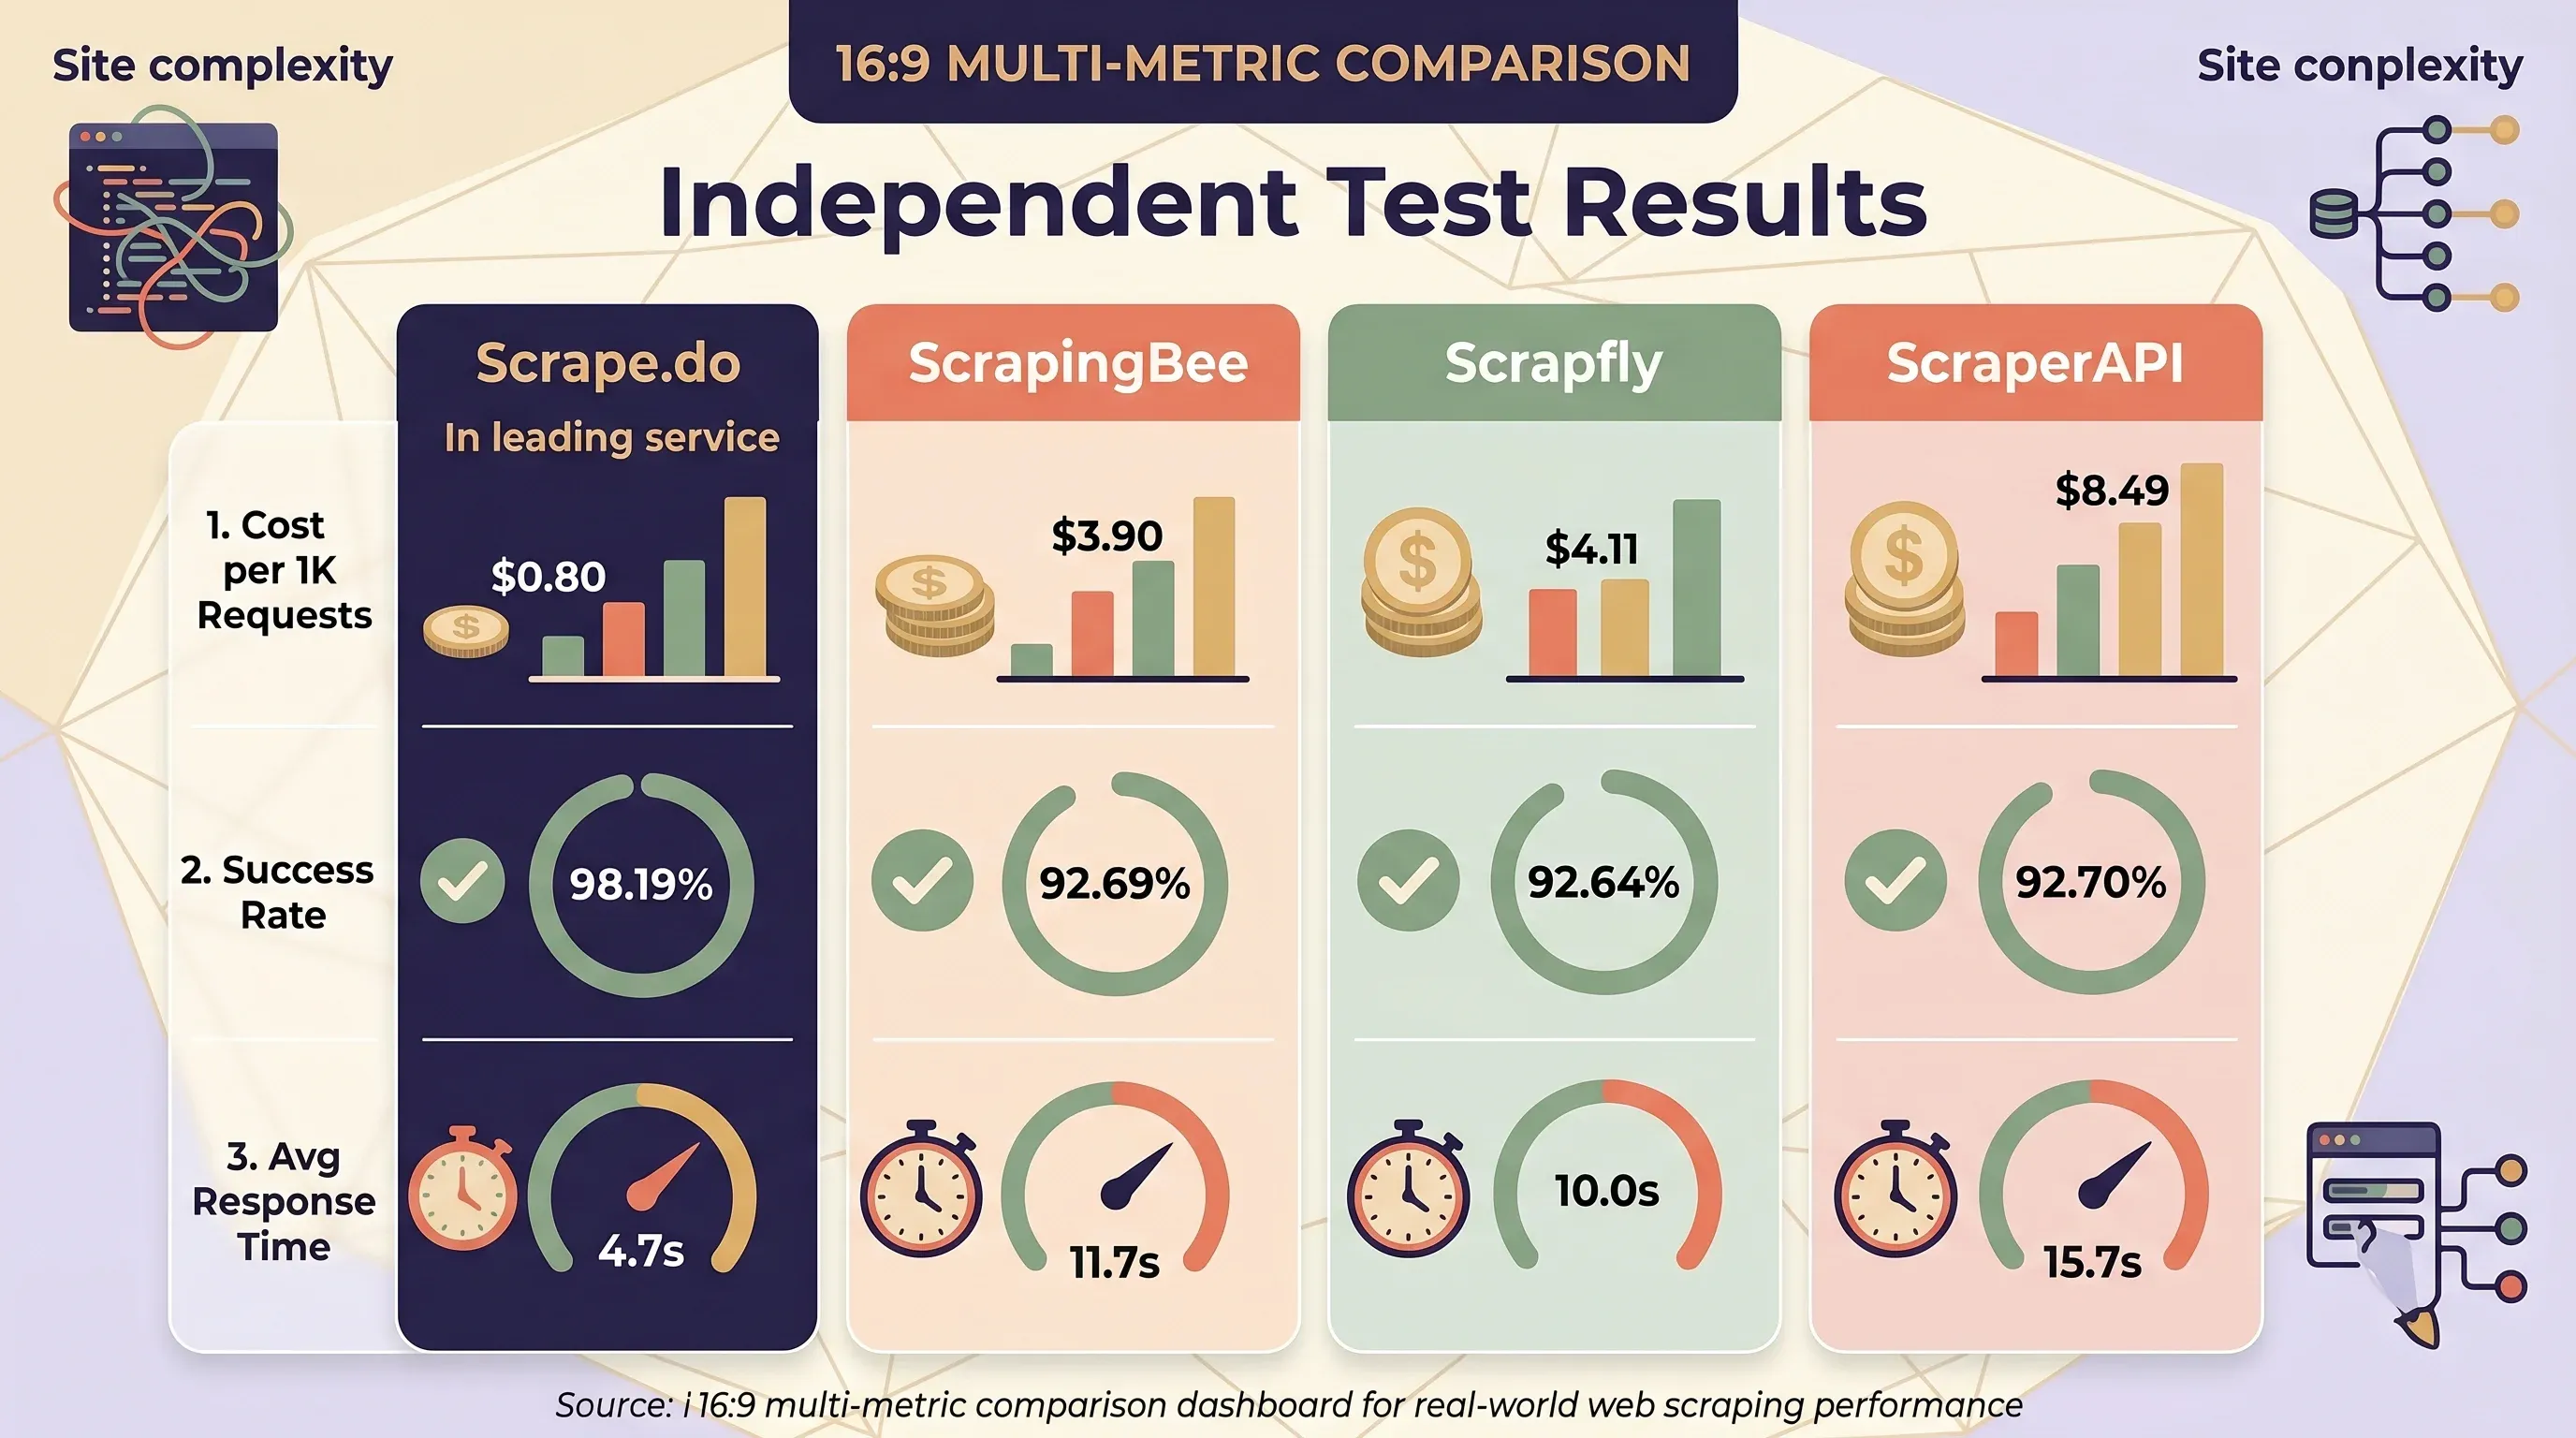
بشكل عام، ScrapingBee هو الأرخص أو من الأقل تكلفة في الصفحات الثابتة وتلك التي تحتاج عرض JS. أما ScraperAPI فهو الأغلى باستمرار — لأن تكلفة عرض JS فيه +10 أرصدة مقابل +5 في ScrapingBee وScrapfly. لكن اختبارًا مستقلًا من Scrape.do يروي قصة مختلفة عندما ندخل تعقيدات المواقع الواقعية بالحسبان:
| الخدمة | متوسط التكلفة لكل 1K طلب | معدل النجاح | متوسط وقت الاستجابة |
|---|---|---|---|
| Scrape.do | $0.80 | 98.19% | 4.7s |
| ScrapingBee | $3.90 | 92.69% | 11.7s |
| Scrapfly | $4.11 | — | — |
| ZenRows | $4.48 | 92.64% | 10.0s |
| ScraperAPI | $8.49 | 92.70% | 15.7s |
نموذج أرصدة Thunderbit: نهج مختلف
Thunderbit يستخدم نموذج تسعير أبسط بكثير: 1 رصيد = 1 صف ناتج، بدون مضاعفات بسبب عرض JS أو نوع البروكسي أو النطاق المستهدف. أما استخراج الصفحات الفرعية فيكلف 2 رصيد لكل صف.
| الخطة | السعر الشهري | الأرصدة | التكلفة لكل صف |
|---|---|---|---|
| Free | $0 | 6 صفحات/شهر | مجاني |
| Starter | $15 | 500 | $0.030 |
| Pro 1 | $38 | 3,000 | $0.013 |
| Pro 2 | $75 | 6,000 | $0.013 |
| Pro 3 | $125 | 10,000 | $0.013 |
| Pro 4 | $249 | 20,000 | $0.012 |
مستخدم Thunderbit اللي يستخرج 10,000 قائمة منتجات من مواقع تجارة إلكترونية ثقيلة بالـ JS يدفع $125/شهر بغض النظر هل هذه المواقع تحتاج JavaScript rendering أو بروكسيات premium أو تجاوز مكافحة البوتات. مع ScrapingBee، الشغل نفسه ممكن يكلف من $49 إلى $599 حسب الإعداد. التنبؤ بالميزانية هنا مسألة حقيقية.
CSS Selectors مقابل الاستخراج بالذكاء الاصطناعي: تكلفة الصيانة التي يجب أن تعرفها
معظم مراجعات ScrapingBee تتجاوز هذه النقطة، وهي في رأيي أهم عامل لأي شخص يخطط للاستخراج على مدى شهور أو سنوات.
يعتمد ScrapingBee على CSS/XPath selectors لاستخراج البيانات من HTML. أنت تحدد قواعد الاستخراج ككائنات JSON تتضمن selectors، ثم يعيد ScrapingBee البيانات المطابقة. هذا يشتغل كويس في البداية، لكن المشكلة تظهر لاحقًا.
مشكلة تكسّر الـ Selectors
لما الموقع المستهدف يغيّر تصميمه — أسماء الـ class، بنية DOM، أو إصدار الإطار البرمجي — تتعطل selectors الخاصة بك. في أنظمة استخراج ناضجة تدير أكثر من 2,500 مهمة نشطة، تُظهر الأبحاث معدل كسر أسبوعي 1–2%، ما يتطلب 30–35 إصلاحًا أسبوعيًا فقط للحفاظ على عمل الـ extractors. بالنسبة للمؤسسات اللي تستخرج من 50 موقعًا، تتراوح الصيانة السنوية بين 850 و1,300 ساعة، بتكلفة $64,000–$156,000 وفق معدلات المهندسين الكاملة.
غالبًا الفرق تقلل من شأن هذا الأمر. التقديرات الأولية عادةً تفترض 10–15 ساعة صيانة شهريًا، لكن الواقع الفعلي أعلى 4–6 مرات (40–90 ساعة شهريًا). وفشل صامت واحد — لما يتعطل الـ selector ويستمر بإرجاع بيانات فارغة بدون تنبيه — قد يكلف ما يقدّر بـ $38,000–$57,000 من المبيعات المفقودة، واستعادة الترتيب، ووقت الموظفين.
الأسباب الشائعة: إعادة تسمية CSS class أثناء تحديثات الإطار البرمجي، إدخال عناصر حاوية جديدة حول الهدف، ترقيات React/Vue/Angular التي تعيد تشكيل DOM، اختبارات A/B باستخدام أسماء class ديناميكية، وتقنيات الإخفاء المضادة للاستخراج.
الاستخراج بالذكاء الاصطناعي يقلل الصيانة 60–80%
وجدت دراسة من DataRobot لعام 2025 أن أدوات الاستخراج المدعومة بالذكاء الاصطناعي تحتاج صيانة أقل بنسبة 70% مقارنة بالأدوات التقليدية المعتمدة على selectors بعد إعادة تصميم المواقع. كما تنعكس نسبة الوقت عمليًا:
| المؤشر | التقليدي (CSS selectors) | مدعوم بالذكاء الاصطناعي |
|---|---|---|
| الصيانة بعد إعادة التصميم | خط أساس | أقل 70% |
| توزيع الوقت (الإعداد : الصيانة) | 20% : 80% | 5% : 95% باستخدام البيانات |
| إجمالي خفض الصيانة | خط أساس | خفض 60–80% |
| السرعة في الصفحات الثقيلة بالـ JS | خط أساس | أسرع 30–40% |
وقت الإعداد: كتابة الـ selectors مقابل الحقول المقترحة بالذكاء الاصطناعي
إعداد ScrapingBee: تفقد مصدر الصفحة → حدّد CSS selectors → اكتب قواعد الاستخراج بصيغة JSON → اختبر وصحح الأخطاء → تعامل مع الحالات الخاصة لاختلاف الصفحات → راقب الأعطال → أصلح الـ selectors عندما يحدّث الموقع نفسه.
إعداد Thunderbit: افتح الصفحة في Chrome → انقر "AI Suggest Fields" → يقرأ الذكاء الاصطناعي الصفحة ويقترح الأعمدة مع أنواع البيانات المناسبة → انقر "Scrape". لا كتابة selectors، ولا تفقد لمصدر الصفحة. يعتمد ذكاء Thunderbit على عدة نماذج أساسية (ChatGPT وGemini وClaude وDeepSeek R1) لقراءة صفحات الويب بصريًا كما يفعل الإنسان.
تضيف Field AI Prompts في Thunderbit طبقة إضافية: يمكن لكل عمود أن يحمل تعليمات AI مخصصة تحول البيانات أثناء الاستخراج — تنسيق التواريخ، ترجمة النصوص، تصنيف المنتجات، تقسيم الأسماء، توحيد أرقام الهواتف. هذا يلغي خطوة معالجة لاحقة منفصلة كان على مستخدمي ScrapingBee بناءها بأنفسهم.
المخرجات المنظمة: HTML خام أم صفوف جاهزة للاستخدام
| البعد | ScrapingBee (معتمد على selectors) | Thunderbit (مدعوم بالذكاء الاصطناعي) |
|---|---|---|
| المخرجات الافتراضية | HTML خام | صفوف منظمة بأعمدة محددة النوع |
| الاستخراج المنظم | يتطلب كتابة قواعد CSS/XPath أو استخدام إضافة AI (+5 أرصدة) | الذكاء الاصطناعي يكتشف الحقول تلقائيًا |
| أنواع البيانات المدعومة | نص فقط (يتطلب تحليل HTML) | نص، رقم، تاريخ، URL، بريد إلكتروني، هاتف، صورة |
| مقاومة تغيّر التصميم | ⚠️ يحتاج تحديث يدوي للـ selectors | ✅ يعيد الذكاء الاصطناعي قراءة الصفحة من جديد كل مرة |
| المهارة التقنية المطلوبة | Python/cURL، CSS selectors، فهم HTML | لا شيء — إضافة Chrome مع سير عمل من خطوتين |
| الصيانة مع الوقت | مستمرة (معدل كسر أسبوعي 1–2%) | قليلة جدًا (يتكيف الذكاء الاصطناعي تلقائيًا) |
أضافت ScrapingBee ميزات استخراج بالذكاء الاصطناعي (ai_query وai_extract_rules) تعالج مشكلة صيانة الـ selectors جزئيًا. لكن هذه تضيف +5 أرصدة لكل طلب فوق التكلفة الأساسية، وما يزال المنتج في جوهره API-first بدون واجهة مرئية.
ScrapingBee لغير المطورين: تقييم صريح لسهولة الاستخدام
ScrapingBee ليس موجهًا لغير التقنيين. إنه API. يعني أنك تكتب كودًا لاستخدامه. إذا كنت مدير تسويق أو مسؤول عمليات مبيعات وتقرأ هذا، فهذه هي الخلاصة الأساسية.
إليك ما يواجهه المستخدم غير التقني فعليًا مع ScrapingBee:
- كتابة طلب API بلغة Python أو cURL أو غيرها
- فهم معاملات HTTP مثل
render_js=trueوpremium_proxy=trueوcountry_code=us - تحليل ردود HTML الخام باستخدام مكتبة مثل BeautifulSoup
- كتابة CSS selectors لاستخراج حقول محددة
- التعامل مع pagination عبر كتابة منطق زحف مخصص (ScrapingBee يتعامل فقط مع طلبات الصفحة الواحدة)
- بناء خط بيانات لتنظيف البيانات المستخرجة وتنظيمها وتخزينها
ما فيه منشئ بالسحب والإفلات. ولا واجهة بنقرة وتحديد. ولا معاينة مرئية لما تستخرجه.
"هناك منحنى تعلم. كما أن التوثيق ضخم، ويستغرق من يوم إلى أسبوع لقراءته." — Arvind K، مالك، الخدمات المالية، Capterra
"نظامهم دقيق جدًا، ويستغرق الأمر وقتًا لتعلم أوامرهم وبنيتهم." — مراجعة على Capterra
المطورون يحبون هذا النوع من الأدوات. وصفه أحد المراجعين بأنه "يعتمد بالكامل على API: حديث وأنيق جدًا: ويعمل فقط." لكن "سهولة الاستخدام" عند المطور اللي يقيم API تختلف كثيرًا عن "سهولة الاستخدام" لشخص يحاول يبني قائمة leads بدون كتابة كود.
متى يكون البديل no-code خيارًا أفضل؟
يقدم Thunderbit Chrome Extension تجربة مختلفة تمامًا:
- افتح صفحة ويب في Chrome مع تثبيت الإضافة
- انقر "AI Suggest Fields" — يقوم الذكاء الاصطناعي بمسح الصفحة واقتراح أعمدة مثل اسم المنتج، السعر، التقييم، الرابط، إلخ مع أنواع البيانات المناسبة
- راجع وعدّل — أضف أعمدة أو احذفها أو أعد تسميتها؛ وأضف Field AI Prompts للتحويل
- انقر "Scrape" — تُستخرج البيانات في صفوف منظمة
- صدّر — بنقرة واحدة إلى Google Sheets أو Airtable أو Notion أو Excel أو CSV أو JSON (كل التصديرات مجانية)
لا طلبات API، لا selectors، لا كود. يدعم Thunderbit 55 لغة حتى أبريل 2026.
وللمواقع الشائعة، يوفّر Thunderbit أيضًا قوالب استخراج فورية — قوالب جاهزة ومُصانة لـ Amazon وZillow وShopify وLinkedIn وGoogle Maps وInstagram وeBay وApollo وغيرها. ما تحتاج حتى تنتظر الذكاء الاصطناعي عشان يقترح الحقول؛ القالب جاهز من الأساس.
إضافة إلى ذلك، يتضمن Thunderbit عدة أدوات مجانية للأبد لا تتطلب أي خطة: أداة استخراج البريد الإلكتروني، وأداة استخراج أرقام الهاتف، وأداة استخراج الصور — وهي مفيدة جدًا لفرق المبيعات والتسويق التي تحتاج فقط إلى سحب سريع للبيانات.
إطار القرار: من يستخدم ماذا؟
| إذا كنت… | الخيار الأنسب |
|---|---|
| مطورًا مرتاحًا مع API وتحليل HTML | ScrapingBee أو ScraperAPI |
| مستخدمًا تقنيًا يريد بيانات منظمة بدون صداع selectors | Thunderbit API (نقطة النهاية Extract) |
| مستخدم أعمال (مبيعات، تسويق، عمليات تجارة إلكترونية) بدون مهارات برمجة | Thunderbit Chrome Extension |
| فريقًا يحتاج مراقبة مجدولة بدون DevOps | Thunderbit Scheduled Scraper (جدولة باللغة الطبيعية) |
| تبني خطوط LLM/RAG وتحتاج Markdown نظيف | Thunderbit Distill API أو Firecrawl |
| مهتمًا بالميزانية وتريد عدم وجود مضاعفات رصيد | Thunderbit (1 رصيد = 1 صف) |
بعد الاستخراج: إلى أين تذهب بياناتك فعلًا؟
الاستخراج نصف المهمة فقط. النصف الثاني — إيصال البيانات إلى مكان مفيد — هو المكان اللي تصمت فيه معظم مراجعات ScrapingBee.
ScrapingBee: يخرج HTML خام، وعليك تبني خط المعالجة بنفسك
يرجع ScrapingBee HTML خامًا افتراضيًا. ومن هناك عليك:
- تحليل HTML باستخدام BeautifulSoup أو lxml
- إزالة القوائم الجانبية والتذييل والسكربتات والأنماط، والتي تشكل 80–90% من محتوى الصفحة النموذجية
- استخراج الحقول المطلوبة
- تحويل النتائج إلى صيغ منظمة
- التعامل مع pagination وحالات الخطأ
- تخزين البيانات وتوزيعها
"ScrapingBee يعيد HTML خامًا. وكلاء الذكاء الاصطناعي يحتاجون Markdown نظيفًا، وبحثًا دلاليًا، وwebhooks." — KnowledgeSDK
صحيح إن ScrapingBee يوفّر return_page_markdown=true وreturn_page_text=true كبدائل اختيارية، كما أن Google Search API يعيد JSON منظمًا. لكن سير العمل الافتراضي — وتجربة الاستخراج العامة — ما تزال تعتمد على HTML خام يحتاج معالجة يديوية.
غالبًا المستخدمون يحتاجون أدوات إضافية: BeautifulSoup/lxml للتحليل، وPandas لتنظيف البيانات، وcron/Airflow للجدولة، ومنطق زحف مخصص للصفحات المتعددة، وتخزين سحابي منفصل. هذا كثير من الهندسة بين عبارة "استخرجته" وعبارة "أقدر أستخدمه".
Thunderbit: مخرجات منظمة مع تصدير مدمج
يعيد Thunderbit صفوفًا منظمة مع أنواع بيانات واضحة (نص، رقم، تاريخ، URL، بريد إلكتروني، هاتف، صورة) جاهزة للتصدير. وكل التصديرات مجانية عبر جميع الخطط:
| وجهة التصدير | التكلفة |
|---|---|
| Excel (.xlsx) | مجاني |
| Google Sheets | مجاني (تكامل مباشر) |
| Airtable | مجاني (تكامل مباشر) |
| Notion | مجاني (تكامل مباشر) |
| CSV | مجاني |
| JSON | مجاني |
وللفرق اللي تستخدم أصلًا Google Sheets أو Airtable كمركز CRM أو عمليات، فهذا يزيل طبقة كاملة من الهندسة. وعند التصدير إلى Notion أو Airtable، تُرفع الصور إلى مكتبة الصور حتى يقدر المستخدم يشوفها داخل السجل — تفصيلة صغيرة لكنها مهمة جدًا عمليًا.
منظومة تكاملات ScrapingBee
يوفر ScrapingBee تكاملات مع أطراف ثالثة: Zapier (أكثر من 8,000 اتصال تطبيقي)، وMake (أكثر من 3,000 تطبيق)، وn8n، وMicrosoft Power Automate. هذه الأدوات تقدر تربط HTML الخام مع أدواتك النهائية — لكنها تضيف تكلفة وتعقيد ونقطة فشل إضافية.
للمطورين: واجهة Thunderbit المفتوحة
للقراء اللي يريدون مسارات برمجية، يقدم Thunderbit Open API بنقطتي نهاية رئيسيتين:
- نقطة نهاية Distill — تحول الصفحات إلى Markdown نظيف، مثالية لخطوط LLM/RAG (1 رصيد لكل استدعاء)
- نقطة نهاية Extract — تعيد JSON منظمًا وفق schema يحدده المستخدم (20 رصيدًا لكل استدعاء)
- معالجة دفعات — حتى 100 رابط في الطلب الواحد
هذا يعني أن Thunderbit يخدم مستخدمي no-code (Chrome Extension) والمطورين (Open API) على محرك ذكاء اصطناعي واحد. لا تسأل فقط: "هل يقدر يستخراج؟" بل أيضًا: "وين تروح البيانات بعدين؟"
فحص الاعتمادية في 2026: هل يصمد ScrapingBee في الإنتاج؟
هناك سلاسل قديمة على Reddit (2021–2023) فيها شكاوى من الاعتمادية في ScrapingBee. فهل ما تزال تعكس الواقع في 2026؟ جمعت بيانات من ستة معايير مستقلة. والنتائج مختلطة — وأحيانًا متناقضة.
معيار Scrapeway نصف الشهري (أبريل 2026)
الإجمالي: معدل نجاح 33.3% — في المرتبة السابعة من أصل 9 خدمات تم اختبارها.
| الموقع | معدل النجاح |
|---|---|
| Amazon | 48% |
| 41% | |
| Indeed | 38% |
| Etsy | 21% |
| Booking | 17% |
| Realtor | 0% |
| StockX | 0% |
| Twitter/X | 0% |
| Zillow | 0% |
| Walmart | 0% |
| 0% |
اختبار Scrapingdog المباشر (2025)
| الموقع | ScrapingBee | Scrapingdog | ScraperAPI |
|---|---|---|---|
| Amazon | 100% | 100% | 100% |
| Glassdoor | 0% | 100% | 100% |
| eBay | 100% | 100% | 100% |
| Walmart | 40% | 100% | 100% |
| 90% | 100% | 80% |
معيار Proxyway (ديسمبر 2025)
- 84.47% نجاح عند 2 طلب/ثانية
- 72.98% نجاح عند 10 طلبات/ثانية — هبوط 12 نقطة تحت الضغط
- متوسط زمن استجابة 25.46 ثانية — الأبطأ في مجموعة الاختبار
معيار Scrape.do (2025–2026)
- معدل نجاح إجمالي 92.69%
- قوي على مواقع فردية: Amazon بنسبة 99.11%، وIndeed بنسبة 99.29%، وGitHub بنسبة 100%، وX/Twitter بنسبة 99.6%
- ضعيف على Capterra: نجاح 59% فقط مع أزمنة استجابة وصلت 36 ثانية
النمط العام
البيانات تكشف نمط واضح:
- ScrapingBee يؤدي بشكل جيد على المواقع العامة متوسطة الحماية — Amazon وeBay وGitHub وIndeed تظهر باستمرار معدلات نجاح بين 90–100%
- ScrapingBee يفشل تمامًا على المواقع شديدة الحماية — تكرار 0% على LinkedIn وZillow وRealtor.com وStockX وTwitter عبر عدة معايير
- الأداء يتراجع بوضوح تحت الضغط — 84% عند 2 طلب/ثانية تنخفض إلى 73% عند 10 طلبات/ثانية
- النتائج تختلف بشكل كبير بحسب منهجية الاختبار — من 33.3% (Scrapeway، مزيج واسع من المواقع) إلى 92.69% (Scrape.do، أهداف متوسطة الصعوبة)
تقييم Capterra البالغ 4.9/5 (137 مراجعة) إشارة إيجابية، لكن التقييمات العالية لسهولة الإعداد الأولي ما تعكس دائمًا موثوقية الإنتاج على المدى الطويل وعند التوسع. غالبًا اللي يتركون الأداة يذكرون ارتفاع معدلات الفشل وتزايد التكاليف — مو صعوبة الإعداد الأولي.
"إيجابي جدًا. ScrapingBee كان مستقرًا، ويمكن التنبؤ به، وسهل الدمج في الإنتاج." — مراجع موثّق، CEO، Capterra
أظهر ScrapingBee "اعتمادية غير متسقة"، مع تحقيق "معدل نجاح 0% على Glassdoor" و"40% على Walmart".
كيف يتعامل الاستخراج بالذكاء الاصطناعي مع الاعتمادية بشكل مختلف
يقرأ ذكاء Thunderbit الصفحة المعروضة في الوقت الفعلي، ويتكيف مع إجراءات مكافحة البوتات وتغييرات التخطيط في كل جلسة. هناك نمطان للاستخراج يعالجان تحديات اعتمادية مختلفة:
- Cloud scraping — يعمل على خوادم Thunderbit السحابية، ويتعامل مع ما يصل إلى 50 صفحة دفعة واحدة، وهو الأنسب لمهام الاستخراج العامة الكبيرة على مواقع مثل Amazon وZillow وShopify
- Browser scraping — يعمل محليًا داخل Chrome الخاص بالمستخدم، باستخدام جلسة تسجيل الدخول الخاصة به — وهو مثالي للمواقع المحمية بتسجيل الدخول (LinkedIn، لوحات التحكم الخاصة، منصات SaaS) اللي ما تقدر الأدوات المعتمدة على API مثل ScrapingBee توصل لها خلف طبقة المصادقة
كما يوفر Thunderbit قوالب استخراج فورية للمواقع الشائعة، وهي جاهزة ومُصانة بحيث تبقى تعمل حتى عندما يغير الموقع بنيته. أما المواقع اللي يظهر فيها ScrapingBee معدل نجاح 0% مثل LinkedIn وZillow، فإن وضع browser scraping في Thunderbit — باستخدام جلستك المسجلة — يقدم نهجًا مختلفًا تمامًا.
ScrapingBee مقابل أفضل البدائل: مقارنة مباشرة
| البعد | ScrapingBee | Thunderbit | ScraperAPI | Scrapfly |
|---|---|---|---|---|
| النوع | API فقط | Chrome Extension + API | API فقط | API فقط |
| السعر الابتدائي | $49/شهر | مجاني ($0) | $49/شهر | $30/شهر |
| نموذج الرصيد | مضاعفات (1×–75×) | 1 رصيد = 1 صف (لا مضاعفات) | مضاعفات (1×–75×) | مضاعفات (1×–30×) |
| استخراج AI | نعم (+5 أرصدة/طلب) | مدمج (AI Suggest Fields) | لا يوجد AI أصلي | نعم |
| خيار no-code | لا (API فقط) | نعم (Chrome Extension) | لا (API فقط) | لا (API فقط) |
| المخرجات المنظمة | يتطلب قواعد CSS أو إضافة AI | افتراضيًا (أعمدة محددة النوع) | نقاط نهاية منظمة لمواقع محددة | يختلف |
| وجهات التصدير | HTML/JSON خام (ابنِ ما يلزم بنفسك) | Excel وSheets وAirtable وNotion وCSV وJSON (كلها مجانية) | HTML/JSON خام | HTML/JSON خام |
| استخراج الصفحات الفرعية | يدوي (اكتب منطق الزحف) | مدمج (2 رصيد/صف) | يدوي | يدوي |
| الاستخراج المجدول | CLI فقط (لا يوجد جدول تحكم) | مدمج (باللغة الطبيعية) | غير مدمج | غير مدمج |
| النسخة المجانية | 1,000 رصيد تجريبي | 6 صفحات/شهر (مدى الحياة) | 5,000 رصيد (تجربة 7 أيام) | 1,000 رصيد |
| الـ JS rendering افتراضيًا | مفعّل (تكلفة 5×) | مدمج (بدون تكلفة إضافية) | متوقف | متوقف |
| منحنى التعلم | مرتفع (API + selectors) | منخفض (سير عمل من خطوتين) | مرتفع (API + selectors) | مرتفع (API) |
| الأفضل لـ | المطورون اللي يريدون تحكم دقيق بالبروكسي | مستخدمو الأعمال + المطورون | المطورون + نقاط نهاية منظمة | المطورون اللي يريدون تجاوز anti-scraping protection |
| تقييم Capterra | 4.9/5 (137 مراجعة) | — | 4.6/5 (62 مراجعة) | 4.9/5 (221 مراجعة) |
ScrapingBee مقابل Thunderbit: الفروق الأساسية
أكبر الفروقات ترجع للبنية والجمهور المستهدف:
- API فقط مقابل Chrome Extension + API: يتطلب ScrapingBee كودًا لكل تفاعل. أما Thunderbit فيوفر Chrome Extension لمستخدمي no-code وOpen API للمطورين — نفس محرك الذكاء الاصطناعي، وواجهتان مختلفتان.
- الاستخراج بالـ selectors مقابل الاستخراج المدعوم بالذكاء الاصطناعي: يتطلب ScrapingBee كتابة وصيانة CSS/XPath selectors. أما Thunderbit فيقترح الحقول تلقائيًا ويتكيف لما تتغير المواقع.
- HTML خام مقابل صفوف منظمة مع تصدير مجاني: يعيد ScrapingBee HTML عليك تحليله. يعيد Thunderbit صفوفًا معنونة ومحددة النوع يمكنك تصديرها إلى Excel أو Google Sheets أو Airtable أو Notion بنقرة واحدة.
- استخراج الصفحات الفرعية: Thunderbit يزور كل صفحة تفصيلية ويثري الجدول الرئيسي — مدمج، بدون منطق زحف مخصص. أما ScrapingBee فيتطلب منك كتابة هذا المنطق بنفسك.
- القوالب الفورية: لدى Thunderbit قوالب جاهزة للمواقع الشائعة (Amazon وZillow وShopify وLinkedIn وGoogle Maps وeBay) تعمل مباشرة. أما ScrapingBee فيملك واجهات مخصصة لـ Amazon وWalmart، لكنك ما تزال تحتاج تكتب كود لاستخدامها.
بدائل أخرى جديرة بالذكر
- Scrape.do — الأقل تكلفة بشكل مستقل عند $0.80 لكل 1K طلب مع معدل نجاح 98.19%؛ يبدأ من $29/شهر
- Apify — منصة مبنية على Actors مع أكثر من 415 مراجعة على G2 (4.7/5)، لكن "مشكلات التسعير" هي الشكوى رقم 1
- Firecrawl — أصلي لـ AI/LLM، يعيد Markdown مع عدد tokens أقل بنسبة 67% من HTML الخام؛ نواة مفتوحة المصدر؛ يبدأ من $16/شهر
- Bright Data — بمستوى مؤسسي مع أكثر من 72 مليون IP، يبدأ من $499/شهر؛ تسعير ثابت
- ZenRows — مع 55 مليون IP residential، وقوالب جاهزة لـ Amazon وWalmart وZillow، يبدأ من $69/شهر
ما أداة الاستخراج المناسبة لفريقك؟
توصيات حسب السيناريو:
- إذا كنت مطورًا تبني خط استخراج مخصصًا وتحتاج تحكمًا دقيقًا بالبروكسي → ScrapingBee أو ScraperAPI. ستحصل على معاملات HTTP دقيقة، واختيار نوع البروكسي، وتحكم كامل في العرض. فقط احسب حساب مضاعفات الرصيد.
- إذا كنت فريق مبيعات أو تسويق وتحتاج leads من المواقع بدون كتابة كود → Thunderbit Chrome Extension. خطوتان للوصول إلى بيانات منظمة، وخطوة واحدة إلى Google Sheets. لا API، ولا selectors، ولا تحليل.
- إذا كنت تحتاج بيانات منظمة من مواقع شائعة بسرعة → Thunderbit Instant Templates. Amazon وZillow وShopify وLinkedIn — جاهزة ومصانة، ولا تحتاج إعداد AI.
- إذا كنت تحتاج مراقبة الأسعار أو المخزون وفق جدول بدون DevOps → Thunderbit Scheduled Scraper. اكتب الفترة بلغة بسيطة (مثل "كل يوم اثنين الساعة 9 صباحًا") وخله يشتغل.
- إذا كنت تبني خطوط LLM/RAG وتحتاج Markdown نظيفًا على نطاق واسع → Thunderbit Distill API أو Firecrawl. كلاهما يعيد Markdown مناسبًا لاستهلاك الذكاء الاصطناعي.
- إذا كانت قابلية التنبؤ بالميزانية مهمة وما تريد مضاعفات رصيد → Thunderbit. 1 رصيد = 1 صف، بغض النظر عن JS rendering أو نوع البروكسي.
إجمالي تكلفة الملكية ليس سعر API فقط. إنه: وقت الإعداد + ساعات الصيانة + هندسة التحليل + سير عمل تصدير البيانات. سعر ScrapingBee المعلن تنافسي؛ أما الصورة الكاملة للتكلفة فليست كذلك.
الخلاصة الأساسية من مراجعة ScrapingBee هذه
خمسة استنتاجات تستحق التذكر:
- تكلفة الأرصدة تتضاعف بسرعة عند التوسع. سعر الدخول البالغ $49 قد يتحول إلى $599+ عندما تحتاج إلى JS rendering وبروكسيات premium. نموذج Thunderbit الثابت، حيث 1 رصيد = 1 صف، يزيل هذه المفاجأة.
- CSS selectors تفرض عبئًا مستمرًا على الصيانة، بينما يتفادى الذكاء الاصطناعي هذا العبء. توقّع صيانة أقل بنسبة 60–80% مع الأدوات المدعومة بالذكاء الاصطناعي، ودون كسر للـ selectors عند تحديث المواقع.
- غير المطورين سيواجهون منحنى تعلم حادًا مع ScrapingBee. فهو أداة API فقط تتطلب برمجة، وفحص HTML، وبناء selectors. على المستخدمين التجاريين النظر في بدائل no-code.
- تصدير البيانات يتطلب هندسة مخصصة. يعيد ScrapingBee HTML خامًا؛ بينما تبني أنت خط المعالجة. أما Thunderbit فيصدر بيانات منظمة إلى Excel وSheets وAirtable وNotion مجانًا.
- الاعتمادية قوية لبعض المواقع لكنها غير مستقرة لأخرى. يعمل ScrapingBee جيدًا على Amazon وeBay، لكنه يظهر 0% على LinkedIn وZillow وعدة أهداف أخرى شديدة الحماية.
يبقى ScrapingBee أداة قوية للمطورين الذين يريدون وصول HTTP بإدارة بروكسي وتحكمًا دقيقًا. لكن مشهد استخراج الويب في 2026 تحوّل نحو أدوات مدعومة بالذكاء الاصطناعي وبدون كود — وThunderbit مصمم تحديدًا لهذا التحول. جرّب الخطة المجانية (6 صفحات مجانية، أو أكثر عبر التجربة المجانية) لترى الفرق بنفسك.
الأسئلة الشائعة
هل يستحق ScrapingBee التجربة في 2026؟
يعتمد ذلك على مهاراتك التقنية وحجم الاستخدام. بالنسبة للمطورين الذين يستخرجون صفحات ثابتة بحجم متوسط، يقدم ScrapingBee API قويًا وموثقًا جيدًا مع دعم سريع وتقييم 4.9/5 على Capterra. أما لمستخدمي الأعمال، أو للاستخراج عالي الحجم، أو للفرق التي تريد بيانات منظمة بدون برمجة، فإن البدائل المدعومة بالذكاء الاصطناعي مثل Thunderbit تقدّم قيمة أفضل وتكلفة ملكية أقل بكثير.
هل يعمل ScrapingBee بدون برمجة؟
لا. ScrapingBee أداة API فقط تتطلب كتابة كود (Python أو cURL أو ما شابه) وفهم معاملات HTTP. ما فيه واجهة مرئية لبناء عمليات الاستخراج. على المستخدمين غير التقنيين التفكير في بدائل no-code مثل Thunderbit Chrome Extension، التي تتيح لك استخراج البيانات وتصديرها بدون كتابة سطر كود واحد.
كم تبلغ تكلفة ScrapingBee فعليًا لكل صفحة؟
يعتمد ذلك على الميزات المفعلة. الصفحة الثابتة تكلف 1 رصيد. الصفحة التي تعرض JavaScript (وهو الوضع الافتراضي) تكلف 5 أرصدة. أما صفحة premium proxy + JS فتكلف 25 رصيدًا. وصفحة stealth proxy تكلف 75 رصيدًا. ويضيف الاستخراج بالذكاء الاصطناعي +5 أرصدة فوق ذلك. في خطة Freelance ($49/250K رصيد)، هذا يعادل $0.20 لكل 1,000 صفحة ثابتة أو $14.70 لكل 1,000 صفحة عبر stealth proxy. راجع جداول التكلفة أعلاه للتفاصيل الكاملة.
ما أفضل بدائل ScrapingBee في 2026؟
تشمل أفضل البدائل Thunderbit (مدعوم بالذكاء الاصطناعي، no-code عبر Chrome Extension + API، 1 رصيد = 1 صف)، وScraperAPI (API للمطورين مع نقاط نهاية منظمة لمواقع محددة)، وScrapfly (API للمطورين مع قدرات قوية لتجاوز anti-bot)، وScrape.do (الأقل تكلفة لكل طلب في الاختبارات المستقلة)، وFirecrawl (أصلي للـ AI/LLM ويعيد Markdown نظيفًا). كل واحد له نقطة قوة مختلفة — Thunderbit لمستخدمي الأعمال وقابلية التنبؤ بالميزانية، وScraperAPI وScrapfly للمطورين اللي يريدون تحكمًا بالبروكسي، وFirecrawl لخطوط LLM.
هل يستطيع ScrapingBee استخراج مواقع ثقيلة بالـ JavaScript؟
نعم، لكنه يكلف 5× من الرصيد الأساسي مع بروكسي دوّار، أو 25× مع بروكسي premium. عرض JavaScript مفعّل افتراضيًا، لذلك أنت تدفع أصلًا معدل 5× ما لم توقفه صراحةً. أما Thunderbit فيتعامل مع عرض JS تلقائيًا بدون مضاعفات رصيد — 1 رصيد لكل صف بغض النظر عن بنية الصفحة.
معرفة المزيد



