Slack 消息、线程和表情反应爬虫





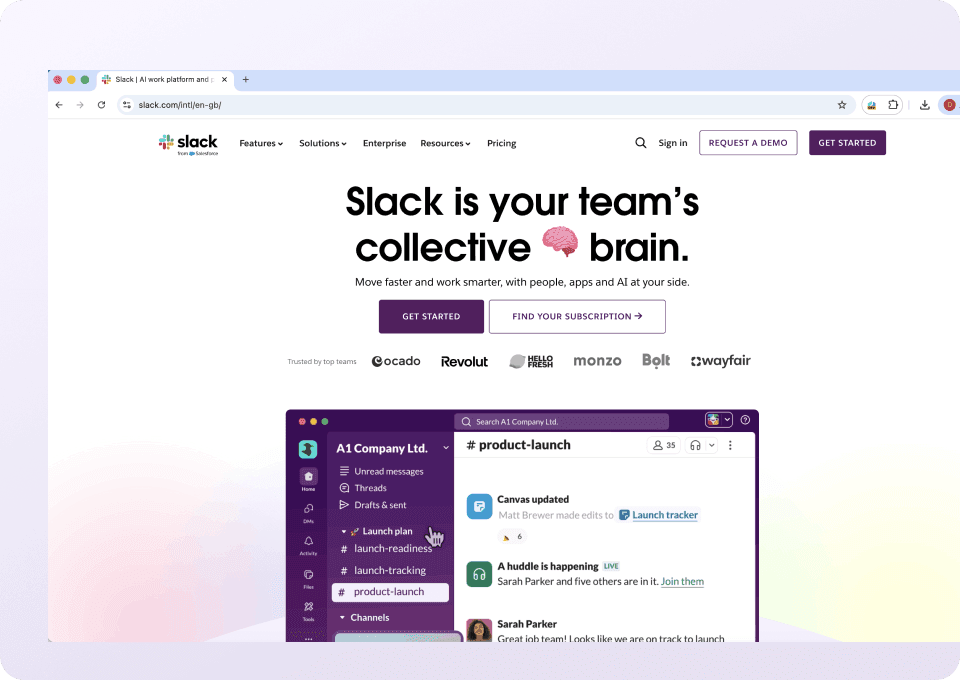
将 Slack 消息和线程上下文一起保留
一键开始,保留可见上下文,并可用自然语言继续细化任务。
无需设置 CSS 选择器
Thunderbit 会按语义识别可见的消息、作者、时间、反应和线程标签,因此你无需先为 Slack 界面编写 CSS 规则。
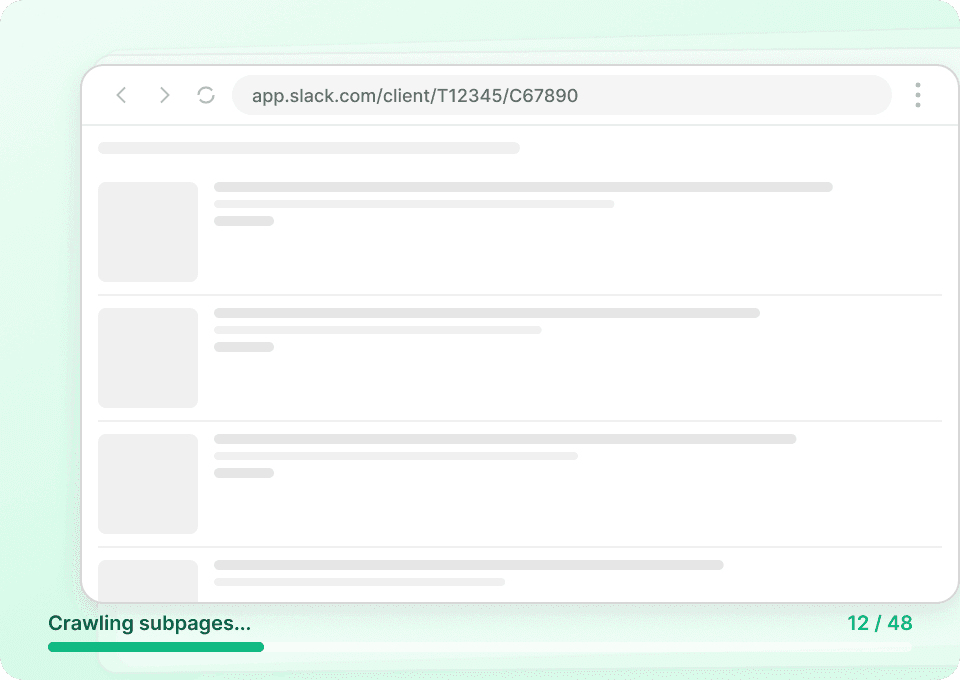
打开线程,获取完整上下文
对于带线程的消息,Thunderbit 可以打开线程视图,抓取回复、作者和时间戳。如果你只需要频道信息,也可以关闭链接页面跳转。
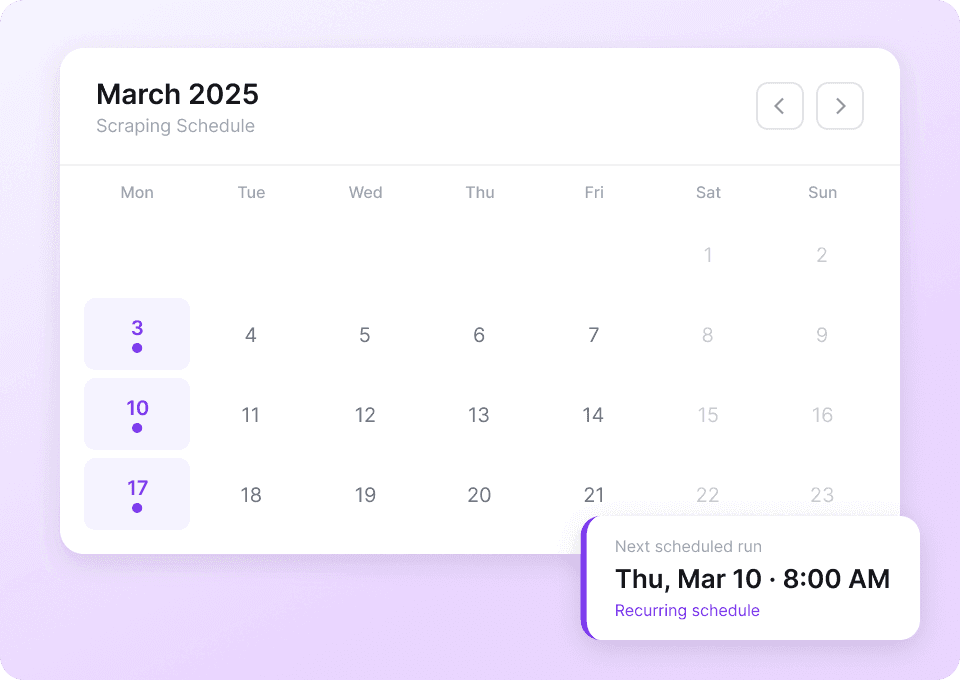
按计划刷新频道数据
支持定时运行。每次运行都会记录当时会话中可见的内容,并可将结果发送到 Google Sheets、Notion、Airtable 或 CSV。
无需自己搭建爬虫,也能把 Slack 线程整理在一起
用合适的消息结构,完整保留可见的作者、时间、反应和回复。
手动复制或选择器工具
上下文很容易丢失Thunderbit AI 代理
打开 Slack 视图即可开始保留发言人、时间和位置的字段
只会采集当前 Slack 视图中显示的字段;隐藏数据会保持空白。
- channel_name
- channel_privacy
- channel_topic
- channel_purpose
- channel_member_count
- message_text
- sender_display_name
- sender_avatar_image
- message_date
- message_time
- message_edited_flag
- message_edited_time
- is_app_message
- app_name
- thread_reply_count
- thread_last_reply_time
- thread_participants_count
- reaction_emoji
- reaction_count
- reactions_total
- mentioned_users
- mentioned_channels
- attachments_count
- attachment_title
- attachment_filetype
- attachment_filesize
- attachment_uploader_name
- pinned_flag
- first_reply_text
- first_reply_sender
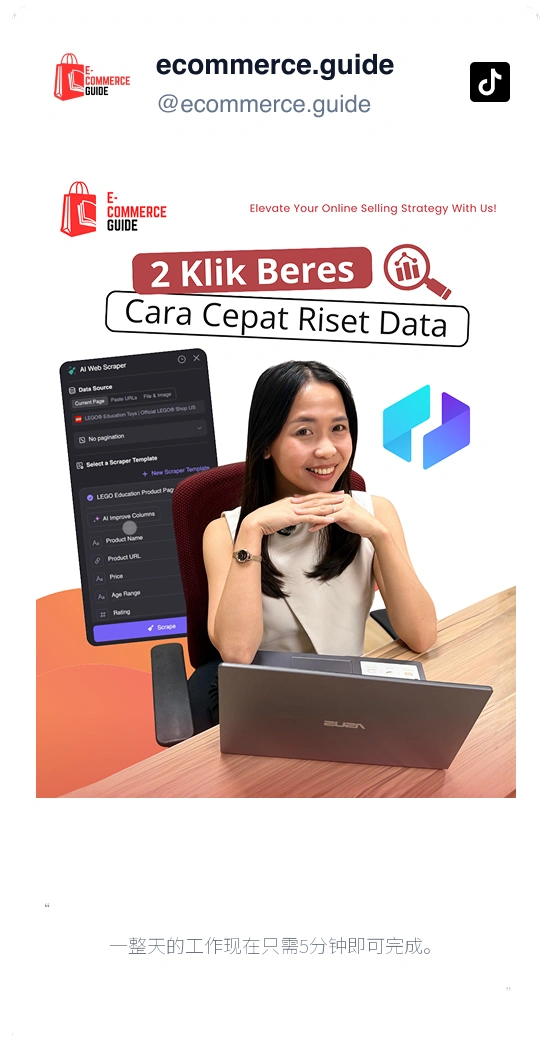
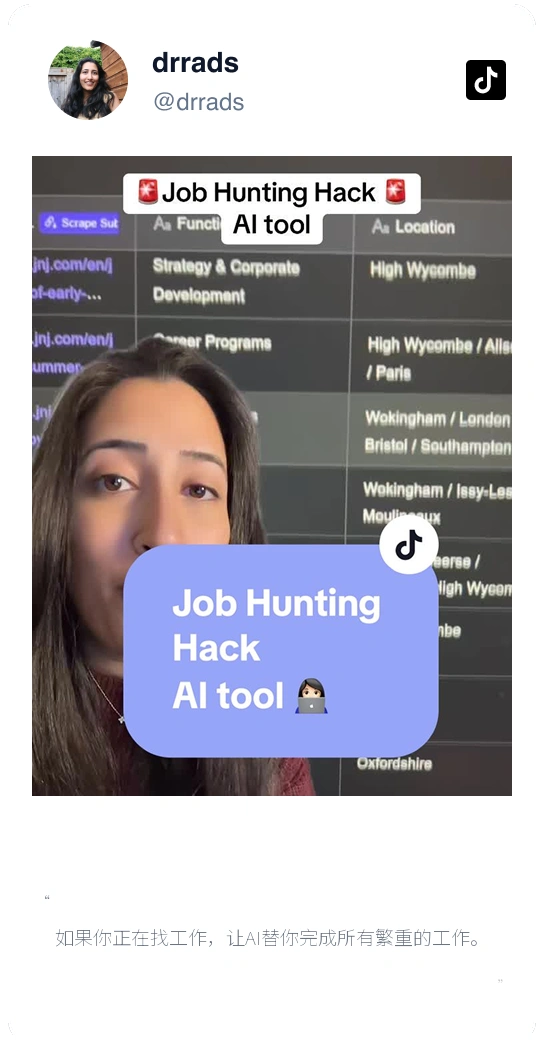
Hear users explain how they preserve page context
These Thunderbit videos show real projects where authors, dates, links, and surrounding details need to stay attached to the right row.
完整保留作者、时间和线程链接
适用于你可以打开的频道和线程。
Apply this to forums, support threads, and notes
Extract visible message lists from communities, help desks, and release‑note pages you can open in your session.
Flixster 爬虫
Thunderbit Flixster 爬虫可帮助你轻松提取 Flixster 的热门票房榜单和周边影院数据。借助 AI 智能字段推荐,快速收集电影名称、票房收入、评分、上映日期、影院名称、地址及在映影片,助力数据分析与研究。
了解更多 ->
olympustaff.com 爬虫
Thunderbit olympustaff.com 爬虫可帮助你从 olympustaff.com 上批量提取漫画列表和评论数据。借助 AI 智能字段推荐,快速获取漫画标题、作者、发布时间和读者评论,便于分析与研究。非常适合市场人员、研究者及内容创作者高效获取 olympustaff.com 的结构化数据。
了解更多 ->
Hatena 爬虫
Thunderbit Hatena 爬虫可帮助你通过 AI 智能字段推荐,从 Hatena 博客和话题列表中提取数据。支持采集博客标题、作者、发布时间、内容摘要及热门话题,适用于调研、营销或内容分析。非常适合需要结构化 Hatena 数据的市场人员、研究者和内容创作者。
了解更多 ->
namu.wiki 爬虫
Thunderbit namu.wiki 爬虫可帮助你从 namu.wiki 提取数据,包括所需页面和最新讨论。借助 AI 智能字段推荐,快速收集页面标题、网址、最后编辑时间、讨论主题及参与者姓名,助力学术研究、内容创作或社区分析。
了解更多 ->
网易云音乐爬虫
Thunderbit 网易云音乐爬虫可帮助你从网易云音乐的搜索结果和艺人作品页提取数据。借助 AI 智能字段推荐,快速获取歌曲名称、歌手、专辑详情、时长及歌曲链接,便于分析和研究。非常适合音乐分析师、市场人员及音乐爱好者高效获取结构化网易云音乐数据。
了解更多 ->
QQ 音乐爬虫
Thunderbit QQ 音乐爬虫可帮助你从 QQ 音乐搜索结果和歌手作品列表中提取数据。借助 AI 智能字段推荐,快速收集歌曲名称、歌手、专辑详情、发行时间等信息,便于分析和研究。非常适合音乐分析师、市场人员及音乐爱好者获取结构化 QQ 音乐数据。
了解更多 ->准备好大幅提升你的数据提取效率了吗?
加入已在使用 Thunderbit 自动化网页抓取流程的 200,000+ 专业人士。
免费试用可为 8 个网页提供无限额度。


