用于搜索结果和文章的百度爬虫








把百度搜索结果变成干净、好用的数据
将搜索结果和可获取的文章详情汇总到同一张清晰表格中。
在采集时就整理好百度数据
Thunderbit 会把可见的标题、URL、摘要、日期和来源整理到清晰的列中。若结果未展示某个字段,该单元格就保持空白。

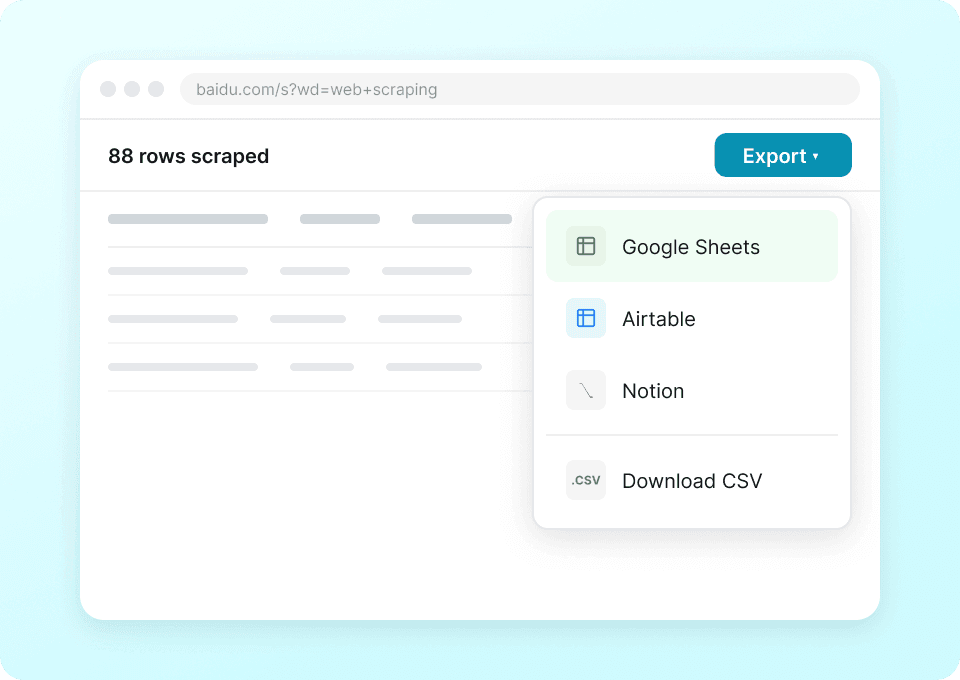
一键导出百度研究结果
每次运行都能直接发送到搜索结果审查表中。排名、来源、日期和链接页面详情会和对应的百度结果并排保存。
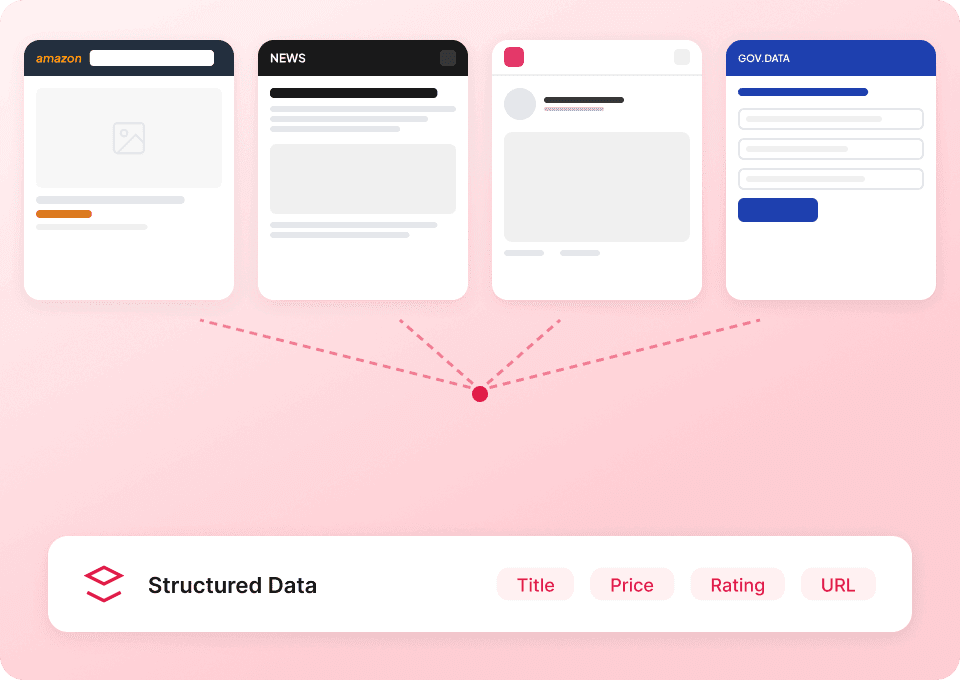
同一套流程适用于任何网站
Thunderbit 是按字段含义识别内容,而不是只适配百度某一种版式。只要是可访问的公开网站,当你的研究切换到新来源时,也可以沿用同样的方法。
保留每条百度结果的上下文信息
单纯保存链接清单会丢失上下文。Thunderbit 会把可见信息和每条结果放在一起。
复制链接和零散笔记
结果详情彼此分散结构化百度研究数据
可见上下文始终跟随每条结果你可以从百度提取哪些数据?
可从这些公开可见字段中选择。不同结果模块和关联页面并不会为每个搜索词展示全部字段。
- 搜索词
- 结果排名
- 结果标题
- 结果 URL
- 展示 URL
- 结果摘要
- 结果日期
- 结果站点图标
- 相关搜索词
- 拼写建议
- 拼音建议
- 搜索结果页码
- 来源站点
- 来源域名
- 文章作者
- 文章发布日期
- 文章摘要
- 文档名称
- 文档描述
- 文档面包屑
- 文档类型
- 文档文件格式
- 文档页数
- 文档上传时间
- 文档 URL
- 结果内容类型
- 图片缩略图
- 视频缩略图
- 地址
- 百度功能模块
See how researchers track Chinese search results
These user feedback videos show how people review Chinese search results, track sources, and check linked articles.
关于收集百度搜索数据的常见问题
可用字段会因搜索词、结果类型以及链接页面展示的信息而不同。
Continue from Baidu results to source-page research
Explore article and website scrapers when you need full page text or other details beyond the fields shown in Baidu results.
Flixster 爬虫
Thunderbit Flixster 爬虫可帮助你轻松提取 Flixster 的热门票房榜单和周边影院数据。借助 AI 智能字段推荐,快速收集电影名称、票房收入、评分、上映日期、影院名称、地址及在映影片,助力数据分析与研究。
了解更多 ->
olympustaff.com 爬虫
Thunderbit olympustaff.com 爬虫可帮助你从 olympustaff.com 上批量提取漫画列表和评论数据。借助 AI 智能字段推荐,快速获取漫画标题、作者、发布时间和读者评论,便于分析与研究。非常适合市场人员、研究者及内容创作者高效获取 olympustaff.com 的结构化数据。
了解更多 ->
Hatena 爬虫
Thunderbit Hatena 爬虫可帮助你通过 AI 智能字段推荐,从 Hatena 博客和话题列表中提取数据。支持采集博客标题、作者、发布时间、内容摘要及热门话题,适用于调研、营销或内容分析。非常适合需要结构化 Hatena 数据的市场人员、研究者和内容创作者。
了解更多 ->
namu.wiki 爬虫
Thunderbit namu.wiki 爬虫可帮助你从 namu.wiki 提取数据,包括所需页面和最新讨论。借助 AI 智能字段推荐,快速收集页面标题、网址、最后编辑时间、讨论主题及参与者姓名,助力学术研究、内容创作或社区分析。
了解更多 ->
网易云音乐爬虫
Thunderbit 网易云音乐爬虫可帮助你从网易云音乐的搜索结果和艺人作品页提取数据。借助 AI 智能字段推荐,快速获取歌曲名称、歌手、专辑详情、时长及歌曲链接,便于分析和研究。非常适合音乐分析师、市场人员及音乐爱好者高效获取结构化网易云音乐数据。
了解更多 ->
QQ 音乐爬虫
Thunderbit QQ 音乐爬虫可帮助你从 QQ 音乐搜索结果和歌手作品列表中提取数据。借助 AI 智能字段推荐,快速收集歌曲名称、歌手、专辑详情、发行时间等信息,便于分析和研究。非常适合音乐分析师、市场人员及音乐爱好者获取结构化 QQ 音乐数据。
了解更多 ->准备好大幅提升你的数据提取效率了吗?
加入已在使用 Thunderbit 自动化网页抓取流程的 200,000+ 专业人士。
免费试用可为 8 个网页提供无限额度。



