用于提取文本、作者和日期的文章爬虫








在不断变化的页面版式中采集文章数据
按语义读取字段、设置定时重复运行,并在各类公开网站上复用同一套流程。
文章版式变化也能灵活应对
Thunderbit 会根据语义读取可见的标题、导语、日期、摘要和文章正文。当新闻网站调整页面版式时,这个流程对固定位置的依赖会更小。
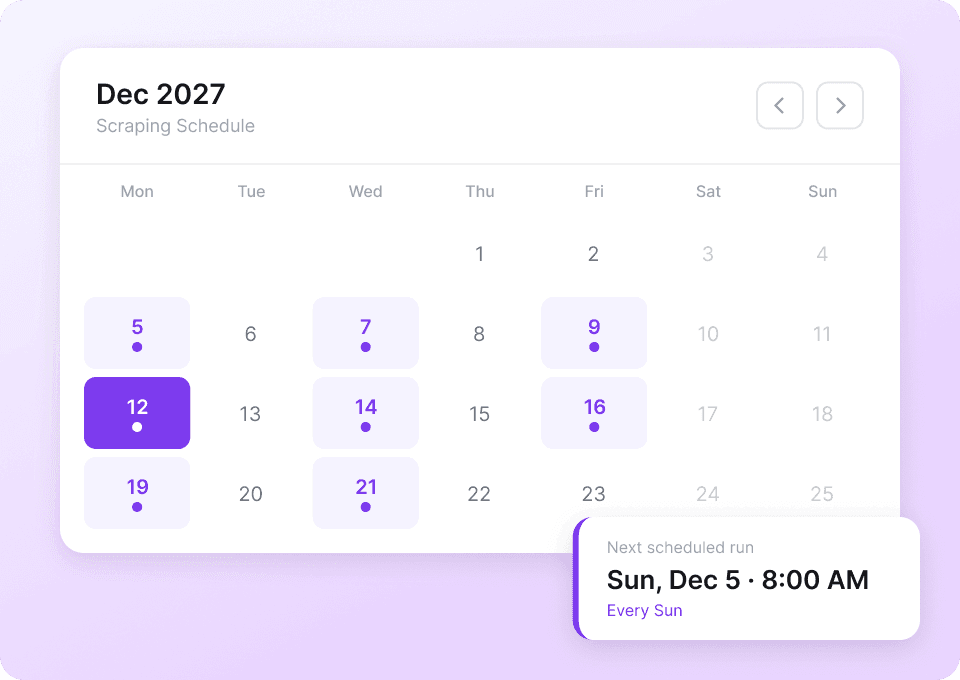
按计划运行文章爬取任务
如果你会反复查看某个公开的新闻页、博客页或栏目页,可以设置重复运行。Thunderbit 能采集最新可见文章,并把新行发送到你选择的文件或应用中。
一套流程适用于任何公开网站
同一套工作流可以用于任何带文章内容的公开网站。只需命名你需要的字段,Thunderbit 就会把每个页面放进相同的列中。
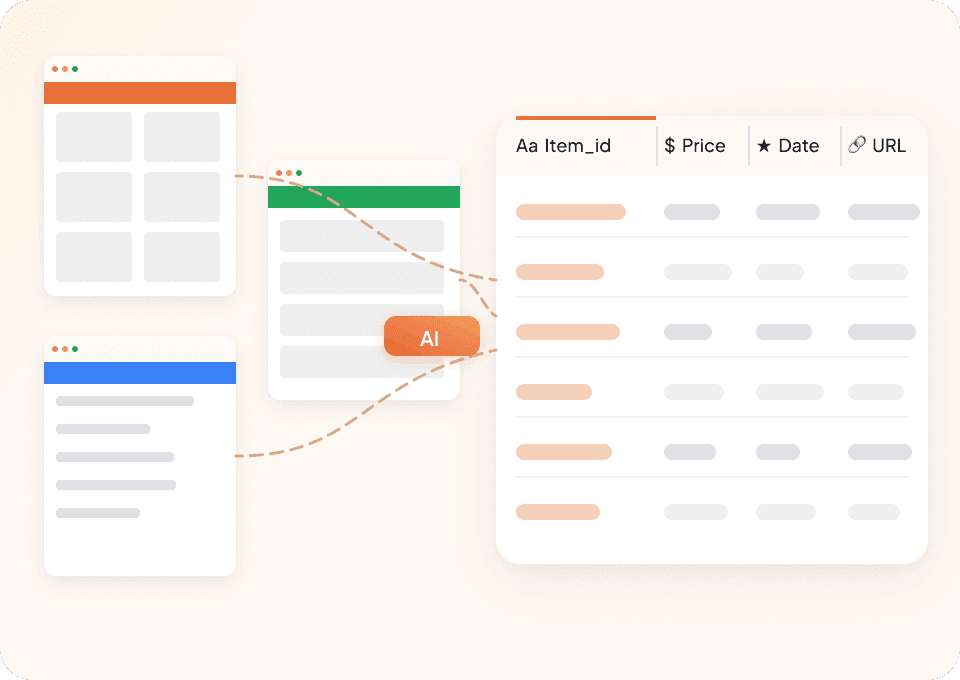
一套文章流程,适配不同页面版式
固定选择器依赖位置。Thunderbit AI 会按你指定的文章字段去识别内容。
为每个发布者单独维护选择器映射
每一种页面设计都要单独维护由 Thunderbit 整理文章字段
所需记录始终保持一致你可以从文章中提取哪些数据?
从 30 个可见的内容、作者、发布者、日期、链接、主题、媒体和页面元数据字段中自由选择。
- 标题
- 替代标题
- 文章正文
- 文章摘要
- 作者姓名
- 作者 URL
- 作者机构
- 发布者名称
- 发布者 URL
- 发布日期
- 修改日期
- 文章栏目
- 关键词
- 字数
- 语言
- 规范 URL
- 主要实体 URL
- 图片 URL
- 图片说明
- 图片署名
- 视频 URL
- 音频 URL
- 日期行
- 关于主题
- 提及内容
- 引用链接
- 许可 URL
- 相关文章链接
- 页面标题
- Meta 描述
Hear editors and research teams discuss article data
In these user videos, editors and researchers gather article text, bylines, dates, and source links for review.
关于抓取公开文章的问题
新闻网站的版式和页面细节各不相同,因此最终能拿到哪些字段,取决于你抓取的具体文章页面。
Continue from articles to the pages around them
Explore news, author, and publisher scrapers when your research also needs indexes, profiles, or related stories.

4PDA 爬虫
Thunderbit 4PDA 爬虫借助 AI 技术,帮助你高效提取 4PDA 新闻文章和论坛帖子的各类数据。无论是文章标题、发布时间、作者信息,还是帖子内容,都能一键获取,便于科研、分析或追踪科技讨论。非常适合科技爱好者、研究人员和市场人员获取结构化的 4PDA 数据。
了解更多 ->
Ptt 爬虫
Thunderbit Ptt 爬虫借助 AI 智能字段推荐,帮助你高效提取 Ptt 看板和帖子数据。无论是看板名称、链接、热度,还是帖子标题、作者、评论内容,都能一键获取。无论你是市场营销人员、研究者还是内容创作者,都能轻松获得结构化的 Ptt 数据,助力数据分析与内容创作。
了解更多 ->
Pizza Marketplace 爬虫
Thunderbit 的 Pizza Marketplace 爬虫可帮助你轻松提取 Pizza Marketplace 新闻列表和供应商目录中的数据。借助 AI 智能字段推荐,快速收集新闻标题、发布时间、作者、供应商名称、地址及联系方式,助力调研、营销或数据分析。
了解更多 ->
Failory 爬虫
Thunderbit Failory 爬虫可帮助你从 Failory 的 Startup Cemetery 和新闻文章中提取结构化数据。借助 AI 智能字段推荐,轻松收集创业公司名称、年份、失败原因、文章标题、作者等信息,适用于创业者、投资人和研究人员深入分析 Failory 数据。
了解更多 ->
Investing.com 爬虫
只需 2 次点击,即可从 Investing.com 提取股票数据——包括股票代码、价格、成交量和市值——并直接导出到 Google Sheets、Notion 或 Excel。打开任意 Investing.com 页面,让 AI 自动识别字段。
了解更多 ->
Substack 爬虫
只需 2 次点击,即可抓取 Substack 的订阅人数、文章标题和发布简介,并导出到 Excel、Google Sheets 或 Notion。无需编写代码,Thunderbit 的 AI 会自动帮你整理好数据结构。
了解更多 ->准备好大幅提升你的数据提取效率了吗?
加入已在使用 Thunderbit 自动化网页抓取流程的 200,000+ 专业人士。
免费试用可为 8 个网页提供无限额度。



