
Năm 2026 rồi, nếu bạn làm sales, vận hành hay bất kỳ công việc kinh doanh nào, chắc hẳn bạn cũng nhận ra rằng web vừa là “trợ thủ đắc lực” vừa là “ổ nuốt thời gian” lớn nhất. Trên mạng có nhiều thông tin giá trị hơn bao giờ hết — từ khách hàng tiềm năng, giá bán, đánh giá cho đến động thái của đối thủ — nhưng đưa được những dữ liệu đó vào spreadsheet hay dashboard mới là phần đáng nói. Tôi đã thấy nhiều đội ngũ dành hàng giờ copy-paste, rồi cuối cùng vẫn chỉ có dữ liệu lộn xộn, lỗi thời và một cảm giác kiệt sức vì bảng tính.
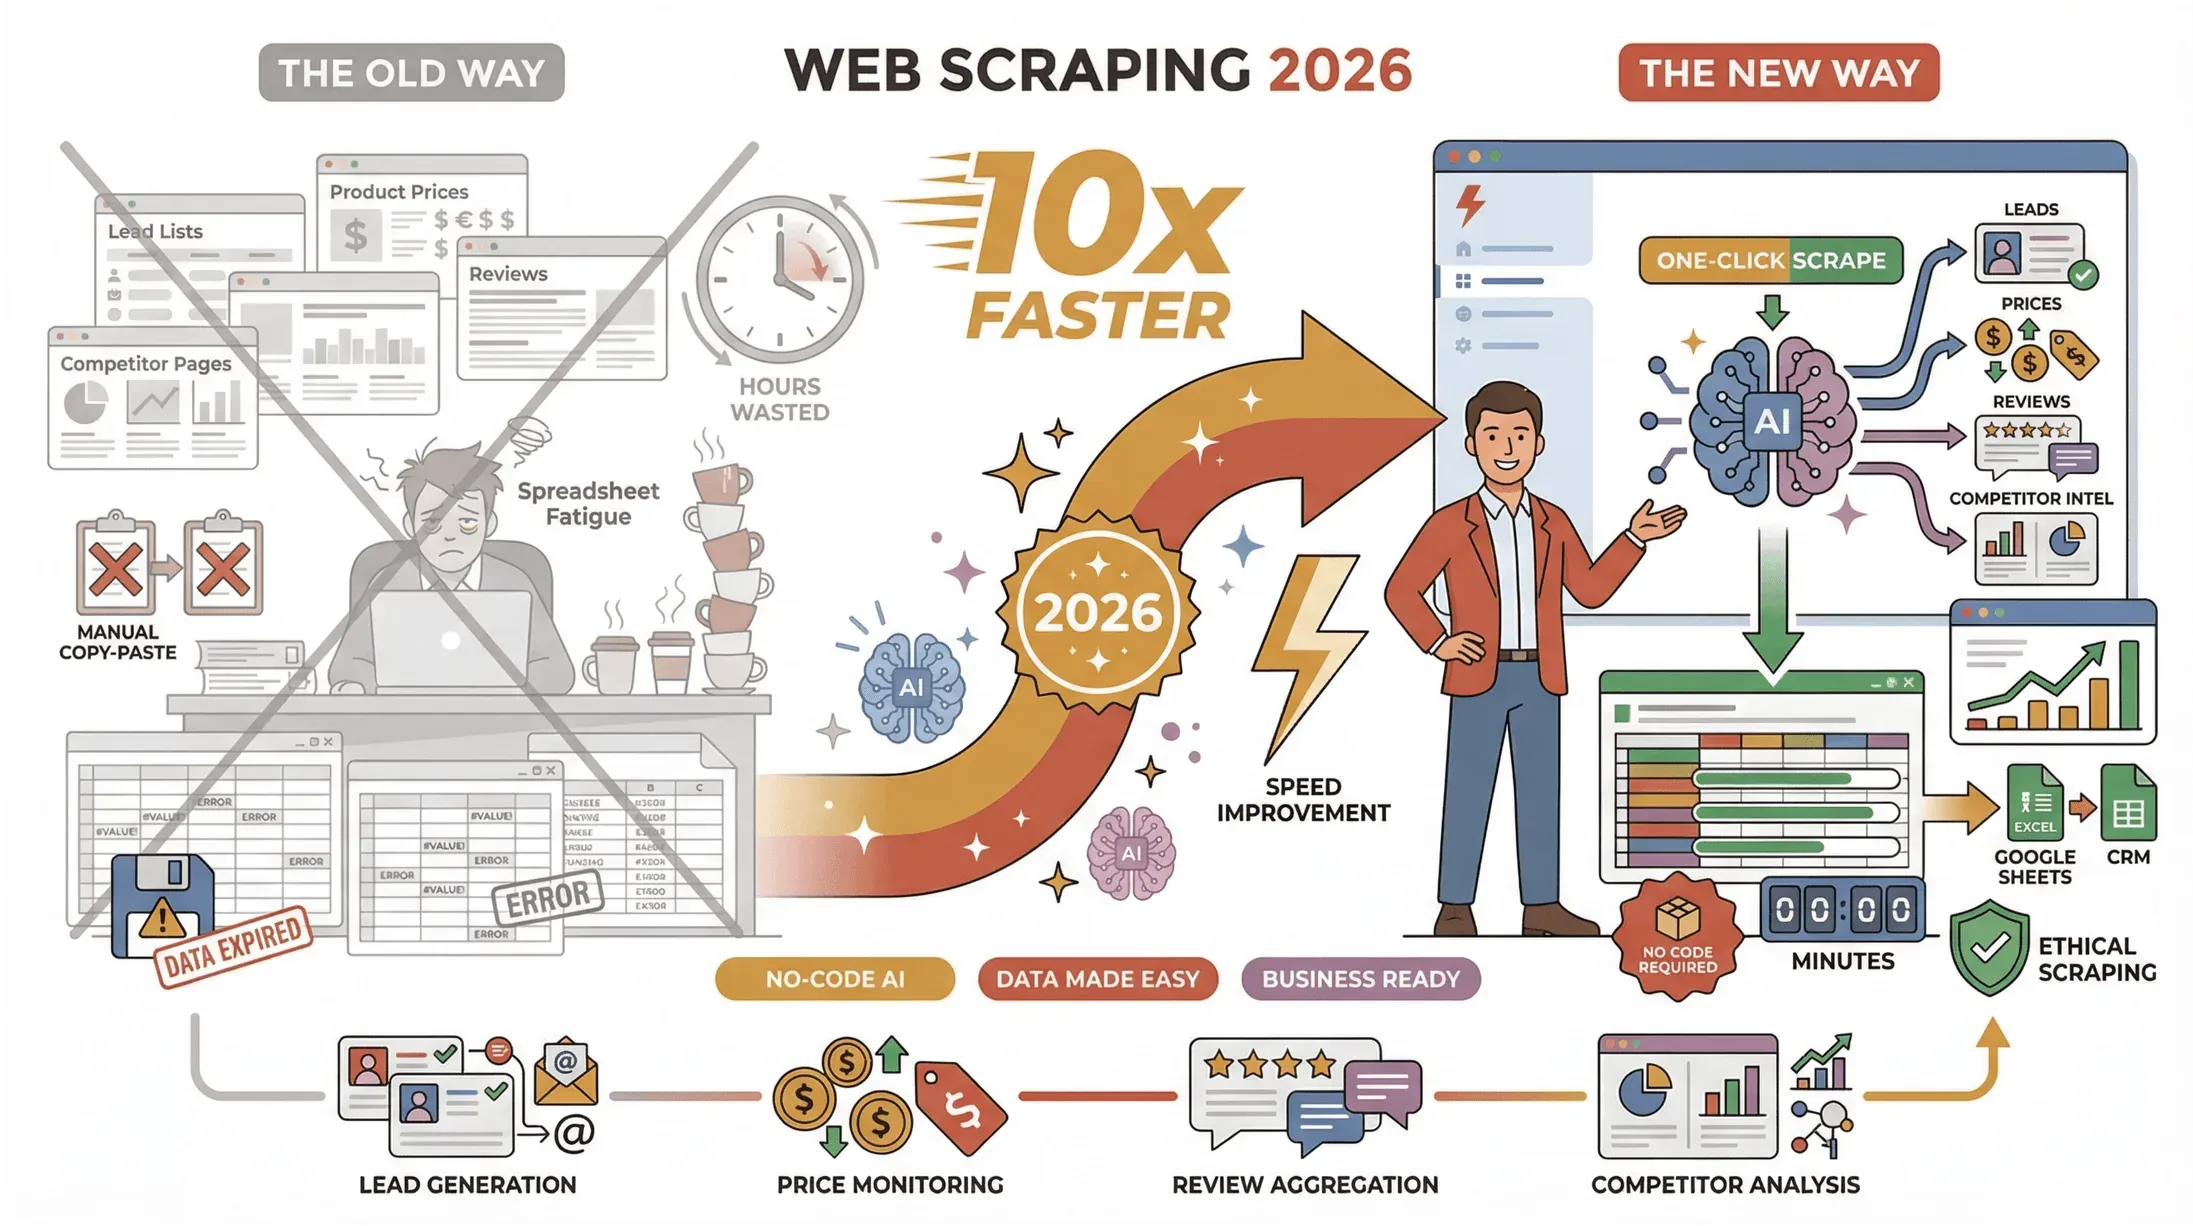
Tin vui là: trích xuất nội dung từ website khác không nhất thiết phải là việc nặng nhọc dành riêng cho lập trình viên hay data scientist. Nhờ sự xuất hiện của các công cụ AI không cần code như Thunderbit, ngay cả người không rành kỹ thuật cũng có thể lấy dữ liệu mình cần — nhanh, chính xác và không rườm rà. Trong hướng dẫn này, tôi sẽ giải thích web scraping thực sự là gì, vì sao nó trở nên thiết yếu với doanh nghiệp hiện đại, và cách bạn có thể bắt đầu trích xuất nội dung từ website một cách hiệu quả (và hợp pháp) trong năm 2026. Dù bạn là người mới hoàn toàn hay chỉ đang muốn nâng cấp quy trình làm việc, bài viết này dành cho bạn.
“Trích xuất nội dung từ website khác” nghĩa là gì?
Hiểu đơn giản: trích xuất nội dung từ website khác là việc dùng phần mềm để tự động lấy thông tin từ các trang web rồi sắp xếp chúng thành định dạng có cấu trúc — như bảng, spreadsheet hoặc cơ sở dữ liệu. Thay vì phải tự tay copy và paste thông tin sản phẩm, dữ liệu liên hệ hay đánh giá, một công cụ scraper sẽ làm phần việc nặng nhọc đó cho bạn (ParseHub).
Hãy tưởng tượng thế này: bạn đang ở thư viện, và thay vì phải ghi chép thủ công từ từng cuốn sách, bạn có một trợ lý robot quét qua các trang rồi đưa cho bạn bản tóm tắt gọn gàng, được sắp xếp ngăn nắp. Web scraping trên internet cũng hoạt động tương tự như vậy.
Vì sao mọi người lại trích xuất nội dung từ website?
- Tìm kiếm khách hàng tiềm năng: Lấy tên, email, số điện thoại từ danh bạ hoặc danh sách doanh nghiệp.
- Phân tích đối thủ: Theo dõi giá bán, sản phẩm mới hoặc đánh giá trên các trang ecommerce.
- Nghiên cứu thị trường: Gom tin tức, bài blog hoặc thảo luận trên forum để nhận diện xu hướng.
- Tổng hợp nội dung: Thu thập bài viết hoặc tài nguyên cho bản tin nội bộ hay kho tri thức.
Sự khác biệt giữa copy-paste thủ công và scraping tự động là một trời một vực: scraping nhanh hơn, chính xác hơn và có thể xử lý hàng nghìn trang chỉ trong vài phút (Outscraper).
Vì sao trích xuất nội dung từ website khác lại quan trọng với người dùng doanh nghiệp
Data Scraping là gì và cách thực hiện trong năm 2026 Get Started Free
Nếu bạn vẫn đang dựa vào nghiên cứu thủ công, bạn đang bỏ lỡ tốc độ và sức mạnh phân tích mà các đội ngũ hiện đại đang dùng để đi trước một bước. Các công ty dựa trên dữ liệu đang tăng năng suất gần 63%, và năm 2026 — chính là năm nay — được các nhà phân tích xem là cột mốc để 65% tổ chức vận hành hoàn toàn theo hướng data-driven.
Đây là cách việc trích xuất nội dung từ website khác tạo ra giá trị kinh doanh thực tế:
| Trường hợp sử dụng | Nên trích xuất gì | Lợi ích |
|---|---|---|
| Tìm kiếm khách hàng tiềm năng | Danh bạ doanh nghiệp, LinkedIn, Yellow Pages | Xây dựng danh sách khách hàng mục tiêu, lấp đầy pipeline nhanh hơn |
| Theo dõi giá | Danh sách sản phẩm của đối thủ, trang ecommerce | Điều chỉnh chiến lược giá theo thời gian thực |
| Hiểu khách hàng | Đánh giá, bài đăng mạng xã hội, forum | Phân tích phản hồi, phát hiện xu hướng, cải thiện sản phẩm |
| Tổng hợp nội dung | Trang tin, blog, forum ngành | Biên tập tin tức ngành, nuôi dưỡng marketing nội dung |
Khi tự động hóa các việc này, bạn không chỉ tiết kiệm thời gian — bạn còn ra quyết định tốt hơn, nhanh hơn và giải phóng đội ngũ để tập trung vào những việc thực sự quan trọng (Ujeebu).
Cách chọn đúng công cụ web scraping: Hướng dẫn cho người mới
Nếu bạn mới bắt đầu trích xuất nội dung từ website khác, quyết định lớn đầu tiên là chọn đúng công cụ. Những gì tôi rút ra được (thường là từ trải nghiệm không mấy dễ chịu) là: lựa chọn của bạn nên phụ thuộc vào mức độ thoải mái với kỹ thuật, độ phức tạp của website mục tiêu và tốc độ bạn muốn có kết quả.
Các loại công cụ web scraping phổ biến:
- Công cụ dựa trên code (ví dụ: Python với BeautifulSoup hoặc Scrapy): Linh hoạt tối đa, nhưng bạn phải biết lập trình. Phù hợp với developer hoặc đội ngũ có hỗ trợ IT.
- Công cụ no-code (ví dụ: ParseHub, Octoparse): Giao diện trực quan, có template và quy trình point-and-click. Rất hợp với người không biết code, nhưng có thể trở nên phức tạp trên các website khó.
- Tiện ích mở rộng trình duyệt (ví dụ: Thunderbit, Web Scraper): Chạy trực tiếp trên Chrome, dễ cài đặt và lý tưởng cho các tác vụ nhanh, có mục tiêu rõ ràng.
Với hầu hết người dùng doanh nghiệp — đặc biệt là người mới — sự dễ dùng là yếu tố quan trọng nhất. Đó là lý do tôi khuyên bạn nên bắt đầu bằng một tiện ích mở rộng trình duyệt như Thunderbit. Công cụ này được thiết kế cho người không chuyên kỹ thuật và tận dụng AI để việc cài đặt trở nên cực kỳ đơn giản.
So sánh các công cụ web scraping phổ biến
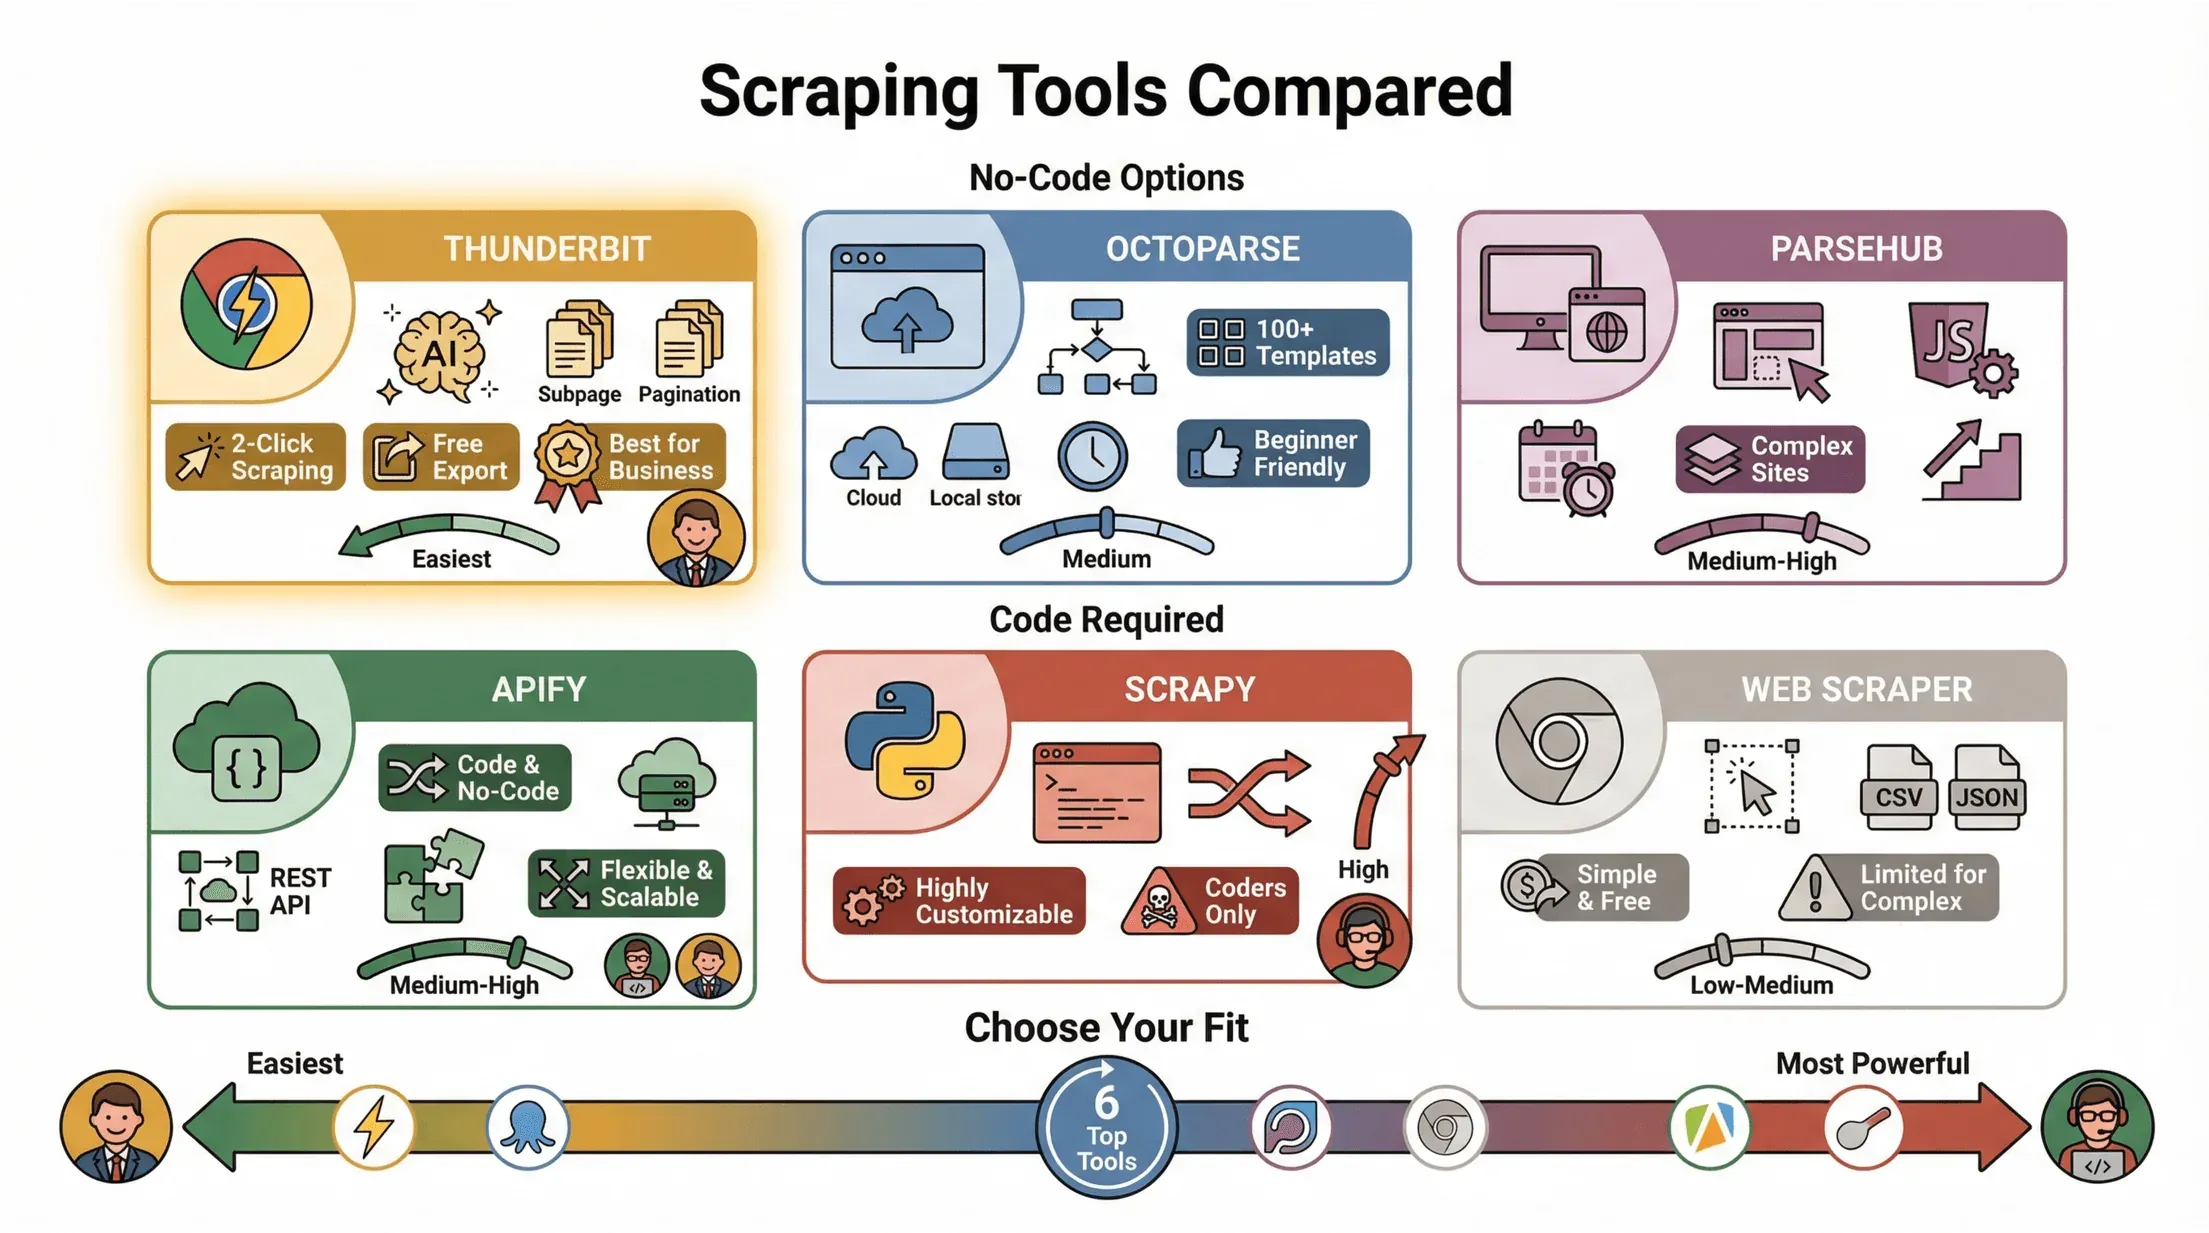
Hãy xem một số công cụ hàng đầu hoạt động thế nào khi trích xuất nội dung từ website khác:
| Công cụ | Loại | Tính năng nổi bật | Ưu / nhược điểm |
|---|---|---|---|
| Thunderbit | Tiện ích Chrome, AI | Scraping 2 cú nhấp, gợi ý trường bằng AI, subpage & pagination, xuất miễn phí | Cực dễ dùng, không cần code, hợp nhất cho người dùng doanh nghiệp |
| Octoparse | Ứng dụng desktop, no-code | Quy trình trực quan, hơn 100 template, cloud/local, lập lịch | Thân thiện với người mới, nhưng gói miễn phí còn hạn chế |
| ParseHub | Desktop/Web, no-code | Trình dựng trực quan, xử lý trang động/JS nặng, lập lịch | Tốt cho site phức tạp, nhưng học khó hơn |
| Apify | Cloud/Code/no-code | Có code & no-code, serverless, REST API, tích hợp | Linh hoạt, mở rộng tốt, cần chút kỹ năng kỹ thuật |
| Scrapy | Thư viện Python, code | Crawl bất đồng bộ, tùy biến rất cao | Mạnh, nhưng chỉ dành cho người biết code |
| Web Scraper | Tiện ích Chrome, no-code | Chọn dữ liệu bằng trực quan, xuất CSV/JSON | Đơn giản, miễn phí, nhưng hạn chế với site phức tạp |
Với đa số người dùng doanh nghiệp, Thunderbit và Octoparse là hai lựa chọn dễ bắt đầu nhất (ScrapingLab).
Ưu điểm nổi bật của Thunderbit khi trích xuất nội dung từ website khác
Cách trích xuất dữ liệu từ bất kỳ website nào bằng AI Get Started Free
Giờ cho phép tôi “đội mũ Thunderbit” một chút (à, chính xác hơn là mặc một chiếc hoodie kỹ thuật số): điều khiến Thunderbit nổi bật là nó cực kỳ thân thiện với người mới và người dùng doanh nghiệp.
Điều làm Thunderbit khác biệt:
- Giao diện ngôn ngữ tự nhiên: Chỉ cần mô tả bạn muốn gì (“Lấy tất cả đánh giá và xếp hạng sản phẩm trên trang này”), AI của Thunderbit sẽ xử lý phần còn lại.
- AI Suggest Fields & Improve Fields: Thunderbit quét trang và đề xuất những cột nên trích xuất — tên, giá, email, bất kỳ thứ gì bạn cần. Không phải vật lộn với selector hay code.
- Quy trình 2 cú nhấp: Nhấn “AI Suggest Fields”, rồi nhấn “Scrape”. Xong. Ngay cả mẹ tôi cũng làm được (và bà vẫn nghĩ “đám mây” chỉ là thời tiết xấu).
- Hỗ trợ subpage và pagination: Thunderbit có thể lần theo các liên kết sang trang chi tiết (như từng bài đánh giá sản phẩm) và tự động xử lý nhiều trang.
- Xuất dữ liệu tức thì: Đẩy dữ liệu thẳng sang Excel, Google Sheets, Airtable hoặc Notion — không thêm bước nào, không tốn thêm phí.
Ví dụ: Giả sử bạn muốn lấy đánh giá sản phẩm từ một trang ecommerce. Mở trang đánh giá, nhấp biểu tượng Thunderbit, bấm “AI Suggest Fields”, và Thunderbit sẽ đề xuất các cột như “Reviewer Name”, “Rating” và “Review Text”. Nhấn “Scrape” là xong. Cần thêm chi tiết từ từng đánh giá? Hãy dùng subpage scraping để lấy hết.
Trên Trustpilot, người dùng thường nhắc đến cùng hai điểm: Thunderbit “xử lý các trang dài tốt hơn tôi nghĩ” và “làm cho việc scraping các site động trở nên cực kỳ dễ dàng” (Trustpilot, đánh giá tháng 1/2026).
Dùng thử Thunderbit miễn phí để web scraping chỉ với 2 cú nhấp
Trích xuất nội dung từ website phức tạp: Pagination và subpage scraping
Nói thật nhé: không phải website nào cũng dễ dàng cho bạn lấy dữ liệu. Các nền tảng ecommerce, danh bạ và trang đánh giá thường dùng pagination (nhiều trang danh sách) hoặc subpage lồng nhau (nhấp vào từng sản phẩm hay doanh nghiệp để xem thêm chi tiết).
Thách thức: Các công cụ scraping truyền thống thường bỏ sót dữ liệu ẩn sau nút “Next” hoặc nằm trong các subpage. Còn làm thủ công? Quên đi — bạn sẽ phải nhấp liên tục cả ngày.
Giải pháp của Thunderbit: AI sẽ phát hiện liên kết phân trang hoặc cuộn vô hạn và tiếp tục scraping cho đến khi thu thập đủ mọi thứ. Với subpage, Thunderbit có thể đi vào từng liên kết trong bảng của bạn (như từng sản phẩm hoặc từng doanh nghiệp), lấy thêm trường dữ liệu và gộp vào dataset chính.
Hướng dẫn từng bước: Trích xuất nội dung nhiều trang và subpage
Đây là cách xử lý một website phức tạp bằng Thunderbit:
- Mở trang danh sách chính (ví dụ: danh mục ecommerce hoặc danh bạ).
- Nhấp biểu tượng Thunderbit và chọn “AI Suggest Fields.” Thunderbit sẽ đề xuất các cột như “Product Name”, “Price”, “Link.”
- Nhấp “Scrape.” Thunderbit sẽ trích xuất tất cả mục trên trang hiện tại — và tự động theo phân trang để lấy phần còn lại.
- Cần thêm chi tiết? Nhấp “Scrape Subpages.” Thunderbit sẽ ghé vào trang chi tiết của từng mục và lấy thêm thông tin (như đánh giá, thông số kỹ thuật hoặc thông tin liên hệ).
- Rà soát và xuất bộ dữ liệu hoàn chỉnh, đã được làm giàu.
Mẹo: Hãy dùng subpage scraping khi bạn thấy các liên kết như “details”, “reviews” hoặc “contact” — cực kỳ phù hợp với ecommerce, yellow pages hoặc danh sách bất động sản.
Sắp xếp và phân tích dữ liệu đã trích xuất: Tags, danh mục và tùy chọn xuất
Trích xuất nội dung chỉ là bước đầu. Để tạo ra giá trị thực sự, bạn cần tổ chức, phân tích và chia sẻ dữ liệu.
Thunderbit giúp việc này rất dễ:
- Gắn tag và phân loại: Thêm tag hoặc danh mục cho các trường dữ liệu của bạn (ví dụ: “Product Type”, “Region”, “Lead Status”) để sau này có thể lọc và phân tích.
- Field AI Prompts: Bạn muốn phân loại SKU hoặc dịch đánh giá? Chỉ cần thêm hướng dẫn tùy chỉnh cho trường đó, AI của Thunderbit sẽ xử lý ngay trong lúc scraping.
- Tùy chọn xuất: Gửi dữ liệu ngay sang Excel, Google Sheets, Airtable hoặc Notion. Bạn cũng có thể tải xuống dạng CSV hoặc JSON để phân tích sâu hơn.
Thực hành tốt khi tổ chức dữ liệu:
- Dùng tên cột rõ ràng, nhất quán.
- Thêm tag hoặc danh mục để lọc dễ hơn.
- Lưu trữ dữ liệu gốc song song với dataset đã làm sạch.
- Thiết lập xuất định kỳ hoặc scraping theo lịch cho các dự án dài hạn.
Đội sales có thể gắn nhãn khách hàng tiềm năng theo nguồn hoặc trạng thái, còn đội vận hành có thể phân loại sản phẩm theo nhà cung cấp hoặc khu vực. Mục tiêu là biến dữ liệu đã trích xuất thành thứ có thể hành động được và dễ chia sẻ.
Tuân thủ quy định: Những lưu ý pháp lý khi trích xuất nội dung từ website khác
Trước khi bạn “quét” cả thế giới web, hãy nói về compliance. Tin tốt là: scraping dữ liệu công khai thường là hợp pháp nếu bạn tuân thủ vài nguyên tắc cơ bản (Iubenda, ScraperAPI).
Mẹo tuân thủ quan trọng:
- Chỉ scraping nội dung công khai. Không vượt qua đăng nhập, paywall hay các biện pháp bảo vệ.
- Tôn trọng robots.txt và Điều khoản dịch vụ. Dù không phải lúc nào cũng ràng buộc pháp lý, chúng thể hiện mong muốn của chủ website.
- Tránh scraping dữ liệu có bản quyền hoặc dữ liệu cá nhân. Hãy tập trung vào thông tin thực tế như tên, giá, thông số; không tái xuất bản khối lớn văn bản hay hình ảnh có bản quyền.
- Ghi nguồn nếu bạn dùng dữ liệu đã trích xuất trong báo cáo hoặc ấn phẩm.
- Giảm tốc độ request để tránh gây quá tải cho website.
Checklist scraping an toàn:
- ✅ Chỉ trang công khai (không đăng nhập)
- ✅ Kiểm tra robots.txt và TOS
- ✅ Không dữ liệu có bản quyền hoặc dữ liệu cá nhân
- ✅ Ghi nguồn
- ✅ Không scrape quá nhanh
Thunderbit khuyến khích scraping có trách nhiệm bằng cách giúp bạn dễ dàng chỉ nhắm đến dữ liệu cần thiết và xuất ra cho mục đích sử dụng nội bộ.
Hướng dẫn từng bước: Trích xuất nội dung từ website khác bằng Thunderbit
Sẵn sàng thử chưa? Đây là cách trích xuất nội dung từ website khác bằng Thunderbit:
- Cài đặt Thunderbit Chrome Extension: Tải tại đây và đăng ký tài khoản miễn phí.
- Mở website mục tiêu: Đi tới trang bạn muốn trích xuất (ví dụ: danh sách sản phẩm, danh bạ doanh nghiệp, trang đánh giá).
- Nhấp biểu tượng Thunderbit: Trên thanh công cụ Chrome, nhấp Thunderbit để mở tiện ích.
- Dùng “AI Suggest Fields”: Thunderbit quét trang và gợi ý các cột nên lấy (như “Name”, “Price”, “Email”).
- Điều chỉnh cột nếu cần: Đổi tên, thêm hoặc xóa trường theo ý bạn. Bạn cũng có thể thêm prompt AI tùy chỉnh để gắn nhãn hoặc phân loại.
- Nhấp “Scrape”: Thunderbit sẽ trích xuất dữ liệu từ trang hiện tại — và theo phân trang nếu có.
- Scrape subpages (tùy chọn): Nếu cần thêm chi tiết, nhấp “Scrape Subpages” để lấy dữ liệu từ các trang được liên kết.
- Rà soát và xuất: Xem trước dữ liệu, sau đó xuất sang Excel, Google Sheets, Airtable, Notion hoặc tải CSV/JSON.
Khắc phục các vấn đề thường gặp:
- Trang yêu cầu đăng nhập: Dùng chế độ Browser Scraping của Thunderbit khi đã đăng nhập.
- Website chặn hoặc chạy chậm: Hãy thử scraping vào thời điểm ít tải, hoặc chia nhỏ tác vụ thành nhiều đợt.
- Nội dung động không tải: Cuộn hết trang trước khi scraping, hoặc dùng chế độ browser của Thunderbit.
- Layout thay đổi: Chạy lại “AI Suggest Fields” để AI thích ứng với cấu trúc trang mới.
Nếu gặp khó khăn, tài liệu documentation và đội ngũ hỗ trợ của Thunderbit luôn sẵn sàng giúp bạn.
Bắt đầu trích xuất nội dung với Thunderbit
Kết luận & điểm chính cần nhớ
Trích xuất nội dung từ website khác đã chuyển từ “vũ khí bí mật của lập trình viên” thành nhu cầu thiết yếu trong công việc kinh doanh hằng ngày. Bước vào giữa năm 2026, khi dữ liệu web tăng nhanh hơn tốc độ bất kỳ đội ngũ nào có thể đọc, và các công cụ no-code tích hợp AI ngày càng trưởng thành ở mọi mặt, bất kỳ ai cũng có thể lấy thông tin mình cần — nhanh, chính xác và không đau đầu.
Điều cần nhớ:
- Trích xuất nội dung từ website khác là điều thiết yếu cho tìm khách hàng tiềm năng, nghiên cứu thị trường và giữ lợi thế cạnh tranh.
- Các công cụ hiện đại như Thunderbit giúp web scraping dễ tiếp cận với mọi người, nhờ prompt ngôn ngữ tự nhiên, gợi ý trường bằng AI và xuất dữ liệu tức thì.
- Thunderbit hỗ trợ pagination, subpage scraping và tổ chức dữ liệu, nên bạn có thể xử lý cả những website phức tạp nhất.
- Hãy tuân thủ quy định: chỉ scraping dữ liệu công khai, tôn trọng quy tắc của website và tránh nội dung có bản quyền hoặc dữ liệu cá nhân.
- Bắt đầu đơn giản như cài một tiện ích Chrome và nhấp vài nút là đủ.
Sẵn sàng nói lời tạm biệt với copy-paste chưa? Dùng thử Thunderbit miễn phí và xem bạn tiết kiệm được bao nhiêu thời gian (và cả sự tỉnh táo) trong dự án dữ liệu web tiếp theo. Để xem thêm mẹo và hướng dẫn, hãy ghé Thunderbit Blog.
Dùng thử AI Web Scraper để trích xuất nội dung dễ dàng Get Started Free
Câu hỏi thường gặp
1. Trích xuất nội dung từ website khác có hợp pháp không?
Nhìn chung là có — nếu bạn chỉ dùng dữ liệu công khai, tôn trọng robots.txt và Điều khoản dịch vụ, đồng thời tránh trích xuất thông tin có bản quyền hoặc dữ liệu cá nhân. Luôn kiểm tra quy định của từng website và sử dụng dữ liệu đã trích xuất một cách có trách nhiệm (Iubenda).
2. Tôi có cần biết code để trích xuất nội dung từ website không?
Không cần! Các công cụ như Thunderbit được thiết kế cho người không chuyên kỹ thuật. Bạn có thể lấy dữ liệu chỉ với vài cú nhấp, nhờ prompt ngôn ngữ tự nhiên và gợi ý trường bằng AI.
3. Tôi có thể scraping những loại website nào bằng Thunderbit?
Thunderbit hoạt động trên rất nhiều loại site — ecommerce, danh bạ, nền tảng đánh giá, danh sách bất động sản, v.v. Trong đa số trường hợp, nó xử lý tốt pagination, subpage và cả nội dung động.
4. Tôi nên tổ chức và phân tích dữ liệu đã trích xuất như thế nào?
Thunderbit cho phép bạn gắn tag, phân loại và đặt nhãn cho dữ liệu ngay khi trích xuất. Bạn có thể xuất thẳng sang Excel, Google Sheets, Airtable hoặc Notion để phân tích và chia sẻ tiếp.
5. Tôi nên làm gì nếu website chặn scraper hoặc thay đổi bố cục?
Hãy thử giảm tốc độ scraping, dùng chế độ Browser Scraping của Thunderbit, hoặc chạy lại “AI Suggest Fields” để thích ứng với layout mới. Nếu vẫn gặp vấn đề, hãy xem documentation hoặc liên hệ đội hỗ trợ Thunderbit để được giúp đỡ.
Chúc bạn scraping vui vẻ — và mong rằng bảng tính của bạn luôn sạch sẽ, có cấu trúc và sẵn sàng để hành động.
Tìm hiểu thêm



