
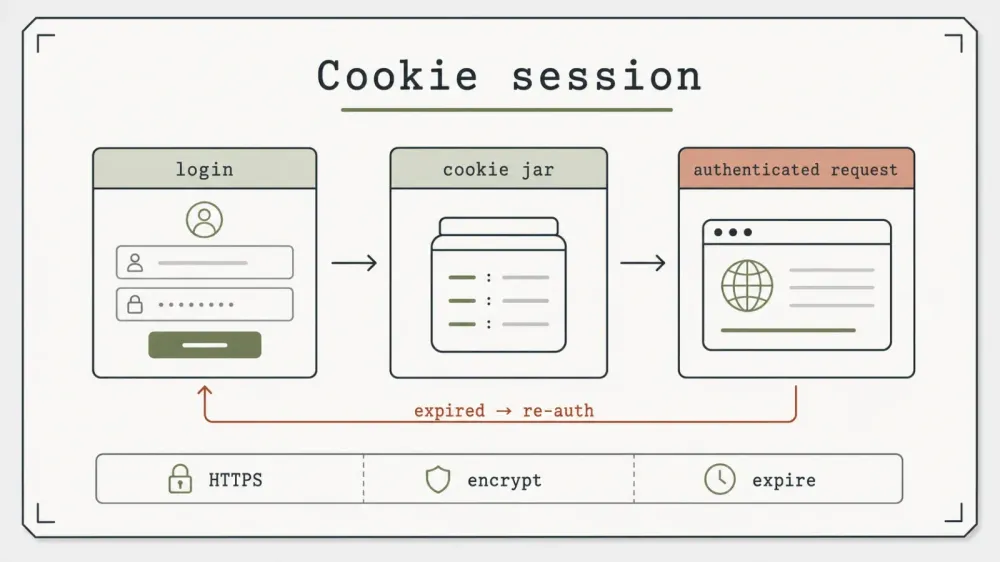
Có một cảm giác rất “đã” khi nhìn một web scraper lướt qua hàng loạt trang, thu thập dữ liệu mà nếu làm thủ công bạn sẽ mất hàng giờ, thậm chí hàng ngày. Nhưng nếu bạn từng thấy một lần scrape đang chạy bỗng thất bại—có thể vì bị đăng xuất, hoặc bị chặn truy cập một cách khó hiểu—thì rất có thể bạn đã va vào những “người gác cổng” vô hình của web hiện đại: cookie. Trong nhiều năm xây dựng công cụ tự động hóa và làm việc với các đội sales, ecommerce và research, tôi đã thấy cookie có thể quyết định thành bại của cả một dự án dữ liệu. Chúng là những “anh hùng thầm lặng” (và đôi khi là “phản diện”) của web scraping; xử lý đúng cách hay không chính là ranh giới giữa mọi thứ chạy trơn tru và một mớ rắc rối.
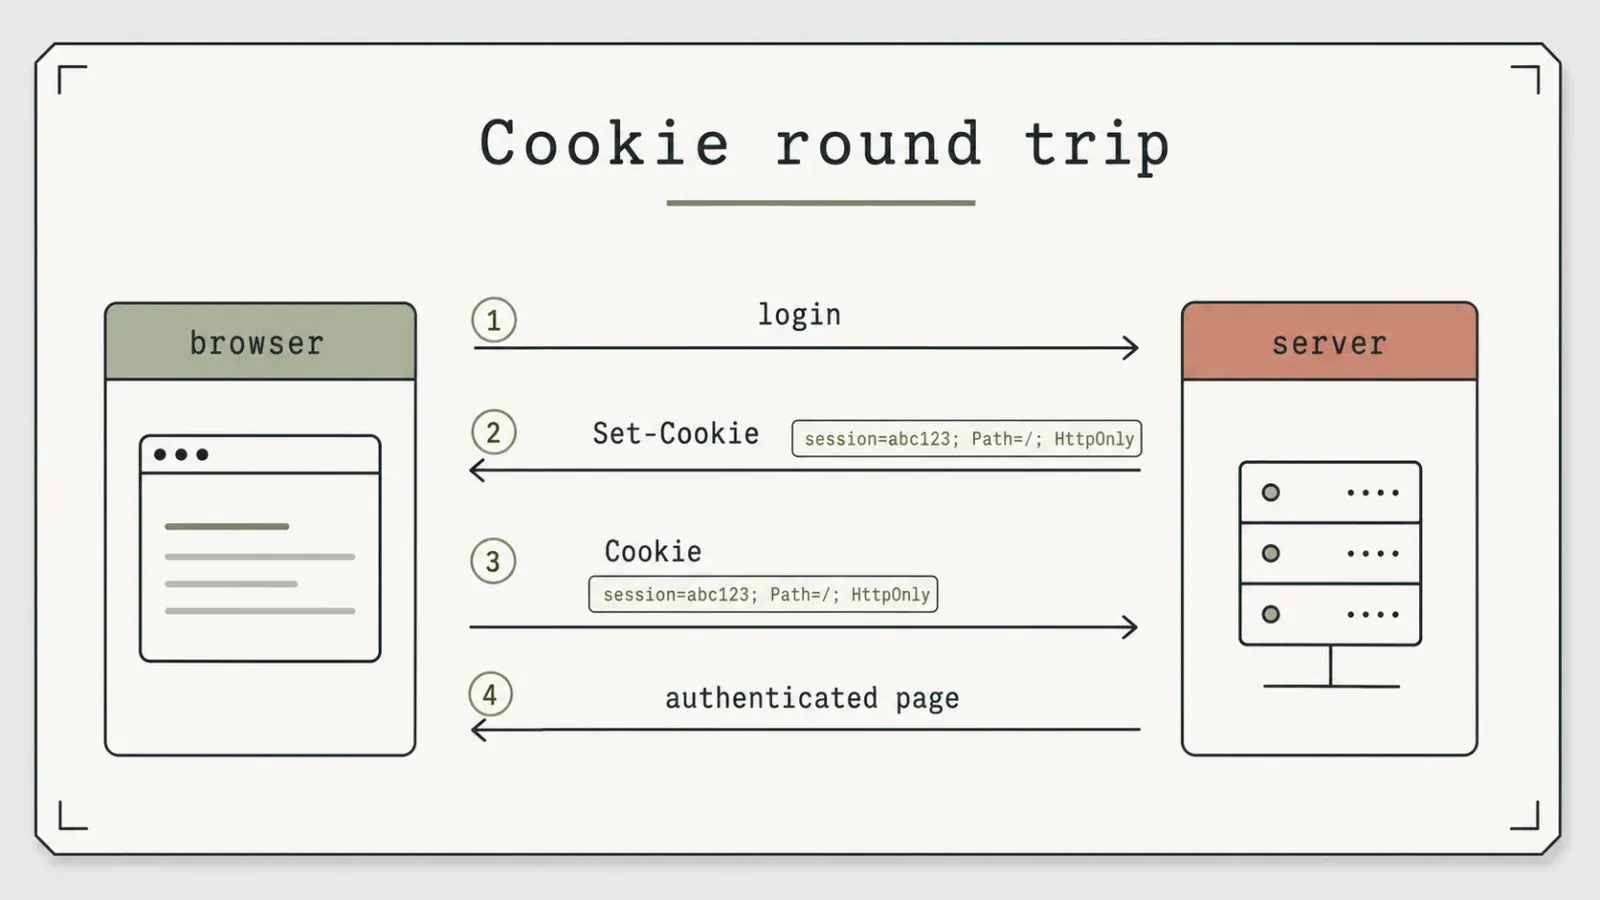
Hãy cùng tìm hiểu vì sao cookie lại quan trọng đến vậy trong web scraping, những phiền toái khi quản lý chúng theo cách truyền thống, và cách các công cụ dùng AI như Thunderbit đang thay đổi cuộc chơi cho người dùng doanh nghiệp. Tôi cũng sẽ chia sẻ những thực hành tốt nhất để giữ cho cookie của bạn—và dữ liệu của bạn—luôn an toàn, bảo mật và tuân thủ.
Vì Sao Việc Quản Lý Cookie Khi Web Scraping Lại Quan Trọng Với Người Dùng Doanh Nghiệp
Xem Cách Web Scraping Tự Động Hoạt Động AI của Thunderbit đọc trang giống như con người và trích xuất dữ liệu chỉ với một cú nhấp, không cần bạn tự quản lý cookie hay header. Get Started Free
Cookie không chỉ để theo dõi món đồ bạn bỏ vào giỏ hàng online. Trong thế giới web scraping, chúng là “chất keo” giữ phiên làm việc của bạn không bị đứt gãy. Dù bạn đang scrape để tìm khách hàng tiềm năng, theo dõi giá hay nghiên cứu thị trường, cookie chính là thứ giúp scraper của bạn:
- Giữ trạng thái đăng nhập trên các website thành viên hoặc dashboard
- Truy cập dữ liệu cá nhân hóa (ví dụ: giao diện CRM hoặc hệ thống tồn kho theo cấu hình riêng của bạn)
- Duy trì phiên làm việc qua nhiều request, để không bị đá ra sau trang đầu tiên
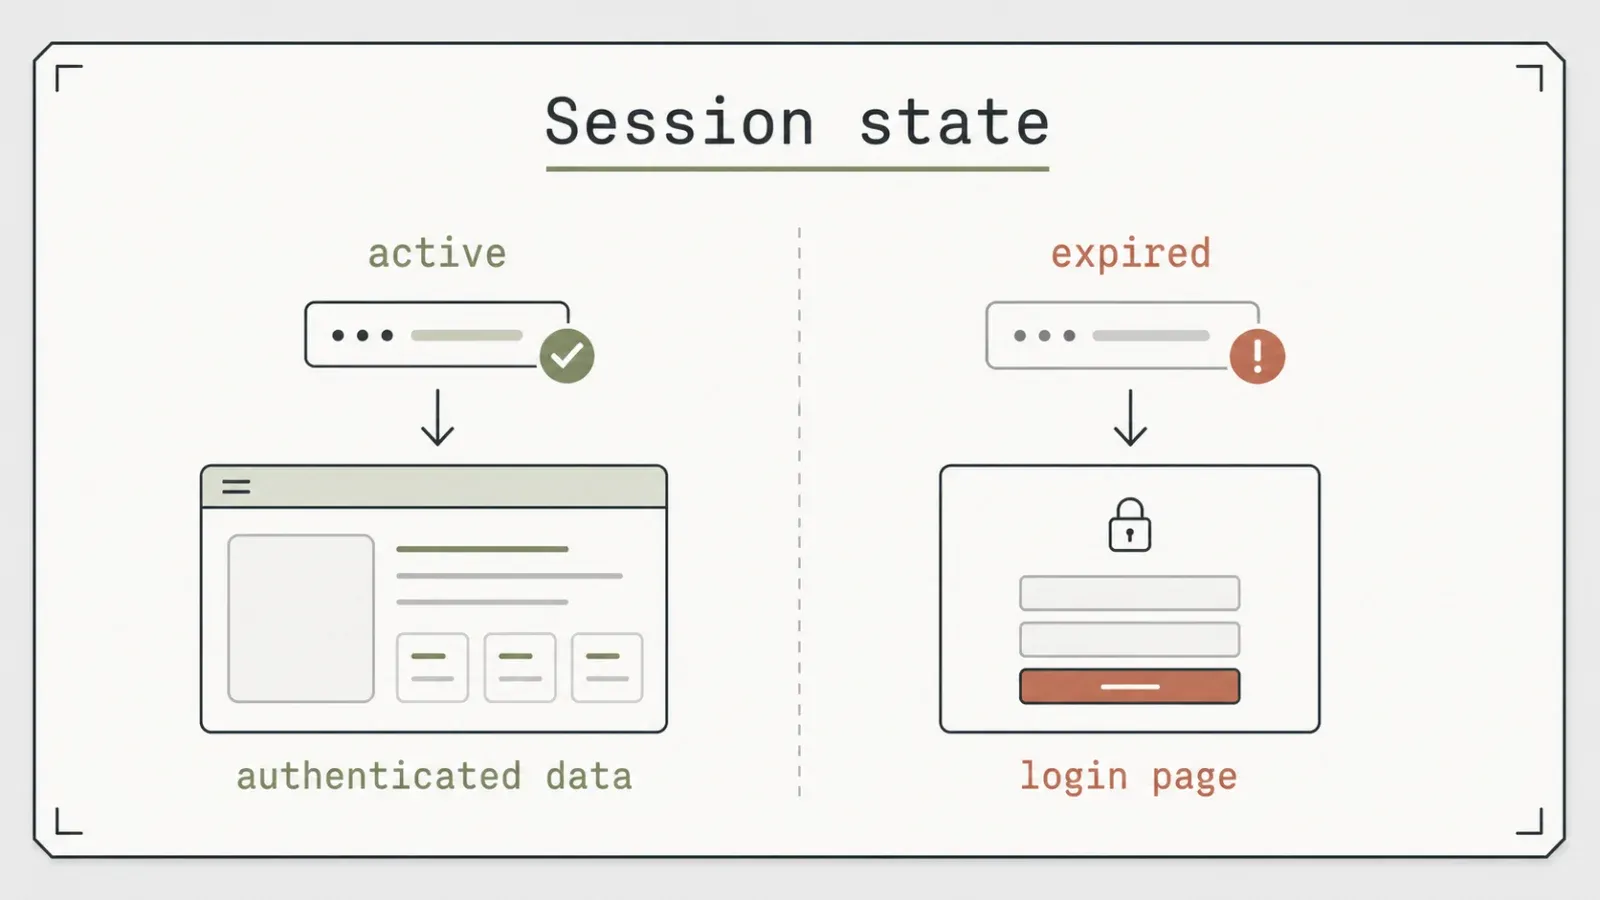
Theo các báo cáo ngành, session cookie đóng vai trò then chốt trong xác thực đăng nhập và duy trì chế độ xem theo từng người dùng. Khi bot chiếm tới 42% tổng lưu lượng web theo Akamai—và hoạt động bot do AI điều khiển tăng khoảng 300% đến năm 2025—các website càng dựa nhiều hơn vào kiểm tra cookie và dấu vân tay phiên làm việc để phân biệt người thật với tự động hóa.
Điều gì xảy ra nếu xử lý cookie sai cách? Bạn có thể gặp rủi ro:
- Bị đăng xuất giữa chừng (tạm biệt dữ liệu)
- Nhận dữ liệu thiếu hoặc dữ liệu chung chung thay vì thông tin cá nhân hóa bạn cần
- Kích hoạt các cơ chế chặn bảo mật hoặc thậm chí bị khóa tài khoản—đặc biệt trên những trang có chính sách chống bot nghiêm ngặt
Tôi đã thấy nhiều đội mất cả ngày làm việc chỉ vì session cookie hết hạn hoặc không được cập nhật, khiến scraper chỉ thu về trang đăng nhập. Nói ngắn gọn, quản lý cookie vững chắc chính là nền tảng của web scraping ổn định và đáng tin cậy.
Những Thách Thức Ẩn Sau Khi Quản Lý Cookie Trong Web Scraping Truyền Thống
Nói thật nhé: quản lý cookie thủ công chẳng vui hơn việc lắp đồ IKEA mà không có hướng dẫn. Với các công cụ scraping truyền thống, bạn thường phải:
- Đăng nhập thủ công bằng trình duyệt
- Xuất cookie (bằng DevTools của trình duyệt hoặc plugin)
- Nhét cookie đó vào code scraper
- Lặp lại toàn bộ quy trình mỗi khi cookie hết hạn hoặc website thay đổi luồng đăng nhập
Nếu bạn đang xử lý đăng nhập nhiều bước (như 2FA, chuyển hướng, hoặc CAPTCHA), mọi thứ còn rối hơn nữa. Và nếu bạn chạy scraper trên nhiều luồng hoặc nhiều proxy, bạn còn phải đồng bộ cookie giữa chúng—nếu không, bạn sẽ làm hỏng session hoặc khiến hệ thống bảo mật của website nghi ngờ (source).
Các điểm đau đầu:
- Tốn nhiều thời gian thiết lập: Viết script đăng nhập và lấy cookie rất mất công
- Bảo trì thường xuyên: Cookie hết hạn, website đổi, script hỏng
- Dễ phát sinh lỗi: Chỉ cần quên cập nhật một cookie là cả quá trình scrape có thể thất bại
Ngay cả những công cụ mạnh như Selenium hay Puppeteer cũng cần code riêng để lưu cookie bền vững. Và nếu bạn quên làm mới session, bạn có thể bị chặn hoặc scrape nhầm dữ liệu (source). Không lạ khi rất nhiều người dùng doanh nghiệp bỏ cuộc trước cả khi bắt đầu.
Thunderbit: Tự Động Hóa Cookie Trong Web Scraping Để Trích Xuất Dữ Liệu Ổn Định
Tải Tiện Ích Mở Rộng Thunderbit Trên Chrome Cài tiện ích Chrome miễn phí của Thunderbit và bắt đầu trích xuất dữ liệu từ những trang có chặn cookie chỉ với một cú nhấp. Get Started Free
Đây chính là lúc Thunderbit phát huy tác dụng. Là người đã làm trong SaaS và automation nhiều năm, tôi muốn xây dựng một công cụ biến nỗi đau về cookie thành chuyện của quá khứ. Thunderbit xử lý cookie để bạn không phải bận tâm:
- Chế độ Browser Scraping: Thunderbit chạy như một tiện ích Chrome, nên nó dùng đúng phiên trình duyệt thật và cookie thật của bạn. Nếu bạn xem được trang đó trong Chrome, Thunderbit cũng scrape được—không cần xuất cookie thủ công (source).
- Tự động bắt cookie: Chỉ cần đăng nhập như bình thường, nhấn “One Click Extract”, và Thunderbit sẽ tự lấy session cookie ở phía sau.
- Xử lý đăng nhập nhiều bước: Nếu site có 2FA, chuyển hướng hay luồng phức tạp khác, bạn chỉ cần hoàn tất trong trình duyệt. Thunderbit sẽ tự nhận session cuối cùng.
- Cloud scraping cho dữ liệu công khai: Với website mở, chế độ cloud của Thunderbit cực nhanh (tối đa 50 trang cùng lúc), nhưng với nội dung sau đăng nhập thì browser mode là lựa chọn tốt nhất.
Kết quả thực tế: ít bị đăng xuất giữa chừng hơn, ít session bị hỏng hơn sau khi website thay đổi luồng xác thực, và tiết kiệm rất nhiều thời gian phải xuất cookie từ DevTools bằng tay. Nó không phải phép màu—các site có chống bot gắt gao vẫn có thể gây khó—nhưng mức độ phiền phức giảm đi rõ rệt khi bạn ngừng đụng vào cookie thủ công.
Trải Nghiệm Thunderbit Để Quản Lý Cookie Dễ Dàng Web scraper tự động của Thunderbit xử lý việc hiển thị trang ngay trên trình duyệt, nên chỉ một cú nhấp là đủ thay cho thiết lập cookie và session thủ công. Get Started Free
Nâng Cao Độ Chính Xác Và Hiệu Suất Cookie Nhờ AI
Scraper truyền thống rất “mong manh” — chỉ cần website đổi cấu trúc cookie hoặc luồng đăng nhập là script của bạn coi như hỏng. Các công cụ dùng AI như Thunderbit đưa mọi thứ lên một tầm cao mới:
- Nhận diện cookie tự động: AI của Thunderbit “nhìn” và hiểu trang, tự phát hiện cookie nào cần cho từng request.
- Tự làm mới session: Nếu session cookie hết hạn, AI có thể nhắc bạn đăng nhập lại và cập nhật kho cookie ngay lập tức.
- Thích ứng với thay đổi của website: Khi website thay đổi logic đăng nhập hoặc cookie, AI của Thunderbit sẽ thích nghi—không cần viết lại script hay đi tìm tên cookie mới.
- Giảm lỗi do con người: Không còn cảnh quên refresh cookie hoặc vô tình scrape như một người đã đăng xuất.
Điều đó có nghĩa là uptime cao hơn, ít gián đoạn hơn và dữ liệu chính xác hơn—đặc biệt hữu ích với người dùng doanh nghiệp cần thông tin cập nhật và đáng tin cậy (source).
Thực Hành Tốt Nhất Để Xử Lý Cookie Web Scraping An Toàn Và Tuân Thủ
Cookie có thể chứa dữ liệu phiên nhạy cảm, nên xử lý an toàn không chỉ là khôn ngoan—nhiều khi còn là yêu cầu pháp lý. Đây là cách để bạn an toàn và tuân thủ:
- Mã hóa nơi lưu cookie: Không bao giờ lưu cookie ở dạng văn bản thuần hoặc file không được bảo vệ. Hãy dùng cơ sở dữ liệu mã hóa hoặc cookie jar an toàn (source).
- Luôn dùng HTTPS: Cookie có thuộc tính
Securechỉ nên được truyền qua kết nối được mã hóa (source). - Thiết lập cờ HttpOnly: Điều này ngăn cookie bị JavaScript độc hại truy cập, giảm rủi ro XSS (source).
- Giảm thời gian giữ cookie: Chỉ lưu cookie trong thời gian cần cho xác thực. Xóa cookie cũ hoặc không còn dùng thường xuyên.
- Tuân thủ GDPR và CCPA: Theo GDPR, cookie có thể nhận diện người dùng được xem là dữ liệu cá nhân. Hãy luôn có cơ sở pháp lý để sử dụng cookie và tôn trọng các yêu cầu từ chối hoặc xóa dữ liệu của người dùng.
- Tôn trọng chính sách website: Luôn kiểm tra điều khoản dịch vụ và robots.txt trước khi scrape. Một số website yêu cầu phải có sự đồng ý rõ ràng cho việc dùng cookie.
Làm đúng các thực hành này sẽ giúp bạn giảm rủi ro pháp lý và giữ cho dữ liệu của bạn—cũng như người dùng của bạn—được an toàn.
So Sánh Các Cách Quản Lý Cookie: Thủ Công, Tự Động Và Dựa Trên AI
Hãy cùng nhìn nhanh ưu và nhược điểm của từng chiến lược quản lý cookie:
| Cách tiếp cận | Công sức thiết lập | Độ tin cậy | Bảo mật | Tuân thủ & Bảo trì |
|---|---|---|---|---|
| Thủ công (Python, cURL) | Cao (script riêng, tự lấy cookie thủ công) | Thay đổi tùy site (dễ hỏng khi website đổi) | Lập trình viên phải tự thêm mã hóa/cờ bảo vệ | Dễ phát sinh lỗi, cần cập nhật thường xuyên |
| Công cụ tự động | Trung bình (cấu hình công cụ, quản lý thông tin đăng nhập) | Tốt với site ổn định | Thường có bảo mật tiêu chuẩn | Vẫn cần theo dõi, đôi khi phải thao tác thủ công |
| Dùng AI (Thunderbit) | Thấp (không cần code, chạy trên trình duyệt) | Cao (thích ứng với thay đổi, tự làm mới) | Lưu trữ mã hóa, session an toàn | Có sẵn yếu tố tuân thủ, bảo trì tối thiểu |
Các công cụ AI như Thunderbit cần ít công sức nhất nhưng lại cho kết quả bền vững và sẵn sàng cho tương lai nhất (source).
Những Sai Lầm Phổ Biến Cần Tránh Khi Xử Lý Cookie Trong Web Scraping
Ngay cả khi có công cụ tốt, bạn vẫn rất dễ mắc lỗi. Hãy cẩn thận với những sai lầm thường gặp sau:
- Cookie hết hạn hoặc bị thiếu: Luôn làm mới session cookie trước một đợt scrape lớn. Nếu scraper bắt đầu trả về trang đăng nhập, rất có thể cookie của bạn đã hết hạn (source).
- Lưu trữ không an toàn: Đừng bao giờ lưu cookie dạng text thuần hoặc gửi qua email/chat. Hãy dùng nơi lưu trữ đã mã hóa.
- Bỏ qua thuộc tính cookie: Đảm bảo scraper của bạn tôn trọng các cờ
SecurevàHttpOnly. - Bỏ qua chính sách website: Không xử lý banner cookie hoặc pop-up xin consent có thể khiến scraper bị chặn.
- Lỗi khi chạy song song: Nếu scrape đồng thời nhiều luồng, hãy सुनिश्चित bảo mọi luồng dùng chung đúng cookie store.
- Giả định cứng nhắc: Đừng gắn scraper vào tên hoặc giá trị cookie cố định—các website thay đổi những thứ này liên tục.
Mẹo xử lý lỗi: nếu scraper ngừng hoạt động, hãy kiểm tra giá trị cookie, so sánh request từ trình duyệt với request từ script, và thử dùng browser automation với những website khó xử lý.
Hướng Dẫn Từng Bước: Thiết Lập Quản Lý Cookie An Toàn Và Hiệu Quả Trong Thunderbit
Sẵn sàng áp dụng các thực hành tốt nhất này chưa? Đây là cách xử lý cookie an toàn với Thunderbit:
- Chọn đúng chế độ: Với trang có đăng nhập hoặc nội dung cá nhân hóa, hãy dùng chế độ Browser Scraping. Với dữ liệu công khai, hãy dùng Cloud Scraping để có tốc độ cao hơn.
- Đăng nhập như bình thường: Mở Chrome, đăng nhập vào website mục tiêu như bạn vẫn làm. Hoàn thành các bước 2FA hoặc chấp thuận consent nếu có.
- Bật tự động bắt cookie: Nhấn vào tiện ích Thunderbit, rồi chọn “One Click Extract.” Thunderbit sẽ tự dùng session cookie của bạn—không cần xuất thủ công (source).
- Kiểm tra session: Xem phần preview ở sidebar của Thunderbit để নিশ্চিত bạn đang thấy đúng nội dung đã đăng nhập.
- Chạy thử một lần scrape nhỏ: Bắt đầu với một lô nhỏ để xác nhận dữ liệu nhận được đúng như mong đợi.
- Theo dõi và đăng nhập lại khi cần: Với các job chạy định kỳ hoặc dài hạn, hãy để ý khi session hết hạn. Nếu bị đăng xuất, chỉ cần đăng nhập lại—Thunderbit sẽ tự cập nhật cookie.
- Xuất dữ liệu an toàn: Khi xuất dữ liệu, Thunderbit giữ cookie của bạn ở trạng thái an toàn và không bao giờ đưa chúng ra file đầu ra.
Vậy là xong—không code, không vật lộn thủ công với cookie, chỉ còn scraping ổn định và an toàn.
Bắt Đầu Web Scraping An Toàn Với Thunderbit Gói miễn phí bao gồm 6 trang mỗi tháng, không cần thẻ tín dụng — đủ để bạn thử một lần crawl trước khi mở rộng quy mô. Get Started Free
Những Điểm Mấu Chốt Cho Các Đội Ngũ Doanh Nghiệp Dùng Cookie Khi Web Scraping
- Cookie là yếu tố thiết yếu để web scraping ổn định, có xác thực và cá nhân hóa. Xử lý sai có thể dẫn tới mất dữ liệu, tài khoản bị chặn hoặc rắc rối pháp lý.
- Quản lý cookie thủ công vừa tốn thời gian vừa dễ lỗi. Các công cụ AI như Thunderbit tự động hóa quy trình, giảm thời gian thiết lập và tăng độ tin cậy.
- Lưu trữ an toàn và tuân thủ là rất quan trọng. Luôn mã hóa cookie, dùng HTTPS và tuân thủ quy định GDPR/CCPA.
- Xử lý cookie bằng AI thích ứng với thay đổi của website, giảm lỗi con người và giữ dòng dữ liệu luôn thông suốt.
- Tránh các lỗi phổ biến: Làm mới cookie thường xuyên, không lưu trữ thiếu an toàn và tôn trọng chính sách của website.
Hãy áp dụng những thực hành này—mã hóa lưu trữ, tôn trọng Secure/HttpOnly, làm mới session theo lịch rõ ràng—và hầu hết lỗi cookie thường ngày sẽ biến mất. Nếu tự quản lý cookie vẫn là việc bạn không muốn dành cả tuần để làm, tiện ích Chrome của Thunderbit sẽ xử lý phần bắt và làm mới ngay trong phiên trình duyệt của bạn. Bạn có thể đọc thêm các bài phân tích sâu về cookie và chống chặn trên Thunderbit Blog.
Thử Quản Lý Cookie Bằng AI Với Thunderbit Get Started Free
Câu Hỏi Thường Gặp
1. Vì sao cookie lại quan trọng đến vậy trong web scraping?
Cookie giúp scraper duy trì trạng thái đăng nhập, giữ session và truy cập nội dung được cá nhân hóa hoặc bảo vệ. Nếu không quản lý cookie đúng cách, scraper của bạn có thể bị đăng xuất, bị chặn, hoặc thu thập dữ liệu không đầy đủ (source).
2. Rủi ro khi xử lý cookie sai trong quá trình scrape là gì?
Xử lý cookie sai có thể dẫn tới mất dữ liệu, quá trình scrape bị gián đoạn, tài khoản bị khóa, hoặc thậm chí vấn đề pháp lý nếu cookie được lưu không an toàn hay dùng vi phạm luật riêng tư (source).
3. Thunderbit tự động hóa quản lý cookie như thế nào?
Thunderbit dùng phiên Chrome đang hoạt động của bạn để tự động kế thừa cookie—không cần xuất thủ công hay viết code. Nó xử lý xác thực, làm mới session và thích ứng với thay đổi của website bằng AI (source).
4. Cách tốt nhất để lưu cookie an toàn là gì?
Luôn mã hóa nơi lưu cookie, dùng HTTPS để truyền dữ liệu, đặt cờ HttpOnly và Secure, và không bao giờ lưu cookie ở dạng text thuần hoặc chia sẻ qua kênh không an toàn (source).
5. Làm sao để đảm bảo xử lý cookie của tôi tuân thủ GDPR và CCPA?
Hãy xem cookie như dữ liệu cá nhân: chỉ thu thập phần cần thiết, xin consent của người dùng khi bắt buộc, và tôn trọng yêu cầu từ chối hoặc xóa dữ liệu. Thường xuyên rà soát chính sách cookie để luôn phù hợp với quy định đang thay đổi (source).
6. AI browser agent đang thay đổi bức tranh quản lý cookie như thế nào? Thế hệ công cụ mới—như tiện ích Chrome của Thunderbit, cùng các agent mã nguồn mở như Browser Use chạy trên Playwright—bỏ qua hoàn toàn bước xuất cookie thủ công bằng cách làm việc trực tiếp từ một hồ sơ trình duyệt đang đăng nhập. Cookie, localStorage và session state được chuyển qua tự động; nếu session hết hạn, bạn chỉ cần đăng nhập lại trong trình duyệt và scraper sẽ tiếp tục. Đổi lại, bạn sẽ mất một phần quyền kiểm soát chi tiết mà việc tự viết cookie header trong Python mang lại. Với người dùng doanh nghiệp đang scrape các trang có đăng nhập, sự đánh đổi này thường rất đáng giá.
Sẵn sàng đưa web scraping của bạn lên tầm cao hơn? Dùng thử Thunderbit miễn phí và để AI xử lý cookie—để bạn tập trung vào dữ liệu thực sự quan trọng.
Tìm hiểu thêm




