
Thế giới này vận hành bằng dữ liệu, và đến năm 2026, nhu cầu biến dữ liệu web thành insight kinh doanh còn lớn hơn bao giờ hết. Tôi đã tận mắt thấy các team sales, vận hành và marketing chạy nước rút để tự động hóa việc nghiên cứu, theo dõi đối thủ và xây dựng những pipeline thông minh hơn — tất cả đều nhờ web scraping. Nhưng có một điểm rất quan trọng: muốn giỏi web scraping thì không thể chỉ đọc vài bài hướng dẫn là xong. Bạn phải xắn tay vào thực hành trên những website thật sự, và đôi khi là những site cực kỳ khó nhằn.
Tìm được một web scraping test site phù hợp đôi khi còn khó hơn mò kim đáy bể. Có site quá dễ, có site lại gài sẵn lớp chống bot, và cũng có những site… kỳ quặc theo đúng nghĩa đen. Vì vậy, tôi đã tổng hợp danh sách 10 trang web mẫu tốt nhất để luyện web scraping — được chọn lọc để giúp bạn xây dựng kỹ năng thực chiến, từ nền tảng cho người mới đến xử lý dữ liệu động nâng cao. Dù bạn muốn scrape danh sách sản phẩm thương mại điện tử, forum hay review phim, hướng dẫn này sẽ giúp bạn nâng cấp kỹ năng và tránh cảm giác “404” của sự bế tắc khi scraping.
Vì sao nên luyện web scraping trên các trang web mẫu?
Xem cách web scraping theo tác tử hoạt động AI của Thunderbit đọc trang giống như con người và quyết định cần trích xuất gì — hãy thử trên bất kỳ site luyện tập nào ở trên. Get Started Free
Nói thẳng nhé: web scraping là môn thực hành. Tất nhiên bạn có thể xem bao nhiêu video YouTube cũng được, nhưng cho đến khi bạn thật sự vật lộn với HTML thật, nội dung động và thỉnh thoảng gặp CAPTCHA, bạn vẫn chưa chạm được vào bản chất. Luyện trên các web scraping test site là cách tốt nhất để:
- Hiểu các cấu trúc dữ liệu khác nhau: Từ bảng đơn giản đến danh sách lồng nhau và nội dung tải bằng AJAX, mỗi site là một bài toán mới.
- Kiểm tra công cụ và kỹ năng của bạn: Xem scraper của bạn (hoặc công cụ bạn thích, như Thunderbit) xử lý phân trang, subpage và các chiêu chống bot ra sao.
- Chuẩn bị cho nhu cầu doanh nghiệp: Scraping thực tế hỗ trợ nghiên cứu thị trường, tạo lead và phân tích đối thủ cho doanh nghiệp ở mọi nơi.
Số liệu cũng nói lên điều đó: thị trường web scraping toàn cầu được dự đoán đạt 1,17 tỷ USD vào năm 2026, tăng từ khoảng 0,99 tỷ USD năm 2025 với tốc độ tăng trưởng kép khoảng 18%, và gần 95% tổ chức cho rằng ra quyết định dựa trên dữ liệu là yếu tố “then chốt” để họ thành công. Nhưng bí mật thật sự là gì? Những scraper giỏi nhất không chỉ biết code — họ là những người kiên trì thử nghiệm, liên tục mài giũa kỹ năng trên các site mới.
Cách chúng tôi chọn ra những website luyện web scraping tốt nhất
Không phải mọi trang web mẫu để web scraping đều giống nhau. Với danh sách này, tôi ưu tiên các site:
- Cung cấp nhiều kiểu dữ liệu: Văn bản, số liệu, hình ảnh, đánh giá, review và hơn thế nữa.
- Có độ phức tạp đa dạng: Từ HTML tĩnh đến các trang động nhiều JavaScript.
- Hợp pháp và an toàn để scrape: Hoặc được tạo riêng cho mục đích luyện tập, hoặc là các trang công khai, không cần đăng nhập.
- Mô phỏng tình huống kinh doanh thực tế: Thương mại điện tử, forum, review và nhiều hơn nữa.
- Cho bạn tiếp xúc với các cơ chế chống scraping: Vì ngoài đời thực, bạn sẽ phải xử lý CAPTCHA, giới hạn tốc độ và AJAX.
Tôi cũng đảm bảo các site này phù hợp để test cả scraper truyền thống viết bằng code lẫn công cụ no-code hiện đại như Thunderbit. Sẵn sàng đi sâu hơn chưa? Bắt đầu thôi.
1. Thunderbit: Web scraping test site tất cả trong một

Trích xuất dữ liệu từ bất kỳ website nào bằng AI Agentic web scraper của Thunderbit đọc bất kỳ trang test nào hoặc trang mục tiêu thực tế và trích xuất dữ liệu chỉ bằng một cú nhấp. Get Started Free
Thunderbit không chỉ là một công cụ — nó là sân chơi cho bất kỳ ai nghiêm túc với việc luyện web scraping. Là người đã dành nhiều năm để xây dựng và phá vỡ scraper, tôi có thể nói rằng: Thunderbit là lựa chọn hàng đầu của tôi để test mọi thứ, từ danh sách đơn giản đến những site thương mại điện tử động, cực kỳ rối.
Vì sao Thunderbit nổi bật:
- Scraping bằng AI: Chỉ cần bấm “One Click Extract”, Thunderbit sẽ đọc trang, tự xác định cột phù hợp nhất và thậm chí tự viết logic trích xuất cho bạn. Không cần code, không đau đầu chọn selector.
- Xử lý site phức tạp: Thunderbit phát huy tốt trên HTML khó, nội dung động và các trang có subpage hoặc cuộn vô hạn. Nó giống như một bộ dao đa năng cho web scraping.
- Hỗ trợ subpage và phân trang: Bạn cần scrape danh sách sản phẩm rồi vào từng trang chi tiết để lấy thêm thông tin? Thunderbit xử lý rất mượt.
- Xuất dữ liệu ngay lập tức: Xuất kết quả sang Excel, Google Sheets, Airtable hoặc Notion — miễn phí và không giới hạn.
- Bộ trích xuất miễn phí: Công cụ một chạm để lấy email, số điện thoại và hình ảnh. Rất hợp để luyện sales và tạo lead.
- Template cho các site phổ biến: Amazon, Zillow, Shopify và nhiều hơn nữa — chỉ cần chọn template rồi chạy.
- Thân thiện với người mới: Người không chuyên kỹ thuật rất thích việc họ “không cần học quá nhiều” để bắt đầu (Trustpilot).
Tình huống thực hành:
- Scrape danh sách sản phẩm thương mại điện tử (như Amazon hoặc eBay) rồi làm giàu dữ liệu từ subpage.
- Trích xuất thông tin liên hệ từ các thư mục doanh nghiệp.
- Tự động hóa các lần kéo dữ liệu lặp đi lặp lại cho nghiên cứu thị trường.
Thunderbit là web scraping test site duy nhất trong danh sách này cho phép bạn luyện cả phần scraping lẫn tự động hóa workflow. Và đúng vậy, bạn có thể dùng thử miễn phí — để tự mình thấy vì sao đây là lựa chọn số một của tôi cho mọi cấp độ kỹ năng.
Dùng thử Thunderbit Agentic Web Scraper miễn phí Gói miễn phí hỗ trợ 6 trang mỗi tháng, không cần thẻ tín dụng — quá đủ để luyện trên các site ở trên. Get Started Free
2. Codeforces: Luyện scrape dữ liệu lập trình có cấu trúc
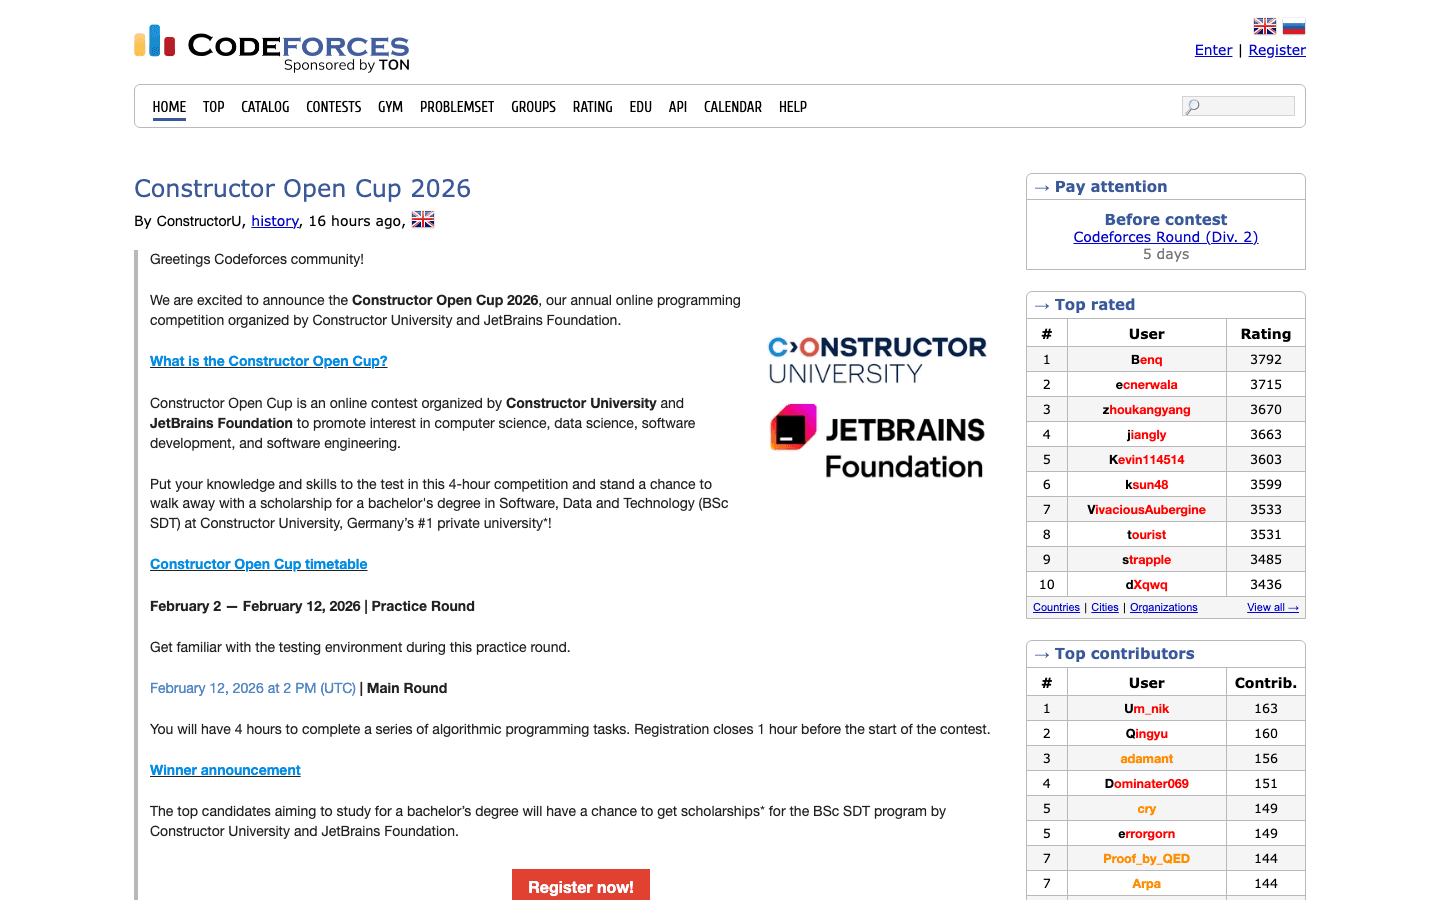 Codeforces là mỏ vàng cho ai muốn luyện scrape dữ liệu có cấu trúc, dạng bảng. Nền tảng thi lập trình này có:
- Danh sách contest: Bảng gồm tên contest, ngày diễn ra và đường dẫn.
- Bộ bài tập: Các bảng lồng nhau với tên bài, tag và độ khó.
- Xếp hạng người dùng: Bảng thành tích và trang profile với điểm số, thống kê.
Vì sao phù hợp để luyện tập:
- Giúp bạn học cách parse HTML table, danh sách lồng nhau và kết quả nhiều trang.
- Phần lớn dữ liệu là HTML tĩnh — không cần đăng nhập hay xử lý JavaScript phức tạp.
- Mô phỏng các tình huống thực tế như scrape trang tuyển dụng hoặc kết quả học thuật.
Mẹo nhỏ: Hãy thử trích xuất toàn bộ bài trong một contest, hoặc xây dựng bảng xếp hạng người dùng đứng đầu. Bạn sẽ có một khóa học cấp tốc về xử lý dữ liệu có cấu trúc và phân trang.
3. Books to Scrape: Website luyện web scraping kinh điển
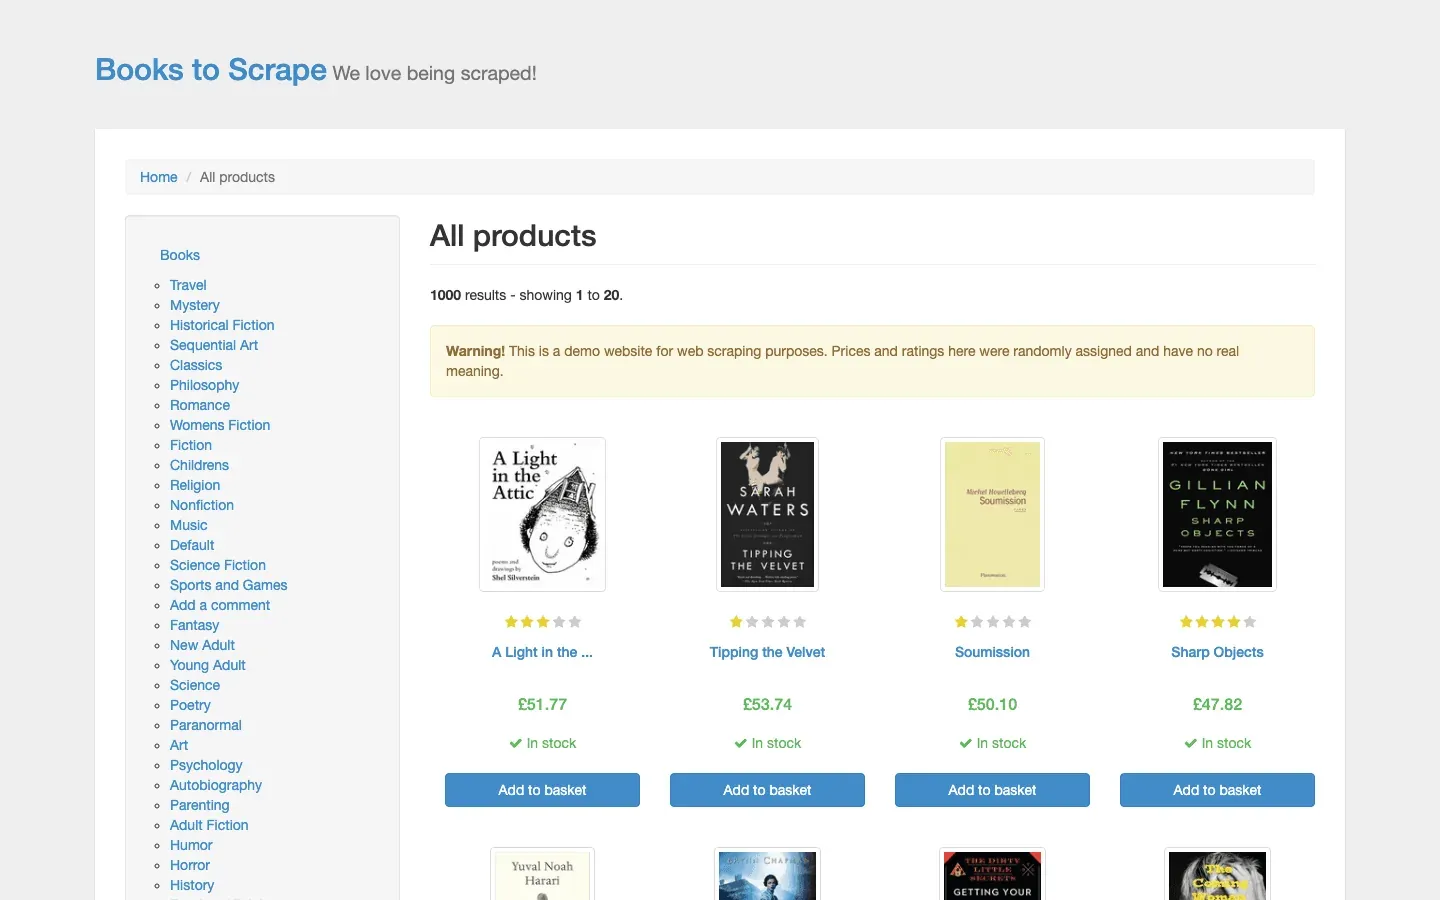 Books to Scrape chính là “hello world” của web scraping. Đây là một hiệu sách online giả lập dành cho người mới, nhưng đừng để điều đó đánh lừa bạn — nó vẫn là nơi tuyệt vời để nắm vững các kiến thức cơ bản.
Bạn sẽ tìm thấy gì:
- Danh sách sản phẩm HTML tĩnh: Tên sách, giá, đánh giá và danh mục.
- Phân trang: Luyện scrape qua nhiều trang.
- Cấu trúc nhất quán: Rất dễ học selector và vòng lặp.
Bài tập thực hành:
- Trích xuất toàn bộ tên sách và giá.
- Scrape đánh giá và tình trạng còn hàng.
- Xử lý phân trang để lấy toàn bộ catalog.
Trang này cực kỳ phổ biến trong các tutorial vì nó an toàn, dễ đoán và rất phù hợp để xây dựng sự tự tin trước khi bạn bước vào thế giới web thực sự (Proxyway).
4. HackerRank: Luyện web scraping cho dữ liệu text và thuật toán
 HackerRank là nơi mọi thứ bắt đầu khó hơn hẳn. Nền tảng thử thách lập trình này chứa đầy:
- Nội dung động: Mô tả bài toán, test case và bảng xếp hạng.
- Hồ sơ người dùng: Thống kê, huy hiệu và thứ hạng.
- Đăng nhập/xác thực: Nhiều trang yêu cầu phiên đăng nhập.
Vì sao đây là một test site tốt:
- Giúp bạn học cách xử lý luồng đăng nhập và session cookie.
- Đưa bạn tiếp xúc với nội dung render bằng JavaScript và AJAX.
- Rất phù hợp để luyện scrape các bài coding challenge, thống kê người dùng hoặc kết quả thi đấu.
Nếu bạn muốn học cách scrape những site không “hợp tác” với các HTTP request đơn giản, HackerRank chính là nơi để bạn chứng minh khả năng.
5. Web Scraper Test: Web scraping test site chuyên dụng
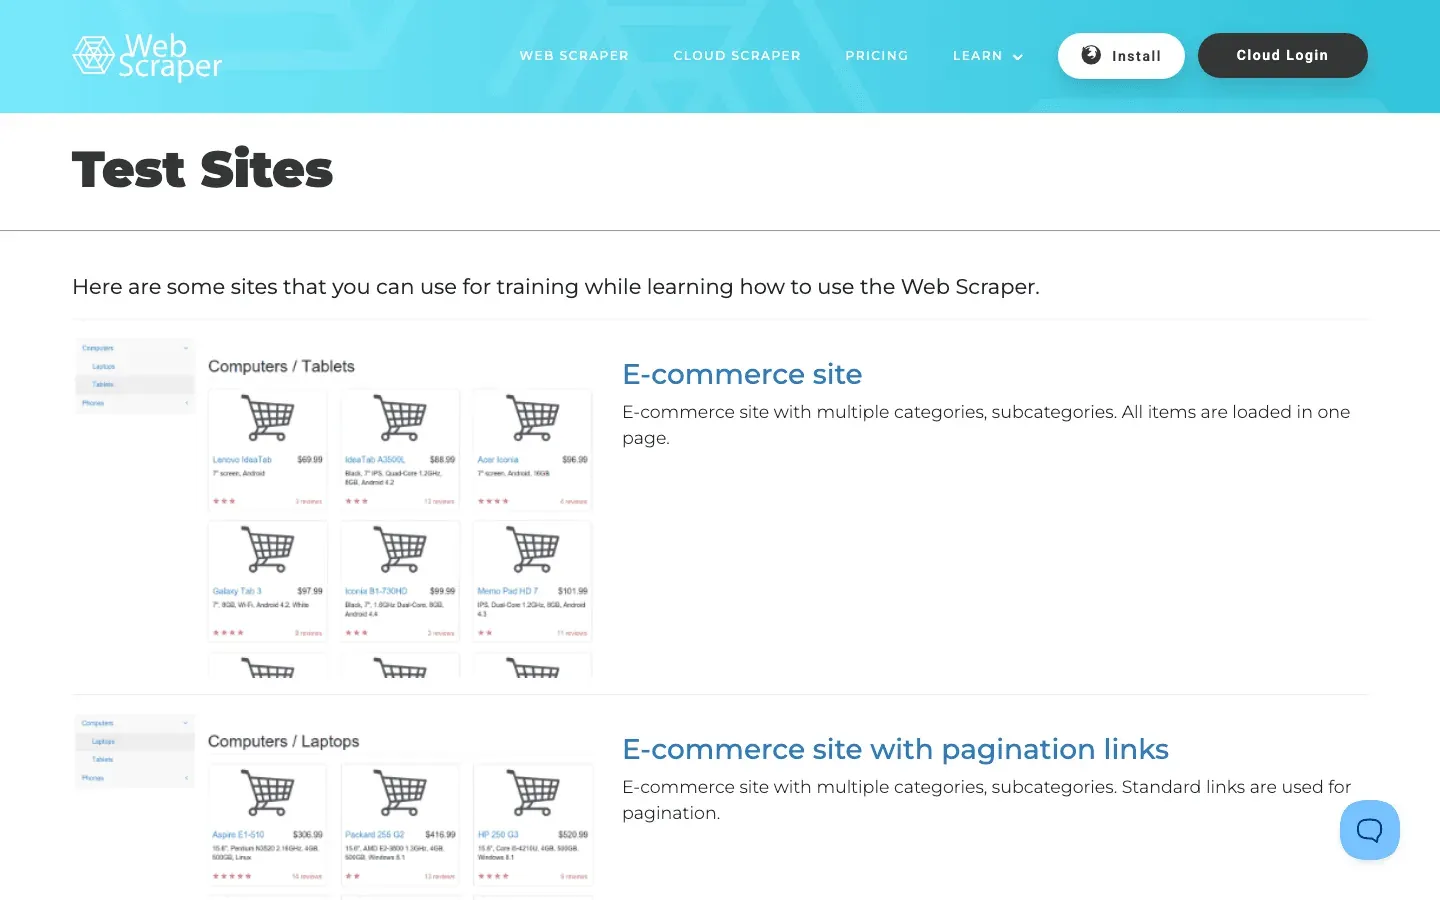 Web Scraper Test được tạo riêng cho những người như chúng ta — các tín đồ scraping muốn luyện tập trên những tình huống được thiết kế sẵn.
Bên trong có gì:
- Trang thương mại điện tử: Cả tĩnh lẫn chạy bằng AJAX.
- Bảng và danh mục lồng nhau: Từ danh sách đơn giản đến menu nhiều cấp.
- Nội dung động: Test khả năng xử lý JavaScript của scraper.
Điểm hay:
- Không có cơ chế chống bot — bạn có thể scrape thoải mái.
- Cho phép benchmark hiệu năng công cụ của bạn trên trang tĩnh so với trang động.
- Rất phù hợp để so sánh cách Thunderbit và các scraper khác xử lý nhiều loại site khác nhau (Firecrawl).
Nếu bạn muốn một môi trường an toàn để đẩy scraper đến giới hạn, đây chính là nơi phù hợp.
6. eBay: Luyện web scraping thương mại điện tử trong môi trường thực tế
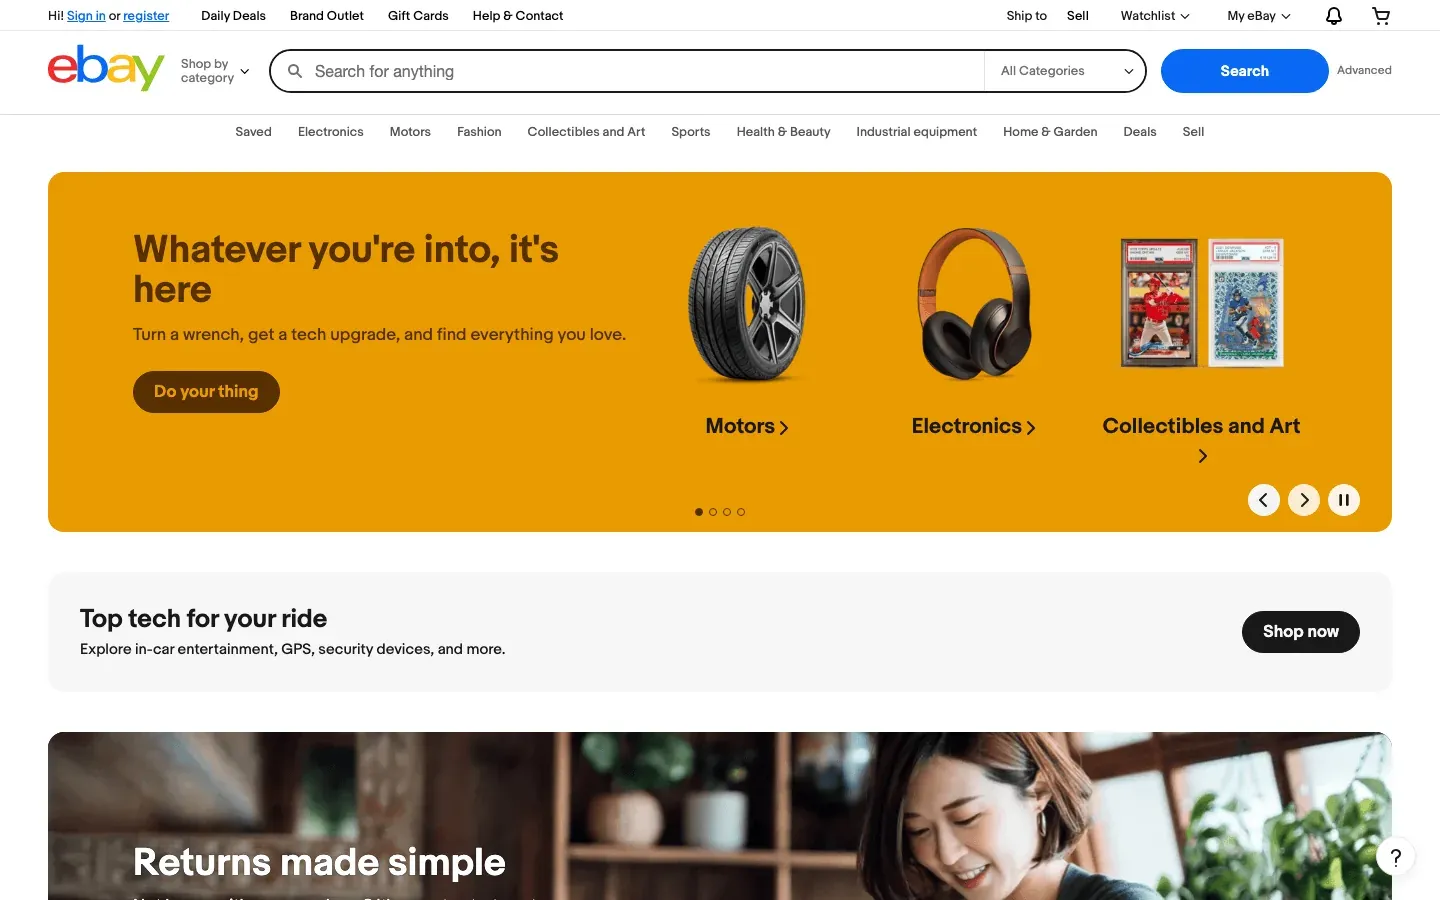 eBay là nơi web scraping chạm vào thế giới thật. Với hàng triệu listing sản phẩm, đây là địa chỉ yêu thích để luyện:
- Trích xuất dữ liệu sản phẩm: Tên, giá, hình ảnh, thông tin người bán.
- Phân trang và lọc: Scrape theo danh mục hoặc kết quả tìm kiếm.
- Nội dung động: Danh sách và review được tải qua AJAX.
Thách thức:
- eBay dùng CAPTCHA, giới hạn tốc độ và HTML động để chặn bot (Oxylabs).
- Bạn sẽ cần tìm hiểu về proxy, user agent và cách scrape có trách nhiệm.
Ứng dụng kinh doanh:
- Theo dõi giá, phân tích đối thủ và nghiên cứu thị trường.
Nếu scrape được eBay, bạn đã sẵn sàng cho gần như mọi thử thách trong thương mại điện tử.
7. Amazon: Web scraping test site tối thượng cho thương mại điện tử
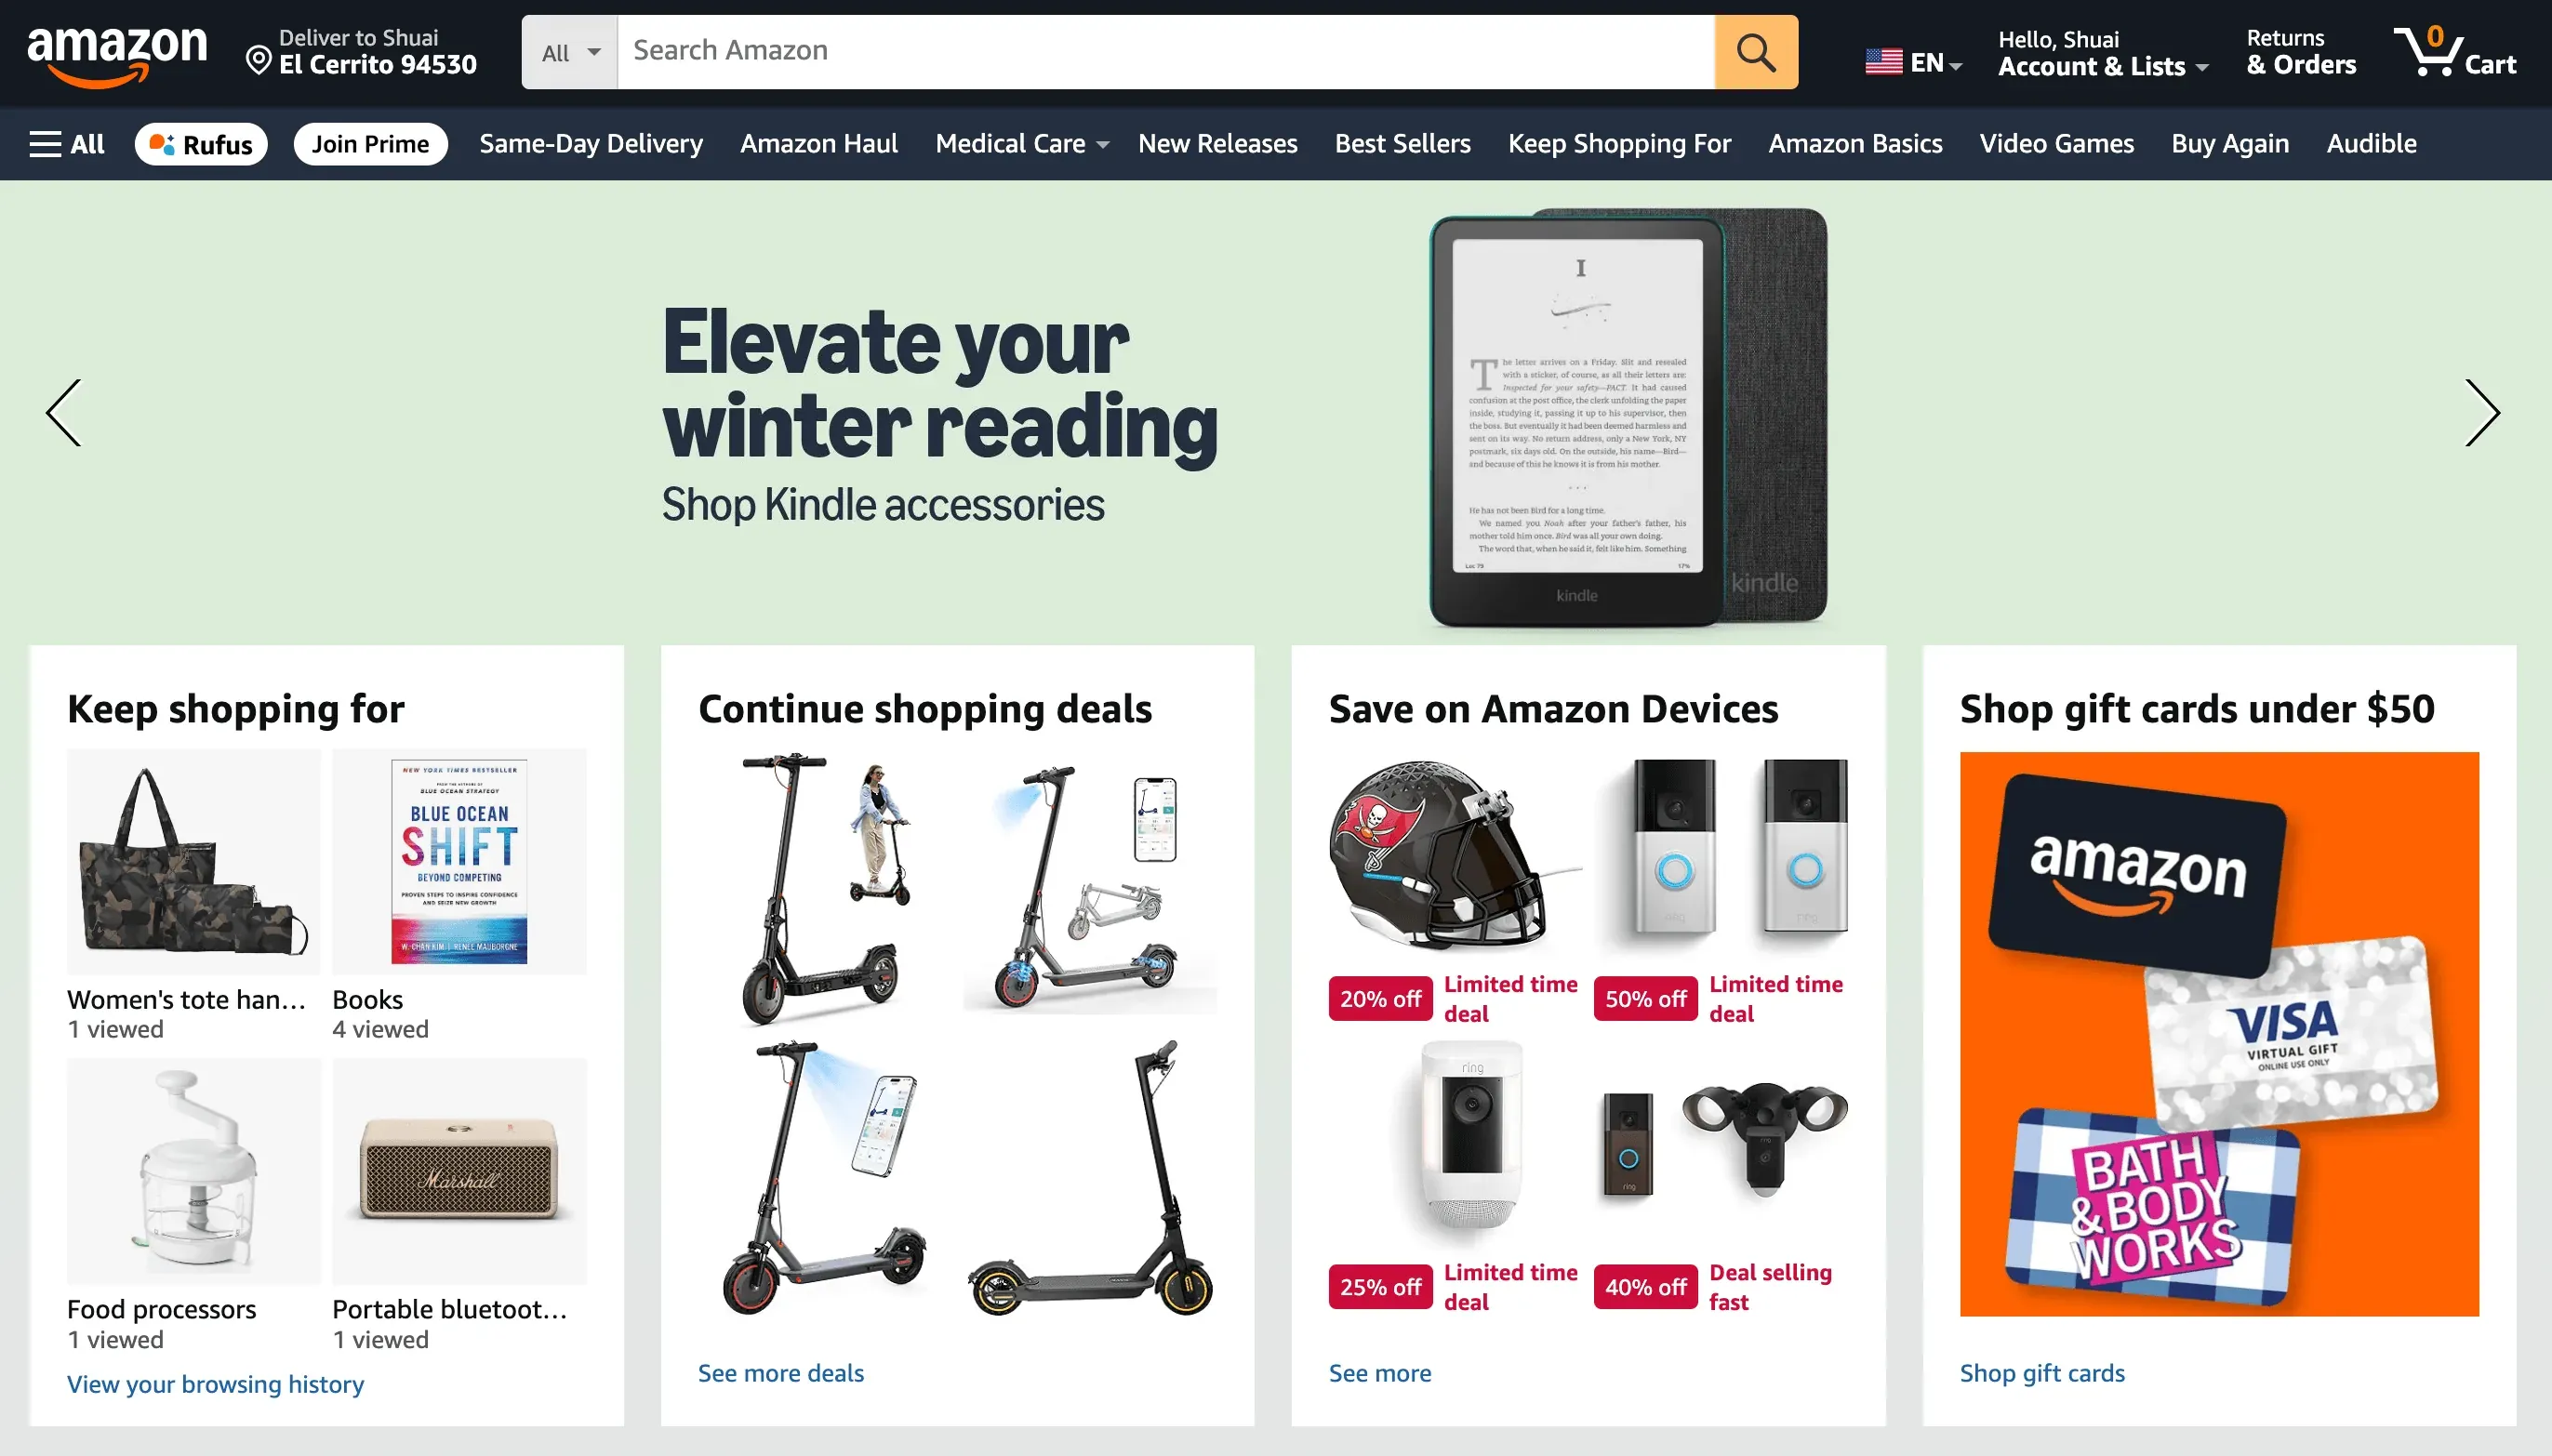 Amazon là “trùm cuối” của web scraping. Bản thân Amazon bán khoảng 12 triệu SKU first-party, còn marketplace của họ hiển thị xấp xỉ 600 triệu listing nếu tính cả hơn 588 triệu người bán bên thứ ba — và Amazon bảo vệ kho dữ liệu đó bằng một trong những hệ thống chống bot mạnh nhất trên web công khai.
Bài tập thực hành:
- Trích xuất thông tin sản phẩm, giá, đánh giá và review.
- Xử lý infinite scroll, phần tử động và dữ liệu lồng nhau.
- Tôn trọng các cơ chế chống bot: chặn IP, fingerprinting request và nhiều hơn nữa (LiveProxies).
Tại sao vẫn nên thử?
- Scrape Amazon giúp bạn học các kỹ thuật nâng cao như xoay proxy và tự động hóa trình duyệt.
- Đây là cách tốt nhất để luyện cho các dự án ecommerce thực tế — chỉ cần nhớ scrape có trách nhiệm và tuân thủ điều khoản của Amazon.
Trích xuất dữ liệu sản phẩm và review Amazon Sau khi luyện trên các site test, hãy đưa Thunderbit vào một listing Amazon thật và nó sẽ trích xuất dữ liệu sản phẩm cùng review chỉ bằng một cú nhấp. Get Started Free
8. Yelp: Luyện scrape danh sách doanh nghiệp và review
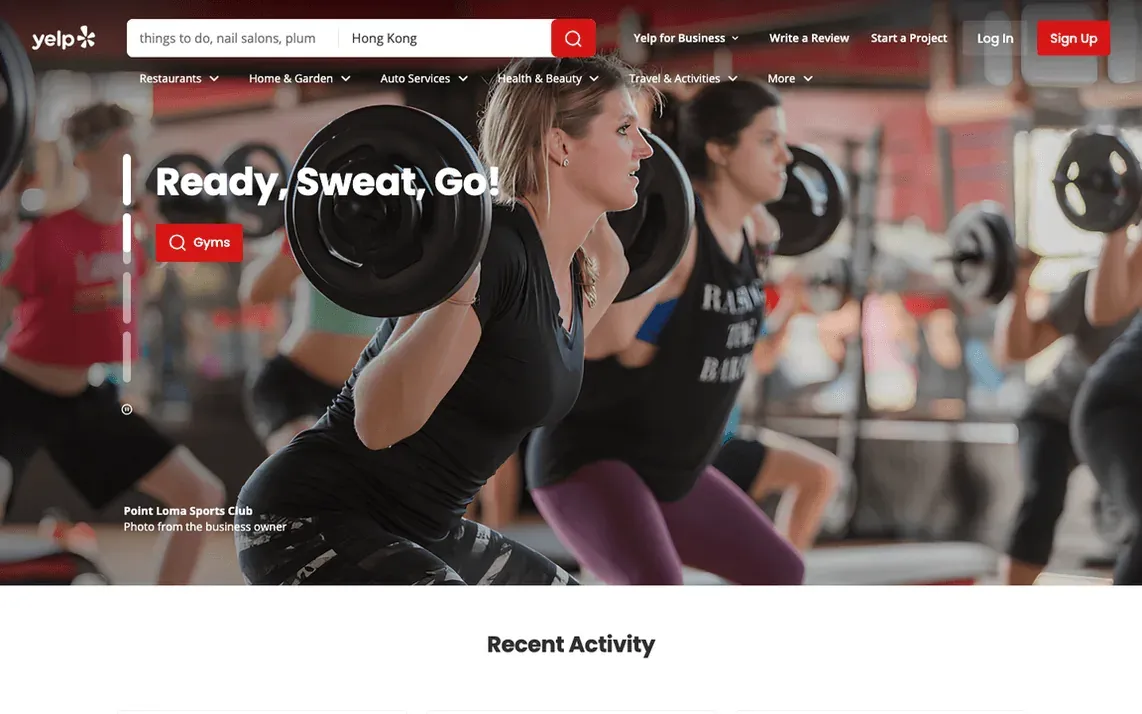 Yelp là kho báu cho những ai quan tâm đến dữ liệu doanh nghiệp địa phương, review và xếp hạng.
Bạn có thể scrape gì:
- Tên doanh nghiệp, danh mục, điểm đánh giá và địa chỉ.
- Review của người dùng (nội dung, ngày, số sao).
- Hình ảnh và mức giá.
Thách thức:
- Yelp đã tăng cường phòng vệ chống scraping, bao gồm CAPTCHA và giới hạn tốc độ API (Reddit).
- Phù hợp nhất để luyện cấu hình công cụ và scrape một cách tôn trọng.
Lợi ích kinh doanh:
- Nghiên cứu thị trường địa phương, tạo lead và phân tích cảm xúc.
9. Stack Overflow: Scrape Q&A và insight cho developer
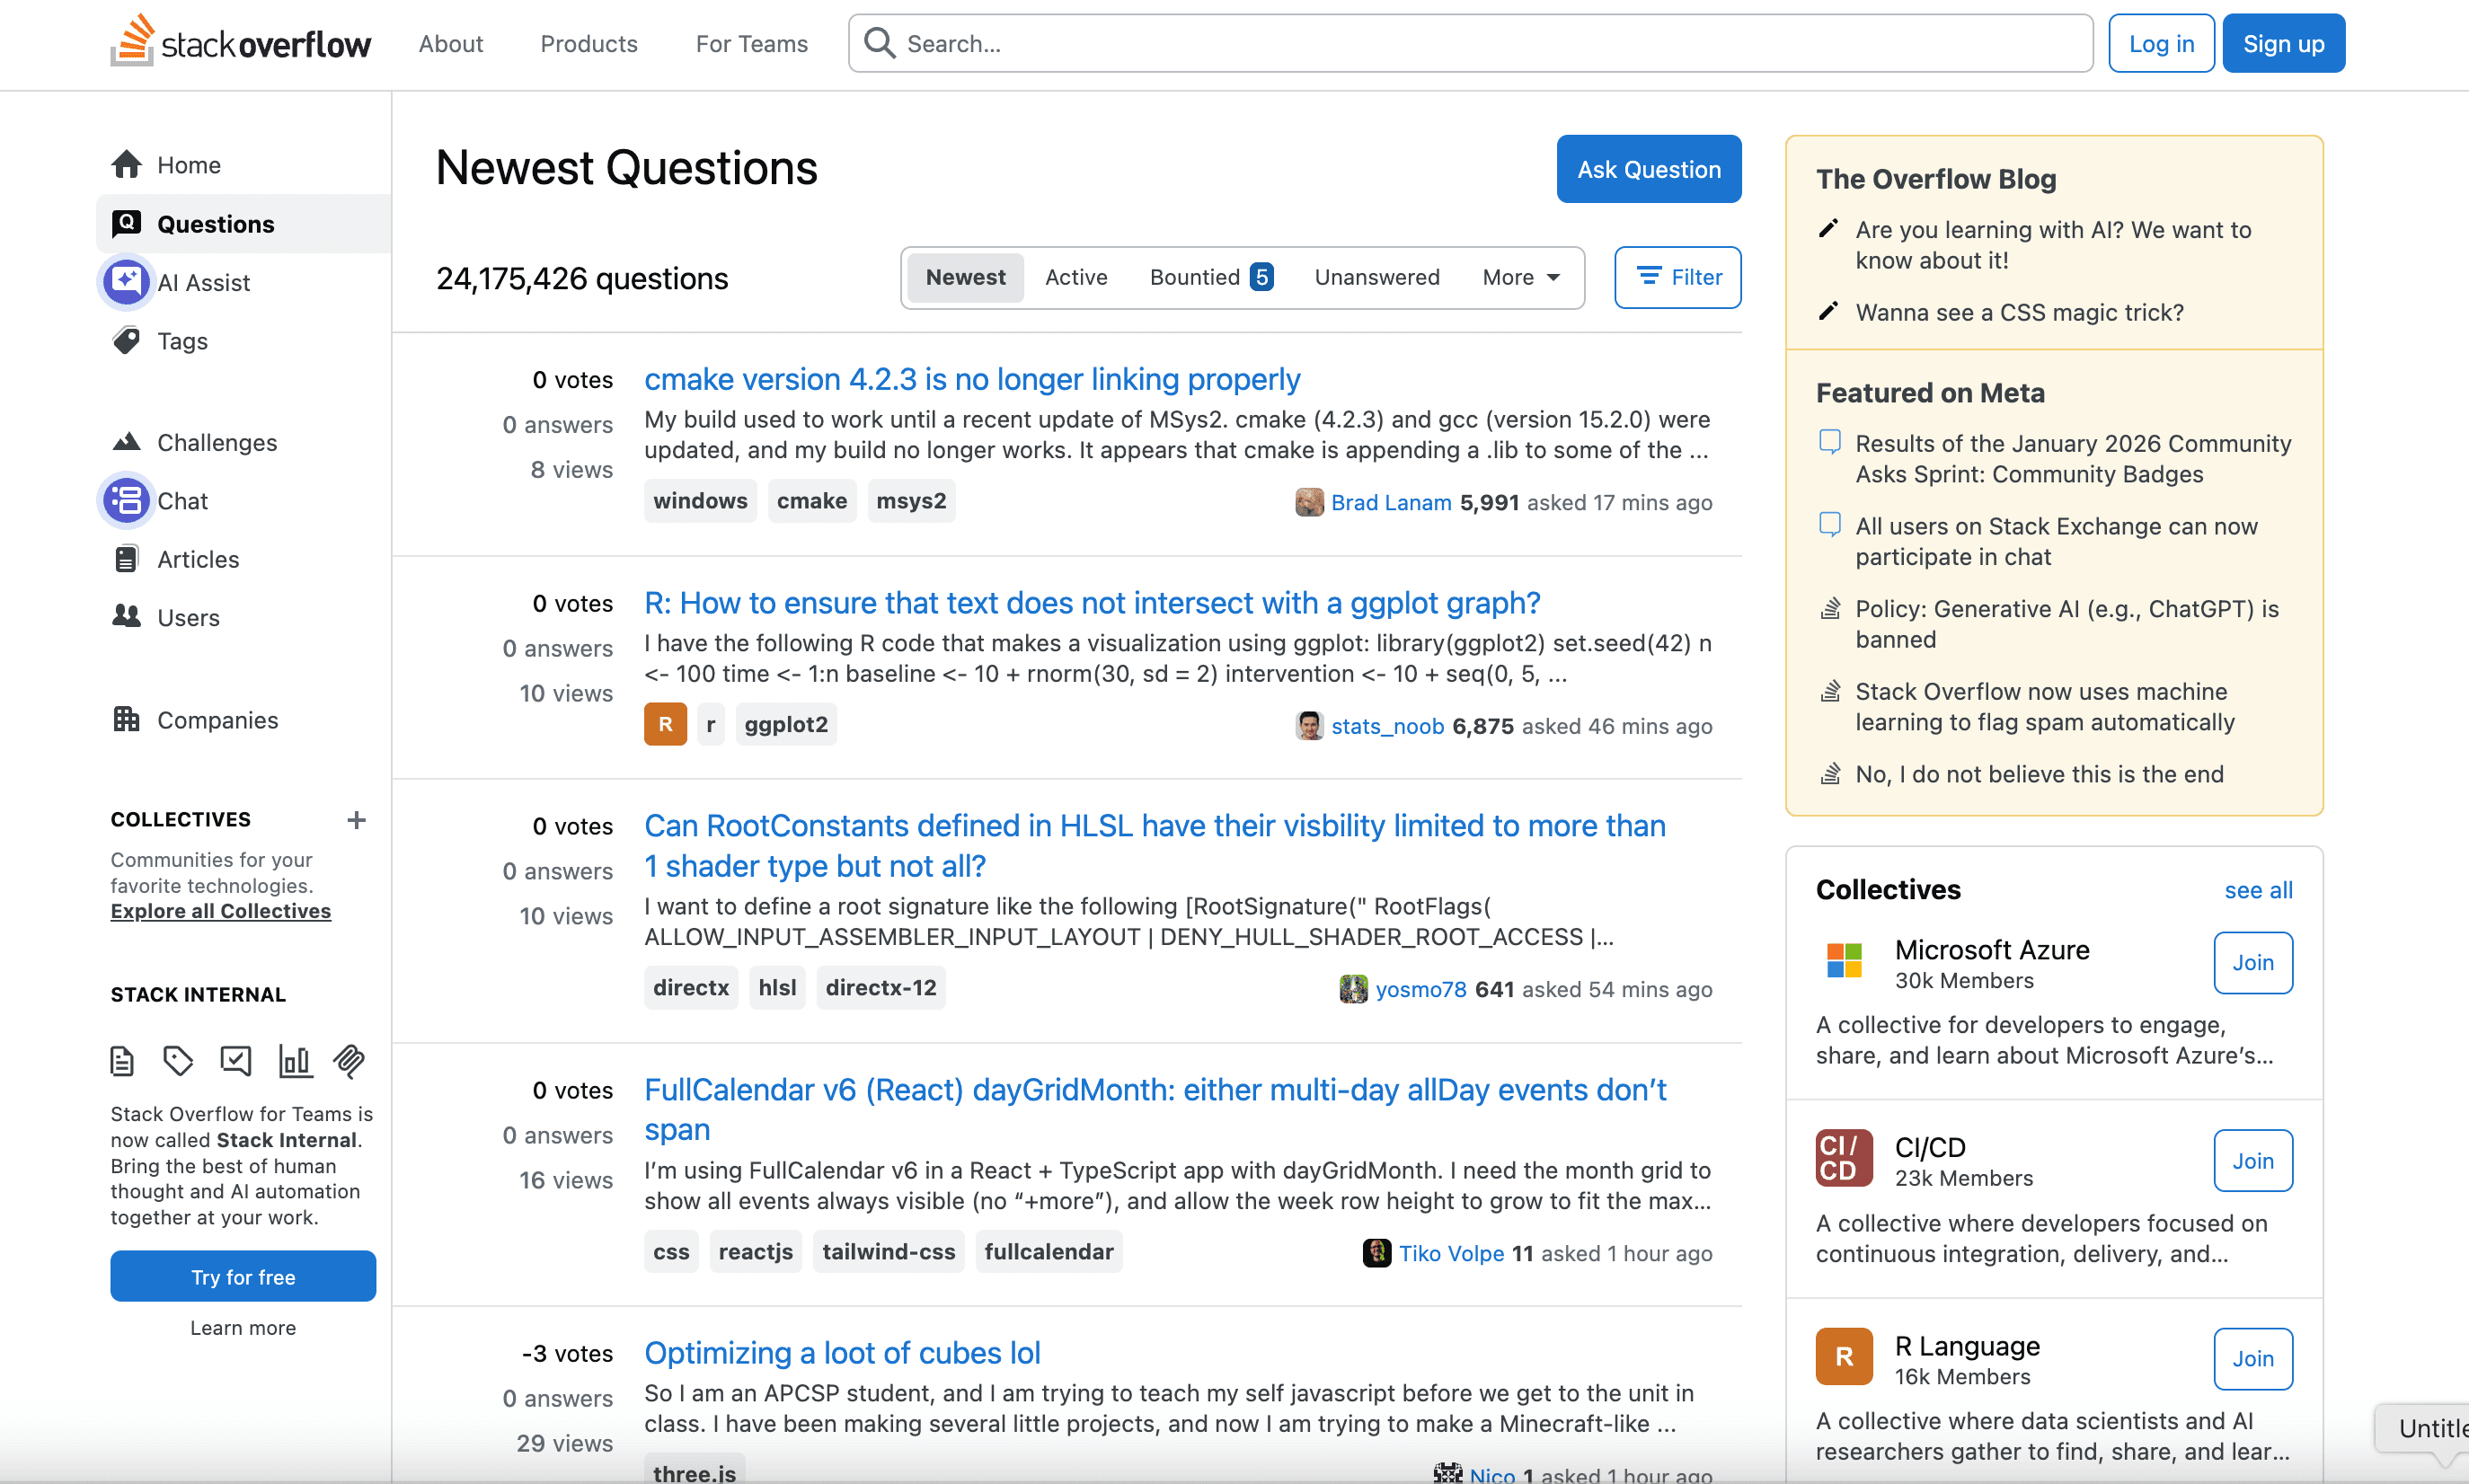 Stack Overflow là trang Q&A lớn nhất thế giới dành cho lập trình viên — và cũng là một web scraping test site tuyệt vời.
Cơ hội thực hành:
- Scrape câu hỏi, câu trả lời, tag và hồ sơ người dùng.
- Xử lý phân trang và bình luận lồng nhau.
- Dùng public API để truy cập dữ liệu có trách nhiệm.
Vì sao hữu ích:
- Giúp bạn học cách scrape forum và các cộng đồng trực tuyến.
- Rất tốt để xây dựng bộ dữ liệu phục vụ phân tích xu hướng hoặc khai thác tri thức.
Stack Overflow phần lớn là HTML tĩnh nên khá thân thiện với người mới, nhưng quy mô và cấu trúc của nó vẫn mang đến nhiều thử thách nâng cao.
10. Rotten Tomatoes: Scrape review phim và rating
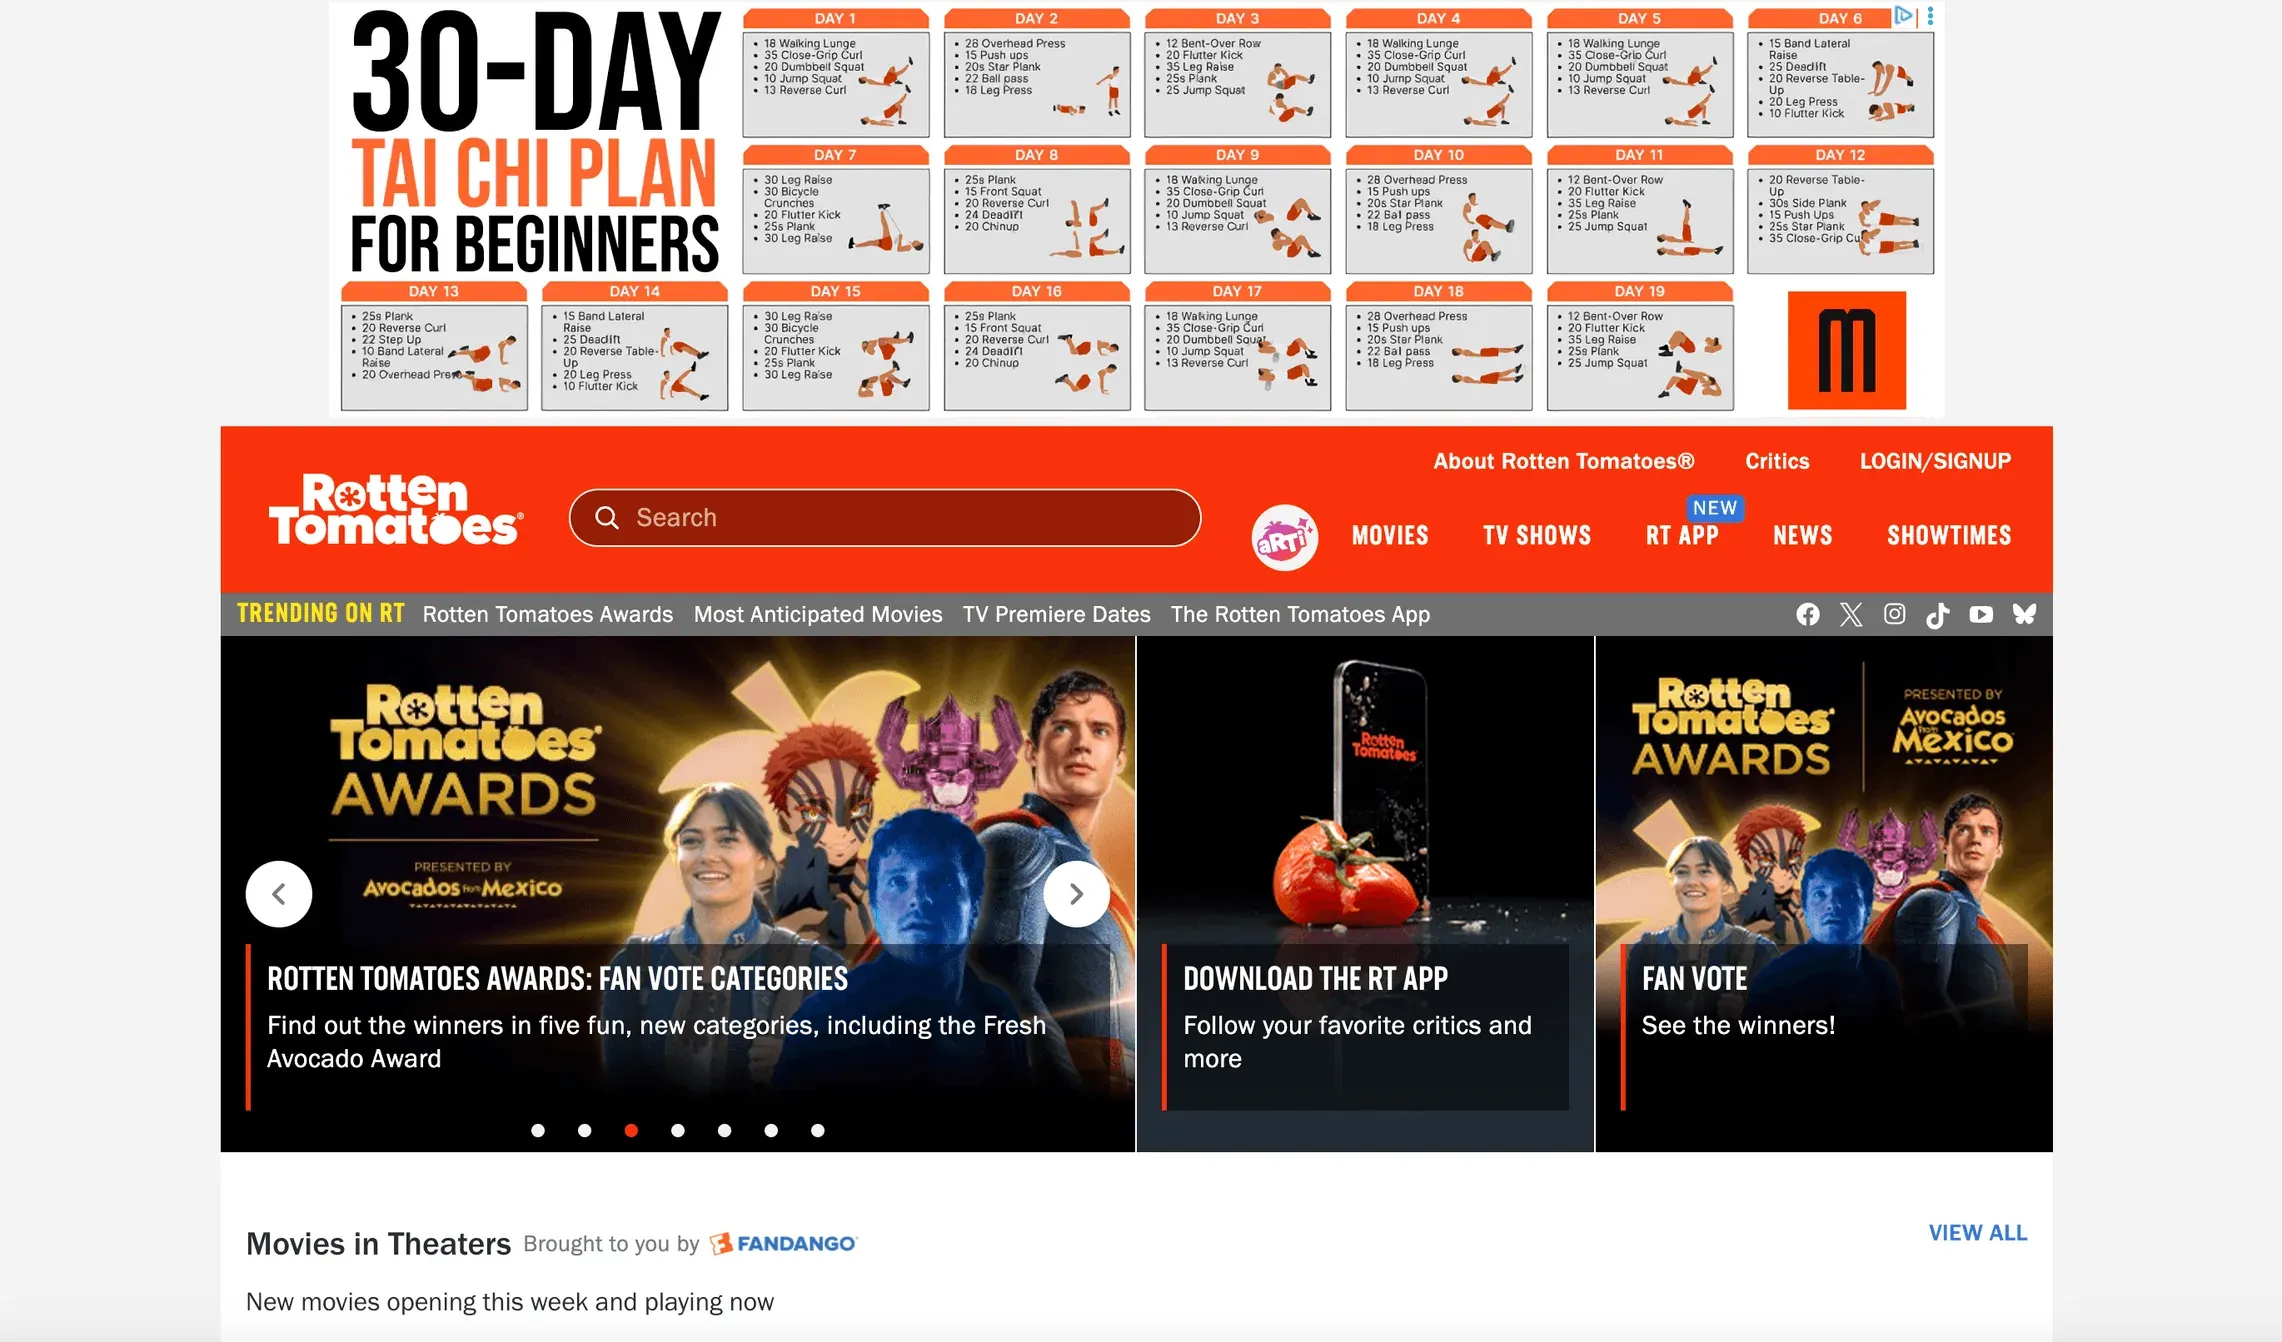 Rotten Tomatoes là trang quen thuộc để xem điểm phim, review của giới phê bình và điểm số từ khán giả.
Bạn sẽ tìm thấy gì:
- Tên phim, điểm của giới phê bình/khán giả và đoạn trích review.
- Nội dung động, được tải qua AJAX và các API ẩn.
- Một số tính năng cần đăng nhập hoặc kỹ thuật scraping nâng cao (Reddit).
Bài tập thực hành:
- Trích xuất rating phim và đoạn review ngắn.
- Reverse-engineer các API call để lấy dữ liệu JSON.
- Xử lý nội dung động và cơ chế chống bot.
Rotten Tomatoes là một bài test tổng kết — nếu scrape được site này, bạn gần như đã sẵn sàng cho mọi dự án trích xuất dữ liệu.
Bảng so sánh: Tổng quan các website luyện web scraping
| Website | Kiểu dữ liệu | Độ phức tạp | Chống scraping | Tình huống sử dụng tốt nhất |
|---|---|---|---|---|
| Thunderbit | Bất kỳ loại nào (văn bản, ảnh, email, số điện thoại, v.v.) | Mọi cấp độ | Không áp dụng (là công cụ, không phải site) | Luyện trên mọi site, test workflow |
| Codeforces | Bảng, xếp hạng, thống kê người dùng | Trung bình | Thấp | Parse dữ liệu có cấu trúc, contest |
| Books to Scrape | Tên sách, giá, đánh giá, danh mục | Thấp | Không có | Scrape ecommerce cho người mới |
| HackerRank | Bài toán, hồ sơ người dùng, leaderboard | Cao | Đăng nhập, nhiều JS | Nội dung động, xác thực |
| Web Scraper Test | Sản phẩm, bảng, trang lồng nhau | Thay đổi | Không có | Benchmark công cụ, tĩnh/động |
| eBay | Listing, giá, ảnh, thông tin người bán | Cao | CAPTCHA, giới hạn tốc độ | Ecommerce thực tế, theo dõi giá |
| Amazon | Sản phẩm, review, ảnh, giá | Rất cao | Chặn IP, fingerprinting | Scraping ecommerce nâng cao |
| Yelp | Doanh nghiệp, review, rating, ảnh | Cao | CAPTCHA, giới hạn API | Dữ liệu doanh nghiệp địa phương, review |
| Stack Overflow | Q&A, tag, thống kê người dùng | Trung bình | Thấp, có API | Scrape forum, insight cho developer |
| Rotten Tomatoes | Phim, rating, review, giới phê bình | Cao | AJAX, API ẩn | Phân tích review, nội dung động |
Kết luận: Nâng cấp kỹ năng của bạn với các website luyện web scraping phù hợp
Nếu bạn muốn giỏi web scraping, không có con đường nào tốt hơn thực hành trực tiếp. Những site ở trên tạo thành một lộ trình đi từ môi trường an toàn cho người mới đến “chiến trường” thực sự đầy cơ chế chống bot. Hãy bắt đầu với thứ gì đó đơn giản như Books to Scrape, rồi dần tiến lên các “ông lớn” động như Amazon hoặc Rotten Tomatoes.
Đừng quên: công cụ bạn dùng quan trọng không kém gì website bạn luyện tập. Thunderbit là lựa chọn hàng đầu của tôi cho người dùng doanh nghiệp và bất kỳ ai muốn đi nhanh, tự động hóa workflow và xử lý cả những website rối rắm nhất. Nhưng dù bạn chọn gì, hãy tiếp tục thử nghiệm, tiếp tục học hỏi và luôn scrape có trách nhiệm — tôn trọng robots.txt, rate limit và quyền riêng tư.
Muốn đi sâu hơn nữa? Hãy xem Thunderbit Blog để đọc thêm hướng dẫn, hoặc tham gia cộng đồng web scraping để trao đổi mẹo và thử thách. Web là sân chơi của bạn — hãy đi scrape thứ gì đó thật tuyệt.
Dùng thử Thunderbit Agentic Web Scraper miễn phí Get Started Free
Câu hỏi thường gặp
1. Vì sao tôi nên luyện web scraping trên các website mẫu thay vì site kinh doanh thật?
Các website mẫu được thiết kế cho việc thực hành an toàn và hợp pháp. Chúng giúp bạn xây dựng kỹ năng, test công cụ và thử nghiệm mà không lo bị chặn hay gặp rắc rối pháp lý. Khi đã tự tin, bạn có thể xử lý các dự án thực tế một cách có trách nhiệm hơn.
2. Điều gì khiến Thunderbit trở thành một web scraping test site tốt?
Thunderbit không chỉ là một site test — nó là công cụ chạy bằng AI cho phép bạn luyện scraping trên bất kỳ website nào, từ đơn giản đến phức tạp. Các tính năng như One Click Extract, scrape subpage và xuất dữ liệu ngay lập tức khiến nó rất phù hợp cho cả người mới lẫn người dùng nâng cao.
3. Làm sao xử lý các biện pháp chống scraping trên site như eBay hay Amazon?
Hãy bắt đầu bằng cách tôn trọng rate limit và robots.txt. Với những site khó hơn, bạn có thể cần dùng proxy, xoay user agent hoặc mô phỏng hành vi trình duyệt. Việc luyện trên những site này sẽ giúp bạn học cách điều chỉnh phương pháp của mình.
4. Web scraping có rủi ro pháp lý không?
Luôn kiểm tra điều khoản sử dụng và robots.txt của website. Chỉ nên luyện trên các trang công khai, không cần đăng nhập, và tránh scrape dữ liệu cá nhân hoặc nhạy cảm. Khi không chắc chắn, hãy dùng các site mẫu hoặc API chính thức.
5. Cách tốt nhất để nâng cấp kỹ năng web scraping là gì?
Bắt đầu với các site dành cho người mới như Books to Scrape, sau đó chuyển sang dữ liệu có cấu trúc (Codeforces), nội dung động (HackerRank) và các thử thách thực tế (Amazon, Yelp). Dùng những công cụ như Thunderbit để tự động hóa và tối ưu quy trình, đồng thời tiếp tục học hỏi từ cộng đồng.
Chúc bạn scraping vui vẻ — và mong rằng dữ liệu của bạn luôn sạch, có cấu trúc rõ ràng và sẵn sàng để hành động.
Tìm hiểu thêm



