
Mạng web đang lớn nhanh đến mức ly cà phê sáng của tôi cũng phải chịu thua — mà tin tôi đi, tôi uống rất nhanh. Bước sang năm 2026, khai thác dữ liệu từ web không còn là thứ “có thì tốt” chỉ dành cho dân kỹ thuật nữa; nó đã thành “gia vị bí mật” đứng sau việc tìm khách hàng tiềm năng, theo dõi giá ecommerce, nghiên cứu thị trường và cả phân tích bất động sản. Với hơn 49% doanh nghiệp hiện đang dùng công cụ web scraping hằng tuần, một thư viện hay công cụ phù hợp có thể tạo ra khác biệt rất lớn: либо là bạn mất hàng giờ làm việc thủ công chán ngắt, hoặc là bạn có ngay một bảng tính đầy insight hữu ích — xong trước khi đối thủ kịp đi ăn trưa.
Nhưng điểm hay là thế này: các thư viện web scraping năm 2026 cực kỳ đa dạng, từ tiện ích Chrome AI không cần code cho tới những framework “nặng ký” dành cho lập trình viên. Dù bạn là nhân viên sales chỉ muốn có danh sách lead trong Excel, quản lý vận hành đang theo dõi 500 SKU, hay một cao thủ Python đang tự xây crawler riêng, đều sẽ có công cụ hợp gu. Tôi đã dành nhiều năm làm việc trong SaaS và automation — và cũng không ít đêm thức muộn đến mức không muốn nhớ lại — để tìm hiểu mảng này. Vậy nên, cùng điểm qua 10 thư viện web scraping hàng đầu bạn nên biết trong năm nay, và cách chọn công cụ giúp cuộc sống nhẹ đầu hơn.
Điều gì tạo nên một thư viện Web Scraping mạnh mẽ trong năm 2026?
Trích xuất dữ liệu từ bất kỳ website nào bằng AI Get Started Free
Trước khi vào danh sách, hãy nói về những yếu tố thật sự đáng cân nhắc khi chọn một thư viện web scraping. Theo kinh nghiệm của tôi, những công cụ tốt nhất trong năm 2026 thường có vài điểm chung:
- Dễ dùng: Người không biết code có lấy được kết quả trong vài phút không? Hay phải có bằng tiến sĩ Python mới dám đụng vào?
- Xử lý nội dung động: Có scrape được các trang hiện đại, dùng nhiều JavaScript không? Hay sẽ “đứng hình” trước bất cứ thứ gì phức tạp hơn HTML tĩnh?
- Hỗ trợ ngôn ngữ và nền tảng: Có chạy tốt trong ngôn ngữ bạn thích — Python, JavaScript, Java — hoặc thậm chí ngay trên trình duyệt không?
- Khả năng mở rộng: Có xử lý hàng trăm, thậm chí hàng nghìn trang mà không hụt hơi không?
- Tích hợp và xuất dữ liệu: Có làm việc ngon với Excel, Google Sheets, Notion hay pipeline dữ liệu của bạn không?
- AI và tự động hóa: Trong năm 2026, những công cụ có AI và chỉ cần prompt tự nhiên để tự chạy là một lợi thế rất lớn — nhất là với người dùng doanh nghiệp không muốn đụng vào code.
Thực tế là, các đội kinh doanh lúc nào cũng muốn nhanh, chính xác và càng ít phải setup càng tốt. Càng ít thời gian phải sửa scraper lỗi hay loay hoay với code, bạn càng có nhiều thời gian để biến dữ liệu thành hành động. Và cùng với sự bùng nổ của AI và tự động hóa trình duyệt, ngay cả người không rành kỹ thuật cũng có thể scrape được những dữ liệu trước đây thường phải nhờ lập trình viên hỗ trợ (PromptCloud).
Được rồi — giờ thì đến phần đáng mong nhất.
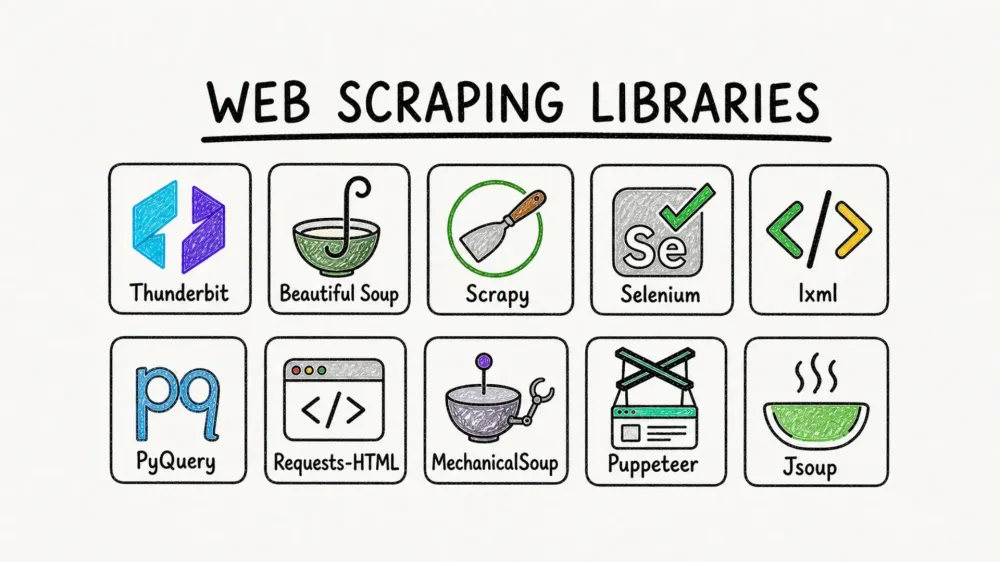
10 thư viện Web Scraping mạnh mẽ nhất nên dùng trong năm 2026
- Thunderbit dành cho web scraping không cần code, tích hợp AI ngay trong trình duyệt
- Beautiful Soup để phân tích HTML và làm sạch dữ liệu dễ dàng trong Python
- Scrapy cho crawler quy mô lớn, tốc độ cao và pipeline dữ liệu
- Selenium cho tự động hóa trình duyệt và scrape các site động, nhiều JavaScript
- lxml để phân tích XML/HTML cực nhanh trong Python
- PyQuery cho cách chọn HTML kiểu jQuery trong Python
- Requests-HTML cho bộ công cụ “tất cả trong một” gồm HTTP, phân tích HTML và render JavaScript trong Python
- MechanicalSoup để tự động hóa form và các tác vụ trình duyệt đơn giản trong Python
- Puppeteer để điều khiển Chrome headless trong Node.js
- Jsoup để phân tích HTML mạnh mẽ trong Java
1. Thunderbit

Thunderbit là lựa chọn tôi hay khuyên nhất cho bất kỳ ai muốn scrape dữ liệu web mà không cần viết dù chỉ một dòng code. Tiện ích AI-powered Chrome extension này cho phép bạn mô tả thứ mình cần (“Lấy tất cả tên sản phẩm, giá và hình ảnh từ trang này”), rồi AI sẽ lo phần còn lại. Không cần template, không cần cài đặt rườm rà — chỉ cần bấm một cái, chỉnh vài cột nếu muốn, và quá trình trích xuất sẽ chạy dù bạn có ngồi nhìn hay không.
Điểm khiến Thunderbit nổi bật trong năm 2026:
- Giao diện no-code, dùng ngôn ngữ tự nhiên: Ai cũng dùng được — sales, vận hành, marketing, bất động sản. Không cần Python.
- Tự động nhận diện trường dữ liệu: AI tự suy ra bộ cột ngay từ cấu trúc trang.
- Scrape trang con: Cần thêm chi tiết? Thunderbit có thể đi qua từng trang con (như trang sản phẩm hoặc hồ sơ) và tự động làm giàu bảng dữ liệu của bạn (Thunderbit Blog).
- Template có sẵn cho các website phổ biến: Amazon, Zillow, Shopify và nhiều hơn nữa — scrape chỉ với một cú nhấp.
- Xuất sang Excel, Google Sheets, Notion, Airtable: Dữ liệu đi thẳng đến nơi team của bạn đang làm việc.
- Hỗ trợ 34 ngôn ngữ: Rất hợp cho đội ngũ toàn cầu.
- Scrape trên cloud hoặc ngay trên trình duyệt: Chọn cách phù hợp với workflow của bạn — cloud rất nhanh cho site công khai, còn chế độ trình duyệt xử lý đăng nhập tốt hơn.
Thunderbit đã được hơn 200.000 người dùng trên toàn thế giới tin cậy, và gói miễn phí cho phép bạn scrape tối đa 6 trang (hoặc 10 trang nếu có ưu đãi dùng thử). Nếu bạn muốn xem web scraping hiện đại trông ra sao, đây là nơi tôi sẽ bắt đầu.
Dùng thử Thunderbit AI Web Scraper miễn phí
2. Beautiful Soup
Beautiful Soup là một thư viện Python kinh điển, được dân data và analyst yêu thích vì sự đơn giản nhưng rất mạnh tay khi xử lý HTML lộn xộn. Nếu bạn từng cố kéo dữ liệu từ một trang có tag lỗi hoặc format kỳ quặc, Beautiful Soup đúng kiểu “người bạn cứu cánh”.
Điểm mạnh của Beautiful Soup:
- Xử lý HTML không chuẩn: Rất hợp để làm sạch và trích xuất dữ liệu từ những trang web “khó nhìn” (Beautiful Soup Docs).
- Dễ học: Ngay cả người mới học Python cũng có thể bắt đầu nhanh.
- Linh hoạt: Kết hợp tốt với các HTTP client như Requests, và có thể dùng chung với lxml để tăng tốc.
- Trường hợp sử dụng điển hình: Trích xuất dữ liệu nhanh, làm sạch dữ liệu web, tích hợp trong các script nhỏ.
Nếu bạn đang làm việc với trang tĩnh hoặc cần xử lý markup lộn xộn, Beautiful Soup là lựa chọn rất chắc tay.
3. Scrapy
Scrapy là “ông lớn” trong thế giới web scraping bằng Python. Đây là một framework đầy đủ tính năng để xây dựng crawler và data pipeline có khả năng mở rộng. Nếu bạn cần scrape hàng nghìn trang, lần theo liên kết và xử lý dữ liệu ở quy mô lớn, Scrapy sinh ra là để làm việc đó.
Vì sao Scrapy là lựa chọn hàng đầu:
- Tính mô-đun cao: Có thể xây dựng spider, pipeline và middleware phức tạp (Scrapy Docs).
- Xử lý tốt dự án lớn: Hợp cho nghiên cứu thị trường, phân tích đối thủ hoặc bất kỳ công việc nào cần crawl và trích xuất từ nhiều website.
- Bất đồng bộ và nhanh: Được thiết kế cho tốc độ và hiệu suất.
- Cộng đồng lớn: Có rất nhiều plugin, tài liệu hướng dẫn và hỗ trợ.
Scrapy có độ khó ban đầu nhất định, nhưng với những bài toán lớn, nó là một cỗ máy cực mạnh.
4. Selenium
Selenium là công cụ quen mặt để tự động hóa trình duyệt. Nó được dùng từ test web app cho tới scrape các website yêu cầu đăng nhập, click chuột hoặc xử lý pop-up. Nếu bạn cần tương tác với các site nhiều JavaScript hoặc rất động, Selenium có thể mô phỏng hành vi người dùng thật (ScrapingBee Selenium Guide).
Điểm mạnh của Selenium:
- Tự động hóa trình duyệt thật: Chrome, Firefox, Safari, Edge — gần như trình duyệt nào cũng có.
- Xử lý đăng nhập, pop-up và thao tác người dùng: Rất hữu ích khi scrape sau bước xác thực hoặc đi qua flow nhiều bước.
- Hỗ trợ nhiều ngôn ngữ: Python, Java, C# và nhiều hơn nữa.
- Phù hợp nhất cho: Website chặn scraper đơn giản, hoặc khi bạn cần mô phỏng hành vi người dùng thực.
Nó nặng hơn các thư viện dựa trên HTTP, nhưng đôi khi bạn thật sự cần một trình duyệt thật.
5. lxml
lxml là một trình phân tích XML và HTML hiệu năng cao cho Python. Nếu ưu tiên số một của bạn là tốc độ — ví dụ như xử lý hàng nghìn tài liệu lớn — thì lxml rất khó bị vượt qua (Python HTML Parser Performance).
Vì sao lxml được ưa chuộng:
- Cực nhanh: Nhanh hơn phần lớn parser Python khác, nhất là với file lớn.
- Ổn định và mạnh: Hỗ trợ cả XML lẫn HTML, đồng thời dễ tích hợp với các công cụ khác.
- Phù hợp cho: Xử lý bộ dữ liệu lớn, kết hợp với Beautiful Soup hoặc Scrapy để tăng lực.
Nếu bạn scrape ở quy mô lớn hoặc cần xử lý file khổng lồ, lxml gần như là món đồ không thể thiếu trong bộ công cụ.
6. PyQuery
PyQuery mang sức mạnh cú pháp selector của jQuery vào Python. Nếu bạn thích cách chọn phần tử siêu gọn như $('.class') trong jQuery, PyQuery cho phép bạn làm điều tương tự trong script scrape của mình (PyQuery Docs).
Điểm nổi bật của PyQuery:
- Selector kiểu jQuery: Rất trực quan với ai từng làm front-end.
- Code ngắn gọn, dễ đọc: Giúp các truy vấn phức tạp trở nên đơn giản hơn.
- Tích hợp với lxml: Bên dưới vẫn rất nhanh và hiệu quả.
- Phù hợp nhất cho: Dự án cần thao tác HTML nhanh, theo phong cách giống jQuery trong Python.
Đây là cầu nối rất tốt cho những ai chuyển từ web development sang trích xuất dữ liệu.
7. Requests-HTML
Requests-HTML là một thư viện Python kết hợp sự tiện lợi của Requests (cho HTTP) với khả năng phân tích HTML tích hợp sẵn, thậm chí còn có cả render JavaScript.
Điểm khác biệt của Requests-HTML:
- Tất cả trong một: Lấy trang, phân tích HTML và thậm chí render JavaScript trong cùng một gói.
- Thân thiện với người mới: Hợp cho các dự án scrape quy mô nhỏ đến vừa.
- Rất tốt cho: Script nhanh, website có một phần nội dung động và người dùng thích sự đơn giản.
Nếu bạn mới bắt đầu hoặc cần một công cụ linh hoạt cho công việc nhỏ hơn, Requests-HTML là lựa chọn rất đáng tiền.
8. MechanicalSoup
MechanicalSoup là một thư viện Python để tự động hóa web form và các tương tác trình duyệt đơn giản. Nó được xây dựng dựa trên Beautiful Soup và Requests, nên rất dễ dùng để đăng nhập, điền form và điều hướng các quy trình cơ bản (ScrapingBee MechanicalSoup Guide).
Vì sao MechanicalSoup hữu ích:
- Tự động hóa form và đăng nhập: Rất hợp khi scrape dữ liệu nằm sau lớp xác thực.
- API đơn giản: Người mới cũng dễ tiếp cận.
- Phù hợp nhất cho: Các tác vụ trình duyệt lặp đi lặp lại, workflow đơn giản, và những trang mà dùng full browser automation thì hơi “quá tay”.
Nó không mạnh bằng Selenium trên các site phức tạp, nhưng nhẹ hơn và dễ dùng hơn nhiều cho nhu cầu cơ bản.
9. Puppeteer
Puppeteer là thư viện Node.js để điều khiển Chrome hoặc Chromium ở chế độ headless. Đây là công cụ được nhiều người ưa chuộng khi scrape các website nhiều JavaScript và tương tác cao (Scrape.do Puppeteer Guide).
“Siêu năng lực” của Puppeteer:
- Tự động hóa trình duyệt toàn diện: Click, cuộn trang, điền form và tương tác như người dùng thật.
- Xử lý nội dung động: Rất hợp với các site tải dữ liệu bằng JavaScript.
- Rất tốt cho: Ecommerce, mạng xã hội, hoặc bất kỳ website nào khiến scraper truyền thống bó tay.
Nếu bạn là lập trình viên JavaScript hoặc cần scrape “web hiện đại”, Puppeteer là công cụ gần như phải có.
10. Jsoup
Jsoup là tiêu chuẩn vàng cho việc phân tích HTML trong Java. Nó giống như Beautiful Soup, nhưng dành cho các lập trình viên Java (Baeldung Jsoup Guide).
Vì sao các đội Java thích Jsoup:
- API đơn giản nhưng mạnh: Trích xuất và xử lý dữ liệu chỉ với vài dòng code.
- Xử lý HTML lộn xộn: Làm sạch và phân tích tốt ngay cả những trang có định dạng kém.
- Phù hợp nhất cho: Tích hợp scraping vào ứng dụng doanh nghiệp hoặc workflow backend viết bằng Java.
Nếu hệ sinh thái của bạn là Java, Jsoup là lựa chọn quá rõ ràng.
Bảng so sánh các thư viện Web Scraping
Dưới đây là bảng so sánh nhanh cả 10 thư viện:
| Thư viện | Ngôn ngữ | Dễ sử dụng | Nội dung động | AI/No-code | Trường hợp sử dụng điển hình | Phù hợp nhất cho |
|---|---|---|---|---|---|---|
| Thunderbit | Tiện ích Chrome | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | Có | Sales, vận hành, nghiên cứu, bất động sản | Người không biết code, người dùng doanh nghiệp |
| Beautiful Soup | Python | ⭐⭐⭐⭐ | ⭐ | Không | Phân tích HTML, làm sạch dữ liệu | Người mới học Python, chuyên viên phân tích |
| Scrapy | Python | ⭐⭐⭐ | ⭐⭐ | Không | Crawl quy mô lớn, pipeline | Lập trình viên, dự án dữ liệu lớn |
| Selenium | Đa ngôn ngữ | ⭐⭐ | ⭐⭐⭐⭐⭐ | Không | Tự động hóa trình duyệt, đăng nhập | QA, scrape site động |
| lxml | Python | ⭐⭐⭐ | ⭐ | Không | Phân tích nhanh, file lớn | Người dùng nâng cao, bộ dữ liệu lớn |
| PyQuery | Python | ⭐⭐⭐⭐ | ⭐ | Không | Chọn phần tử kiểu jQuery | Web dev, script ngắn gọn |
| Requests-HTML | Python | ⭐⭐⭐⭐ | ⭐⭐ | Không | Script nhanh, render JS | Người mới, dự án nhỏ |
| MechanicalSoup | Python | ⭐⭐⭐⭐ | ⭐⭐ | Không | Tự động form, đăng nhập | Tác vụ trình duyệt đơn giản |
| Puppeteer | Node.js | ⭐⭐⭐ | ⭐⭐⭐⭐⭐ | Không | Site nhiều JS, tự động hóa | Lập trình viên JS, scrape web động |
| Jsoup | Java | ⭐⭐⭐⭐ | ⭐ | Không | Phân tích HTML trong Java | Đội ngũ Java, workflow backend |
Cách chọn thư viện Web Scraping phù hợp cho doanh nghiệp của bạn
Data Scraping là gì và làm như thế nào trong năm 2025 Get Started Free
Vậy nên dùng thư viện nào? Dưới đây là lời khuyên của tôi, đúc kết từ nhiều năm thử sai và không ít phiên debug kéo dài tới khuya:
- Người không biết code hoặc người dùng doanh nghiệp: Hãy bắt đầu với Thunderbit. Cách tiếp cận AI/no-code giúp bạn có kết quả trong vài phút thay vì vài ngày. Nếu team của bạn chỉ cần dữ liệu trong Excel hoặc Sheets, đừng làm mọi thứ phức tạp hơn mức cần thiết.
- Lập trình viên Python: Beautiful Soup và Requests-HTML rất hợp cho các việc nhỏ. Scrapy là người bạn đồng hành cho dự án lớn. Kết hợp thêm lxml hoặc PyQuery để tăng sức mạnh.
- Cần xử lý đăng nhập hoặc nội dung động? Selenium (đa ngôn ngữ) hoặc Puppeteer (Node.js) là lựa chọn tốt nhất.
- Đội ngũ Java: Jsoup là lựa chọn rõ ràng nhất để tích hợp scraping vào ứng dụng Java.
- Cần tự động hóa form hoặc quy trình đơn giản? MechanicalSoup nhẹ và dễ dùng.
Những yếu tố quan trọng cần cân nhắc:
- Mức độ thành thạo kỹ thuật: Công cụ no-code như Thunderbit rất hợp với team không chuyên kỹ thuật. Lập trình viên có thể thích sự linh hoạt của thư viện code-based.
- Độ phức tạp của dữ liệu: Với trang tĩnh đơn giản, Beautiful Soup hoặc Jsoup là lựa chọn tốt. Với site động, nhiều JavaScript, hãy dùng Selenium hoặc Puppeteer.
- Quy mô: Scrapy và lxml nổi bật khi xử lý việc lớn, tốc độ cao.
- Tích hợp: Thunderbit xuất trực tiếp sang Sheets, Notion và Airtable, giúp tiết kiệm rất nhiều thời gian cho workflow doanh nghiệp.
Để tìm hiểu sâu hơn về cách chọn công cụ phù hợp, hãy xem hướng dẫn của PromptCloud.
Xem giá Thunderbit và gói miễn phí
Kết luận: Mở khóa dữ liệu web bằng công cụ phù hợp
Web scraping trong năm 2026 không còn chỉ dành cho lập trình viên hay nhà khoa học dữ liệu nữa. Với sự bùng nổ của các công cụ AI và no-code, mọi team — từ sales đến nghiên cứu — đều có thể khai thác kho dữ liệu khổng lồ của web. Thư viện phù hợp có thể giúp bạn tiết kiệm hàng trăm giờ mỗi năm (Browsercat), tăng độ chính xác và mang lại lợi thế thật sự cho doanh nghiệp.
Lời khuyên của tôi? Hãy bắt đầu từ nhu cầu của bạn — tốc độ, quy mô, mức độ thoải mái với kỹ thuật — rồi thử vài lựa chọn khác nhau. Gói miễn phí của Thunderbit là cách rất tuyệt để bắt đầu, còn các thư viện mã nguồn mở như Beautiful Soup hay Scrapy luôn sẵn sàng nếu bạn muốn tự tay “làm cho ra trò”.
Muốn tìm hiểu sâu hơn? Hãy xem Thunderbit Blog để đọc thêm nhiều bài hướng dẫn, hoặc đăng ký kênh YouTube của chúng tôi để xem tutorial thực hành.
Chúc bạn scrape vui vẻ — và mong rằng dữ liệu của bạn luôn sạch, có cấu trúc và sẵn sàng để hành động.
Dùng thử Thunderbit AI Web Scraper miễn phí Get Started Free
Câu hỏi thường gặp
1. Thư viện web scraping nào dễ dùng nhất cho người không biết code trong năm 2026?
Thunderbit là lựa chọn hàng đầu cho người không biết code. Tiện ích Chrome tích hợp AI của nó cho phép người dùng scrape dữ liệu bằng prompt ngôn ngữ tự nhiên — không cần viết code.
2. Thư viện nào tốt nhất để scrape các website nhiều JavaScript hoặc động?
Puppeteer (Node.js) và Selenium (đa ngôn ngữ) là lựa chọn tốt nhất cho các site động, render bằng JavaScript. Chúng điều khiển trình duyệt thật và xử lý tương tác phức tạp.
3. Beautiful Soup khác gì so với Scrapy?
Beautiful Soup rất hợp để phân tích và trích xuất dữ liệu từ từng trang riêng lẻ hoặc dự án nhỏ, nhất là khi HTML lộn xộn. Scrapy là một framework hoàn chỉnh để xây dựng crawler có khả năng mở rộng và xử lý bộ dữ liệu lớn.
4. Tôi có thể xuất dữ liệu scrape trực tiếp sang Google Sheets hoặc Notion không?
Có — Thunderbit hỗ trợ xuất trực tiếp sang Google Sheets, Notion, Airtable và Excel. Phần lớn thư viện code sẽ yêu cầu bạn tự viết logic xuất dữ liệu.
5. Làm sao chọn thư viện web scraping phù hợp cho doanh nghiệp của tôi?
Hãy cân nhắc kỹ năng kỹ thuật, độ phức tạp của website cần scrape, khối lượng dữ liệu và nhu cầu tích hợp. Công cụ no-code như Thunderbit rất lý tưởng cho team kinh doanh, còn lập trình viên có thể thích các thư viện như Scrapy, Beautiful Soup hoặc Puppeteer để có nhiều quyền kiểm soát hơn.
Tìm hiểu thêm
- Top 10 thư viện Web Scraping Python & một lựa chọn thay thế bằng AI
- 7 công cụ Web Scraping phổ biến nhất nên dùng trong năm 2026
- Top 5 phần mềm khai thác dữ liệu web tốt nhất trong năm 2026
- Những công cụ và phần mềm Web Scraping tốt nhất năm 2025
- Cách trích xuất dữ liệu website hiệu quả với các công cụ hàng đầu



