
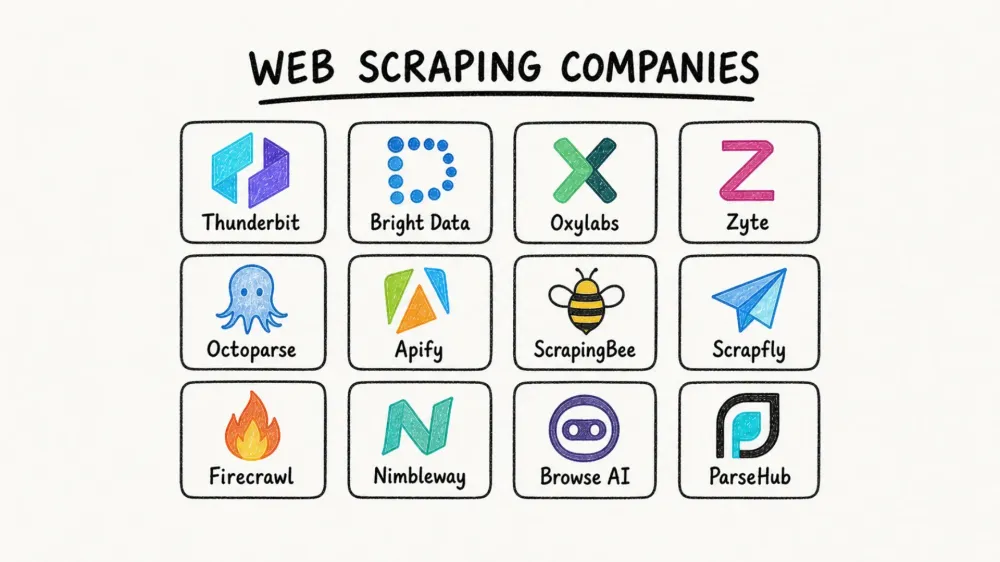
Thị trường web scraping đã chạm mốc 754 triệu USD vào năm 2024 và được dự đoán sẽ đạt 2,87 tỷ USD vào năm 2034. Thế nhưng, phần lớn người mua vẫn chọn sai nhà cung cấp ngay từ lần đầu.
Sự lệch pha này không có gì khó hiểu. “Công ty web scraping” là một khái niệm rất rộng, bao gồm mọi thứ từ một tiện ích Chrome Extension cài trong 10 giây cho đến một hệ thống dữ liệu doanh nghiệp trị giá hàng triệu USD. Cộng thêm bảng giá mập mờ, scraper thường xuyên bị gãy (một người dùng trên Reddit cho biết có tới 10–15% scraper hỏng mỗi tuần), và hàng trăm nhà cung cấp đều tuyên bố rằng họ có thể “scrape mọi website”, thì việc khách hàng bối rối là điều hoàn toàn dễ hiểu.
Tôi đang làm việc trong đội ngũ Thunderbit Official Website, nên tôi có cơ hội quan sát rất gần những câu hỏi mà người mua đặt ra trước khi quyết định — cũng như sự thất vọng họ mang theo từ những công cụ cũ đã ngừng hoạt động ngay khi website mục tiêu đổi giao diện. Bài viết này là tài nguyên mà tôi ước gì đã có lúc bắt đầu nghiên cứu thị trường: 12 công ty, 3 nhóm sản phẩm rõ ràng, giá thực tế cho năm 2026, một bảng so sánh thống nhất, và khung ra quyết định đủ thực tế để giúp bạn chọn đúng.
Vì Sao Việc Chọn Đúng Công Ty Web Scraping Lại Quan Trọng Trong Năm 2026
Web scraping không còn là một dự án phụ của dân lập trình. Nó đã trở thành một đầu vào kinh doanh phục vụ tình báo giá, tạo lead, nghiên cứu thị trường, tổng hợp nội dung, và ngày càng nhiều hơn là các pipeline cho AI và LLM. Market.us cho rằng riêng price monitoring và dynamic pricing đã chiếm 25,8% thị trường web scraping. Mordor Intelligence dự báo quy mô thị trường năm 2026 đạt 1,17 tỷ USD, trong đó mảng theo dõi giá và đối thủ tăng trưởng với CAGR 19,23%. Hai đơn vị này dùng cách định nghĩa khác nhau, nên con số không trùng khớp — hãy xem cả hai như thước đo tương đối về quy mô, không phải số liệu tuyệt đối.
Lợi ích thì đo đếm được. Các case study của nhà cung cấp cho thấy con số rất cụ thể: Zyte báo cáo tiết kiệm 25% thời gian phát triển cho mỗi spider ở một nhà bán lẻ toàn cầu. Một case dùng Apify cho lead generation ghi nhận giảm hơn 40 giờ làm thủ công cho mỗi chu kỳ chiến dịch.
Nhưng những điểm đau cũng lặp lại gần như giống nhau:
- Scraper liên tục bị hỏng khi website mục tiêu đổi bố cục hoặc thêm lớp chống bot.
- Chi phí trở nên khó đoán khi mở rộng quy mô, đặc biệt với mô hình tính theo mức sử dụng.
- Nhiều công cụ vẫn mặc định rằng người dùng có thời gian kỹ thuật, trong khi đa số team kinh doanh không hề có.
Chọn sai nhóm sản phẩm — chứ không chỉ chọn sai nhà cung cấp — mới là sai lầm đắt giá nhất. Một team sales đăng ký API dành cho developer sẽ mất hàng tuần mới nhận ra họ cần công cụ no-code. Một team engineering chọn trình dựng bằng click-and-point sẽ chạm ngưỡng giới hạn dung lượng chỉ trong một tháng. Quyết định về nhóm sản phẩm phải đặt lên trước. Quyết định về nhà cung cấp mới là bước tiếp theo.
3 Nhóm Công Ty Web Scraping (và Vì Sao Điều Này Quan Trọng)
Trước khi đánh giá từng nhà cung cấp, bạn cần hiểu 3 mô hình vận hành đang ẩn sau cái nhãn duy nhất “công ty web scraping”. Nếu nhầm lẫn giữa chúng, bạn rất dễ mua sai ngay từ đầu.
| Nhóm | Bạn Nhận Được Gì | Phù Hợp Nhất Cho | Ví Dụ Trong Danh Sách Này |
|---|---|---|---|
| Dịch vụ trọn gói / managed scraping | Họ xây và duy trì scraper cho bạn; bạn nhận dữ liệu sạch, có cấu trúc | Team không có nguồn lực dev hoặc cần mục tiêu phức tạp, dung lượng lớn | Bright Data (datasets), Zyte, Nimbleway |
| Scraping API & hạ tầng | Bạn gọi API; họ lo proxy, render và chống bot | Developer muốn kiểm soát nhưng không muốn tự quản lý hạ tầng | ScrapingBee, Scrapfly, Oxylabs, Firecrawl, Apify |
| Công cụ no-code / chạy trên trình duyệt | Giao diện bấm-chọn; gần như không cần code | Người dùng kinh doanh trong sales, e-commerce, marketing, bất động sản | Thunderbit, Octoparse, Browse AI, ParseHub |
Công Ty Web Scraping Trọn Gói / Managed
Các nhà cung cấp này chịu trách nhiệm toàn bộ pipeline. Bạn chỉ cần xác định dữ liệu mình muốn; họ lo phần trích xuất, chống bot, render, bảo trì và bàn giao dữ liệu. Đổi lại, chi phí cao hơn nhưng gánh nặng vận hành gần như thấp nhất. Nếu team của bạn không có developer rảnh tay và cần dữ liệu từ những mục tiêu được bảo vệ mạnh ở quy mô lớn, đây là nhóm nên bắt đầu.
Nhà Cung Cấp Scraping API và Hạ Tầng
Bạn gửi một URL hoặc một tác vụ tới endpoint. Họ trả về HTML đã render, dữ liệu có cấu trúc, hoặc ảnh chụp màn hình — đồng thời xử lý proxy, render trình duyệt, retry, và CAPTCHA ở phía sau. Phần code tích hợp, logic phân tích dữ liệu và workflow phía sau vẫn do bạn quản lý. Đổi lại là chi phí trung bình, mức bảo trì trung bình đến cao, nhưng toàn quyền kiểm soát pipeline.
Công Cụ Web Scraping No-Code / Trên Trình Duyệt
Đây là nhóm được tạo ra cho người vận hành chứ không phải kỹ sư. Phần lớn dùng browser extension, trình dựng workflow trực quan, hoặc giao diện được AI hỗ trợ để tạo dữ liệu có cấu trúc rất nhanh. Đổi lại, thời gian khởi động nhanh nhất nhưng ngưỡng xử lý dung lượng thường thấp hơn các nhà cung cấp thiên về API.
Thunderbit nằm trọn trong nhóm thứ ba này. Bạn mở một trang, nhấp một lần, và AI tự xác định cần lấy những gì rồi điền vào bảng mà không cần thêm thao tác. Mục tiêu là giúp một nhân viên sales hoặc chuyên viên phân tích e-commerce đi từ trang web đến bảng tính chỉ trong vài phút, với khả năng xuất miễn phí sang Excel, Google Sheets, Airtable và Notion.
Dùng Thử AI Web Scraper của Thunderbit
Chúng Tôi Đánh Giá Các Công Ty Web Scraping Tốt Nhất Như Thế Nào
Chúng tôi áp dụng cùng 7 tiêu chí cho toàn bộ 12 nhà cung cấp.
| Tiêu chí | Vì Sao Quan Trọng |
|---|---|
| Loại công ty (trọn gói / API / no-code / extension) | Quyết định ai là người thực sự làm việc |
| Chống bot & xử lý proxy | Điểm đau kỹ thuật số 1 — bị chặn thường tốn thời gian hơn cả viết parser |
| Gánh nặng bảo trì | Scraper sẽ hỏng; câu hỏi chính là ai sửa chúng |
| Giá minh bạch (chi phí gói 2026 thực tế, có free tier hay không) | “Liên hệ sales” không phải là câu trả lời |
| Thân thiện với no-code | Phần lớn người mua là người không chuyên kỹ thuật |
| Định dạng xuất dữ liệu & tích hợp | Khả năng tương thích đầu ra quyết định toàn bộ workflow phía sau |
| Nhãn “phù hợp nhất cho” | Giúp người đọc nhanh chóng đối chiếu nhà cung cấp với tình huống sử dụng |
Các tiêu chí này phản ánh trực tiếp những gì người dùng phàn nàn trong cộng đồng công khai. Trên Hacker News, một cuộc thảo luận năm 2025 cho rằng API là hợp đồng còn scraping thì vốn dĩ mong manh. Trên GitHub, issue của Firecrawl với tiêu đề “All scraping engines failed!” là lời nhắc rất thực tế rằng ngay cả các công cụ hiện đại thân thiện với AI cũng vẫn vấp phải các case biên.
1. Thunderbit
 Thunderbit là một Chrome Extension ứng dụng AI, được xây dựng cho người dùng không chuyên kỹ thuật cần dữ liệu có cấu trúc từ website, PDF và hình ảnh mà không phải viết code hay tự quản lý selector.
Nhóm: Công cụ no-code / chạy trên trình duyệt, có API tùy chọn
Quy trình cốt lõi: Mở bất kỳ trang nào → nhấp một lần → AI tự xác định các trường cần lấy và chạy đến khi thành bảng hoàn chỉnh. Nếu bạn muốn trường cụ thể nào, chỉ cần mô tả bằng ngôn ngữ tự nhiên, hệ thống sẽ lấy đúng theo yêu cầu. Với hầu hết công việc, đó là toàn bộ quy trình.
Tính năng chính:
- Tự động nhận diện trường dữ liệu: Xác định các cột dữ liệu trên trang và trích xuất mà không cần bạn thiết lập trước.
- Scrape trang con: Tự truy cập từng trang chi tiết và làm giàu bảng chính — không cần cấu hình thủ công.
- Scraping theo lịch: Mô tả khoảng thời gian bằng ngôn ngữ tự nhiên; hệ thống sẽ chạy định kỳ trên cloud.
- Chế độ cloud và browser: Dùng browser mode cho các trang cần đăng nhập, cloud mode để xử lý nhanh hơn (50 trang cùng lúc).
- Miễn phí email, số điện thoại và trích xuất hình ảnh: Hữu ích cho workflow tạo lead mà không cần thêm công cụ khác.
- Xuất miễn phí: Excel, Google Sheets, Airtable, Notion, CSV, JSON — không tính phí xuất dữ liệu.
Chống bot & bảo trì: AI đọc lại từng trang từ đầu ở mỗi lần scrape, tự thích ứng khi bố cục thay đổi. Điều này loại bỏ kiểu lỗi phổ biến nhất đối với người dùng doanh nghiệp khi scrape nhiều website khác nhau, đặc biệt là các website ngách. Không thể nói là không cần bảo trì hoàn toàn, nhưng nó xử lý đúng điểm thất bại khiến team không chuyên kỹ thuật đau đầu nhất.
Giá: Gói miễn phí (6 trang/tháng), cộng thêm dùng thử 7 ngày cho tính năng Pro. Starter 15 USD/tháng, hoặc 9 USD/tháng nếu thanh toán theo năm. Pro 38 USD/tháng, hoặc 24 USD/tháng nếu thanh toán theo năm. Business báo giá tùy chỉnh. Thunderbit Web Scraper API được tính riêng, từ 29 USD/tháng (16 USD/tháng nếu thanh toán theo năm), kèm 600 đơn vị miễn phí ban đầu. Credits được tính theo từng dòng đầu ra: 1 credit cho mỗi dòng, 2 credits nếu dòng đó đến từ trang con, và 30 credits cho mỗi truy vấn làm giàu dữ liệu cá nhân. Xem Thunderbit Pricing để biết thông tin mới nhất.
Tùy chọn cho developer: Thunderbit Open API có Distill endpoint (webpage → Markdown) và Extract endpoint (webpage → JSON có cấu trúc theo schema).
Phù hợp nhất cho: Đội sales (tạo lead từ directory), vận hành e-commerce (theo dõi giá, scrape SKU của đối thủ), đại lý bất động sản (dữ liệu listing), marketer và operator cần dữ liệu web có cấu trúc mà không cần hỗ trợ từ kỹ sư.
Hạn chế: Không phải lựa chọn tốt nhất cho giám sát SERP cấp doanh nghiệp với hơn 100K trang, hoặc các website có lớp bảo vệ bot nặng — đó là sân chơi của các nhà cung cấp proxy và API trong danh sách này. Ngưỡng dung lượng cũng thấp hơn các nhà cung cấp hạ tầng API chuyên dụng.
2. Bright Data
 Bright Data là một trong những nền tảng web data toàn diện nhất thế giới, kết hợp mạng proxy khổng lồ, scraper API, Web Scraper IDE và các bộ dữ liệu dựng sẵn.
Nhóm: Lai — dịch vụ quản lý + hạ tầng API
Tính năng chính:
- Mạng proxy hơn 400 triệu IP (residential, datacenter, mobile, ISP)
- Web Scraper API, Web Unlocker, IDE scrape trên trình duyệt
- Hơn 350 datasets và hơn 437 scraper dựng sẵn
- Hạ tầng giao nhận dữ liệu và tuân thủ dành cho doanh nghiệp
Chống bot & bảo trì: Xử lý Cloudflare, CAPTCHA, render JavaScript ở quy mô lớn. Các dataset quản lý thay bạn gần như toàn bộ bảo trì.
Giá: Web Scraper API từ 1,5 USD / 1K records theo pay-as-you-go, gói Scale 499 USD/tháng. Chi phí proxy có thể tăng mạnh khi mở rộng, nên việc dự trù ngân sách phải theo dõi rất kỹ.
Phù hợp nhất cho: Doanh nghiệp lớn có nhu cầu scrape phức tạp, dung lượng cao và ngân sách tương xứng.
Hạn chế: Đường cong học tập khá dốc với người không chuyên kỹ thuật. Cấu trúc giá phức tạp và có nguy cơ đội chi phí ở quy mô lớn.
3. Oxylabs
 Oxylabs là nhà cung cấp proxy và hạ tầng scraping cao cấp, sở hữu một trong những cụm IP lớn nhất ngành.
Nhóm: Scraping API + hạ tầng proxy
Tính năng chính:
- Proxy residential và datacenter với geo-targeting nâng cao
- Web Scraper API, SERP Scraper API, E-commerce Scraper API
- AI Web Scraping API / OxyCopilot để cải thiện phân tích dữ liệu
- Dùng thử miễn phí tới 2.000 kết quả
Chống bot & bảo trì: Khả năng unblock mạnh cho các tác vụ scraping quy mô lớn, nhiều phụ thuộc vào IP. Phù hợp cho trích xuất lặp lại ở quy mô lớn.
Giá: Web Scraper API từ 49 USD/tháng. Các gói proxy và add-on IP pool có thể làm tổng chi phí tăng lên.
Phù hợp nhất cho: Team developer cần hạ tầng proxy ổn định cho trích xuất dữ liệu quy mô lớn, lặp lại thường xuyên — đặc biệt là SERP và product intelligence.
Hạn chế: Không có lối đi no-code thực sự cho người dùng kinh doanh. Tổng chi phí sẽ tăng khi cộng thêm proxy và các use case nâng cao.
4. Zyte
 Zyte do chính những người tạo ra framework mã nguồn mở Scrapy thành lập, kết hợp scraping API có hỗ trợ AI với Scrapy Cloud và dịch vụ trích xuất được quản lý.
Nhóm: Lai — API + dịch vụ quản lý
Tính năng chính:
- Zyte API với khả năng trích xuất tự động có hỗ trợ AI
- Scrapy Cloud để triển khai và quản lý spider
- Quản lý proxy thông minh và render trình duyệt tích hợp sẵn
- Zyte Data cho trích xuất dữ liệu quản lý ở cấp doanh nghiệp
Chống bot & bảo trì: Xoay proxy thông minh tích hợp sẵn cùng các tính năng AI giúp giảm công việc duy trì selector.
Giá: Có 5 USD credit miễn phí ban đầu. Zyte API tính theo mức sử dụng. Scrapy Cloud từ 9 USD/unit/tháng.
Phù hợp nhất cho: Các team Python/Scrapy muốn môi trường cloud được quản lý với khả năng trích xuất có hỗ trợ AI.
Hạn chế: Người không chuyên kỹ thuật sẽ thấy khó tiếp cận hơn. Câu chuyện no-code còn hạn chế so với các công cụ chạy trên trình duyệt.
5. Octoparse
 Octoparse là một trong những thương hiệu web scraping no-code lâu đời và phổ biến nhất, xoay quanh trình dựng workflow trực quan kiểu bấm-chọn.
Nhóm: Công cụ no-code
Tính năng chính:
- Trình dựng workflow trực quan với logic kéo-thả
- Ứng dụng desktop kết hợp chạy lịch trên cloud
- Xử lý phân trang, cuộn vô hạn và các trang cần đăng nhập
- Template dựng sẵn cho các website phổ biến
- Xuất sang CSV, Excel, JSON, HTML và XML
Chống bot & bảo trì: Có xử lý CAPTCHA và cloud scraping với xoay IP tích hợp. Tuy nhiên, người dùng vẫn phải cập nhật workflow khi bố cục website thay đổi.
Giá: Gói miễn phí vĩnh viễn (10 tác vụ, 50.000 dòng xuất mỗi tháng). Standard 83 USD/tháng, hoặc 69 USD/tháng nếu thanh toán theo năm. Professional 299 USD/tháng, hoặc 249 USD/tháng nếu thanh toán theo năm. Enterprise báo giá riêng.
Phù hợp nhất cho: Marketer, nhà nghiên cứu và team e-commerce muốn giao diện scraping trực quan mà không cần code.
Hạn chế: Phần mềm desktop phải cài đặt. Việc bảo trì workflow vẫn đặt lên người dùng khi website mục tiêu thay đổi, vì workflow chạy trên selector đã lưu chứ không đọc lại trang mỗi lần.
6. Apify
 Apify không chỉ là một scraper — mà là một nền tảng cộng với marketplace. Điều đó giúp nó đặc biệt mạnh khi đã có sẵn scraper phù hợp cho website bạn cần.
Nhóm: Nền tảng API / developer platform có marketplace
Tính năng chính:
- Actor marketplace với khoảng 59.000 scraper và automation dựng sẵn (Apify Store, tháng 8/2026)
- Apify SDK để xây crawler tùy chỉnh
- Tích hợp với Zapier, Google Sheets, webhook và API
- Kèm quản lý proxy trong các gói nền tảng
Chống bot & bảo trì: Phụ thuộc vào chất lượng từng Actor. Actor chính thức thường được duy trì tốt; Actor từ cộng đồng có thể hỏng mà không báo trước.
Giá: Gói miễn phí kèm 5 USD usage credit. Starter từ 29 USD/tháng. Phí tính thêm theo compute credit.
Phù hợp nhất cho: Team muốn dùng sẵn một scraper cho website phổ biến cụ thể (Google Maps, Amazon, Instagram) mà không phải xây từ đầu.
Hạn chế: Chất lượng khác nhau giữa các Actor cộng đồng. Các website phức tạp hoặc ngách vẫn cần dev tự làm. Không thật sự là no-code nếu bạn cần scraper tùy chỉnh.
7. ScrapingBee
 ScrapingBee là một trong những API thân thiện nhất với developer trong nhóm này — tập trung vào việc làm cho việc lấy trang, render và xoay proxy trở nên đơn giản như một lần gọi API. Hiện công cụ này thuộc nhóm Oxylabs nhưng vẫn vận hành như một sản phẩm riêng, điều này đáng lưu ý nếu bạn đang cân nhắc cả hai.
Nhóm: Scraping API
Tính năng chính:
- REST API một lần gọi (gửi URL, nhận HTML hoặc JSON)
- Render bằng headless Chrome tích hợp sẵn
- Xoay proxy residential và datacenter
- Google Search API và screenshot API
- Các tùy chọn Markdown và AI extraction mới hơn
Chống bot & bảo trì: Tự xử lý render JavaScript và xoay proxy. Phần parsing logic và thiết kế schema do bạn quản lý.
Giá: Dùng thử có 1.000 credit miễn phí. Gói từ 49 USD/tháng.
Phù hợp nhất cho: Developer muốn một API gọn gàng, đơn giản để render và lấy trang — sau đó tự xử lý dữ liệu.
Hạn chế: Sản phẩm cốt lõi vẫn là lấy trang. Bạn phải tự lo trích xuất, chuẩn hóa và độ tin cậy của workflow phía sau.
8. Scrapfly
 Scrapfly là API tập trung vào chống bot rõ ràng nhất trong danh sách này, được xây dựng cho developer nhắm tới những website được bảo vệ rất chặt.
Nhóm: Scraping API
Tính năng chính:
- Vượt chống bot cho Cloudflare, DataDome, PerimeterX và các lớp bảo vệ tương tự
- Render bằng headless browser
- Xoay proxy residential
- Gửi webhook, tự retry và chụp screenshot
Chống bot & bảo trì: Chuyên xử lý các mục tiêu khó scrape. Gánh phần lớn độ phức tạp của anti-bot. Bạn vẫn phải tự xử lý parsing.
Giá: Gói miễn phí có 1.000 credit. Gói trả phí từ 30 USD/tháng.
Phù hợp nhất cho: Developer scrape các website có lớp bảo vệ anti-bot mạnh, cần tỷ lệ thành công cao mà không phải tự quản lý stack proxy/bypass.
Hạn chế: Tập trung vào lấy trang và render — việc trích xuất dữ liệu có cấu trúc là trách nhiệm của bạn. Hệ sinh thái nhỏ hơn Bright Data hoặc Oxylabs.
9. Firecrawl
 Firecrawl được thiết kế cho developer muốn có nội dung web sạch cho workflow AI — không chỉ là HTML thô.
Nhóm: Scraping API cho AI / LLM pipeline
Tính năng chính:
- Endpoint scrape và crawl
- Đầu ra ưu tiên Markdown (thiết kế riêng cho RAG và nạp vào LLM)
- Trích xuất dữ liệu có cấu trúc qua LLM
- Render JS và chế độ proxy
- Workflow theo lô phù hợp với agent system
Chống bot & bảo trì: Xử lý render và chống bot cơ bản. Tối ưu cho chất lượng nội dung hơn là dung lượng thô.
Giá: 1.000 credit miễn phí mỗi tháng. Hobby 19 USD/tháng, hoặc 16 USD/tháng nếu thanh toán theo năm. Standard 99 USD/tháng, hoặc 83 USD/tháng nếu thanh toán theo năm.
Phù hợp nhất cho: Team AI/ML và developer xây pipeline RAG, knowledge base, hoặc ứng dụng dùng LLM cần nội dung web sạch.
Hạn chế: Sản phẩm còn mới, bộ tính năng nhỏ hơn các nhà cung cấp enterprise. Không được thiết kế cho giám sát e-commerce dung lượng lớn. Chỉ dành cho developer — không có lựa chọn no-code.
10. Nimbleway
 Nimbleway được định vị giống một nền tảng cung cấp dữ liệu có cấu trúc hơn là một công cụ scraping tự phục vụ cho SMB.
Nhóm: Dịch vụ trọn gói / managed scraping có lớp API
Tính năng chính:
- Nimble Browser (trình duyệt cloud để scraping)
- API dữ liệu có cấu trúc theo thời gian thực cho tìm kiếm, e-commerce và maps
- Phân tích dữ liệu bằng AI và hạ tầng unblock
- Giao nhận pipeline được quản lý
Chống bot & bảo trì: Quản lý toàn phần. Nimbleway chịu trách nhiệm bảo trì pipeline, chống bot và giao dữ liệu.
Giá: Pay-as-you-go từ 1 USD cho mỗi 1.000 request cho extract, crawl và map, và 3 USD cho mỗi 1.000 với các template trích xuất dựng sẵn. Managed Data Services bắt đầu từ 2.500 USD/tháng, thanh toán theo năm.
Phù hợp nhất cho: Doanh nghiệp vừa đến lớn muốn có dữ liệu sạch, có cấu trúc mà không phải tự quản lý scraper.
Hạn chế: Giá quá cao cho nhiều workflow SMB. Dư thừa đối với các tác vụ scrape đơn giản hoặc chỉ dùng một lần.
11. Browse AI
 Browse AI mạnh nhất khi workflow không chỉ là trích xuất một lần mà là giám sát định kỳ kèm cảnh báo.
Nhóm: Công cụ no-code
Tính năng chính:
- Huấn luyện robot bằng cách bấm-chọn
- Phát hiện thay đổi và giám sát kèm cảnh báo
- Tích hợp Google Sheets, Airtable, Zapier, webhook và API
- Trích xuất hàng loạt và chạy lịch lặp lại
Chống bot & bảo trì: Xử lý anti-bot cơ bản. Robot có thể cần huấn luyện lại khi cấu trúc website thay đổi lớn.
Giá: Gói miễn phí vĩnh viễn (50 credit/tháng). Personal 48 USD/tháng, hoặc 19 USD/tháng nếu thanh toán theo năm. Professional 87 USD/tháng, hoặc 69 USD/tháng nếu thanh toán theo năm.
Phù hợp nhất cho: Người dùng kinh doanh theo dõi giá đối thủ, tin tuyển dụng hoặc tình trạng còn hàng theo thời gian.
Hạn chế: Có thể gặp khó với các website động mạnh hoặc dùng nhiều JavaScript. Cần huấn luyện lại robot khi layout thay đổi.
12. ParseHub
 ParseHub vẫn còn chỗ đứng cho các dự án nhỏ, sinh viên và team thử scraping lần đầu.
Nhóm: Công cụ no-code
Tính năng chính:
- Trích xuất trực quan kiểu bấm-chọn
- Xử lý trang render bằng JavaScript
- Đầu ra CSV, JSON, Excel, API và webhook
- Gói miễn phí khá dễ nhận biết (5 project, 200 trang/lần chạy)
Chống bot & bảo trì: Hỗ trợ ở mức cơ bản. Không có hạ tầng proxy nâng cao. Workflow có thể hỏng khi website thay đổi.
Giá: Có gói miễn phí. Gói trả phí từ 189 USD/tháng.
Phù hợp nhất cho: Dự án nhỏ tiết kiệm ngân sách hoặc người dùng muốn thử scraping mà chưa muốn đầu tư hạ tầng.
Hạn chế: Giá trả phí khá cao so với độ sâu tính năng. Trải nghiệm sản phẩm có phần cũ hơn so với các đối thủ AI-native. Chậm hơn và kém linh hoạt hơn các lựa chọn cloud-first hiện đại.
So Sánh Các Công Ty Web Scraping Tốt Nhất: Bảng Tổng Hợp
Tất cả thông tin trên được gom lại ở đây. Giá khởi điểm là mức thanh toán theo tháng, kèm mức thanh toán theo năm trong ngoặc nếu nhà cung cấp có. Ở cột “Free Tier?”, “Yes” nghĩa là có hạn mức được làm mới hoặc không bao giờ hết hạn; “Trial” nghĩa là hạn mức dùng một lần.
| Công ty | Nhóm | Phù Hợp Nhất Cho | Free Tier? | Giá Khởi Điểm | Mô Hình Tính Giá | Chống Bot | Gánh Nặng Bảo Trì | No-Code? | Định Dạng Xuất Dữ Liệu Chính |
|---|---|---|---|---|---|---|---|---|---|
| Thunderbit | No-code + API | Team kinh doanh, website đa dạng | Có (6 trang/tháng) | 15 USD/tháng (9 USD/tháng theo năm) | Credit theo dòng; API units | Trung bình | 🟡 | Có | Excel, Sheets, Airtable, Notion, CSV, JSON |
| Bright Data | Managed lai + API | Trích xuất quy mô doanh nghiệp | Có (5K records/tháng) | 1,5 USD/1K records hoặc 499 USD/tháng | Theo kết quả, theo request, dataset | Rất mạnh | 🟢 dataset / 🟠 API | Một phần | Output API, giao dataset |
| Oxylabs | API + hạ tầng proxy | Trích xuất lặp lại, phụ thuộc proxy nhiều | Dùng thử | 49 USD/tháng | Theo kết quả + gói proxy | Rất mạnh | 🟠 | Không | API / do người dùng định nghĩa |
| Zyte | Managed lai + API | Team Scrapy/Python | Có (5 USD credit) | Theo mức sử dụng; cloud 9 USD/unit/tháng | API theo usage + cloud | Mạnh | 🟢 Zyte Data / 🟠 Zyte API | Hạn chế | CSV, JSON, XML, storage |
| Octoparse | No-code | Workflow scraping trực quan | Có (10 tác vụ) | 83 USD/tháng (69 USD/tháng theo năm) | Thuê bao + add-on | Trung bình | 🟡 | Có | CSV, Excel, JSON, HTML, XML |
| Apify | Nền tảng + marketplace | Scraper dựng sẵn theo website | Có (5 USD credit) | 29 USD/tháng | Thuê bao + usage + Actor | Tốt (tùy Actor) | 🟠 | Một phần | Datasets, API, tích hợp |
| ScrapingBee | API | Render/unblock đơn giản | Dùng thử | 49 USD/tháng | Credit hàng tháng | Tốt | 🟠 | Không | HTML, Markdown, JSON |
| Scrapfly | API | Mục tiêu có anti-bot mạnh | Có (1.000 credit) | 30 USD/tháng | Credit hàng tháng | Rất mạnh | 🟠 | Không | HTML, ảnh chụp màn hình, JSON |
| Firecrawl | API scraping cho AI/LLM | Markdown và pipeline dữ liệu AI | Có (1K credit/tháng) | 19 USD/tháng (16 USD/tháng theo năm) | Theo credit | Trung bình-mạnh | 🟠 | Không | Markdown, HTML, JSON |
| Nimbleway | Managed + API | Dữ liệu doanh nghiệp có cấu trúc | Có (5K request/tháng) | 1 USD/1K request hoặc 2.500 USD/tháng managed | PAYG API + gói theo năm | Mạnh | 🟢 managed / 🟠 API | Không | Structured feeds, API |
| Browse AI | No-code | Giám sát và cảnh báo thay đổi | Có (50 credit/tháng) | 48 USD/tháng (19 USD/tháng theo năm) | Credit + giới hạn site | Cơ bản-trung bình | 🟡 | Có | Sheets, Airtable, Zapier, API |
| ParseHub | No-code | Dự án nhỏ, miễn phí | Có (200 trang/lần chạy) | 189 USD/tháng | Các gói thuê bao | Cơ bản | 🟡 | Có | CSV, JSON, Excel, API |
Thang đo gánh nặng bảo trì:
- 🟢 Thấp nhất: nhà cung cấp chịu phần lớn công việc bảo trì
- 🟡 Thấp-trung bình: nhà cung cấp lo phần lấy và parse, người dùng chạy workflow và sửa khi site mục tiêu thay đổi
- 🟠 Trung bình-cao: nhà cung cấp lo lấy dữ liệu/unblock, người dùng lo parsing và tích hợp
- 🔴 Cao nhất: người dùng gần như tự lo mọi thứ
Độ Tin Cậy và Bảo Trì: Cái Gì Hỏng và Ai Sửa
Phần này quan trọng hơn bất kỳ bảng so sánh tính năng nào.
Lý do chính khiến người mua không hài lòng với nhà cung cấp scraping không phải là lần chạy đầu tiên bị lỗi. Mà là lần chạy thứ 5, thứ 50, hay thứ 500 bị lỗi — và phải có ai đó trong team chịu trách nhiệm giải quyết mớ hỗn độn đó.
| Mức bảo trì | Loại nhà cung cấp | Bạn phụ trách | Họ phụ trách |
|---|---|---|---|
| 🟢 Thấp nhất | Dịch vụ trọn gói (Bright Data datasets, Zyte managed, Nimbleway) | Yêu cầu và kiểm tra đầu ra | Scraping, chống bot, thay đổi layout, QA, bàn giao |
| 🟡 Thấp-Trung bình | Công cụ no-code (Thunderbit, Octoparse, Browse AI, ParseHub) | Chạy workflow, kiểm tra đầu ra, và dựng lại nếu công cụ phụ thuộc selector đã lưu | Lấy dữ liệu, parsing, hosting và lên lịch |
| 🟠 Trung bình-Cao | Scraping API (ScrapingBee, Scrapfly, Oxylabs, Apify, Firecrawl) | Code tích hợp, parsing, retry, kiểm tra schema | Proxy, render, một phần lớp unblock |
| 🔴 Cao nhất | Framework tự làm / mã nguồn mở | Mọi thứ | Không gì cả |
Công cụ no-code nằm ở khoảng giữa. Không có công cụ nào loại bỏ hoàn toàn mọi điểm hỏng, và những công cụ dựa trên selector đã lưu vẫn sẽ gãy khi trang bị dựng lại. Đây chính là kiểu lỗi mà cách tiếp cận ưu tiên AI nhắm tới: Thunderbit đọc lại trang từ đầu mỗi lần thay vì phụ thuộc vào selector cố định mà người dùng phải tự bảo trì. Với người dùng doanh nghiệp xử lý nhiều website không đồng nhất, điều này dễ sống chung hơn rất nhiều so với một trình dựng workflow trực quan truyền thống.
Các nhà cung cấp trọn gói vẫn gánh phần lớn công việc bảo trì tổng thể. Đổi lại, họ cũng tính phí cao nhất. Không có bữa trưa miễn phí — bạn luôn phải chọn ai sẽ chịu nỗi đau vận hành.
Giá Thực Tế Năm 2026: So Sánh Chi Phí Minh Bạch
Phần này thường bị né tránh trong các bài tổng hợp. “Liên hệ sales” không phải là một bảng giá. Dưới đây là con số thực tế. Cùng quy ước như bảng tổng hợp ở trên, kèm một cột cho những chi phí không hiện ra ngay ở mức giá niêm yết.
| Công ty | Free Tier? | Giá Khởi Điểm | Mô Hình Tính Giá | Rủi Ro Chi Phí Ẩn |
|---|---|---|---|---|
| Thunderbit | Có (6 trang/tháng) | 15 USD/tháng (9 USD/tháng theo năm) | Credit theo dòng | Dòng từ trang con tốn 2 credit, truy vấn làm giàu dữ liệu 30 |
| Bright Data | Có (5K records/tháng) | 1,5 USD/1K records, hoặc 499 USD/tháng cho gói Scale | Theo kết quả hoặc theo request | Chi phí proxy tăng vọt theo dung lượng |
| Oxylabs | Dùng thử (2.000 kết quả) | 49 USD/tháng | Theo request + gói proxy | Add-on IP pool |
| Zyte | Có (5 USD credit) | Theo mức sử dụng | API usage + cloud units | Các tầng render và độ phức tạp |
| Octoparse | Có (10 tác vụ) | 83 USD/tháng (69 USD/tháng theo năm) | Thuê bao + extras | Proxy, CAPTCHA và add-on dịch vụ |
| Apify | Có (5 USD credit) | 29 USD/tháng | Thuê bao + compute + phí Actor | Dao động theo Actor và mức dùng |
| ScrapingBee | Dùng thử (1.000 credit) | 49 USD/tháng | Theo credit | Các tùy chọn render tiêu tốn nhiều credit hơn |
| Scrapfly | Có (1.000 credit) | 30 USD/tháng | Theo credit | Chế độ residential và enhanced tốn hơn |
| Firecrawl | Có (1.000 credit/tháng) | 19 USD/tháng (16 USD/tháng theo năm) | Theo credit | Proxy nâng cao và chế độ trích xuất giàu dữ liệu hơn |
| Nimbleway | Có (5K request/tháng) | 1 USD/1K request hoặc 2.500 USD/tháng managed | API + gói theo năm | Gói managed tính phí theo năm |
| Browse AI | Có (50 credit/tháng) | 48 USD/tháng (19 USD/tháng theo năm) | Credit + giới hạn | Site cao cấp và giới hạn số website |
| ParseHub | Có (200 trang/lần chạy) | 189 USD/tháng | Theo tầng thuê bao | Giá rõ ràng nhưng giá trị ở gói trả phí thấp hơn |
Trong số các công cụ có mức phí tháng cố định, Thunderbit (15 USD) và Firecrawl (19 USD) là hai lựa chọn khởi điểm rẻ nhất, sát phía sau là Apify (29 USD) và Scrapfly (30 USD); Octoparse (83 USD) và ParseHub (189 USD) là các lựa chọn đắt nhất trong nhóm no-code. Bright Data và Zyte tính theo mức sử dụng, nên một pilot nhỏ với hai nền tảng này có thể rẻ hơn tất cả các công cụ trên. Bright Data, Oxylabs và Nimbleway sẽ hợp lý hơn khi khối lượng, độ khó của mục tiêu và yêu cầu doanh nghiệp quan trọng hơn chuyện ngân sách đơn giản.
Công Ty Web Scraping Nào Phù Hợp Với Bạn? Khung Ra Quyết Định
Dùng chuỗi câu hỏi này để thu hẹp lựa chọn thật nhanh.
1. Khối lượng dữ liệu của bạn là bao nhiêu?
- Dưới 1.000 trang/tháng → công cụ no-code (Thunderbit, Browse AI, Octoparse, ParseHub)
- Từ 10K trang/tháng trở lên → API (Oxylabs, ScrapingBee, Apify, Scrapfly, Firecrawl)
- Từ 100K trang/tháng trở lên → dịch vụ enterprise managed (Bright Data, Nimbleway, Zyte Data)
2. Công ty bạn có developer không?
- Có → công cụ API cho bạn quyền kiểm soát tốt hơn (Oxylabs, ScrapingBee, Apify, Scrapfly, Firecrawl, Zyte API)
- Không → no-code (Thunderbit, Browse AI, Octoparse) hoặc dịch vụ trọn gói (Bright Data datasets, Nimbleway)
3. Có bao nhiêu website mục tiêu?
- Vài website quen thuộc, ổn định → template và Actor dựng sẵn hoạt động rất tốt
- Nhiều website đa dạng, thay đổi thường xuyên → khả năng thích ứng bằng AI trở nên quan trọng (Thunderbit rất mạnh ở điểm này)
4. Ngân sách tối đa của bạn là bao nhiêu?
- Dưới 50 USD/tháng → dùng free tier (Thunderbit, ParseHub, Apify, Scrapfly, Firecrawl)
- 50–500 USD/tháng → các API tầm trung và gói no-code trả phí
- Trên 500 USD/tháng → dịch vụ managed dành cho doanh nghiệp
5. Trích xuất một lần hay giám sát liên tục?
- Liên tục → khả năng scrape theo lịch rất quan trọng (Thunderbit, Browse AI, Bright Data datasets)
- Một lần → gần như công cụ nào cũng dùng được; hãy tối ưu cho tốc độ thiết lập
Tóm tắt trả lời nhanh:
- Team không chuyên kỹ thuật, nhiều website khác nhau, không có dev → Thunderbit
- Developer xây pipeline dữ liệu ở quy mô lớn → Oxylabs, ScrapingBee hoặc Apify
- Muốn người khác lo toàn bộ → dịch vụ managed của Bright Data hoặc Zyte
- Xây pipeline dữ liệu cho AI/LLM → Firecrawl hoặc Thunderbit API
Tình Huống Thực Tế: Công Ty Web Scraping Nào Hợp Với Scenario Nào
Theo Dõi Giá E-Commerce
Với team vận hành đang theo dõi giá đối thủ trên một cửa hàng Shopify, Thunderbit là con đường nhanh nhất. Mở trang collection và nhấp một lần. AI sẽ tự nhận ra những trường cần lấy — thường là tên sản phẩm, giá, tình trạng còn hàng và URL — rồi tự điền vào bảng. Nếu bạn muốn bộ trường khác, chỉ cần mô tả bằng một câu và hệ thống sẽ dùng bộ đó. Sau đó chạy theo lịch ở chế độ cloud. Nếu bạn cần kiểm tra từng trang chi tiết sản phẩm nữa, tính năng scrape trang con sẽ tự động làm giàu bảng. Xuất sang Google Sheets và để workflow định giá của bạn chạy tiếp từ đó.
Bright Data giải bài toán tương tự theo hướng khác. Thay vì tự vận hành workflow, bạn có thể mua dataset e-commerce được quản lý hoặc dùng stack enterprise. Cách này ít phải động tay hơn, nhưng cấu trúc chi phí lại hoàn toàn khác.
Tạo Lead B2B (Email và Số Điện Thoại)
Với các dự án prospecting nhỏ đến vừa, bộ trích xuất email và số điện thoại miễn phí của Thunderbit rất thực dụng cho directory công khai, trang listing địa phương và các website doanh nghiệp ngách. Giá trị nằm ở tốc độ: lấy danh sách, xuất ra, đưa vào CRM mà không cần thiết lập kỹ thuật.
Apify mạnh hơn khi nguồn dữ liệu là một nền tảng lớn, phổ biến, có hệ sinh thái Actor trưởng thành. Nếu bạn muốn danh sách lead từ Google Maps ở dung lượng lớn, một Actor dựng sẵn sẽ giúp bạn chạy nhanh hơn nhiều so với tự xây từ đầu.
Giám Sát SERP Quy Mô Lớn
Ở đây cần nói thật. Thunderbit không phải lựa chọn tốt nhất cho hơn 100K truy vấn SERP mỗi ngày. Ở quy mô đó, bạn nên xem xét Oxylabs SERP APIs, sản phẩm SERP của Bright Data, hoặc hạ tầng enterprise tương tự — nơi tỷ lệ thành công, chất lượng IP và quản lý tốc độ quan trọng hơn sự dễ dùng.
Đưa Dữ Liệu Scrape Vào Pipeline AI / LLM
Nếu mục tiêu của bạn là biến các trang công khai thành nội dung sạch cho RAG hoặc workflow agent, Firecrawl là cái tên rất đáng cân nhắc nhờ thiết kế ưu tiên Markdown. Thunderbit cũng đáng so sánh vì Distill API có thể chuyển webpage sang Markdown và Extract API có thể biến trang thành JSON có cấu trúc theo schema — nghĩa là một nền tảng có thể phục vụ cả người dùng kinh doanh (Chrome Extension) lẫn pipeline AI cho developer (API layer). Để hiểu thêm về cách Thunderbit xử lý AI data extraction cho doanh nghiệp, bạn có thể xem bài hướng dẫn chuyên sâu của chúng tôi.
Mẹo Để Khai Thác Tối Đa Bất Kỳ Công Ty Web Scraping Nào
- Hãy bắt đầu bằng free tier hoặc trial trước khi chi tiền. Tất cả nhà cung cấp trong danh sách này đều có.
- Xác định schema trước khi scrape. Hãy quyết định trước những trường, định dạng và nơi lưu đầu ra. Chỉ một bước này cũng đủ ngăn phần lớn rắc rối phía sau.
- Test 50–100 trang để đánh giá chất lượng dữ liệu và tỷ lệ thành công trước khi ước tính chi phí ở quy mô lớn.
- Xác nhận định dạng xuất trước. Không phải công cụ nào cũng hỗ trợ mọi đích đến như nhau. Nếu bạn cần Airtable hoặc Notion, hãy kiểm tra trước.
- Với công việc lặp lại, hãy lên lịch chạy thay vì scrape thủ công từng lần. Thunderbit, Browse AI, Octoparse và Bright Data đều hỗ trợ.
- Theo dõi độ lệch chất lượng theo thời gian. Ngay cả dịch vụ managed cũng có thể giảm hiệu quả khi website mục tiêu thay đổi.
- Hiểu rõ mức tiêu thụ credit và giới hạn tốc độ trước khi mở rộng quy trình. Giá tính theo mức dùng có thể phình rất nhanh nếu bạn không theo dõi.
Sai lầm của người mới thường không nằm ở kỹ thuật. Nó nằm ở vận hành. Các team bắt đầu scrape trước khi quyết định hình dạng đầu ra mình cần là gì, hoặc dữ liệu đó sẽ được dùng thế nào ở phía sau. Nếu muốn tìm hiểu sâu hơn data scraping là gì và cách thực hiện, chúng tôi có một bài hướng dẫn thân thiện cho người mới bắt đầu.
Kết Luận
Cách mua đúng trong thị trường này là: chọn nhóm sản phẩm trước, rồi mới chọn nhà cung cấp.
Nếu bạn muốn người khác chịu trách nhiệm toàn bộ pipeline, hãy bắt đầu với các nhà cung cấp managed như Bright Data, Zyte Data hoặc Nimbleway. Nếu bạn có developer và muốn kiểm soát hạ tầng trực tiếp, các API như Oxylabs, ScrapingBee, Scrapfly, Apify và Firecrawl sẽ phù hợp hơn. Nếu bạn cần một con đường nhanh cho người vận hành và người dùng kinh doanh không thể viết code, lớp no-code chính là nơi tạo ra đòn bẩy lớn nhất — và đó cũng là nơi Thunderbit được xây dựng để tồn tại.
Những lựa chọn mạnh nhất theo từng tình huống:
- Khởi động nhanh nhất cho team không chuyên kỹ thuật: Thunderbit
- Hạ tầng enterprise mạnh nhất: Bright Data hoặc Oxylabs
- API developer tốt nhất cho sự đơn giản: ScrapingBee
- Tốt nhất cho pipeline AI/LLM: Firecrawl hoặc Thunderbit API
- Lựa chọn miễn phí tốt nhất cho dự án nhỏ: ParseHub hoặc free tier của Apify
Với đa số team không chuyên kỹ thuật cần scrape nhiều website khác nhau, Thunderbit là nơi thực tế nhất để bắt đầu. Gói miễn phí giúp giảm rủi ro, thiết lập rất tối giản, và workflow ưu tiên AI phù hợp hơn với thực tế bảo trì của năm 2026 so với các trình dựng scraping trực quan đời cũ. Hãy thử Thunderbit Chrome Extension và xem một cú nhấp chuột có thể đi xa đến đâu. Nếu bạn muốn xem công cụ hoạt động trước khi cài đặt, Thunderbit YouTube Channel có các video hướng dẫn cho những trường hợp sử dụng phổ biến nhất.
Dùng Thử Thunderbit AI Web Scraper Get Started Free
Câu Hỏi Thường Gặp
1. Sự khác nhau giữa một công ty web scraping và một công cụ web scraper là gì?
Một công ty web scraping có thể cung cấp dịch vụ trọn gói — hạ tầng, bảo trì, hỗ trợ và bàn giao dữ liệu. Còn web scraper tool là phần mềm bạn tự vận hành. Một số nhà cung cấp (như Bright Data và Zyte) bao phủ cả hai mô hình. Những nhà cung cấp khác (như Thunderbit) chủ yếu là công cụ, kèm một lớp API tùy chọn cho developer.
2. Dùng công ty web scraping có hợp pháp không?
Việc scrape dữ liệu công khai nhìn chung là hợp pháp ở nhiều khu vực pháp lý, nhưng chi tiết còn phụ thuộc vào website, loại dữ liệu được thu thập và quy định địa phương. Hãy luôn tôn trọng Terms of Service, robots.txt và các luật bảo vệ dữ liệu như GDPR và CCPA. Các nhà cung cấp uy tín thường tích hợp yếu tố tuân thủ vào nền tảng của họ. Để tìm hiểu sâu hơn, xem hướng dẫn của chúng tôi về hệ quả pháp lý của web scraping.
3. Năm 2026, các công ty web scraping có giá bao nhiêu?
Thị trường trải rộng từ các gói miễn phí và gói khởi điểm dưới 50 USD/tháng đến dịch vụ managed cấp doanh nghiệp bắt đầu khoảng 500 USD/tháng và có thể cao hơn nhiều. Thunderbit, ParseHub và Apify có free tier. Các API tầm trung như ScrapingBee và Scrapfly bắt đầu từ 30–49 USD/tháng. Nhà cung cấp enterprise bắt đầu cao hơn: gói Scale của Bright Data là 499 USD/tháng và các gói managed của Nimbleway bắt đầu từ 2.500 USD/tháng.
4. Tôi có thể dùng công ty web scraping mà không cần code không?
Có. Các công cụ no-code như Thunderbit, Octoparse, Browse AI và ParseHub được thiết kế cho người dùng không chuyên kỹ thuật. Thunderbit không cần viết code: chỉ cần cài Chrome Extension, mở một trang và nhấp một lần — AI sẽ tự xác định trường cần lấy và hoàn thành công việc. Bạn thậm chí chỉ cần mô tả dữ liệu mình muốn bằng tiếng Việt tự nhiên. Dữ liệu sẽ đi thẳng vào bảng tính hoặc cơ sở dữ liệu của bạn.
5. Công ty web scraping nào tốt nhất cho doanh nghiệp nhỏ?
Thunderbit là lựa chọn mặc định mạnh nhất cho doanh nghiệp nhỏ cần dữ liệu có cấu trúc từ nhiều website khác nhau mà không có developer hỗ trợ. Gói miễn phí và mô hình tính theo dòng giúp bạn bắt đầu dễ dàng, đồng thời dự đoán chi phí cũng đơn giản khi đã biết gần đúng số dòng cần lấy. Apify cũng rất hấp dẫn khi đã có Actor dựng sẵn cho website bạn cần, còn ParseHub phù hợp với các dự án nhỏ dùng free tier khi khối lượng thấp.
Tìm hiểu thêm



