
Web càng ngày càng phức tạp hơn qua từng năm, và khoảng cách giữa “tôi cần dữ liệu này” với “tôi biết cách lấy nó” vẫn cứ kéo dài mãi. Với người mới, câu hỏi đầu tiên thường rất thẳng: Có thật sự phải học Python chỉ để lấy giá sản phẩm từ một website không?
Tin vui là không cần. Nhưng câu hỏi tiếp theo—vậy tôi nên dùng công cụ nào?—mới là chỗ làm mọi thứ rối lên. Có ứng dụng desktop không cần code, tiện ích mở rộng trình duyệt, framework Python, thư viện Go, SEO spider, API dạng managed, và cả những dự án mã nguồn mở, trong đó ranh giới giữa chúng ngày càng mờ dần. Mười lựa chọn nổi bật trong năm 2026 dưới đây được đánh giá theo đúng những điều người mới quan tâm nhất: cần viết code đến đâu, mất bao lâu để có dữ liệu dùng được, công cụ có xử lý được website nhiều JavaScript hay không, bạn nhận được gì ở bản miễn phí, và nó thật sự hợp với tình huống nào. Dù bạn chưa từng viết một dòng code hay chỉ là một junior developer đang tìm framework crawler đầu tiên, ở đây đều có điểm xuất phát phù hợp.
Cách Chúng Tôi Chọn Ra Những Web Crawler Tốt Nhất Cho Người Mới
“Người mới bắt đầu” không có nghĩa là “không rành kỹ thuật.” Nó chỉ bất kỳ ai chưa từng tự xây một quy trình web crawling trước đây—bao gồm cả những người viết được Python hoặc JavaScript cơ bản nhưng chưa từng đụng đến hàng đợi URL hay file robots.txt.
Mỗi công cụ được đánh giá theo 6 tiêu chí bám rất sát những câu hỏi người mới hay hỏi trên diễn đàn:
- Mức độ cần code — Không cần, Python/JS cơ bản, hay từ trung cấp trở lên
- Độ khó thiết lập — Từ lúc cài đến lúc có dữ liệu đầu tiên dùng được
- Kết xuất JavaScript — Có xử lý được SPA và trang tải nội dung động không?
- Độ hào phóng của gói miễn phí — Trước khi trả tiền, bạn nhận được gì?
- Định dạng đầu ra — CSV, JSON, Excel, Google Sheets, v.v.
- Trường hợp sử dụng phù hợp nhất — Kịch bản cụ thể mà công cụ đó tỏa sáng với người mới
Danh sách này trải rộng trên ba mức kỹ năng: không cần code (zero programming), trung cấp (Python hoặc JavaScript cơ bản), và người mới nâng cao (Go hoặc hiểu sâu hơn về framework). Tôi cố gắng nói thật về điểm mạnh và điểm yếu của từng công cụ—vì chọn sai crawler so với trình độ của mình là cách nhanh nhất để mất cả buổi chiều vô ích.
Chọn Web Crawler Đầu Tiên: Sơ Đồ Quyết Định Nhanh
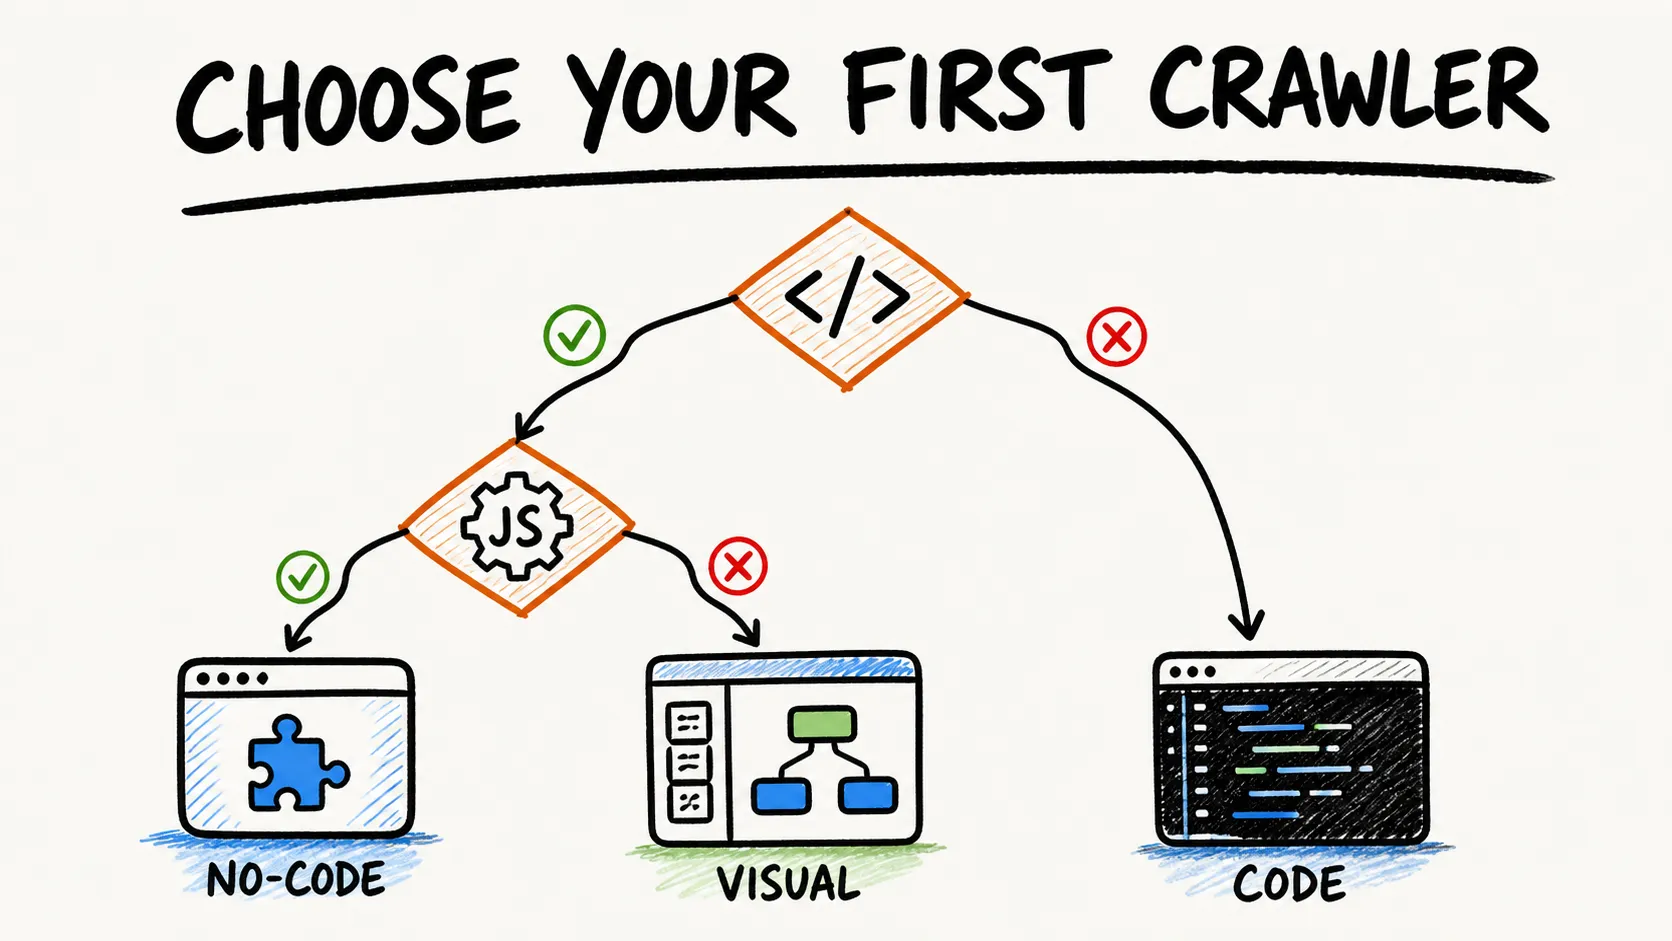
Trước khi lướt qua 10 bài review, hãy trả lời 3 câu hỏi. Điểm giao nhau sẽ gợi ý cho bạn 1–2 công cụ phù hợp.
Câu 1: Bạn thoải mái với code đến mức nào?
- Không biết code → Sang Câu 2a
- Python cơ bản → Sang Câu 2b
- JavaScript/TypeScript → Sang Câu 2c
- Go → Colly
Câu 2a (Không code): Mục tiêu chính của bạn là gì?
- Trích xuất dữ liệu tổng quát (thông tin sản phẩm, danh sách lead, nghiên cứu) → Thunderbit hoặc Octoparse
- Luồng nhiều bước phức tạp (đăng nhập, dropdown, cuộn vô hạn) → ParseHub hoặc Octoparse
- Audit SEO → Screaming Frog
Câu 2b (Python): Mục tiêu chính của bạn là gì?
- Pipeline AI/LLM (RAG, huấn luyện chatbot) → Crawl4AI hoặc Firecrawl
- Crawl có cấu trúc quy mô lớn trên các website chủ yếu tĩnh → Scrapy
- Tự động hóa trình duyệt trên website nhiều JS → Playwright (nhưng bạn sẽ phải tự xây logic crawl)
Câu 2c (JavaScript/TypeScript): Mục tiêu chính của bạn là gì?
- Crawl SPA hiện đại với chống chặn → Crawlee
- Tương tác trình duyệt phức tạp (đăng nhập, click, chụp màn hình) → Playwright
- Markdown sạch để nạp vào AI → Firecrawl (qua API/SDK)
Lọc theo ngân sách: Nếu bạn cần phần mềm giá $0 và có thể tự host, các công cụ mã nguồn mở ở đây (Scrapy, Crawlee, Crawl4AI, Playwright, và Colly) không áp quota theo trang từ nhà cung cấp, dù chi phí compute, băng thông, lưu trữ, bảo trì và giới hạn từ website đích vẫn còn. Nếu bạn không thể tự host, Octoparse, ParseHub, Thunderbit, Firecrawl, và Screaming Frog đều có lộ trình miễn phí với các giới hạn khác nhau.
Riêng sơ đồ này đã có thể giúp bạn tiết kiệm hàng giờ chuyển tab. Hãy đánh dấu lại.
Tổng Quan Các Web Crawler Tốt Nhất Cho Người Mới
Dưới đây là bảng so sánh đầy đủ. “Coding Required” cho biết bạn cần ngôn ngữ nào (nếu có). “JS Rendering” cho biết công cụ có xử lý được trang tải nội dung bằng JavaScript hay không. “Free Tier” tóm tắt những gì bạn nhận được ở mức $0. Phần review chi tiết nằm bên dưới.
| Công cụ | Cấp độ kỹ năng | Cần code | Kết xuất JS | Gói miễn phí | Phù hợp nhất cho |
|---|---|---|---|---|---|
| Octoparse | Người mới | Không | ✅ Tích hợp sẵn | Gói miễn phí: 10 tác vụ, chỉ chạy cục bộ, 10K dòng/xuất | Scraping dữ liệu có cấu trúc bằng cách trỏ và bấm |
| ParseHub | Người mới | Không | ✅ Tích hợp sẵn | 5 dự án công khai, 200 trang/lần chạy, lưu 14 ngày | Luồng nhiều trang phức tạp mà không cần code |
| Thunderbit | Người mới | Không | ✅ Qua trình duyệt | Gói miễn phí (xem giới hạn hiện tại) | Trích xuất có AI hỗ trợ ngay trên trang bạn đang mở |
| Crawl4AI | Trung cấp | Python | ✅ Chromium | Mã nguồn mở (tự host) | Crawl sẵn sàng cho LLM cho pipeline RAG |
| Firecrawl | Trung cấp | API/SDK | ✅ Managed | 1,000 credit/tháng (cloud) | Đầu ra Markdown sạch để nạp vào AI |
| Scrapy | Trung cấp | Python | ⚠️ Cần plugin | Mã nguồn mở (BSD) | Dự án crawl HTTP quy mô lớn, tùy biến cao |
| Crawlee | Trung cấp | JS/TS hoặc Python | ✅ Qua Playwright | Mã nguồn mở (Apache) | Crawl JS hiện đại với chống chặn |
| Playwright | Trung cấp | Python/JS/Java/.NET | ✅ Native | Mã nguồn mở (Apache) | Tự động hóa trình duyệt + tương tác website nhiều JS |
| Screaming Frog | Người mới | Không | ✅ (chỉ bản trả phí) | 500 URL/lần crawl (miễn phí vĩnh viễn) | Audit SEO và phân tích kỹ thuật website |
| Colly | Người mới nâng cao | Go | ⚠️ Không có sẵn | Mã nguồn mở (Apache) | Crawl HTTP nhanh, nhẹ, chạy song song |
Bây giờ là phần phân tích chi tiết.
1. Octoparse

Octoparse là một công cụ dựng tác vụ trên desktop không cần code, có tùy chọn chạy cloud trả phí. Bạn dán URL, để Auto-detect nhận diện các trường dữ liệu lặp lại và mẫu điều hướng, xem trước kết quả rồi chạy tác vụ cục bộ. Trình dựng workflow dạng trực quan hỗ trợ vòng lặp, nhánh rẽ, phân trang, cuộn vô hạn, AJAX, form và dropdown—dù các luồng động đôi khi vẫn cần chỉnh thời gian thủ công.
Tính năng chính:
- Auto-detect cho trường dữ liệu và điều hướng trang
- Kết xuất JavaScript tích hợp sẵn qua trình duyệt nội bộ
- Hàng trăm template dựng sẵn cho các website phổ biến
- Workflow có thể chỉnh sửa với vòng lặp, nhánh rẽ và bộ chọn tùy biến
- Xuất ra Excel, CSV, HTML, JSON, XML, Google Sheets và database (tùy gói)
Giá: Gói miễn phí giới hạn hỗ trợ chạy cục bộ. Chạy cloud, lập lịch, xoay IP và truy cập API cần gói trả phí. Hãy kiểm tra giá hiện tại trước khi quyết định vì giới hạn gói có thể thay đổi.
Phù hợp nhất cho: Người mới muốn trích xuất dữ liệu có cấu trúc lặp đi lặp lại từ website thương mại điện tử, directory hoặc danh sách mà không phải viết code. Kém phù hợp hơn nếu bạn cần sự tiện lợi kiểu browser extension hoặc đầu ra tối ưu cho LLM.
2. ParseHub
ParseHub là công cụ trích xuất trực quan tải về được cho Windows, macOS và Linux (qua AppImage). Giao diện dạng cây lệnh cho phép mô hình hóa các thao tác chọn, click, nhập form, cuộn và template trang. Nó hỗ trợ AJAX/JavaScript, dropdown, tab, pop-up, phân trang, form đăng nhập và cuộn vô hạn.
Tính năng chính:
- Cây lệnh trực quan cho luồng trích xuất nhiều bước
- Xử lý AJAX, JavaScript, dropdown, tab và cuộn vô hạn
- Ứng dụng desktop đa nền tảng (Windows, macOS, Linux)
- Truy cập API để lấy dữ liệu theo lập trình
- Xuất CSV và JSON
Giá: Có cả gói miễn phí và trả phí. Một “page” tính phí có thể là một URL hoặc một lần tải nội dung động được kích hoạt bởi click hoặc cuộn, nên số trang được phép không phải lúc nào cũng tương đương với số URL. Hãy kiểm tra kỹ giới hạn dự án, lượt chạy và thời gian lưu trữ hiện tại trước khi chọn gói.
Lưu ý về quyền riêng tư: Đừng nhập thông tin đăng nhập thật vào công cụ bên thứ ba cho đến khi bạn đã xem cách công cụ đó lưu input đăng nhập và dữ liệu dự án. Hãy dùng tài khoản thử nghiệm có giới hạn để đánh giá.
Phù hợp nhất cho: Người mới cần scrape các website động, nhiều bước (có điều hướng phức tạp, dropdown hoặc tải bằng cuộn) mà không phải viết code.
ParseHub vs. Octoparse: Khác nhau ở đâu?
Cả hai đều là công cụ desktop không cần code và xử lý được JavaScript. Mô hình cây lệnh của ParseHub cho bạn kiểm soát rõ hơn với các luồng nhiều bước—hữu ích cho điều hướng phức tạp, nhưng hơi khó làm quen hơn với tác vụ đơn giản. Auto-detect của Octoparse nhanh hơn với website có cấu trúc bảng/danh sách rõ ràng và gói miễn phí cho phép xuất dữ liệu thoáng tay hơn. Nếu website đích chủ yếu là bảng và danh sách, hãy bắt đầu với Octoparse. Nếu bạn cần mô hình hóa chuỗi click, điền form và điều hướng có điều kiện, ParseHub có thể dễ hiểu hơn.
3. Thunderbit

Thunderbit là tiện ích mở rộng trình duyệt web scraping dạng agentic cho Chrome và Edge, được thiết kế cho người dùng doanh nghiệp không rành kỹ thuật nhưng muốn trích xuất dữ liệu từ ngay trang họ đang mở. (Xin nói rõ: tôi làm việc tại Thunderbit, nên tôi sẽ thẳng thắn cả về ưu điểm lẫn giới hạn.)
Tính năng chính:
- One Click Extract tự động nhận diện cột dựa trên nội dung trang
- AI prompt ở cấp trường dữ liệu để phân loại, dịch, định dạng và chuẩn hóa ngay trong lúc trích xuất
- Xuất ra Excel/CSV, Google Sheets, Airtable và Notion
- Browser Mode hoạt động với phiên đăng nhập hiện tại của người dùng, xử lý tốt nội dung tải bằng JavaScript trên các trang tương thích
- Không cần cài gì ngoài browser extension
Giá: Gói miễn phí hiện bao gồm 6 trang/tháng với tối đa 30 credit mỗi trang. Starter ($15/tháng hoặc $9/tháng nếu thanh toán năm) bổ sung phân trang, scrape trang con, scrape hàng loạt, làm giàu dữ liệu, scraper dựng sẵn và lịch chạy. Xem giá hiện tại tại đây.
Giới hạn cần biết: Thunderbit thiên về trang/schema hơn là spider khám phá toàn bộ domain. Phân trang và scrape trang con là tính năng của gói Starter, không phải Free. Các trường do AI gợi ý luôn nên được kiểm tra lại trước khi chạy scrape—gợi ý khá tốt, nhưng không phải lúc nào cũng đúng tuyệt đối.
Phù hợp nhất cho: Đội sales, vận hành và nghiên cứu cần dữ liệu có cấu trúc từ ngay trang đang mở trong trình duyệt, kèm hỗ trợ AI để khỏi phải cấu hình trường dữ liệu thủ công. Nếu bạn muốn cách nhanh nhất để kéo một bảng, danh sách hoặc tập bản ghi từ một trang tương thích rồi xuất sang spreadsheet, đây là đường đi nhanh nhất mà tôi biết.
Để hiểu sâu hơn cách trích xuất có hỗ trợ AI vận hành trong thực tế, xem hướng dẫn của chúng tôi về AI web scraping.
Bỏ Qua Code, Bắt Đầu Chỉ Với Một Click Web scraper dạng agentic của Thunderbit tự đọc bất kỳ trang nào và tự chọn trường dữ liệu, không cần code — một lựa chọn khởi đầu rất hợp cho người mới. Get Started Free
4. Crawl4AI
Crawl4AI là một crawler Python mã nguồn mở, ưu tiên trình duyệt, được thiết kế để tạo đầu ra sạch cho workflow LLM. Nó xuất raw và clean HTML, nhiều biến thể Markdown, nội dung trích xuất có cấu trúc, link, media, bảng, ảnh chụp màn hình, PDF và MHTML.
Tính năng chính:
- AsyncWebCrawler dùng Chromium/Playwright ở tầng dưới
- Nhiều định dạng đầu ra tối ưu cho RAG pipeline và agent workflow
- Crawling thích ứng đánh giá độ phủ, độ nhất quán và mức bão hòa để ưu tiên link liên quan và dừng khi đã đủ thông tin
- Tùy chọn trích xuất bằng LLM với provider local (Ollama) hoặc API cloud
- Giấy phép Apache-2.0 kèm yêu cầu ghi nhận nguồn bổ sung
Giá: Hoàn toàn mã nguồn mở—không thu phí theo trang. Bạn tự host hạ tầng và trả chi phí inference cho LLM nếu dùng (local hoặc cloud).
Hạn chế: Cần hiểu Python async và phụ thuộc trình duyệt. Chất lượng trích xuất phụ thuộc vào LLM được dùng (nếu có). Crawler thích ứng ưu tiên link liên quan dựa trên tín hiệu đủ thông tin—nó không “học” vĩnh viễn hay tự sửa CSS selector theo thời gian.
Phù hợp nhất cho: Người dùng Python trình độ trung cấp đang xây pipeline dữ liệu AI và muốn kiểm soát hoàn toàn, không tốn phí theo request từ nhà cung cấp.
5. Firecrawl
Firecrawl là API dữ liệu web được quản lý sẵn (kèm SDK cho Python và Node.js) cùng một codebase tự host dưới giấy phép AGPL. Dịch vụ cloud của nó xử lý JavaScript rendering và trả về Markdown, tóm tắt, HTML, link, hình ảnh, ảnh chụp màn hình, JSON và theo dõi thay đổi.
Tính năng chính:
- Endpoint
/crawlvới lọc theo path, độ sâu khám phá, sitemap, giới hạn, độ trễ và điều khiển concurrency - Tự động render JavaScript trên cloud managed
- Nhiều định dạng đầu ra, bao gồm Markdown sạch
- Endpoint
/mapđể khám phá cấu trúc site nhanh - Browser/Interact và luồng agent beta cho tương tác nhiều bước (tách biệt với crawl cơ bản)
Giá: Cloud Free là 1,000 credit/tháng với 2 request đồng thời và giới hạn tốc độ thấp. Gói trả phí tính theo credit/concurrency—hãy xem trang giá để biết con số mới nhất. Tự host nghĩa là bạn tự lo hạ tầng và bảo trì, đồng thời không có đầy đủ tính năng cloud managed.
Hạn chế: /crawl cơ bản khám phá URL đệ quy qua link và sitemap, nhưng không đảm bảo xử lý được mọi kiểu phân trang bằng click. Chi phí credit thay đổi theo loại thao tác. Bộ tính năng của bản self-host và cloud không hoàn toàn giống nhau.
Phù hợp nhất cho: Người dùng trung cấp cần đưa nội dung website vào LLM, chatbot hoặc knowledge base và muốn dùng dịch vụ managed thay vì tự vận hành cả một browser stack.
Firecrawl vs. Crawl4AI: Công cụ nào cho AI pipeline?
Firecrawl mạnh ở chuyển đổi sang Markdown có quản lý sẵn và API gọn gàng—bạn gửi URL, nhận đầu ra có cấu trúc. Crawl4AI mạnh ở mô hình local-first, nơi bạn kiểm soát trình duyệt và LLM tùy chọn. Nếu bạn muốn giảm tối đa việc quản trị hạ tầng, cloud của Firecrawl là đường dễ hơn. Nếu bạn muốn tự host hoàn toàn, không tốn phí theo page của nhà cung cấp và thoải mái với Python async, Crawl4AI cho bạn nhiều quyền kiểm soát hơn.
6. Scrapy
Scrapy là framework crawling và scraping Python lâu đời, được cấp phép BSD, xây trên engine async Twisted. Nó cung cấp lập lịch request, theo link, khử trùng lặp, middleware, retry, throttling, pipeline và xuất dữ liệu sang JSON, JSON Lines, CSV, XML, pickle và marshal.
Tính năng chính:
- Xử lý request bất đồng bộ phù hợp cho các lượt crawl lớn nhưng có giới hạn rõ ràng
- Hệ sinh thái middleware rộng lớn (proxy, retry, throttling, header tùy chỉnh)
- Kiến trúc pipeline có cấu trúc cho làm sạch và lưu trữ dữ liệu
- Cộng đồng, tài liệu và extension bên thứ ba rất lớn
- Hoàn toàn mã nguồn mở (BSD)
Hạn chế: Không có kết xuất JavaScript native. Hướng dẫn chính thức về nội dung động khuyên nên tìm nguồn dữ liệu gốc khi có thể hoặc tích hợp browser/rendering một cách chủ động (ví dụ scrapy-playwright). Kiến trúc—spider, middleware, item pipeline, settings—có đường cong học tập khá rõ.
Giá: Miễn phí. Bạn tự host.
Phù hợp nhất cho: Người dùng Python trình độ trung cấp cần crawl website quy mô lớn, chủ yếu tĩnh hoặc render từ server.
Bắt Đầu Với Scrapy: Quickstart Có Giải Thích
Đây là đường tối thiểu từ cài đặt đến dữ liệu đầu tiên:
pip install scrapy
scrapy startproject beginner_crawl
cd beginner_crawl
scrapy genspider example example.com
Mở beginner_crawl/spiders/example.py và chỉnh sửa:
import scrapy

class ExampleSpider(scrapy.Spider):
    name = "example"
    allowed_domains = ["example.com"]       # Chỉ ở lại domain này
    start_urls = ["https://example.com"]    # URL khởi tạo

    custom_settings = {
        "ROBOTSTXT_OBEY": True,            # Tôn trọng robots.txt
        "DOWNLOAD_DELAY": 2,               # Chờ 2 giây giữa các request
        "CLOSESPIDER_PAGECOUNT": 10,       # Dừng sau 10 trang (giới hạn an toàn)
        "USER_AGENT": "Beginner-Crawl-Bot (+https://yoursite.com/bot-info)",
    }

    def parse(self, response):
        yield {
            "title": response.css("title::text").get(),
            "url": response.url,
        }
        # Theo các link trên trang (trong allowed_domains)
        for link in response.css("a::attr(href)").getall():
            yield response.follow(link, callback=self.parse)
Chạy nó:
scrapy crawl example -o output.json
Hãy test selector trước bằng scrapy shell "https://example.com" rồi mới scale lên. Thời gian thiết lập thay đổi theo mức quen thuộc với Python—đừng kỳ vọng xong trong 10 phút nếu bạn mới với virtual environment và lệnh terminal.
7. Crawlee
Crawlee là thư viện crawler mã nguồn mở, cấp phép Apache, cho JavaScript/TypeScript và Python, do Apify duy trì. Nó có cả lớp chỉ HTTP (như CheerioCrawler) lẫn crawler trình duyệt Playwright/Puppeteer, request queue, dataset, quản lý session, retry và các cơ chế giới hạn phạm vi.
Tính năng chính:
- Chọn HTTP-first (CheerioCrawler) hoặc trình duyệt đầy đủ (PlaywrightCrawler) theo từng dự án
- Queue request, khử trùng lặp và lưu dataset tích hợp sẵn
- Quản lý session, browser fingerprint, retry và kiểm soát biên request
- TypeScript là trọng tâm, đồng thời hỗ trợ Python ổn định
- Quickstart chính thức khuyến nghị dùng HTTP-first khi HTML đã chứa dữ liệu
Giá: Miễn phí. Mã nguồn mở, tự host.
Hạn chế: Cần biết JavaScript/TypeScript hoặc Python. Tài liệu cộng đồng ít hơn Scrapy. Tính năng chống chặn không tạo ra quyền truy cập hợp pháp hay bảo đảm truy cập—nó chỉ giảm nguy cơ bị phát hiện chứ không biến crawling không được phép thành hợp lệ.
Phù hợp nhất cho: Lập trình viên JavaScript trình độ trung cấp cần crawl SPA hiện đại và site render bằng JS với quản lý queue và chống chặn tích hợp.
Quickstart Crawlee: Từ Cài Đặt Đến Dữ Liệu Đầu Tiên
npx crawlee create my-crawler
cd my-crawler
Chọn template Playwright khi trình cài đặt hỏi.
Sửa handler trong src/routes.ts để trích xuất dữ liệu bạn cần, rồi:
npm start
Kết quả sẽ nằm trong thư mục dataset cục bộ dưới dạng JSON. Hãy thêm maxRequestsPerCrawl, giới hạn độ sâu, quy tắc cùng domain và mức concurrency hợp lý trước khi scale vượt quá một lần test.
8. Playwright
Playwright là framework tự động hóa trình duyệt của Microsoft, cấp phép Apache, hỗ trợ Python, Node.js, Java và .NET. Nó điều khiển trình duyệt thật Chromium, Firefox và WebKit—rất phù hợp với các trang tải nội dung bằng JavaScript, cần đăng nhập hoặc có tương tác phức tạp.
Tính năng chính:
- Render trình duyệt thật native trên ba engine
- Xử lý SPA, luồng đăng nhập, click, điền form, tải file, chụp ảnh màn hình và PDF
- Hỗ trợ đa ngôn ngữ (Python, JS/TS, Java, .NET)
- Tài liệu rất tốt và phát triển tích cực
- Chặn/giả lập mạng và mock request
Playwright không phải là gì: Không phải một crawler hoàn chỉnh. Nó không có frontier URL native, queue khử trùng lặp, chính sách lịch sự, mô hình retry hay exporter feed sẵn. Bạn phải tự xây các phần đó—hoặc kết hợp Playwright với một framework như Crawlee để có sẵn chúng.
Giá: Miễn phí. Mã nguồn mở.
Phù hợp nhất cho: Developer trình độ trung cấp cần tự động hóa tương tác trình duyệt trên website nhiều JS hoặc có đăng nhập, và sẵn sàng tự xây logic crawl xung quanh nó.
9. Screaming Frog
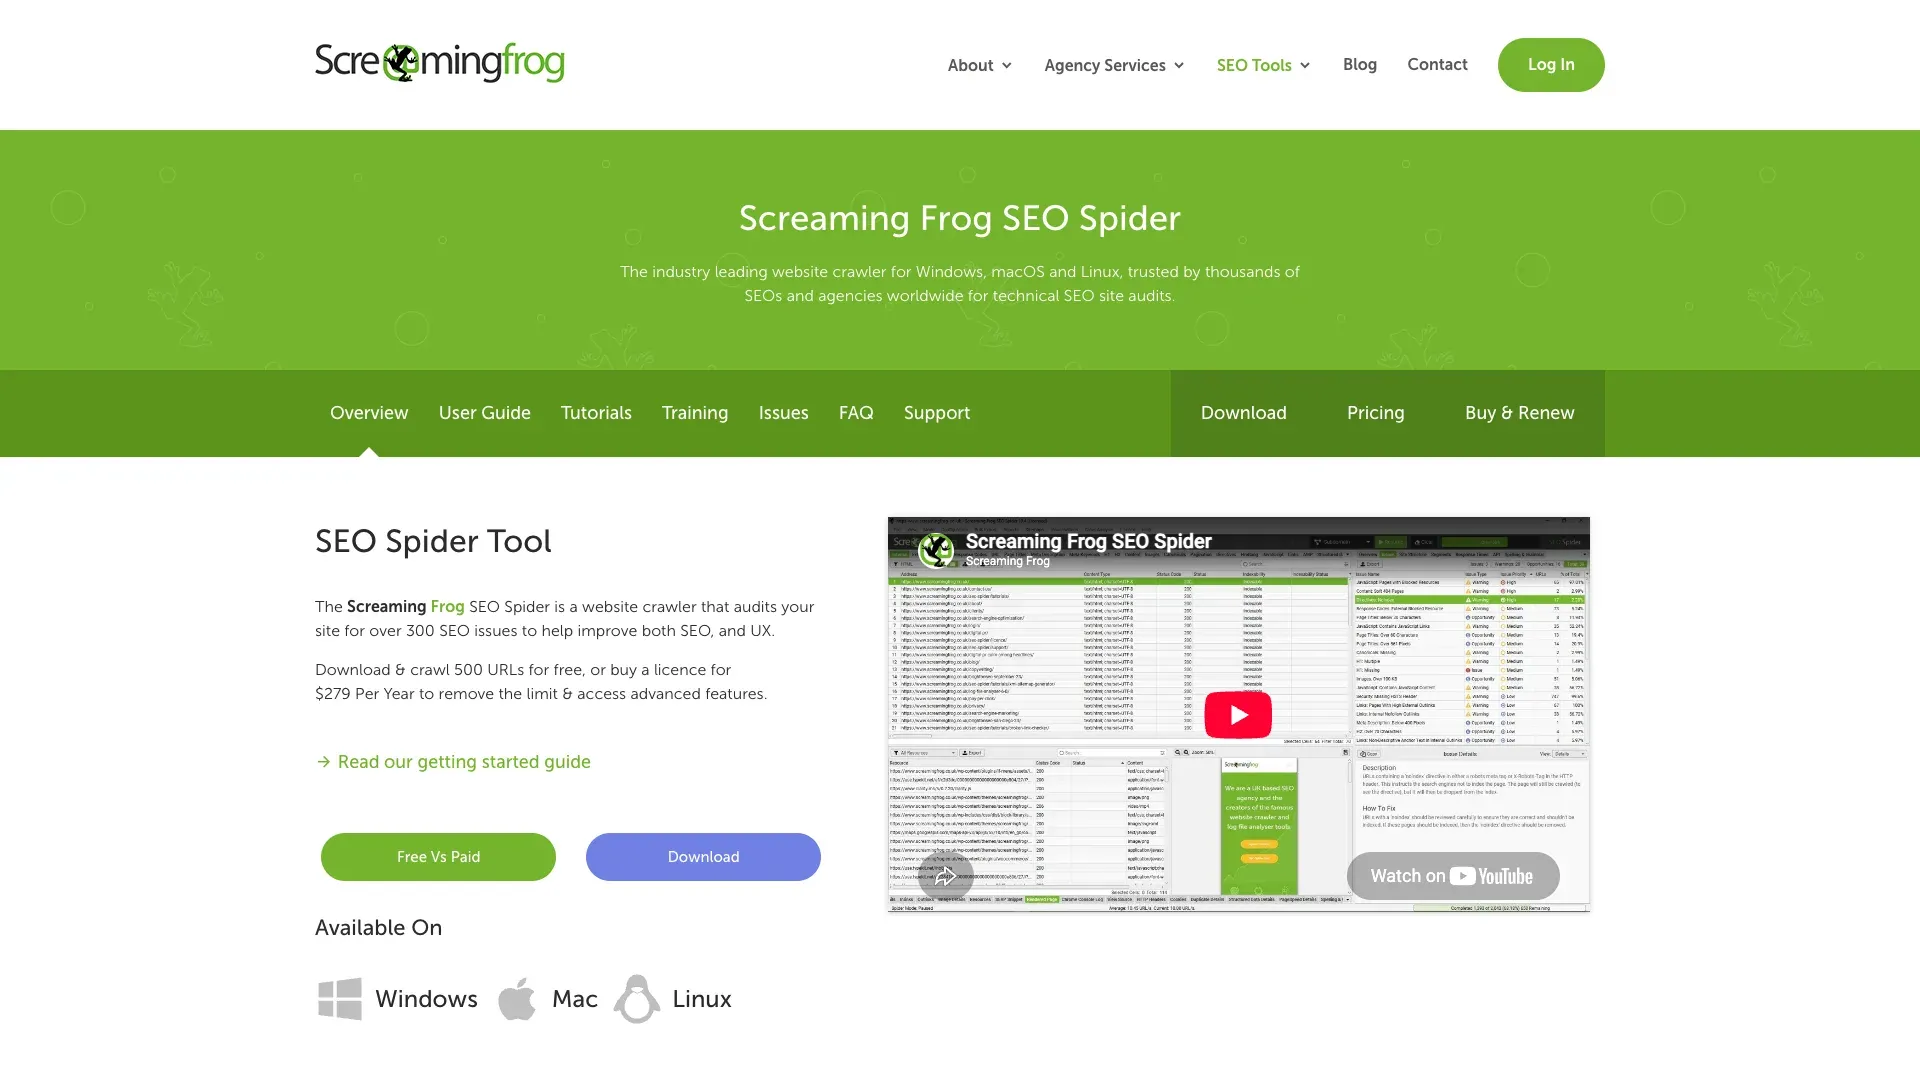
Screaming Frog SEO Spider là crawler kỹ thuật SEO dạng desktop cho Windows, macOS và Linux. Nó không phải công cụ trích xuất dữ liệu đa năng—đây là crawler quen thuộc cho audit SEO, phát hiện link hỏng, chuỗi redirect, nội dung trùng lặp, metadata bị thiếu và hàng trăm vấn đề kỹ thuật SEO khác.
Tính năng chính:
- Crawl tối đa 500 URL miễn phí (vĩnh viễn, không phải trial)
- Phát hiện link hỏng, chuỗi redirect, nội dung trùng lặp, metadata thiếu
- Các tab chi tiết cho title, meta description, heading, image và nhiều mục khác
- Bản trả phí thêm JavaScript rendering, lưu crawl, custom extraction, tích hợp GA/GSC và tích hợp AI (OpenAI, Gemini, Anthropic, Ollama)
Giá: Bản miễn phí là vĩnh viễn với 500 URL/lần crawl nhưng không có JavaScript rendering, cấu hình nâng cao, custom extraction và tích hợp. License là £199 / $279 / €245 cho mỗi người dùng mỗi năm.
Hạn chế: Đường cong học tập dốc với người không làm SEO. Tiêu tốn tài nguyên máy cục bộ (trang lớn sẽ ngốn RAM). Không có tùy chọn gói tháng. Không được thiết kế cho trích xuất dữ liệu tổng quát—đây là công cụ audit.
Phù hợp nhất cho: Người mới tập trung vào audit SEO và phân tích kỹ thuật website. Nếu bạn cần lấy dữ liệu sản phẩm hoặc xây danh sách lead, hãy tìm công cụ khác.
10. Colly
Colly là framework crawl/scrape HTTP bằng Go, cấp phép Apache, với API dựa trên callback, kiểm soát concurrency, session/cookie, queue, cache và backend lưu trữ có thể thay thế.
Tính năng chính:
- Crawl HTTP song song nhanh, sử dụng ít tài nguyên
- API gọn, dựa trên callback
- Hỗ trợ cookie/session và caching tích hợp
- Giới hạn tốc độ ở cấp domain qua LimitRule
- Cài đặt hiện tại:
go get github.com/gocolly/colly/v2
Lưu ý quan trọng cho người mới: Mã nguồn hiện tại của Colly khởi tạo IgnoreRobotsTxt = true theo mặc định. Bạn phải đặt rõ thành false và cấu hình LimitRule với độ trễ và mức song song phù hợp. Nếu không làm vậy, Colly sẽ bỏ qua robots.txt và rất dễ làm quá tải máy chủ đích.
Giá: Miễn phí. Mã nguồn mở.
Hạn chế: Cần biết lập trình Go. Không có trình render JavaScript tích hợp hoặc exporter feed dùng được ngay—bạn phải tự serialize đầu ra. Cộng đồng nhỏ hơn các công cụ viết bằng Python.
Phù hợp nhất cho: Người mới nâng cao biết Go và cần một crawler HTTP nhanh, nhẹ cho site tĩnh hoặc API—miễn là cấu hình robots và rate limit một cách rõ ràng.
So Sánh Gói Miễn Phí: Trước Khi Trả Tiền Bạn Thực Sự Nhận Được Gì
Đây là bảng mà những người mới quan tâm chi phí đang tìm. Mỗi công cụ bên dưới được chia thành hai nhóm: sản phẩm freemium (có giới hạn nhưng không cần tự lo hạ tầng) và công cụ mã nguồn mở (không giới hạn page nhưng bạn phải tự host mọi thứ).
Freemium / Gói Miễn Phí Cho Desktop
| Công cụ | Giới hạn miễn phí | Giới hạn dự án/tác vụ | Hạn chế xuất dữ liệu | Có giới hạn thời gian không? | Khóa tính năng chính |
|---|---|---|---|---|---|
| Octoparse | Không giới hạn trang/crawl | 10 tác vụ | 10K dòng/xuất; 50K dòng/tháng | Không (vĩnh viễn) | Cloud, lập lịch, xoay IP, API |
| ParseHub | 200 trang/lần chạy | 5 dự án công khai | CSV/JSON | Không (vĩnh viễn) | Dự án/dữ liệu có thể công khai; lưu 14 ngày |
| Thunderbit | 6 trang/tháng | Không áp dụng | Excel/CSV, Sheets, Airtable, Notion | Không (vĩnh viễn) | Phân trang, trang con, bulk, lịch chạy là Starter |
| Firecrawl | 1,000 credit/tháng | Không áp dụng | Tất cả định dạng | Không (vĩnh viễn) | 2 request đồng thời; rate limit thấp |
| Screaming Frog | 500 URL/lần crawl | Không giới hạn số lần chạy | Xuất dữ liệu hạn chế | Không (vĩnh viễn) | JS rendering, lưu crawl, custom extraction, tích hợp |
Công Cụ Mã Nguồn Mở (Tự Host)
| Công cụ | Giới hạn page | Giấy phép | Bạn phải trả cho |
|---|---|---|---|
| Scrapy | Không có | BSD | Compute, băng thông, lưu trữ, tích hợp browser tùy chọn |
| Crawlee | Không có | Apache | Compute, băng thông, tiến trình browser |
| Crawl4AI | Không có | Apache-2.0 + attribution | Compute, tiến trình browser, inference LLM tùy chọn |
| Playwright | Không có | Apache | Compute, tiến trình browser (CPU/RAM cao) |
| Colly | Không có | Apache | Compute, băng thông |
Nếu ngân sách phần mềm của bạn là 0 và bạn biết code, các công cụ mã nguồn mở sẽ tránh được quota theo trang từ nhà cung cấp, nhưng hạ tầng, giới hạn của website đích và chi phí vận hành vẫn còn. Không biết code? Octoparse, ParseHub và Thunderbit đều có lộ trình miễn phí—chỉ cần để ý các giới hạn và điều kiện riêng tư.
10 Phút Đầu Tiên: Hướng Dẫn Nhanh Cho 3 Mức Kỹ Năng
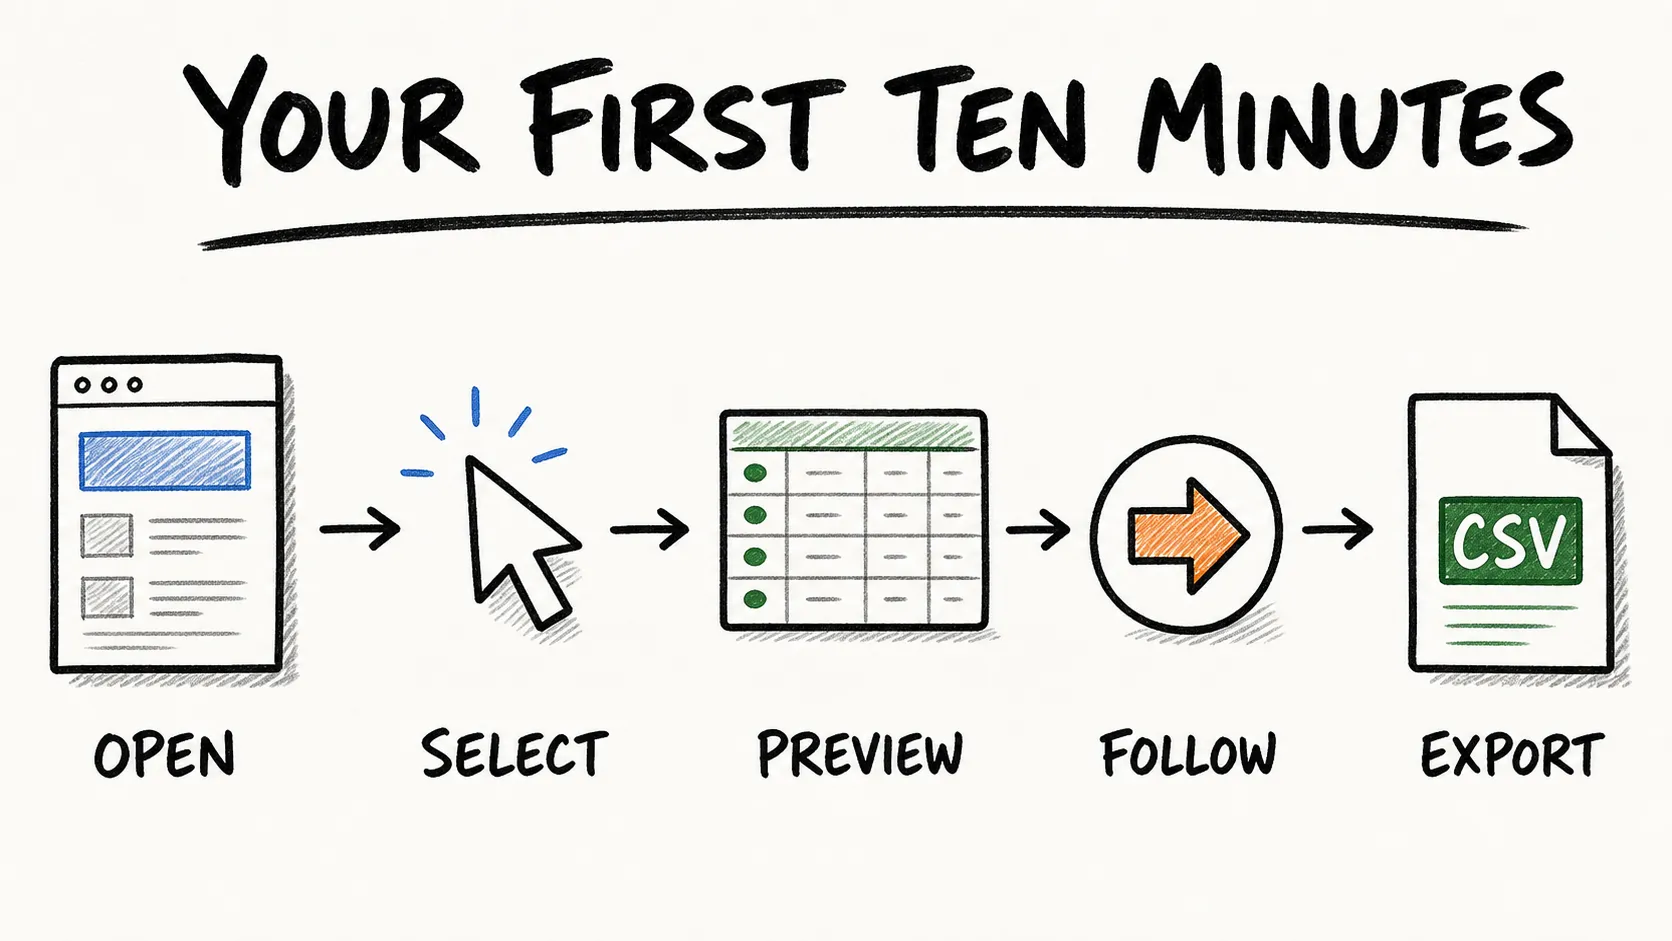
Lý thuyết thì hay. Thực hành còn hay hơn. Dưới đây là cách đi từ số 0 đến lần xuất dữ liệu đầu tiên trong ba công cụ tiêu biểu—mỗi công cụ đại diện cho một cấp độ kỹ năng.
Con Đường Không Cần Code: Bắt Đầu Với Thunderbit
- Cài Thunderbit browser extension
- Mở trang đích (ví dụ: trang danh sách sản phẩm, directory hoặc trang kết quả tìm kiếm)
- Click biểu tượng Thunderbit và chọn One Click Extract — AI đọc trang, tự hiểu cấu trúc, quyết định cột nào cần lấy và trích xuất trong một lần
- Xem lại kết quả trong extension — đổi tên, xoá hoặc thêm cột và thêm Field AI Prompts nếu muốn tinh chỉnh — rồi xuất sang Excel, Google Sheets, Airtable hoặc Notion
Trên một trang tương thích, đây được thiết kế như một bước thiết lập ngắn gọn chứ không phải một dự án lập trình.
Để xem hướng dẫn chi tiết hơn, hãy xem bài viết của chúng tôi về trích xuất dữ liệu từ trang web bằng Thunderbit.
Con Đường Cho Người Mới Học Python: Bắt Đầu Với Scrapy
Xem phần quickstart có giải thích ở trên trong mục Scrapy. Các lệnh chính là pip install scrapy, scrapy startproject, chỉnh spider với ROBOTSTXT_OBEY = True và DOWNLOAD_DELAY, sau đó scrapy crawl example -o output.json. Hãy test selector trong scrapy shell trước khi scale. Thời gian thực hiện thay đổi tùy mức quen với Python của bạn.
Con Đường JavaScript: Bắt Đầu Với Crawlee
Xem phần quickstart Crawlee ở trên. Chạy npx crawlee create my-crawler, chọn template Playwright, sửa handler rồi npm start. Kết quả sẽ xuất hiện dưới dạng JSON trong thư mục dataset cục bộ. Thêm maxRequestsPerCrawl và ràng buộc domain trước khi scale.
Nếu bạn muốn một walkthrough dài hơn theo kiểu Python-first để hiểu một dự án crawler vận hành ra sao, khóa học này là tài liệu đi kèm rất hữu ích:
Thử Miễn Phí, Không Cần Thẻ Tín Dụng Gói miễn phí cho 6 trang mỗi tháng, đủ để bạn thực hành trích xuất dữ liệu trước khi quyết định dùng công cụ trả phí. Get Started Free
5 Sai Lầm Phổ Biến Khiến Lần Crawl Đầu Tiên Thất Bại (và Cách Tránh)
Những lỗi này xuất hiện liên tục trên diễn đàn, nhưng hiếm có bài viết top đầu nào dành riêng một mục cho chúng.
Sai lầm 1: Dùng crawler chỉ HTTP cho site render bằng JavaScript
Vấn đề: nhiều website hiện đại tải dữ liệu bằng JavaScript sau phản hồi HTML ban đầu. Một request HTTP đơn giản chỉ trả về trang khung với các thẻ <div> trống—không có dữ liệu.
Cách khắc phục: Trước khi chọn công cụ, hãy mở trang đích, click phải và chọn View Source. Nếu dữ liệu bạn cần không nằm trong HTML thô, bạn cần công cụ có render trình duyệt: Playwright, PlaywrightCrawler của Crawlee, hoặc công cụ không cần code như Thunderbit hay Octoparse có render trong trình duyệt. Nhưng cũng đừng mặc định dùng browser khi HTTP là đủ—vì sẽ tăng chi phí và độ phức tạp.
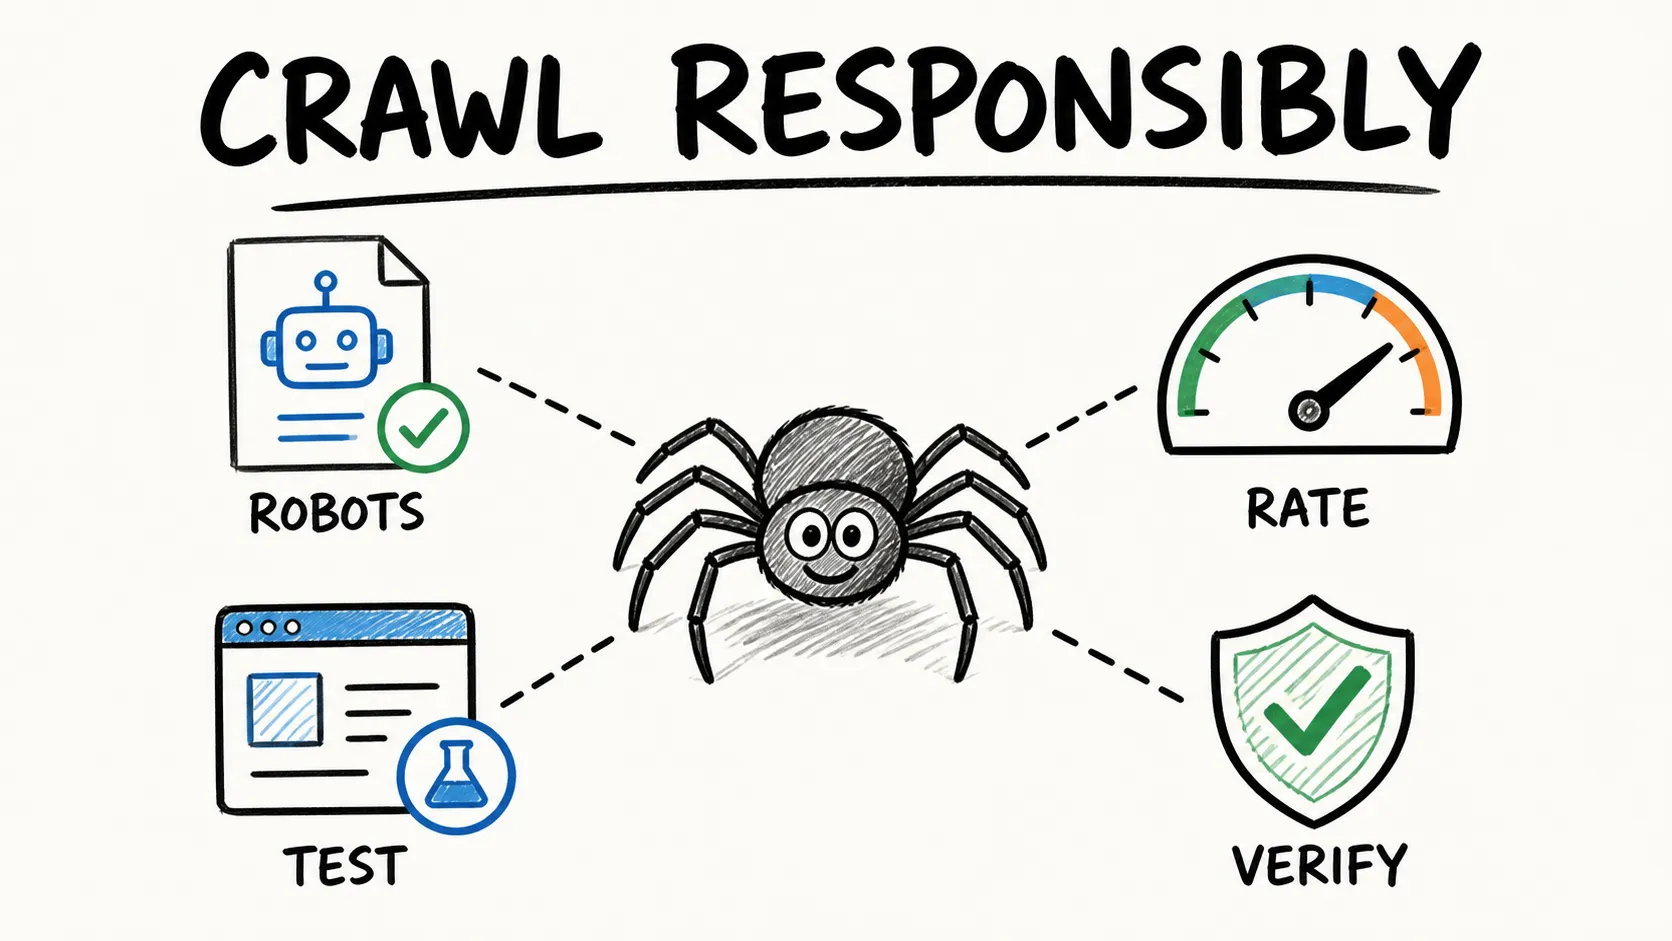
Sai lầm 2: Bỏ qua robots.txt và quy tắc Crawl-Delay
Vấn đề: robots.txt là tiêu chuẩn cho biết token crawler nào được truy cập đường dẫn nào. Bỏ qua chính sách crawl của website có thể dẫn đến bị chặn, gây hại vận hành và rủi ro tuân thủ.
Cách khắc phục: Luôn kiểm tra yoursite.com/robots.txt trước khi crawl, và xác minh giá trị mặc định thực tế của công cụ bạn chọn. Mặc định không giống nhau: ví dụ Colly khởi tạo IgnoreRobotsTxt = true và cần cấu hình rõ ràng. Lưu ý robots.txt là tín hiệu điều khiển crawl, không phải sự cho phép về mặt pháp lý. Một đường dẫn được phép không có nghĩa là bạn có quyền thu thập hay tái sử dụng dữ liệu cho mọi mục đích.
Sai lầm 3: Gửi quá nhiều request mà không giới hạn tốc độ
Vấn đề: bắn hàng trăm request mỗi giây có thể làm quá tải máy chủ đích, khiến IP của bạn bị chặn, và nói chung là thực hành rất tệ.
Cách khắc phục: Đặt độ trễ dương. Trong Scrapy, dùng DOWNLOAD_DELAY = 2 và giảm CONCURRENT_REQUESTS_PER_DOMAIN. Trong Colly, cấu hình LimitRule với độ trễ và mức song song. Các công cụ cloud/no-code thường tự xử lý chuyện này, nhưng vẫn nên kiểm tra cài đặt. Bắt đầu với một request đang chạy cho mỗi domain rồi chỉ tăng lên nếu hành vi và điều khoản của website cho phép.
Sai lầm 4: Chọn công cụ cấp doanh nghiệp cho một dự án nhỏ
Vấn đề: dựng một cụm Scrapy phân tán với xoay proxy và message queue cho dự án 500 trang cũng giống như thuê xe tải lớn chỉ để đi mua đồ ăn.
Cách khắc phục: Quay lại sơ đồ quyết định. Hãy khớp độ phức tạp của công cụ với quy mô dự án. Với các tác vụ trích xuất nhỏ, làm một lần, browser extension hoặc script đơn giản gần như luôn là lựa chọn đúng.
Sai lầm 5: Không kiểm tra dữ liệu đầu ra
Vấn đề: người mới thường xuất dữ liệu mà không kiểm tra, rồi sau đó mới phát hiện một nửa dòng bị trống, bị trùng hoặc bị lỗi mã hóa.
Cách khắc phục: Luôn kiểm tra nhanh 10–20 dòng đầu trước khi chạy toàn bộ. Tìm các trường trống, lỗi mã hóa (mojibake), dòng trùng lặp và giá trị bất thường. Xác định schema kỳ vọng trước khi bắt đầu—cần những cột nào, kiểu dữ liệu gì, trường nào bắt buộc. Một lần crawl thành công không có nghĩa là dữ liệu chính xác.
“LLM-Ready Output” Nghĩa Là Gì, Và Vì Sao Quan Trọng Ngay Cả Khi Bạn Chưa Làm AI
“LLM-ready” xuất hiện khắp nơi trong marketing về crawler năm 2026. Phần lớn giải thích giả định bạn đã biết vector database là gì. Dưới đây là bản diễn giải dễ hiểu.
LLM-ready output là văn bản sạch, có cấu trúc mà một mô hình AI (như GPT hoặc Claude) có thể nạp vào mà không cần dọn dẹp thủ công. Hãy hình dung nó như sự khác biệt giữa việc đưa ai đó một bảng tính gọn gàng so với một đống trang web in ra còn dính quảng cáo, menu điều hướng và banner cookie.
Vì sao bạn nên quan tâm dù không xây chatbot? Vì các công cụ được thiết kế cho đầu ra LLM-ready thường tạo ra dữ liệu sạch và dễ dùng hơn cho mọi người. Ít hậu xử lý hơn, ít cột rác hơn, ít vấn đề mã hóa hơn. Dữ liệu sạch vẫn là dữ liệu sạch, bất kể người hay máy đọc nó.
Những công cụ nào trong danh sách này tạo ra đầu ra LLM-ready ngay từ đầu?
- Firecrawl → Markdown sạch, tóm tắt, JSON có cấu trúc
- Crawl4AI → Nhiều biến thể Markdown, các khối có cấu trúc, bảng
- Thunderbit → Các trường có cấu trúc do AI gợi ý, kèm chuẩn hóa dựa trên prompt
Dưới đây là ví dụ trước/sau để dễ hình dung. HTML thô từ một trang sản phẩm có thể như sau:
<div class="product-card">
  <span class="price">$29.99</span>
  <h2 class="title">Wireless Mouse</h2>
  <p class="desc">Ergonomic design, 2.4GHz...</p>
  <a href="/buy" class="btn">Add to Cart</a>
</div>
Đầu ra Markdown LLM-ready từ Firecrawl:
## Wireless Mouse
- **Price:** $29.99
- **Description:** Ergonomic design, 2.4GHz
Đầu ra có cấu trúc từ Thunderbit:
| Tên sản phẩm | Giá | Mô tả |
|---|---|---|
| Wireless Mouse | $29.99 | Ergonomic design, 2.4GHz |
Cả hai đều dùng được ngay—không cần parse HTML, không cần lọc quảng cáo, không cần map cột thủ công. Để xem AI-powered extraction khác gì so với scraping truyền thống, hãy xem bài tổng quan về những AI web scraper tốt nhất.
Web Crawling Có Trách Nhiệm: Mẹo Nhanh Về Đạo Đức Và Tuân Thủ
Đạo đức và tuân thủ trong web crawling là thứ không thể bỏ qua:
- Kiểm tra robots.txt trước khi crawl bất kỳ website nào. Đây là tín hiệu điều khiển crawl theo chuẩn (RFC 9309), nhưng không phải là sự cho phép về mặt pháp lý hay ranh giới bảo mật.
- Tôn trọng rate limit và header Retry-After. Giảm tốc hoặc dừng lại khi gặp phản hồi 429 và 503.
- Chỉ dùng dữ liệu công khai hoặc được cho phép. Ưu tiên API chính thức hoặc xuất dữ liệu chính thức nếu nó đáp ứng nhu cầu của bạn.
- Kiểm tra điều khoản sử dụng của website. Việc dữ liệu hiển thị công khai là có liên quan, nhưng không phải lúc nào cũng là giấy phép chung để thu thập hoặc tái sử dụng.
- Cẩn trọng với dữ liệu cá nhân. Giảm thiểu thu thập, đặt quy tắc lưu trữ/xóa, và xin đánh giá chuyên môn cho các mục đích nhạy cảm. GDPR và các quy định tương tự vẫn áp dụng bất kể bạn dùng công cụ nào.
Nhiều công cụ có các cài đặt hỗ trợ crawl có trách nhiệm, nhưng cấu hình không chuyển trách nhiệm khỏi người vận hành. Để hiểu sâu hơn về quy trình nền tảng, xem bài giải thích của chúng tôi về web scraping là gì.
Nên Bắt Đầu Với Web Crawler Nào?
Tóm tắt nhanh theo cấp độ kỹ năng:
- Không code: Thunderbit để trích xuất trang có AI hỗ trợ, Octoparse để dựng workflow trực quan, ParseHub cho luồng nhiều bước phức tạp, Screaming Frog cho audit SEO
- Python trung cấp: Scrapy cho crawl HTTP quy mô lớn, Crawl4AI cho pipeline LLM
- JavaScript trung cấp: Crawlee cho crawl SPA hiện đại, Playwright cho tự động hóa trình duyệt phức tạp
- Go: Colly cho crawl HTTP nhanh (với cấu hình robots và rate limit rõ ràng)
- API managed: Firecrawl cho đầu ra Markdown sạch mà không cần tự host
Crawler tốt nhất là công cụ khớp với dữ liệu, quyền truy cập, trình độ và giới hạn vận hành của bạn. Hãy bắt đầu đơn giản, kiểm tra bằng một lượt chạy nhỏ, rồi chỉ tăng độ phức tạp khi dự án thật sự cần. Nếu bạn muốn thử trích xuất có hỗ trợ AI, Thunderbit browser extension cung cấp một lộ trình không cần code từ trang tương thích đến spreadsheet.
Tìm hiểu thêm
- AI Web Scraping
- Web Scraping Không Cần Code
- Web Scraping Là Gì
- Giải Pháp Thay Thế Instant Data Scraper
- Scraping LinkedIn
Thử Web Scraper Dạng Agentic Của Thunderbit Get Started Free
Câu Hỏi Thường Gặp
1. Web crawler là gì và khác gì với web scraper?
Crawler có nhiệm vụ khám phá và lấy các trang—nó theo link, quản lý hàng đợi URL, xử lý khử trùng lặp và giới hạn độ sâu. Scraper thì trích xuất dữ liệu có cấu trúc cụ thể từ các trang đó—nó parse HTML, chọn trường dữ liệu và xuất bản ghi. Phần lớn công cụ hiện đại làm cả hai ở các mức độ khác nhau, và hai thuật ngữ thường bị dùng thay thế cho nhau, nhưng sự phân biệt này rất quan trọng khi chọn công cụ: có công cụ như Playwright rất giỏi render trang nhưng không có hạ tầng crawl; trong khi công cụ như Scrapy cung cấp toàn bộ pipeline crawl nhưng cần plugin để render JavaScript.
2. Web crawler nào tốt nhất cho người không biết code?
Thunderbit, Octoparse và ParseHub là ba lựa chọn no-code hàng đầu cho trích xuất dữ liệu tổng quát. Thunderbit dùng AI để gợi ý trường dữ liệu và hoạt động như một browser extension; Octoparse có trình dựng workflow trực quan với Auto-detect; ParseHub mạnh ở luồng nhiều bước phức tạp. Với nhu cầu chỉ làm SEO, bản miễn phí của Screaming Frog crawl được tới 500 URL mà không cần code.
3. Web crawler có miễn phí không?
Có hai nhóm. Công cụ mã nguồn mở hoàn toàn (Scrapy, Crawlee, Crawl4AI, Playwright, Colly) không thu phí theo page, nhưng bạn phải tự host hạ tầng và trả chi phí compute, băng thông, lưu trữ. Công cụ freemium (Octoparse, ParseHub, Thunderbit, Firecrawl, Screaming Frog) có gói miễn phí với các giới hạn khác nhau về trang, dự án, xuất dữ liệu hoặc tính năng. Xem bảng so sánh gói miễn phí ở trên để biết chi tiết.
4. Web crawler có xử lý được website nhiều JavaScript không?
Có, nhưng không phải tất cả. Các công cụ có render trình duyệt tích hợp—Playwright, Crawlee (PlaywrightCrawler), Octoparse, ParseHub, Crawl4AI, và Thunderbit (qua Browser Mode)—đều xử lý được nội dung tải bằng JavaScript. Scrapy và Colly là HTTP-first và cần tích hợp browser riêng để render JS. Screaming Frog chỉ hỗ trợ JavaScript rendering ở bản trả phí. Luôn kiểm tra xem trang đích có thật sự cần browser hay không bằng cách xem source HTML trước.
5. Web crawling có hợp pháp không?
Không có câu trả lời chung là có hay không. Việc đánh giá pháp lý phụ thuộc vào dữ liệu, phương thức truy cập, mục đích sử dụng, điều khoản website, hợp đồng, quy định về sở hữu trí tuệ, nghĩa vụ riêng tư như GDPR và thẩm quyền áp dụng. robots.txt là tín hiệu điều khiển crawl, không phải là sự cho phép về mặt pháp lý, và việc nội dung hiển thị công khai không phải giấy phép dùng chung. Với các tình huống cụ thể—đặc biệt liên quan đến dữ liệu cá nhân, nội dung có bản quyền, xác thực đăng nhập hoặc tái sử dụng thương mại—hãy tham khảo chuyên gia pháp lý đủ năng lực.




