
Tháng trước, một tích hợp Stripe của người bạn tôi bắt đầu lặng lẽ trả về lỗi 503 vào đúng 11 giờ đêm thứ Sáu. Không ai phát hiện ra cho đến sáng thứ Bảy — lúc đó hộp thư hỗ trợ đã chất hơn 200 email bức xúc từ khách hàng vì thanh toán bị fail.
Câu chuyện như vậy không hề hiếm. Một chuẩn tham chiếu được trích dẫn rộng rãi ước tính chi phí downtime trung bình là 5.600 USD mỗi phút, trong khi các sự cố nghiêm trọng có thể lên tới hàng triệu USD mỗi giờ. Con số thực tế còn tùy vào lưu lượng, tỷ lệ chuyển đổi, giá trị đơn hàng, phạm vi SLA và chi phí khôi phục — nhưng kết luận chung thì quá rõ: API không được giám sát là rủi ro kinh doanh, chứ không chỉ là sự cố kỹ thuật. Và khi các tổ chức hiện đang vận hành trung bình 131 API bên thứ ba và chỉ 16% báo cáo có khả năng cao để giảm thiểu rủi ro từ API bên thứ ba, thì giám sát không còn là thứ có cũng được nữa. Điều tôi muốn làm trong bài này là một việc mà tôi chưa thấy ở nơi khác: sắp xếp công cụ theo từng tình huống sử dụng, đánh giá chất lượng cảnh báo (không chỉ là có cảnh báo hay không), đưa ra mức giá thực tế năm 2026, và đo xem bạn có thể triển khai thật sự nhanh đến đâu. Không chỉ đơn thuần là một danh sách logo.
Thêm một điểm nữa: nếu công việc API của bạn có liên quan đến thu thập dữ liệu web, cấp nguồn cho LLM, xây dựng hệ thống RAG, theo dõi trang đối thủ, hoặc trích xuất dữ liệu giá/sản phẩm từ website, thì cuộc trò chuyện về “công cụ API” không nên dừng ở giám sát uptime. Bạn còn cần một cách đáng tin cậy để biến những trang web lộn xộn thành dữ liệu có cấu trúc. Đó là chỗ Thunderbit Open API xuất hiện trong bài này: nó không phải công cụ giám sát uptime, nhưng lại là một trong những cách nhanh nhất để biến website thành Markdown sạch hoặc JSON theo schema thông qua API.
Giám sát API là gì (và vì sao đội của bạn nên quan tâm)?
Giám sát API nghĩa là kiểm tra liên tục xem các endpoint của bạn có đang sẵn sàng, phản hồi nhanh và trả về dữ liệu đúng hay không. Nó không chỉ dừng ở câu hỏi “server còn sống không?” — một bộ monitor tốt sẽ xác thực mã trạng thái HTTP, nội dung phản hồi, độ trễ, chứng chỉ SSL, luồng nhiều bước (như đăng nhập → tìm kiếm → thanh toán), và thậm chí cả tính đúng đắn của schema.
Điều này khác với giám sát website nói chung (chỉ xem trang có tải được hay không) và khác với APM (Application Performance Monitoring), vốn đi sâu vào trace cấp mã nguồn, truy vấn cơ sở dữ liệu và các chi tiết runtime nội bộ. Giám sát API đứng ở điểm giao nhau: nó kiểm thử trải nghiệm thực tế mà người dùng, đối tác và các tích hợp cảm nhận được khi gọi endpoint của bạn.
Cũng có một nhóm liên quan khá đáng chú ý: các web data API. Những công cụ này không giám sát xem API của chính bạn có khỏe hay không; chúng giúp sản phẩm hoặc workflow của bạn thu thập dữ liệu web bên ngoài một cách ổn định. Ví dụ, Thunderbit Open API có thể rút gọn một trang web thành Markdown sạch, trích xuất các trường có cấu trúc dưới dạng JSON, và chạy batch trên nhiều URL. Nếu dự án “API” của bạn phụ thuộc vào dữ liệu nhà cung cấp mới, trang sản phẩm, danh sách công khai, trang tài liệu hoặc nguồn nghiên cứu, thì kiểu API trích xuất dữ liệu này quan trọng về mặt vận hành không kém gì việc kiểm tra uptime.
Vì sao người không làm kỹ thuật cũng nên quan tâm? Vì API chiếm 71% lưu lượng web động và 62% chuyên gia API cho biết API trực tiếp tạo ra doanh thu. Khi cổng thanh toán, dịch vụ xác thực hoặc API vận chuyển gặp lỗi, đó không còn là chuyện hạ tầng trừu tượng nữa — mà là mất doanh thu, đổ vỡ hợp đồng đối tác, tăng đột biến ticket hỗ trợ và bào mòn niềm tin. PM, sales, ops và customer success đều bị ảnh hưởng.
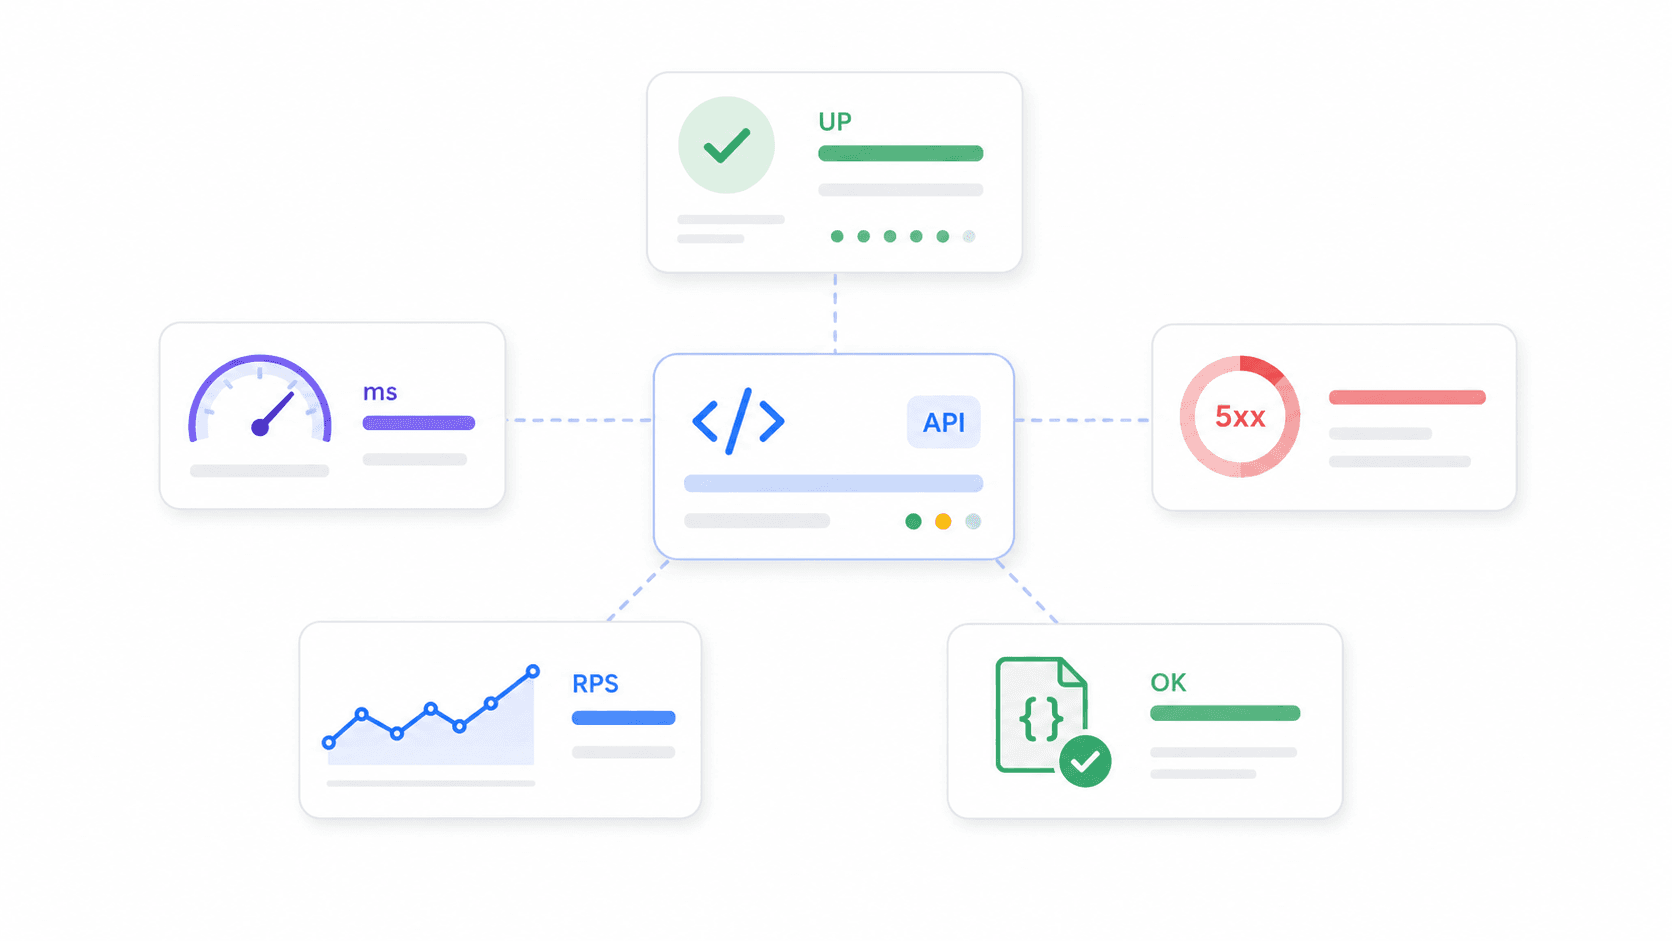
Các chỉ số chính cần theo dõi:
- Tỷ lệ uptime: phần thời gian endpoint khả dụng
- Thời gian phản hồi / độ trễ: endpoint mất bao lâu để trả lời (trung bình, p95, p99)
- Tỷ lệ lỗi: tỷ lệ request trả về 5xx, timeout hoặc lỗi assertion
- Throughput: số request mỗi giây/phút
- Độ chính xác: API có trả về dữ liệu mong đợi hay không, chứ không chỉ là 200 OK
Cách chúng tôi đánh giá các công cụ giám sát API tốt nhất cho 2026
Phần lớn các bài “công cụ giám sát API tốt nhất” chỉ liệt kê tên nhà cung cấp và tính năng. Tôi muốn chọn lọc kỹ hơn — một phần vì đã dành khá nhiều thời gian đọc forum dev, và một phần vì team Thunderbit đã giúp tôi trích xuất hàng loạt dữ liệu giá và tính năng từ website của các nhà cung cấp để xây dựng so sánh thực tế (tôi sẽ nói rõ workflow đó ở phần sau).
Dưới đây là các tiêu chí chúng tôi cân nhắc:
| Tiêu chí | Vì sao quan trọng |
|---|---|
| Dễ triển khai / thời gian đến cảnh báo đầu tiên | Đội nhỏ cần có coverage ngay hôm nay, không phải sau một dự án nền tảng kéo dài |
| Độ thông minh của cảnh báo & giảm nhiễu | Cảnh báo quá ồn thì đội sẽ bỏ qua, rồi bỏ lỡ sự cố thật |
| Mức hào phóng của gói miễn phí | Dự án phụ và startup giai đoạn đầu thường bắt đầu từ gói free |
| Tính minh bạch về giá | Hóa đơn observability có thể phình ra vì host, seat, log, synthetic run và data ingest |
| Độ phủ tích hợp | Cảnh báo phải đến nơi đội đang làm việc: Slack, PagerDuty, v.v. |
| Khả năng mở rộng & độ sâu dữ liệu | Team trưởng thành cần trace, log, APM, RBAC, SSO, retention |
| Chất lượng cộng đồng & hỗ trợ | Team open-source cần nhịp phát hành đều; team enterprise cần SLA |
| Khả năng trích xuất dữ liệu web | Ứng dụng AI, workflow RAG và công cụ nghiên cứu thị trường thường cần dữ liệu bên ngoài sạch, không chỉ uptime endpoint |
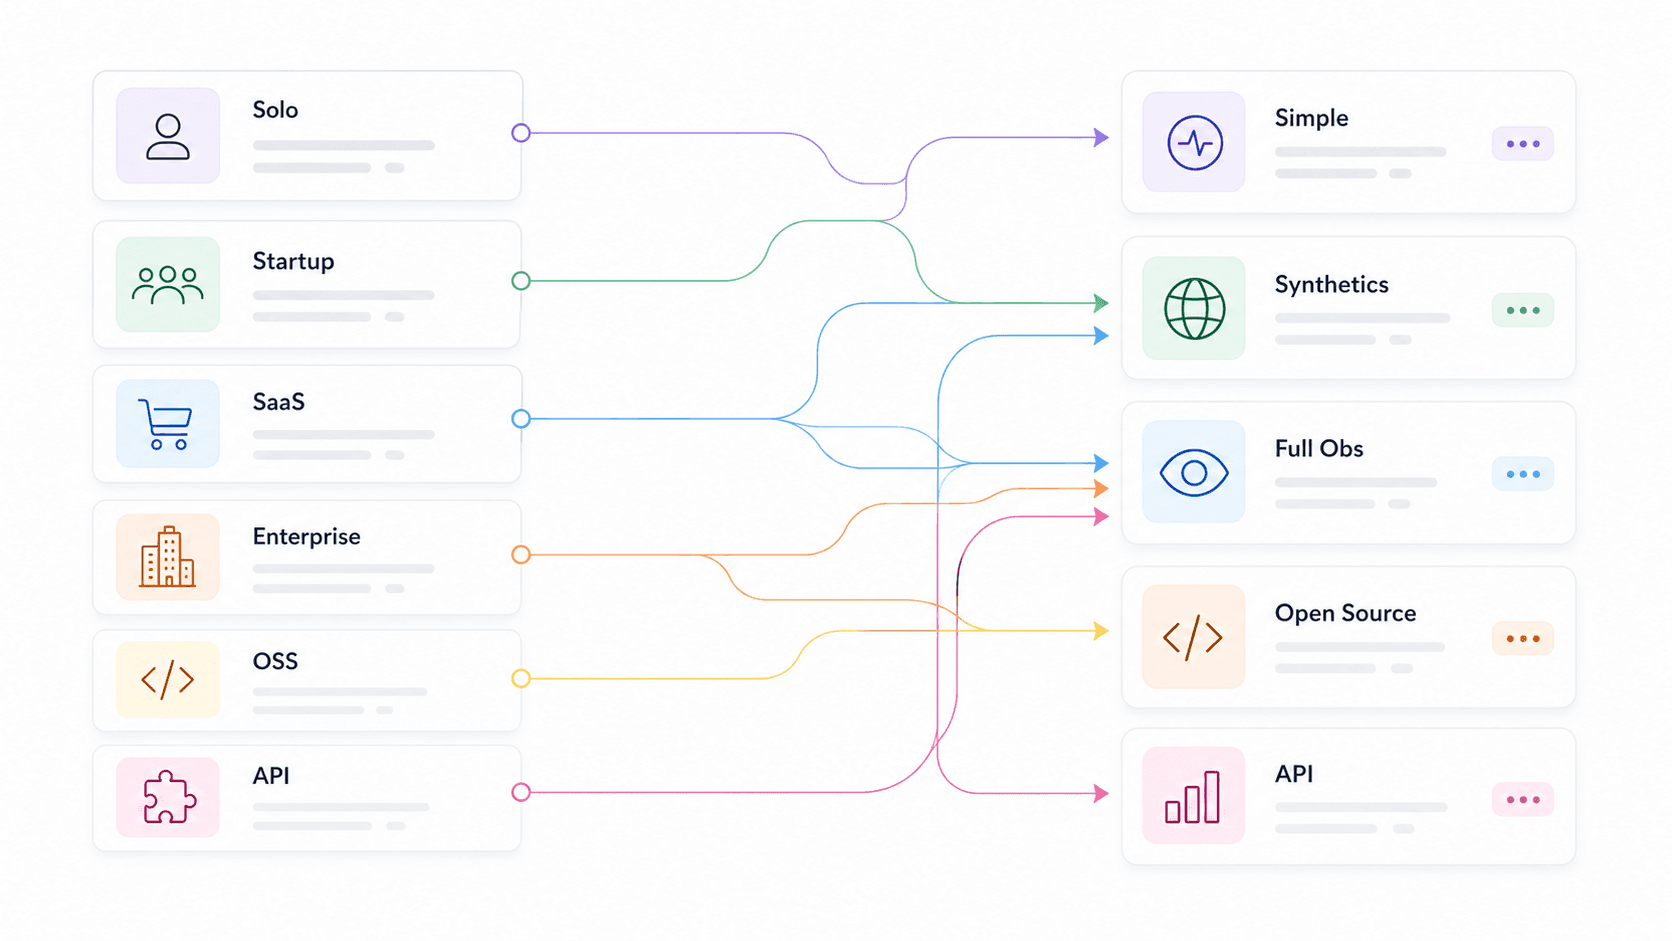
Chúng tôi cũng phân nhóm khuyến nghị theo use case — dev solo, startup, e-commerce/SaaS, enterprise, người theo chủ nghĩa open-source, team sản phẩm API và team AI/dữ liệu web — để bạn có thể nhảy ngay tới bối cảnh của mình thay vì đọc 14 phần mô tả công cụ rồi đoán xem cái nào hợp. Khảo sát năm 2025 của Grafana cho thấy 46% người tham gia nêu khả năng tương thích và 35% nêu mức dễ chuyển đổi trong tương lai là tiêu chí lựa chọn, điều này xác nhận rằng đây không chỉ là những tính năng “cho có”.
Công cụ giám sát API tốt nhất theo từng use case: Bảng chọn nhanh
Đây là lối tắt. Hãy tìm dòng của bạn, rồi đọc kỹ phần công cụ ở bên dưới để xem phân tích đầy đủ.
| Use Case | Công cụ đề xuất | Điểm khác biệt chính |
|---|---|---|
| Team web data / AI app | Thunderbit Open API, Moesif, Apitally | Biến website thành Markdown sạch hoặc JSON có cấu trúc cho LLM, RAG, giá và research workflow |
| Dev solo / dự án phụ | UptimeRobot, Uptime Kuma, Gatus | Miễn phí hoặc tự host, cấu hình tối thiểu, triển khai rất nhanh |
| Startup (đội 5–15 người) | Checkly, Better Stack, Postman | Cảnh báo thông minh, setup nhanh, chi phí hợp lý, status page |
| E-commerce / SaaS | Datadog, New Relic, Moesif, Checkly | Business metrics, APM/tracing, độ sâu SDK, synthetic nhiều bước |
| Enterprise / multi-cloud | Datadog, New Relic, Splunk, Grafana Cloud | Distributed tracing, compliance, hybrid, RBAC/SSO |
| Người theo chủ nghĩa open-source | Prometheus + Grafana, Uptime Kuma, Gatus, Uptrace | Toàn quyền kiểm soát, native với OTel, không bị khóa bởi nhà cung cấp |
| Team sản phẩm API | Moesif, Apitally, New Relic | Mức sử dụng theo từng khách hàng, xu hướng endpoint, cảnh báo bất thường |
Mẫu hình lớn nhất: công cụ triển khai càng nhanh thì thường càng nhẹ về phân tích; còn nền tảng càng sâu thì càng cần cấu hình nhiều và kỷ luật chi phí chặt hơn. Đây không phải lỗi — mà là một đánh đổi cần hiểu rõ. Thunderbit nằm ở một ngách hơi khác: nó nhanh nhất khi nhiệm vụ là biến trang web thành dữ liệu sẵn sàng cho API, chứ không phải báo cho kỹ sư trực on-call về downtime.
Thunderbit Open API: Tốt nhất để biến website thành dữ liệu API có cấu trúc
Bắt đầu xây dựng với Thunderbit Open API Rút gọn trang thành Markdown, trích xuất JSON có cấu trúc và xử lý hàng loạt URL mà không phải tự duy trì hạ tầng scraping. Get Started Free
Thunderbit Open API là API tôi sẽ đặt lên đầu cho các team mà workflow “giám sát” hoặc nghiên cứu của họ phụ thuộc vào dữ liệu web bên ngoài. Đây không phải công cụ giám sát uptime truyền thống như Checkly hay UptimeRobot. Thay vào đó, Thunderbit biến bất kỳ trang web nào thành dữ liệu sạch, có cấu trúc để app, agent, dashboard và pipeline LLM có thể dùng ngay.
API này có ba workflow cốt lõi. Distill chuyển một trang thành Markdown sạch, sẵn sàng cho LLM. Extract nhận một schema và trả về các trường JSON có cấu trúc như tên sản phẩm, giá, tình trạng còn hàng, quy mô công ty, giai đoạn gọi vốn hoặc điểm đánh giá. Batch cho phép xử lý tới 100 URL bất đồng bộ với webhook, rất hữu ích khi bạn theo dõi trang giá, catalog đối thủ, tài liệu nhà cung cấp, nguồn tin tức hoặc danh sách nghiên cứu lớn.
Lý do nó xứng đáng có mặt trong bài viết về công cụ API là vì nhiều team đánh giá thấp hạ tầng mà câu lệnh “chỉ cần scrape trang này” đòi hỏi. Các trang nặng JavaScript cần render. Một số trang cần định tuyến theo vùng địa lý. HTML phải được dọn khỏi thanh điều hướng, quảng cáo, modal và các phần boilerplate trước khi có ích cho LLM. Selector có thể gãy khi layout thay đổi. Xoay proxy, xử lý anti-bot, retry, queue và polling kết quả có thể biến một workflow dữ liệu nhỏ thành một dự án bảo trì. Thunderbit hấp thụ phần lớn công việc đó qua một API duy nhất.
Phù hợp nhất cho: người xây app AI, team RAG, ops e-commerce, sales ops, growth team, nhà nghiên cứu thị trường và lập trình viên cần dữ liệu website qua API mà không muốn tự xây và tự vận hành một stack scraping.
Giá: Miễn phí: 600 API units dùng một lần, bao gồm tối đa 600 trang Distill hoặc 30 trang Extract, với 2 request đồng thời. Gói Starter được niêm yết 16 USD/tháng khi thanh toán theo năm, gồm 60.000 API units/năm và 30 request đồng thời. Gói Pro được niêm yết 40 USD/tháng theo năm, gồm 600.000 API units/năm và 50 request đồng thời.
Tốc độ thiết lập: khoảng 5–15 phút để lấy API key và chạy request Distill hoặc Extract đầu tiên bằng cURL, SDK hoặc Thunderbit CLI.
Hạn chế: Thunderbit không thay thế Datadog, New Relic, Better Stack hay Checkly cho việc kiểm tra uptime, điều phối sự cố, trace, log hay routing on-call. Hãy xem nó là API bạn dùng để thu thập và cấu trúc dữ liệu web — bao gồm giá từ nhà cung cấp, tài liệu, trang đối thủ, danh sách sản phẩm hoặc dataset công khai — chứ không phải hệ thống báo động cho kỹ sư trực on-call.
Datadog: Tốt nhất cho khả năng quan sát toàn stack
Datadog là công cụ tôi thường thấy trong các stack enterprise và SaaS tầm trung, và điều đó có lý do. Nó không chỉ là giám sát API — mà là một nền tảng observability đầy đủ, kết nối synthetic API test với distributed trace, log, metric hạ tầng và real user monitoring trong cùng một màn hình.
Riêng với giám sát API, Datadog hỗ trợ HTTP, SSL, DNS, WebSocket, TCP, UDP, ICMP, gRPC và multi-step API tests. Anomaly detection monitors của nó học mẫu kỳ vọng và cảnh báo khi có sai lệch thay vì chỉ dựa vào ngưỡng tĩnh — đây là một bước nâng cấp đáng kể so với kiểu “cảnh báo khi latency > 500ms”. Nó cũng có forecast monitor để dự đoán thời điểm một metric sẽ chạm ngưỡng, cùng composite monitor để kết hợp nhiều điều kiện.
Phù hợp nhất cho: đội e-commerce, SaaS và enterprise cần một bảng điều khiển duy nhất cho API, hạ tầng, log và trace.
Giá: chi tiết gói miễn phí thay đổi theo từng sản phẩm. Infrastructure Pro bắt đầu từ 15 USD/host/tháng; synthetic API test ở mức 5 USD cho 10.000 lần chạy. Hơn 800 tích hợp.
Tốc độ thiết lập: khoảng 15–30 phút cho việc cài agent và tạo một synthetic test cơ bản.
Hạn chế: Có thể rất đắt khi mở rộng — “bill shock” là chủ đề lặp lại trên Hacker News và Reddit. Số lượng SKU quá nhiều (host, log, custom metric, synthetic, user) đồng nghĩa phải có người theo dõi hóa đơn chứ không chỉ dashboard. Độ dốc học tập cho toàn nền tảng là có thật.
Checkly: Tốt nhất cho các synthetic check thân thiện với dev
Checkly là công cụ tôi sẽ đưa cho team engineering ở startup muốn các API check nằm gần code. Ý tưởng cốt lõi của nó là “monitoring as code”: định nghĩa API check và browser check bằng chương trình, chạy từ các vị trí toàn cầu, tích hợp với CI/CD và quản lý mọi thứ qua Git.
Khía cạnh chất lượng cảnh báo ở đây rất mạnh. Logic retry của Checkly được mô tả rõ là “tuyến phòng thủ đầu tiên” chống false positive — bạn có thể cấu hình retry cố định, tuyến tính hoặc lũy thừa, retry cùng hoặc khác vị trí, và giới hạn thời gian retry tối đa trước khi cảnh báo được phát. Nó cũng phân biệt trạng thái degraded, failed và recovered, giúp giảm cảnh báo ồn.
Phù hợp nhất cho: startup và team dev muốn API check có thể lập trình, browser check dựa trên Playwright, tích hợp CI/CD và triển khai nhanh.
Giá: dữ liệu công khai gần đây cho thấy có gói miễn phí với 10 uptime monitor, 1.000 browser check và 10.000 API check. Gói Starter khoảng 24 USD/tháng khi thanh toán theo năm — hãy kiểm tra trang giá chính thức trước khi mua.
Tốc độ thiết lập: khoảng 10–20 phút để có API check đầu tiên và kênh cảnh báo.
Hạn chế: tập trung vào synthetic check. Không thay thế được APM sâu, phân tích log hoặc distributed tracing. Nếu bạn cần ghép lỗi API với nút thắt cơ sở dữ liệu, bạn sẽ cần thêm công cụ khác.
UptimeRobot: Tốt nhất cho việc theo dõi uptime đơn giản, tiết kiệm
UptimeRobot là “Honda Civic” của giám sát API. Nó làm tốt một việc: bạn tạo monitor HTTP, keyword, ping, port, SSL hoặc heartbeat, chọn khoảng thời gian kiểm tra, rồi nhận cảnh báo khi nó lỗi. Hết.
Phù hợp nhất cho: dev solo, team nhỏ, agency hoặc bất kỳ ai cần theo dõi uptime và latency cơ bản mà không muốn phức tạp.
Giá: Miễn phí: 50 monitor, interval 5 phút. Gói Solo trả phí khoảng 7 USD/tháng khi thanh toán theo năm. Không cần thẻ tín dụng cho gói free. Tốc độ thiết lập: khoảng 2–5 phút — nhanh nhất trong danh sách.
Hạn chế: trí thông minh cảnh báo hạn chế. Chỉ có ngưỡng cơ bản, không có anomaly detection, không có distributed tracing, không có phân tích sâu. Nếu bạn cần biết vì sao endpoint chậm chứ không chỉ rằng nó chậm, UptimeRobot chưa đủ.
Uptime Kuma: Công cụ giám sát API tự host miễn phí tốt nhất
Uptime Kuma là công cụ được cộng đồng self-host cực kỳ yêu thích, và các con số GitHub nói lên tất cả: 86.637 sao, 7.831 fork, 1.060 contributor, với bản phát hành 2.3.2 tính đến tháng 5/2026. Nó dùng giấy phép MIT, hỗ trợ HTTP(s), keyword, JSON query, WebSocket, TCP, ping, DNS, push, Docker, nhiều status page và hơn 90 dịch vụ thông báo.
Phù hợp nhất cho: dev solo và team muốn toàn quyền kiểm soát, riêng tư và không tốn phí SaaS định kỳ — miễn là bạn có server.
Giá: miễn phí. Chi phí thực tế là VM/container, backup, cập nhật, và đảm bảo chính monitor cũng luôn hoạt động. Tốc độ thiết lập: khoảng 5–15 phút với Docker cho một check cơ bản; 15–30 phút nếu thêm thông báo và status page chỉn chu.
Hạn chế: bạn tự gánh bảo trì. Và đây là điểm cần đặc biệt lưu ý: nếu bạn host Uptime Kuma trên cùng hạ tầng mà nó đang giám sát, một sự cố cloud hoặc DNS sẽ làm sập cả app lẫn monitor. Hãy host nó bên ngoài hoặc kết hợp với một check SaaS.
Better Stack: Tốt nhất cho phản ứng sự cố nhanh
Better Stack (thường vẫn được người dùng gọi là Better Uptime) kết hợp giám sát uptime với quản lý sự cố, lịch on-call, chính sách leo thang và status page trong cùng một nền tảng. Điểm mạnh nhất của nó không phải là công cụ phân tích, mà là công cụ workflow sự cố được gắn với monitoring.
Chính sách leo thang xác định ai sẽ được cảnh báo, theo thứ tự nào, với độ trễ ra sao, cho đến khi có người xác nhận. Routing dựa trên metadata gửi sự cố theo mức độ nghiêm trọng hoặc quyền sở hữu. Nó tích hợp với Slack, Teams, webhooks và Zapier.
Phù hợp nhất cho: startup và team quy mô vừa muốn monitoring + incident response + status page mà không phải ghép ba công cụ riêng biệt.
Giá: gói miễn phí: 10 monitor/heartbeat, 1 status page. Gói Team khoảng 29 USD/tháng khi thanh toán theo năm. Tốc độ thiết lập: khoảng 5–10 phút qua GUI wizard.
Hạn chế: độ sâu trong phân tích payload API, distributed tracing hoặc phân tích KPI kinh doanh thấp hơn Datadog, New Relic hay Moesif.
Prometheus + Grafana: Stack giám sát API open-source tốt nhất
Đây là combo open-source tiêu chuẩn trong ngành. Prometheus thu thập và lưu trữ metric chuỗi thời gian. Grafana (73.705 sao GitHub, 3.010 contributor) cung cấp dashboard và alerting. Alertmanager xử lý routing, grouping, deduplication, silencing và inhibition. Với kiểm tra endpoint API, các team thường thêm Blackbox Exporter để probe HTTP, HTTPS, DNS, TCP, ICMP và gRPC.
Phù hợp nhất cho: người theo chủ nghĩa open-source, team Kubernetes/SRE và các tổ chức đã chuẩn hóa theo metric Prometheus.
Giá: tự host miễn phí. Grafana Cloud có gói free (100.000 lần thực thi API test mỗi tháng) và các gói trả phí theo mức sử dụng.
Tốc độ thiết lập: 1–4 giờ cho cấu hình cơ bản Blackbox + Prometheus + Grafana + Alertmanager. Cần vài ngày nếu muốn HA sản xuất và tinh chỉnh cảnh báo.
Hạn chế: PromQL, YAML, relabeling, thiết kế dashboard, retention, storage, HA và tinh chỉnh alert đều là công việc vận hành thật sự. Đánh đổi lặp đi lặp lại là “ít UI hơn, nhiều YAML hơn.” Đây là stack dành cho team vốn đã nghĩ bằng metric và muốn một control plane thống nhất — không phải cho đội muốn mọi thứ chạy xong trước giờ ăn trưa.
New Relic: Tốt nhất cho hiệu năng ứng dụng SaaS
New Relic kết hợp APM, giám sát hạ tầng, log, distributed tracing, synthetic monitoring, alert, dashboard và phân tích sự cố có hỗ trợ AI. Gói miễn phí của nó — 100 GB/tháng data ingest và 1 full platform user — thực sự khá hào phóng cho team nhỏ.
Phần trí thông minh cảnh báo là nơi New Relic tỏa sáng trong câu chuyện giảm alert fatigue. Các tính năng incident intelligence gồm tương quan sự kiện, anomaly detection, cảnh báo dự đoán, phân tích nguyên nhân gốc rễ và chặn flapping. New Relic từng đưa ra một ví dụ rằng 97,2% hiệu quả chặn flapping nghĩa là chỉ có 28 vấn đề được đưa ra trên mỗi 1.000 sự cố flapping — đây là một con số giảm nhiễu rất cụ thể.
Phù hợp nhất cho: team SaaS và nền tảng e-commerce muốn giám sát API được tích hợp chặt với trace cấp ứng dụng, lỗi, throughput và tác động đến người dùng.
Giá: miễn phí: 100 GB/tháng, 1 full user. Gói trả phí tính theo user và dữ liệu.
Tốc độ thiết lập: khoảng 15–30 phút để cài agent và dùng setup có hướng dẫn.
Hạn chế: giá có thể trở nên phức tạp khi mở rộng. Cấu hình cảnh báo cũng có độ dốc học tập — nền tảng rất mạnh nhưng không phải lúc nào cũng trực quan ngay từ đầu.
Moesif: Tốt nhất cho phân tích API và chỉ số kinh doanh
Moesif không phải là một monitor uptime truyền thống. Đây là phân tích API và product intelligence: hiểu cách sử dụng API theo từng khách hàng, endpoint, cohort, công ty, khu vực, SDK, gói và hành vi. Nếu câu hỏi của bạn là “khách hàng nào đang bị ảnh hưởng?” chứ không phải “endpoint có đang lên không?”, Moesif được tạo ra cho điều đó.
Nó hỗ trợ cảnh báo ngưỡng tĩnh và cảnh báo bất thường động cho các metric API như tăng/giảm traffic đột ngột, latency và thay đổi hành vi. Cảnh báo động cần vài ngày dữ liệu hành vi API để xây dựng mô hình, nhưng sau khi được huấn luyện, chúng bắt được những thay đổi mà rule tĩnh bỏ sót.
Phù hợp nhất cho: team sản phẩm API, công ty SaaS và nền tảng e-commerce cần nối hiệu năng API với doanh thu, mức độ tương tác và giữ chân khách hàng.
Giá: có bản free/trial; gói trả phí mở rộng theo lượng API event. Mức giá tự phục vụ bằng USD tôi không trích xuất được đầy đủ trong quá trình nghiên cứu — hãy kiểm tra trang hiện tại.
Tốc độ thiết lập: khoảng 20–45 phút (tích hợp SDK/proxy/gateway sâu hơn một lần ping bên ngoài).
Hạn chế: thiên về phân tích hơn là giám sát uptime truyền thống. Bạn có thể sẽ muốn ghép Moesif với Checkly, UptimeRobot hoặc Datadog synthetics để kiểm tra khả dụng từ bên ngoài.
Splunk: Tốt nhất cho phân tích log doanh nghiệp và compliance
Splunk là công cụ bạn dùng khi tổng hợp log, tìm kiếm, tương quan, khả năng audit sẵn sàng cho compliance và hỗ trợ hybrid/multi-cloud là những thứ bắt buộc phải có. Splunk Observability Cloud bao phủ hạ tầng, APM, synthetics, real user monitoring, log và xử lý sự cố. ITSI/Event Analytics có thể nhóm các sự kiện đáng chú ý thành episode và giảm nhiễu trên các silo giám sát.
Nghiên cứu quan sát năm 2025 của chính Splunk cho thấy một bức tranh khá đáng lo: 73% người trả lời thuộc ITOps/engineering báo cáo outage do cảnh báo bị bỏ qua hoặc bị chặn, 59% gặp khó vì quá nhiều công cụ rời rạc và 52% gặp vấn đề false alert.
Phù hợp nhất cho: enterprise và team multi-cloud có yêu cầu nghiêm ngặt về compliance, bảo mật, audit và tìm kiếm log.
Giá: tính theo mức sử dụng và thường phải báo giá. Không có gói free đơn giản cho môi trường production.
Tốc độ thiết lập: onboarding cloud có thể nhanh hơn, nhưng triển khai enterprise thường mất vài ngày đến vài tuần.
Hạn chế: đắt khi mở rộng. Thiết lập phức tạp. Quá mức cần thiết cho dev solo và startup nhỏ.
Postman: Tốt nhất cho team đã quen test API
Postman chủ yếu là nền tảng phát triển và kiểm thử API, nhưng sản phẩm monitoring của nó cho phép các team lên lịch collection Postman và chạy chúng từ các vị trí cloud. Lý do mạnh nhất để dùng là khả năng tái sử dụng: nếu QA hoặc dev team của bạn đã có sẵn các collection với assertion, biến chúng thành monitor là bước đi rất tự nhiên.
Phù hợp nhất cho: team dev và QA vốn đã dùng Postman collections và muốn có check theo lịch mà không cần mua thêm một synthetic tool riêng.
Giá: có gói free. Mức vượt ngưỡng monitoring là 0,75 USD cho mỗi 1.000 cuộc gọi; có gói add-on 50.000 cuộc gọi với giá 20 USD/tháng. Hãy kiểm tra trang plan hiện tại — cách Postman đóng gói gói dịch vụ thường thay đổi.
Tốc độ thiết lập: khoảng 10 phút nếu collection đã có sẵn.
Hạn chế: khả năng monitoring nhẹ hơn các công cụ chuyên dụng như Checkly, Datadog hay New Relic. Tùy chọn cảnh báo khá cơ bản.
Những công cụ giám sát API khác đáng xem xét
Gatus: dashboard kiểm tra sức khỏe nhẹ, tự host, theo cấu hình. 10.906 sao GitHub, hỗ trợ HTTP, ICMP, TCP, DNS, metric thân thiện với Prometheus và uptime badge. Rất hợp với dev solo muốn thứ gì đó đơn giản hơn Prometheus nhưng thích YAML/config-as-code hơn giao diện của Uptime Kuma.
Apitally: công cụ mới hơn tập trung vào phân tích lưu lượng API và theo dõi chất lượng cho startup. Cho biết thiết lập dưới 5 phút với cảnh báo tùy chỉnh trên 14 metric. Phù hợp cho phân tích API nhẹ mà không cần áp một nền tảng observability đầy đủ.
Sematext: monitoring full-stack với log, synthetics và khả năng quan sát hạ tầng. Synthetics khoảng 2 USD mỗi HTTP monitor, 7 USD mỗi browser monitor, tối thiểu 5 USD/tháng. Một lựa chọn thay thế Datadog với chi phí thấp hơn cho team mid-market.
Uptrace: backend APM, tracing, metric và log native với OpenTelemetry. 4.198 sao GitHub. Không phải trình kiểm tra uptime thuần túy, nhưng rất hợp với team chuẩn hóa theo OTel và muốn một backend tracing thân thiện với open-source.
Tự xây hay mua: Có nên tự làm giám sát API không?
“Tôi chỉ cần viết một script ping endpoint của mình thôi, hay nên dùng công cụ chuyên dụng?”
Câu hỏi này xuất hiện liên tục trên các forum dev. Tôi đã đọc đủ nhiều thread Reddit để thấy mẫu hình rất rõ: team bắt đầu với curl + cron, chạy ổn một thời gian, rồi chuyển sang công cụ chuyên dụng khi họ cần dashboard, dữ liệu lịch sử, kiểm tra đa vùng, routing cảnh báo đáng tin cậy hoặc khả năng quan sát xuyên team.
Một ma trận quyết định thẳng thắn:
| Yếu tố | Script tự viết | Công cụ chuyên dụng |
|---|---|---|
| Thời gian thiết lập | 1–4 giờ (cơ bản); vài ngày (vững chắc) | 5–30 phút |
| Bảo trì | Bạn phải tự gánh mãi mãi | Nhà cung cấp lo cập nhật |
| Chất lượng cảnh báo | Cơ bản (up/down) | Thông minh hơn (xu hướng latency, bất thường, retry) |
| Chi phí | Miễn phí (tính bằng thời gian của bạn) | 0–500+ USD/tháng |
| Dashboard | Tự xây từ đầu | Có sẵn, tùy biến được |
| Phù hợp nhất khi… | ≤3 endpoint, đội thiên về dev, dự án hobby | 5+ endpoint, team ops/product, doanh thu bị ảnh hưởng |
Điểm mấu chốt từ các forum là: những người tự xây thường hối hận khi họ cần dashboard, dữ liệu lịch sử hoặc khả năng quan sát xuyên team. Và còn một vấn đề meta nữa — “bạn cần giám sát chính công cụ giám sát của mình.” Một monitor tự host, database, backup, đường mạng và nhà cung cấp cảnh báo đều phải đáng tin cậy.
Hãy tự xây nếu bạn có 2 endpoint và thích mày mò. Hãy mua nếu bạn có sản phẩm cần ra mắt.
Logic tương tự cũng áp dụng cho trích xuất dữ liệu web. Bạn có thể tự viết scraper, chạy headless browser, xoay proxy, duy trì selector, làm sạch HTML và xây queue. Nhưng nếu nhiệm vụ là đưa dữ liệu web vào một sản phẩm API, agent AI hoặc workflow nghiên cứu một cách ổn định, dùng Thunderbit Open API thường nhanh hơn nhiều so với tự xây hạ tầng scraping.
Alert fatigue: Vì sao chất lượng cảnh báo quan trọng hơn số lượng cảnh báo
Đây có lẽ là tiêu chí bị đánh giá thấp nhất khi chọn công cụ giám sát API. Alert fatigue xảy ra khi team nhận quá nhiều cảnh báo ồn, trùng lặp hoặc không thể hành động, đến mức họ bắt đầu bỏ qua tất cả — rồi bỏ lỡ sự cố thật.
Các con số khá đáng chú ý. Báo cáo 2025 của BigPanda cho thấy tổ chức trung vị tạo ra 2.350 cảnh báo mỗi ngày và 803.406 cảnh báo mỗi năm. Mức trung vị về khả năng hành động của sự cố chỉ là 18% — tức là chưa đến một trong năm sự cố sinh ra từ cảnh báo thực sự có thể hành động. Khảo sát 2026 của NeuBird cho thấy 77% team on-call nhận ít nhất 10 cảnh báo mỗi ngày và 80% nói rằng một nửa hoặc ít hơn trong số đó là có thể hành động.
Công cụ monitoring tốt nhất là công cụ mà bạn thực sự tin vào cảnh báo của nó. So sánh cách các công cụ xử lý alert intelligence:
| Công cụ | Loại cảnh báo | Cách giảm nhiễu | Kênh cảnh báo |
|---|---|---|---|
| Datadog | Bất thường ML, dự báo, composite | Dải bất thường lịch sử, baseline động, Watchdog AI | Slack, PagerDuty, Opsgenie, Teams, hơn 20 kênh |
| Checkly | Threshold + dựa trên mức suy giảm | Retry trước khi bắn cảnh báo, retry cùng/khác vị trí | Slack, PagerDuty, Opsgenie, Teams, incident.io |
| New Relic | AI grouping sự cố, bất thường, dự báo | Tương quan sự kiện, chặn flapping, ngữ cảnh root cause | Slack, PagerDuty, Teams, webhooks |
| Moesif | Bất thường hành vi | Mô hình động sau vài ngày dữ liệu hành vi | Slack, PagerDuty, email, SMS |
| Better Stack | Uptime/incident/on-call | Chính sách leo thang, routing theo ownership, độ trễ | Slack, Teams, webhooks, Zapier |
| Prometheus + Alertmanager | Rule alert từ PromQL | Grouping, deduplication, silencing, inhibition | Email, PagerDuty, Opsgenie, webhooks |
| Splunk | Sự kiện, episode, sức khỏe dịch vụ | ITSI Event Analytics, nhóm episode, ticketing | Splunk On-Call, ServiceNow, webhooks |
| Thunderbit Open API | Không phải nền tảng cảnh báo | Dùng cùng scheduler, workflow tool hoặc stack monitoring của bạn | Webhook cho batch job; cảnh báo xử lý bên ngoài |
Lời khuyên thực tế: hãy bắt đầu với ít cảnh báo hơn nhưng đáng tin cậy hơn. Dùng retry trước khi bắn cảnh báo, xác nhận đa vùng, cảnh báo theo burn-rate SLO, deduplication và routing theo ownership. Hãy cảnh báo theo tác động tới người dùng và các luồng kinh doanh quan trọng (checkout lỗi, auth lỗi, payment 5xx), chứ không phải mọi triệu chứng nội bộ.
Free tier và giá năm 2026: Bạn thực sự phải trả bao nhiêu
Trang giá thay đổi. Gói free thay đổi. Các chi phí ẩn (host, seat, log, synthetic run, data ingest) có thể khiến bạn bất ngờ. Đây là phần tôi ước gì có trong mọi bài “công cụ tốt nhất”. Bức tranh năm 2026:
| Công cụ | Gói miễn phí | Giá khởi điểm trả phí | Có cần thẻ tín dụng không? | Use case miễn phí tốt nhất |
|---|---|---|---|---|
| Thunderbit Open API | 600 API units dùng một lần | ~16 USD/tháng khi thanh toán theo năm | Không | Trích xuất dữ liệu web cho LLM, RAG, giá và research |
| Uptime Kuma | Không giới hạn (tự host) | — | Không | Giám sát đầy đủ, tự vận hành server |
| UptimeRobot | 50 monitor, interval 5 phút | ~7 USD/tháng | Không | Kiểm tra uptime cơ bản |
| Better Stack | 10 monitor, 1 status page | ~29 USD/tháng | Không | Uptime + status page cho startup |
| Checkly | 10 uptime, 10k API check | ~24 USD/tháng | Có | Synthetic API check |
| Postman | Tài khoản free + hạn mức monitoring | ~14 USD/user/tháng | Không | Tái sử dụng collection sẵn có |
| Prometheus + Grafana | Không giới hạn (tự host) | — | Không | Metric + trực quan hóa |
| Grafana Cloud | 100k lượt chạy API test/tháng | 29 USD/tháng platform + usage | Kiểm tra | Thử nghiệm synthetic được quản lý |
| New Relic | 100 GB/tháng, 1 full user | Theo user + dữ liệu | Một số gói | APM + observability cơ bản |
| Datadog | Trial/khác nhau theo sản phẩm | 15 USD/host/tháng (Infra Pro) | Thường có | Đánh giá full-stack |
| Moesif | Có free/trial | Theo volume | Kiểm tra | Đánh giá API analytics |
| Splunk | Có trial | Báo giá tùy chỉnh | Qua sales | Proof of concept cho enterprise |
| Gatus | Không giới hạn (tự host) | — | Không | Status dashboard theo YAML |
| Apitally | Có free/trial | Kiểm tra | Kiểm tra | API analytics nhẹ |
| Sematext | Trial/free thay đổi | ~2 USD/HTTP monitor | Kiểm tra | Synthetics/log chi phí thấp hơn |
| Uptrace | Free self-hosted | Gói cloud thay đổi | Kiểm tra | Đánh giá OTel APM |
Lưu ý chi phí ẩn: các công cụ tự host (Uptime Kuma, Prometheus, Gatus) “miễn phí” về giấy phép, nhưng một VM nhỏ, backup, thời gian bảo trì và failover bên ngoài có thể nhanh chóng biến thành chi phí thật. Với web data API, chi phí ẩn thường khác: duy trì headless browser, selector hỏng, pool proxy, biện pháp lách anti-bot và làm sạch HTML.
Ước tính cho team nhỏ: với 10 endpoint API và 3 thành viên team, con đường SaaS rẻ nhất thường là UptimeRobot free hoặc gói thấp, Better Stack free/Team, hoặc Checkly nếu khối lượng chạy phù hợp. Datadog và New Relic có thể rẻ lúc đánh giá ban đầu, nhưng hóa đơn thật phụ thuộc vào host, user, log, trace và số lượng synthetic run. Nếu dự án của bạn cần dữ liệu website dưới dạng API, các API unit miễn phí của Thunderbit đã đủ để test workflow trước khi cam kết gói trả phí.
Bảng điểm độ phức tạp triển khai: Bạn mất bao lâu để có cảnh báo đầu tiên
Tôi chưa thấy bài so sánh đối thủ nào đánh giá time-to-value — tức là từ lúc đăng ký đến lúc nhận được cảnh báo thực sự có ý nghĩa là bao lâu. Với đội nhỏ, điều này quan trọng hơn độ sâu tính năng.
| Công cụ | Thời gian đến cảnh báo đầu tiên | Kỹ năng kỹ thuật cần có | Cách cấu hình |
|---|---|---|---|
| Thunderbit Open API | ~5–15 phút | Thấp–Trung bình | API key, cURL/SDK/CLI |
| UptimeRobot | ~2–5 phút | Thấp | GUI, click là thêm |
| Better Stack | ~5–10 phút | Thấp | GUI wizard |
| Checkly | ~10–20 phút | Thấp–Trung bình | Code hoặc GUI |
| Postman | ~10 phút (nếu đã có collection) | Thấp–Trung bình | Collection scheduler |
| Uptime Kuma | ~5–30 phút | Trung bình | Docker + GUI |
| Gatus | ~15–45 phút | Trung bình | YAML + Docker |
| Datadog | ~15–30 phút | Trung bình | Cài agent + GUI |
| New Relic | ~15–30 phút | Trung bình | Agent + setup có hướng dẫn |
| Moesif | ~20–45 phút | Trung bình | Tích hợp SDK/proxy |
| Grafana Cloud Synthetics | ~15–45 phút | Trung bình | GUI, có thể dùng Terraform |
| Prometheus + Grafana | 1–4 giờ | Trung bình–Cao | YAML, PromQL |
| Uptrace | 30–90 phút | Trung bình–Cao | Tích hợp OTel SDK |
| Splunk | Vài giờ đến vài tuần | Cao | Onboarding doanh nghiệp |
Nếu monitoring cần chạy trong ngày hôm nay, hãy bắt đầu ở nửa trên của bảng đó. Nếu mục tiêu là observability bền vững cho nền tảng, hãy chuẩn bị một dự án riêng cho nửa dưới. Và nếu cột mốc đầu tiên của bạn là “đưa dữ liệu sạch từ 100 trang web này vào một app”, hãy bắt đầu với Thunderbit trước khi tự xây hạ tầng scraping.
So sánh các công cụ giám sát API tốt nhất: bảng side-by-side đầy đủ
Một bảng để quét nhanh trước khi quyết định:
| Công cụ | Use case tốt nhất | Gói miễn phí | Trí thông minh cảnh báo | Thời gian thiết lập | Triển khai | Điểm nổi bật |
|---|---|---|---|---|---|---|
| Thunderbit Open API | Trích xuất dữ liệu web / pipeline dữ liệu API | 600 API units | Không phải công cụ cảnh báo | 5–15 phút | Cloud | Rút gọn trang thành Markdown hoặc JSON theo schema |
| Datadog | Enterprise/SaaS full-stack | Trial/thay đổi | Anomaly, forecast, AI | 15–30 phút | Cloud | Ghép synthetic với log/trace/hạ tầng |
| Checkly | Synthetic thân thiện với dev | Hào phóng theo số lượng check | Retry, degradation | 10–20 phút | Cloud | Monitoring as code + Playwright |
| UptimeRobot | Uptime đơn giản | 50 monitor | Threshold cơ bản | 2–5 phút | Cloud | Monitor cơ bản giá rẻ, nhanh nhất |
| Uptime Kuma | Tự host miễn phí | Không giới hạn | Status/threshold cơ bản | 5–30 phút | Self-hosted | UI gọn, không tốn phí SaaS |
| Better Stack | Incident response/status page | 10 monitor | Escalation, routing | 5–10 phút | Cloud | Monitoring + on-call + status page |
| Prometheus + Grafana | Stack metric open-source | Không giới hạn (tự host) | Grouping của Alertmanager | 1–4 giờ | Self-hosted/cloud | Độ sâu hệ sinh thái PromQL |
| New Relic | SaaS APM + API check | 100 GB/tháng, 1 user | AI grouping, chặn flapping | 15–30 phút | Cloud | APM mạnh kết hợp synthetics |
| Moesif | API analytics / business metrics | Free/trial | Bất thường hành vi | 20–45 phút | Cloud | Phân tích hành vi API theo từng khách hàng |
| Splunk | Enterprise log / compliance | Trial | Episode ITSI, AIOps | Vài ngày+ | Cloud/self-managed | Tìm kiếm log và governance cấp enterprise |
| Postman | Team đã test API sẵn | Tài khoản free | Cảnh báo monitor cơ bản | 10 phút | Cloud | Tái sử dụng collection kiểm thử API |
Thunderbit có thể giúp tăng tốc việc đánh giá công cụ API của bạn như thế nào
Nói rõ trước: Thunderbit không phải công cụ giám sát API — mà là một agentic web scraper và Open API để biến trang web thành Markdown sạch hoặc JSON có cấu trúc. Điều đó làm cho nó hữu ích ở một phần khác của quá trình ra quyết định về công cụ giám sát: thu thập giá của nhà cung cấp, giới hạn gói, claim tính năng, chi tiết tài liệu và danh sách tích hợp trước khi bạn chọn nền tảng.
Thay vì mở thủ công hơn 10 trang giá của vendor, sao chép tên plan, giới hạn monitor, interval kiểm tra, tích hợp và yêu cầu thẻ tín dụng vào spreadsheet, chúng tôi đã dùng Thunderbit Chrome Extension để trích xuất dữ liệu có cấu trúc từ các trang giá và tính năng của từng công cụ. AI của Thunderbit đọc từng trang và gợi ý các trường — tên plan, chi tiết gói free, giá trả phí, các tích hợp được hỗ trợ — rồi cấu trúc đầu ra thành một bảng có thể xuất ra.
Với workflow dành cho dev, Thunderbit Open API cho bạn cùng một ý tưởng đó theo cách lập trình. Dùng Distill khi bạn muốn Markdown sạch cho LLM hoặc RAG. Dùng Extract khi bạn cần các trường cụ thể trả về dưới dạng JSON. Dùng Batch khi bạn cần xử lý danh sách lớn các trang giá, URL tài liệu, trang sản phẩm hoặc trang đối thủ và nhận kết quả bất đồng bộ.
Workflow như sau:
- Mở trang giá của một vendor (Datadog, Checkly, UptimeRobot, v.v.)
- Nhấp “One Click Extract” — AI của Thunderbit đọc trang, hiểu cấu trúc và điền bảng chỉ trong một lần
- Dùng subpage scraping để đi qua các trang giá, tính năng và tài liệu của từng vendor
- Xuất sang Google Sheets, Excel, Airtable, Notion hoặc CSV
Với team ưu tiên API, workflow qua API cũng trực tiếp không kém:
- Lấy API key miễn phí từ Thunderbit
- Gọi endpoint Distill để lấy Markdown sạch từ bất kỳ trang công khai nào
- Gọi endpoint Extract với mô tả schema để nhận JSON có cấu trúc
- Dùng endpoint Batch và webhook cho danh sách URL lớn hơn
- Đưa kết quả vào app, spreadsheet, warehouse, vector database hoặc workflow monitoring của bạn
Đối với việc so sánh hơn 10 vendor, thao tác copy-paste thủ công có thể dễ dàng mất 2–3 giờ nếu tính cả các trang phụ về giá, tài liệu và tích hợp. Thunderbit rút giai đoạn trích xuất vòng đầu của chúng tôi xuống còn khoảng 15–30 phút, phần thời gian còn lại dành cho kiểm tra và ra quyết định. Nếu team ops, procurement, research hoặc team sản phẩm AI của bạn đang phải đánh giá công cụ dưới áp lực thời gian, đây là một đường tắt thực dụng. Bạn có thể xem thêm về kiểu workflow này trong hướng dẫn web scraping không cần code, tìm hiểu giá Thunderbit API, hoặc xem kênh YouTube của chúng tôi để theo dõi hướng dẫn.
Cách chọn công cụ giám sát API tốt nhất cho đội của bạn
Công cụ giám sát API “tốt nhất” phụ thuộc vào quy mô team, độ sâu kỹ thuật, ngân sách và điều gì đồng nghĩa với thất bại cho sản phẩm của bạn.
Một dev solo không cần Splunk. Một doanh nghiệp bị quản lý chặt không nên dựa vào một cron job. Team sản phẩm API có thể cần analytics theo khách hàng kiểu Moesif hơn là những ping uptime. Team e-commerce nên ưu tiên check cho các luồng quan trọng như đăng nhập, tìm kiếm, thêm vào giỏ, thanh toán và xác thực payment. Team sản phẩm AI hoặc dữ liệu có thể cần trích xuất dữ liệu web kiểu Thunderbit trước khi cần observability đầy đủ.
Ba nguyên tắc vẫn đúng xuyên suốt quá trình nghiên cứu của tôi:
- Chọn công cụ khớp use case. Bảng chọn nhanh tồn tại là có lý do — hãy bắt đầu từ đó.
- Ưu tiên chất lượng cảnh báo hơn số lượng cảnh báo. Nếu team bỏ qua cảnh báo, bạn không có monitoring. Bạn chỉ có tiếng ồn.
- Đừng đánh giá thấp tốc độ triển khai. Một monitor chạy được ngay hôm nay và gửi cảnh báo đáng tin cậy tốt hơn một kế hoạch nền tảng hoàn hảo nhưng để checkout không được giám sát thêm một tháng nữa.
Nếu bạn đang so sánh nhiều công cụ cùng lúc và muốn tăng tốc nghiên cứu, hãy thử Thunderbit để trích xuất hàng loạt dữ liệu vendor vào một spreadsheet duy nhất. Nếu bạn đang xây sản phẩm API, pipeline RAG, AI agent hoặc workflow phân tích thị trường cần dữ liệu web sạch, hãy bắt đầu với Thunderbit Open API. Nó không chọn hộ bạn công cụ monitoring — nhưng sẽ đưa bạn đến quyết định nhanh hơn, và có thể cung cấp cho chính sản phẩm của bạn một lớp dữ liệu web đáng tin cậy.
Câu hỏi thường gặp về các công cụ giám sát API tốt nhất
Công cụ giám sát API miễn phí tốt nhất năm 2026 là gì?
Về sự đơn giản kiểu SaaS, UptimeRobot cung cấp 50 monitor miễn phí với interval 5 phút và không cần thẻ tín dụng. Về kiểm soát tự host, Uptime Kuma là open-source, không giới hạn và có UI gọn với hơn 90 dịch vụ thông báo. Với team muốn độ sâu metric và đã có năng lực kỹ thuật, Prometheus + Grafana + Alertmanager là stack open-source tốt nhất — dù thiết lập mất hàng giờ chứ không phải vài phút.
Nếu mục tiêu của bạn không phải giám sát uptime mà là trích xuất dữ liệu web qua API, Thunderbit Open API có gói miễn phí với 600 API units dùng một lần, đủ để thử rút gọn trang thành Markdown hoặc trích xuất JSON theo schema trước khi mở rộng.
Sự khác nhau giữa giám sát API và APM là gì?
Giám sát API kiểm tra khả dụng endpoint, thời gian phản hồi, lỗi và độ chính xác từ bên ngoài — mô phỏng trải nghiệm của người dùng hoặc hệ thống tích hợp. APM (Application Performance Monitoring) đi sâu vào bên trong ứng dụng: trace cấp mã, truy vấn cơ sở dữ liệu, lỗi runtime, độ trễ queue và phụ thuộc dịch vụ. Các công cụ như Datadog và New Relic cung cấp cả hai; UptimeRobot và Uptime Kuma tập trung vào kiểm tra uptime từ bên ngoài.
Thunderbit Open API khác cả hai: đó là API trích xuất dữ liệu web. Nó giúp bạn biến website bên ngoài thành Markdown hoặc JSON có cấu trúc, hữu ích cho ứng dụng LLM, workflow nghiên cứu, phân tích giá và pipeline dữ liệu.
Tôi nên giám sát API bao lâu một lần?
Các API production quan trọng trực tiếp đến doanh thu (checkout, auth, payments) thường nên được kiểm tra mỗi 1 phút. Các API nội bộ hoặc ít lưu lượng có thể kiểm tra mỗi 5 phút. Nhưng tần suất không phải là toàn bộ câu chuyện — hãy dùng retry, nhiều vùng và các assertion có ý nghĩa để mỗi lần kiểm tra vừa nhanh vừa đáng tin. Một check 1 phút nhưng bắn cảnh báo giả thì tệ hơn một check 5 phút mà bạn có thể tin.
Với workflow trích xuất dữ liệu web, tần suất phụ thuộc vào tốc độ thay đổi của nguồn. Trang giá có thể chỉ cần trích xuất hàng ngày hoặc hàng tuần. Dữ liệu tồn kho, du lịch hoặc marketplace thay đổi nhanh có thể cần làm mới theo giờ hoặc thường xuyên hơn. Batch API và webhook của Thunderbit rất hữu ích khi bạn cần xử lý nhiều URL theo lịch.
Tôi có thể giám sát API mà không cần viết code không?
Có. UptimeRobot, Better Stack và Uptime Kuma có thể dùng hoàn toàn qua GUI. Checkly hỗ trợ cả GUI lẫn cấu hình bằng code. Postman dùng giao diện dựa trên collection. Prometheus/Grafana thường cần YAML và PromQL. Datadog và New Relic có thể bắt đầu bằng setup có hướng dẫn nhưng mạnh hơn nhiều khi được instrument sâu hơn.
Nếu bạn muốn trích xuất dữ liệu website mà không cần code, Chrome Extension của Thunderbit là con đường no-code. Nếu bạn muốn tự động hóa workflow đó từ ứng dụng, Thunderbit Open API cung cấp cho dev các endpoint Distill, Extract và Batch.
Làm sao để giảm alert fatigue từ giám sát API?
Hãy chọn công cụ có cảnh báo thông minh: phát hiện bất thường (Datadog, New Relic), retry trước khi bắn cảnh báo (Checkly), bất thường hành vi (Moesif), hoặc grouping/silencing (Prometheus Alertmanager). Bắt đầu với ít cảnh báo hơn nhưng có độ tin cậy cao, tập trung vào tác động đến người dùng. Dùng cảnh báo burn-rate SLO thay vì ngưỡng tĩnh, deduplicate giữa các service, route theo ownership, và đo khả năng hành động — nếu dưới 20% cảnh báo dẫn đến hành động thực sự, hãy giảm nhiễu trước.
Thử Thunderbit Open API để trích xuất dữ liệu web Get Started Free
Tìm hiểu thêm



