
Eğer daha önce bir web scraping aracı arayıp hem Thunderbit hem de Bright Data ile karşılaştıysanız, bu iki ürünün aslında aynı kategoriye ait olmadığını çoktan fark etmiş olabilirsiniz. Çünkü gerçekten de değiller.
Biri, birkaç dakika içinde bir web sayfasından yapılandırılmış veri çekmek isteyen iş kullanıcıları için tasarlanmış, yapay zekâ destekli bir tarayıcı eklentisidir. Diğeri ise 195’ten fazla ülkeyi kapsayan proxy ağları, birden fazla scraper API’si, yönetilen tarayıcılar ve kurumsal uyumluluk sertifikaları sunan modüler bir Web data infrastructure platformudur. Arama sonuçlarında yan yana görünürler, ama özünde çok farklı insanların, çok farklı dertlerine çözüm üretirler. Ben ikisini de epey kurcaladım — nasıl çalıştıklarını, fiyatlarını, nerede parladıklarını ve nerede tökezlediklerini — ve amacım size hangisinin gerçekten ihtiyacınıza uyduğunu göstermek. İstek listenize göre değil. Gerçek iş akışınıza göre.
Thunderbit ve Bright Data’ya Hızlı Bakış
Detaya girmeden önce, önce kısa bir özetle başlayalım.
| Boyut | Thunderbit | Bright Data |
|---|---|---|
| Ürün tipi | AI web scraper eklentisi + web uygulaması + API | Web data infrastructure platformu (proxy’ler, API’ler, scraper’lar, veri setleri) |
| Birincil kullanıcı | İş kullanıcıları, satış operasyonları, pazarlamacılar, serbest çalışanlar | Geliştiriciler, veri mühendisleri, kurumsal veri ekipleri |
| Kurulum modeli | Eklentiyi kur, sayfayı aç, veriyi çek | Ürün seç, kimlik bilgilerini/scraper’ı yapılandır, çalıştır |
| Kod gerektirmeme kolaylığı | Temel iş akışı tamamen kodsuz | Kodsuz kullanım yolları var (Scraper Studio AI Agent, hazır kolektörler, veri setleri), ancak daha derin özellikler teknik kurulum ister |
| Fiyatlandırma modeli | Eklenti için krediler (satır), API için API birimleri | Ürüne göre istek başına, kayıt başına, GB başına veya IP başına |
| Ölçekleme yaklaşımı | Sayfa sayfa ya da zamanlanmış; büyük işler için API | Yüksek eşzamanlı API, yönetilen tarayıcılar, proxy ağları |
| Dışa aktarma/teslim | Google Sheets, Excel, Airtable, Notion, CSV, JSON | JSON, NDJSON, CSV, XLSX, Parquet, HTML, Markdown + API, webhook, bulut depolama, SFTP, e-posta, veri ambarları |
| En uygun kullanım | Tek seferlik veri çekme, lead listeleri, hızlı araştırma, orta hacimli izleme | Büyük ölçekli pipeline’lar, anti-bot koruması güçlü hedefler, kurumsal uyumluluk, sürekli veri akışları |
Aşağıda özellikler, fiyatlandırma, gerçek kullanım senaryoları ve sonunda bir karar matrisiyle tam değerlendirmeyi bulacaksınız.
Thunderbit Nedir?

Thunderbit iş kullanıcıları için geliştirilmiş, ajan tabanlı bir web scraper ve otomasyon platformudur. Ana kullanım alanı bir Chrome/Edge tarayıcı eklentisi, buna ek olarak bir web uygulaması, Open API, AI agent iş akışları için bir MCP Server ve bir CLI sunar.
Thunderbit bir ajan tabanlı web scraper’dır: uyumlu ve yetkilendirilmiş bir sayfada One Click Extract’e tıkladığınızda, ajan sayfayı algılar, okur ve analiz eder; hangi verilerin çekileceğine karar verir. Run Now hemen başlatır, ama hiçbir şey yapmazsanız görev otomatik olarak başlar — yani varsayılan deneyimde kod, selector ya da şema kurulumuna gerek yoktur; tek bir bilinçli tıklama yeterlidir.
Temel iş akışı gerçekten çok basittir: tarayıcınızda bir sayfa açın ve One Click Extract’e tıklayın. Ajan sayfayı algılar, okur ve analiz eder; Run Now ile anında başlayabilirsiniz, aksi halde dışa aktarmadan önce işlem otomatik olarak başlar ve veriyi Google Sheets, Excel, Airtable veya Notion’a gönderebilirsiniz. Ayrıca herkese açık sayfalar için Cloud Mode kullanabilir, düzenli aralıklarla çalışan zamanlamalar kurabilir ve popüler siteler için hazır şablonlardan yararlanabilirsiniz. AI yalnızca alan önermekle kalmaz — Field AI Prompts ile çıkarım sırasında veriyi dönüştürebilir, çevirebilir, kategorize edebilir, özetleyebilir veya biçimlendirebilir.
Thunderbit ayrıca Distill (ham sayfa içeriği), yapılandırılmış Extract, async batch’ler, render kontrolleri, ülke hedefleme ve webhook’ları destekleyen bir Open API’ye de sahiptir. Ancak çoğu kullanıcının asıl deneyimi, kodsuz ve tarayıcı içinde çalışan bu iş akışıdır.
Bright Data Nedir?
Bright Data, genel web verisi altyapısı ve teslimatı için kapsamlı bir platformdur. Tek bir araç değildir; veri toplama ihtiyacınıza göre ürün(ler) seçtiğiniz modüler bir sistemdir.
Ürün aileleri şunları içerir:
- Unlocker API — korumalı sayfalarda HTML/JSON erişimi
- SERP API — yapılandırılmış arama motoru sonuçları
- Browser API / Agent Browser — Puppeteer, Playwright veya Selenium üzerinden yönetilen Chromium
- Crawl API — bulut tabanlı tarama, ayrıştırma ve teslim
- Scraper API’leri — popüler alan adları için hazır yapılandırılmış kolektörler
- Scraper Studio — özel scraper’lar için AI Agent (kodsuz) veya JavaScript IDE
- Datasets ve Data Firehose — hazır veya sürekli veri akışları
- Proxy ağları — residential (Bright Data’nın iddiasına göre 195+ ülkede 400M+ aylık residential IP), datacenter, ISP ve mobile
- MCP Server — ajan odaklı iş akışları için
Bright Data’nın müşteri kitlesi ağırlıklı olarak kurumsal ve geliştirici ekiplerdir. ISO 27001/27017/27018, SOC 2 Type II (NDA altında), herkese açık SOC 3, CSA STAR ve KYC/kullanım senaryosu inceleme süreçlerini belgelerler. Platform; ölçekli proxy, tarayıcı, coğrafi konum, oturum ve uyumluluk kontrollerine ihtiyaç duyan ekipler için tasarlanmıştır.
Tarayıcı Eklentisi vs. Proxy Altyapısı: Web Scraping’e İki Farklı Yaklaşım
Karşılaştırma yazılarının çoğu mimari farkı tamamen atlar — oysa hangi aracı seçmeniz gerektiğini aslında bu fark belirler.
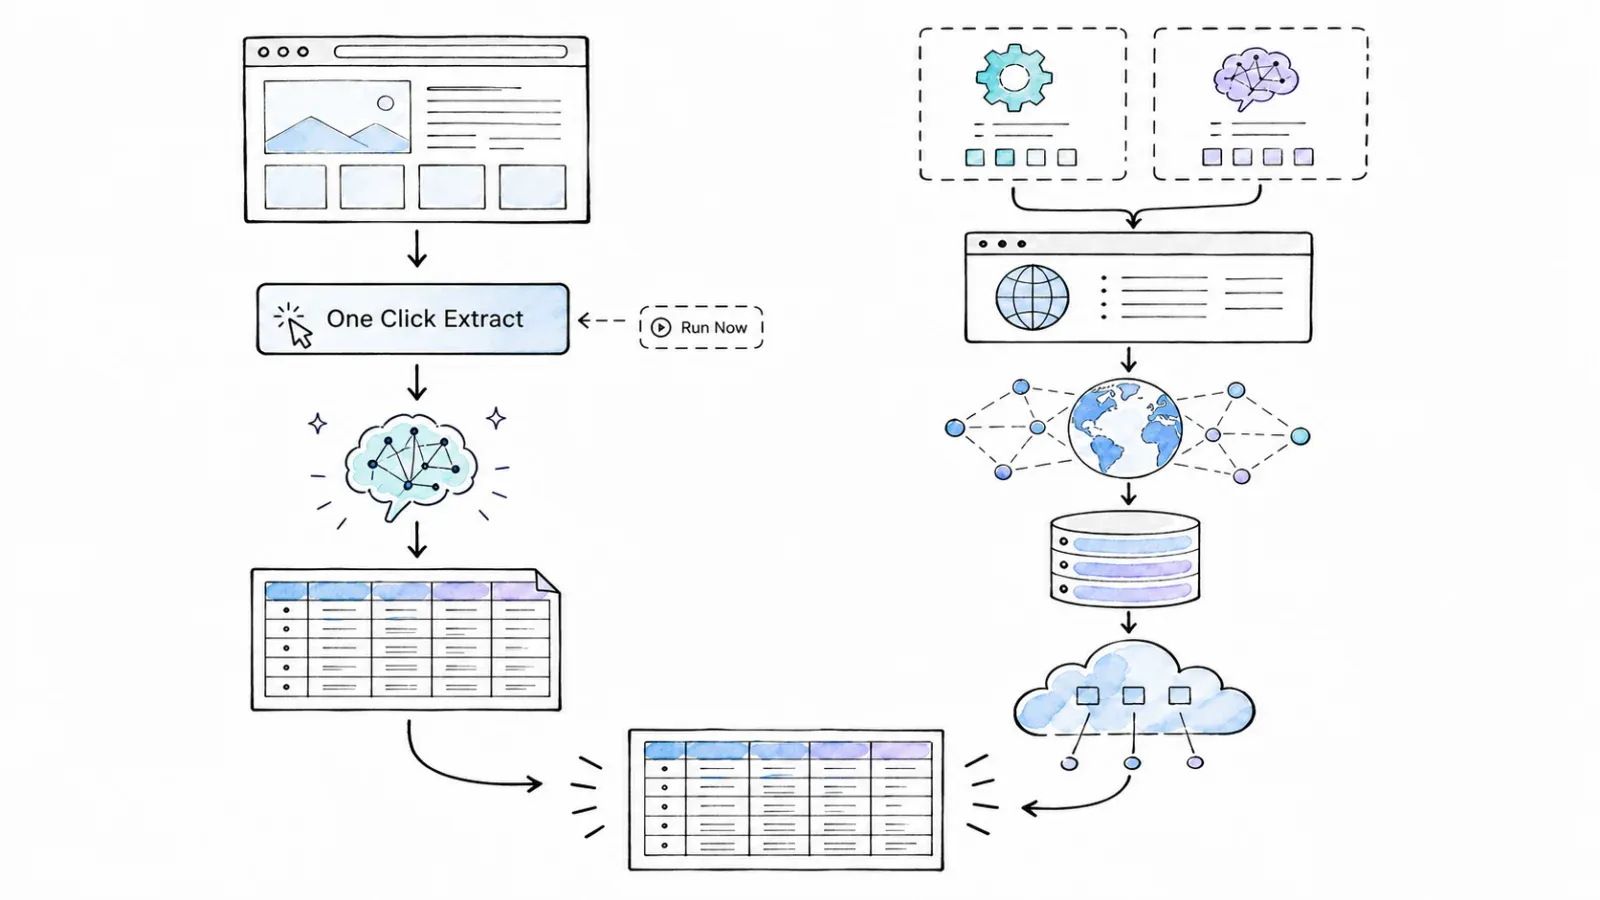
Thunderbit modeli: Bir tarayıcı eklentisi kurarsınız, veri almak istediğiniz sayfaya gidersiniz ve gördüğünüz içerikten yapılandırılmış veri çekersiniz. AI sütunları önerir. Geçerli sayfadan scrape edersiniz (Browser Mode, uyumlu sayfalarda mevcut tarayıcı oturumunuzu kullanabilir) ya da herkese açık sayfalar için Cloud Mode kullanırsınız. Bunu tarayıcınızın üstüne oturan akıllı bir kopyala-yapıştır katmanı gibi düşünün — tabloları, listeleri ve sayfa yapısını anlayan bir katman.
Bright Data modeli: Modüler bir platformdan bir ürün seçersiniz, kimlik bilgilerini ve scraper mantığını yapılandırırsınız (veya bunu bir AI Agent ile oluşturursunuz), ardından çıkarımı Bright Data’nın bulut altyapısı üzerinden çalıştırırsınız. İstekler milyonlarca IP üzerinden yönlendirilebilir, yönetilen tarayıcılar render ve anti-bot zorluklarını üstlenir, veriler ise API, webhook, bulut depolama veya başka hedeflere teslim edilir. Bunu ölçekli veri toplama için bir altyapı sistemi gibi düşünün — boruyu, basıncı ve hedefi siz seçersiniz.
Mimari farklar şöyle görünür:
| Boyut | Thunderbit | Bright Data |
|---|---|---|
| Çalışma ortamı | Kullanıcının tarayıcısı (Browser Mode) veya bulut (Cloud Mode) | Bright Data bulut altyapısı |
| Başlangıç önkoşulu | Eklentiyi kur, sayfayı aç | Ürün seç, hesap oluştur, kimlik bilgilerini/scraper’ı yapılandır |
| Anti-bot yaklaşımı | Desteklenen sayfalarda yönetilen render | Proxy rotasyonu, Unlocker, Browser API, CAPTCHA çözümü, fingerprint yönetimi |
| Birincil etkileşim | Görsel, tarayıcı içinde, AI destekli | Programatik (API/SDK) veya Scraper Studio (AI Agent/IDE); ayrıca bazı ürünlerde dashboard |
| Ölçekleme modeli | Sayfa sayfa, zamanlanmış çalıştırmalar veya API batch’leri | Yüksek eşzamanlı API istekleri, yönetilen tarayıcılar, proxy ağları |
Bu yaklaşımlardan biri evrensel olarak daha iyi değildir. Farklı insanlar için farklı sorunları çözerler. Zaten baktığınız sayfadan bir tablo almak istiyorsanız, Thunderbit sizi daha hızlı sonuca götürür. 50.000 isteği dönen residential IP’ler ve yönetilen tarayıcı render’ı üzerinden geçirmek istiyorsanız, Bright Data tam bu iş için tasarlanmıştır.
Kodsuz Deneyim: İş Kullanıcıları İçin Her Araç Nasıl Görünüyor?
API’ye hiç dokunmamış biri için gerçek deneyim nasıl? Çünkü bu araçları değerlendiren insanların çoğu geliştirici değil — pazarlamacılar, satış operasyonu yöneticileri, serbest veri toplayıcılar veya küçük işletme sahipleri.
Thunderbit: Tarayıcı İçin Tasarlanmış
Teknik olmayan bir kullanıcı için Thunderbit iş akışı şu şekildedir:
- Chrome Web Store üzerinden eklentiyi kurun.
- Veri almak istediğiniz sayfaya gidin (dizin, ürün listesi, arama sonuçları vb.).
- Eklentiyi açın ve One Click Extract çalıştırın. AI sayfayı okur ve sütun önerir (ör. “Company Name”, “Price”, “Rating”).
- Sütunları gözden geçirin, yeniden adlandırın, ekleyin veya kaldırın. Çıkarma sırasında veriyi dönüştürmek için Field AI Prompts da ekleyebilirsiniz — başka bir dile çevirme, kategorize etme, özetleme, telefon numaralarını biçimlendirme gibi.
- Birden fazla sayfadan veya detay sayfasından veri gerekiyorsa sayfalama veya alt sayfa zenginleştirmeyi yapılandırın.
- Run Now isteğe bağlıdır. Hemen başlatmak için tıklayın; aksi halde çıkarım otomatik olarak başlar. Browser Mode’u (mevcut oturumunuzu kullanır) veya public sayfalar için Cloud Mode’u seçin.
- Sonucu doğrudan Google Sheets, Excel, Airtable, Notion, CSV veya JSON’a aktarın.
Her şey tarayıcınızın içinde gerçekleşir. API anahtarı yok, proxy yapılandırması yok, kod yok. Sayfayı görürsünüz, veriyi görürsünüz, dışa aktarırsınız. Sadece bir lead listesi veya rakip fiyat tablosuna ihtiyacı olan biri için bu, mümkün olan en düşük sürtünme seviyelerinden biridir.
Hâlâ biraz düşünme gerektiren kısım ise şunlardır: karmaşık biçimlendirme için Field AI Prompts özelleştirmek, sıra dışı yapıya sahip sayfaları yönetmek ve Cloud Mode’un ne zaman kullanılabilir, ne zaman Browser Mode’un gerekli olduğunu anlamak.
Bright Data: Kodsuz Giriş Noktaları Olan Altyapı
Bright Data yalnızca geliştiricilere yönelik değildir — bu yaygın bir yanılgıdır. Gerçekten kodsuz yolları da vardır:
- Scraper Studio AI Agent: Hedef URL’yi verirsiniz ve ne istediğinizi doğal dille anlatırsınız. AI netleştirici sorular sorar, bir şema önerir, scraper oluşturur ve bunu test etmenize, yayınlamanıza ve zamanlamanıza izin verir — hepsi dashboard üzerinden. Bright Data’nın kendi dokümantasyonu, scraper oluşturmanın yaklaşık 10–15 dakika sürdüğünü belirtir.
- Hazır Scraper API’leri: Desteklenen popüler bir alan adı için mevcut kolektörü seçersiniz, girdilerinizi verirsiniz ve kontrol panelinden veya API üzerinden çalıştırırsınız. Hiç özel geliştirme yapmadan yapılandırılmış kayıtlar elde edersiniz.
- Datasets: Mevcut bir veri setini seçer, örnek/teslimat/yeni güncelleme ihtiyaçlarınızı belirlersiniz ve hiç scraper kurmadan veri alırsınız.
- Crawl API kontrol paneli: Alan adlarını veya URL’leri girer, çıktıyı yapılandırır, taramayı başlatır ve sonuçları indirme, webhook veya storage üzerinden alırsınız.
Ancak dürüst kısmı da söyleyelim: Bright Data’nın gelişmiş özelliklerinin çoğu — Unlocker, Browser API, ham proxy zone’ları, SERP API, özel IDE scraper’ları — ürün seçimi, kimlik bilgisi yönetimi ve en azından bir miktar teknik kurulum gerektirir. Kodsuz yüzü gerçektir, ama mühendisler için tasarlanmış bir platformun üstünde yer alır.
| Boyut | Thunderbit | Bright Data |
|---|---|---|
| İlk çıkarıma kadar adım sayısı | Eklentiyi kur → sayfayı aç → AI Suggest → Scrape → dışa aktar | Hesap oluştur → ürün seç → yapılandır veya AI Agent kullan → çalıştır → veriyi al |
| Gerekli teknik bilgi | Temel çıkarım için yok; gelişmiş prompt’lar için biraz | AI Agent/veri setleri için yok; API’ler, proxy’ler, IDE için orta-yüksek |
| İlk sonuca ulaşma süresi | Dakikalar (satıcı tarafından belgelenen iş akışı) | Ürüne göre değişir; AI Agent için satıcı 10–15 dk tahmin ediyor; API/proxy yolları daha uzun |
İlk Scrape’e Kadar Geçen Süre: Veriyi Ne Kadar Hızlı Alabilirsiniz?
“Bright Data kurulumu daha karmaşıktır” — bunu her rakip karşılaştırma yazısında okursunuz, ama çoğu bunu sayısallaştırmaz. Kontrollü, aynı hedef üzerinde bir test yapmadım; bu yüzden sayı uydurmayacağım. Yapabileceğim şey, halka açık bir e-ticaret sayfasından ürün listelemeyi çekmek gibi yaygın bir iş için belgelenmiş iş akışlarını karşılaştırmak.
Thunderbit: Belgelenmiş İş Akışı
| Adım | Ne olur |
|---|---|
| 1. Eklentiyi kur | Tek seferlik, yaklaşık 1 dakika |
| 2. Sayfaya git | Hedef URL’yi tarayıcıda açın |
| 3. One Click Extract | Bir kez tıklayın; ajan sayfayı algılar, okur ve analiz eder |
| 4. Alanları gözden geçir/düzenle | Yeniden adlandır, ekle, kaldır veya prompt ekle |
| 5. Sayfalama ayarla | Gerekirse aç/kapat |
| 6. Otomatik başlangıç | Run Now anında başlatır; aksi halde görev otomatik başlar |
| 7. Dışa aktar | Sheets, Excel, Airtable, Notion, CSV veya JSON’a tek tık |
Ön koşullar: Chrome veya Edge tarayıcısı, Thunderbit eklentisinin kurulu olması, bir Thunderbit hesabı (ücretsiz plan mevcut).
Bright Data: Belgelenmiş İş Akışları (İki Yol)
Scraper Studio AI Agent (kodsuz):
| Adım | Ne olur |
|---|---|
| 1. Hesap oluştur | Kaydolun, kimlik doğrulaması yapın |
| 2. Scraper Studio’yu aç | Studio dashboard’una gidin |
| 3. URL + açıklama ver | AI’ye doğal dille ne istediğinizi söyleyin |
| 4. Otomatik hazırlık | Ajan çıkarım planını belirler; isteğe bağlı kontroller özel çıktıyı iyileştirebilir |
| 5. Scraper’ı test et | Test çalıştırın; çıktıyı inceleyin |
| 6. Yayınla + çalıştır | Zamanlayın veya manuel tetikleyin |
| 7. Veriyi al | Dashboard, API, webhook veya storage’dan indirin |
Scraper API (hazır kolektör):
| Adım | Ne olur |
|---|---|
| 1. Hesap oluştur | Kaydolun, kimlik doğrulaması yapın |
| 2. Kolektör seç | Katalogdan desteklenen bir alan adı seçin |
| 3. Girdi ver | URL’ler, arama terimleri veya parametreler |
| 4. Çalıştır | Dashboard’dan veya API ile |
| 5. Veriyi al | Dashboard, API veya teslim hedefi üzerinden yapılandırılmış kayıtlar |
Ön koşullar: Bright Data hesabı (bazı ürünlerde ücretsiz katman mevcut), ürün seçimi ve — API/proxy yolları için — API anahtarı oluşturma ile yapılandırma.
Çıkarım: Thunderbit, özellikle anlık ve tek seferlik işlerde hız için tasarlanmıştır — zaten açık olan sayfadan minimum karar yüküyle veri çekersiniz. Bright Data’nın AI Agent yolu da gerçek bir seçenek, ancak platform hâlâ sizden ürün seçmenizi, faturalama birimini anlamanızı ve daha geniş bir dashboard içinde gezinmenizi ister. Tek seferlik iş mi? Thunderbit daha kısa yolu sunar. Veri ambarına teslim edilen, kalıcı ve zamanlanmış bir scraper mı kuruyorsunuz? Bright Data’nın Studio yolu, yatırım olarak daha anlamlıdır.
Thunderbit ve Bright Data: Özellik Özellik Karşılaştırma
| Özellik | Thunderbit | Bright Data |
|---|---|---|
| Ajan tabanlı sayfa analizi | One Click Extract + isteğe bağlı Field AI Prompts | Scraper Studio AI Agent (doğal dil → şema → scraper) |
| Alt sayfa zenginleştirme | Desteklenir (detay sayfası verileri ana tabloya birleştirilir) | Özel Studio/Browser/Crawl iş akışları ve bazı hazır kolektörler üzerinden desteklenir |
| Sayfalama yönetimi | Sayfalama ve infinite scroll desteklenir | Studio, Crawl API ve hazır kolektörlerde desteklenir |
| Zamanlanmış çıkarım | Tekrarlayan zamanlamalar (Starter: en fazla 5; Pro: en fazla 25, minimum 5 dk sıklık) | Studio’da saatlik/günlük/haftalık/özel zamanlamalar; operasyonel izleme/uyarılar |
| Dışa aktarma hedefleri | Google Sheets, Airtable, Notion, Excel, CSV, JSON | JSON, NDJSON, CSV, XLSX, Parquet, HTML, Markdown + API, webhook, bulut depolama, SFTP, e-posta, veri ambarları |
| Tarayıcı vs. bulut yürütme | Browser Mode (mevcut oturum) ve Cloud Mode (herkese açık sayfalar, satıcı beyanına göre tek seferde 50’ye kadar) | Yalnızca bulut; yönetilen tarayıcılar, proxy ile yönlendirilen istekler |
| Proxy/IP altyapısı | Desteklenen yüzeylerde yönetilir; API’de render/ülke/başlık/çerez kontrolleri vardır | Residential (satıcı iddiasına göre aylık 400M+ IP), datacenter, ISP, mobile; coğrafi konum/oturum/ASN/operatör kontrolleri |
| Anti-bot yönetimi | Desteklenen sayfalarda yönetilen render/anti-bot ve API | Unlocker, Browser API, proxy’ler, CAPTCHA/fingerprint/yeniden deneme araçları |
| Hazır scraper/şablonlar | Site şablonları + özel e-posta/telefon/görsel extractor’ları | Popüler alan adları için hazır Scraper API’leri (satıcı sayıları yüzeye göre değişir; resmi sayfalarda 100+ ile 600+ arası rakamlar geçer) |
| API erişimi | Open API: Distill, Extract, Suggest Fields, async batch’ler, webhook’lar | Birden çok ürün API’si: Crawl, Unlocker, Browser, Scraper, SERP, Datasets, Proxies |
| MCP/agent desteği | Resmi açık kaynak MCP + CLI | Resmi barındırılan MCP, Agent Browser, Search & Extract yüzeyleri |
| Belge/görsel çıkarımı | PDF ve görsele yönelik araçlar belgelenmiştir | Birincil odak değildir; Crawl/Studio’da bazı veri ayrıştırma özellikleri vardır |
| Çok dilli destek | Field AI Prompts çıkarım sırasında çeviri yapabilir | Çıktı dili kaynağa bağlıdır; yerleşik “çıkarırken çevir” özelliği yoktur |
| Uyumluluk sertifikaları | İstek üzerine DPA, TLS/AES; kamuya açık SOC 2 bulunamadı | ISO 27001/27017/27018, SOC 2 Type II (NDA altında), herkese açık SOC 3, CSA STAR, KYC |
Thunderbit’in Öne Çıktığı Noktalar
- One Click Extract ve tarayıcı içindeki görsel iş akışı. Sayfayı görürsünüz, ajan tarafından algılanan sütunları görürsünüz, düzenler ve scrape edersiniz. Geri bildirim döngüsü anlıktır.
- Popüler siteler için tek tıkla çıkarım yapan isimlendirilmiş şablonlar ve özel e-posta/telefon/görsel extractor’ları.
- Google Sheets, Airtable, Notion, Excel gibi iş araçlarına doğrudan aktarım — arada ekstra adım yok.
- Field AI Prompts ile çıkarım sırasında veriyi dönüştürme, çevirme, kategorize etme veya biçimlendirme. Temiz ve doğrudan kullanıma hazır çıktıya ihtiyaç duyan iş kullanıcıları için gerçekten faydalıdır.
- Anlık ve aralıklı scraping görevlerinde hızlı değer üretimi. Bir sayfadan şimdi bir tabloya ihtiyacınız varsa, hız açısından Thunderbit’i geçmek zor.
Bright Data’nın Öne Çıktığı Noktalar
- Devasa proxy altyapısı. Bright Data, 195+ ülkede 400M+ aylık residential IP olduğunu iddia ediyor; buna ek olarak datacenter, ISP ve mobile ağlar da sunuyor. Coğrafi hedefleme, oturum kontrollü veya IP çeşitliliği gerektiren isteklerde bu çok daha derin bir araç setidir.
- Anti-bot ve blok aşma ürünleri. Unlocker, Browser API, CAPTCHA çözümü, fingerprint yönetimi ve yeniden deneme mantığı; Cloudflare, DataDome, PerimeterX gibi güçlü korumalı siteler için özel olarak geliştirilmiştir. Başarı oranı hedefe ve tarihe bağlıdır, ancak araç takımı daha kapsamlıdır.
- Yüksek eşzamanlılıkla, API odaklı büyük ölçekli çıkarım. Scraper Studio SSS, kuyruklanmadan önce scraper başına 1.000 paralel batch işine kadar destek verdiğini belirtir. Birden çok ürün API’si karmaşık pipeline mimarilerini destekler.
- Popüler alan adları için hazır Scraper API’leri, ayrıca veri setleri, Data Firehose ve veriyi scrape etmek yerine doğrudan teslim almak isteyen ekipler için yönetilen veri toplama seçenekleri.
- Kurumsal uyumluluk sertifikaları. ISO 27001, SOC 2 Type II (NDA altında), SOC 3, CSA STAR ve KYC; regüle sektörler ve kurumsal satın alma süreçleri için önemlidir.
Thunderbit ve Bright Data Fiyatlandırması: Gerçekte Ne Ödersiniz?
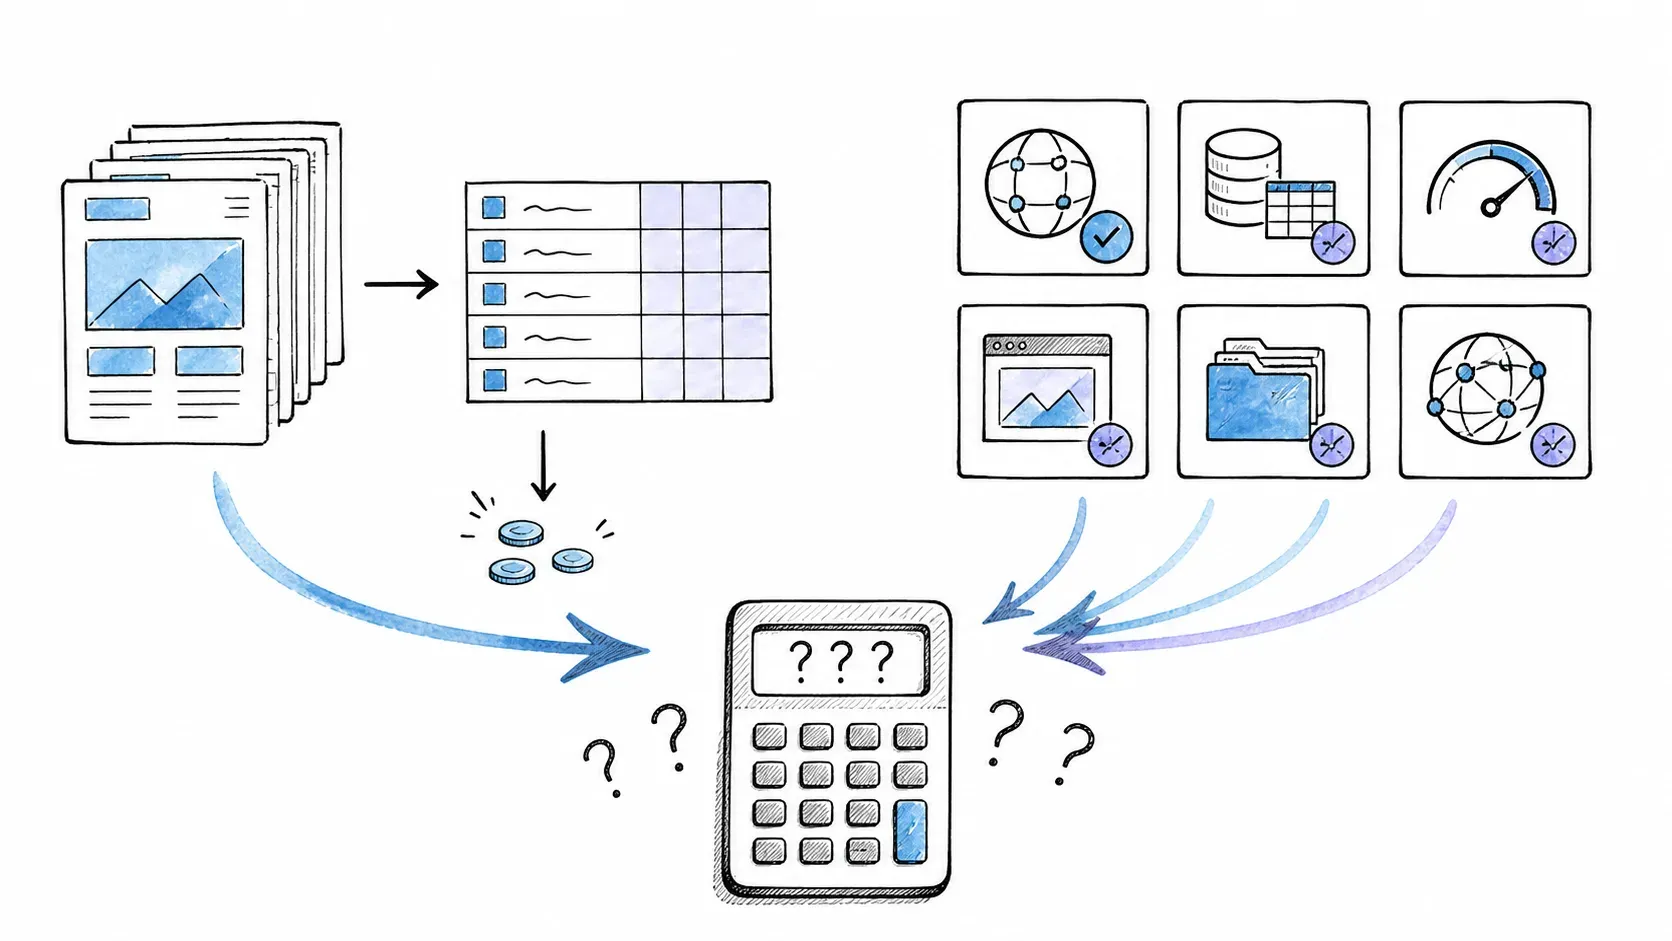
Buradaki en zor sorulardan biri bu. İki araç kullanımı tamamen farklı şekillerde ölçer; bu yüzden basit bir “sayfa başına” karşılaştırma işlemez.
Thunderbit Fiyatlandırması (Ağustos 2026 itibarıyla)
Thunderbit’in kodsuz eklentisi kredi sistemi kullanır. Standart scraping, çıktıdaki her satır için 1 kredi; alt sayfa zenginleştirme, satır başına 2 kredi; Personal Data Enrichment ise başarılı her sorgu için 30 kredi harcar.
| Plan | Aylık fiyat | Aylık kredi |
|---|---|---|
| Free | $0 | Ayda 6 sayfa, sayfa başına maksimum 30 kredi |
| Starter | $15/ay | 500/ay |
| Pro Tier 1 | $38/ay | 3,000/ay |
| Pro Tier 2 | $75/ay | 6,000/ay |
| Pro Tier 3 | $125/ay | 10,000/ay |
| Pro Tier 4 | $249/ay | 20,000/ay |
| Business | Özel | Özel |
Yıllık ödeme belirgin şekilde daha ucuzdur (örneğin Starter, yıllık 5.000 kredi için yılda $108’e düşer).
Open API için ayrı bir ölçüm sistemi vardır: Distill sayfa başına 1 API birimi, Extract sayfa başına 20 birim kullanır. API planları, yıllık faturalandırıldığında yılda 60.000 birim için ayda $16’dan başlar.
Bright Data Fiyatlandırması (Ağustos 2026 itibarıyla)
Bright Data’nın fiyatlandırması ürüne ve ölçüm birimine göre değişir. İşte önemli ürünler için giriş seviyesindeki kullandıkça öde oranları:
| Ürün | Ücretsiz katman | PAYG başlangıç oranı | Ölçüm |
|---|---|---|---|
| Unlocker API | Ayda 5K istek | $1.50 / 1K başarılı istek | Başarılı istekler |
| SERP API | Ayda 5K istek | $1.50 / 1K başarılı istek | Başarılı istekler |
| Scraper APIs | Ayda 5K kayıt | $1.50 / 1K teslim edilen kayıt | Kayıtlar |
| Scraper Studio | Ayda 5K sayfa yükleme | $1.50 / 1K sayfa yükleme | Sayfa yükleme |
| Browser API | Deneme değişken | $8 / GB | Aktarılan bant genişliği |
| Residential proxies | PAYG | $8 / GB | Bant genişliği |
| Datasets | Örnekler değişken | 100K kayıt için $250’dan başlar | Kayıt + yenileme kapsamı |
Bright Data’nın global gezinmesinde bazen yüksek hacimli katmanlara veya promosyonlara karşılık gelen daha düşük “başlangıç fiyatı” değerleri görünür. Değerlendirdiğiniz ürünün canlı fiyat sayfasını mutlaka kontrol edin.
Neden Basit Bir Fiyat Kazananı Yok?
100 kategori sayfası ve her sayfada 50 satır, Thunderbit’te 5.000 kodsuz kredi olabilir (Pro Tier 1 seviyesinde yaklaşık $38/ay). Aynı iş Bright Data’da 100 sayfa yükleme ile Scraper Studio’da, 5.000 teslim edilen kayıt ile Scraper API’de veya değişken Browser API bant genişliğiyle çalışabilir — her birinin fiyatı farklıdır. “Daha ucuz” araç tamamen şuna bağlıdır:
- Her platformda hangi ürün/yüzeyi kullandığınız
- Girdi URL’si başına kaç çıktı satırı aldığınız
- Sayfalama, alt sayfalar veya tarayıcı render’ı gerekip gerekmediği
- Aylık mı yıllık mı faturalandırma olduğu
- Yeniden denemeler, eksik alan oranları ve limit aşımı politikaları
Teknik olmayan ekiplerin hafif ila orta ölçekli kullanımı için (ayda birkaç yüz ila birkaç bin satır), Thunderbit’in kredi tabanlı planları genellikle daha öngörülebilir ve ekonomiktir. Yüksek hacimli, API odaklı pipeline’lar ve karmaşık teslim ihtiyaçları için Bright Data’nın kayıt başına ya da istek başına fiyatlandırması büyük ölçekte daha maliyet etkin olabilir — fakat bunun için belirli ürünü ve ölçüm modelini iyi analiz etmek gerekir.
Karar vermeden önce her zaman Thunderbit’in fiyatlandırma sayfasını ve ilgili Bright Data fiyatlandırma sayfasını kontrol edin.
Gerçek Kullanım Senaryoları: Thunderbit ve Bright Data Pratikte
Özellik listeleri anlaşmayı kapatmaz — iş akışları kapatır. İşte beş yaygın senaryo ve her aracın bunları nasıl ele aldığı.
Bir Dizin Sitesinden Lead Listesi Oluşturmak
Senaryo: Bir satış operasyonu yöneticisinin, niş bir sektör dizininden 200 iletişim kaydı çekip Google Sheets’e aktarması gerekiyor.
Thunderbit uyumu: Bu, Thunderbit’in tam güçlü olduğu alan. Dizini tarayıcınızda açın, One Click Extract’i çalıştırın, ajan analizi yapıp otomatik başlatsın ve sonucu doğrudan Sheets’e aktarın. API yok, proxy yok, kod yok. Sayfa oturum açmış bir kullanıcı gerektiriyorsa, Browser Mode uyumlu sayfalarda mevcut oturumunuzu kullanabilir.
Bright Data uyumu: Bir hazır Scraper API ile mümkün olabilir (dizin destekleniyorsa) veya özel bir Scraper Studio scraper’ı ile. Ancak tek bir siteden 200 kayıt almak için hesap oluşturma, ürün seçimi ve scraper yapılandırma gibi ek yükler bunu zorlaştırır. Bright Data, bu tür işleri çok daha büyük ölçekte (binlerce ya da on binlerce kayıt) çözmek için tasarlanmıştır.
Yüzlerce SKU’da Rakip Fiyatlarını İzlemek
Senaryo: Bir e-ticaret operasyon ekibi, birkaç rakip sitede 500+ ürünün fiyatını haftalık olarak takip ediyor.
Thunderbit uyumu: Desteklenen sayfalarda zamanlanmış çıkarım orta hacimler için gayet iyi çalışır. Her rakip için bir scraper kurun, sayfalamayı ayarlayın, haftalık çalıştırmalar planlayın ve Sheets veya Airtable’a aktarın. 500 SKU için muhtemelen Pro plan gerekir.
Bright Data uyumu: Güçlü korumalı e-ticaret sitelerinde (Cloudflare korumalı mağazalar gibi), Bright Data’nın Unlocker veya Browser API’si, Scraper Studio ya da Scraper API akışıyla birlikte daha dayanıklıdır. Binlerce SKU’yu, onlarca sitede ve karmaşık anti-bot önlemleriyle takip ediyorsanız, Bright Data’nın altyapısı bunun için biçilmiş kaftandır. Bedeli ise daha fazla kurulum ve daha dik bir öğrenme eğrisidir.
Pazar Raporu İçin Tek Seferlik Araştırma
Senaryo: Bir pazarlama analisti, üç aylık bir rapor için 5 web sitesinden veri istiyor — ürün listeleri, yorum sayıları, fiyat katmanları.
Thunderbit uyumu: İdeal. Eklentiyi kurun, her siteyi ziyaret edin, scrape edin, dışa aktarın. Altyapı yatırımı yok, zaten sahip olduğunuz plan dışında tekrar eden maliyet yok. Thunderbit’in hızlı değer üretimi tam bu tür görevlerde öne çıkar.
Bright Data uyumu: Gereğinden fazla. Kurulum süresi ve ürün seçimi süreci, 5 site üzerindeki tek seferlik bir iş için mantıklı değildir. Bu siteler çok güçlü koruma altındaysa ve veriyi başka türlü alamıyorsanız başka, ama aksi halde Bright Data burada ihtiyaçtan fazla bir araçtır.
Bir Mühendislik Ekibi İçin Büyük Ölçekli Veri Pipeline’ı
Senaryo: Bir veri mühendisliği ekibi, birden fazla kaynaktan günde 100K+ sayfa toplayan ve bunları bir bulut veri ambarına teslim eden otomatik bir pipeline kuruyor.
Thunderbit uyumu: Open API, async batch’leri, webhook’ları ve Pro API planında aynı anda 50’ye kadar eşzamanlı istekle milyonlarca sayfaya kadar ölçek iddiasını destekler. Orta ölçekli pipeline’lar için makul bir seçenek olabilir. Ancak Thunderbit’in ana tasarım odağı tarayıcı eklentisi ve iş kullanıcı iş akışıdır; yüksek eşzamanlı altyapı değildir.
Bright Data uyumu: Bunun için doğrudan tasarlanmıştır. Birden çok ürün API’si (Crawl, Unlocker, Browser, Scraper, SERP), yönetilen tarayıcılar, proxy ağları ve webhook, bulut depolama, SFTP ve veri ambarlarına teslim seçenekleri vardır. Scraper Studio, scraper başına 1.000 paralel batch işini belgelendirir. Derin proxy kontrolü, coğrafi hedefleme, oturum yönetimi ve kurumsal uyumluluk kanıtı gerekiyorsa, Bright Data daha doğal bir değerlendirme adaydır.
AI/ML Eğitim Verisi Toplama
Senaryo: Bir ML mühendisi, yüzlerce domainden yapısal eğitim verisi istiyor ve bunu aylık olarak yeniliyor.
Thunderbit uyumu: API, orta ölçekte yapılandırılmış çıkarımı yönetebilir; ayrıca MCP/CLI entegrasyonu, AI agent iş akışlarından erişimi kolaylaştırır. Daha küçük ve net tanımlı veri setleri için uygundur.
Bright Data uyumu: Datasets, Data Firehose ve Scraper API’leri tam da bunun için tasarlanmıştır — büyük ölçekli, çok kaynaklı, sürekli yenilenen yapılandırılmış veri. MCP Server ve Agent Browser da ajan odaklı erişim sağlar. Ölçekli eğitim verisi için Bright Data daha fazla yüzey ve teslim seçeneği sunar.
Thunderbit’i Ne Zaman Seçmeli / Bright Data’yı Ne Zaman Seçmeli?
Aşağıdaki matriste kendi durumunuzu bulun. Gerçekten hangisindesiniz, dürüst olun.
| Eğer siz… | Ve ihtiyacınız… | Şunu düşünün… |
|---|---|---|
| Pazarlamacı veya satış operasyonları uzmanı (teknik olmayan) | Sheets/Excel’e aktarılan hızlı bir lead listesi veya rakip verisi | Thunderbit — tarayıcı eklentisi, One Click Extract, doğrudan dışa aktarım |
| Tek kurucu veya serbest çalışan | Altyapı yatırımı olmadan tek seferlik veri çekimleri | Thunderbit — ücretsiz katman, hızlı kurulum, tekrarlayan altyapı maliyeti yok |
| Orta hacimli operasyon ekibi | Haftalık olarak birkaç yüz ila birkaç bin satır izleme | Thunderbit — zamanlanmış çıkarım, Pro planlar, iş aracı entegrasyonları |
| Veri pipeline’ı kuran geliştirici | Proxy rotasyonu ve veri ambarına teslim ile yüksek hacimli, API odaklı çıkarım | Bright Data — Crawl/Unlocker/Browser API’leri, proxy ağları, webhook/storage teslimi |
| Kurumsal veri ekibi | Uyumluluk sertifikalı, büyük ölçekli, çok kaynaklı toplama ve satın alma süreçleri | Bright Data — ISO/SOC sertifikaları, KYC, kurumsal kontroller, yönetilen toplama |
| AI/ML mühendisi | Sürekli yenilenen, ölçekli yapılandırılmış eğitim verisi | Bright Data — Datasets, Firehose, Scraper API’leri, MCP; daha küçük işler için Thunderbit API’yi değerlendirin |
| Güçlü korumalı sitelerle uğraşan herkes | Cloudflare/DataDome/PerimeterX korumalı hedeflerden ölçekli veri | Bright Data — Unlocker, Browser API, proxy rotasyonu, CAPTCHA/fingerprint araçları |
Karar, hangi aracın “daha iyi” olduğu ile ilgili değil. Thunderbit’in gücü, iş kullanıcıları için kodsuz sadelik ve hızlı değer üretimidir. Bright Data’nın gücü ise altyapı derinliği, anti-bot dayanıklılığı, kurumsal uyumluluk ve teknik ekipler için ölçektir. Bir aracı diğerinin yerine kullanmak, zarf açmak için testere kullanmaya benzer.
Uyumluluk ve Veri Gizliliği: İş Kullanıcılarının Bilmesi Gerekenler
Hiçbir satıcının güvenlik veya uyumluluk programı, bir hedefi scrape etme izni vermez. Sorumluluk her zaman yetkili erişim, geçerli yasa, kişisel veri yükümlülükleri ve web sitesi kullanım şartlarına aittir. Her iki araç da GDPR ve CCPA gibi veri gizliliği yasalarına uyum gerektirir.
Bright Data, ISO/IEC 27001:2022, ISO 27017, ISO 27018, SOC 2 Type II (NDA altında), herkese açık SOC 3 raporu, CSA STAR, TLS 1.3, beklemede AES-256 ve bir KYC/kullanım senaryosu inceleme süreci belgeler. Bu, denetim kanıtı talep eden regüle sektörler ve kurumsal satın alma ekipleri için önemlidir.
Thunderbit, şartlarında ve gizlilik politikasında GDPR/CCPA/CPRA rolleri, talep üzerine DPA, SCC’ler, TLS 1.2+ ve beklemede AES-256 tanımlar. Bu yazı itibarıyla herkese açık bir SOC 2 onayı bulunamadı.
Kişisel veri topluyorsanız veya regüle bir sektörde çalışıyorsanız, hukuk danışmanına başvurun. Uyumluluk araçları bir başlangıç noktasıdır, son nokta değil.
Thunderbit vs Bright Data: Gerçek İhtiyacınıza Uygun Aracı Seçin
Thunderbit, hızlı şekilde yapılandırılmış veri almak isteyen, kod istemeyen ve minimum kurulumla çalışan iş kullanıcıları için AI destekli bir tarayıcı eklentisidir. Bright Data ise yüksek hacimde, teknik ekipler için ölçek, anti-bot dayanıklılığı, derin proxy kontrolü ve uyumluluk kanıtı sunan modüler bir Web data infrastructure platformudur.
- Tarayıcınızdaki bir sayfadan veri alıp dakikalar içinde Sheets’e aktarmak istiyorsanız: Thunderbit’i deneyin.
- Mühendislik kaynağı ve kurumsal gereksinimleri olan uzun vadeli bir veri pipeline’ı kuruyorsanız: Bright Data’yı değerlendirin.
- İki seçenek arasında kalıyorsanız: önce daha basit araçla başlayın, ihtiyaçlarınız büyüdükçe daha güçlü olana geçin. Bu bir kaçamak değil — ekiplerin veri iş akışlarını gerçekte böyle olgunlaştırdığı bir yöntemdir.
SSS
Hangisi daha ucuz: Thunderbit mi Bright Data mı?
Teknik olmayan ekiplerin hafif ila orta ölçekli kullanımı için (ayda birkaç yüz ila birkaç bin satır), Thunderbit’in kredi tabanlı planları genellikle daha uygun ve öngörülebilirdir. Bright Data’nın fiyatlandırması yüksek hacimli, altyapı seviyesi kullanım için tasarlanmıştır ve ürüne ve ölçüm birimine göre değişir (istek başına, kayıt başına, GB başına, IP başına). Doğrudan maliyet karşılaştırması için belirli ürünü, hacmi ve faturalama birimini eşleştirmek gerekir. Güncel oranlar için her zaman Thunderbit’in fiyatlandırma sayfasını ve ilgili Bright Data fiyatlandırma sayfasını kontrol edin.
Thunderbit ve Bright Data’yı birlikte kullanabilir miyim?
Evet. Bazı ekipler Thunderbit’i hızlı ve tek seferlik çıkarımlar için (lead aramaları, bir defalık araştırmalar, küçük izleme işleri) kullanırken, Bright Data’yı proxy altyapısı gerektiren büyük ölçekli veya yoğun korumalı hedefler için kullanır. Bu “hibrit” yaklaşım, basit işler için gereksiz kurulumdan kaçınırken karmaşık işler için de altyapıyı eksik bırakmamanızı sağlar.
Thunderbit veya Bright Data kullanmak için kodlama bilgisi gerekir mi?
Thunderbit: Tarayıcı eklentisi iş akışı için kodlama gerekmez. Ancak Open API, MCP ve CLI teknik bilgi ister. Bright Data: Scraper Studio AI Agent, hazır kolektörler ve veri setleri, script yazmadan kullanılabilen düşük kodlu seçeneklerdir. Ama en gelişmiş özelliklerin çoğu — Unlocker, Browser API, ham proxy zone’ları, özel IDE scraper’ları — geliştirici desteği gerektirir. Bright Data’da tam güce ulaşmak teknik yapılandırma demektir.
LinkedIn scraping için Thunderbit mi Bright Data mı daha iyi?
Thunderbit, tarayıcınızda yetkili erişiminiz olan sayfalardan veri çekebilir (ör. uyumlu sayfalarda kendi LinkedIn oturumunuz). Bright Data, LinkedIn için API üzerinden hazır Scraper API’leri sunar. Her iki araç da kullanıcıların LinkedIn’in kullanım şartlarına ve geçerli yasalara uymasını gerektirir. LinkedIn yaptırım konusunda agresiftir; bu yüzden hangi aracı kullanırsanız kullanın dikkatli ilerleyin. Lead generation yaklaşımları hakkında daha fazla bilgi için rehberimize göz atın.
Thunderbit’i aşarsam Bright Data’ya daha sonra geçebilir miyim?
Kesinlikle. Thunderbit, herhangi bir pipeline’a aktarılabilen standart formatlara (CSV, JSON, Excel, Google Sheets) dışa aktarım yapar. Veri ihtiyaçlarınız Thunderbit’in eklentisi veya API’sinin karşılayabileceğinin ötesine geçerse — ya da daha derin proxy, anti-bot veya uyumluluk altyapısına ihtiyaç duyarsanız — mevcut veri ve iş akışlarınızı kaybetmeden Bright Data’ya geçebilir veya onu Thunderbit ile birlikte kullanabilirsiniz. Bu iki araç sizi kilitlemez.
Daha Fazla Bilgi




