
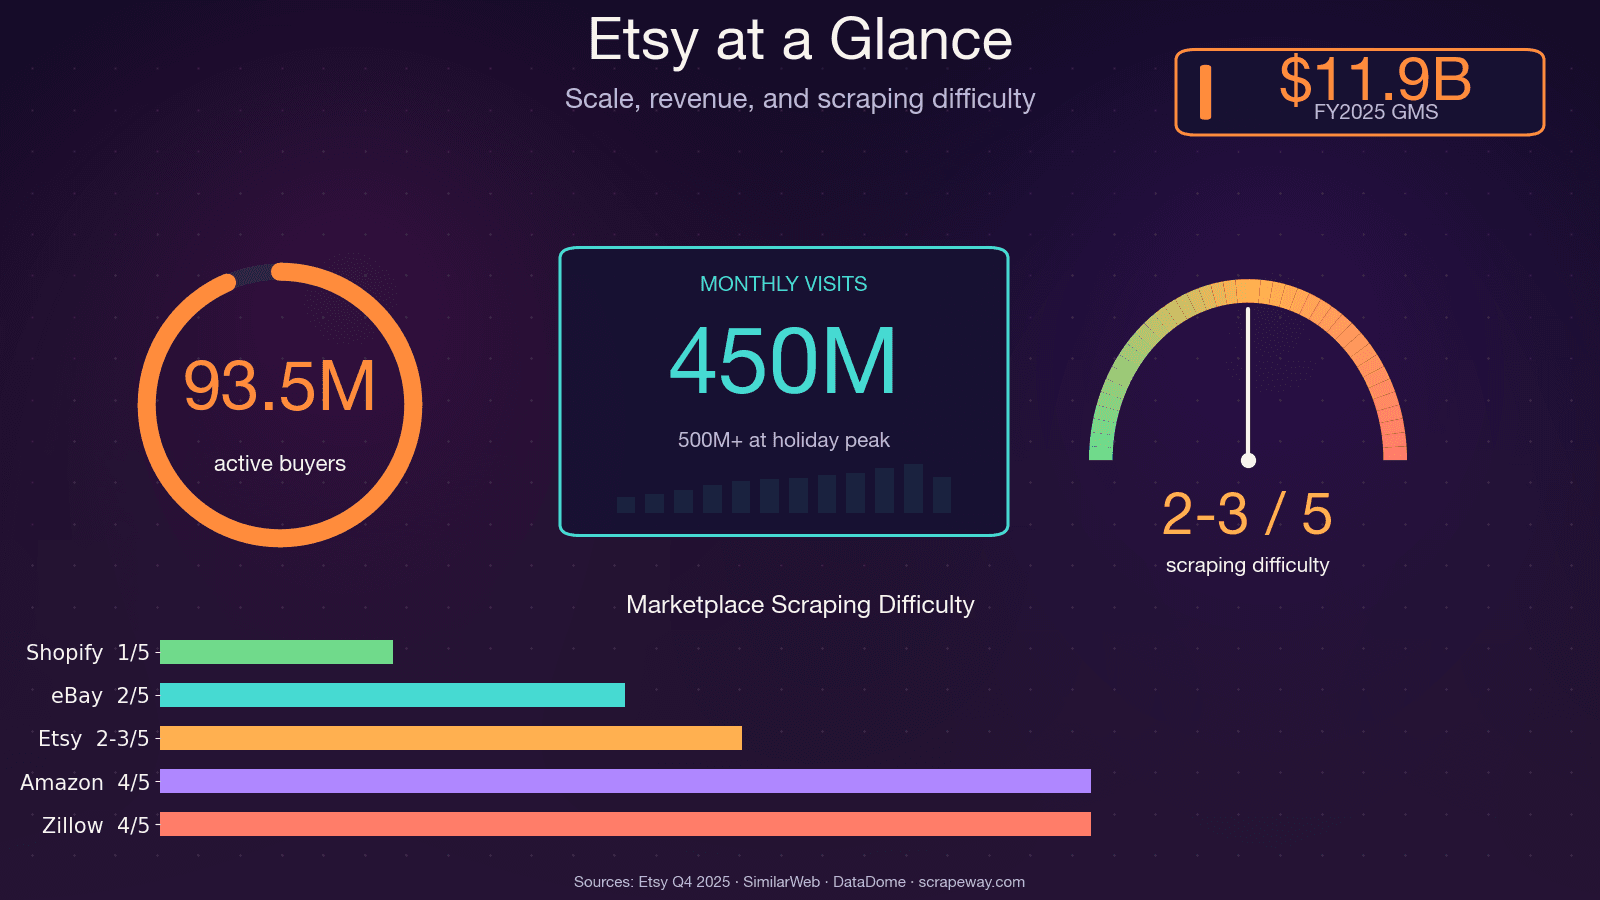
Etsy’de 100 milyondan fazla aktif ilan, 5,6 milyon satıcı ve aylık yaklaşık 450 milyon ziyaret var. Bu da fiyatlar, trendler, yorumlar ve rakipler hakkında herkese açık devasa bir veri havuzu demek — ve bunları elle toplamaya çalıştıysan, bunun ne kadar zahmetli olduğunu bilirsin.
Bir zamanlar pazar araştırması projesi için rakip ürünleri tek tek kataloglamaya bir hafta sonumu harcamıştım. Ürün numarası 30’a geldiğimde, beni o tabloya götüren tüm hayat seçimlerini sorguluyordum. Asıl mesele şu: Etsy verileri fiyat analizi, ürün geliştirme, niş keşfi ve satıcı kıyaslaması için inanılmaz değerli — ama yalnızca bunu ölçekli biçimde çıkarabiliyorsan. Bu rehber tam da bunun için var: Python ile Etsy’den veri çekmeyi, dört ana sayfa türünün tamamında (arama sonuçları, ürün sayfaları, mağaza sayfaları ve yorumlar) nasıl yapacağını anlatan tek bir kaynak ve ayrıca Etsy’nin bot karşıtı savunmalarına dair dürüst bir değerlendirme ile, kod yazmak istemeyenler için kodsuz bir alternatif.
Python ile Etsy’den Veri Çekmek Ne Anlama Gelir?
Basitçe söylemek gerekirse, web kazıma; web sayfalarını ziyaret eden ve ardından ilgilendiğin verileri — ürün adları, fiyatlar, açıklamalar, görseller, puanlar, yorumlar, mağaza bilgileri — otomatik olarak çıkaran ve bunları elektronik tablo ya da veritabanı gibi yapılandırılmış bir formata dönüştüren kod yazmaktır.
Bu iş için en sık tercih edilen dil genellikle Python’dur. Öğrenmesi kolaydır, çok büyük bir topluluğa sahiptir ve kazıma için güçlü bir kütüphane ekosistemi sunar: Requests (sayfa çekmek için), BeautifulSoup (HTML ayrıştırmak için), Selenium ve Playwright (tarayıcı otomasyonu için) ve pandas (veriyi düzenlemek ve dışa aktarmak için). Python, Stack Overflow’un yıllık geliştirici anketinde düzenli olarak en popüler 3 dil arasında yer alır; kazıma kütüphaneleri de PyPI’da en çok indirilenler arasındadır.
Etsy’den veri çekerken, tarayıcıya sunulan HTML’den (ve bazen gizli JSON’dan) veri alırsın. Çekebileceğin veri türleri şunları içerir:
- Ürün adları, fiyatlar, açıklamalar, görseller ve varyasyonlar
- Satıcı/mağaza bilgileri (ad, satış sayısı, konum, puan)
- Puanlar ve tam yorum metni
- Arama sonucu ilanları, kategoriler ve trend sinyalleri
Neden Etsy’den Veri Çekmeli? ROI Sağlayan Gerçek Kullanım Senaryoları
Etsy’den veri çekmek sadece teknik bir egzersiz değildir — aynı zamanda rekabet avantajıdır. İster satıcı, ister ürün yöneticisi, ister veri analisti ol; elinin altında yapılandırılmış Etsy verisi olması doğrudan kârlılığı etkileyebilir.
| Kullanım Senaryosu | Ne Çekilir | Kimler İçin Faydalı | İş Etkisi |
|---|---|---|---|
| Rekabetçi Fiyat Analizi | Arama sonuçları + ürün fiyatları | E-ticaret operasyonları, satıcılar | Dinamik fiyatlandırma ortalamada geliri 5–22% artırabilir |
| Niş ve Trend Keşfi | Arama sonuçları, trend olan ilanlar | Kurucular, analistler | Trend nişleri erken fark et (ör. "preppy pijamalar" arama büyümesinde +1.112% gördü) |
| Ürün Geliştirme ve İyileştirme | Yorumlar, ürün detayları | Ürün ekipleri | Bir mutfak eşyası markası, yorum duygu verilerini kullanarak 60 günde #1 En Çok Satan konumunu geri aldı |
| SEO ve Anahtar Kelime Araştırması | Arama sonuçları, ürün başlıkları/etiketleri | Pazarlama ekipleri | Yüksek talep, düşük rekabetli anahtar kelimeleri belirle |
| Satıcı Kıyaslama | Mağaza sayfaları, satış sayıları | Satış ekipleri, analistler | Satın alınmış listelere kıyasla kayıtta $0,01–0,10 maliyetle nitelikli müşteri listeleri oluştur |
| Stok ve Envanter Takibi | Ürün bulunabilirliği | E-ticaret operasyonları | Rakip stok değişimlerine daha hızlı tepki ver |
Bu kullanım senaryolarının her biri farklı Etsy sayfa türlerinden veri gerektirir — bu yüzden bu rehber hepsini kapsıyor.
Zaman tasarrufu: manuel ve otomatik karşılaştırması
- Manuel Etsy araştırması: Ürün başına 30–45 dakika (100 ürün için 50–75 saat)
- Otomatik veri çekme: 100 ilanı 2–5 dakikada
- Yapay zekâ destekli veri çekme, 30–40% daha hızlıdır ve doğruluk oranı %99,5’e kadar çıkabilir
Etsy API mi, Web Kazıma mı: Hangisini Seçmelisin?
Tek bir satır kod yazmadan önce sormaya değer: Etsy’nin resmi API’sini mi kullanmalıyım, yoksa siteyi doğrudan mı kazımalıyım? Forumlarda bu soruyu sürekli görürüm ve cevap, ihtiyacın olan veriye bağlıdır.
Etsy API Neleri Yapabilir, Neleri Yapamaz?
Etsy, OAuth 2.0 kimlik doğrulamasıyla çalışan API v3 sunar. Kendi mağazanıza ait verileri — ilanlar, siparişler, makbuzlar — almak için uygundur. Ancak ciddi sınırlamaları vardır:
- Rakip verisi: API çoğunlukla kendi mağazanla sınırlıdır. Başka bir satıcının fiyatlarını, satışlarını veya ilanlarını çekemezsin.
- Yorumlar: Toplu şekilde tam yorum metni için güçlü bir uç nokta yok.
- Hız limitleri: Varsayılan olarak saniyede 10 istek, günde 10.000 istek. Offset sınırı 12.000 kayıttır.
- AI/ML kullanımı: Uygulama incelemesinde açıkça reddedilir.
- Dokümantasyon: Topluluk şikâyetleri yaygındır — kötü örnekler, kullanım dışı kalmış uç noktalar, yavaş destek.
Web Kazıma Ne Zaman Daha İyi Bir Yoldur?
Rakip istihbaratı, yorum duygu analizi, mağazalar arası analiz veya API’nin açığa çıkarmadığının ötesindeki veriler gerekiyorsa, doğru yol kazımadır. Bedeli şu: Etsy’nin bot karşıtı savunmalarıyla uğraşman gerekir (aşağıda daha fazlası var) ve kurulum için biraz emek harcarsın.
Karşılaştırma Tablosu: API mi, Kazıma mı, Kodsuz mu?
| Kriter | Etsy Resmi API | Python ile Web Kazıma | Thunderbit (Kodsuz) |
|---|---|---|---|
| Ürün fiyatlarına erişim | ✅ (sınırlı alanlar) | ✅ Tam HTML/JSON-LD | ✅ AI görünür herhangi bir alanı çıkarır |
| Yorum verisi | ❌ Toplu olarak yok | ✅ Yorum uç noktası/HTML üzerinden | ✅ Alt sayfa kazıma |
| Rakip mağaza verisi | ❌ Sadece kendi mağazan | ✅ Herkese açık herhangi bir mağaza | ✅ Herkese açık herhangi bir mağaza |
| Kimlik doğrulama gerekli mi? | ✅ OAuth 2.0 | ⚠️ Giriş yapan veriler için çerezler | ⚠️ Giriş için tarayıcı üzerinden kazıma |
| Bot karşıtı risk | Yok | YÜKSEK (DataDome) | Yönetiliyor (tarayıcı yerel) |
| Kurulum süresi | Orta (API anahtarları, OAuth) | Yüksek (kod + proxy) | ~2 dakika |
Rakip verisi, yorumlar veya mağazalar arası analiz gerekiyorsa, API bunu basitçe karşılamaz. Durumun dürüst özeti bu.
Tek Satır Kod Yazmadan Önce Python ile Kazıma Yaklaşımını Seç
Reddit ve Stack Overflow’da sürekli gördüğüm bir soru: "Requests + BeautifulSoup mu, Selenium mu, proxy API mi, yoksa bambaşka bir şey mi kullanmalıyım?" Doğru cevap; beceri seviyene, bütçene ve kullanım senaryona bağlı.
| Yaklaşım | En Uygun Olduğu Durum | Öğrenme Eğrisi | JS Destekler mi? | Bot Karşıtı Yönetim | Maliyet |
|---|---|---|---|---|---|
| Requests + BeautifulSoup | Tam kontrol isteyen geliştiriciler | Orta | ❌ | Manuel (başlıklar, proxy’ler) | Ücretsiz + proxy maliyeti |
| Selenium / Playwright | JS ağırlıklı sayfalar, giriş akışları | Yüksek | ✅ | Kısmi (tarayıcı parmak izi) | Ücretsiz + proxy maliyeti |
| Proxy API servisleri | Ölçek + bot engelini aşma | Orta | ✅ (API üzerinden) | ✅ Yerleşik | Aylık $49+ |
| Thunderbit (kodsuz) | Geliştirici olmayanlar, hızlı çıkarım | Çok düşük | ✅ (tarayıcı yerel) | ✅ (tarayıcı oturumu) | Ücretsiz plan mevcut |
Tam kontrol istiyorsan ve Python konusunda rahatsan, Requests + BeautifulSoup ile ilerle. JS renderlama veya giriş akışları gerekiyorsa Selenium kullan. Ölçekte bot engelini aşmak istiyorsan proxy hizmetini düşün. Etsy verisine kod yazmadan ya da kodu bakımda tutmadan ulaşmak istiyorsan, Thunderbit’e göz atmaya değer — birazdan daha detaylı anlatacağım.
Etsy Nasıl Karşılık Veriyor: DataDome Bot Karşıtı Korumasını Anlamak
Çoğu kazıma rehberi sana sadece "bir proxy kullan" der ve geçer. Etsy için bu yeterli değil. Etsy, webdeki en agresif bot karşıtı sistemlerden biri olan DataDome kullanıyor. DataDome’un kendi vaka çalışması Etsy’yi bir başarı hikâyesi olarak öne çıkarıyor ve kazıyıcıların bir zamanlar Etsy’nin bilişim maliyetlerinin yaklaşık %1’ini oluşturduğunu belirtiyor.
DataDome Nedir ve Nasıl Çalışır?
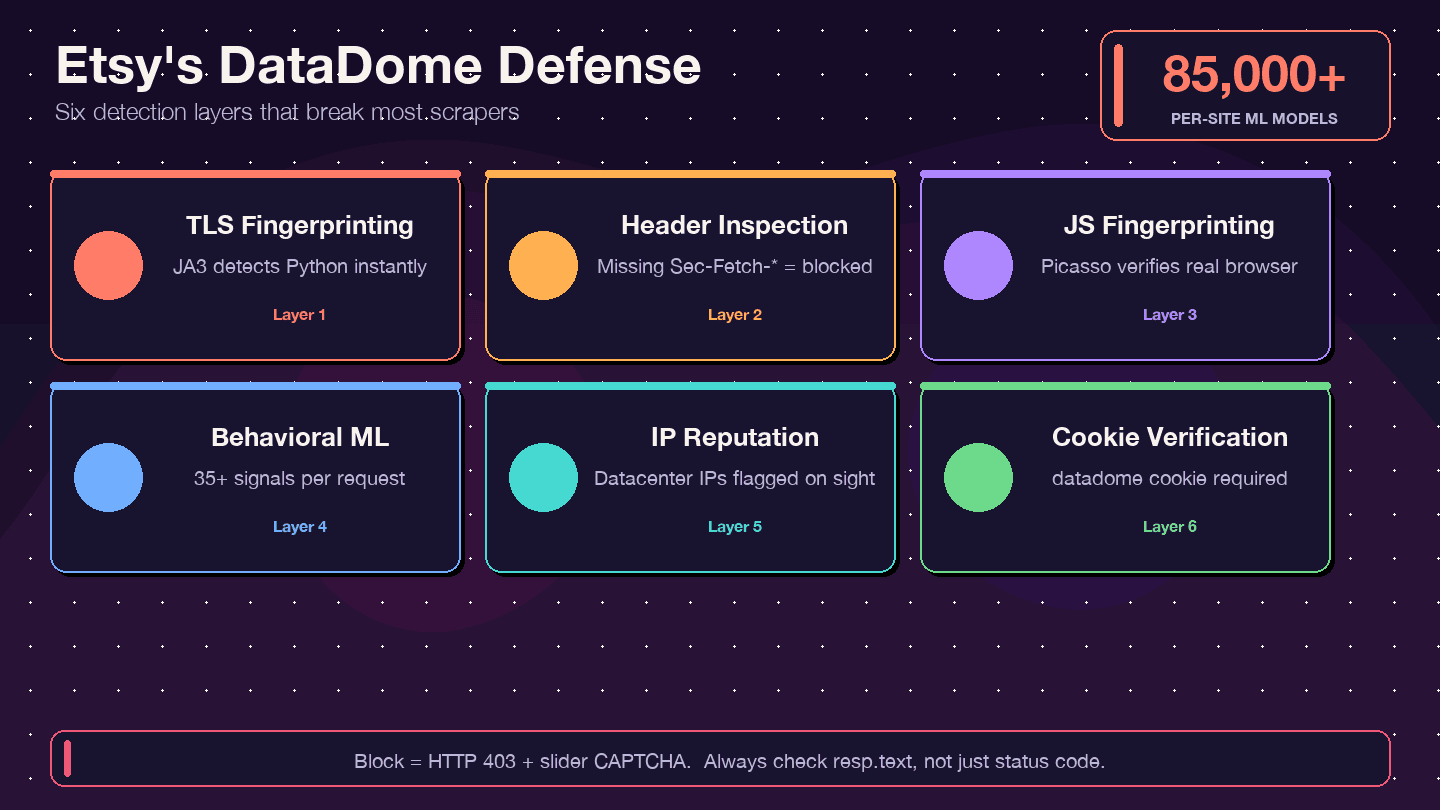
DataDome yalnızca IP adresini kontrol etmez. Çok katmanlı bir tespit sistemi çalıştırır:
- TLS parmak izi (JA3): Python’un
requestskütüphanesinin, DataDome’un anında fark edebileceği ayırt edici bir TLS imzası vardır. - HTTP başlığı/protokol denetimi: Eksiksiz ve tutarlı tarayıcı başlıklarını kontrol eder — eksik veya yanlış sıralanmış başlıklar uyarı işaretidir.
- JavaScript parmak izi (Picasso protokolü): Gerçek kullanıcı olup olmadığını doğrulamak için tarayıcıda JS meydan okumaları çalıştırır.
- Davranışsal ML: Her istek için 35’ten fazla sinyali analiz eder; site başına 85.000’den fazla model kullanır.
- IP itibar skoru: Veri merkezi IP’leri anında işaretlenir.
- Çerez doğrulaması:
datadomeçerezi mevcut ve geçerli olmalıdır.
Engellendiğini Gösteren İşaretler ve Nasıl Kontrol Edeceğin
En yaygın tuzaklardan biri şu: 200 OK yanıtı alırsın, ama HTML aslında istediğin veri değil, bir CAPTCHA sayfasıdır. Diğer işaretler:
- 403 Forbidden hataları
- Yönlendirme döngüleri
- Yanıt gövdesinde
ddJavaScript nesnesi veya slider CAPTCHA HTML’si bulunması
Yalnızca durum kodunu değil, yanıt gövdesini de mutlaka incele. Hızlı bir kontrol:
if "captcha" in resp.text.lower() or "datadome" in resp.text.lower():
    print("Engellendin! Veri yerine bir CAPTCHA sayfası geldi.")
Tespiti Azaltan Başlıklar ve Çerezler
Engellenmeyeceğini garanti edemezsin, ama gerçekçi başlıklar ve çerez yönetimi ciddi fark yaratır:
session = requests.Session()
session.headers.update({
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 Chrome/133.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8",
    "Accept-Language": "en-US,en;q=0.9",
    "Accept-Encoding": "gzip, deflate, br",
    "Sec-Ch-Ua": '"Chromium";v="133", "Not-A.Brand";v="99", "Google Chrome";v="133"',
    "Sec-Ch-Ua-Mobile": "?0",
    "Sec-Ch-Ua-Platform": '"Windows"',
    "Sec-Fetch-Dest": "document",
    "Sec-Fetch-Mode": "navigate",
    "Sec-Fetch-Site": "none",
    "Upgrade-Insecure-Requests": "1",
})
Ayrıca önemli olanlar:
- İstekler arasında
requests.Session()kullanarak çerezleri kalıcı tut. - İstekler arasına rastgele beklemeler ekle (2–7 saniye).
- Yönlendirme zincirini taklit et: Önce ana sayfayı, sonra aramayı, sonra ürün sayfalarını ziyaret et.
- Ölçek büyüdüğünde residential proxy dönüşümü şarttır. Veri merkezi IP’leri neredeyse anında işaretlenir.
Bu teknikler tespiti azaltır ama tamamen ortadan kaldırmaz. Yüksek hacimli kazıma için büyük olasılıkla bir proxy hizmetine ya da tarayıcı tabanlı bir yaklaşıma ihtiyacın olacak.
Etsy’den Veri Çekmek İçin Python Ortamını Kurmak
Başlamadan Önce:
- Zorluk: Orta
- Gerekli Süre: ~30–60 dakika (kurulum + ilk kazıma)
- İhtiyacın Olanlar: Python 3.8+, pip, bir kod editörü, Chrome tarayıcısı (DevTools incelemesi için)
Bağımlılıkları Kur
Bir proje klasörü oluştur, sanal ortam kur ve ihtiyacın olacak kütüphaneleri yükle:
mkdir etsy-scraper && cd etsy-scraper
python -m venv venv
source venv/bin/activate  # Windows'ta: venv\Scripts\activate

pip install requests beautifulsoup4 lxml pandas
- requests — web sayfalarını çeker
- beautifulsoup4 — HTML ayrıştırır
- lxml — daha hızlı HTML ayrıştırıcıdır (isteğe bağlı ama önerilir)
- pandas — veriyi yapılandırır ve CSV/Excel’e aktarır
Daha sonra tarayıcı otomasyonu gerekirse (giriş veya JS ağırlıklı sayfalar için), şunu da yükle:
pip install selenium
Koda Başlamadan Önce Etsy’nin Sayfa Yapısını Anla
Çok zaman kazandıran bir ipucu: Etsy, çoğu sayfada yapılandırılmış ürün verisini <script type="application/ld+json"> etiketlerinin içine yerleştirir. Bu JSON-LD verisi zaten düzenlidir — ürün adı, fiyat, puan, görseller — bu yüzden her alan için kırılgan CSS seçicilerle uğraşmana gerek kalmaz.
Herhangi bir Etsy ürün sayfasını aç, sağ tıkla, "Sayfa Kaynağını Görüntüle" seçeneğine gir ve application/ld+json ifadesini ara. @type: Product içeren bir blok bulacaksın; ihtiyaç duyacağın verilerin çoğu burada yer alır. Arama sonuç sayfalarında ise @type: ItemList bulunur.
CSS seçiciler yine de yedek olarak kullanışlıdır (kargo detayları veya yorum metni gibi JSON-LD’de olmayan veriler için), ama ilk durağın JSON-LD olmalı.
1. Adım: Etsy Arama Sonuçlarını Python ile Kazı
Arama sonuçları, çoğu Etsy kazıma projesinin başlangıç noktasıdır — ister bir nişi izliyor, ister rakip fiyatlarını takip ediyor, ister bir ürün veritabanı kuruyor ol.
Arama URL’sini Oluştur
Etsy arama URL’leri şu yapıyı izler:
https://www.etsy.com/search?q={keyword}&ref=pagination&page={page_number}
Çok kelimeli sorgularda boşlukları URL kodlamasıyla yaz (ör. handmade+jewelry veya handmade%20jewelry). ref=pagination parametresi, isteğin gerçek bir tarayıcı gezinmesine daha çok benzemesini sağlar.
Ek kullanışlı parametreler: order (most_relevant, price_asc, price_desc, date_desc), min_price, max_price, ship_to, free_shipping=true. Her sayfa 48 öğe döndürür.
İsteği Gönder ve HTML’yi Ayrıştır
import requests
from bs4 import BeautifulSoup
import json
import time
import random

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 Chrome/124.0.0.0 Safari/537.36",
    "Accept-Language": "en-US,en;q=0.9",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
}

def scrape_etsy_search(query, max_pages=3):
    all_products = []
    for page in range(1, max_pages + 1):
        url = f"https://www.etsy.com/search?q={query}&ref=pagination&page={page}"
        resp = requests.get(url, headers=headers, timeout=30)
        if "captcha" in resp.text.lower():
            print(f"{page}. sayfada engellendin. Gecikme eklemeyi veya proxy kullanmayı dene.")
            break
        soup = BeautifulSoup(resp.text, "lxml")
        for script in soup.find_all("script", type="application/ld+json"):
            data = json.loads(script.string)
            if data.get("@type") == "ItemList":
                for item in data.get("itemListElement", []):
                    all_products.append({
                        "name": item.get("name"),
                        "url": item.get("url"),
                        "image": item.get("image"),
                        "price": item.get("offers", {}).get("price"),
                        "currency": item.get("offers", {}).get("priceCurrency"),
                        "position": item.get("position"),
                    })
        time.sleep(random.uniform(2, 5))
    return all_products
JSON-LD’den İlan Verilerini Çıkar
itemListElement dizisi sana her ilanın adını, URL’sini, görselini, fiyatını ve para birimini verir. Yıldız puanları veya sonuç sayısı gibi (her zaman JSON-LD’de olmayan) ek veriler de gerekiyorsa, CSS seçicilere dön:
- İlan kartı:
.v2-listing-card - Başlık:
h3.v2-listing-card__title - Fiyat:
span.currency-value - Bağlantı:
a.listing-link(href)
Sayfalama Yönetimi
Sayfalar arasında döngü kur ve her istek arasına rastgele gecikme ekle. Etsy, sorguya bağlı olarak genellikle 20–250 sayfaya kadar sonuç döndürür.
results = scrape_etsy_search("handmade+jewelry", max_pages=5)
print(f"{len(results)} ürün kazındı.")
5 sayfalık bir kazıma, testlerimde yaklaşık 20 saniye sürdü — manuel kopyala-yapıştırla 30+ dakikaya kıyasla.
2. Adım: Etsy Ürün Sayfalarını Python ile Kazı
Aramadan bir ürün URL’si listesi elde ettikten sonra, bir sonraki adım her ilan sayfasından ayrıntılı veriyi çekmektir.
Ürün Sayfasını Getir
def scrape_etsy_product(url):
    resp = requests.get(url, headers=headers, timeout=30)
    soup = BeautifulSoup(resp.text, "lxml")
    for script in soup.find_all("script", type="application/ld+json"):
        data = json.loads(script.string)
        if data.get("@type") == "Product":
            offers = data.get("offers", {})
            price = offers.get("price") or offers.get("lowPrice")
            rating_data = data.get("aggregateRating", {})
            return {
                "name": data.get("name"),
                "description": data.get("description", "")[:500],
                "brand": data.get("brand", {}).get("name") if isinstance(data.get("brand"), dict) else data.get("brand"),
                "category": data.get("category"),
                "price": price,
                "currency": offers.get("priceCurrency"),
                "availability": offers.get("availability"),
                "rating": rating_data.get("ratingValue"),
                "review_count": rating_data.get("reviewCount"),
                "images": data.get("image", []),
                "sku": data.get("sku"),
                "material": data.get("material"),
            }
    return None
Fiyat Varyasyonlarını Yönet
Bazı ürünlerde tek bir offers.price vardır. Diğerlerinde ise (boyut veya renk gibi varyasyonları olanlar) offers.lowPrice ve offers.highPrice kullanılır. Yukarıdaki kod, price alanı yoksa lowPrice’a düşerek her ikisini de işler.
CSS Seçicilerle Ek Alanları Ayrıştır
JSON-LD’de olmayan veriler için — kargo bilgisi, varyasyon seçenekleri, tam satıcı detayları — CSS seçicilere ihtiyacın olacak:
- Başlık:
h1[data-buy-box-listing-title] - Varyasyonlar:
select[data-selector-id]veyadiv[data-option-set] - Kargo: kargo bölümünün yakınındaki
div.wt-text-caption
Buradaki ödün şu: JSON-LD daha temizdir ve düzen değişikliklerine karşı daha stabildir. CSS seçiciler daha kırılgandır ama daha fazla alan kapsar.
3. Adım: Etsy Mağaza Sayfalarını Python ile Kazı
Bu bölüm çoğu rakip rehberde tamamen atlanır — oysa satış ekipleri ve rekabet analistleri için belki de en değerli kısımdır.
Mağaza URL’sini Oluştur ve Sayfayı Getir
def scrape_etsy_shop(shop_name):
    url = f"https://www.etsy.com/shop/{shop_name}"
    resp = requests.get(url, headers=headers, timeout=30)
    soup = BeautifulSoup(resp.text, "lxml")

    # HTML’den mağaza meta verileri (JSON-LD’de değil)
    sales_el = soup.select_one("div.shop-sales-reviews a")
    rating_el = soup.find("input", {"name": "initial-rating"})
    location_el = soup.select_one("div.shop-location")

    shop_data = {
        "name": shop_name,
        "sales": sales_el.text.strip() if sales_el else None,
        "rating": rating_el["value"] if rating_el else None,
        "location": location_el.text.strip() if location_el else None,
    }

    # JSON-LD’den ilanlar
    listings = []
    for script in soup.find_all("script", type="application/ld+json"):
        data = json.loads(script.string)
        if data.get("@type") == "ItemList":
            for item in data.get("itemListElement", []):
                listings.append({
                    "name": item.get("name"),
                    "url": item.get("url"),
                    "price": item.get("offers", {}).get("price"),
                })
    shop_data["listings"] = listings
    return shop_data
Mağaza Sayfalarından Neler Çıkarabilirsin?
Mağaza sayfalarındaki JSON-LD @type: ItemList olur — ürün ilanlarını kapsar, ama satış sayısı, konum veya puan gibi mağaza düzeyi meta verileri kapsamaz. Bunlar için CSS seçiciler gerekir:
| Veri Noktası | Seçici | Notlar |
|---|---|---|
| Mağaza adı | h1 veya meta başlık | Genellikle sayfa başlığında yer alır |
| Toplam satış | div.shop-sales-reviews a | "12.345 satış" gibi bir metin |
| Yıldız puanı | input[name="initial-rating"] değeri | Sayısal 1–5 |
| Konum | div.shop-location | Şehir, ülke |
| Üyelik tarihi | div.shop-info | Tarih metni |
Mağaza verileri, lead listeleri oluşturmak, rakipleri kıyaslamak veya bir nişte en iyi satıcıları belirlemek için benzersiz biçimde değerlidir.
4. Adım: Etsy Yorumlarını Python ile Kazı
Yorumlar, Etsy’deki en değerli — ve en zor — veri noktaları arasındadır. Tam yorum metni, puanlar ve tarihler ilk sayfa HTML’sinde bulunmaz; bunlar dahili bir API uç noktası üzerinden yüklenir.
Yöntem 1: Etsy’nin Dahili Yorum API Uç Noktasını Bul
Chrome’da bir ürün sayfası aç, DevTools’u (F12) aç, Network sekmesine git ve yorumlar bölümüne kaydır. Şuna benzer bir POST isteği göreceksin:
https://www.etsy.com/api/v3/ajax/bespoke/member/neu/specs/deep_dive_reviews
Bu uç nokta, yorum kartlarını içeren HTML parçaları döndürür. Kullanmak için şunlara ihtiyacın olacak:
- listing_id — ürün URL’sindeki sayısal ID
- shop_id — ürün sayfası HTML’sinden regex ile çıkarılır
- csrf_nonce — sayfadaki bir
<meta>etiketinden çıkarılır
ID’leri ve CSRF Jetonunu Çıkar
import re

def get_review_params(product_url):
    resp = requests.get(product_url, headers=headers)
    html = resp.text
    listing_id = product_url.split("/")[-1].split("?")[0]
    shop_id_match = re.search(r'"shopId"\s*:\s*(\d+)', html)
    shop_id = shop_id_match.group(1) if shop_id_match else None
    soup = BeautifulSoup(html, "lxml")
    csrf_meta = soup.find("meta", {"name": "csrf_nonce"})
    csrf = csrf_meta["content"] if csrf_meta else None
    return listing_id, shop_id, csrf
Yorumları Sayfalayarak Kazı
def scrape_reviews(listing_id, shop_id, csrf, max_pages=5):
    session = requests.Session()
    session.headers.update(headers)
    all_reviews = []
    for page in range(1, max_pages + 1):
        payload = {
            "specs": {
                "deep_dive_reviews": {
                    "module_path": "neu/specs/deep_dive_reviews",
                    "listing_id": listing_id,
                    "shop_id": shop_id,
                    "page": page,
                }
            }
        }
        resp = session.post(
            "https://www.etsy.com/api/v3/ajax/bespoke/member/neu/specs/deep_dive_reviews",
            json=payload,
            headers={"x-csrf-token": csrf, "Content-Type": "application/json"},
        )
        data = resp.json()
        html_fragment = data.get("output", {}).get("deep_dive_reviews", "")
        review_soup = BeautifulSoup(html_fragment, "lxml")
        for card in review_soup.select("div.review-card"):
            rating_el = card.find("input", {"name": "rating"})
            text_el = card.select_one("div.wt-text-body")
            user_el = card.select_one("a[data-review-username]")
            date_el = card.select_one("p.wt-text-body-small")
            all_reviews.append({
                "rating": rating_el["value"] if rating_el else None,
                "text": text_el.text.strip() if text_el else None,
                "reviewer": user_el.text.strip() if user_el else None,
                "date": date_el.text.strip() if date_el else None,
            })
        time.sleep(random.uniform(2, 5))
    return all_reviews
Yöntem 2: Yorumları HTML’den Ayrıştır (Yedek Plan)
API yaklaşımı başarısız olursa (örneğin CSRF jetonu sorunları yüzünden), yorumların ilk sayfasını doğrudan ürün sayfası HTML’sinden ayrıştırabilirsin. Sınırlama şu: yorumların yalnızca ilk partisi statik HTML’de bulunur. Daha fazlası için API’ye ya da Selenium gibi bir tarayıcı otomasyonu aracına ihtiyacın olur.
Giriş Gerektiren Verilerle Çalışmak: Kendi Etsy Mağazanı Kazımak
Bu, başka hiçbir rehberin pek ele almadığı ama gerçekte çok ihtiyaç duyulan bir boşluk — özellikle kendi siparişlerini, gelirini ve istatistiklerini çıkarmak isteyen Etsy satıcıları için.
Sorun şu: requests tek başına Etsy panona erişemez, çünkü oturum çerezlerini taşımaz.
Seçenek 1: Manuel Giriş ve Çerez Yakalama ile Selenium
Selenium kullanarak bir tarayıcı aç, elle giriş yap (ya da giriş işlemini otomatikleştir), sonra kimlik doğrulaması yapılmış halde kazımaya devam et:
from selenium import webdriver

driver = webdriver.Chrome()
driver.get("https://www.etsy.com/signin")
# Tarayıcı penceresinde elle giriş yap, sonra:
input("Giriş yaptıktan sonra Enter'a bas...")

cookies = driver.get_cookies()
# Şimdi dashboard sayfalarına gitmek ve kazımak için driver.get() kullan
İlk girişten sonra Selenium oturumundan çerezleri kaydedip bunları requests.Session() ile yeniden kullanarak daha hızlı ve hafif kazıma da yapabilirsin.
Seçenek 2: Tarayıcı Çerezlerini Requests ile Kullanmak İçin Dışa Aktar
Aktif Etsy oturum çerezlerini dışa aktarmak için bir tarayıcı uzantısı (örneğin "EditThisCookie") kullan, sonra bunları bir Requests oturumuna yükle:
import requests

session = requests.Session()
# Tarayıcıdan dışa aktarılan çerezleri ekle
session.cookies.set("uaid", "YOUR_UAID_VALUE", domain=".etsy.com")
session.cookies.set("user_prefs", "YOUR_USER_PREFS_VALUE", domain=".etsy.com")
# ... gerektiği kadar başka oturum çerezi ekle

resp = session.get("https://www.etsy.com/your/orders", headers=headers)
Kolay Yol: Thunderbit’in Tarayıcı Kazıma Modu
Thunderbit doğrudan Chrome tarayıcının içinde çalıştığı için aktif Etsy oturumunu otomatik olarak devralır. Kimlik doğrulama kodu yok, çerez dışa aktarma yok — sadece Etsy panona git ve kazı. Siparişleri, geliri, istatistikleri ve yalnızca satıcılara açık diğer verileri hiçbir betik yazmadan çıkarmak için gerçekten kullanışlıdır.
Çektiğin Etsy Verisini Dışa Aktarma ve Kullanma
CSV veya JSON Olarak Kaydet
import pandas as pd

df = pd.DataFrame(results)
df.to_csv("etsy_products.csv", index=False, encoding="utf-8")
df.to_json("etsy_products.json", orient="records", indent=2)
En iyi uygulamalar: dosya adlarında zaman damgası kullan, UTF-8 kodlaması tercih et ve ürün adlarındaki özel karakterleri düzgün işle (Etsy satıcıları emoji ve aksanlı karakterleri sever).
Google Sheets, Airtable veya Notion’a Aktar
Python kullanıcıları için gspread (Google Sheets) ya da Airtable API gibi kütüphaneler, veriyi programatik olarak göndermeni sağlar. Ama Thunderbit kullanıyorsan; Google Sheets, Excel, Airtable ve Notion’a dışa aktarma işlemlerinin tamamı ücretsiz ve tek tıkla yapılır. API anahtarı yok, OAuth kurulumu yok.
Kodu Atla: Thunderbit ile Etsy’den Nasıl Veri Çekilir? (Kodsuz Alternatif)
Herkes Python betikleri yazmak, proxy yapılandırmalarını sürdürmek veya sabaha karşı 2’de CSS seçicileri ayıklamak istemez. Eğer sen de onlardansan, Thunderbit ile Etsy verisini nasıl alacağını şöyle özetleyebilirim.
Thunderbit Chrome Uzantısını Kur
Chrome Web Mağazası’na git ve Thunderbit’i yükle. Ücretsiz hesap oluştur — ücretsiz planda ayda 6 sayfa hakkın olur ve tüm dışa aktarımlar ücretsizdir.
Herhangi Bir Etsy Sayfasında AI Alan Önerisini Kullan
Bir Etsy arama, ürün veya mağaza sayfasına git. Thunderbit kenar çubuğunda "AI Alan Öner" seçeneğine tıkla. AI sayfayı tarar ve sütunlar önerir — ürün adı, fiyat, puan, görseller, mağaza adı, etiketler, kargo bilgisi. Gerekirse sütunları ayarla ya da yenilerini ekle.
Tıkla, Kazı ve Dışa Aktar
Geçerli sayfadaki veriyi çıkarmak için "Kazı" düğmesine tıkla. Çok sayfalı sonuçlarda Thunderbit’in sayfalama kazımasını kullan. Ürün URL’lerinden oluşan bir listeyi, her ürün sayfasından ayrıntı (açıklama, yorumlar, kargo bilgisi) ile zenginleştirmek için alt sayfa kazıma kullan — Thunderbit her bağlantıyı ziyaret eder ve ekstra veriyi otomatik olarak çeker.
Excel, Google Sheets, Airtable veya Notion’a dışa aktar — hepsi ücretsiz.
Thunderbit, Etsy Kazımada Python’a Ne Zaman Üstün Gelir?
- Proxy kurulumu veya bot karşıtı kod gerekmez. Thunderbit gerçek Chrome tarayıcısında çalışır; bu yüzden oturumunu devralır ve DataDome’a normal bir kullanıcı gibi görünür.
- AI, düzen değişikliklerine otomatik uyum sağlar. Etsy ön yüzünü güncellediğinde bozulmuş seçicileri düzeltmek zorunda kalmazsın.
- Tek seferlik araştırma, rekabet analizi veya teknik olmayan ekip üyeleri için harikadır. Hızlı bir veri seti istiyorsan Python ortamına bile ihtiyacın olmaz.
- Alt sayfa kazıma, iç içe döngüler yazmadan ürün URL listelerini ayrıntılı verilerle zenginleştirmeni sağlar.
Bir anlatım için Thunderbit YouTube kanalına göz at.
Python ve Thunderbit: 6 Aylık Maliyet Karşılaştırması
| Faktör | Kendin Yap Python | Thunderbit |
|---|---|---|
| Kurulum süresi | 8–20 saat | 5 dakikanın altında |
| 6 aylık maliyet (işçilik, proxy dahil) | $2.720–9.450 | $90–228 |
| Aylık bakım | 4–10+ saat (seçici güncellemeleri = %80+ ek yük) | 0–1 saat |
| Bot karşıtı yönetim | Normal kredi maliyetinin 85 katı maliyette residential proxy’ler | Tarayıcı tabanlı, DataDome’u doğal olarak aşar |
| Veri kalitesi | Yüksek (emekle) | Yüksek (AI destekli) |
Python yanlış seçimdir demiyorum — tam kontrol, özel mantık ya da daha büyük bir iş akışına entegrasyon gerekiyorsa kod hâlâ kraldır. Ama çoğu iş kullanıcısı yalnızca Etsy verisine ihtiyaç duyuyorsa, ROI hesabı kodsuz bir aracı daha mantıklı kılar.
Etsy Kazımada Yasal ve Etik İpuçları
Kazıma ile ilgili her yazıda benden yasallık soruluyor; kısa versiyon şu:
- Etsy’nin Kullanım Şartları otomatik erişimi açıkça yasaklar. Bununla birlikte Etsy, hukuki yaptırımdan çok teknik uygulamaya (DataDome) dayanır — kazıyıcılara yönelik bilinen Etsy-özel davalar yoktur.
- Yalnızca herkese açık verileri kazı. Kimlik doğrulamayı aşma ya da sana ait olmayan özel satıcı panolarına erişme.
- Makul istek oranları kullan. İstekler arasında 2–7 saniye bekle ve Etsy sunucularını yormamaya dikkat et.
robots.txtkurallarına uy. Etsy arama sayfalarına izin verir ama bazı yolları kısıtlar.- Kişisel verileri GDPR gibi gizlilik yasaları altında sorumlu biçimde işle.
- Ticari ölçekteki kazıma projeleri için hukuki danışmanlık al.
Daha fazla arka plan için web kazımanın hukuki etkileri yazımıza bak — public veri kazımasının onaylandığı Meta v. Bright Data (2024) davası dahil.
Kapanış: Ana Çıkarımlar
Burada epey yol kat ettik. Akılda kalmasını istediğim şeyler şunlar:
- Etsy’nin JSON-LD yapılandırılmış verisi, çoğu alan için ham HTML ayrıştırmaya göre çıkarımı daha temiz hale getirir.
- DataDome gerçek bir engeldir — Python ile büyük ölçekte kazıma yaparken uygun başlıklar, gecikmeler, çerez yönetimi ve residential proxy’ler kullan.
- Etsy API’si sınırlıdır. Yorumlara, rakip mağazalara veya satıcılar arası analize ihtiyacın varsa, pratik yol kazımadır.
- Thunderbit, bot karşıtını ve kimlik doğrulamayı doğal olarak yöneten kodsuz bir alternatif sunar — betikleri bakımda tutmadan Etsy verisi istiyorsan denemeye değer.
- Her zaman sorumlu biçimde kazı yap ve Etsy’nin şartlarına saygı göster.
Kod yazmadan başlamak istiyorsan, Thunderbit’i ücretsiz dene. Ya da bu rehberdeki Python kodunu kullanarak kendi özel kazıyıcını oluştur — ve umarım seçicilerin Cuma öğleden sonra asla bozulmaz.
Daha fazla kazıma rehberi için Etsy kazıyıcı rehberimize ve en iyi AI web kazıyıcılar derlememize göz at.
Etsy Verisini Daha Hızlı Kazımak İçin Thunderbit’i Dene Get Started Free
SSS
1. Python ile Etsy’den veri çekmek yasal mı?
Herkese açık verileri kazımak, son yasal emsallere göre genel olarak izin verilir (ör. Meta v. Bright Data, hiQ v. LinkedIn). Ancak Etsy’nin Kullanım Şartları otomatik erişimi yasaklar; bu yüzden kazımadan önce mutlaka ToS ve robots.txt dosyasını incele. Büyük ölçekli veya ticari kullanım için hukuki danışmanlık al.
2. Engellenmeden Etsy’den veri çekebilir miyim?
Etsy, en zorlu bot karşıtı sistemlerden biri olan DataDome’u kullanır. Gerçekçi başlıklar, istek gecikmeleri, çerez kalıcılığı ve residential proxy dönüşümü engellenme riskini azaltır. Thunderbit’in tarayıcı yerel yaklaşımı, gerçek Chrome oturumunda çalıştığı için tespitin çoğunu aşar.
3. Kazıma yerine kullanabileceğim bir Etsy API’si var mı?
Evet — Etsy API v3 sunuyor, ancak çoğunlukla kendi mağazanıza ait verilerle sınırlı ve yorum erişimi güçlü değil. Rekabet istihbaratı ve mağazalar arası analiz kullanım senaryolarının çoğu kazıma gerektirir.
4. Etsy’yi kazımak için hangi Python kütüphanelerine ihtiyacım var?
En azından: requests, beautifulsoup4, pandas (dışa aktarma için) ve json (yerleşik). JS ağırlıklı veya giriş gerektiren sayfalar için selenium ekle. Daha hızlı HTML ayrıştırma için lxml kullan.
5. Etsy yorumlarını özellikle nasıl kazırım?
Etsy yorumları dahili bir API uç noktası üzerinden yüklenir (/api/v3/ajax/bespoke/member/neu/specs/deep_dive_reviews). Ürün sayfasından ilan ID’sini, mağaza ID’sini ve CSRF jetonunu çıkarman, ardından sayfalama ile bu uç noktaya POST atman gerekir. Yedek olarak, yorumların ilk partisini ürün sayfası HTML’sinden ayrıştırabilirsin — her iki yaklaşım da bu rehberde adım adım anlatılıyor.
Daha Fazla Bilgi



