
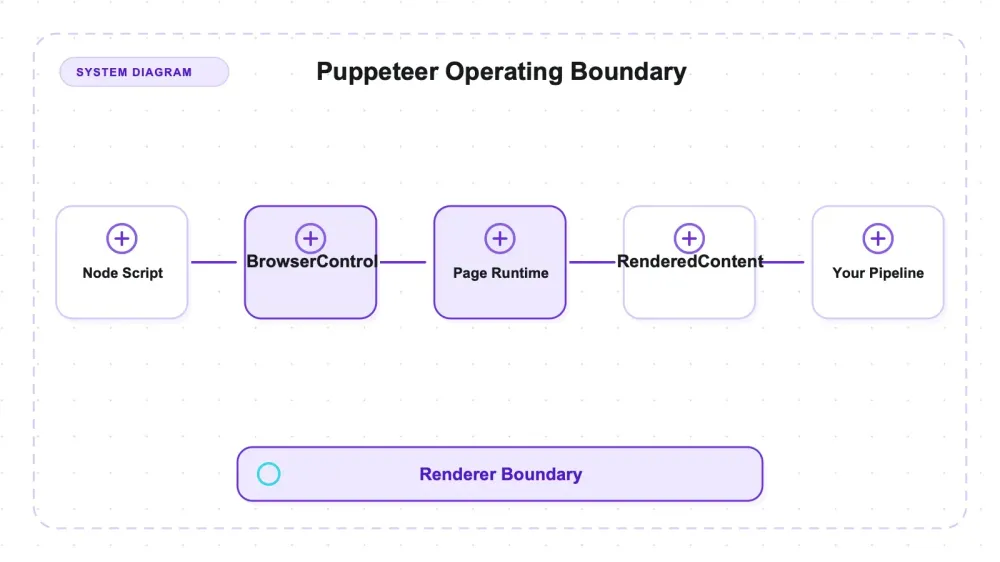
Puppeteer, Google’ın JavaScript üzerinden gerçek bir Chrome’u kontrol etmeye yarayan Node kütüphanesidir — otomasyonu siz yazarsınız, komutları Chrome DevTools Protocol taşır ve siz tek bir byte okumadan önce sayfayı tam bir tarayıcı işler. GitHub’daki adresi puppeteer/puppeteer: Apache-2.0 lisanslı, TypeScript ile yazılmış ve snapshot’ı aldığım gün yaklaşık 95,3 bin yıldıza sahipti (95.307). Resmî konumlandırması bilerek dar tutulmuş: "Chrome’u (ve deneysel olarak Firefox’u) kontrol etmek için bir JavaScript API" — bu da size ne olduğunu, en az onun kadar önemli biçimde, ne olmadığını söylüyor.
Puppeteer 24.16.0 sürümünü, her tarayıcı otomasyon kütüphanesinde kullandığımız aynı fixture sunucusu ve herkese açık demo sitelerinde denedim: sayfalı statik bir katalog, bir makale, JavaScript ile render edilen bir katalog, bir JSON API, 500 dönen bir rota, küçük bir crawl grafiği, ayrıca Books to Scrape ve Quotes to Scrape. Yaptığı render işi tertemiz ve gösterişsizdi. Fakat masama da tam olarak tek bir iş bıraktı — tıpkı her headless tarayıcı kütüphanesinin bıraktığı iş gibi — ve bu boşluğu dürüstçe anlatmak, faydalı bir incelemeyi basın bülteninden ayıran ana şeylerden biri.
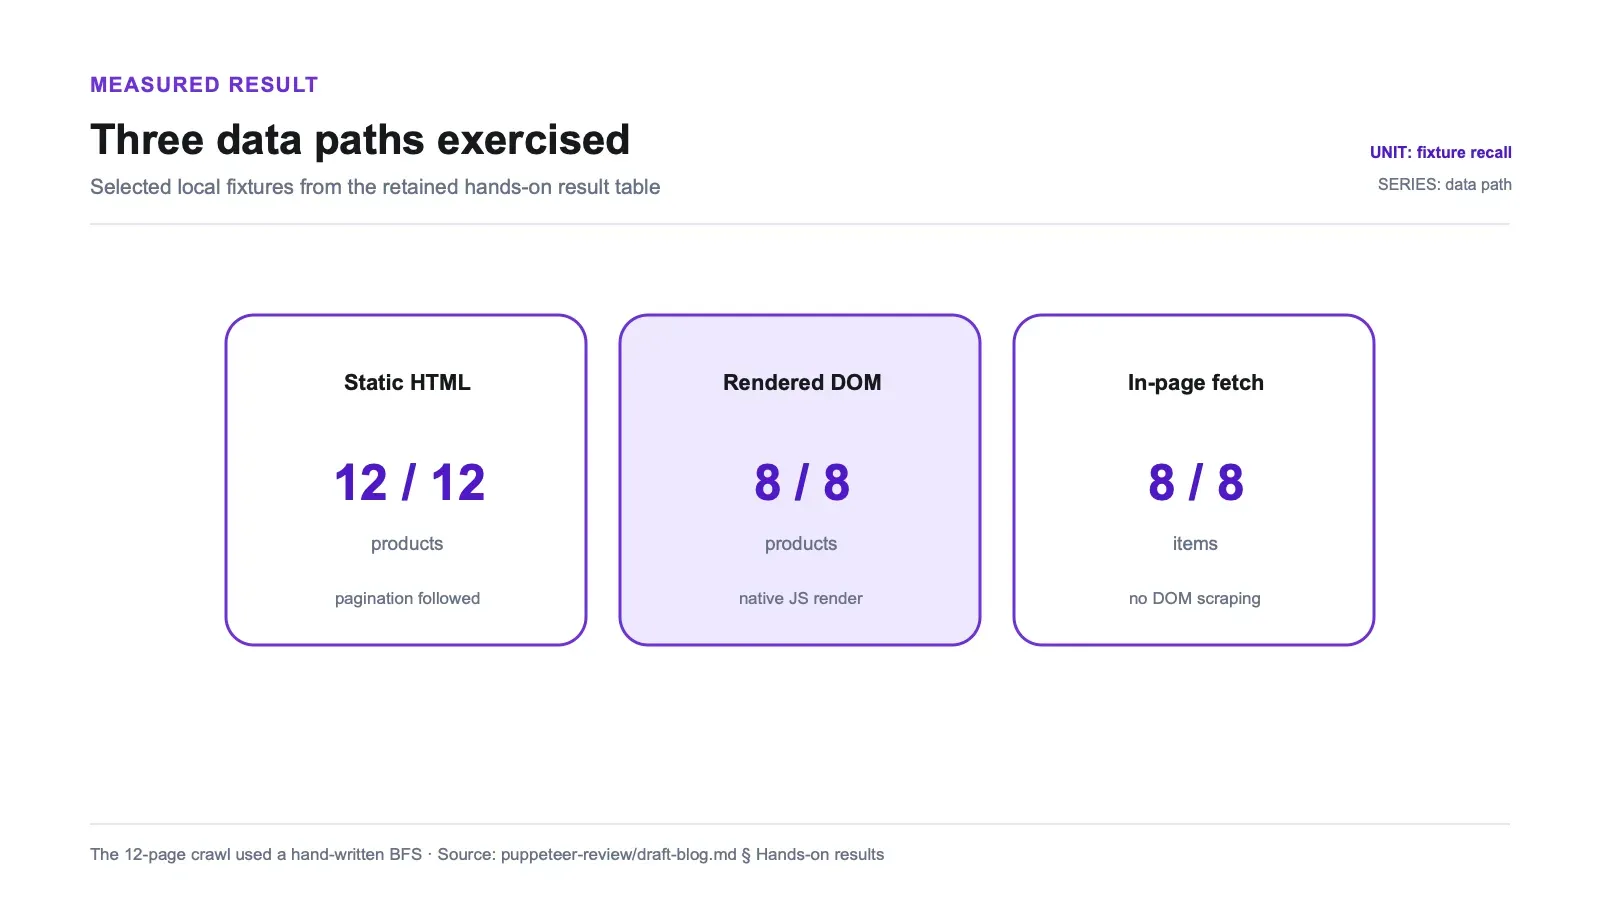
Sonuç tablosundan daha fazla dikkat çeken tek sayı, geri çağırma oranı değildi. Verileri bir JSON uç noktasından gelen bir sayfada Puppeteer, DOM’u hiç kazımadan 8 kaydın tamamını çekti — sayfanın içinde fetch çalıştırdı ve yanıt nesnesini doğrudan okudu. Bu, çalışan ekran görüntüleriyle birlikte yerel render desteğiyle birleşince, aracın karakterini net biçimde gösteriyor: olgun bir Chrome render motoru, bir crawler çatısı değil; ve bu ayrım, tek satır kod yazmadan önce önem taşıyor.
Puppeteer aslında nedir? (ve hangi araçlarla yarışır?)
Kategori adı burada gerçekten iş görüyor; o yüzden oradan başlayalım. Puppeteer bir tarayıcı otomasyon kütüphanesidir. Chrome’u başlatır, sayfaları açar, sayfanın JavaScript’inin çalışmasına izin verir ve render edilmiş sonucu okumanız ya da ekran görüntüsü almanız için size teslim eder. HTTP istemcisi artı HTML ayrıştırıcı yerine onu seçmenizin sebebi tam olarak budur: sunucunun ilk gönderdiği boş kabuk değil, script’ler çalıştıktan sonraki sayfayı istersiniz.
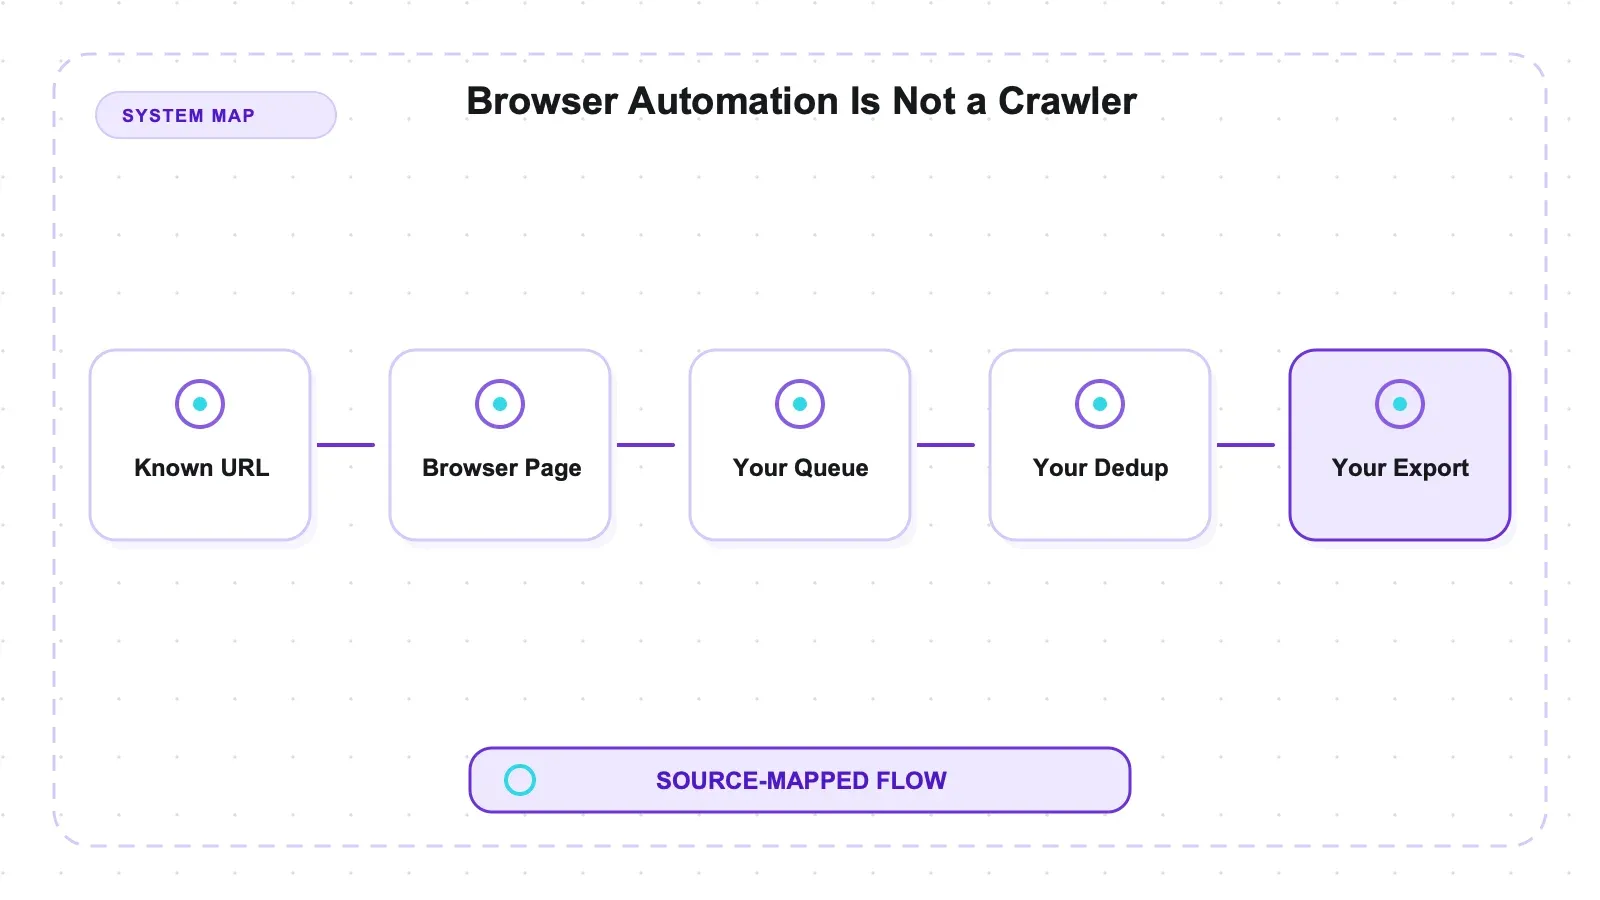
Yapı olarak, Scrapy gibi crawler çatılarından ya da LLM-Markdown araçlarından ziyade Playwright ve Selenium gibi gerçek tarayıcı kütüphaneleriyle yarışır. Eğer Puppeteer’a binlerce URL verir ve bunları sıraya almasını, yinelenenleri ayıklamasını, nazikçe hız sınırlaması uygulamasını ve bir veri seti yazmasını beklerseniz, bir render motorunu crawling problemine getirmiş olursunuz. Her sayfayı güzelce render eder ama orkestrasyonu yapmaz. (Bu bir kusur değil, kapsam sınırıdır — buna geri döneceğim, çünkü aracı benimsemeden önce içselleştirilmesi gereken en önemli nokta bu.)
Puppeteer, Google’ın Chrome ekibinden çıktı. Bu yüzden tasarım gereği Chrome-odaklıdır ve API’si, tarayıcının kendi hata ayıklama protokolünün üzerine geçirilmiş ince, eprimiş bir eldiven gibi okunur. Yaşı, iyi anlamda sıkıcı olacak kadar eskidir: ihtiyacınız olan yöntemler yıllardır stabildir, dokümantasyon kapsamlıdır ve çevresindeki ekosistem olgunlaşmıştır.
Yerel render ve sayfa içi fetch kalıbı
Gerçek kullanım şeklini belirlediği için sonuç tablosundaki iki davranışı özellikle ayırmak gerekiyor.
İlki, yerel render. Yüklendikten sonra ürün ızgarasını istemci tarafında oluşturan JavaScript destekli katalog 8/8 döndü ve tam sayfa ekran görüntüsü diske kaydedildi. Kurulum minimaldi ama goto sonrasında hedef içerik için bekleme içeriyordu. Public Quotes to Scrape JS sayfası da aynı kalıpla on alıntının tamamını verdi. Bunlar fixture sonucu; genel bir render geri çağırma puanı değil.
İkincisi, JSON-API fixture’ı ürünleri /api/dynamic-products üzerinden yükledi. page.evaluate içinde aynı origin’e ait bir fetch çalıştırmak, render edilmiş satırları ayrıştırmadan sekiz kaydın tamamını döndürdü. Bu, Puppeteer’a özgü bir keşif özelliği değil, genel bir tarayıcı değerlendirme kalıbıdır. Uç nokta ve istek sözleşmesi biliniyorsa çıkarmayı basitleştirebilir; ancak kimlik doğrulama başlıkları, çalışma anı token’ları, izin politikaları, CORS/CSP, service worker’lar ve sayfalama yine uygulama isteğini farklılaştırabilir.
Taşımanız gereken üçüncü şey sayı değil, çerçevedir: Puppeteer olgun bir Chrome render motorudur ve bir crawler değildir. İkisinin de doğru olması mümkündür; yazılarda çoğu zaman atlanan kısım ikinci yarıdır.
Puppeteer Chrome ile nasıl konuşur?
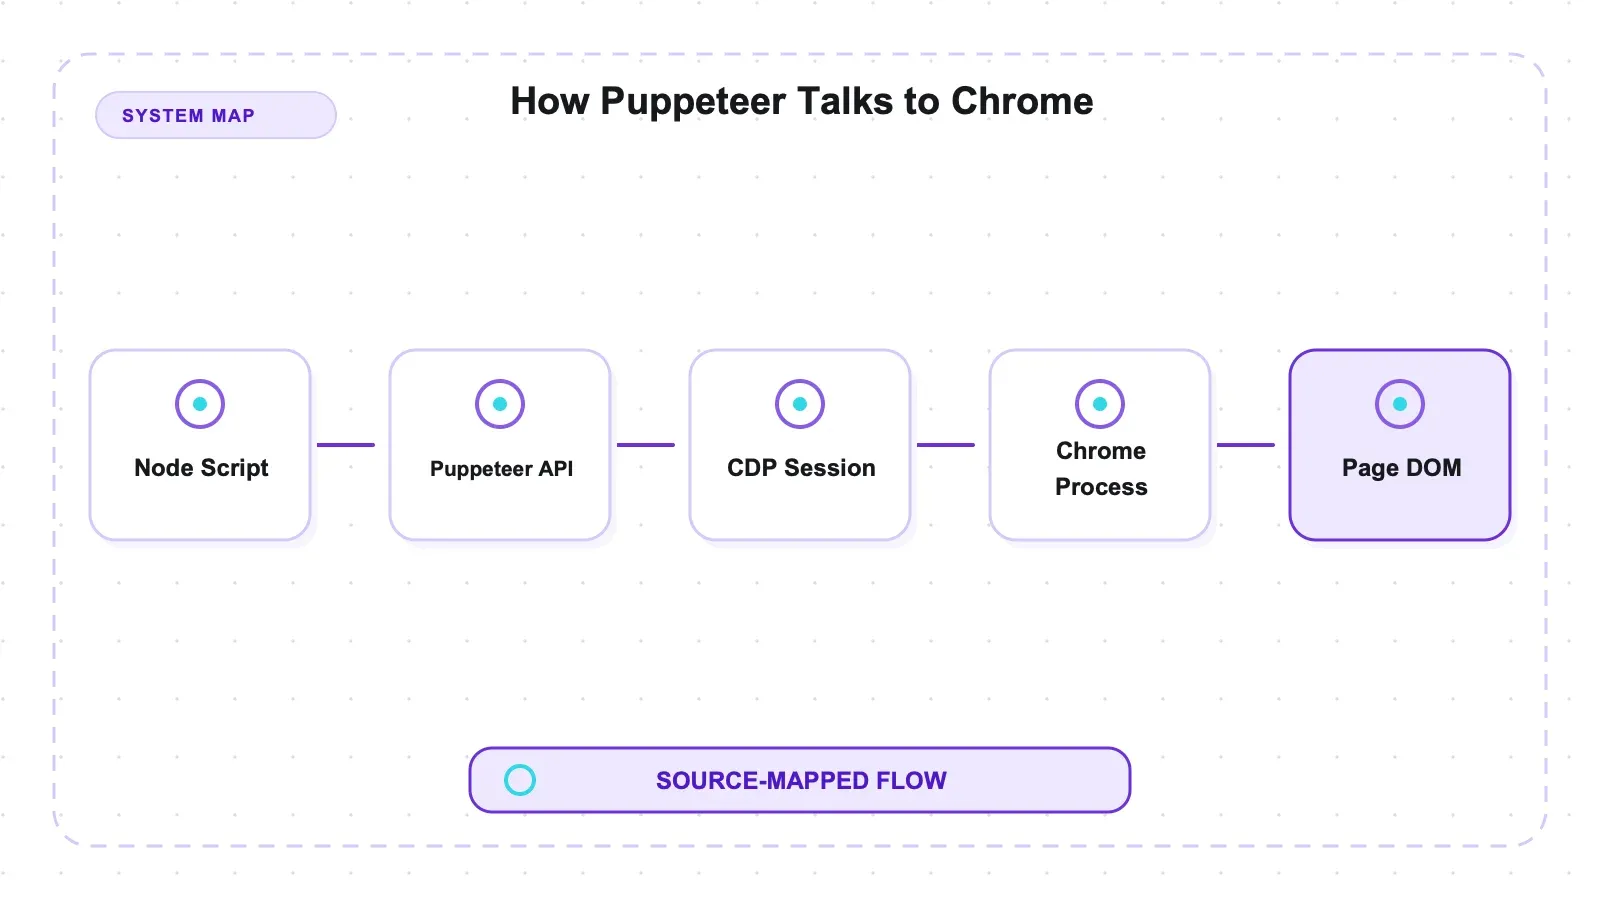
Chrome tarafında Puppeteer, tarayıcı geliştirici araçlarının kullandığı JSON-over-WebSocket kanalı olan Chrome DevTools Protocol (CDP) üzerinden çalışır. puppeteer.launch() Chrome’u başlatır ve bu protokol bağlantısını açar; goto, $$eval ve screenshot gibi çağrılar tarayıcı işlemlerini daha üst seviye bir API üzerinden sunar. Firefox desteği aşağıda anlatılan WebDriver BiDi yolunu izler; dolayısıyla Puppeteer’daki her işlem evrensel bir CDP komutu değildir.
page.evaluate, bir fonksiyonu sayfa bağlamında çalıştırır; bu yüzden göreli bir fetch('/api/...'), o sayfanın origin’ini kullanır ve uygunsa çerezleri ile oturum durumunu yeniden kullanabilir. Ancak uygulamanın oluşturduğu yetkilendirme başlıklarını, istek seçeneklerini, token’ları veya service worker davranışını otomatik olarak kopyalamaz. Aynı origin üzerindeki bu fixture’da JSON’u doğrudan döndürdü; üretim isteklerinde gerçek sözleşmenin incelenmesi gerekir.
Puppeteer’ın ağır hissettirmesinin sebebi de budur. Her sayfa, arkasında gerçek bir render motoru çalışan gerçek bir tarayıcı sekmesidir. Bu, JavaScript ağırlıklı sayfalarda doğruluk kazandırır; fakat yalnızca HTTP ile veri çekmeye kıyasla bellek ve başlatma süresi maliyeti getirir. Bedava render yoktur; CDP sadece faturayı okunur hale getirir.
Motor meselesi, doğrudan anlatımıyla
Puppeteer için sık kullanılan kısa tanım "Chrome-only" ifadesidir. Test ettiğim sürüm için bu yanlıştır ve doğru versiyonu bilmek karşılaştırmayı değiştirir.
| Motor | Puppeteer 24.16.0 onu nasıl çalıştırıyor | Bu testlerde denendi mi |
|---|---|---|
| Chrome | CDP üzerinden Chrome-odaklı — varsayılan seçenek, bu yüzden mevcut otomasyonlar çalışmaya devam eder | evet |
| Firefox | v23 sürümünden beri WebDriver BiDi üzerinden belgelenmiş destek | hayır |
| WebKit | Hiç çalıştırılmıyor | — |
Hem Chrome for Developers hem de Mozilla Firefox desteği geçiş yaptığı anda bunu duyurdu. Çalıştırdığım 24.16.0 sürümü v23’ün epey üzerinde; dolayısıyla "Chrome-only" demek kutuda gelen desteği küçümsemek olur. WebKit yokluğu ve çapraz motor hikâyesinin Playwright’a kıyasla daha genç olması, gerçek kapsam farkıdır — "bir motor üç motor" meselesi değil.
Firefox/BiDi yolu belgelenmiş durumda ve test ettiğim sürümde kullanılabilir; ancak fixture’larımı bu yol üzerinden çalıştırmadım. Bu yüzden ölçüm değil, kabiliyet bildiriyorum. Hedefleriniz için Firefox render’ı kritikse, kendi sayfalarınızda canlıya almadan önce doğrulamanız gerekir. Motor ve dil kapsamı açısından tam karşılaştırmayı görmek isteyenler için Playwright-vs-Puppeteer karşılaştırmamız iki kütüphaneyi de aynı testlerden geçirip "hangisi" sorusunu orada netleştiriyor; burada konu yalnızca Puppeteer.
Kurulum ve yükleme gerçeği: asıl ağır parça tarayıcıdır
Varsayılan npm install puppeteer yolu, uyumlu bir Chrome for Testing sürümünü indirir. Bu davranış yapılandırmayla atlanabilir ya da başka bir yöne çevrilebilir; ayrıca kullanıcılar Puppeteer’ı farklı bir çalıştırılabilir dosyaya işaret edebilir, bu yüzden sürüm eşleşmesi dağıtım tercihine bağlıdır. Bu kurulumun en ağır kısmı tarayıcı indirmesiydi; paket yöneticisi denetim özetini kalıcı bir güvenlik özelliği olarak değerlendirmiyorum.
Bu otomatik paketleme hem gerçek bir kullanım kolaylığı hem de gerçek bir boyut maliyetidir; iki tarafı da adlandırmak gerekir. Kazanç: uyumlu tarayıcı aramaz, sürümleri elle kilitlemezsiniz; npm install size çalışan bir ikili verir. Maliyet: bir tarayıcı indiriyorsunuz; bu yüzden özellikle önbelleksiz CI ortamlarında disk ve bant genişliği bütçesi ayırmanız gerekir.
Bu, Playwright ile de gerçek bir karşıtlık oluşturur: Playwright iki adımı ayırır — önce kütüphaneyi kurarsınız, sonra ayrı bir npx playwright install komutuyla tarayıcı sürümlerini çekersiniz. Hiçbiri zor değildir; sadece farklı şekillerde sürpriz yapar. Puppeteer’ın tek komutu, kota sınırlı bağlantıda boyutuyla sizi şaşırtabilir; Playwright’ın ikinci adımı ise unutulduğu için sürpriz olabilir. Hangisini çalıştırdığınızı bilin.
Uygulamalı sonuçlar
Tüm testler, Node v22.22.3, macOS arm64, Puppeteer 24.16.0 ve paket içi Chrome ile birlikte 127.0.0.1 üzerindeki yerel fixture sunucusu ve iki herkese açık pratik siteye karşı çalıştırıldı. Her fixture için gerçek sonuçlar çalıştırmadan önce not edildi; böylece geri çağırma, Puppeteer’ın o anda ne yazdığına değil, sabit bir beklenen kümeye göre ölçüldü.
Açık araştırma paketi fixture sunucusunu, test çalıştırıcısını ve gerçek veriyi içeriyor. Sıkı güvenlik incelemesi bağımlılık kilidi verilerini ve ortama özgü uç nokta materyallerini reddettiği için, bağımlılık kilidi ve ham çalıştırma özeti yayın paketinden bilerek çıkarıldı. Güvenli yerel fixture’ı yeniden üretmek için tools/puppeteer/tests içinde önce npm install, ardından node run_puppeteer_material_tests.mjs çalıştırın ve sonucu yayınlanan gerçek veriyle karşılaştırın. Herkese açık demo sayfaları değişebileceğinden, beklenen sayı kontrolleri için sağlam temel yerel fixture’dır.
Tam tarihsel bağımlılık yeniden oluşturması için, yayımlanmamış bir kilidi kamuya açık kanıt gibi kabul etmek yerine yerelde yeni bir lockfile oluşturup denetleyin.
| Test | Hedef | Sonuç |
|---|---|---|
| Statik katalog + sayfalama | yerel fixture | 12/12, geri çağırma 1.0 |
| Makale çıkarımı | yerel fixture | başlık + 3/3 paragraf, boilerplate ayrıldı |
| Dinamik JS sayfası (yerel render) | yerel fixture | 8/8, geri çağırma 1.0, tam sayfa ekran görüntüsü kaydedildi |
Dinamik JSON API (sayfa içi fetch) | yerel fixture | 8/8, geri çağırma 1.0, DOM kazıma yok |
| HTTP 500 işleme | yerel fixture | 500 durumu incelenebilir, hata fırlatmadı |
| Crawl grafiği (elle yazılmış BFS) | yerel fixture | 12 sayfa, derinlikler {0:1, 1:4, 2:7} |
| Books to Scrape | herkese açık demo | 20 ürün |
| Quotes JS | herkese açık demo | 10 alıntı, yerel olarak render edildi |
Bunlardan birkaçını tabloya bakıp geçmemek gerekiyor.
Elle yazılmış sayfalama kodu, beklenen 12 katalog öğesinin tamamını kurtardı. Makale seçicisi başlığı ve beklenen üç gövde paragrafını geri getirdi; çevredeki boilerplate DOM’da erişilebilir kaldı. Puppeteer render edilmiş DOM’u sağladı, ancak makale içeriği sayılan şeyi Puppeteer değil, seçici mantığı belirledi.
Test edilen HTTP 500 rotasında goto, incelenebilir bir 500 durumuna sahip bir response nesnesi döndürdü ve hata fırlatmadı. Bu, timeout’lar, DNS hataları, tarayıcı çökmesi, ayrılmış çerçeveler ya da diğer gezinme hataları hakkında bir şey söylemez; onlar için yine açık işleme ihtiyacı vardır.
Crawl grafiği tüm hikâyeyi anlatan test oldu. Fixture’ın iç bağlantıları üzerinde 12 sayfa gezmek, URL’leri yeniden ziyaret etmemek için derinliği izlemek, elle yazılmış bir breadth-first search gerektirdi — çünkü Puppeteer’ın yerleşik bir crawl kuyruğu yok. {0:1, 1:4, 2:7} derinlikleri boyunca 12 sayfanın tamamını buldu; yani BFS’im çalıştı. Ama BFS bana aitti. Puppeteer her sayfayı render etti; siteyi dolaşma mantığı ise benim yazdığım koddu. On iki sayfa için bu, bir düzine satır ve önemsizdir. Binlerce URL, dedup, yeniden deneme ve nazik gecikmelerle birlikte geldiğinde ise o bir düzine satır bir projeye dönüşür.
Tekrar vurgulamak istediğim bir uyarı var, çünkü suistimal edilmesi kolay: artefaktlar test başına süreler içeriyor, ama bunlar tek çalıştırma, tek makine gözlemleridir; benchmark değildir. Tek bir dizüstü bilgisayar ve tek bir çalıştırma ile Puppeteer’ın hızını başkalarıyla kıyaslamıyorum. Sayıları destekleyen şey, sekiz farklı sayfa türü boyunca geri çağırma ve davranıştır — kronometre iddiası değil.
Test etmediklerim
Sonuçların olduğundan geniş okunmaması için, test çalıştırmasının dışında kalan ve dolayısıyla bu sayıların dışında kalan şeyler şunlar:
| Test çalıştırmasının dışında | Durum |
|---|---|
| WebDriver BiDi üzerinden Firefox | Belgelenmiş, 24.16.0’da mevcut, burada çalıştırılmadı |
| Proxy ve istek yakalama | Test edilmedi; ikisi de desteklenen özellikler, ama ben çalıştırmadım |
| Paralel sayfa ölçeği | Küçük ölçekte çalıştım; gerçek eşzamanlılık altında tarayıcı filosu davranışı ölçülmedi |
| En son sürümde yeniden çalıştırma | 24.16.0’ı test ettim; npm latest, 2026-07-09 itibarıyla tam bir ana sürüm ileride olan 25.3.0. Kullandığım API’ler (launch, goto, $$eval, screenshot, sayfa içi fetch) 24→25 arasında stabildir; fakat dürüst olan, tam sayılara güvenmeden önce 25.3.0 üzerinde yeniden çalıştırmaktır |
Bunların hiçbiri eksi puan değil. Bunlar, tek bir fixture çalıştırmasının dürüstçe iddia edebileceği sınırlar.
Artılar ve eksiler
Artılar:
- Açıkça içerik bekleyen yerel JavaScript render’ı: dinamik fixture’da 8/8 ve herkese açık demoda on alıntının tamamı, ekran görüntüleriyle birlikte.
- Elle yazılmış sayfalama ve makale seçicileri beklenen fixture öğelerini geri getirdi.
- Sayfa içi
fetch, bilinen aynı-origin uç noktadan DOM ayrıştırması olmadan sekiz kaydın tamamını döndürdü. - Test edilen HTTP 500, hata fırlatmadan incelenebilir bir yanıt olarak geldi.
- Varsayılan kurulum, uyumlu bir Chrome for Testing sürümü indirir; alternatif çalıştırılabilir ve indirmeyi atlama yapılandırmaları da mümkündür.
- CDP üzerinde olgun, Chrome odaklı bir API; derin ekosistem ve kapsamlı dokümantasyon. Apache-2.0.
- Ününden daha geniş: v23’ten beri WebDriver BiDi üzerinden belgelenmiş Firefox desteği.
Eksiler:
- Yerleşik crawl kuyruğu, veri seti yazıcısı veya hız sınırlayıcı yok — crawl ölçeği için kendi kodunuz ya da bir sarmalayıcı gerekir.
- WebKit motoru yok ve çapraz motor hikâyesi Playwright’a göre daha genç.
- Gerçek tarayıcı ağırlığı: indirilmesi gereken paketlenmiş bir Chrome ve HTTP tabanlı araçlara kıyasla sayfa başına bellek maliyeti.
- Node tabanlı; başka bir dilden kullanmak istiyorsanız bir köprü kurup sürdürmeniz gerekir.
- Çalıştırdığım sürüm (24.16.0), npm latest (25.3.0) karşısında bir ana sürüm geride — kesin rakamlara güvenmeden önce güncel sürümde yeniden doğrulayın.
Kimin için uygun, kimler geçmeli?
Node üzerinde çalışıyorsanız, hedefleriniz Chrome’da sorunsuz render oluyorsa (çoğu oluyor) ve "JavaScript çalıştıktan sonraki sayfa"yı okunabilir ve ekran görüntüsü alınabilir hale getiren olgun, odaklı bir kütüphane istiyorsanız Puppeteer’a yönelin. Dinamik sayfalar topluluğunu kazımak, sayfanın kendi oturumuyla bir JSON API çekmek ya da render edilmiş ekran görüntülerini kanıt olarak almak için güçlü ve sorunsuz bir varsayılandır. Firefox/BiDi seçeneği büyüdükçe oraya da geçebilirsiniz; ekosistem sayesinde karşılaştığınız sorunların çoğu daha önce de yaşanmıştır.
Sorununuz render değil de crawl orkestrasyonu ise iki kere düşünün. Yüzlerce ya da binlerce URL’yi dedup, yeniden deneme ve hız sınırlarıyla gezmeniz gerekiyorsa, yalnızca Puppeteer sizi elle bir crawler yeniden yazmaya zorlar — bu onun doğru çalışma yüksekliği değildir. Veriniz JavaScript olmadan da görünüyorsa headless tarayıcıyı tamamen bırakın; HTTP isteği ve ayrıştırıcı içeriği veriyorsa gerçek tarayıcı pahalı bir fazlalıktır, sadece bellek ve kurulum süresi yakar. WebKit doğruluğu ya da JavaScript olmayan bir dil istemcisi gerekiyorsa, bu eksende doğru araç bu değildir.
Alternatifler ve Thunderbit’in yeri
Önce dürüst çerçeve: Puppeteer ücretsizdir, Apache-2.0 lisanslıdır, kendi kendinize barındırırsınız ve çalıştırmanın her parçası size aittir — tarayıcı filosu, üzerine eklediğiniz crawl kodu ve devam eden anti-bot silahlanma yarışı. Birçok proje için bu sahiplik tam isabetlidir ve hiçbir yönetilen servis, zaten elinizde olan bir tarayıcıdan daha ucuza yetkili bir sayfayı render edemez.
Açık kaynak içinde işe yarayan karşılaştırma, logoya göre değil işe göre yapılır. Özellikle crawl ölçeğinde, Crawlee doğal eşlikçidir: PuppeteerCrawler, Puppeteer’ın bilerek dışarıda bıraktığı request queue, dataset ve throttling katmanını sarar; böylece render’ı korur, orkestrasyonu eklersiniz. Çıktı hedefiniz render edilmiş DOM değil de bir LLM hattı için temiz Markdown ise, Crawl4AI gerçek bir tarayıcı çalıştırır ve tam da bunu üretir. Sayfalarınızın tarayıcıya ihtiyacı yoksa, Scrapy gibi HTTP-odaklı bir çatı bambaşka ve daha hafif bir kategoridir. Bunların birkaçını aynı anda tartıyorsanız, open-source scraper roundup yazımız kategorileri yan yana koyuyor.
Thunderbit gibi yönetilen bir servis, tarayıcı işletimini ve veri çıkarmayı bir API’nin arkasına taşır. Bu testlerde Puppeteer fixture’ları üzerinden çalıştırılmadı; dolayısıyla bu inceleme, render, engellenme, çıkarım kalitesi ya da maliyet hakkında eşleşen bir iddiada bulunmaz. Karar sınırı operasyonel sahipliktir: tarayıcı ve crawl kodunu kendiniz mi yöneteceksiniz, yoksa bu katmanın bir kısmını bir sağlayıcıya mı ödeyeceksiniz?
Puppeteer’da tedarikçi kullanım ücreti yoktur; ancak hesaplama gücü, bant genişliği, tarayıcı bakımı, orkestrasyon ve operasyon size kalır. Yönetilen yol kullanım üzerinden ücretlendirir ve bu sorumluluğun bir kısmını sağlayıcıya kaydırır. Bu deneyim sonuçları karşılaştırmadı.
Web Veri Çıkarma için Thunderbit’i Deneyin
Karar
Puppeteer 24.16.0, Node üzerinde çalışıyor ve Chrome-odaklı tarayıcı otomasyonuna ihtiyaç duyuyorsanız değerlendirmeye değer. Elle yazılmış fixture kodu 12 statik öğeyi, sekiz dinamik öğeyi ve on herkese açık demo alıntısını geri getirdi; bilinen aynı-origin API, page.evaluate üzerinden sekiz kayıt döndürdü; ekran görüntüleri çalıştı; test edilen HTTP 500 ise incelenebilir kaldı. Bu sonuçlar, isimli fixture’lara ve eski bir ana sürüme aittir; genel çıkarım geri çağırmasına değil.
Ama iddiaları doğru ölçeklendirin. Puppeteer bir render motorudur, crawler değildir: 12 sayfalık gezinti için elle yazılmış BFS gerekiyordu çünkü yerleşik kuyruk yok; ölçek büyüdüğünde bu boşluk gerçek iştir — işi Crawlee’ye bırakın ya da mekanizmayı kendiniz yazın. CDP üzerinden Chrome-odaklıdır, WebDriver BiDi ile belgelenmiş Firefox desteği vardır ama WebKit yoktur; yani çapraz motor genişliği için doğru araç değildir. Gerçek bir tarayıcının ağırlığını taşır. Ve ben 24.16.0 sürümünü 25.3.0 latest’e karşı test ettim; bu yüzden kesin rakamlara güvenmeden önce güncel sürümde yeniden çalıştırın. Bu dört gerçeği baştan kabul ederseniz, Puppeteer mükemmel bir Chrome otomasyon kütüphanesidir. Siz ondan sitenizi sizin için crawl etmesini beklerseniz, aslında indirdiğinizi sandığınız crawler’ı kendi ellerinizle yazmaya başlarsınız.
Web Veri Çıkarma için Thunderbit’i Deneyin Get Started Free
SSS
Puppeteer JavaScript sayfalarını render eder mi, yoksa eklenti mi gerekir?
Evet, yerel olarak render eder; eklenti gerekmez. Dinamik fixture’ımda istemci tarafında oluşturulmuş 8 ürünün 8’ini de 1.0 geri çağırma ile döndürdü ve tam sayfa ekran görüntüsü aldı; public Quotes to Scrape JS sayfası da aynı şekilde 10 alıntının tamamını verdi — sıradan bir goto, sonra render edilmiş DOM’u okuma. Puppeteer, DevTools Protocol üzerinden gerçek bir Chrome çalıştırdığı için, bir şey okumadan önce sayfanın script’leri gerçekten çalışır.
Puppeteer HTML ayrıştırmadan bir JSON API’yi kazıyabilir mi?
Evet, uç nokta ve istek sözleşmesi buna izin veriyorsa. page.evaluate, sayfanın origin’inden istek gönderebilir ve uygunsa çerezleri yeniden kullanabilir; fakat uygulama başlıklarını, token’ları, seçenekleri ya da service worker davranışını otomatik olarak kopyalamaz. Aynı-origin fixture’da DOM ayrıştırması yapmadan sekiz kaydın tamamını döndürdü.
Puppeteer bir web crawler mıdır? Hayır — bir tarayıcı otomasyon kütüphanesidir, crawler çatısı değildir. Yerleşik request queue, dataset writer veya throttle yoktur; bu yüzden 12 sayfalık crawl’um (derinlikler {0:1, 1:4, 2:7}) elle yazılmış bir breadth-first search gerektirdi. Bu bir kapsam sınırıdır, kusur değil. Crawl ölçeği için, onu Crawlee’nin PuppeteerCrawler’ı gibi bir sarmalayıcıyla eşleştirin; o, Puppeteer’ın bırakıp gittiği kuyruk ve dataset mekanizmasını ekler.
Puppeteer yalnızca Chrome için mi? Artık değil. CDP üzerinden Chrome-odaklıdır, ancak v23’ten beri WebDriver BiDi ile belgelenmiş Firefox desteğine sahiptir ve test ettiğim sürüm (24.16.0) bunun epey ötesindedir. Çalıştırmadığı motor WebKit’tir ve çapraz motor hikâyesi Playwright’tan daha gençtir — doğru sınırlama "Chrome-only" değil, budur. Burada yalnızca Chrome’u denedim; bu yüzden Firefox/BiDi desteğini ölçülmüş bir sonuç olarak değil, belgelenmiş bir kabiliyet olarak aktarıyorum.
Puppeteer kurulunca gerçekte ne indiriliyor?
Varsayılan olarak npm install puppeteer, uyumlu bir Chrome for Testing sürümü indirir. İndirme atlanabilir veya başka bir yöne çevrilebilir; farklı bir çalıştırılabilir de yapılandırılabilir, bu yüzden sürüm eşleşmesi dağıtım tercihine bağlıdır. Özellikle önbelleksiz CI çalıştırıcılarında, tarayıcı için disk ve bant genişliği bütçesi ayırın. Bu inceleme 24.16.0’ı test etti; yayın anındaki sürüm üzerinde çekirdek fixture’ları yeniden çalıştırın.




