
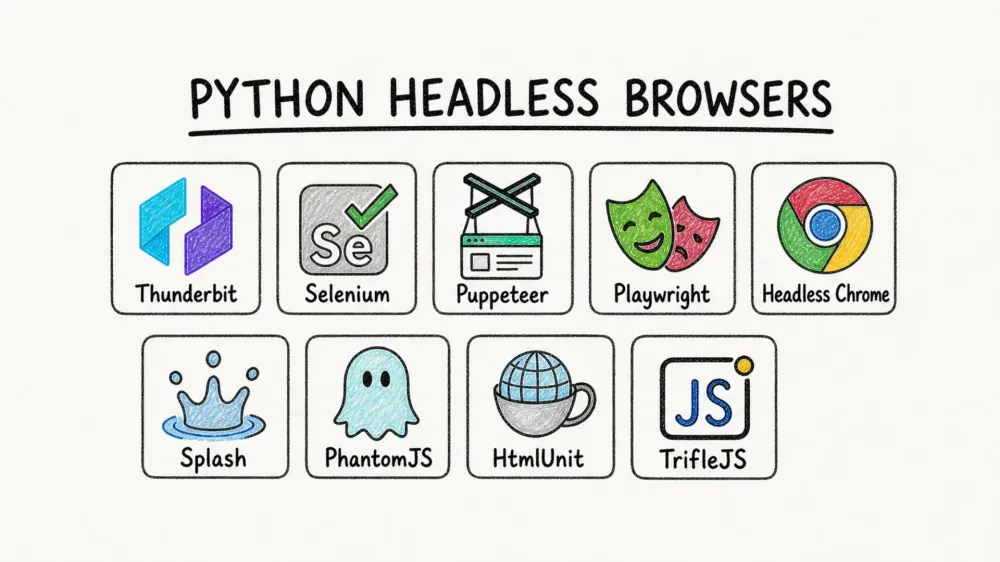
Web, sürekli değişen vahşi bir alana dönüştü—artık “dijital kütüphane”den çok “veri ormanı” gibi. 2026’da modern sitelerden veri çekmeye çalışıyorsanız, yalnızca JavaScript duvarıyla değil, adeta bir kaleyle karşı karşıyasınız. Geleneksel scraping araçlarının dinamik içerik, sonsuz kaydırma ve anti-bot kalkanları karşısında nasıl zorlandığını bizzat gördüm. Bu yüzden python headless browser yükselişi sadece bir trend değil; güvenilir ve ölçeklenebilir web verisi çekmeye ihtiyaç duyan herkes için tam anlamıyla bir devrim.
Ve bu konu sadece geliştiricileri ilgilendirmiyor. 2025 itibarıyla şirketlerin %73’ü iş zekâsı için otomatik web veri çekimine güveniyor, ayrıca web sitelerinin %94’ünden fazlası artık istemci taraflı JavaScript render’ına dayanıyor. İster satışta, ister e-ticarette, ister operasyon tarafında olun; doğru python headless browser, “veri elimizin altında” ile “veri ulaşılamaz” arasındaki farkı yaratır. O yüzden laf kalabalığını bir kenara bırakalım—bu araçları test ettim, karşılaştırdım, günlük kullanımda deneyimledim. Şimdi de modern scraping için en iyi 10 python headless browser’ı (ve AI’ın kod yazmayanlar için oyunu nasıl değiştirdiğini) net biçimde anlatacağım.
Modern Veri Çekimi İçin Python Headless Browser Neden Bu Kadar Önemli?
AI kullanarak herhangi bir web sitesinden veri çekin Get Started Free
Önce terimi sadeleştirelim: python headless browser, Python koduyla kontrol ettiğiniz bir web tarayıcısıdır; farkı, ekranda açılan ağır pencerenin görünmemesidir. Sayfaları yükler, JavaScript’i çalıştırır, butonlara tıklar, formları doldurur—hem de görünmeden, arka planda. Bunu, kahvenizi yudumlarken sessizce çalışan bir hayalet tarayıcı gibi düşünebilirsiniz.
Neden önemli? Çünkü modern web siteleri botlar için değil, kullanıcılar için tasarlanıyor. Verileri JavaScript arkasına saklıyor, giriş yapmanızı istiyor ve gerçek bir insan gibi etkileşim bekliyor. Sadece HTML çekip çalışan geleneksel scraper’lar ise boş kabuklara bakıp kalıyor. Headless browser’lar ise gerçek kullanıcı davranışını taklit eder—AJAX çağrılarını bekler, sonsuz akışlarda aşağı kayar ve içeriği Chrome ya da Firefox’ta gördüğünüz haliyle alır (LiveProxies).
Ama avantajları bununla sınırlı değil:
- Hız ve Verimlilik: Headless browser’lar görsel render adımını atladığı için daha hızlıdır ve daha az bellek tüketir—ölçekli veri çekimi için idealdir (LiveProxies).
- Dinamik İçerik Desteği: JavaScript çalıştırdıkları için yalnızca ham HTML değil, gerçek render edilmiş veriyi alırsınız.
- Otomasyon Gücü: Giriş yapma, sayfalandırma, açılır pencereleri yönetme gibi işler kolayca otomatikleştirilebilir.
- Ölçeklenebilirlik: Bulutta yüzlerce örnek çalıştırabilir, binlerce sayfayı paralel olarak çekebilirsiniz.
İş kullanıcıları için bu; potansiyel müşteri toplama, rakip takibi ve fiyat izleme işlerini, sitenin adeta Fort Knox gibi tasarlanmış olması halinde bile yapabilmek demek. Üstelik yeni AI destekli araçlarla, bu sürece katılmak için kod yazmanız da gerekmiyor.
En İyi Python Headless Browser’ları Nasıl Seçtik?
Listeye rastgele araç isimleri atmadım. Şunlara baktım:
- Performans ve Hız: Modern, JavaScript yoğun siteleri hızlı ve güvenilir biçimde çalıştırabiliyor mu?
- Tarayıcı Desteği: Chrome, Firefox, WebKit ya da IE gibi eski motorlarla uyumlu mu?
- Kullanım Kolaylığı: Kod bilmeyenler için uygun mu, yoksa Python’da doktora mı gerektiriyor?
- AI ve No-Code Özellikleri: İş kullanıcıları script yazmadan AI ile scraping yapabiliyor mu?
- Topluluk ve Destek: Aktif bir topluluk, iyi dokümantasyon ve devam eden geliştirme var mı?
- Öne Çıkan Özellikler: Hazır şablonlar, bulut scraping, alt sayfa gezinme gibi ekstra avantajlar sunuyor mu?
Ekiplerin kurulumu haftalarca uğraşıp, site düzeni değişince yine başa dönmesini çok gördüm. En iyi araçlar sadece çalışmaz; uyum sağlar, ölçeklenir ve işleri kolaylaştırır.
Modern Veri Çekimi İçin En İyi 10 Python Headless Browser
İşte her bir aracın neden öne çıktığını ya da nerede zorlandığını detaylı şekilde ele aldığım kesin listem.
1. Thunderbit
 Thunderbit, yıllar önce elimde olmasını isteyeceğim python headless browser çözümü. Sadece bir tarayıcı otomasyon aracı değil; sonuç odaklı çalışan iş kullanıcıları için geliştirilmiş bir AI destekli web scraper Chrome uzantısı.
Thunderbit’i öne çıkaran özellikler:
- AI Alan Kurulumu: Uzantıyı açmanız yeterli—tek tıkla Thunderbit’in AI’ı sayfa düzenini anlar, alanları seçer ve scraping işlemini sizin için başlatır (Thunderbit Docs).
- Anında Veri Şablonları: Amazon, Zillow, LinkedIn gibi popüler siteler için tek tıkla hazır şablonlar sunar; kurulum gerekmez.
- Alt Sayfa ve Sayfalama Scraping’i: Thunderbit alt sayfalara tıklayabilir, sonsuz kaydırmayı yönetebilir ve tüm veriyi tek tabloda birleştirebilir.
- Doğal Dil Komutları: Ne istediğinizi sade İngilizceyle anlatmanız yeterli; kalanını Thunderbit’in AI’ı yapar.
- Bulutta veya Tarayıcıda Çalışma: Scrape işlemlerini yerelde ya da bulutta çalıştırabilirsiniz (hız için aynı anda 50 sayfaya kadar).
- Kod Gerekmez: Cidden—bir tarayıcı kullanabiliyorsanız Thunderbit’i de kullanabilirsiniz.
- Ücretsiz Veri Dışa Aktarma: Verileri tek tıkla Excel, Google Sheets, Notion veya Airtable’a aktarabilirsiniz.
Thunderbit’in satış ve operasyon ekiplerine saatler kazandırdığını gördüm—lead toplama, fiyat takibi veya ürün verisi derleme işlerindeki zahmeti tamamen ortadan kaldırıyor. Dünya genelinde 200.000’den fazla kullanıcı tarafından kullanılıyor ve geri bildirimler genelde aynı noktada birleşiyor: “Bu kadar kolay olacağına inanamıyorum.”
Kimler için ideal: Teknik olmayan kullanıcılar, iş ekipleri, AI’ın ağır işi üstlenmesini isteyen herkes.
Thunderbit AI Web Scraper’ı Ücretsiz Deneyin
2. Selenium
 Selenium, tarayıcı otomasyonunun klasik lideri. “python headless browser” diye aradıysanız, büyük ihtimalle Selenium WebDriver ile karşılaşmışsınızdır.
Artıları:
- Tüm Büyük Tarayıcıları Destekler: Chrome, Firefox, Safari, Edge, hatta Internet Explorer (cesareti olanlar için).
- Devasa Topluluk: Sayısız eğitim, eklenti ve Stack Overflow cevabı mevcut.
- Oldukça Esnek: Bir kullanıcının yapabildiği her şeyi otomatikleştirebilirsiniz—tıklamalar, formlar, gezinme.
Eksileri:
- Kurulum Zor Olabilir: Tarayıcı sürücülerini yönetmeniz ve sürümleri uyumlu tutmanız gerekir.
- Modern Araçlara Göre Daha Yavaş: WebDriver protokolü ek yük getirir; yüzlerce tarayıcıya ölçeklemek zahmetlidir.
- Detaylı API: Playwright veya Puppeteer’a göre daha fazla kod yazarsınız.
Kimler için ideal: Mevcut Selenium deneyimi olan ekipler, çapraz tarayıcı testleri veya eski otomasyon akışları.
3. Puppeteer
 Puppeteer, Google’ın Chrome/Chromium için geliştirdiği üst seviye otomasyon kütüphanesidir. Doğrudan Node.js dünyasına ait olsa da, Python kullanıcıları Pyppeteer üzerinden bu ekosisteme dahil olabilir.
Artıları:
- Chrome için Optimize Edilmiştir: Hızlı, verimli ve Chrome DevTools ile sıkı entegrasyonlu.
- Async API: Modern, JavaScript yoğun siteler için çok uygundur.
- Zengin Özellikler: Ekran görüntüsü alma, PDF dışa aktarma, ağ trafiğini yakalama.
Eksileri:
- Sadece Chromium: Firefox veya Safari desteği yok.
- Node.js Odaklı: Python kullanıcıları Pyppeteer kullanmak zorunda kalır (aşağıda değineceğimiz gibi artık bakım altında değil).
Kimler için ideal: Hızlı ve güvenilir Chrome otomasyonu isteyen, çapraz tarayıcı desteğine ihtiyaç duymayan geliştiriciler.
4. Playwright
 Playwright, Microsoft tarafından geliştirilen yeni nesil bir araç ve gelişmiş scraping için kısa sürede benim vazgeçilmezim oldu.
Artıları:
- Çoklu Tarayıcı Desteği: Chromium, Firefox ve WebKit’i tek API ile otomatikleştirebilir.
- Otomatik Bekleme: Sayfanın hazır olup olmadığını tahmin etmenize gerek kalmaz—Playwright sizin için bekler.
- Eşzamanlılık: Birden fazla tarayıcı context’ini paralel çalıştırarak inanılmaz hız elde edersiniz.
- Python Öncelikli: Yerleşik Python binding’leri vardır; hem async hem sync kullanılabilir.
Eksileri:
- Daha Büyük Kurulum: Birden fazla tarayıcıyı birlikte paketlediği için kurulum biraz daha ağırdır.
- Hâlâ Kod Gerektirir: Thunderbit kadar teknik olmayan kullanıcı dostu değildir.
Kimler için ideal: Özellikle karmaşık ve dinamik web uygulamalarında, sağlam ve modern otomasyon isteyen geliştiriciler.
5. Headless Chrome
 Headless Chrome, yukarıdaki birçok aracın arkasındaki temel motordur. Maksimum esneklik için doğrudan Chrome DevTools Protocol (CDP) üzerinden kontrol edebilirsiniz.
Artıları:
- En Güncel Web Desteği: Chrome’da çalışıyorsa, headless Chrome’da da çalışır.
- İnce Ayarlı Kontrol: Tarayıcının her köşesine erişebilirsiniz.
Eksileri:
- Öğrenme Eğrisi Yüksek: CDP konuşmanız ya da bir sarmalayıcı kütüphane kullanmanız gerekir.
- Sadece Chrome: Çapraz tarayıcı desteği yok.
Kimler için ideal: Özel otomasyon hatları kuran veya Chrome’u düşük seviyede entegre eden uzmanlar.
6. Pyppeteer
 Pyppeteer, Puppeteer’ın resmi olmayan Python portudur. Async Chrome otomasyonunu Python’a taşıdı; ama bir sorun var.
Artıları:
- Puppeteer Tarzı API: Puppeteer bilenler kendini evinde hisseder.
- Hızlı Chrome Otomasyonu: Dinamik siteler için çok uygundur.
Eksileri:
- Bakımı Durmuş: Orijinal proje artık güncellenmiyor (geliştiriciler Playwright’a geçmeyi öneriyor).
- Sadece Chromium: Firefox veya Safari desteği yok.
Kimler için ideal: Hâlihazırda Pyppeteer kullanan eski projeler. Yeni projeler için Playwright daha doğru seçim.
7. Splash
 Splash, Scrapinghub (şimdiki Zyte) ekibi tarafından geliştirilen, HTTP API’si olan hafif ve betiklenebilir bir headless browser’dır.
Artıları:
- Hafif: QtWebKit kullandığı için Chrome’a göre daha az kaynak tüketir.
- HTTP API: Sadece Python değil, herhangi bir dilden kontrol edilebilir.
- Scrapy ile Güçlü Entegrasyon: JS render için Scrapy spider’larıyla sorunsuz çalışır.
Eksileri:
- Daha Eski WebKit Motoru: En yeni JavaScript özelliklerinde zorlanabilir.
- Lua Gerektirir: Gelişmiş etkileşimler için Lua öğrenmeniz gerekir.
Kimler için ideal: Arada bir JS render’a ihtiyaç duyan Scrapy kullanıcıları veya hafif sunucu taraflı render işleri.
8. PhantomJS
 PhantomJS, WebKit tabanlı ilk betiklenebilir headless browser’dı. Öncüydü—ama artık büyük ölçüde tarihe karıştı.
Artıları:
- Basit Betikleme: JavaScript ile otomasyonu kolaydır.
- Eski Sistem Desteği: Hâlâ eski, statik sitelerde çalışabilir.
Eksileri:
- Bakımı Yok: 2016’dan beri güncelleme almıyor.
- Eski Motor: Modern, JavaScript yoğun siteleri işleyemez.
- Güvenlik Riskleri: Son dönem yamaları yok.
Kimler için ideal: Eski script’leri ayakta tutmak için. Yeni projelerde Playwright veya Puppeteer’a geçin.
9. HtmlUnit
 HtmlUnit, tarayıcı davranışını simüle eden Java tabanlı bir headless browser’dır. Hızlı ve hafiftir, ancak gerçek anlamda bir tarayıcı motoru değildir.
Artıları:
- Tamamen Java: Java ağırlıklı ortamlarda çok uygundur.
- Statik Sayfalarda Hızlı: Tam bir tarayıcı açmaya gerek yoktur.
Eksileri:
- Sınırlı JavaScript Desteği: Modern ve dinamik sitelerde zorlanır.
- Doğrudan Python-yerel Değil: Entegrasyon katmanları gerekir (ör. Selenium’un HtmlUnitDriver’ı).
Kimler için ideal: Java tabanlı iş akışları, eski uygulamaların testi veya basit, sunucu tarafında render edilen sayfalar.
10. TrifleJS
 TrifleJS, Windows üzerinde legacy web uygulamalarını otomatikleştirmeye odaklanan, Internet Explorer (IE) için bir headless browser’dır.
Artıları:
- IE Otomasyonu: Eski intranet uygulamalarını veya yalnızca IE’de çalışan sistemleri yönetebilir.
- PhantomJS’e Benzer API: PhantomJS script’lerine minimum değişiklikle uyarlanabilir.
Eksileri:
- Sadece Windows: Platform bağımsız değildir.
- Eski Teknoloji: IE kullanım dışı kaldı; TrifleJS niş ve nadiren bakım alan bir araç.
Kimler için ideal: Hâlâ IE otomasyonu gerektiren özel legacy iş akışları.
Karşılaştırma Tablosu: Python Headless Browser’lar Bir Bakışta
| Araç | Tarayıcı Desteği | Performans ve Ölçek | Kullanım Kolaylığı | AI/No-Code Özellikleri | Topluluk ve Destek | Kimler İçin En Uygun |
|---|---|---|---|---|---|---|
| Thunderbit | Chrome (Uzantı/Bulut) | Yüksek (bulut paralelliği) | En kolay—kod gerekmez | Evet (AI, şablonlar) | Büyüyen, aktif | Kod bilmeyenler, satış/operasyon, hızlı veri çekimi |
| Selenium | Tüm büyük tarayıcılar | Orta | Orta (kurulum) | Hayır | Çok büyük, olgun | Çapraz tarayıcı, legacy, test otomasyonu |
| Puppeteer | Chromium/Chrome | Çok yüksek | Yüksek (geliştiriciler) | Hayır | Büyük (Node.js) | Sadece Chrome, geliştiriciler, hızlı otomasyon |
| Playwright | Chromium, Firefox, WebKit | Çok yüksek (çoklu context) | Yüksek (geliştiriciler) | Hayır | Hızla büyüyor | Gelişmiş, çoklu tarayıcı, modern scraping |
| Headless Chrome | Chrome/Edge | Çok yüksek | Düşük (manuel CDP) | Hayır | Yok (altyapı) | Özel, uzman, düşük seviyeli kontrol |
| Pyppeteer | Chromium/Chrome | Yüksek | Orta (async) | Hayır | Küçük, bakımı durmuş | Eski Pyppeteer script’leri |
| Splash | QtWebKit | Orta | Orta (API/Lua) | Hayır | Niş (Scrapy/Zyte) | Scrapy kullanıcıları, hafif JS render |
| PhantomJS | WebKit (eski) | Düşük (artık eski) | Orta (JS) | Hayır | Kapanmış | Sadece legacy |
| HtmlUnit | Simüle (Java) | Orta/Yüksek (statik) | Düşük (Java) | Hayır | Küçük, Java odaklı | Java iş akışları, basit/statik sayfalar |
| TrifleJS | Internet Explorer (Trident) | Düşük/Orta | Orta (JS, Win) | Hayır | Çok küçük, legacy | Yalnızca IE legacy otomasyonu |
İşiniz İçin Doğru Python Headless Browser’ı Nasıl Seçersiniz?
Veri Scraping Nedir ve 2025’te Nasıl Yapılır Get Started Free
İşte doğru aracı seçmek için kısa rehberim:
- AI desteğiyle hızlı ve no-code scraping mi istiyorsunuz? Thunderbit ile başlayın. Özellikle satış, e-ticaret veya araştırma ekipleri için güvenilir veriye ulaşmanın en kolay yolu.
- Maksimum kontrol ve çoklu tarayıcı desteği mi lazım? Playwright en iyi seçeneğiniz. Sağlam, modern ve ölçek için tasarlanmış.
- Zaten Selenium’a yatırım yaptıysanız? Selenium ile devam edin—legacy ve çoklu tarayıcı iş akışlarında hâlâ güçlüdür.
- Geliştirici olarak sadece Chrome için otomasyon mu kuruyorsunuz? Puppeteer (veya Playwright) hızlı ve güçlüdür.
- Java ortamında basit, statik sayfalar mı çekiyorsunuz? HtmlUnit hafif ve kolay entegre edilebilir.
- Legacy script’leri veya sadece IE çalışan uygulamaları mı yönetiyorsunuz? PhantomJS ve TrifleJS son çare çözümleridir.
Unutmayın: En iyi araç, iş akışınıza, ekibinizin yetkinliklerine ve iş ihtiyaçlarınıza uyan araçtır. Bazen en iyi yaklaşım birkaç aracı birlikte kullanmaktır—hızlı işler için Thunderbit, ağır işler için Playwright, eski sistemler için Selenium.
Sık Sorulan Sorular
1. Python headless browser nedir ve scraping için neden gerekir?
Python headless browser, Python koduyla kontrol ettiğiniz ama görünmeden çalışan bir web tarayıcısıdır (GUI yoktur). Modern, JavaScript yoğun siteleri çekmek için gereklidir; çünkü script çalıştırabilir, kullanıcı etkileşimlerini yönetebilir ve tam render edilmiş içeriği alabilir—geleneksel HTML scraper’ların yapamadığı şeyleri yapar.
2. Teknik olmayan kullanıcılar için en iyi python headless browser hangisi?
Thunderbit kod bilmeyenler için en iyi tercihtir. Kurulumu AI ile otomatikleştirir, hazır şablonlar sunar ve veriyi tek tıkla ya da AI’a bir cümleyle neye ihtiyacınız olduğunu söyleyerek çekmenizi sağlar—programlama gerekmez.
3. Python kullanıcıları için Playwright ile Puppeteer arasındaki fark nedir?
Playwright birden fazla tarayıcıyı (Chromium, Firefox, WebKit) destekler ve güçlü Python binding’lerine sahiptir; bu da onu gelişmiş otomasyon için ideal kılar. Puppeteer ise yalnızca Chrome odaklıdır ve doğal olarak Node.js içindir; Python kullanıcıları Pyppeteer kullanabilir, ancak proje artık bakım altında değildir. Yeni Python projeleri için Playwright daha iyi seçimdir.
4. Selenium modern web scraping için hâlâ geçerli mi?
Evet—özellikle çapraz tarayıcı testleri ve legacy otomasyonlarda Selenium hâlâ yaygın biçimde kullanılır. Ancak Playwright veya Thunderbit gibi yeni araçlara göre kurulumu daha yavaş ve daha karmaşıktır; ayrıca büyük ölçekte scraping için daha az verimlidir.
5. PhantomJS, HtmlUnit veya TrifleJS gibi legacy araçları ne zaman kullanmalıyım?
Yalnızca eski iş akışlarını sürdürmek veya taşımak için. PhantomJS ve TrifleJS artık eski teknoloji sayılır; HtmlUnit ise basit sayfalı Java ortamları için daha uygundur. Yeni projelerde aktif olarak bakım gören modern araçları tercih edin.
Modern, AI destekli scraping’in nasıl göründüğünü görmek istiyorsanız, Thunderbit’i deneyin. Web otomasyonu hakkında daha fazla detay için Thunderbit Blog’a göz atın. Mutlu scraping’ler—veriniz hep güncel, tarayıcılarınız hep headless olsun.
Thunderbit AI Web Scraper’ı Bugün Deneyin Get Started Free
Daha Fazla Bilgi



