Wikipedia 爬虫:抓取信息框、引文与章节













为研究整理 Wikipedia 文章
将文章事实、信息框数值、引文和章节上下文分开保存到不同字段中。
一键提取 Wikipedia 数据
系统会为你打开的页面自动建议字段,并在一次运行中完成抓取。如果需要,你还可以用自然语言调整或重命名字段,然后再运行一次。
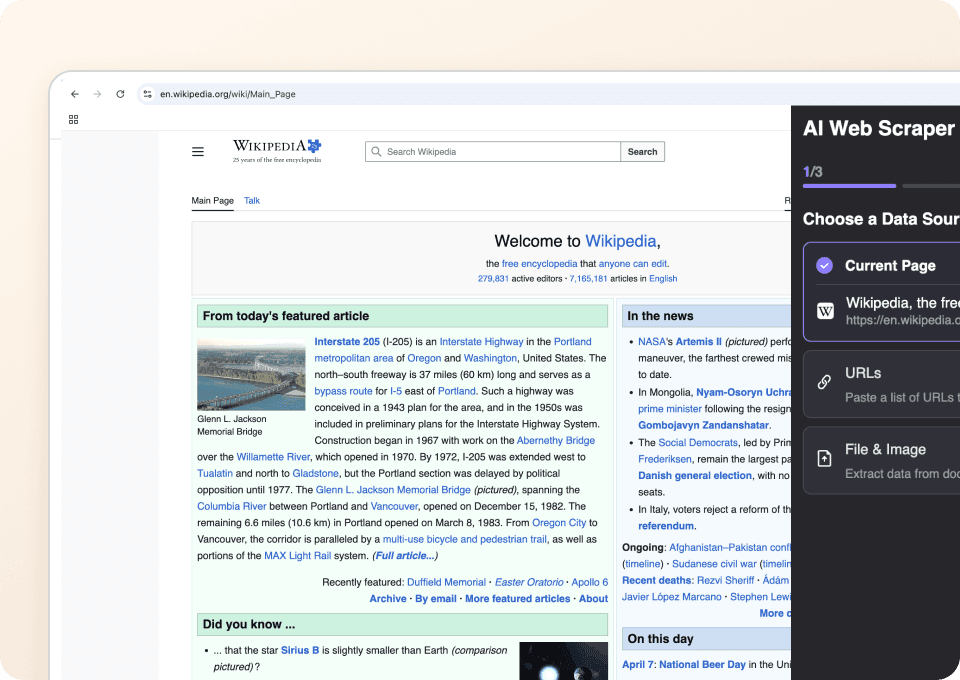
适配不同类型的 Wikipedia 页面
Agent 会读取页面中可见的标签、标题和章节名,来匹配你能访问到的内容。如果某个字段不存在,对应列就会保持空白。
直接导出 Wikipedia 数据
可继续将研究结果导入 Google Sheets、Excel、Airtable、Notion,或下载为 CSV。
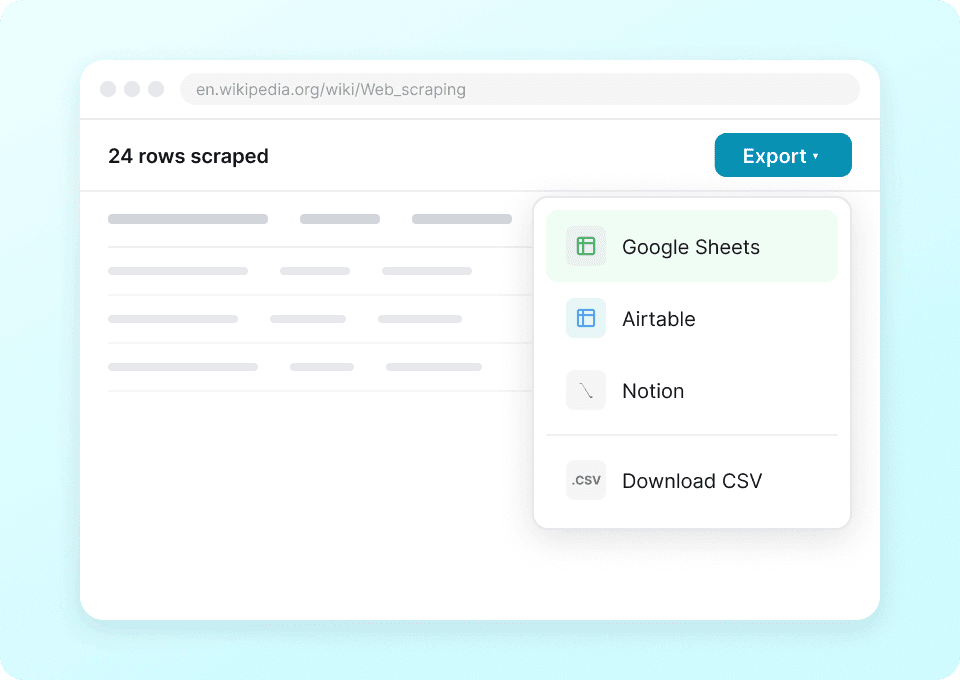
无需自己搭建爬虫,也能收集 Wikipedia 研究数据
减少 Wikipedia 研究中的选择器维护工作。
手动或基于选择器的方案
把时间花在维护规则上Thunderbit AI Agent
自动字段建议与单次运行文章事实、信息框、引文与章节字段
只有在你可访问的页面中显示出来的字段才会出现。
- page_title
- page_url
- lead_paragraph
- first_sentence
- infobox_image_url
- infobox_image_caption
- birth_name
- birth_date
- death_date
- birth_place
- death_place
- nationality
- occupation
- years_active
- employer
- alma_mater
- spouse
- children
- website
- notable_works
- latitude
- longitude
- categories
- reference_titles
- reference_links
- external_links
- article_sections
- table_of_contents
- hatnotes
- page_last_edited_date
See researchers capture structured facts from open pages
In user-recorded videos, researchers pick page facts, check the rows, and move the result into their own tools.

关于 Wikipedia 研究任务的问题
关于 Wikipedia 的 Agent Mode,这里有简明解答。
When your research spans Wikimedia projects
Pair Wikipedia articles with Wikidata items, Commons groups, or media pages.
Framer Scraper
Framer Scraper ของ Thunderbit ช่วยดึงข้อมูลรายการเทมเพลตและตัวอย่างผลงานจาก Framer ด้วย AI คุณสามารถเก็บข้อมูลจากหมวดหมู่ต่าง ๆ เช่นเทมเพลต Portfolio แล้วให้ระบบเข้าไปยังหน้าเทมเพลตหรือหน้า Showcase แต่ละรายการเพื่อเก็บรายละเอียดเพิ่มเติม เช่น ชื่อเรื่อง แท็ก ลิงก์พรีวิว และเมทาดาทา จากนั้นส่งออกไปยัง Excel, Google Sheets, Airtable หรือ Notion ได้ในไม่กี่คลิก
เรียนรู้เพิ่มเติม ->
WordPress.org Scraper
WordPress.org Scraper ของ Thunderbit ช่วยดึงข้อมูลแบบมีโครงสร้างจากไดเรกทอรีปลั๊กอิน WordPress และคลัง Block Pattern ด้วยพลัง AI เก็บข้อมูลได้ทั้งหน้ารายการและต่อยอดด้วยรายละเอียดจากหน้ารอง เช่น สถิติปลั๊กอิน เวอร์ชัน คะแนนรีวิว และเมทาดาต้าของแพตเทิร์น ก่อนส่งออกไปยัง Excel, Google Sheets, Airtable หรือ Notion ได้ทันที
เรียนรู้เพิ่มเติม ->
CoinMarketCap Scraper
ดึงข้อมูลคริปโต — ราคา มูลค่าตลาด และปริมาณซื้อขาย 24 ชั่วโมง — จาก CoinMarketCap ได้ใน 2 คลิก เปิดหน้าใดก็ได้ให้ AI ตรวจจับฟิลด์ให้อัตโนมัติ แล้วส่งออกไปยัง Excel, Google Sheets หรือ Notion ได้ทันที
เรียนรู้เพิ่มเติม ->
GoDaddy Scraper
ชี้ไปที่โดเมน GoDaddy ไม่ว่าจะเป็นสถานะการพร้อมใช้งานหรือราคา — Thunderbit ใช้ AI ดึงข้อมูลได้ใน 2 คลิก และส่งออกไปยัง Excel, Google Sheets หรือ Notion ได้ทันที
เรียนรู้เพิ่มเติม ->
Goodreads scraper
ดึงชื่อหนังสือ ชื่อผู้เขียน คะแนน และจำนวนรีวิวจาก Goodreads ได้ใน 2 คลิก — แล้วส่งออกข้อมูลไปยัง Excel, Google Sheets หรือ Notion พร้อมใช้งานสำหรับการวิเคราะห์ทันที
เรียนรู้เพิ่มเติม ->
Pixiv Scraper
ดึงชื่อผลงาน Pixiv, ชื่อศิลปิน, แท็ก และยอดเข้าชมได้ใน 2 คลิก — ส่งออกไปยัง Excel, Google Sheets หรือ Notion ได้ทันที โดยไม่ต้องเขียนโค้ดหรือเซ็ตอัปอะไรเพิ่ม
เรียนรู้เพิ่มเติม ->พร้อมเร่งพลังการดึงข้อมูลของคุณหรือยัง?
เข้าร่วมกับมืออาชีพกว่า 200,000+ คนที่ใช้ Thunderbit เพื่อทำเวิร์กโฟลว์การดึงข้อมูลเว็บให้อัตโนมัติ
ทดลองใช้ฟรีพร้อมเครดิตไม่จำกัดสำหรับ 8 หน้าเว็บ


