Baidu Scraper สำหรับผลการค้นหาและบทความ













เปลี่ยนผลลัพธ์ Baidu ให้เป็นข้อมูลที่สะอาดและใช้งานได้จริง
เก็บผลการค้นหาและรายละเอียดบทความที่มีอยู่ไว้ในตารางเดียวที่ชัดเจน
ทำความสะอาดข้อมูล Baidu ตั้งแต่ตอนเก็บ
Thunderbit จะจัดชื่อเรื่อง, URL, ข้อความสรุป, วันที่ และแหล่งที่มาที่มองเห็นได้ลงในคอลัมน์ที่อ่านง่าย หากผลลัพธ์ใดไม่แสดงฟิลด์นั้น เซลล์จะเว้นว่างไว้

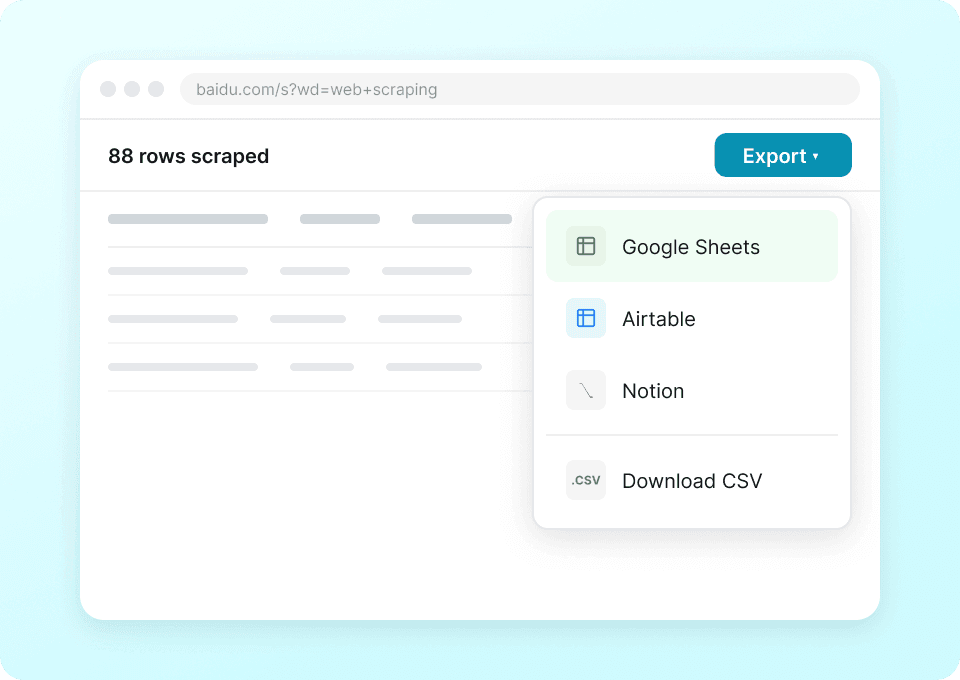
ส่งออกข้อมูลวิจัย Baidu ได้ในคลิกเดียว
ส่งแต่ละรอบการดึงข้อมูลไปยังชีตสำหรับตรวจทานผลการค้นหา โดยอันดับ, แหล่งที่มา, วันที่ และรายละเอียดจากหน้าที่เชื่อมโยงจะอยู่ข้างผลลัพธ์ Baidu ที่ตรงกัน
ใช้เวิร์กโฟลว์เดียวกันได้กับทุกเว็บไซต์
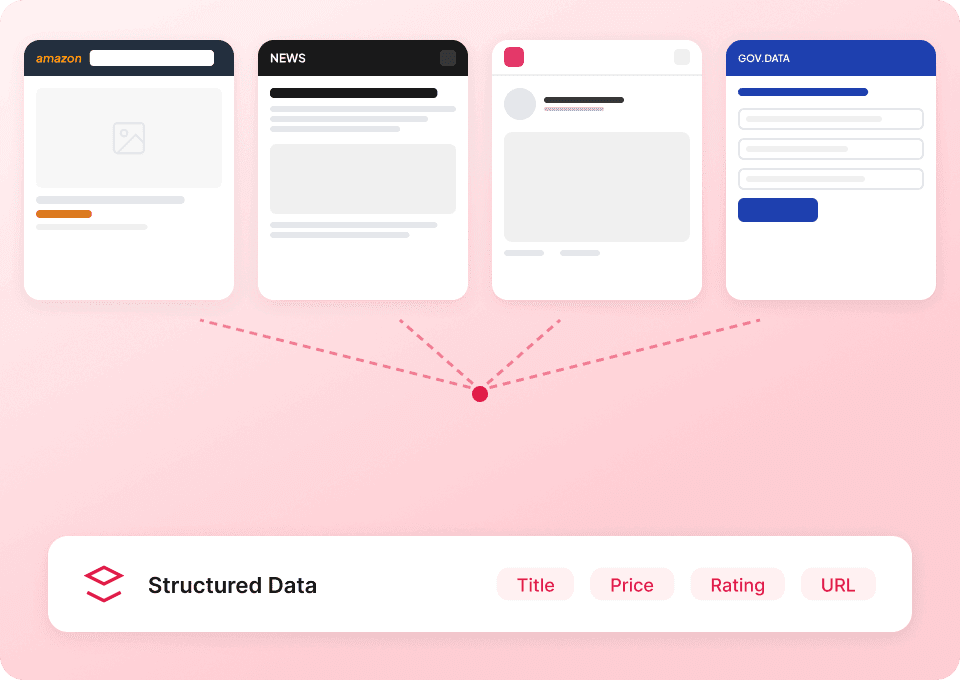
Thunderbit อ่านฟิลด์ตามความหมาย ไม่ได้ยึดติดกับเลย์เอาต์ของ Baidu เพียงแบบเดียว คุณจึงใช้แนวทางเดิมกับเว็บไซต์สาธารณะที่เข้าถึงได้อื่น ๆ ได้เมื่อการวิจัยของคุณไปถึงแหล่งข้อมูลใหม่
รักษาบริบทของทุกผลลัพธ์ Baidu ไว้ครบถ้วน
แค่รายการลิงก์อย่างเดียวทำให้บริบทหายไป แต่ Thunderbit จะเก็บรายละเอียดที่มองเห็นได้ไว้ข้างผลลัพธ์แต่ละรายการ
ลิงก์ที่คัดลอกมาและบันทึกแบบกระจัดกระจาย
รายละเอียดของผลลัพธ์แยกออกจากกันงานวิจัย Baidu ที่มีโครงสร้างชัดเจน
บริบทที่มองเห็นได้ยังคงอยู่กับผลลัพธ์แต่ละรายการคุณดึงข้อมูลอะไรจาก Baidu ได้บ้าง?
เลือกใช้จากฟิลด์สาธารณะที่มองเห็นได้เหล่านี้ โดยแต่ละโมดูลของผลลัพธ์และหน้าที่เชื่อมโยงอาจไม่ได้แสดงทุกฟิลด์ในทุกคำค้น
- Search Query
- Result Rank
- Result Title
- Result URL
- Displayed URL
- Result Snippet
- Result Date
- Result Site Icon
- Related Search Phrase
- Spelling Suggestion
- Pinyin Suggestion
- Search Result Page Number
- Source Site
- Source Domain
- Article Author
- Article Publication Date
- Article Abstract
- Document Name
- Document Description
- Document Breadcrumb
- Document Genre
- Document File Format
- Document Page Count
- Document Upload Time
- Document URL
- Result Content Type
- Image Thumbnail
- Video Thumbnail
- Location Address
- Baidu Feature Module
See how researchers track Chinese search results
These user feedback videos show how people review Chinese search results, track sources, and check linked articles.

คำถามเกี่ยวกับการเก็บข้อมูลค้นหา Baidu
ฟิลด์ที่ใช้งานได้จะแตกต่างกันไปตามคำค้น ประเภทผลลัพธ์ และข้อมูลที่แสดงบนหน้าที่เชื่อมโยง
Continue from Baidu results to source-page research
Explore article and website scrapers when you need full page text or other details beyond the fields shown in Baidu results.
Framer Scraper
Framer Scraper ของ Thunderbit ช่วยดึงข้อมูลรายการเทมเพลตและตัวอย่างผลงานจาก Framer ด้วย AI คุณสามารถเก็บข้อมูลจากหมวดหมู่ต่าง ๆ เช่นเทมเพลต Portfolio แล้วให้ระบบเข้าไปยังหน้าเทมเพลตหรือหน้า Showcase แต่ละรายการเพื่อเก็บรายละเอียดเพิ่มเติม เช่น ชื่อเรื่อง แท็ก ลิงก์พรีวิว และเมทาดาทา จากนั้นส่งออกไปยัง Excel, Google Sheets, Airtable หรือ Notion ได้ในไม่กี่คลิก
เรียนรู้เพิ่มเติม ->
WordPress.org Scraper
WordPress.org Scraper ของ Thunderbit ช่วยดึงข้อมูลแบบมีโครงสร้างจากไดเรกทอรีปลั๊กอิน WordPress และคลัง Block Pattern ด้วยพลัง AI เก็บข้อมูลได้ทั้งหน้ารายการและต่อยอดด้วยรายละเอียดจากหน้ารอง เช่น สถิติปลั๊กอิน เวอร์ชัน คะแนนรีวิว และเมทาดาต้าของแพตเทิร์น ก่อนส่งออกไปยัง Excel, Google Sheets, Airtable หรือ Notion ได้ทันที
เรียนรู้เพิ่มเติม ->
CoinMarketCap Scraper
ดึงข้อมูลคริปโต — ราคา มูลค่าตลาด และปริมาณซื้อขาย 24 ชั่วโมง — จาก CoinMarketCap ได้ใน 2 คลิก เปิดหน้าใดก็ได้ให้ AI ตรวจจับฟิลด์ให้อัตโนมัติ แล้วส่งออกไปยัง Excel, Google Sheets หรือ Notion ได้ทันที
เรียนรู้เพิ่มเติม ->
GoDaddy Scraper
ชี้ไปที่โดเมน GoDaddy ไม่ว่าจะเป็นสถานะการพร้อมใช้งานหรือราคา — Thunderbit ใช้ AI ดึงข้อมูลได้ใน 2 คลิก และส่งออกไปยัง Excel, Google Sheets หรือ Notion ได้ทันที
เรียนรู้เพิ่มเติม ->
Goodreads scraper
ดึงชื่อหนังสือ ชื่อผู้เขียน คะแนน และจำนวนรีวิวจาก Goodreads ได้ใน 2 คลิก — แล้วส่งออกข้อมูลไปยัง Excel, Google Sheets หรือ Notion พร้อมใช้งานสำหรับการวิเคราะห์ทันที
เรียนรู้เพิ่มเติม ->
Pixiv Scraper
ดึงชื่อผลงาน Pixiv, ชื่อศิลปิน, แท็ก และยอดเข้าชมได้ใน 2 คลิก — ส่งออกไปยัง Excel, Google Sheets หรือ Notion ได้ทันที โดยไม่ต้องเขียนโค้ดหรือเซ็ตอัปอะไรเพิ่ม
เรียนรู้เพิ่มเติม ->พร้อมเร่งพลังการดึงข้อมูลของคุณหรือยัง?
เข้าร่วมกับมืออาชีพกว่า 200,000+ คนที่ใช้ Thunderbit เพื่อทำเวิร์กโฟลว์การดึงข้อมูลเว็บให้อัตโนมัติ
ทดลองใช้ฟรีพร้อมเครดิตไม่จำกัดสำหรับ 8 หน้าเว็บ



