
ตอนนี้อาจมีใครสักคนกำลังพิมพ์คำว่า "Thunderbit vs Browserless" ลงใน Google และหวังว่าจะได้คำเปรียบเทียบแบบชัด ๆ วัดกันตรง ๆ แต่ปัญหาคือ มันเหมือนเอาแอปสั่งอาหารมาเทียบกับครัวร้านอาหารระดับมืออาชีพ — แม้จะเกี่ยวกับอาหารเหมือนกัน แต่ถูกสร้างขึ้นมาสำหรับคนละกลุ่ม และใช้ทำคนละเรื่องโดยสิ้นเชิง
ผมรู้เรื่องนี้ดี เพราะทีมของผมเป็นคนสร้าง Thunderbit ขึ้นมา และผมก็อยู่ในแวดวง SaaS กับระบบอัตโนมัติมานานพอที่จะเห็นบ่อย ๆ ว่าเครื่องมือหลายตัวถูกจับมาเทียบกันทั้งที่จริง ๆ ไม่ควรเทียบ เมื่อเห็นคำค้นนี้เริ่มได้รับความสนใจ ผมเลยอยากเขียนคู่มือแบบตรงไปตรงมาที่ช่วยให้คุณตัดสินใจได้จริง — ไม่ใช่การปะทะทางการตลาด แต่เป็นการมองให้ชัดว่าแต่ละเครื่องมือทำอะไร เหมาะกับใคร และเมื่อไรที่คุณอาจต้องใช้ทั้งสองตัวด้วยซ้ำ เครื่องมือแนว no-code สำหรับงานข้อมูลและการทำงานอัตโนมัติบนเบราว์เซอร์ที่เน้นนักพัฒนา ต่างก็เติบโตเร็วมากในช่วงไม่กี่ปีที่ผ่านมา และถ้ามองจากภายนอก เส้นแบ่งระหว่างกันอาจดูพร่าเลือน ดังนั้นผมจะพาไล่ดูสิ่งที่ผมได้เรียนรู้มาให้คุณเอง
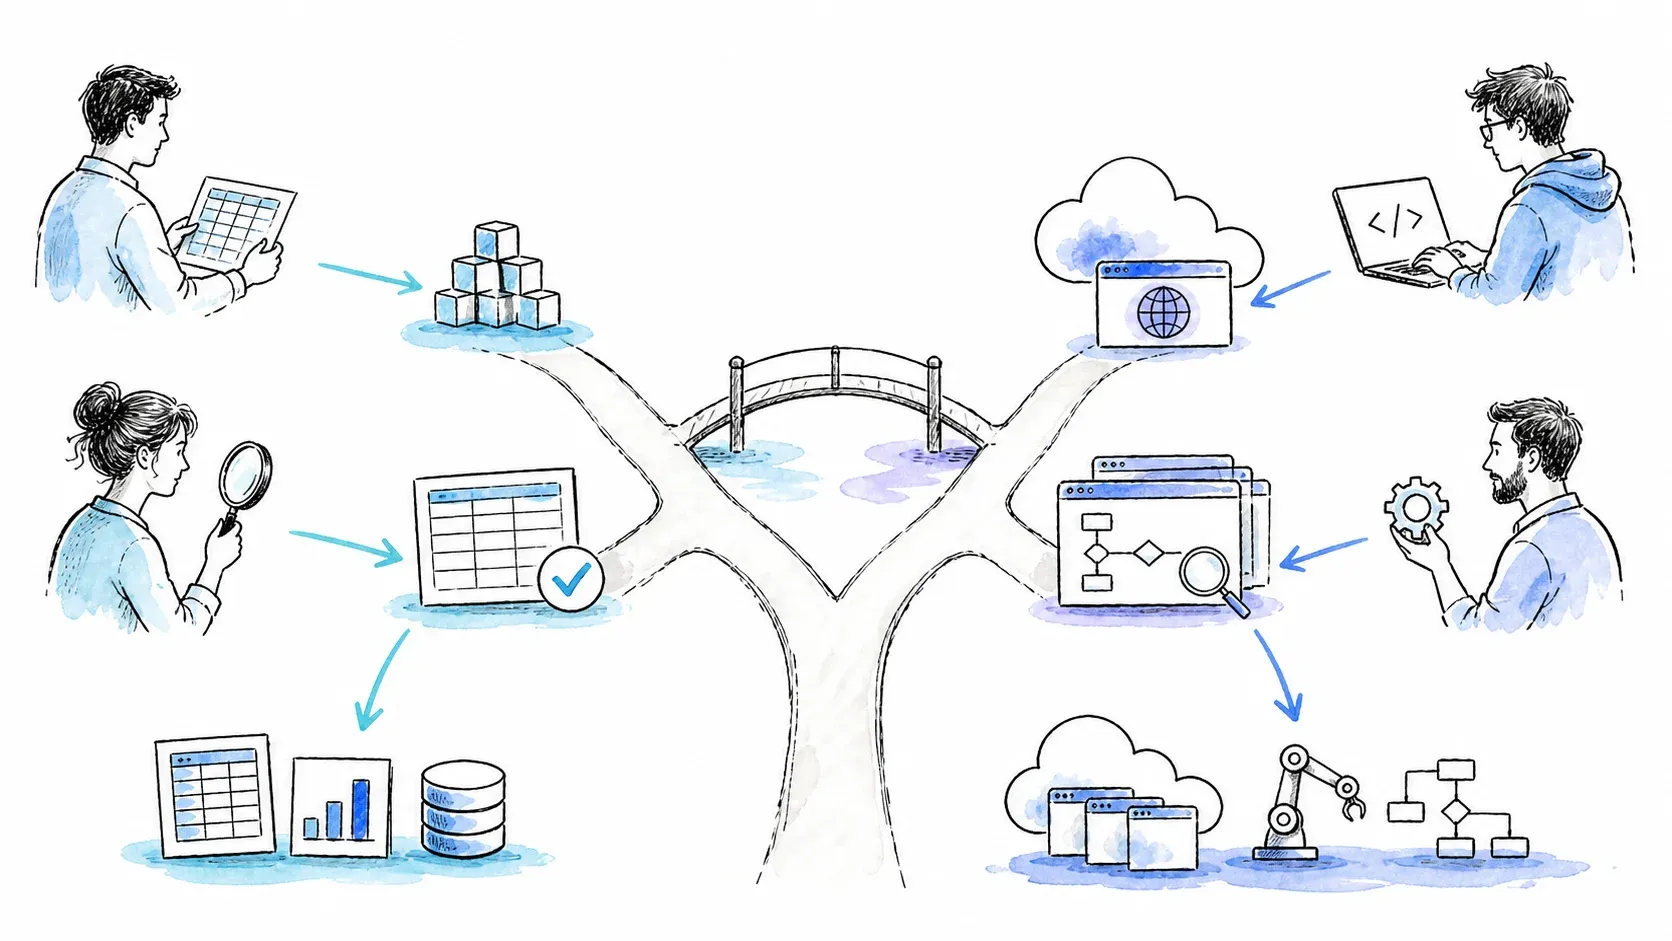
เริ่มจากเรื่องสำคัญ: Thunderbit และ Browserless อยู่คนละหมวดของเครื่องมือ
ก่อนจะไปเทียบฟีเจอร์หรือราคา ผมอยากช่วยคุณตัดความสับสนก่อน Thunderbit กับ Browserless ไม่ได้เป็นคู่แข่งกันโดยตรงแบบเดียวกับที่เรามักเทียบแพลตฟอร์ม CRM สองเจ้า พวกมันอยู่คนละชั้นของสแต็กข้อมูลบนเว็บ
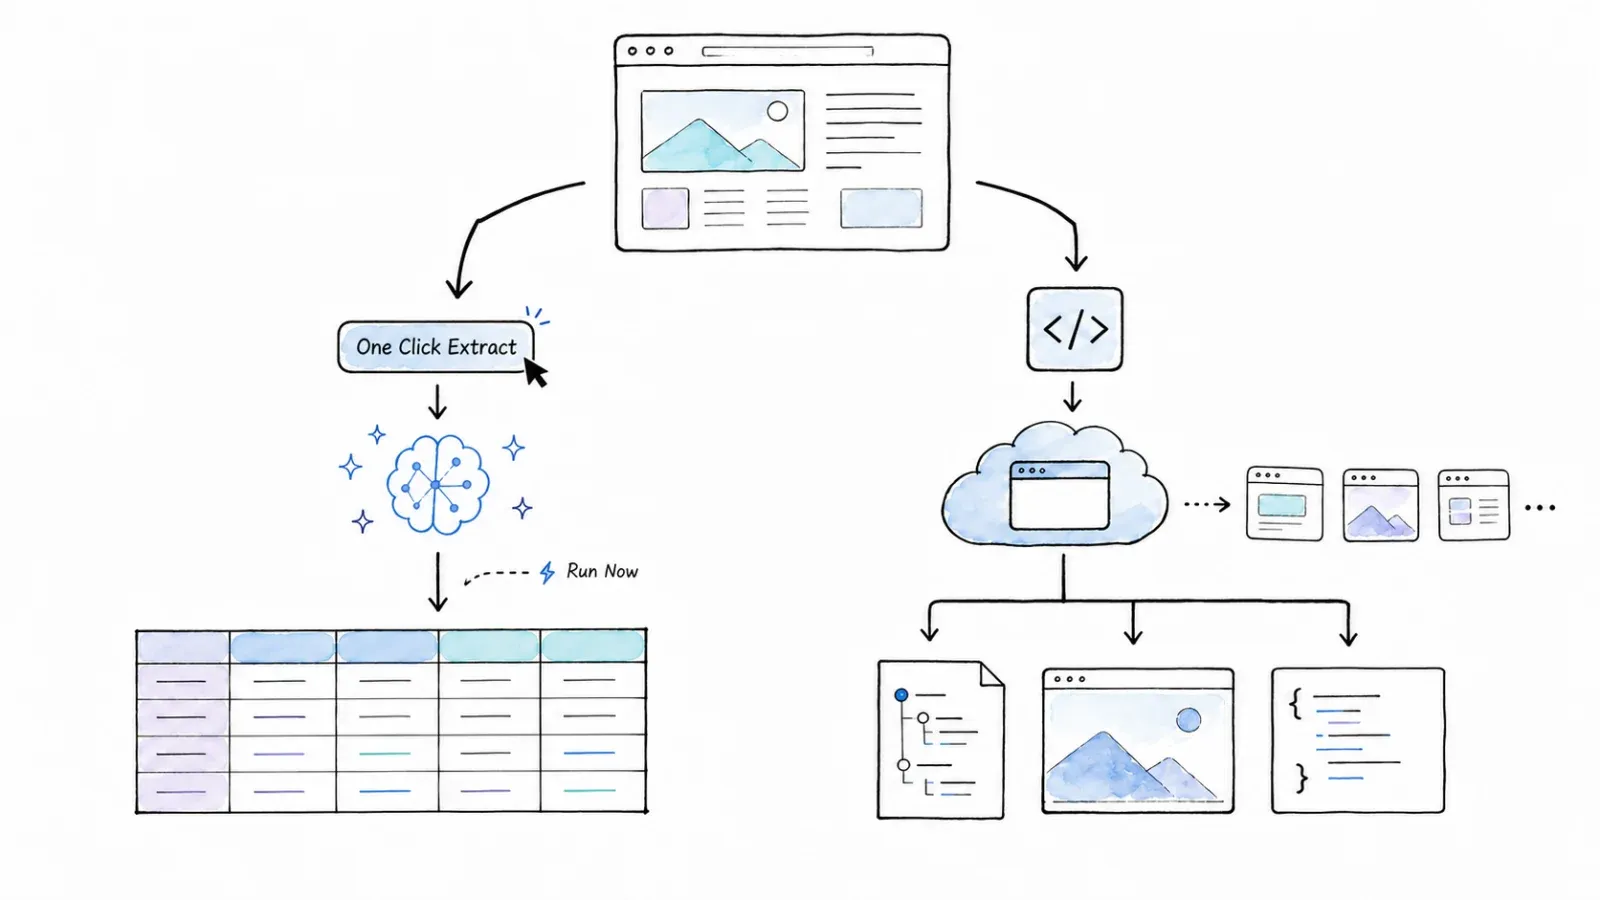
Thunderbit คือเอเจนต์เว็บสแครปและแพลตฟอร์มอัตโนมัติที่สร้างมาเพื่อผู้ใช้สายธุรกิจเป็นหลัก คุณติดตั้งส่วนขยาย Chrome หรือ Edge เปิดหน้าเว็บ ปล่อยให้ AI แนะนำฟิลด์ข้อมูล กดสแครป แล้วส่งออกข้อมูลที่จัดโครงสร้างเรียบร้อยไปยัง Excel, Google Sheets, Airtable หรือ Notion ได้ Thunderbit ยังมี Open API, MCP Server และ CLI สำหรับนักพัฒนาด้วย แต่หัวใจของมันคือผลลัพธ์จากการดึงข้อมูล — ช่วยให้คุณได้ข้อมูลเป็นแถว ๆ ที่สะอาดและเป็นระเบียบ โดยไม่ต้องเขียนโค้ด
Thunderbit คือ agentic web scraper: บนหน้าเว็บที่รองรับและได้รับอนุญาตแล้ว ให้คลิก One Click Extract เอเจนต์จะตรวจจับ อ่าน และวิเคราะห์หน้าเว็บเพื่อเลือกว่าควรดึงข้อมูลอะไร Run Now จะเริ่มทันที แต่ถ้าคุณไม่ทำอะไรเลย งานก็จะเริ่มอัตโนมัติอยู่ดี — ดังนั้นประสบการณ์เริ่มต้นจึงใช้เพียงคลิกเดียวแบบตั้งใจ โดยไม่ต้องมีโค้ด ตัวเลือก selector หรือการตั้งค่า schema ใด ๆ
Browserless คือโครงสร้างพื้นฐานเบราว์เซอร์แบบ headless ที่บริหารจัดการให้สำหรับนักพัฒนา มันให้ Chrome ที่รันบนคลาวด์ ซึ่งโค้ดของคุณที่ใช้ Puppeteer, Playwright หรือ CDP-compatible จะเชื่อมต่อผ่าน WebSocket หรือ REST API ดังนั้นจุดศูนย์กลางของมันคือการรันเบราว์เซอร์แบบโปรแกรมได้ — ใช้เซสชันเบราว์เซอร์จำนวนมาก ถ่ายภาพหน้าจอ สร้าง PDF รับมือการตรวจจับบอท และให้นักพัฒนาควบคุมทุกอย่างที่เกิดขึ้นในเบราว์เซอร์ได้เต็มที่
ตารางสั้น ๆ ด้านล่างช่วยให้เห็นภาพชัดขึ้น:
| มิติ | Thunderbit | Browserless |
|---|---|---|
| ผู้ใช้หลัก | ผู้ใช้ธุรกิจ, ทีมปฏิบัติการ, ฝ่ายขาย, การตลาด | นักพัฒนา, DevOps, วิศวกร QA |
| หน้าตาใช้งาน | ส่วนขยาย Chrome/Edge, Web App, คลิกแล้วใช้งาน | REST/WebSocket API, BrowserQL, เครื่องมือในแดชบอร์ด |
| คุณค่าหลัก | ดึงข้อมูลแบบมีโครงสร้างด้วย AI ช่วยแนะนำ | โครงสร้างพื้นฐาน Managed headless Chrome/Chromium แบบสเกลได้ |
| เวลาในการเริ่มต้น | ไม่กี่นาที (ติดตั้งส่วนขยาย เปิดหน้าเว็บ) | ไม่กี่นาทีถึงหลายชั่วโมง (เขียนสคริปต์ ตั้งค่า API key) |
| ผลลัพธ์ | ข้อมูลเป็นแถว ๆ → Excel, Google Sheets, Airtable, Notion | HTML ที่เรนเดอร์แล้ว, JSON ที่มีโครงสร้าง, ภาพหน้าจอ, PDF ผ่าน API |
| Self-hosting | ไม่มี | มี (Docker, VPC, air-gapped) |
ทำไมเรื่องนี้ถึงสำคัญ? เพราะถ้าคุณเป็นนักการตลาดที่ต้องการรายชื่อลีดลงสเปรดชีตภายในมื้อเที่ยง คุณไม่จำเป็นต้องไปตั้งฟาร์ม headless browser ให้ยุ่งยาก และถ้าคุณเป็นนักพัฒนาที่ต้องรันเบราว์เซอร์ 500 เซสชันใน CI pipeline คุณก็ไม่ได้ต้องการการดึงข้อมูลแบบเอเจนต์ ด้านล่างนี้เราจะยังเทียบกันต่อในเรื่องราคา การใช้งาน และความง่ายในการเรียนรู้ — เพราะถึงจะเป็นคนละหมวด แต่คุณก็ยังต้องเลือกตัวที่เหมาะสมที่สุดอยู่ดี (หรืออาจใช้ทั้งสองตัว)
Thunderbit คืออะไร?

Thunderbit คือแพลตฟอร์มเว็บสแครปและระบบอัตโนมัติที่ขับเคลื่อนด้วย AI ออกแบบมาเพื่อให้ผู้ใช้ที่ไม่ถนัดเทคนิค — เช่น ทีมขาย ผู้จัดการฝ่ายปฏิบัติการ นักการตลาด นักวิจัย — สามารถดึงข้อมูลแบบมีโครงสร้างจากเว็บไซต์ได้โดยไม่ต้องเขียนโค้ดเลย
เวิร์กโฟลว์หลักทำงานประมาณนี้: คุณติดตั้ง Thunderbit Chrome extension เข้าไปยังหน้าเว็บ แล้วกด "One Click Extract" จากนั้นเอเจนต์จะอ่านและวิเคราะห์หน้าเว็บ กำหนดแผนการดึงข้อมูล และเริ่มทำงานอัตโนมัติ เว้นแต่คุณเลือก "Run Now" เพื่อให้เริ่มทันที แล้วคุณสามารถส่งออกข้อมูลไปยัง Excel, Google Sheets, Airtable หรือ Notion ได้ ยังรองรับการแบ่งหน้า การดึงข้อมูลจากหน้าย่อย การตั้งเวลา และเทมเพลตที่นำกลับมาใช้ซ้ำได้ด้วย
Thunderbit ยังมี Open API (มี Distill และ Extract endpoints), MCP Server สำหรับงานของ AI agent และ CLI แต่หัวใจของผลิตภัณฑ์คือประสบการณ์แบบ no-code ที่ใช้งานผ่านเบราว์เซอร์ ถ้าคุณเคยอยากชี้ไปที่หน้าเว็บแล้วบอกว่า "เอาข้อมูลพวกนี้ไปใส่สเปรดชีตให้หน่อย" นั่นแหละคือแนวคิดของมัน
Browserless คืออะไร?
Browserless คือแพลตฟอร์ม headless browser แบบบริหารจัดการให้ ซึ่งช่วยให้นักพัฒนารัน Chrome บนคลาวด์ได้ โดยไม่ต้องดูแลโครงสร้างพื้นฐานของเบราว์เซอร์เอง คำว่า "headless browser" หมายถึงเบราว์เซอร์ที่ไม่มีหน้าต่างให้เห็น — ทุกอย่างถูกควบคุมด้วยโค้ดล้วน ๆ
นักพัฒนาจะเชื่อมสคริปต์ Puppeteer, Playwright หรือที่รองรับ CDP กับอินสแตนซ์เบราว์เซอร์ระยะไกลของ Browserless ผ่าน WebSocket หรือ REST API แทนที่จะเปิด Chrome บนเครื่องตัวเอง (ซึ่งกินหน่วยความจำและ CPU เยอะ) เบราว์เซอร์จะไปรันบนเซิร์ฟเวอร์ของ Browserless เอง Browserless ยังมี BrowserQL ซึ่งเป็นเลเยอร์อัตโนมัติแบบ GraphQL ที่มีคำสั่งในตัวสำหรับการนำทาง คลิก พิมพ์ เลื่อนหน้า ดึงข้อมูล ถ่ายภาพหน้าจอ สร้าง PDF จัดการ CAPTCHA และอื่น ๆ อีกมากมาย ส่วน REST APIs รองรับคอนเทนต์ที่เรนเดอร์แล้ว การดึงข้อมูลแบบมีโครงสร้างด้วย selector, Smart Scrape, ภาพหน้าจอ, PDF และฟังก์ชัน Puppeteer แบบกำหนดเอง
อย่างไรก็ตาม Browserless ก็ไม่ได้มีแค่ "เขียนโค้ดอย่างเดียว" นะ มันมี playground บนแดชบอร์ด ตัวสร้างโค้ดด้วย AI, MCP integration และการเชื่อมต่อกับ n8n, Make และ Zapier แต่แกนหลักของมันยังคงเป็นแบบ developer-first: คุณเขียนตรรกะเอง ส่วน Browserless จัดหาเอนจินเบราว์เซอร์และโครงสร้างพื้นฐานให้ นอกจากนี้ยังมีตัวเลือก self-hosted (Docker, VPC, air-gapped) สำหรับทีมที่ต้องการความเป็นส่วนตัวของข้อมูลหรือควบคุมโครงสร้างพื้นฐานเอง — แม้ว่า Docker image แบบสาธารณะกับเวอร์ชันคลาวด์เชิงพาณิชย์จะไม่ได้มีฟีเจอร์เหมือนกันทั้งหมดก็ตาม
Thunderbit vs Browserless แบบดูเร็ว ๆ: เปรียบเทียบเคียงข้างกัน
มาดูภาพรวมแบบละเอียดในมิติที่สำคัญจริง ๆ กัน:
| มิติ | Thunderbit | Browserless |
|---|---|---|
| ผู้ใช้เป้าหมาย | ผู้ใช้ธุรกิจ, คนไม่เขียนโค้ด, ทีมปฏิบัติการ, ฝ่ายขาย, การตลาด | นักพัฒนา, DevOps, วิศวกร QA |
| หน้าตาใช้งาน | ส่วนขยาย Chrome/Edge, Web App, API, MCP, CLI | REST/WebSocket API, BrowserQL, แดชบอร์ด, MCP, n8n/Make/Zapier |
| การดึงข้อมูลด้วย AI | มี — One Click Extract, คำสั่งระดับฟิลด์ | ไม่มี agentic extraction ในตัว; มี Smart Scrape และการดึงข้อมูลผ่าน BrowserQL |
| เวลาเริ่มต้นจนได้ผลลัพธ์แรก | ไม่กี่นาที (ติดตั้งส่วนขยาย เปิดหน้าเว็บ สแครป) | ไม่กี่นาทีถึงหลายชั่วโมง (ขอ API key เขียน/ตั้งค่าสคริปต์ รัน) |
| ต้องเขียนโค้ดไหม | ไม่ต้อง (ส่วนขยาย/Web App); มีทางเลือกผ่าน API/MCP/CLI | จำเป็นสำหรับเวิร์กโฟลว์หลัก; มีทางเลือก low-code ผ่าน MCP/การเชื่อมต่อ |
| ผลลัพธ์/การส่งออกข้อมูล | ข้อมูลเป็นแถว ๆ → Excel, CSV, Google Sheets, Airtable, Notion | HTML ที่เรนเดอร์แล้ว, JSON, ภาพหน้าจอ, PDF, เอาต์พุตแบบกำหนดเองผ่าน API |
| รองรับ pagination/subpage | มีในตัว ปรับค่าได้จาก UI | ผู้ใช้ต้องเขียนในโค้ดหรือใช้ BrowserQL |
| การตั้งเวลา | รองรับในแพ็กเกจ/หน้าที่ใช้งานที่เข้าเงื่อนไข | ผู้ใช้จัดการเอง (ผ่านโค้ด cron หรือ orchestration ภายนอก) |
| การรับมือ bot detection/stealth | มีการเรนเดอร์แบบจัดการให้ในหน้าที่รองรับ; ไม่รับประกันผล | BrowserQL stealth, residential/datacenter proxies, จัดการ CAPTCHA; ไม่รับประกันผล |
| Self-hosting | ไม่มี | มี (Docker, VPC, air-gapped; ใช้ไลเซนส์แบบ SSPL/เชิงพาณิชย์คู่กัน) |
| การเชื่อมต่อ | ส่งออกตรงไปยังเครื่องมือธุรกิจ; มี API/MCP/CLI สำหรับเวิร์กโฟลว์นักพัฒนา | Puppeteer/Playwright/CDP, MCP, n8n, Make, Zapier, agent SDKs |
| กรณีใช้งานหลัก | ดึงลีด, วิจัยตลาด, เก็บข้อมูลเฉพาะกิจ, ดึงข้อมูลตามกำหนดเวลา | ทดสอบเบราว์เซอร์, automation, ภาพหน้าจอ/PDF, ดึงข้อมูลบนเว็บที่มีระบบกันบอท, งาน agent |
ถ้าคุณเป็นเซลส์ที่ต้องการข้อมูลลีดลงสเปรดชีตภายในมื้อเที่ยง Thunderbit ถูกสร้างมาเพื่อคุณ แต่ถ้าคุณเป็นนักพัฒนาที่ต้องรันเบราว์เซอร์ headless 500 เซสชันใน CI pipeline Browserless ถูกสร้างมาเพื่อคุณ ช่องทับซ้อนกันอยู่ตรง "การดึงข้อมูลจากหน้าเว็บ" แต่แนวทางและประสบการณ์การใช้งานต่างกันคนละโลก
ระดับทักษะและเส้นโค้งการเรียนรู้: Thunderbit vs Browserless
จากงานวิจัยที่ผมดูมา คำถามที่เจอบ่อยที่สุดคือ "เครื่องมือไหนเหมาะกับระดับทักษะของฉัน?" ดังนั้นผมขอตอบแบบตรง ๆ ตรงนี้เลย
สิ่งที่คุณต้องรู้เพื่อใช้ Thunderbit
คุณไม่จำเป็นต้องเขียนโค้ดเป็น ส่วน Thunderbit browser extension ถูกออกแบบให้คุณติดตั้ง เปิดหน้าเว็บ กดปุ่ม แล้วได้ข้อมูลที่จัดโครงสร้างเรียบร้อย One Click Extract ช่วยให้อินเทอร์เฟซอ่านและวิเคราะห์หน้าเว็บ กำหนดผลลัพธ์ และเริ่มดึงข้อมูลให้อัตโนมัติ สำหรับผู้ใช้ธุรกิจส่วนใหญ่ เวิร์กโฟลว์ตั้งแต่ติดตั้งไปจนถึงส่งออกข้อมูลใช้เวลาเพียงไม่กี่นาที
การดูแลต่อเนื่องก็มักจะเบากว่า เพราะ AI จะช่วยแนะนำ schema และปรับตัวกับหน้าที่รองรับได้ คุณจึงไม่ต้องมานั่งดูแล CSS selector หรือ XPath expression ในโค้ด เอกสารต่าง ๆ ก็เป็นแบบภาพ เน้นบทเรียนและคู่มือสำหรับผู้ใช้ธุรกิจ หากเป็นงานโปรแกรมที่ซับซ้อนหรือมีตรรกะเฉพาะทางหนัก ๆ อินเทอร์เฟซแบบ no-code ก็มีขอบเขตของมัน — ตรงนั้นแหละที่ API, MCP หรือ CLI เข้ามาช่วย
สิ่งที่คุณต้องรู้เพื่อใช้ Browserless
Browserless คาดหวังว่าคุณจะคุ้นกับ JavaScript หรือ Python รู้จัก Puppeteer หรือ Playwright และสบายใจกับ API key กับ WebSocket connection คุณจะต้องเขียนสคริปต์เพื่อบอกเบราว์เซอร์ว่าจะทำอะไร — เปิดหน้า คลิก รอ ดึงข้อมูล ถ่ายภาพหน้าจอ เวลาเริ่มใช้งานจนได้ผลลัพธ์แรกขึ้นอยู่กับประสบการณ์ของคุณ แต่แม้แต่นักพัฒนาที่เก่งอยู่แล้ว การทำให้สคริปต์ใหม่วิ่งกับเป้าหมายจริงก็มักใช้เวลานานกว่าการทำงานแบบคลิกแล้วใช้งาน
เมื่อเว็บไซต์เปลี่ยนโครงสร้าง คุณก็ต้องอัปเดต selector และตรรกะในโค้ด เอกสารของมันถูกเขียนมาสำหรับนักพัฒนา: มีตัวอย่างโค้ด, API reference และชุมชน GitHub ที่คึกคัก (ประมาณ 13,500+ stars ณ กลางปี 2026) สำหรับนักพัฒนา ความยืดหยุ่นแบบนี้คือจุดแข็ง — คุณควบคุมรายละเอียดของเซสชันเบราว์เซอร์ได้ทุกจุด
ตารางเปรียบเทียบสั้น ๆ: เส้นโค้งการเรียนรู้
| ปัจจัย | Thunderbit | Browserless |
|---|---|---|
| พื้นฐานทางเทคนิค | ไม่ต้องมี — ส่วนขยายเบราว์เซอร์ คลิกแล้วใช้งาน | JavaScript/Python, คุ้นกับ API |
| เวลาไปถึงผลลัพธ์แรก | ไม่กี่นาที (ติดตั้ง → AI Suggest → สแครป) | แล้วแต่ประสบการณ์: 15 นาทีถึง 1 ชั่วโมงขึ้นไป (API key → สคริปต์ → รัน) |
| การดูแลต่อเนื่อง | ต่ำกว่าสำหรับหน้าที่รองรับ (schema ช่วยด้วย AI) | สูงกว่า (ต้องดูแลสคริปต์ อัปเดต selector ในโค้ด) |
| รูปแบบเอกสาร | คู่มือแบบภาพ, บทเรียนสำหรับผู้ใช้ธุรกิจ | เอกสารนักพัฒนา, ตัวอย่างโค้ด, API reference |
| ชุมชน/ซัพพอร์ต | ช่องทางซัพพอร์ตโดยตรง | GitHub และชุมชนนักพัฒนาแบบแอ็กทีฟ |
ตรงนี้ไม่มีตัวไหน "ดีกว่า" แบบชนะขาด มันขึ้นอยู่กับว่าคุณเป็นใคร ผู้ใช้ที่ไม่ถนัดเทคนิคจะรู้สึกว่า Browserless เกินความจำเป็น ในขณะที่นักพัฒนาที่อยากควบคุมทุกอย่างอาจรู้สึกว่าอินเทอร์เฟซ no-code ของ Thunderbit จำกัดเกินไปสำหรับงานอัตโนมัติที่ซับซ้อน
ราคา Thunderbit vs Browserless: แต่ละตัวคิดเงินอย่างไร?
ราคาเป็นหนึ่งในปัจจัยตัดสินใจที่คนถามบ่อยที่สุด — และเป็นหนึ่งในสิ่งที่เปลี่ยนแปลงบ่อยที่สุดเช่นกัน ชื่อแพ็กเกจ ราคา และโควต้าอาจเปลี่ยนได้ ผมจะแชร์ข้อมูลที่ดีที่สุดเท่าที่มี ณ กลางปี 2026 แต่ คุณควรตรวจสอบหน้าราคาอย่างเป็นทางการของแต่ละเครื่องมืออีกครั้งก่อนตัดสินใจเสมอ
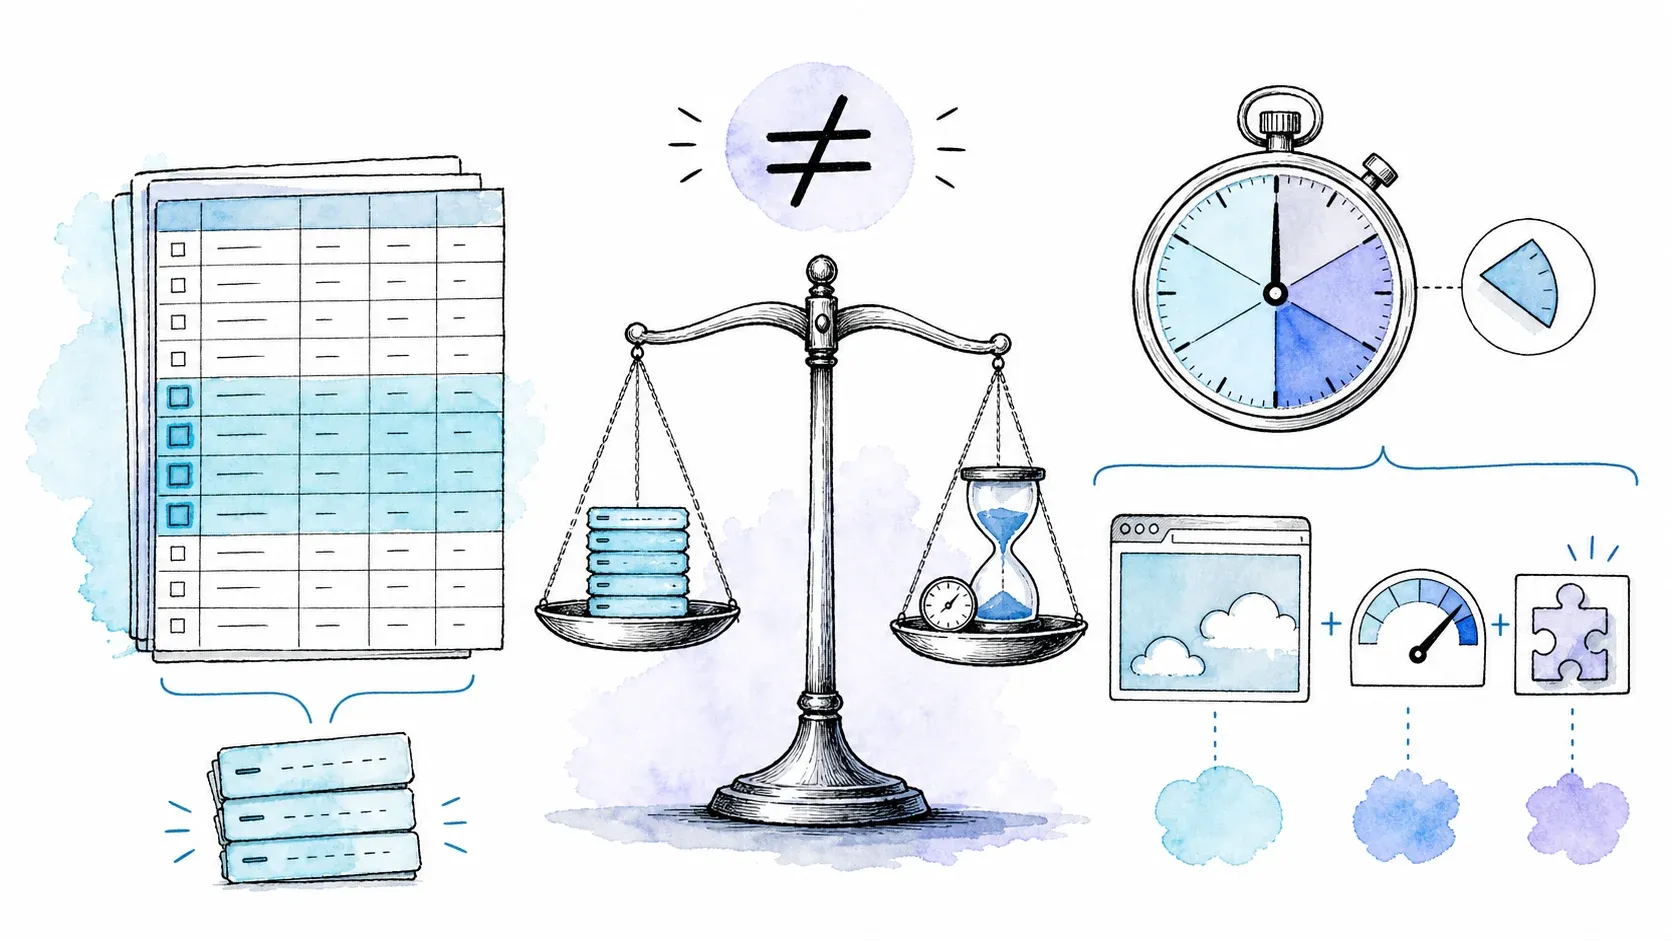
ความต่างเชิงโครงสร้างสำคัญมาก: Thunderbit คิดค่าบริการตาม page credits (ผูกกับจำนวนแถวผลลัพธ์และการทำงาน), ส่วน Browserless คิดตาม compute units (ผูกกับเวลาที่เซสชันเบราว์เซอร์รันและค่าบริการเสริมอย่าง bandwidth/CAPTCHA) หน่วยเหล่านี้ไม่สามารถใช้แทนกันได้ ดังนั้นการเทียบกันแบบดอลลาร์ต่อดอลลาร์ต้องรู้ลักษณะงานจริงของคุณก่อน
ภาพรวมราคา Thunderbit
สรุปจาก หน้าราคา Thunderbit:
| แพ็กเกจ | รายเดือน | รายปี (เฉลี่ยต่อเดือน) | เครดิต |
|---|---|---|---|
| Free | $0 | $0 | 6 pages/เดือน |
| Starter | $15/เดือน | ~$9/เดือน (ชำระรายปี) | 500/เดือน หรือ 5,000/ปี |
| Pro 1 | $38/เดือน | ~$24/เดือน (ชำระรายปี) | 3,000/เดือน หรือ 30,000/ปี |
| Pro 2 | $75/เดือน | ~$48/เดือน (ชำระรายปี) | 6,000/เดือน หรือ 60,000/ปี |
| Pro 3 | $125/เดือน | ~$96/เดือน (ชำระรายปี) | 10,000/เดือน หรือ 120,000/ปี |
| Pro 4 | $249/เดือน | ~$192/เดือน (ชำระรายปี) | 20,000/เดือน หรือ 240,000/ปี |
| Business | กำหนดเอง | กำหนดเอง | กำหนดเอง |
แถวผลลัพธ์มาตรฐานใช้ 1 เครดิต; แถวจากหน้าย่อยใช้ 2 เครดิต Thunderbit ยังมี ราคาแยกสำหรับ API สำหรับเวิร์กโฟลว์นักพัฒนา (Distill: 1 API unit/หน้า, Extract: 20 API units/หน้า) แพ็กเกจ Free ให้คุณลองเวิร์กโฟลว์ได้ แม้โควต้าจะค่อนข้างน้อย
ภาพรวมราคา Browserless
สรุปจาก หน้าราคา cloud ของ Browserless:
| แพ็กเกจ | รายปี (เฉลี่ยต่อเดือน) | รายเดือน | Units/เดือน | Concurrency (รายปี/รายเดือน) | ระยะเซสชันสูงสุด |
|---|---|---|---|---|---|
| Free | $0 | $0 | 1,000 | 2 / 2 | 1 นาที |
| Prototyping | $25/เดือน | $35/เดือน | 20,000 | 10 / 5 | 15 นาที |
| Starter | $140/เดือน | $200/เดือน | 180,000 | 40 / 30 | 30 นาที |
| Scale | $350/เดือน | $500/เดือน | 500,000 | 100 / 80 | 60 นาที |
| Enterprise | กำหนดเอง | กำหนดเอง | กำหนดเอง | กำหนดเอง | กำหนดเอง |
การเชื่อมต่อเบราว์เซอร์หนึ่งครั้งใช้ 1 unit ต่อทุกช่วง 30 วินาทีที่เริ่มต้น — ถ้าไม่ครบช่วงก็ปัดขึ้น ทราฟฟิกผ่าน residential proxy จะเพิ่ม 6 units/MB ส่วน datacenter proxy เพิ่ม 2 units/MB และการจัดการ CAPTCHA ก็ใช้ units เพิ่มเช่นกัน แพ็กเกจแบบเสียเงินมีค่า overage ที่ $0.0015–$0.0020/unit ส่วน Docker image แบบ self-hosted มีให้ใช้ภายใต้ไลเซนส์ SSPL/เชิงพาณิชย์คู่กัน แต่ image แบบโอเพ่นซอร์สจะไม่มีฟีเจอร์เชิงพาณิชย์ครบทั้งหมด (เช่น BrowserQL, stealth ขั้นสูง, replay ฯลฯ) และคุณก็ยังต้องออกค่าโครงสร้างพื้นฐานของตัวเองอยู่ดี
ตารางราคาเปรียบเทียบเคียงข้างกัน
| Thunderbit (No-Code) | Browserless (Cloud) | |
|---|---|---|
| ระดับฟรี | 6 pages/เดือน | 1,000 units |
| แพ็กเกจเริ่มต้น | $15/เดือน (Starter, 500 credits) | $25–$35/เดือน (Prototyping, 20,000 units) |
| ระดับกลาง | $38–$75/เดือน (Pro 1–2) | $140–$200/เดือน (Starter) |
| ระดับสูง | $125–$249/เดือน (Pro 3–4) | $350–$500/เดือน (Scale) |
| หน่วยคิดเงิน | Page credits (ผลลัพธ์เป็นแถว) | Compute units (ช่วง 30 วินาที + proxy/CAPTCHA) |
| Self-hosting | ไม่มี | มี (SSPL/ไลเซนส์เชิงพาณิชย์) |
ราคา Thunderbit ถูกออกแบบมาสำหรับผู้ใช้ธุรกิจที่อยากได้ต้นทุนต่อหน้าที่สแครปคาดการณ์ได้ ส่วน Browserless ถูกออกแบบมาสำหรับนักพัฒนาที่ต้องการเวลา compute สำหรับเซสชันเบราว์เซอร์ หากคุณพยายามเปรียบเทียบแบบต่อหนึ่งงาน คุณจะต้องประเมินว่าเวิร์กโฟลว์ของคุณกินเครดิตหรือยูนิตเท่าไร — และตัวเลขจะต่างกันมากระหว่างลิสต์ลีด 10 แถวกับการไล่เก็บข้อมูล 10,000 หน้า
Thunderbit vs Browserless: สรุปว่าแต่ละกรณีควรเลือกอะไร
นี่คือส่วนที่ผมอยากให้บทความเปรียบเทียบทุกชิ้นมี: คู่มือแบบใช้งานจริงว่า "เลือกตัวนี้ถ้า…" สำหรับแต่ละสถานการณ์ ผมจะให้ข้อสรุปพร้อมเหตุผลสั้น ๆ
| กรณีใช้งาน | ตัวที่เหมาะกว่า | เพราะอะไร |
|---|---|---|
| ดึงลีดขายจากไดเรกทอรี/ลิสต์บริษัท | Thunderbit | ไม่ต้องเขียนโค้ด, One Click Extract, ส่งออกไป Sheets/Excel/Airtable ได้ เซลส์ทำเองได้ในไม่กี่นาที |
| ทดสอบเบราว์เซอร์ใน CI/CD แบบสเกล | Browserless | สร้างมาสำหรับรัน Puppeteer/Playwright แบบโปรแกรมได้ มีหลายเซสชันพร้อมกัน เชื่อมกับ pipeline ได้ |
| วิจัยตลาดและติดตามคู่แข่ง | แล้วแต่ทีม | Thunderbit เหมาะกับการตั้งเวลาสแครปแบบ no-code; Browserless + สคริปต์เองเหมาะกับหน้าที่เรนเดอร์ซับซ้อน |
| การโต้ตอบกับเว็บของ AI agent (Claude, LangChain) | แล้วแต่ทีม | Thunderbit ผ่าน MCP/API เหมาะกับการดึงข้อมูลเป็นโครงสร้าง; Browserless ผ่าน REST/WebSocket เหมาะกับการคุมเบราว์เซอร์แบบดิบ ๆ |
| เว็บไซต์ที่มีระบบกันบอท/ CAPTCHA หนัก | Browserless | มี BrowserQL stealth, proxies, การจัดการ CAPTCHA — แม้ไม่มีเครื่องมือไหนรับประกันการเข้าถึงได้ก็ตาม |
การดึงลีดขาย
ถ้าคุณอยู่ทีมขาย ปฏิบัติการ หรือสรรหา และต้องการรายชื่อคน อีเมล หรือข้อมูลบริษัทจากไดเรกทอรีหรือหน้ารายการ Thunderbit คือเส้นทางที่ตรงกว่า คุณเปิดหน้าเว็บ ให้ AI ช่วยแนะนำฟิลด์ สแครป แล้วส่งออกไป Google Sheets หรือ Airtable ได้เลย ไม่ต้องเขียนสคริปต์ ไม่ต้องตั้งโครงสร้างพื้นฐาน Browserless ก็ทำได้ในทางเทคนิค แต่คุณต้องเขียนและดูแลสคริปต์เฉพาะขึ้นมาเอง — สำหรับผู้ใช้ธุรกิจส่วนใหญ่ นั่นคือสิ่งที่ไม่เหมาะตั้งแต่ต้น (อ่านเพิ่มเติมได้จากคู่มือ AI lead generation ของเรา)
การทดสอบเบราว์เซอร์ใน CI/CD และ QA Automation
Browserless ถูกสร้างมาเพื่อสิ่งนี้ ถ้าทีมของคุณรันทดสอบเบราว์เซอร์อัตโนมัติใน CI/CD pipeline คุณต้องการเซสชัน headless browser หลายตัวพร้อมกัน ไม่ใช่ UI สำหรับดึงข้อมูล Thunderbit ไม่ได้ออกแบบมาสำหรับ use case นี้
การวิจัยตลาดและติดตามคู่แข่ง
ขึ้นอยู่กับทีมของคุณ ถ้าคุณมีนักวิเคราะห์ที่ไม่ถนัดเทคนิคแต่ต้องติดตามราคาคู่แข่งหรือรายการสินค้า Thunderbit ที่มีการตั้งเวลาดึงข้อมูล (ในแพ็กเกจที่รองรับ) พร้อมส่งออกตรง ๆ จะง่ายกว่า แต่ถ้าหน้าเว็บเป้าหมายเรนเดอร์หนัก ต้องมีการโต้ตอบซับซ้อน หรือจำเป็นต้องใช้ stealth ขั้นสูง นักพัฒนาที่ใช้ Browserless กับสคริปต์เฉพาะจะควบคุมได้มากกว่า (ถ้าคุณอยากอ่านเพิ่มเติมเรื่อง เว็บสแครปแบบไม่เขียนโค้ด เรามีคู่มืออีกฉบับหนึ่ง)
การโต้ตอบเว็บของ AI agent
ทั้งสองเครื่องมือมี MCP integration และ API สำหรับเวิร์กโฟลว์ของ agent Thunderbit’s MCP Server และ API จะเน้นงานดึงข้อมูลแบบมีโครงสร้าง — agent ขอข้อมูล แล้ว Thunderbit ส่งกลับมาเป็นแถวที่สะอาด ส่วน MCP และ agent SDK connections ของ Browserless จะเน้นการคุมเบราว์เซอร์แบบดิบ — agent เป็นคนเปิดหน้า คลิก กรอกฟอร์ม หรือจัดการการโต้ตอบซับซ้อนบนหน้าเว็บ ทางเลือกที่เหมาะขึ้นอยู่กับว่า agent ของคุณต้องการข้อมูลที่เป็นโครงสร้าง หรืออยากคุมเบราว์เซอร์เต็มรูปแบบ
เว็บไซต์ที่มีระบบกันบอทและ CAPTCHA หนัก
Browserless มีตัวควบคุมที่ชัดเจนกว่าในจุดนี้: BrowserQL stealth mode, การสุ่ม fingerprint, residential และ datacenter proxies และการจัดการ CAPTCHA ส่วน Thunderbit จะใช้การเรนเดอร์แบบบริหารจัดการให้ในหน้าที่รองรับ แต่ไม่ได้ถูกออกแบบมาเป็นเครื่องมือหลบระบบตรวจจับบอทแบบใช้งานทั่วไป เอกสารของ Browserless เองก็ยอมรับว่า fingerprinting ขั้นสูงหรือ CAPTCHA แบบโต้ตอบได้ยังคงอาจบล็อกระบบอัตโนมัติได้อยู่ — ไม่มีเครื่องมือไหนรับประกันว่าจะสำเร็จทุกเว็บไซต์
เมื่อคุณอาจใช้ทั้งสองตัว: เวิร์กโฟลว์ที่เสริมกัน
บทความเปรียบเทียบส่วนใหญ่จะข้ามเรื่องนี้ไป แต่จริง ๆ แล้วคุณไม่จำเป็นต้องเลือกแค่อย่างเดียว
หลายองค์กรมีความต้องการข้อมูลทั้งฝั่งเทคนิคและไม่ใช่เทคนิค นักพัฒนาในทีมอาจใช้ Browserless เพื่อจัดการหน้าเว็บที่เรนเดอร์ซับซ้อน รันทดสอบเบราว์เซอร์ หรือสร้าง data pipeline สำหรับการดึงข้อมูลขนาดใหญ่ ขณะเดียวกันนักวิเคราะห์ธุรกิจหรือเซลส์ก็ใช้ Thunderbit browser extension สำหรับการดึงข้อมูลแบบรวดเร็วเฉพาะกิจ — เช่น ดึงรายชื่อลีดจากไดเรกทอรีใหม่ เช็กราคาคู่แข่งแบบ spot-check หรือดึงข้อมูลเสริมจากแหล่งที่ไม่คุ้มจะเปิดโปรเจกต์พัฒนาเต็มรูปแบบ
อีกสถานการณ์หนึ่ง: นักพัฒนาสร้างระบบ crawl แบบตั้งเวลาไว้ด้วย Browserless สำหรับการติดตามต่อเนื่อง แล้วคนในทีมปฏิบัติการใช้ Thunderbit ไปดึงข้อมูลจากแหล่งใหม่ที่เพิ่งถูกพูดถึงในที่ประชุม — ไม่ต้องเปิดทิกเก็ต ไม่ต้องรอ ไม่ต้องรีวิวโค้ด
นี่ไม่ใช่การขายเพิ่มแบบฝืน ๆ — แต่มันคือวิธีที่ทีมผสมทำงานกันจริง ๆ ถ้าในทีมคุณมีทั้งคนเขียนโค้ดและไม่เขียนโค้ดที่ต้องใช้ข้อมูลจากเว็บ การใช้ทั้งสองเครื่องมือให้ตรงกับจุดแข็งของแต่ละตัวจะช่วยประหยัดเวลาได้มาก
Thunderbit vs Browserless: สรุปข้อดีข้อเสีย
Thunderbit: ข้อดีและข้อจำกัด
ข้อดี:
- งานหลักไม่ต้องเขียนโค้ด
- One Click Extract อ่านหน้าและเสนอ schema ที่มีโครงสร้างให้
- ได้ผลลัพธ์แรกเร็วมากสำหรับผู้ใช้ที่ไม่ถนัดเทคนิค
- ส่งออกตรงไปยังรูปแบบที่เหมาะกับงานธุรกิจ (Excel, Google Sheets, Airtable, Notion)
- ใช้งานผ่านส่วนขยายเบราว์เซอร์บนหน้าที่คุณกำลังเปิดอยู่
- ดูแลน้อยกว่าสำหรับหน้าที่รองรับ (AI ช่วยแนะนำ schema)
- มี API, MCP และ CLI สำหรับเวิร์กโฟลว์นักพัฒนา
ข้อจำกัด:
- ไม่ได้ออกแบบมาสำหรับ workflow แบบ CI/CD หรือการทดสอบเบราว์เซอร์
- ความยืดหยุ่นน้อยกว่าสำหรับตรรกะเฉพาะทางที่ซับซ้อน หรือการทำงานหลายขั้นตอนบนเบราว์เซอร์
- ไม่มีตัวเลือก self-hosting
- การดึงข้อมูลแบบเอเจนต์อาจต้องปรับเองในหน้าเว็บที่แปลกหรือซับซ้อน
- ชุมชนนักพัฒนามีขนาดเล็กกว่า Browserless
Browserless: ข้อดีและข้อจำกัด
ข้อดี:
- ควบคุมเซสชันเบราว์เซอร์ได้เต็มรูปแบบแบบโปรแกรม
- รองรับ Puppeteer, Playwright และ client ที่รองรับ CDP
- มีเครื่องมือหลบการตรวจจับบอทขั้นสูง (BrowserQL stealth, proxies, CAPTCHA handling)
- มีตัวเลือก self-hosted สำหรับความเป็นส่วนตัวของข้อมูลและการควบคุมโครงสร้างพื้นฐาน
- สเกล concurrency ได้สำหรับงานปริมาณมาก (ขึ้นอยู่กับแพ็กเกจ)
- ชุมชนนักพัฒนาแข็งแรง (~13,500+ GitHub stars)
- มีการเชื่อมต่อกับ MCP, n8n, Make, Zapier และ agent SDKs
- มีการอ้างว่าสอดคล้องกับ SOC 2 Type II (Trust Center)
ข้อจำกัด:
- งานหลักต้องมีทักษะเขียนโค้ด
- ดูแลรักษามากกว่า (สคริปต์พังเมื่อเว็บไซต์เป้าหมายเปลี่ยน)
- เส้นทางการเรียนรู้ชันกว่าสำหรับคนที่ไม่ใช่นักพัฒนา
- ผลลัพธ์มักต้องมีตรรกะเพิ่มเติมเพื่อจัดโครงสร้างและส่งออก (ไม่มี agentic extraction หรือ visual table แบบถาวรในตัว)
- การ self-hosting ทำให้ภาระเรื่องโครงสร้างพื้นฐาน การอัปเดต การเฝ้าระวัง และไลเซนส์ตกอยู่ที่ผู้ใช้งาน
- ใช้ไลเซนส์คู่ SSPL/เชิงพาณิชย์สำหรับ image แบบโอเพ่นซอร์ส — ไม่ใช่โอเพ่นซอร์สที่ได้รับการรับรองจาก OSI
บทสรุป: จะเลือกเครื่องมือให้ทีมอย่างไร
Thunderbit และ Browserless แก้ปัญหาคนละแบบให้คนละกลุ่ม Thunderbit เหมาะกับผู้ใช้ธุรกิจที่ต้องการข้อมูลแบบมีโครงสร้างอย่างรวดเร็ว ไม่ต้องเขียนโค้ด และส่งออกไปยังเครื่องมือที่ใช้อยู่แล้ว Browserless เหมาะกับนักพัฒนาที่ต้องการโครงสร้างพื้นฐานเบราว์เซอร์ที่สเกลได้ เขียนโปรแกรมได้ และควบคุมทุกอย่างที่เกิดขึ้นในเบราว์เซอร์ได้เต็มที่
นี่คือแนวทางตัดสินใจแบบสั้น ๆ:
- เลือก Thunderbit ถ้า: คุณอยู่ฝ่ายขาย ปฏิบัติการ การตลาด หรือวิจัย; คุณไม่เขียนโค้ด; คุณอยากได้ข้อมูลลงสเปรดชีตหรือ Airtable ภายในไม่กี่นาที; คุณต้องการการเลือกฟิลด์ด้วย AI และส่งออกตรง ๆ (ลองใช้ที่นี่)
- เลือก Browserless ถ้า: คุณเป็นนักพัฒนาหรือวิศวกร DevOps; คุณเขียนสคริปต์ Puppeteer/Playwright; คุณต้องการทดสอบเบราว์เซอร์, การหลบระบบกันบอท, ภาพหน้าจอ/PDF หรือโครงสร้างพื้นฐานแบบ self-hosted (ดูแพลตฟอร์มของเขา)
- พิจารณาใช้ทั้งสองตัวถ้า: ทีมของคุณมีทั้งสมาชิกสายเทคนิคและไม่ใช่เทคนิค และต้องการให้แต่ละกลุ่มใช้เครื่องมือที่ตรงกับเวิร์กโฟลว์ของตัวเอง
ไม่มีผู้ชนะที่ชนะทุกกรณี — มีเพียงเครื่องมือที่เหมาะกับงานนั้นที่สุด
คำถามที่พบบ่อย: Thunderbit vs Browserless
Thunderbit แทน Browserless ได้ไหม หรือกลับกัน?
แทนกันตรง ๆ ไม่ได้ เพราะทั้งสองตัวมีผู้ใช้และกรณีใช้งานต่างกัน Thunderbit เป็นแพลตฟอร์มการดึงข้อมูลแบบบริหารจัดการให้สำหรับผู้ใช้ธุรกิจที่ต้องการข้อมูลแบบมีโครงสร้างโดยไม่ต้องเขียนโค้ด ส่วน Browserless คือโครงสร้างพื้นฐานเบราว์เซอร์ที่โปรแกรมได้สำหรับนักพัฒนาที่ต้องการควบคุมเบราว์เซอร์แบบกำหนดเอง จุดที่ทับซ้อนกันคือการสแครปเว็บพื้นฐาน แต่แนวทาง หน้าตา และผลลัพธ์ต่างกันโดยสิ้นเชิง เซลส์ไม่ใช้ Browserless เพื่อทำลิสต์ลีด และนักพัฒนาก็ไม่ใช้ Thunderbit สำหรับการทดสอบเบราว์เซอร์ใน CI/CD
ต้องมีทักษะเขียนโค้ดไหมถึงจะใช้ Thunderbit ได้?
ไม่ต้อง ตัว Web App และส่วนขยายเบราว์เซอร์ถูกออกแบบมาสำหรับผู้ใช้ที่ไม่ถนัดเทคนิค — ติดตั้ง เปิดหน้าเว็บ กด One Click Extract ปล่อยให้เริ่มอัตโนมัติ แล้วส่งออกข้อมูลได้เลย สำหรับนักพัฒนาที่ต้องการใช้แบบโปรแกรม Thunderbit ก็มี Open API, MCP Server และ CLI
Browserless ส่งออกข้อมูลไป Google Sheets หรือ Excel ได้ไหม?
ไม่ได้แบบ native Browserless จะส่งออกผลจากเบราว์เซอร์ — HTML ที่เรนเดอร์แล้ว, JSON ที่มีโครงสร้าง (ผ่าน Smart Scrape, BrowserQL หรือฟังก์ชันกำหนดเอง), ภาพหน้าจอ, PDF หากต้องการเอาข้อมูลไปลงสเปรดชีต คุณต้องเขียนโค้ดเพิ่มเติมหรือใช้เครื่องมืออื่นมาช่วยจัดโครงสร้างและส่งออกข้อมูล Thunderbit ในทางกลับกัน มีการส่งออกไปยัง Excel, Google Sheets, Airtable และ Notion ในตัว
Browserless ใช้ฟรีได้ไหม?
Browserless มี ระดับฟรีที่ให้ 1,000 units ต่อเดือน (ไม่ใช่ 1,000 เซสชัน — เซสชันเดียวอาจใช้หลาย units) Docker image แบบโอเพ่นซอร์สสามารถนำไป self-host ได้ แต่ใช้ไลเซนส์แบบ SSPL/เชิงพาณิชย์คู่กัน และไม่ได้รวมฟีเจอร์เชิงพาณิชย์ทั้งหมด แพ็กเกจที่เสียเงินจะเพิ่ม units, concurrency และความสามารถอื่น ๆ ตรวจสอบ หน้าราคาอย่างเป็นทางการ เพื่อดูข้อมูลล่าสุด
เครื่องมือไหนดีกว่าสำหรับการสแครป LinkedIn หรือเว็บไซต์ที่มีการป้องกันคล้ายกัน?
ไม่มีเครื่องมือไหนรับประกันการเข้าถึงเว็บไซต์ใดเว็บไซต์หนึ่งได้เสมอ โปรดเคารพข้อกำหนดการใช้งานของแพลตฟอร์ม เงื่อนไขการอนุญาต และกฎหมายที่เกี่ยวข้องเสมอ ฟีเจอร์ stealth และการจัดการ CAPTCHA ของ Browserless ถูกออกแบบมาเพื่อลดปัญหาการตรวจจับบอท ขณะที่ Browser Mode ของ Thunderbit สามารถทำงานภายในเซสชันเบราว์เซอร์ local ที่ได้รับอนุญาตได้ สำหรับเว็บไซต์ที่มีการป้องกัน สิ่งสำคัญที่สุดคือคุณมีสิทธิ์เข้าถึงอย่างถูกต้องและใช้งานภายใต้กฎของแพลตฟอร์มหรือไม่ ไม่ใช่ว่าคุณใช้เครื่องมือสแครปตัวไหน (อ่านบริบทเพิ่มเติมได้จากโพสต์ scraping LinkedIn ของเรา)
เรียนรู้เพิ่มเติม




