
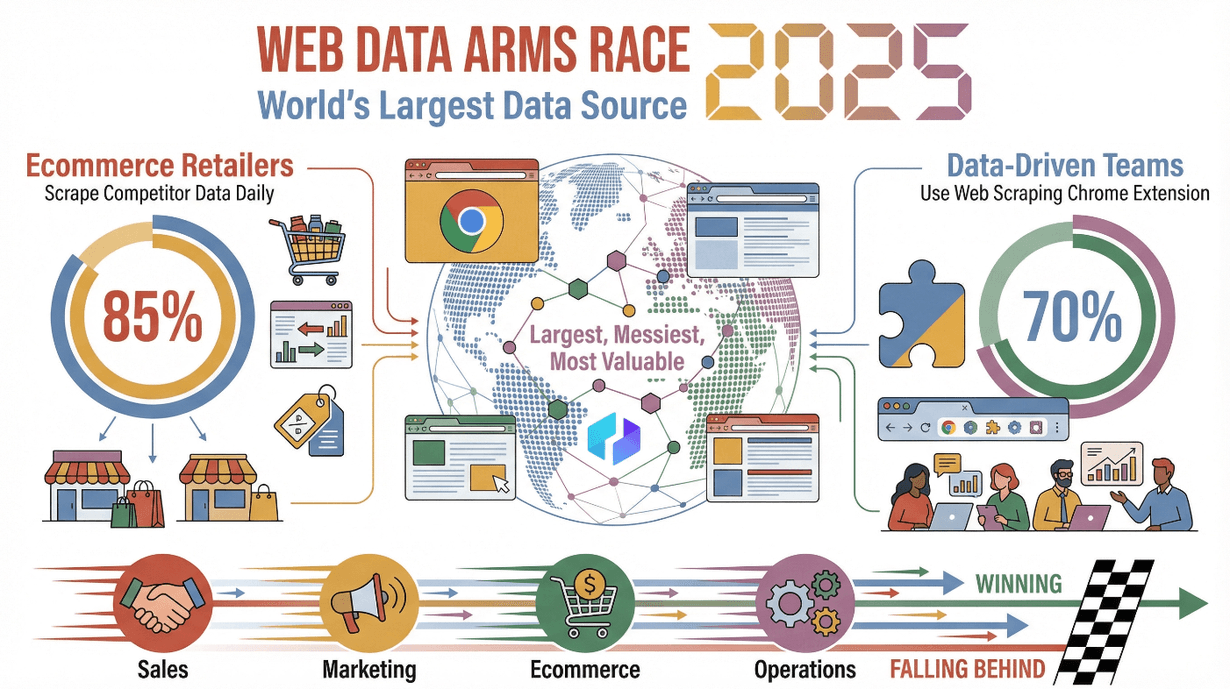
เว็บไม่ได้เป็นแค่ที่ไว้ดูคลิปแมวหรือมีมอีกต่อไป—แต่มันกลายเป็นแหล่งข้อมูลที่ใหญ่ที่สุด ซับซ้อนที่สุด และมีมูลค่ามหาศาลของโลก ธุรกิจต่าง ๆ กำลังแข่งกันอย่างดุเดือดในสนามข้อมูล: ผู้ค้าปลีกเช็กราคาคู่แข่งทุกวัน และทีมที่ขับเคลื่อนด้วยข้อมูลก็หันมาใช้ส่วนขยายเบราว์เซอร์แทนการเปิดทิกเก็ตให้วิศวกรกันมากขึ้น ไม่ว่าคุณจะอยู่ในฝ่ายขาย การตลาด อีคอมเมิร์ซ หรือฝ่ายปฏิบัติการ การได้ข้อมูลที่ถูกต้อง รวดเร็ว และอยู่ในรูปแบบพร้อมใช้งาน อาจเป็นตัวตัดสินได้เลยว่าคุณจะนำหน้าหรือตามหลัง
 แต่ปัญหาก็คือ เว็บไซต์ต่าง ๆ ไม่ได้ปูพรมแดงรอให้คุณดึงข้อมูลแบบง่าย ๆ พวกมันมักจะยุ่งเหยิง เปลี่ยนตลอดเวลา และถูกออกแบบมาเพื่อให้คนอ่านมากกว่าสเปรดชีต นี่แหละคือหน้าที่ของเครื่องมือ web scraping ที่จะเปลี่ยนความวุ่นวายให้กลายเป็นตารางข้อมูลที่สะอาด เป็นระเบียบ และใช้งานได้จริง ผมทำงานในสาย SaaS และระบบอัตโนมัติมาหลายปี และเห็นกับตาตัวเองว่าการเลือกเครื่องมือที่เหมาะสามารถประหยัดเวลา เพิ่มความแม่นยำ และปลดล็อกอินไซต์ที่คุณอาจไม่เคยเห็นมาก่อน
แล้วในปี 2025 เครื่องมือ web scraping ตัวไหนคุ้มเวลาจริง ๆ? ผมรวบรวมมาให้แล้ว 9 ตัวที่ดีที่สุด—ตั้งแต่ส่วนขยาย Chrome ที่ขับเคลื่อนด้วย AI สำหรับผู้ใช้ธุรกิจ ไปจนถึงเฟรมเวิร์กโอเพนซอร์สสำหรับนักพัฒนา มาดูกันเลย
ทำไมเครื่องมือ Web Scraping จึงสำคัญต่อธุรกิจยุคใหม่
ดึงข้อมูลจากเว็บไซต์ใดก็ได้ด้วย AI Get Started Free
เครื่องมือ web scraping คือเบื้องหลังของการขายที่ฉลาดขึ้น การตลาดที่คมขึ้น และงานปฏิบัติการที่ลื่นไหลกว่าเดิม นี่คือเหตุผลที่มันสำคัญมาก:
- การหาลีด: ทีมขายใช้การดึงข้อมูลจากไดเรกทอรี LinkedIn และเว็บไซต์รีวิว เพื่อสร้างรายชื่อลีดแบบเจาะจง
- การวิเคราะห์คู่แข่ง: ทีมการตลาดและอีคอมเมิร์ซติดตามราคาสินค้า การเปิดตัวสินค้า และตำแหน่งโฆษณาของคู่แข่ง—หลายครั้งแบบเรียลไทม์
- การวิจัยตลาด: นักวิจัยและนักวิเคราะห์รวบรวมรีวิว ข่าว และความเห็นของผู้ใช้ เพื่อจับเทรนด์ให้ได้ก่อนคู่แข่ง
- การติดตามราคา: ผู้ค้าปลีกและแบรนด์ต่าง ๆ ตรวจสอบราคาและสต็อกสินค้าจากหลายร้อยเว็บไซต์ เพื่อรักษาความสามารถในการแข่งขัน (Kanhasoft)
- การรวบรวมคอนเทนต์: ทีมปฏิบัติการดึงข้อมูลจากเว็บหางาน รายการอสังหาริมทรัพย์ หรือแคตตาล็อกซัพพลายเออร์ เพื่อทำให้เวิร์กโฟลว์ราบรื่นขึ้น
ภาพรวมสั้น ๆ ว่าเครื่องมือ web scraping ช่วยขับเคลื่อนผลลัพธ์ทางธุรกิจได้อย่างไร:
| กรณีใช้งานทางธุรกิจ | ปัญหาเมื่อทำด้วยมือ | ทางออกด้วย Web Scraping |
|---|---|---|
| การหาลีด | คัดลอกวางจากหลายสิบเว็บไซต์ | ดึงข้อมูลอัตโนมัติ ส่งออกเป็นชุด |
| การติดตามราคา | ตรวจสอบด้วยมือทุกวัน | สแครปตามเวลา แจ้งเตือนทันที |
| การวิจัยตลาด | อ่านรีวิวหลายร้อยรายการ | รวมข้อมูลเป็นชุดข้อมูลที่มีโครงสร้าง |
| การรวบรวมคอนเทนต์ | รวมข้อมูลจากหลายเว็บไซต์ | ส่งออกเป็น Excel/Sheets แบบรวมศูนย์ |
| การวิเคราะห์คู่แข่ง | ข้อมูลช้าและไม่ครบถ้วน | อินไซต์แบบเรียลไทม์ ครอบคลุมทุกมิติ |
ผลตอบแทนคุ้มค่าแบบเห็น ๆ: ทีมที่นำเครื่องมือสแครปยุคใหม่มาใช้ มักย่นเวลาวิจัยและเก็บข้อมูลจากหลายวันให้เหลือแค่ไม่กี่ชั่วโมง และทีมขายก็นำข้อมูลที่สแครปมาใช้ปรับข้อความนำเสนอให้ตรงใจลูกค้ามากขึ้นได้เป็นประจำ
เราเลือกเครื่องมือ Web Scraping ที่ดีที่สุดอย่างไร
เครื่องมือ web scraping ไม่ได้เหมือนกันทุกตัว บางตัวสร้างมาเพื่อผู้ใช้ธุรกิจที่อยากได้ผลลัพธ์โดยไม่ต้องเขียนโค้ดเลย บางตัวเป็นสนามของนักพัฒนาที่ต้องการโปรเจกต์ขนาดใหญ่และปรับแต่งได้เต็มที่ เกณฑ์ที่ผมใช้ในการคัดมีดังนี้:
- ใช้งานง่าย: คนไม่เขียนโค้ดเริ่มใช้ได้เร็วไหม? หน้าตาใช้งานเข้าใจง่ายหรือเปล่า?
- รองรับการขยายตัว: ทำงานกับหลายร้อยหรือหลายล้านหน้าได้ไหม? ตั้งเวลาและทำงานอัตโนมัติได้หรือไม่?
- ตัวเลือกการส่งออกข้อมูล: ส่งออกไป Excel, Google Sheets, Airtable, Notion หรือผ่าน API ได้ไหม?
- การซัพพอร์ตและคอมมูนิตี้: มีเอกสาร คู่มือ วิดีโอสอน และทีมซัพพอร์ตที่ตอบไวไหม?
- ราคาและความคุ้มค่า: มีแพ็กเกจฟรีไหม? แพ็กเกจแบบเสียเงินโปร่งใสและสมเหตุสมผลหรือเปล่า?
- ฟีเจอร์เด่นเฉพาะตัว: การดึงข้อมูลด้วย AI, การสแครปหน้าย่อย, การเชื่อมต่อ API หรือเวิร์กโฟลว์แบบเห็นภาพ
ผมยังจับคู่แต่ละเครื่องมือกับสถานการณ์ธุรกิจที่เหมาะที่สุดไว้ด้วย เพื่อให้คุณหาเครื่องมือที่ตรงกับความต้องการและระดับทักษะทางเทคนิคของตัวเองได้ง่ายขึ้น
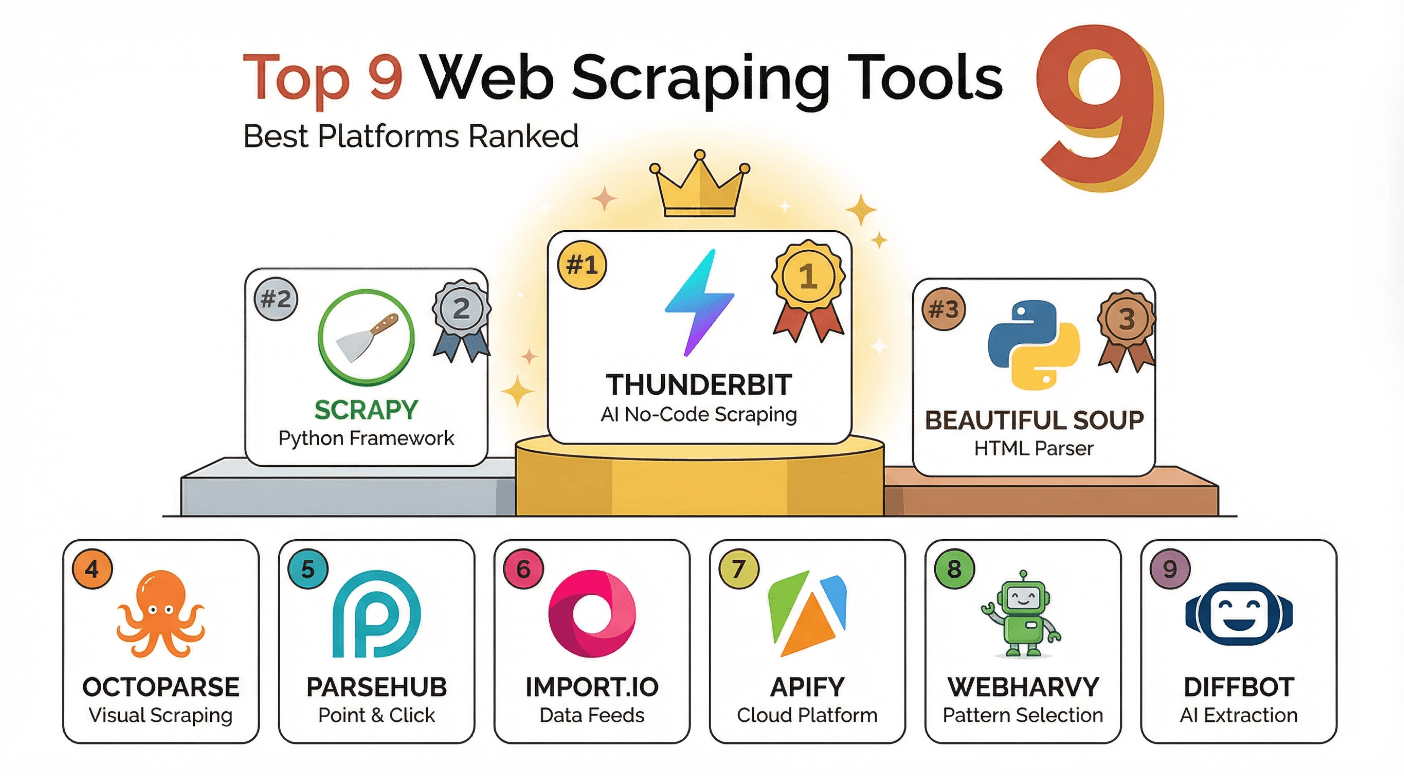
1. Thunderbit
Thunderbit คืออันดับหนึ่งของผมสำหรับผู้ใช้งานธุรกิจที่อยากทำ web scraping ด้วย AI โดยไม่ต้องปวดหัวกับเรื่องเทคนิค ในฐานะส่วนขยาย Chrome Thunderbit ถูกออกแบบมาสำหรับทีมขาย การตลาด อีคอมเมิร์ซ และปฏิบัติการ ที่ต้องการข้อมูลแม่นยำ เป็นโครงสร้าง และได้เร็ว
อะไรที่ทำให้ Thunderbit แตกต่าง? คำตอบคือความเรียบง่ายที่มาพร้อมพลังการทำงาน:
- AI ช่วยแนะนำฟิลด์: คลิก “AI Suggest Fields” แล้ว Thunderbit จะอ่านหน้าเว็บ แนะนำคอลัมน์ที่ควรดึง เช่น ชื่อ ราคา อีเมล และยังสร้างพรอมป์ต์สำหรับการดึงข้อมูลในแต่ละฟิลด์ให้อีกด้วย
- สแครปหน้าย่อย: ถ้าต้องการข้อมูลเชิงลึกมากขึ้น AI ของ Thunderbit สามารถเข้าไปดูแต่ละหน้าย่อย เช่น หน้าสินค้าหรือหน้าโปรไฟล์ แล้วเติมข้อมูลลงในตารางให้ครบได้เลย โดยไม่ต้องตั้งค่าเพิ่ม
- ส่งออกได้ทันที: ส่งข้อมูลไปยัง Excel, Google Sheets, Airtable หรือ Notion โดยตรง การส่งออกฟรีเสมอ
- สแครปตามกำหนดเวลา: ทำงานซ้ำ ๆ เช่น เช็กราคาทุกวัน ให้เป็นอัตโนมัติด้วยการตั้งเวลาผ่านภาษาธรรมชาติ
- ตัวแยกอีเมล โทรศัพท์ และรูปภาพฟรี: ดึงข้อมูลติดต่อหรือรูปภาพจากเว็บไซต์ใดก็ได้ในคลิกเดียว
- AI Autofill: ให้ AI กรอกฟอร์มออนไลน์แทนคุณ—เหมาะมากสำหรับเวิร์กโฟลว์และงานที่ต้องทำซ้ำ
Thunderbit ได้รับความไว้วางใจจากผู้ใช้กว่า 200,000 คนทั่วโลก และ แพ็กเกจฟรี ให้คุณสแครปได้สูงสุด 6 หน้า/เดือน ส่วนแพ็กเกจเสียเงินเริ่มที่เพียง $15/เดือน สำหรับ 500 เครดิต—เหมาะกับทีมทุกขนาด
ถ้าอยากเห็น Thunderbit ใช้งานจริง ลองดู YouTube Channel ของเรา หรือเข้าไปอ่าน blog สำหรับบทความสอนใช้งานและทิปต่าง ๆ
2. Scrapy
Scrapy คือเฟรมเวิร์กโอเพนซอร์สที่นักพัฒนาหลายคนเลือกใช้เมื่อต้องการควบคุมโปรเจกต์ web scraping อย่างเต็มที่ เขียนด้วย Python ทำให้คุณสร้างสไปเดอร์แบบกำหนดเองเพื่อ crawl ดึงข้อมูล และประมวลผลข้อมูลในสเกลใหญ่ได้
ทำไมนักพัฒนาถึงชอบ Scrapy?
- เฟรมเวิร์กทรงพลัง: รองรับการ crawl ซับซ้อนหลายชั้น ท่อประมวลผลแบบกำหนดเอง และการเชื่อมต่อกับ API
- ขยายสเกลได้ดี: รองรับโปรเจกต์ขนาดใหญ่ คำขอแบบพร้อมกันหลายรายการ และสแครปหลายหน้าได้พร้อมกัน (ZenRows)
- ต่อยอดได้: ใส่ middleware สำหรับ proxy, user agent หรือการเรนเดอร์ JavaScript (ด้วย Splash)
- คอมมูนิตี้แข็งแรง: มีคู่มือ ปลั๊กอิน และการช่วยเหลือจำนวนมากสำหรับงานขั้นสูง
Scrapy เหมาะที่สุดสำหรับทีมที่มีทักษะ Python และต้องการสแครปในระดับใหญ่ เชื่อมเข้ากับ data pipeline หรือสร้างเวิร์กโฟลว์ที่เสถียรและทำซ้ำได้ มันเป็นโอเพนซอร์สและใช้ฟรี—but คุณต้องตั้งค่าสภาพแวดล้อมเองและดูแลโค้ดด้วยตัวเอง
3. Beautiful Soup
Beautiful Soup คือไลบรารี Python ที่มือใหม่ชอบมาก เพราะใช้งานง่ายแต่ทรงพลังสำหรับการแยกวิเคราะห์ HTML และ XML ถ้าคุณต้องการดึงข้อมูลจากหน้าเว็บแบบ static อย่างรวดเร็ว Beautiful Soup คือเพื่อนที่ไว้ใจได้
ทำไมถึงเลือก Beautiful Soup?
- เป็นมิตรกับมือใหม่: เรียนรู้ได้ง่าย เส้นโค้งการเรียนรู้ไม่ชัน และมีบทเรียนให้ศึกษาเยอะ (ScraperAPI)
- แยกวิเคราะห์ได้ยืดหยุ่น: รับมือกับ HTML ที่เลอะเทอะหรือเสียรูปได้ดี
- เหมาะกับโปรเจกต์เล็ก: เหมาะสำหรับสคริปต์ครั้งเดียว งานดึงข้อมูลด่วน ๆ หรือใช้เรียนรู้พื้นฐานของ web scraping
ข้อจำกัดล่ะ? Beautiful Soup ไม่ได้ออกแบบมาสำหรับไซต์ขนาดใหญ่หรือเว็บที่เปลี่ยนแปลงตลอดเวลา และไม่รองรับ JavaScript ถ้าเจอสถานการณ์แบบนั้น คุณอาจต้องใช้ร่วมกับ requests หรือ Selenium หรือก้าวไปใช้ Scrapy เลย
4. Octoparse
Octoparse คือเครื่องมือ web scraping แบบ no-code ที่ออกแบบมาสำหรับทุกคน ตั้งแต่ผู้ประกอบการเดี่ยวไปจนถึงทีมระดับองค์กร อินเทอร์เฟซแบบคลิกเลือกทำให้ดึงข้อมูลจากเว็บไซต์ที่ซับซ้อนหรือเปลี่ยนแปลงตลอดเวลาได้ง่าย
ทำไมผู้ใช้ถึงชอบ Octoparse:
- ไม่ต้องเขียนโค้ด: ตัวสร้างเวิร์กโฟลว์แบบภาพ ลากวางตัวเลือก และเทมเพลตสำเร็จรูป
- โหมด Cloud และ Local: รันงานสแครปบนเดสก์ท็อปหรือบนคลาวด์ เพื่อให้ได้งานที่เร็วและใหญ่ขึ้น
- รองรับ Pagination และคอนเทนต์แบบไดนามิก: สแครปหน้าที่มี “Load more” แบบเลื่อนยาวไม่สิ้นสุด และเว็บไซต์ AJAX
- ตัวเลือกการส่งออก: ดาวน์โหลดเป็น CSV, Excel, JSON, HTML หรือส่งออกไปยังฐานข้อมูล (Octoparse Pricing)
แพ็กเกจฟรีของ Octoparse ครอบคลุมงานขนาดเล็ก ส่วนแพ็กเกจเสียเงินเริ่มราว $69/เดือนสำหรับการใช้งานหนัก เป็นที่นิยมมากในงานวิจัยตลาด การวิเคราะห์คู่แข่ง และใครก็ตามที่อยากได้ผลลัพธ์โดยไม่ต้องเขียนโค้ด
5. ParseHub
ParseHub คือเครื่องมือสแครปแบบภาพที่โดดเด่นมากบนเว็บไซต์ที่ใช้ JavaScript หนัก ๆ และเว็บไซต์แบบไดนามิก ตัวสร้างเวิร์กโฟลว์ของมันให้คุณคลิก วนลูป และดึงข้อมูลแบบมีเงื่อนไขได้—even จากเว็บที่ซับซ้อน
ฟีเจอร์เด่นของ ParseHub:
- เลือกข้อมูลแบบเห็นภาพ: คลิกเลือกองค์ประกอบ วนลูปผ่านรายการ และจัดการหน้าย่อยแบบซ้อนกันได้
- รองรับคอนเทนต์แบบไดนามิก: ดึงข้อมูลที่โหลดด้วย JavaScript จัดการดรอปดาวน์ และสั่งคลิกอัตโนมัติได้
- ส่งออกยืดหยุ่น: ดาวน์โหลดเป็น CSV, Excel, JSON หรือเชื่อมกับ Dropbox/Amazon S3 (Salesforge)
- แพ็กเกจฟรี: สูงสุด 5 โปรเจกต์ และ 200 หน้า/รัน ส่วนแพ็กเกจเสียเงินจะปลดล็อกพลังเพิ่มขึ้น
ParseHub เหมาะสำหรับผู้ใช้ระดับกลางที่อยากได้ความยืดหยุ่นโดยไม่ต้องลงลึกเรื่องโค้ด โดยเฉพาะสายอีคอมเมิร์ซ เว็บหางาน และอสังหาริมทรัพย์
6. Import.io
Import.io สร้างมาสำหรับการดึงข้อมูลระดับองค์กรและการทำ visualization โดยเฉพาะ ด้วยการโฟกัสที่โปรเจกต์ขนาดใหญ่ Import.io จึงมีทั้งอินเทอร์เฟซที่ใช้งานง่าย การซัพพอร์ตที่แข็งแกร่ง และระบบวิเคราะห์ขั้นสูง
อะไรทำให้ Import.io โดดเด่น?
- การดึงข้อมูลแบบคลิกเลือก: ไม่ต้องเขียนโค้ด—แค่เลือกข้อมูลที่ต้องการ
- การแสดงผลข้อมูล: มีเครื่องมือในตัวสำหรับวิเคราะห์ สร้างกราฟ และแชร์ผลลัพธ์
- ฟีเจอร์ระดับองค์กร: รองรับ compliance, managed services และการใช้งานปริมาณสูง
- ส่งออกและเชื่อมต่อ: ดาวน์โหลดเป็น CSV, Excel หรือเชื่อมกับ Google Sheets และเครื่องมือ BI (Salesforge)
ราคาถูกปรับตามความต้องการของทีมองค์กร จึงเหมาะที่สุดสำหรับองค์กรที่มีความต้องการข้อมูลขนาดใหญ่และมีงบประมาณรองรับ
7. Apify

Apify คือแพลตฟอร์มสำหรับเว็บออโตเมชันและการดึงข้อมูลแบบปรับขนาดได้ เหมาะกับนักพัฒนาที่ต้องการสร้าง รัน และแชร์ scraping “actors” หรือสคริปต์สำเร็จรูป/กำหนดเอง
ทำไม Apify ถึงเป็นตัวเลือกแถวหน้า:
- มาร์เก็ตเพลซของ Actors: มีสแครปเปอร์สำเร็จรูปกว่า 200 ตัวสำหรับเว็บไซต์ยอดนิยม หรือสร้างเองด้วย JavaScript/Python ก็ได้
- API-first: เชื่อมข้อมูลที่สแครปได้เข้ากับเวิร์กโฟลว์หรือแอปของคุณโดยตรง
- รันบนคลาวด์: ทำงานในสเกลใหญ่ ตั้งเวลางานซ้ำ และจัดการทุกอย่างจากแดชบอร์ดได้ (Apify Pricing)
- ราคายืดหยุ่น: มีแพ็กเกจฟรีสำหรับงานเล็ก ๆ และจ่ายตามการใช้งานสำหรับโปรเจกต์ที่ใหญ่ขึ้น
Apify เหมาะมากสำหรับทีมที่มีทักษะด้านเทคนิคและอยากทำให้ข้อมูลเว็บกลายเป็นส่วนหนึ่งของกระบวนการธุรกิจแบบอัตโนมัติและขยายได้
8. WebHarvy
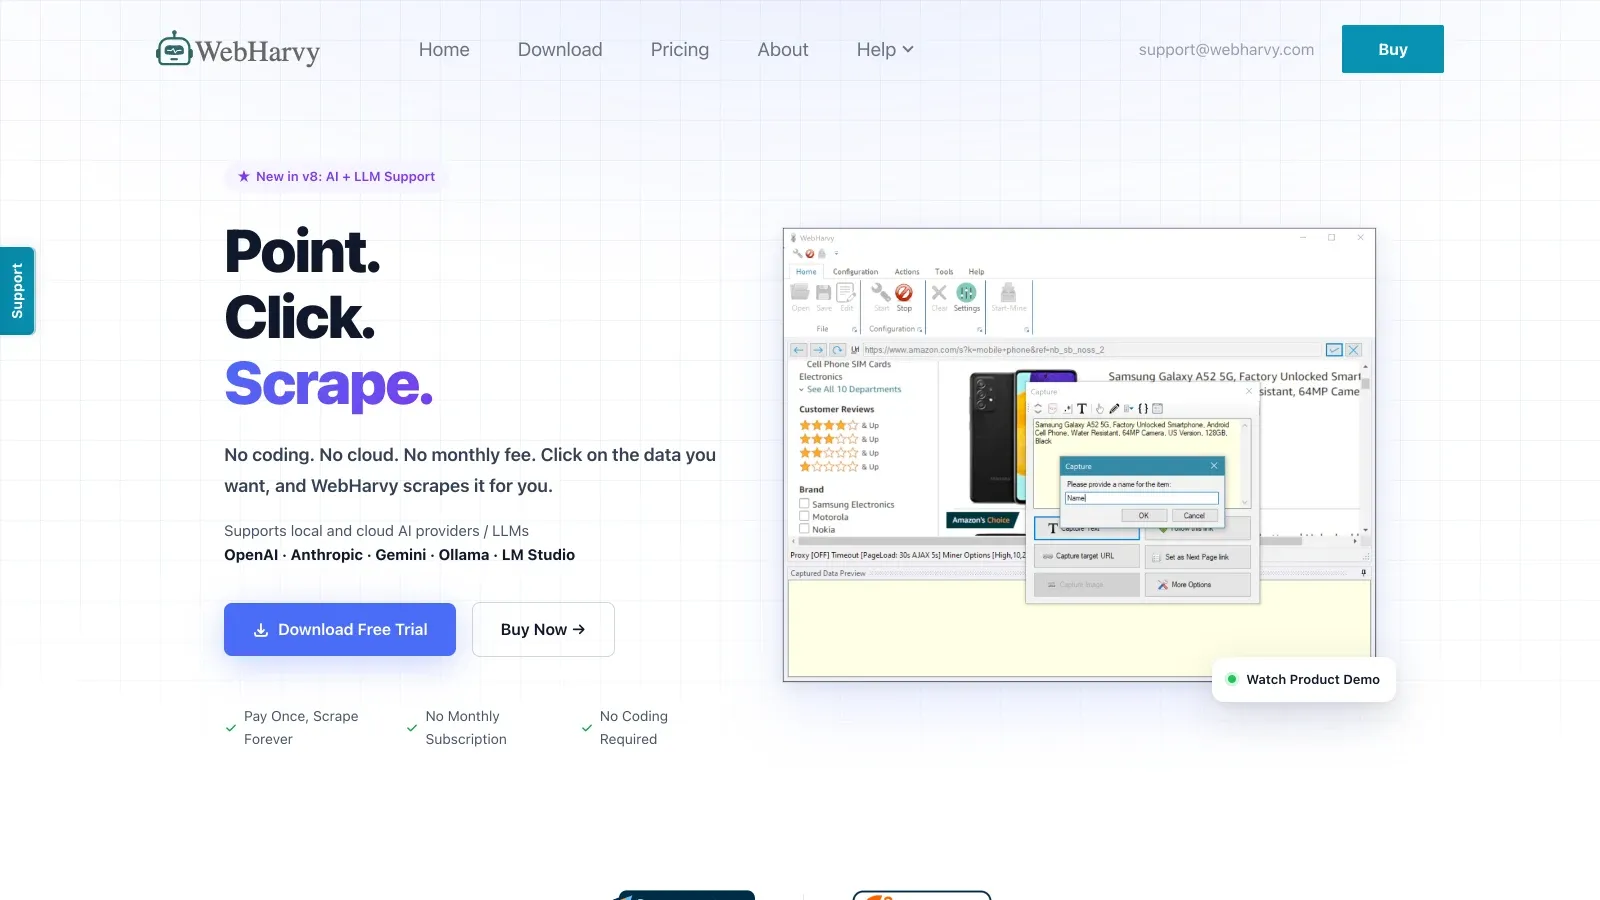
WebHarvy คือเครื่องมือ web scraping แบบคลิกเลือกที่ตรวจจับรูปแบบข้อมูลบนหน้าเว็บให้อัตโนมัติ ออกแบบมาสำหรับคนที่ไม่เขียนโค้ดและไม่อยากเรียนรู้ XPath หรือ CSS selectors
ฟีเจอร์สำคัญของ WebHarvy:
- ตรวจจับแพทเทิร์นอัตโนมัติ: คลิกที่ฟิลด์ข้อมูล แล้ว WebHarvy จะหาองค์ประกอบที่คล้ายกันให้เอง (Thunderbit Blog)
- รองรับ AJAX/JavaScript: จัดการคอนเทนต์แบบไดนามิก การสแครปรูปภาพ และการดึงข้อมูลตามคีย์เวิร์ดได้
- ตัวเลือกการส่งออก: ดาวน์โหลดเป็น Excel, CSV, XML, JSON หรือ SQL
- ไลเซนส์จ่ายครั้งเดียว: จ่ายครั้งเดียว ใช้ได้ตลอดไป (พร้อมอัปเดต/ซัพพอร์ต 1 ปี)
WebHarvy เป็นที่ชื่นชอบของธุรกิจขนาดเล็ก นักวิจัย และผู้ประกอบการเดี่ยวที่อยากได้แนวทางแบบเห็นภาพ และไม่ได้ต้องการระบบอัตโนมัติขั้นสูง
9. Diffbot
Diffbot คือขุมพลัง AI สำหรับการดึงข้อมูลจากเว็บ ด้วยแมชชีนเลิร์นนิงและคอมพิวเตอร์วิชัน Diffbot สามารถแปลงหน้าเว็บสาธารณะเกือบทุกหน้าให้เป็นข้อมูลที่มีโครงสร้างได้ โดยไม่ต้องตั้งค่าด้วยมือ
อะไรที่ทำให้ Diffbot ไม่เหมือนใคร?
- การดึงข้อมูลด้วย AI: ระบุและดึงเอนทิตี ความสัมพันธ์ และข้อเท็จจริงจากหน้าเว็บโดยอัตโนมัติ (VentureBeat)
- Knowledge Graph: เข้าถึงฐานข้อมูลขนาดใหญ่ที่อัปเดตต่อเนื่อง ครอบคลุมคน บริษัท สินค้า และอื่น ๆ
- API Access: นำข้อมูลที่มีโครงสร้างไปเชื่อมกับแอป งานวิจัย หรือเวิร์กโฟลว์ด้านการวิเคราะห์ได้ (Diffbot Docs)
- พร้อมสำหรับองค์กร: ใช้งานโดย Microsoft, Adobe, Hubspot และบริษัทยักษ์ใหญ่อื่น ๆ
ราคาเริ่มต้นที่ $299/เดือนสำหรับสตาร์ทอัป พร้อมตัวเลือกจ่ายตามการเรียก API (Diffbot Pricing) เหมาะที่สุดสำหรับงานวิจัย วิทยาการข้อมูลระดับองค์กร และใครก็ตามที่ต้องการความแม่นยำระดับ AI ในสเกลใหญ่
ตารางเปรียบเทียบเครื่องมือ Web Scraping
มาดูภาพรวมแบบเทียบกันชัด ๆ ของทั้ง 9 เครื่องมือ:
| เครื่องมือ | เหมาะกับ | ไม่ต้องเขียนโค้ด | ใช้ AI | เหมาะกับ API/นักพัฒนา | สแครปหน้าย่อย | ตัวเลือกการส่งออก | ราคาเริ่มต้น |
|---|---|---|---|---|---|---|---|
| Thunderbit | ผู้ใช้งานธุรกิจ | ใช่ | ใช่ | ไม่ใช่ | ใช่ | Excel, CSV, Sheets, Notion, Airtable | ฟรี (6 หน้า), $15/เดือน |
| Scrapy | นักพัฒนา | ไม่ใช่ | ไม่ใช่ | ใช่ | ใช่ (กำหนดเอง) | CSV, JSON, XML, DB | ฟรี, โอเพนซอร์ส |
| Beautiful Soup | ผู้เริ่มต้น, นักพัฒนา | ไม่ใช่ | ไม่ใช่ | ใช่ | ไม่ใช่ | ปรับแต่งเอง (ผ่าน Python) | ฟรี, โอเพนซอร์ส |
| Octoparse | คนไม่เขียนโค้ด, ทีม | ใช่ | ไม่ใช่ | บางส่วน | ใช่ | CSV, Excel, JSON, DB | ฟรี, $69/เดือน |
| ParseHub | เว็บแบบภาพ, ไดนามิก | ใช่ | ไม่ใช่ | บางส่วน | ใช่ | CSV, Excel, JSON, S3, Dropbox | ฟรี, $189/เดือน |
| Import.io | องค์กร, วิเคราะห์ข้อมูล | ใช่ | ไม่ใช่ | ใช่ | ใช่ | CSV, Excel, Sheets, BI tools | กำหนดเอง, สำหรับองค์กร |
| Apify | นักพัฒนา, ออโตเมชัน | ไม่ใช่ | ไม่ใช่ | ใช่ | ใช่ | CSV, JSON, Sheets, API | ฟรี, จ่ายตามการใช้งาน |
| WebHarvy | คนไม่เขียนโค้ด, SMBs | ใช่ | ไม่ใช่ | ไม่ใช่ | ใช่ | Excel, CSV, XML, JSON, SQL | $129 (จ่ายครั้งเดียว) |
| Diffbot | AI, วิจัย, องค์กร | ไม่ใช่ | ใช่ | ใช่ | ใช่ (AI crawl) | JSON, Knowledge Graph API | $299/เดือน |
เลือกเครื่องมือ Web Scraping ให้เหมาะกับความต้องการของคุณ
เครื่องมือและซอฟต์แวร์ Web Scraping ที่ดีที่สุดในปี 2025 Get Started Free
แล้วควรเลือกตัวไหน? นี่คือชีตสรุปสั้น ๆ ของผม:
- สำหรับคนไม่เขียนโค้ด/ผู้ใช้งานธุรกิจ: Thunderbit, Octoparse, ParseHub, WebHarvy
- สำหรับนักพัฒนา/ออโตเมชัน: Scrapy, Beautiful Soup, Apify
- สำหรับระดับองค์กร/ความต้องการด้าน AI: Import.io, Diffbot
- สำหรับเว็บไซต์ที่เปลี่ยนแปลงบ่อยหรือใช้ JavaScript หนัก: ParseHub, Octoparse, Apify
- สำหรับการส่งออกข้อมูลที่รวดเร็วและเป็นโครงสร้าง: Thunderbit, Import.io
คำแนะนำของผม? เริ่มจากเป้าหมายทางธุรกิจและระดับความถนัดทางเทคนิคของคุณ ถ้าคุณอยากได้การสแครปด้วย AI ที่ใช้ง่าย ไม่ยุ่งยาก และส่งออกข้อมูลได้ทันที Thunderbit คือหนึ่งในตัวเลือกที่ยากจะมีใครสู้ได้ ถ้าคุณต้องการควบคุมทั้งหมดหรืออยากสร้าง crawler เอง Scrapy หรือ Apify ก็ยอดเยี่ยมมาก ส่วนงานข้อมูลระดับองค์กรหรือสาย AI-Driven data นั้น Import.io และ Diffbot คือของจริง
เครื่องมือส่วนใหญ่มีทดลองใช้ฟรีหรือมีแพ็กเกจฟรีให้ลอง—ดังนั้นอย่ากลัวที่จะทดลองและดูว่าแบบไหนเข้ากับเวิร์กโฟลว์ของคุณมากที่สุด
คำถามที่พบบ่อย
1. เครื่องมือ web scraping คืออะไร และทำไมต้องใช้?
เครื่องมือ web scraping คือซอฟต์แวร์ที่ดึงข้อมูลจากเว็บไซต์แล้วแปลงให้อยู่ในรูปแบบที่มีโครงสร้าง เช่น สเปรดชีตหรือฐานข้อมูล ธุรกิจใช้เครื่องมือนี้เพื่อหาลีด ติดตามราคา วิจัยตลาด และอีกมากมาย—ช่วยประหยัดเวลาและเพิ่มความแม่นยำเมื่อเทียบกับการคัดลอกวางด้วยมือ
2. การทำ web scraping ถูกกฎหมายไหม?
การทำ web scraping นั้นถูกกฎหมายเมื่อคุณดึงเฉพาะข้อมูลที่เปิดเผยต่อสาธารณะและปฏิบัติตามข้อกำหนดการใช้งานของเว็บไซต์ ควรหลีกเลี่ยงการดึงข้อมูลส่วนบุคคลหรือข้อมูลอ่อนไหวโดยไม่ได้รับความยินยอม และตรวจสอบข้อกฎหมายท้องถิ่นเสมอ
3. เครื่องมือ web scraping ตัวไหนเหมาะกับคนไม่เขียนโค้ดที่สุด?
Thunderbit, Octoparse, ParseHub และ WebHarvy ล้วนเหมาะกับผู้ใช้ที่ไม่ถนัดเทคนิค Thunderbit โดดเด่นเป็นพิเศษด้วย AI ที่ช่วยแนะนำฟิลด์ และส่งออกไป Excel, Google Sheets, Notion หรือ Airtable ได้ทันที
4. ดึงข้อมูลจากเว็บไซต์แบบไดนามิกหรือ JavaScript หนัก ๆ ได้ไหม?
ได้แน่นอน! เครื่องมืออย่าง ParseHub, Octoparse และ Apify ถูกออกแบบมาเพื่อจัดการคอนเทนต์แบบไดนามิก, AJAX และหน้าแบบ “Load more” ได้ Thunderbit เองก็ปรับตัวเข้ากับเลย์เอาต์เว็บยุคใหม่ได้ดีเช่นกัน
5. จะเลือกเครื่องมือ web scraping ให้เหมาะกับธุรกิจได้อย่างไร?
พิจารณาจากทักษะทางเทคนิค ปริมาณข้อมูลที่ต้องการ ความต้องการด้านการส่งออก และงบประมาณ คนไม่เขียนโค้ดควรเริ่มจาก Thunderbit หรือ Octoparse; นักพัฒนาอาจชอบ Scrapy หรือ Apify; องค์กรที่มีความต้องการข้อมูลมากอาจมองไปที่ Import.io หรือ Diffbot เครื่องมือส่วนใหญ่มีทดลองใช้ฟรี—ลองหลายตัวแล้วดูว่าแบบไหนเวิร์กที่สุด
พร้อมเปลี่ยนเว็บให้กลายเป็นข้อได้เปรียบทางธุรกิจถัดไปของคุณแล้วหรือยัง? ดาวน์โหลด Thunderbit หรือเข้าไปดู Thunderbit Blog เพื่ออ่านคู่มือและเคล็ดลับเพิ่มเติม ขอให้สนุกกับการสแครป!
ลองใช้ AI Web Scraper Get Started Free
เรียนรู้เพิ่มเติม



