
โลกทุกวันนี้ขับเคลื่อนด้วยข้อมูล และในปี 2026 ความต้องการแปลงข้อมูลบนเว็บให้กลายเป็นอินไซต์ทางธุรกิจยิ่งสูงขึ้นกว่าเดิม ผมเห็นกับตาตัวเองเลยว่า ทีมขาย ทีมปฏิบัติการ และทีมการตลาดต่างเร่งกันทำงานอัตโนมัติ คอยตามดูคู่แข่ง และสร้างเวิร์กโฟลว์ที่ฉลาดขึ้น โดยมี web scraping เป็นแรงขับสำคัญ แต่ประเด็นคือ การจะเก่ง web scraping ไม่ได้เกิดจากอ่านบทความสอนเพียงไม่กี่ชิ้น มันต้องลงมือจริง ฝึกกับเว็บไซต์จริง และบางครั้งก็ต้องเจอเว็บที่โหดเอาเรื่องด้วย
การหาเว็บไซต์ทดสอบ web scraping ที่เหมาะสม อาจรู้สึกเหมือนงมเข็มในมหาสมุทร บางเว็บง่ายเกินไป บางเว็บตั้งด่านกันบอทไว้แน่นหนา และบางเว็บก็ดูแปลก ๆ ไปเลย นี่แหละเหตุผลที่ผมรวบรวม 10 เว็บไซต์ตัวอย่างสำหรับฝึก web scraping ที่ดีที่สุดไว้ในบทความนี้ คัดมาเพื่อช่วยให้คุณสร้างทักษะที่ใช้ได้จริง ตั้งแต่ระดับเริ่มต้นไปจนถึงการจัดการข้อมูลแบบไดนามิกขั้นสูง ไม่ว่าคุณอยากลองดึงข้อมูลจากเว็บอีคอมเมิร์ซ ฟอรั่ม หรือรีวิวภาพยนตร์ คู่มือนี้จะช่วยให้คุณอัปสกิลได้ไวขึ้น และเลี่ยงความหงุดหงิดแบบโดน “404” ตอนฝึกสแครป
ทำไมควรฝึก Web Scraping บนเว็บไซต์ตัวอย่าง?
ดูว่า Agentic Web Scraping ทำงานอย่างไร AI ของ Thunderbit อ่านหน้าเว็บเหมือนคนจริงและตัดสินใจได้ว่าจะดึงข้อมูลอะไร ลองใช้กับเว็บไซต์ฝึกด้านบนได้เลย Get Started Free
พูดกันตรง ๆ เลยว่า web scraping คือทักษะที่ต้องฝึกจริง จะดูวิดีโอสอนใน YouTube กี่อันก็ได้ แต่ถ้ายังไม่เคยเจอ HTML จริง คอนเทนต์แบบไดนามิก และ CAPTCHA ที่เด้งมาทำเอาปวดหัว คุณก็ยังถือว่ายังไม่ผ่านสนามจริง การฝึกบนเว็บไซต์ทดสอบ web scraping คือวิธีที่ดีที่สุดในการ:
- ทำความเข้าใจโครงสร้างข้อมูลที่หลากหลาย: ตั้งแต่ตารางง่าย ๆ ไปจนถึงลิสต์ซ้อนหลายชั้นและคอนเทนต์ที่โหลดผ่าน AJAX ทุกเว็บคือโจทย์ใหม่
- ทดสอบเครื่องมือและทักษะของคุณ: ดูว่า scraper ของคุณ หรือเครื่องมือที่คุณชอบอย่าง Thunderbit รับมือกับ pagination, subpages และลูกเล่นกันบอทได้ดีแค่ไหน
- เตรียมพร้อมสำหรับการใช้งานจริงในธุรกิจ: การสแครปข้อมูลในโลกจริงช่วยขับเคลื่อนงานอย่าง market research, lead generation, และ competitive analysis ให้กับองค์กรทั่วโลก
ตัวเลขก็ยืนยันเรื่องนี้เช่นกัน ตลาด web scraping ทั่วโลกคาดว่าจะมีมูลค่าถึง 1.17 พันล้านดอลลาร์ในปี 2026 เพิ่มจากราว 0.99 พันล้านดอลลาร์ในปี 2025 ด้วยอัตราเติบโตเฉลี่ยราว 18% และเกือบ 95% ขององค์กร ระบุว่าการตัดสินใจด้วยข้อมูลเป็นเรื่อง “สำคัญอย่างยิ่ง” ต่อความสำเร็จของพวกเขา แต่ความลับจริง ๆ คืออะไร? Scraper ที่เก่งที่สุดไม่ใช่แค่นักเขียนโค้ด—แต่คือคนที่ชอบลองไม่หยุด และฝึกกับเว็บใหม่ ๆ อยู่เสมอ
เราเลือกเว็บไซต์ฝึก Web Scraping ที่ดีที่สุดอย่างไร
เว็บไซต์ตัวอย่างสำหรับ web scraping ไม่ได้มีคุณภาพเท่ากันทั้งหมด สำหรับลิสต์นี้ ผมคัดเฉพาะเว็บที่:
- มีข้อมูลหลายประเภทให้ทดลอง: ทั้งข้อความ ตัวเลข รูปภาพ คะแนน รีวิว และอื่น ๆ
- มีระดับความซับซ้อนหลากหลาย: ตั้งแต่ HTML แบบคงที่ไปจนถึงหน้าเว็บที่พึ่ง JavaScript หนัก ๆ
- ปลอดภัยและถูกกฎหมายสำหรับการสแครป: เป็นเว็บที่ออกแบบมาเพื่อฝึกโดยเฉพาะ หรือเป็นหน้าสาธารณะที่ไม่ต้องล็อกอิน
- สะท้อนสถานการณ์ธุรกิจจริง: เช่น อีคอมเมิร์ซ ฟอรั่ม รีวิว และอื่น ๆ
- ให้คุณได้เจอกับมาตรการกันการสแครป: เพราะในโลกจริง คุณจะต้องรับมือกับ CAPTCHA, rate limit และ AJAX ให้ได้
ผมยังเลือกเว็บที่เหมาะทั้งกับ scraper แบบเขียนโค้ดดั้งเดิม และเครื่องมือแบบ no-code รุ่นใหม่อย่าง Thunderbit ด้วย พร้อมเริ่มแล้วหรือยัง? ไปกันเลย
1. Thunderbit: เว็บไซต์ทดสอบ Web Scraping แบบครบเครื่อง

ดึงข้อมูลจากทุกเว็บไซต์ได้ด้วย AI Agentic web scraper ของ Thunderbit อ่านได้ทั้งเว็บทดสอบและหน้าเว็บจริง แล้วดึงข้อมูลให้คุณในคลิกเดียว Get Started Free
Thunderbit ไม่ได้เป็นแค่เครื่องมือธรรมดา แต่มันคือสนามซ้อมของคนที่จริงจังกับ web scraping ถ้าคุณเคยสร้างและทำลาย scrapers มาหลายแบบเหมือนผม คุณจะรู้ว่า Thunderbit คือเครื่องมือที่ผมใช้ทดสอบทุกอย่าง ตั้งแต่ลิสต์ง่าย ๆ ไปจนถึงเว็บอีคอมเมิร์ซที่ซับซ้อนและเปลี่ยนตลอดเวลา
ทำไม Thunderbit ถึงโดดเด่น:
- สแครปด้วย AI: แค่กด “One Click Extract” Thunderbit ก็จะอ่านหน้าเว็บ คิดคอลัมน์ที่เหมาะสมให้ และยังเขียนตรรกะการดึงข้อมูลให้คุณด้วย ไม่ต้องเขียนโค้ด ไม่ต้องปวดหัวกับ selector
- รับมือเว็บซับซ้อนได้ดี: Thunderbit ทำงานได้ยอดเยี่ยมกับ HTML ที่ยุ่งยาก คอนเทนต์แบบไดนามิก และเว็บที่มี subpage หรือ infinite scroll เหมือนมี Swiss Army knife สำหรับ web scraping อยู่ในมือ
- รองรับ Subpage และ Pagination: ถ้าคุณต้องดึงรายการสินค้าแล้วเข้าไปอ่านรายละเอียดแต่ละหน้า Thunderbit ช่วยให้ทำได้ง่ายมาก
- ส่งออกข้อมูลได้ทันที: Export ไปยัง Excel, Google Sheets, Airtable หรือ Notion ได้ฟรีและไม่จำกัด
- มีตัวดึงข้อมูลฟรี: เครื่องมือคลิกเดียวสำหรับอีเมล เบอร์โทร และรูปภาพ เหมาะมากสำหรับการฝึกงานขายและ lead generation
- เทมเพลตสำหรับเว็บยอดนิยม: เช่น Amazon, Zillow, Shopify และอีกมากมาย แค่เลือกเทมเพลตแล้วเริ่มได้เลย
- เหมาะกับมือใหม่: ผู้ใช้ที่ไม่ใช่สายเทคนิคชอบตรงที่ “ไม่ต้องเรียนรู้อะไรเยอะ” ก็เริ่มได้เลย (Trustpilot)
สถานการณ์ฝึกใช้งาน:
- ดึงรายการสินค้าอีคอมเมิร์ซ เช่น Amazon หรือ eBay พร้อมข้อมูลเสริมจาก subpage
- แยกข้อมูลติดต่อจากไดเรกทอรีธุรกิจ
- ทำงานดึงข้อมูลซ้ำ ๆ เพื่อใช้ในการวิจัยตลาดแบบอัตโนมัติ
Thunderbit เป็นเว็บไซต์ทดสอบ web scraping เพียงตัวเดียวในลิสต์นี้ที่ให้คุณฝึกได้ทั้งด้านการสแครปและการทำ workflow automation และใช่—มันลองใช้ฟรีได้ คุณจึงเห็นเองได้เลยว่าทำไมผมถึงเลือกเป็นอันดับหนึ่งสำหรับทุกระดับทักษะ
ลองใช้ Thunderbit Agentic Web Scraper ฟรี แพ็กเกจฟรีรองรับ 6 หน้า/เดือน ไม่ต้องใช้บัตรเครดิต เพียงพอสำหรับฝึกกับเว็บไซต์ด้านบน Get Started Free
2. Codeforces: ฝึกสแครปข้อมูลโปรแกรมมิงแบบมีโครงสร้าง
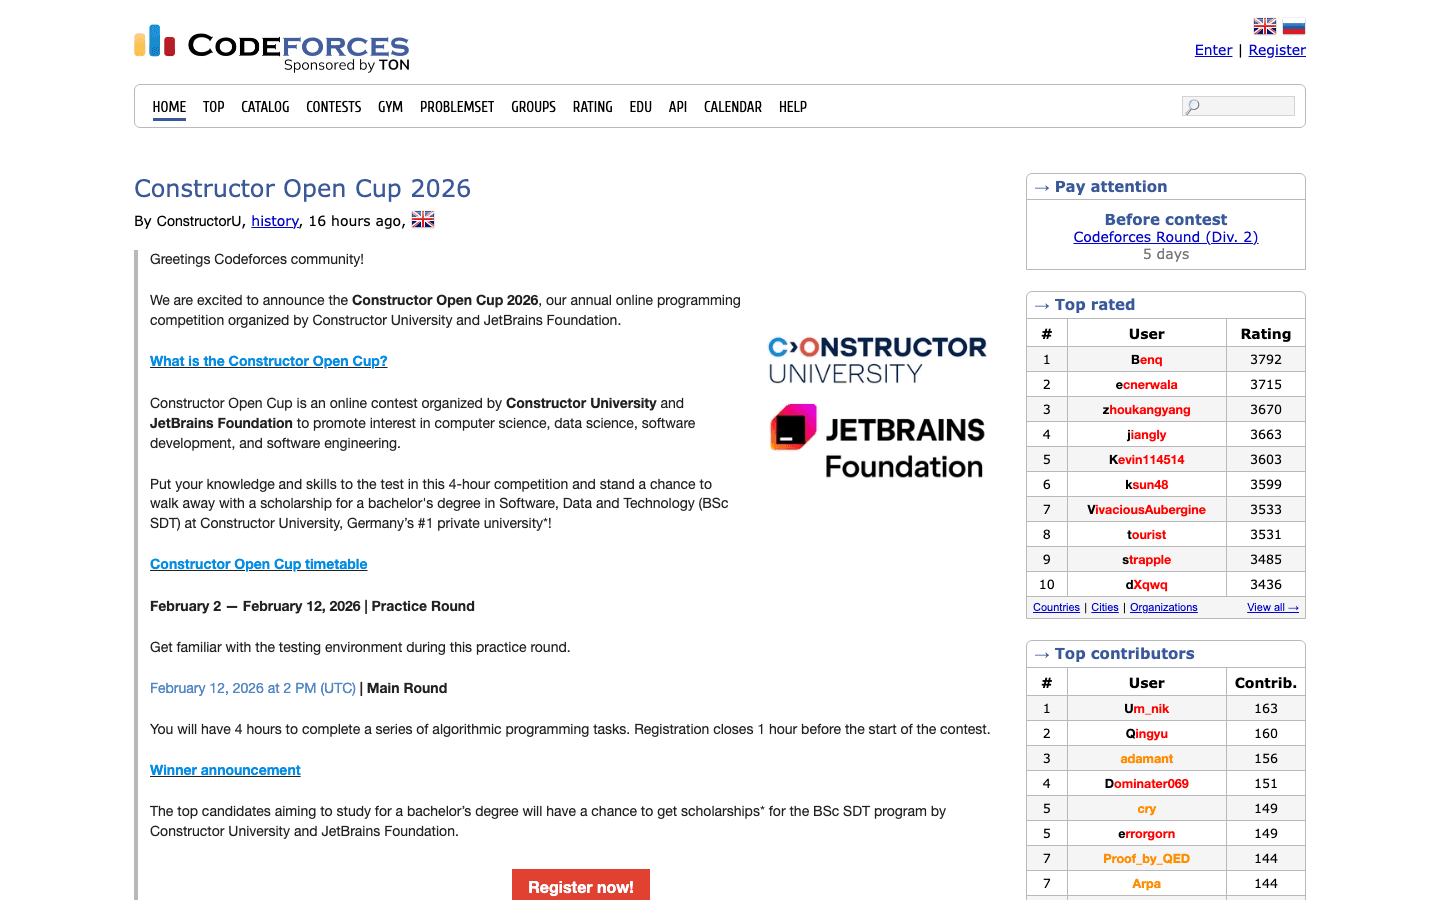 Codeforces คือขุมทรัพย์สำหรับคนที่อยากฝึกดึงข้อมูลแบบตารางที่มีโครงสร้างชัดเจน เว็บไซต์แข่งขันเขียนโปรแกรมนี้มี:
- รายการแข่งขัน: เป็นตารางที่มีชื่อรายการ วันที่ และลิงก์
- ชุดโจทย์: ตารางซ้อนหลายชั้นที่มีชื่อโจทย์ แท็ก และระดับความยาก
- อันดับผู้ใช้: กระดานคะแนนและโปรไฟล์ผู้ใช้ที่มีแต้มและสถิติ
ทำไมถึงเหมาะสำหรับฝึก:
- ช่วยให้คุณฝึก parse HTML tables, nested lists และผลลัพธ์หลายหน้า
- ข้อมูลส่วนใหญ่เป็น HTML แบบคงที่ ไม่ต้องปวดหัวกับการล็อกอินหรือ JavaScript
- สะท้อนสถานการณ์จริง เช่น การสแครป job board หรือผลคะแนนทางวิชาการ
เคล็ดลับ: ลองดึงโจทย์ทั้งหมดจากการแข่งขันหนึ่งครั้ง หรือสร้าง leaderboard ของผู้ใช้ระดับท็อป คุณจะได้เรียนรู้แบบเร่งรัดเรื่อง structured data และ pagination
3. Books to Scrape: เว็บไซต์ฝึก Web Scraping สุดคลาสสิก
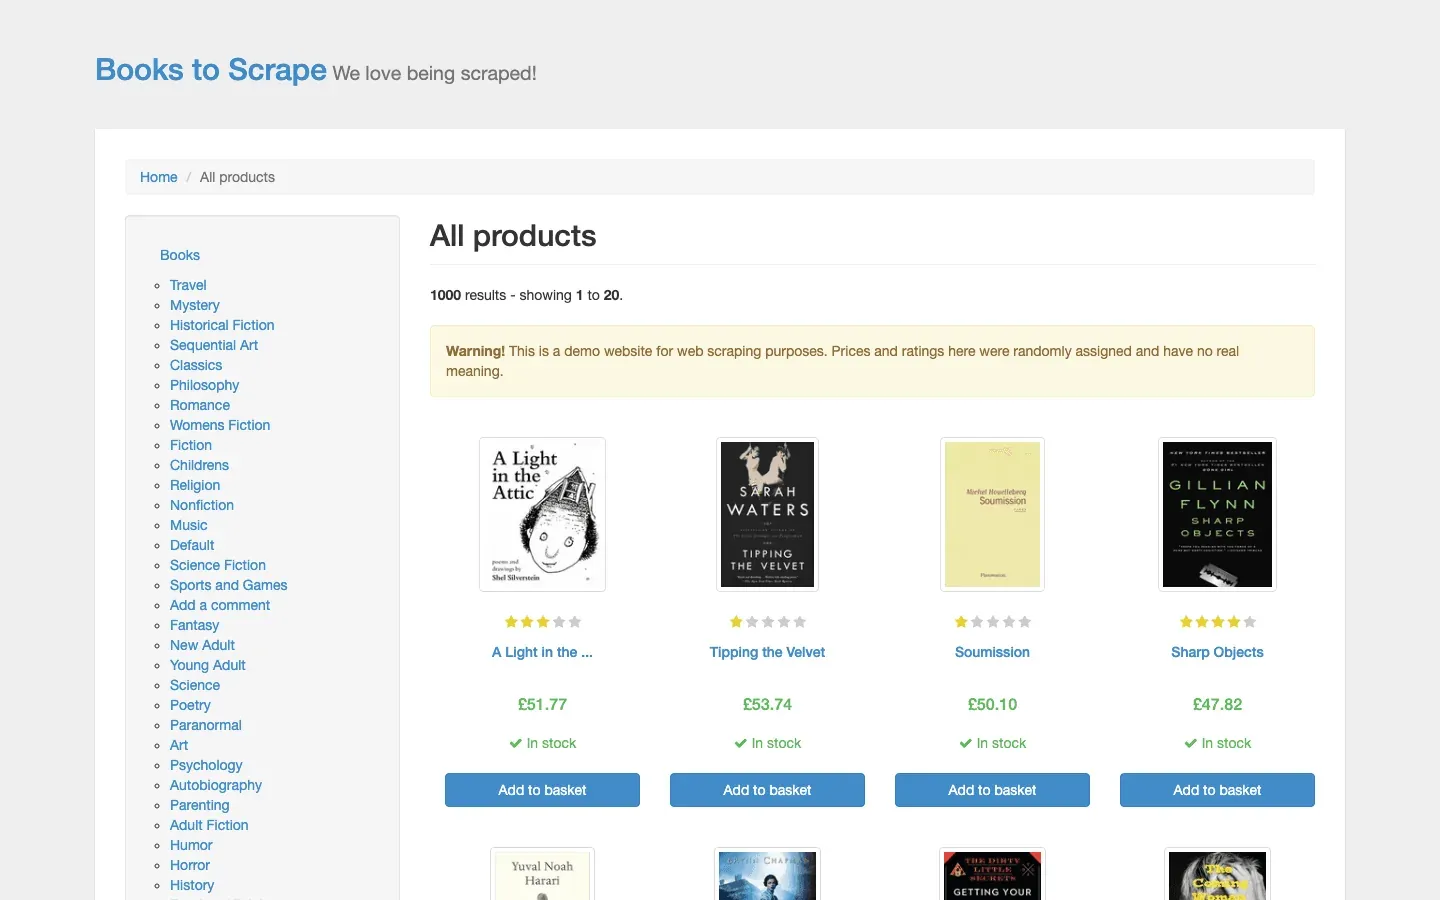 Books to Scrape คือ “hello world” ของโลก web scraping ร้านหนังสือออนไลน์สมมตินี้ถูกออกแบบมาสำหรับมือใหม่ แต่ก็อย่าเพิ่งประมาท—นี่เป็นสนามฝึกพื้นฐานที่ดีมาก
สิ่งที่คุณจะเจอ:
- รายการสินค้าที่เป็น HTML แบบคงที่: ชื่อหนังสือ ราคา คะแนน และหมวดหมู่
- Pagination: ฝึกสแครปข้ามหลายหน้า
- โครงสร้างที่สม่ำเสมอ: ทำให้เรียนรู้ selector และ loop ได้ง่าย
งานฝึก:
- ดึงชื่อหนังสือและราคาให้ครบ
- สแครปคะแนนและสถานะสินค้าว่ามีหรือไม่
- จัดการ pagination เพื่อเก็บแคตตาล็อกทั้งหมด
เว็บนี้ได้รับความนิยมในบทเรียนต่าง ๆ เพราะปลอดภัย คาดเดาได้ และเหมาะมากสำหรับสร้างความมั่นใจก่อนจะไปลุยเว็บจริงที่ซับซ้อนกว่า (Proxyway)
4. HackerRank: ฝึก Web Scraping ข้อมูลตัวอักษรและอัลกอริทึม
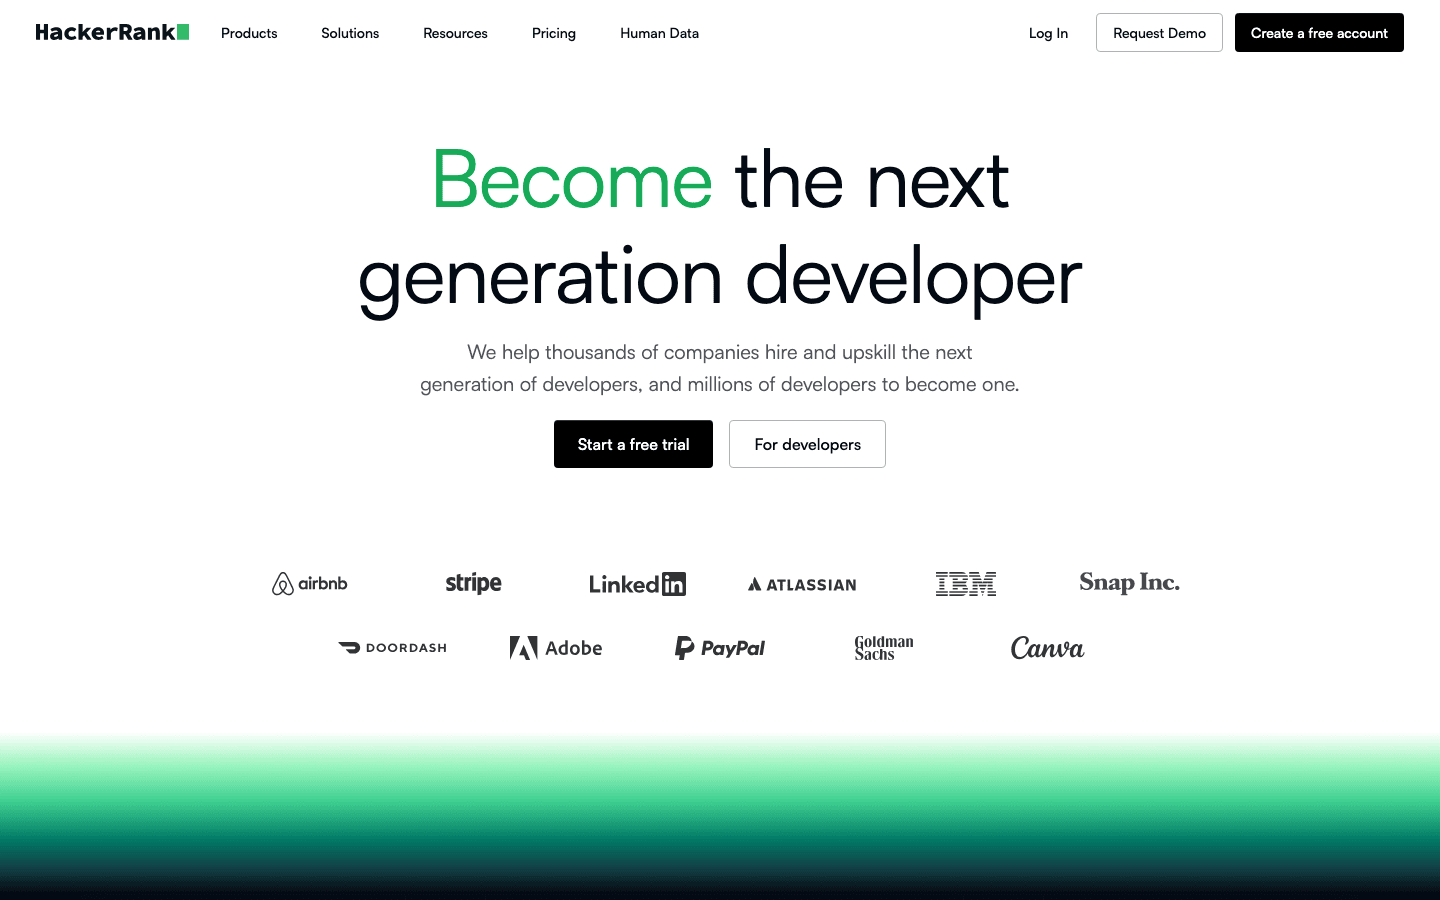 HackerRank คือจุดที่ความยากเริ่มเพิ่มขึ้น เว็บสำหรับชาเลนจ์เขียนโค้ดนี้เต็มไปด้วย:
- คอนเทนต์แบบไดนามิก: คำอธิบายโจทย์ test cases และ leaderboards
- โปรไฟล์ผู้ใช้: สถิติ เหรียญรางวัล และอันดับ
- การล็อกอิน/ยืนยันตัวตน: หลายหน้าต้องใช้ session ของผู้ใช้
ทำไมถึงเป็นเว็บทดสอบที่ดี:
- ช่วยฝึกจัดการ login flow และ session cookies
- ทำให้คุณเจอคอนเทนต์ที่เรนเดอร์ด้วย JavaScript และ AJAX
- เหมาะมากสำหรับฝึกสแครปชาเลนจ์เขียนโค้ด สถิติผู้ใช้ หรือผลการแข่งขัน
ถ้าคุณอยากเรียนรู้วิธีสแครปเว็บที่ไม่ยอมให้เข้าถึงง่าย ๆ ด้วย HTTP request ธรรมดา HackerRank คือสนามพิสูจน์ฝีมือของคุณ
5. Web Scraper Test: เว็บไซต์ทดสอบ Web Scraping โดยเฉพาะ
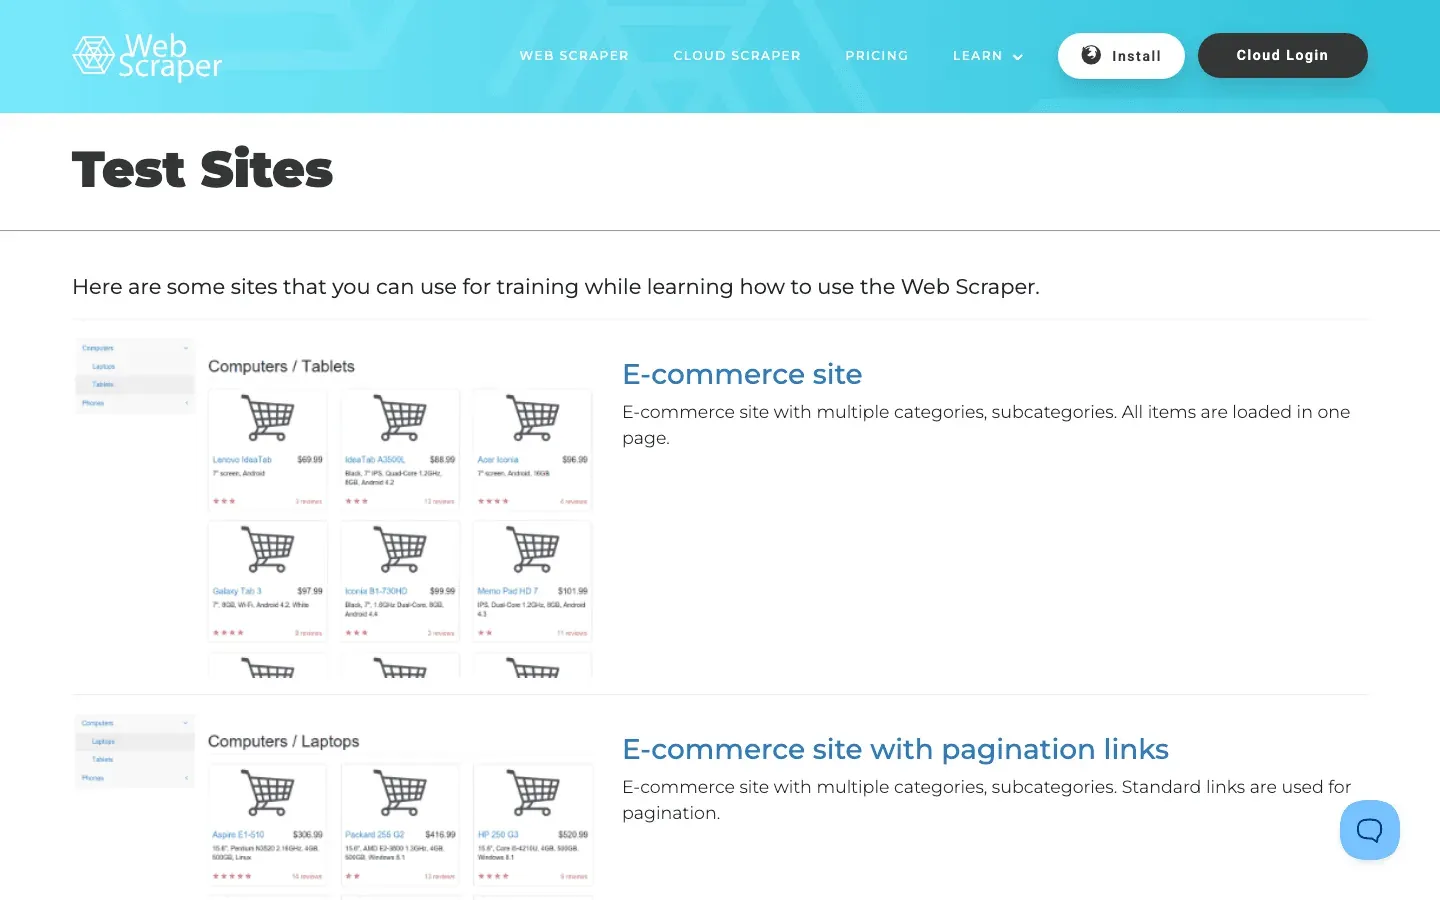 Web Scraper Test ถูกสร้างขึ้นมาเพื่อคนอย่างเราโดยเฉพาะ—คนที่ชอบทดลองสแครปบนสถานการณ์ที่ออกแบบมาให้ฝึกตรง ๆ
ข้างในมีอะไรบ้าง:
- หน้าอีคอมเมิร์ซ: ทั้งแบบ static และแบบใช้ AJAX
- ตารางและหมวดหมู่ซ้อน: ตั้งแต่รายการง่าย ๆ ไปจนถึงเมนูหลายชั้น
- คอนเทนต์แบบไดนามิก: ทดสอบความสามารถของ scraper ในการรับมือ JavaScript
ทำไมถึงดีมาก:
- ไม่มีมาตรการกันบอทให้กังวล สแครปได้แบบสบายใจ
- เหมาะสำหรับวัดประสิทธิภาพเครื่องมือของคุณระหว่างหน้าแบบ static กับ dynamic
- ดีมากสำหรับเปรียบเทียบว่า Thunderbit และ scraper อื่น ๆ รับมือเว็บแต่ละแบบอย่างไร (Firecrawl)
ถ้าคุณอยากได้ sandbox ที่ปลอดภัยเพื่อดัน scraper ของคุณให้ถึงขีดสุด ที่นี่แหละคือคำตอบ
6. eBay: ฝึก Web Scraping อีคอมเมิร์ซในโลกจริง
 eBay คือจุดที่ web scraping เชื่อมกับโลกจริง ด้วยรายการสินค้านับล้าน มันจึงเป็นเว็บยอดนิยมสำหรับฝึก:
- ดึงข้อมูลสินค้า: ชื่อ ราคา รูปภาพ ข้อมูลผู้ขาย
- Pagination และ filtering: สแครปข้ามหมวดหมู่หรือผลการค้นหา
- คอนเทนต์แบบไดนามิก: รายการและรีวิวที่โหลดผ่าน AJAX
ความท้าทาย:
- eBay ใช้ CAPTCHA, rate limit และ HTML แบบไดนามิกเพื่อกันบอท (Oxylabs)
- คุณจะต้องเรียนรู้เรื่อง proxy, user agent และการสแครปอย่างมีมารยาท
กรณีใช้งานทางธุรกิจ:
- การติดตามราคา, วิเคราะห์คู่แข่ง และวิจัยตลาด
ถ้าคุณสแครป eBay ได้ คุณก็พร้อมรับมือกับโจทย์อีคอมเมิร์ซแทบทุกแบบแล้ว
7. Amazon: เว็บไซต์ทดสอบ Web Scraping สุดโหดแห่งอีคอมเมิร์ซ
 Amazon คือบอสใหญ่ของโลก web scraping ตัว Amazon เองมีสินค้า first-party ราว 12 ล้าน SKU แต่เมื่อรวมสินค้าจากผู้ขายภายนอกกว่า 588 ล้านราย ตลาดของมันจะมีรายการสินค้ารวมประมาณ 600 ล้านรายการ และ Amazon ก็ป้องกันแคตตาล็อกนี้ด้วยโครงสร้างกันบอทที่แข็งแกร่งที่สุดชุดหนึ่งบนเว็บสาธารณะ
งานฝึก:
- ดึงรายละเอียดสินค้า ราคา คะแนน และรีวิว
- รับมือ infinite scroll, องค์ประกอบแบบไดนามิก และข้อมูลซ้อนกัน
- เคารพมาตรการกันบอท เช่น IP ban, request fingerprinting และอื่น ๆ (LiveProxies)
ทำไมต้องลอง?
- การสแครป Amazon ช่วยให้คุณเรียนรู้เทคนิคขั้นสูง เช่น rotating proxy และ browser automation
- นี่คือวิธีฝึกที่ดีที่สุดสำหรับงานอีคอมเมิร์ซจริงในโลกธุรกิจ—แค่ต้องสแครปอย่างรับผิดชอบและเคารพเงื่อนไขของ Amazon
ดึงข้อมูลสินค้าและรีวิวจาก Amazon เมื่อคุณฝึกบนเว็บไซต์ทดสอบจนคล่องแล้ว ลองให้ Thunderbit จัดการหน้า Amazon จริง แล้วมันจะดึงข้อมูลสินค้าและรีวิวให้ในคลิกเดียว Get Started Free
8. Yelp: ฝึกสแครปรายชื่อธุรกิจและรีวิว
 Yelp คือขุมข้อมูลชั้นดีสำหรับคนที่สนใจข้อมูลธุรกิจท้องถิ่น รีวิว และคะแนนเรตติ้ง
คุณสแครปอะไรได้บ้าง:
- ชื่อธุรกิจ หมวดหมู่ คะแนน และที่อยู่
- รีวิวจากผู้ใช้ (ข้อความ วันที่ คะแนน)
- รูปภาพและระดับราคา
ความท้าทาย:
- Yelp เพิ่มมาตรการกันการสแครปขึ้นมาก รวมถึง CAPTCHA และ API rate limit (Reddit)
- เหมาะสำหรับฝึกการตั้งค่าเครื่องมือและการสแครปอย่างสุภาพ
ประโยชน์ทางธุรกิจ:
- วิจัยตลาดท้องถิ่น, lead generation และการวิเคราะห์ความรู้สึก
9. Stack Overflow: สแครป Q&A และอินไซต์จากนักพัฒนา
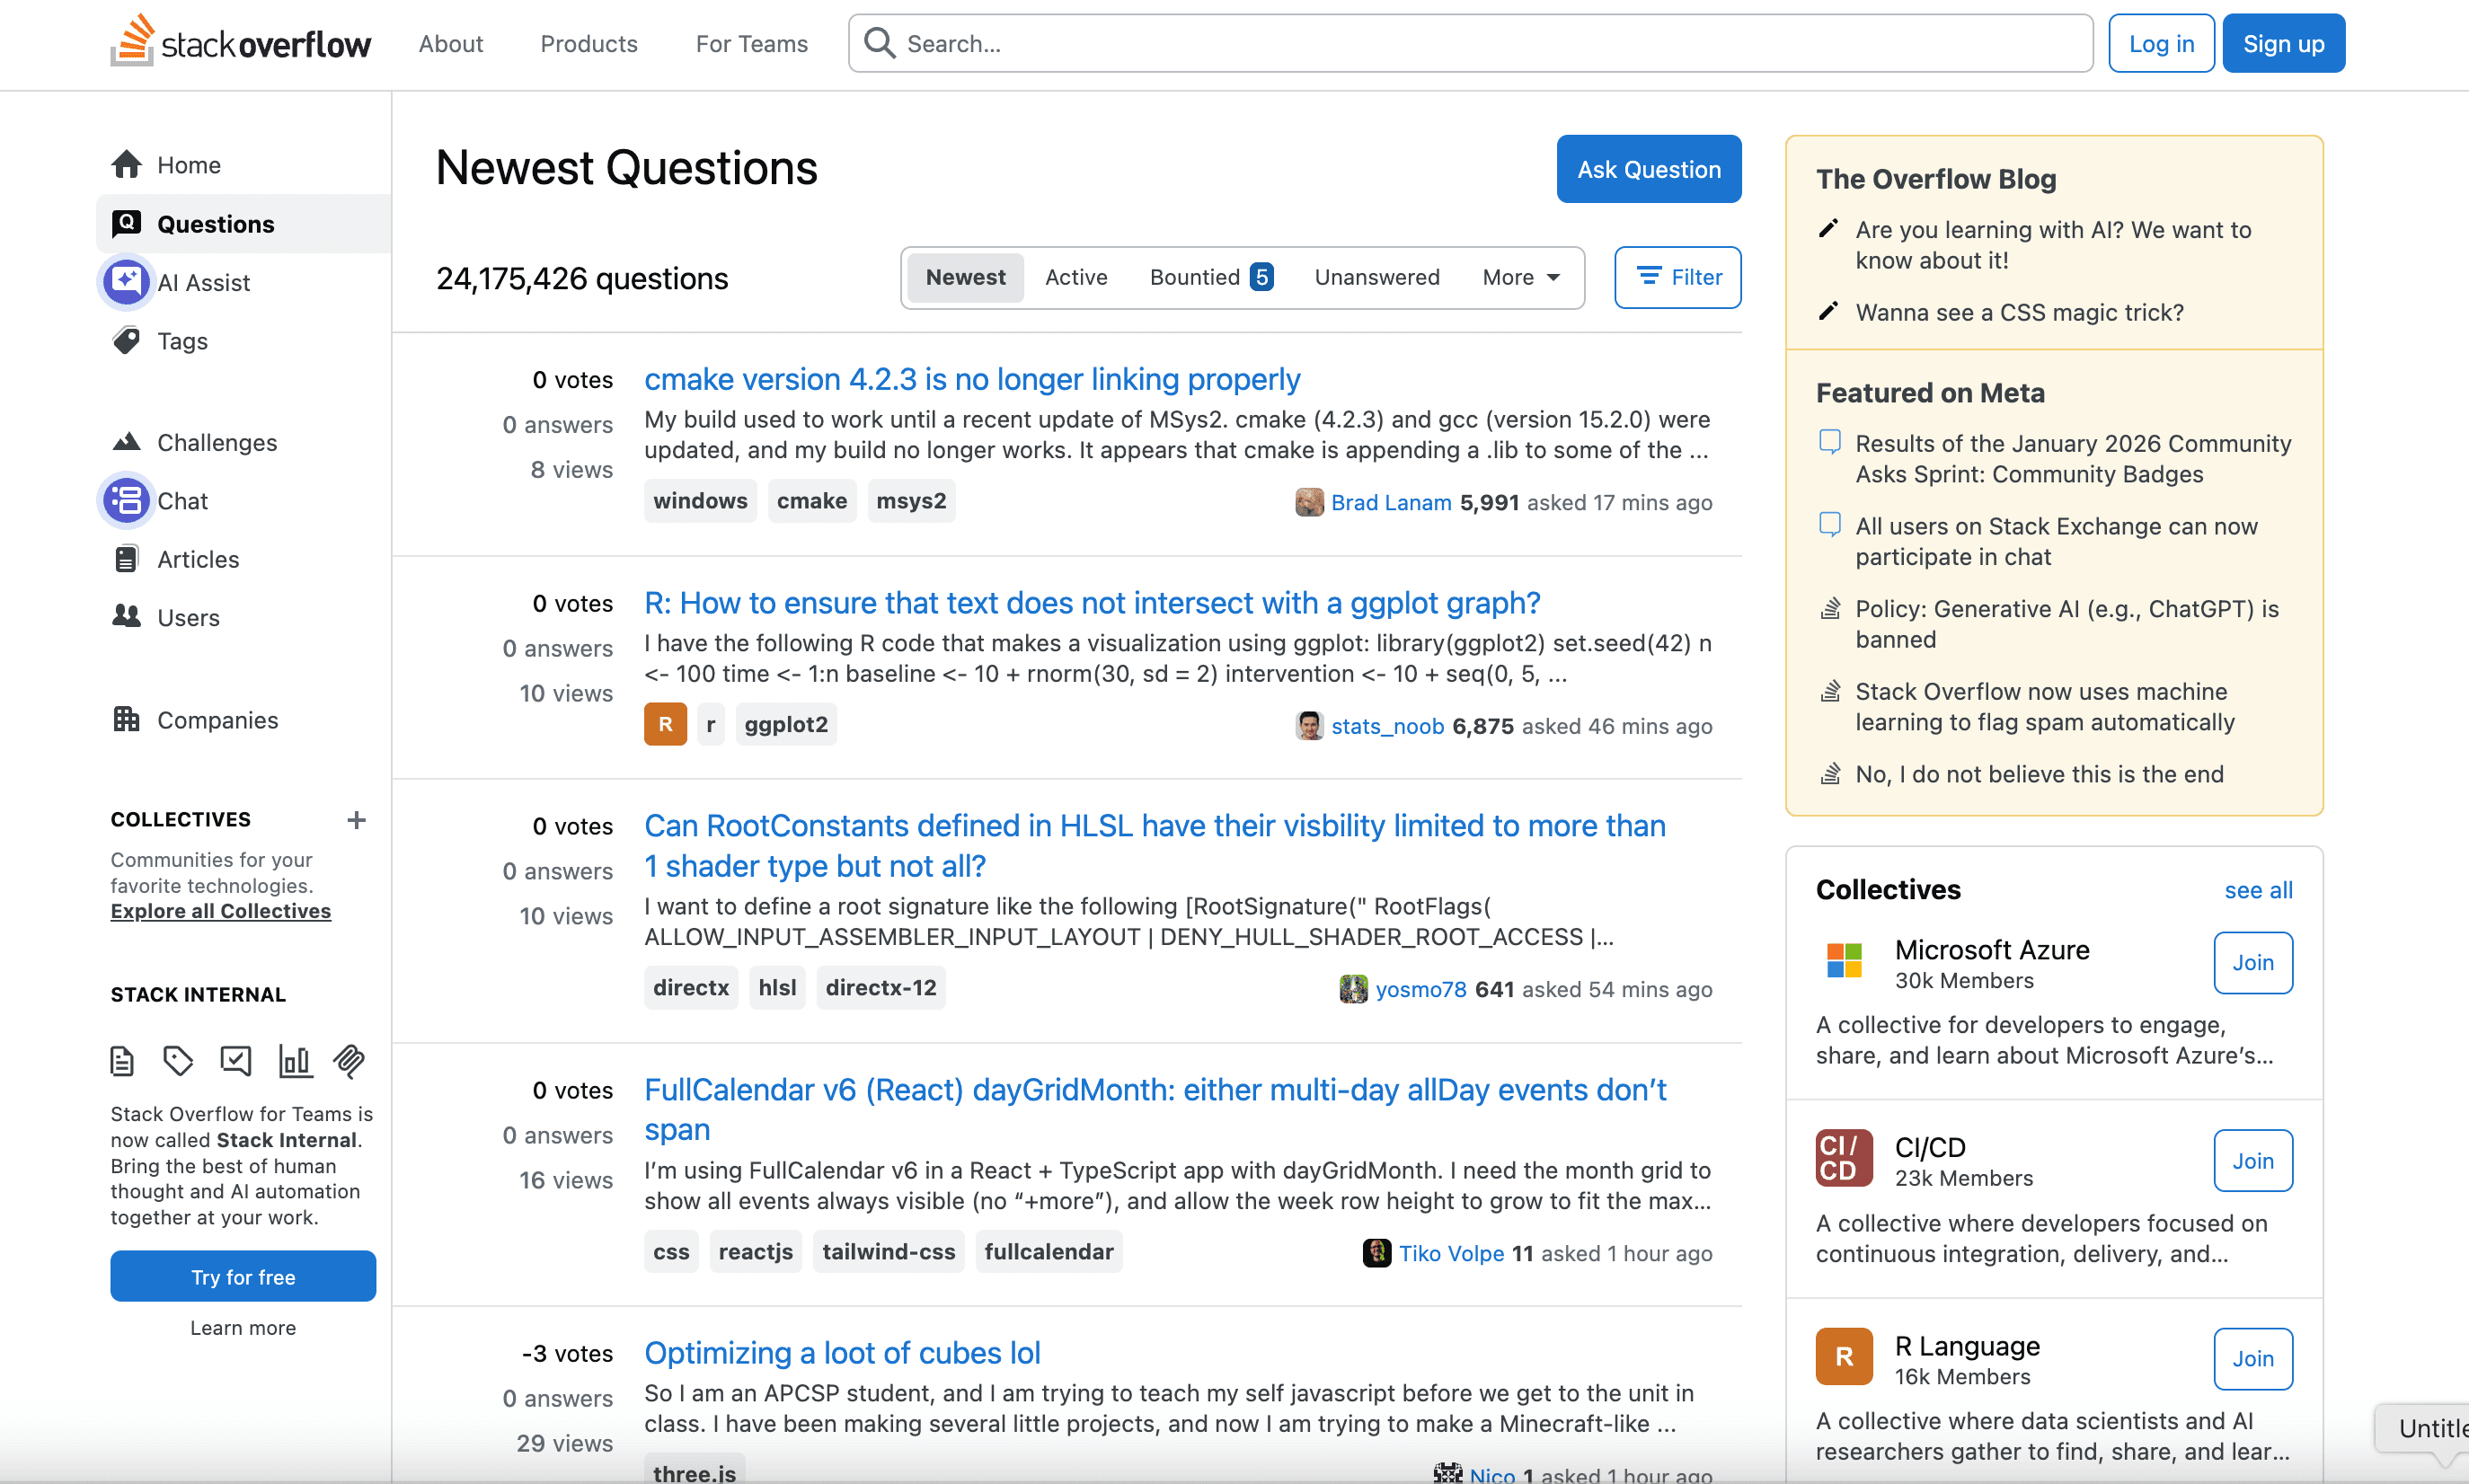 Stack Overflow คือเว็บไซต์ถาม-ตอบสำหรับนักพัฒนาที่ใหญ่ที่สุดในโลก และยังเป็นเว็บไซต์ทดสอบ web scraping ที่ยอดเยี่ยมอีกด้วย
โอกาสในการฝึก:
- สแครปคำถาม คำตอบ แท็ก และโปรไฟล์ผู้ใช้
- รับมือ pagination และคอมเมนต์ที่ซ้อนกัน
- ใช้ public API เพื่อเข้าถึงข้อมูลอย่างเหมาะสม
ทำไมถึงมีประโยชน์:
- สอนให้คุณสแครปฟอรั่มและเว็บไซต์ชุมชน
- เหมาะมากสำหรับสร้างชุดข้อมูลไว้ทำ trend analysis หรือ mining ความรู้
Stack Overflow ส่วนใหญ่เป็น HTML แบบคงที่ จึงเข้าถึงง่ายสำหรับมือใหม่ แต่ด้วยขนาดและโครงสร้างของเว็บ ก็ยังมีความท้าทายขั้นสูงอีกมาก
10. Rotten Tomatoes: ฝึกสแครปรีวิวและคะแนนภาพยนตร์
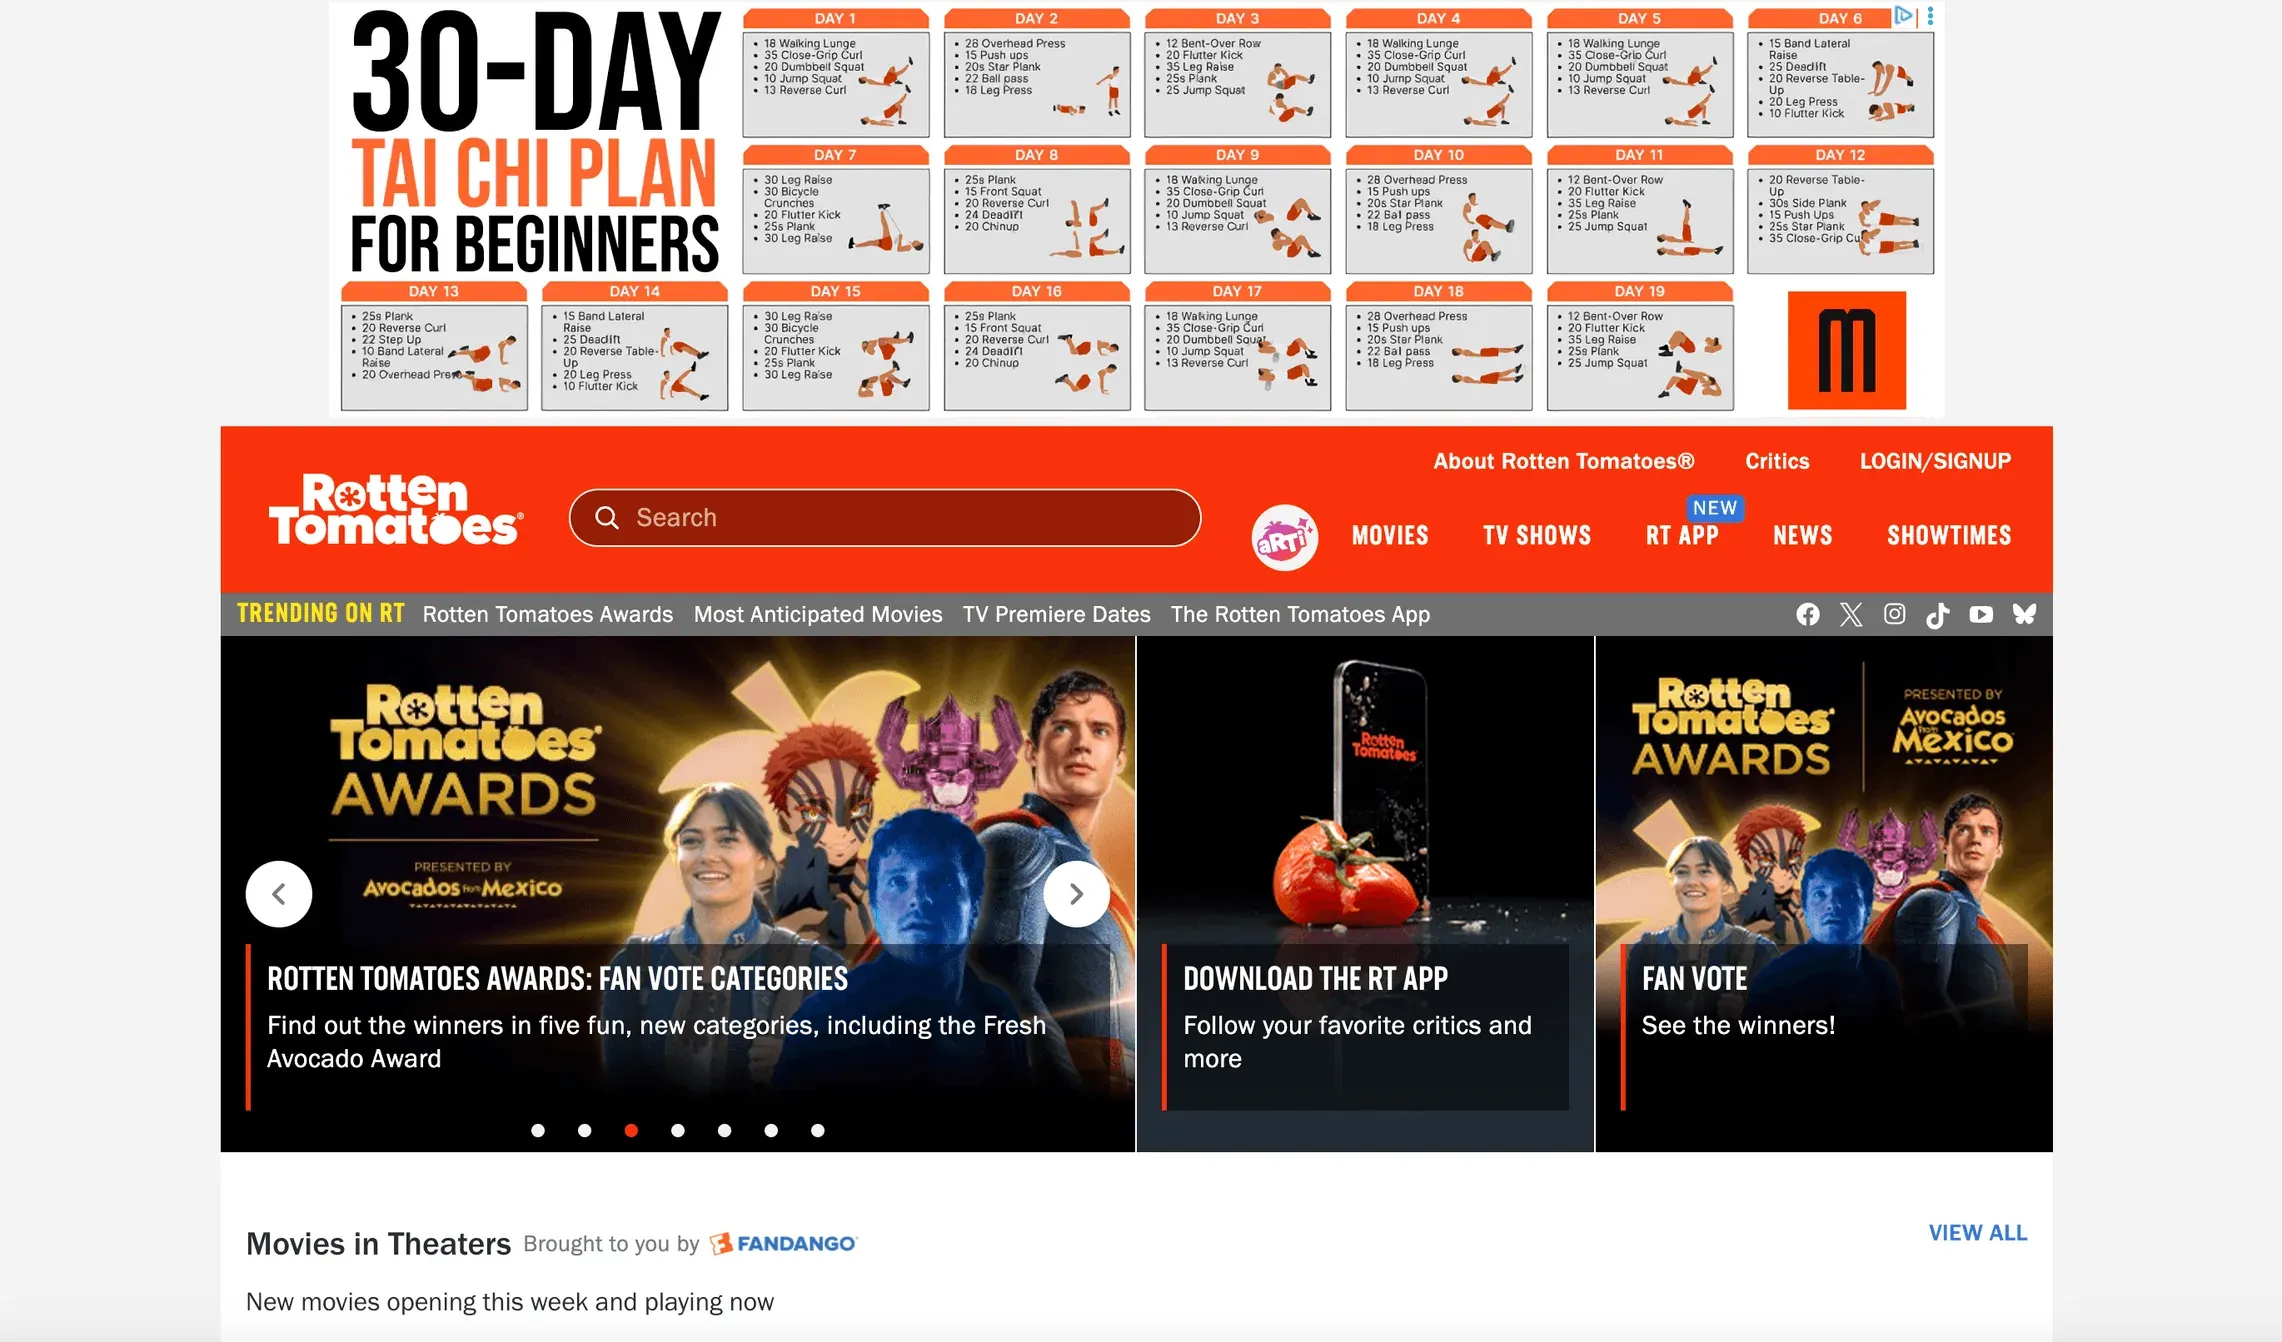 Rotten Tomatoes คือเว็บประจำสำหรับดูคะแนนหนัง รีวิวจากนักวิจารณ์ และคะแนนจากผู้ชม
สิ่งที่คุณจะเจอ:
- ชื่อภาพยนตร์ คะแนนจากนักวิจารณ์/ผู้ชม และตัวอย่างรีวิว
- คอนเทนต์แบบไดนามิกที่โหลดผ่าน AJAX และ hidden APIs
- บางฟีเจอร์อาจต้องล็อกอินหรือใช้เทคนิคสแครประดับสูง (Reddit)
งานฝึก:
- ดึงคะแนนหนังและข้อความตัวอย่างรีวิว
- Reverse-engineer การเรียก API เพื่อดึงข้อมูล JSON
- รับมือคอนเทนต์แบบไดนามิกและมาตรการกันบอท
Rotten Tomatoes คือบททดสอบขั้นสุดท้าย—ถ้าคุณสแครปเว็บนี้ได้ คุณก็พร้อมสำหรับโปรเจกต์ดึงข้อมูลแทบทุกแบบแล้ว
ตารางเปรียบเทียบ: เว็บไซต์ฝึก Web Scraping ในภาพรวม
| เว็บไซต์ | ประเภทข้อมูล | ความยาก | การกันการสแครป | เหมาะกับการใช้งานแบบไหน |
|---|---|---|---|---|
| Thunderbit | ได้ทุกแบบ (ข้อความ รูปภาพ อีเมล เบอร์โทร ฯลฯ) | ทุกระดับ | N/A (เป็นเครื่องมือ ไม่ใช่เว็บ) | ฝึกกับทุกเว็บไซต์ ทดสอบ workflow |
| Codeforces | ตาราง, อันดับ, สถิติผู้ใช้ | ปานกลาง | ต่ำ | แยกข้อมูลแบบมีโครงสร้าง, การแข่งขัน |
| Books to Scrape | ชื่อหนังสือ, ราคา, คะแนน, หมวดหมู่ | ต่ำ | ไม่มี | ฝึกสแครปอีคอมเมิร์ซสำหรับมือใหม่ |
| HackerRank | โจทย์, โปรไฟล์ผู้ใช้, leaderboards | สูง | ต้องล็อกอิน, หนัก JavaScript | คอนเทนต์ไดนามิก, authentication |
| Web Scraper Test | สินค้า, ตาราง, หน้าซ้อน | แปรผัน | ไม่มี | ทดสอบเครื่องมือ, static/dynamic |
| eBay | รายการสินค้า, ราคา, รูปภาพ, ข้อมูลผู้ขาย | สูง | CAPTCHA, rate limit | อีคอมเมิร์ซจริง, ติดตามราคา |
| Amazon | สินค้า, รีวิว, รูปภาพ, ราคา | สูงมาก | IP ban, fingerprinting | สแครปอีคอมเมิร์ซขั้นสูง |
| Yelp | ธุรกิจ, รีวิว, คะแนน, รูปภาพ | สูง | CAPTCHA, API limits | ข้อมูลธุรกิจท้องถิ่น, รีวิว |
| Stack Overflow | Q&A, แท็ก, สถิติผู้ใช้ | ปานกลาง | ต่ำ, มี API ให้ใช้ | สแครปฟอรั่ม, อินไซต์นักพัฒนา |
| Rotten Tomatoes | หนัง, คะแนน, รีวิว, นักวิจารณ์ | สูง | AJAX, hidden API | วิเคราะห์รีวิว, คอนเทนต์ไดนามิก |
สรุป: ยกระดับทักษะของคุณด้วยเว็บไซต์ฝึก Web Scraping ที่ใช่
ถ้าคุณอยากเก่ง web scraping ไม่มีอะไรแทนการฝึกจริงบนของจริงได้ เว็บไซต์ด้านบนไล่ระดับจากสนามซ้อมสำหรับมือใหม่ ไปจนถึงสนามรบจริงที่เต็มไปด้วยมาตรการกันบอท เริ่มจากเว็บง่าย ๆ อย่าง Books to Scrape แล้วค่อยไต่ระดับไปยังยักษ์ใหญ่แบบไดนามิกอย่าง Amazon หรือ Rotten Tomatoes
อย่าลืมว่าเครื่องมือที่คุณเลือกสำคัญพอ ๆ กับเว็บไซต์ที่คุณฝึก Thunderbit คือคำแนะนำอันดับหนึ่งของผมสำหรับผู้ใช้สายธุรกิจ และทุกคนที่อยากทำงานให้ไวขึ้น ทำอัตโนมัติได้มากขึ้น และรับมือกับเว็บไซต์ที่รกที่สุดได้ แต่ไม่ว่าคุณจะเลือกอะไรไว้ก็ตาม จงทดลองต่อไป เรียนรู้อย่างต่อเนื่อง และสแครปอย่างรับผิดชอบเสมอ—เคารพ robots.txt, rate limit และความเป็นส่วนตัว
ถ้าอยากเจาะลึกกว่านี้ ลองเข้าไปอ่าน Thunderbit Blog เพื่อดูคู่มือเพิ่มเติม หรือเข้าร่วมคอมมูนิตี้ web scraping เพื่อแลกเปลี่ยนเทคนิคและโจทย์ฝึกฝน อินเทอร์เน็ตคือสนามเล่นของคุณ—ไปดึงข้อมูลอะไรเจ๋ง ๆ กันเลย
ลองใช้ Thunderbit Agentic Web Scraper ฟรี Get Started Free
คำถามที่พบบ่อย
1. ทำไมฉันควรฝึก web scraping บนเว็บไซต์ตัวอย่าง แทนที่จะฝึกบนเว็บธุรกิจจริง?
เว็บไซต์ตัวอย่างถูกออกแบบมาให้ฝึกได้อย่างปลอดภัยและถูกกฎหมาย ช่วยให้คุณสร้างทักษะ ทดสอบเครื่องมือ และลองผิดลองถูกได้ โดยไม่เสี่ยงโดนแบนหรือมีปัญหาทางกฎหมาย พอคุณมั่นใจแล้ว ค่อยไปทำโปรเจกต์จริงด้วยความรับผิดชอบมากขึ้น
2. อะไรทำให้ Thunderbit เป็นเว็บไซต์ทดสอบ web scraping ที่ดี?
Thunderbit ไม่ใช่แค่เว็บทดสอบ แต่มันคือเครื่องมือที่ขับเคลื่อนด้วย AI ซึ่งให้คุณฝึกสแครปได้บนทุกเว็บไซต์ ตั้งแต่ง่ายไปจนซับซ้อน ฟีเจอร์อย่าง One Click Extract, การสแครป subpage และการส่งออกข้อมูลทันที ทำให้เหมาะทั้งมือใหม่และผู้ใช้ขั้นสูง
3. จะจัดการมาตรการกันการสแครปบนเว็บอย่าง eBay หรือ Amazon ยังไง?
เริ่มจากเคารพ rate limit และ robots.txt ก่อน สำหรับเว็บที่ยากขึ้น คุณอาจต้องใช้ proxy, หมุน user agent หรือจำลองพฤติกรรมของเบราว์เซอร์ การฝึกบนเว็บเหล่านี้จะช่วยให้คุณเรียนรู้การปรับวิธีทำงานได้
4. การทำ web scraping มีความเสี่ยงทางกฎหมายไหม?
ควรตรวจสอบเงื่อนไขการใช้งานของเว็บและ robots.txt เสมอ ฝึกกับหน้าสาธารณะที่ไม่ต้องล็อกอิน และหลีกเลี่ยงการดึงข้อมูลส่วนบุคคลหรือข้อมูลอ่อนไหว หากไม่แน่ใจ ให้ใช้เว็บไซต์ตัวอย่างหรือ official API
5. วิธีที่ดีที่สุดในการพัฒนาทักษะ web scraping คืออะไร?
เริ่มจากเว็บสำหรับมือใหม่อย่าง Books to Scrape จากนั้นขยับไปข้อมูลเชิงโครงสร้างอย่าง Codeforces, คอนเทนต์แบบไดนามิกอย่าง HackerRank และโจทย์จริงอย่าง Amazon หรือ Yelp ใช้เครื่องมืออย่าง Thunderbit เพื่อทำงานให้เป็นอัตโนมัติและคล่องขึ้น พร้อมเรียนรู้จากคอมมูนิตี้ไปด้วย
ขอให้สนุกกับการสแครป และขอให้ข้อมูลของคุณสะอาด เป็นระเบียบ และพร้อมใช้งานเสมอ
อ่านเพิ่มเติม



