
ตลาด web scraping มีมูลค่าถึง 754 ล้านดอลลาร์ในปี 2024 และกำลังก้าวไปสู่ 2.87 พันล้านดอลลาร์ภายในปี 2034 แต่เอาเข้าจริง ผู้ซื้อส่วนใหญ่ก็ยังเลือกผู้ให้บริการผิดตั้งแต่ครั้งแรกอยู่ดี
เรื่องนี้ก็ไม่ได้น่าแปลกอะไรนัก เพราะคำว่า “web scraping company” เป็นคำรวมที่กว้างมาก ตั้งแต่ Chrome Extension ที่ติดตั้งเสร็จใน 10 วินาที ไปจนถึงระบบส่งข้อมูลระดับองค์กรที่ใช้งบหลายล้านดอลลาร์ ยิ่งมีหน้าเว็บราคาไม่ชัด เครื่องมือพังบ่อย ๆ (มีผู้ใช้ Reddit รายหนึ่งบอกว่า ตัวสแครปเปอร์ 10–15% พังทุกสัปดาห์) และผู้ให้บริการนับร้อยที่ชอบอ้างว่า “scrape ได้ทุกเว็บไซต์” ความสับสนก็ยิ่งดูสมเหตุสมผลขึ้นมาทันที
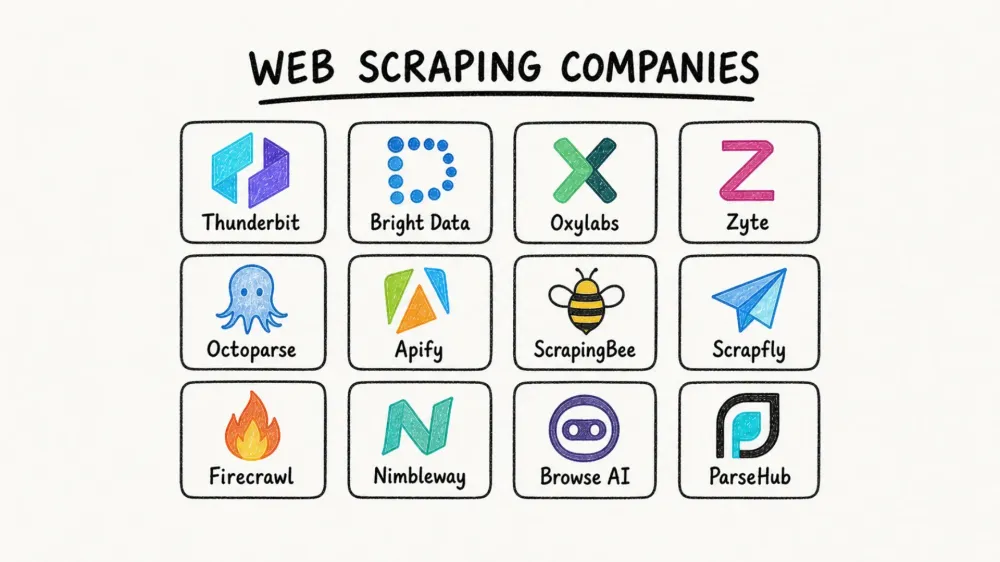
ผมทำงานอยู่ในทีม Thunderbit Official Website เลยได้เห็นคำถามที่ผู้ซื้อถามก่อนตัดสินใจแบบใกล้ชิด — รวมถึงความหงุดหงิดที่พวกเขาสะสมมาจากเครื่องมือเก่า ๆ ที่พอเว็บเป้าหมายปรับหน้าใหม่ก็หยุดทำงานทันที คู่มือฉบับนี้คือสิ่งที่ผมอยากมีตั้งแต่ตอนเริ่มศึกษาตลาดนี้: 12 บริษัท, 3 หมวดหมู่หลัก, ราคาจริงปี 2026, ตารางเปรียบเทียบแบบรวมศูนย์ และกรอบการตัดสินใจที่ช่วยให้คุณเลือกได้จริง
ทำไมการเลือกบริษัท Web Scraping ที่เหมาะสมจึงสำคัญในปี 2026
Web scraping ไม่ได้เป็นโปรเจกต์เสริมของนักพัฒนาอีกต่อไปแล้ว แต่มันกลายเป็นอินพุตทางธุรกิจที่ขับเคลื่อนข้อมูลด้านราคา การหาลูกค้าเป้าหมาย งานวิจัยตลาด การรวบรวมคอนเทนต์ และยิ่งมากขึ้นเรื่อย ๆ คือ pipeline สำหรับ AI และ LLM Market.us ระบุว่า 25.8% ของตลาด web scraping มาจาก price monitoring และ dynamic pricing เพียงอย่างเดียว ขณะที่ Mordor Intelligence ประเมินว่าตลาดในปี 2026 จะอยู่ที่ 1.17 พันล้านดอลลาร์ โดย price และ competitive monitoring โตที่ CAGR 19.23% ทั้งสองเจ้านิยามหมวดหมู่นี้ต่างกัน เลยทำให้ตัวเลขไม่ตรงกัน — ให้มองเป็นภาพคร่าว ๆ ของขนาดตลาดมากกว่าตัวเลขเป๊ะ ๆ
ผลลัพธ์ที่ได้ก็วัดได้จริง กรณีศึกษาของผู้ให้บริการหลายรายยืนยันเรื่องนี้: Zyte รายงานว่าร้านค้าปลีกระดับโลกแห่งหนึ่งประหยัดเวลาในการพัฒนา spider ได้ 25% ต่อหนึ่งตัว ส่วนกรณีใช้งาน Apify ด้าน lead generation ระบุว่าสามารถตัดงานที่ต้องทำด้วยมือออกไปได้มากกว่า 40 ชั่วโมงต่อหนึ่งรอบแคมเปญ
แต่ pain point ก็ชัดพอ ๆ กัน:
- สคริปต์มักพังเมื่อเว็บเปลี่ยนเลย์เอาต์หรือเพิ่มชั้นป้องกันบอท
- ราคาคุมยากเมื่อใช้งานจริงในระดับใหญ่ โดยเฉพาะโมเดลคิดตามการใช้งาน
- เครื่องมือจำนวนมากยังคาดหวังให้มีเวลาของนักพัฒนา ซึ่งทีมธุรกิจส่วนใหญ่ไม่มี
การเลือกผิด “หมวดหมู่” สำคัญกว่าการเลือกผิด “ผู้ขาย” อีก การให้ทีมขายสมัคร API ที่ออกแบบมาสำหรับนักพัฒนา จะเสียเวลาเป็นสัปดาห์กว่าจะรู้ว่าที่ต้องการจริง ๆ คือเครื่องมือแบบ no-code ในทางกลับกัน ทีมวิศวกรที่เลือกเครื่องมือคลิกสร้างสแครปเปอร์แบบ point-and-click ก็อาจชนเพดานปริมาณงานได้ภายในเดือนเดียว ดังนั้นให้ตัดสินใจเรื่องหมวดหมู่ก่อน แล้วค่อยเลือกผู้ให้บริการทีหลัง
บริษัท Web Scraping มี 3 ประเภทหลัก และทำไมเรื่องนี้จึงสำคัญ
ก่อนจะไปดูผู้ให้บริการแต่ละราย คุณต้องเข้าใจโมเดลการทำงาน 3 แบบที่ซ่อนอยู่ภายใต้คำว่า “web scraping company” ก่อน เพราะการสับสนตรงนี้คือสาเหตุหลักของความผิดหวังของผู้ซื้อ
| หมวดหมู่ | สิ่งที่คุณได้รับ | เหมาะกับใคร | ตัวอย่างจากลิสต์นี้ |
|---|---|---|---|
| Full-service / managed scraping | ผู้ให้บริการสร้างและดูแลสคริปต์ให้ทั้งหมด คุณได้ข้อมูลที่สะอาดและมีโครงสร้าง | ทีมที่ไม่มีทรัพยากร dev หรือมีเป้าหมายซับซ้อน ปริมาณสูง | Bright Data (datasets), Zyte, Nimbleway |
| Scraping APIs & infrastructure | คุณเรียก API แล้วระบบจัดการ proxy, rendering และ anti-bot ให้ | นักพัฒนาที่อยากควบคุมระบบ แต่ไม่อยากดูแลโครงสร้างพื้นฐานเอง | ScrapingBee, Scrapfly, Oxylabs, Firecrawl, Apify |
| No-code / browser-based tools | อินเทอร์เฟซแบบคลิกเลือก ใช้โค้ดน้อยหรือไม่ต้องใช้เลย | ผู้ใช้งานสายธุรกิจ เช่น ฝ่ายขาย อีคอมเมิร์ซ มาร์เก็ตติ้ง อสังหาฯ | Thunderbit, Octoparse, Browse AI, ParseHub |
บริษัท Web Scraping แบบ Full-Service / Managed
ผู้ให้บริการกลุ่มนี้ดูแลทั้ง pipeline ตั้งแต่ต้นจนจบ คุณระบุแค่ว่าต้องการข้อมูลอะไร ที่เหลือเขาจัดการให้ทั้งหมด ไม่ว่าจะเป็นการดึงข้อมูล การหลบระบบป้องกันบอท การ render การบำรุงรักษา และการส่งมอบ ข้อแลกเปลี่ยนชัดเจนมาก: งานดูแลน้อยที่สุด แต่ราคาสูงที่สุด ถ้าทีมคุณไม่มีเวลา dev เลย และต้องการข้อมูลจากเว็บที่ป้องกันแน่นในระดับใหญ่ นี่คือหมวดที่ควรเริ่มดู
ผู้ให้บริการ Scraping API และ Infrastructure
คุณส่ง URL หรือ task ไปยัง endpoint แล้วระบบจะส่ง HTML ที่ render แล้ว ข้อมูลที่มีโครงสร้าง หรือ screenshot กลับมา — โดยเบื้องหลังจัดการ proxy, browser rendering, retry และการแก้ CAPTCHA ให้ คุณยังต้องดูแลโค้ดเชื่อมต่อ, logic การ parse และ workflow ปลายน้ำเอง ข้อแลกเปลี่ยนคือ ต้นทุนปานกลาง งานดูแลปานกลางถึงสูง แต่คุม pipeline ได้เต็มที่
เครื่องมือ Web Scraping แบบ No-Code / Browser-Based
เครื่องมือเหล่านี้สร้างมาสำหรับผู้ปฏิบัติงาน ไม่ใช่วิศวกร ส่วนใหญ่ใช้ browser extension, visual workflow builder หรืออินเทอร์เฟซที่มี AI ช่วย เพื่อให้สร้างข้อมูลที่มีโครงสร้างได้เร็ว ข้อแลกเปลี่ยนคือ เริ่มใช้งานได้ไวที่สุด แต่โดยทั่วไปเพดานปริมาณงานจะต่ำกว่าผู้ให้บริการสาย API
Thunderbit อยู่ในหมวดที่สามนี้แบบชัดเจน คุณเปิดหน้าเว็บแล้วคลิกครั้งเดียว AI จะเดาเองว่าควรดึงฟิลด์ไหนและกรอกลงตารางให้ครบโดยไม่ต้องสั่งเพิ่ม เป้าหมายคือให้เซลส์หรือนักวิเคราะห์อีคอมเมิร์ซเปลี่ยนจากหน้าเว็บไปเป็นสเปรดชีตได้ภายในไม่กี่นาที พร้อมส่งออกฟรีไปยัง Excel, Google Sheets, Airtable และ Notion
ลองใช้ AI Web Scraper ของ Thunderbit
เราใช้เกณฑ์อะไรในการประเมินบริษัท Web Scraping ที่ดีที่สุด
เราประเมินผู้ให้บริการทั้ง 12 รายด้วยเกณฑ์เดียวกัน 7 ข้อ
| เกณฑ์ | ทำไมจึงสำคัญ |
|---|---|
| ประเภทบริษัท (full-service / API / no-code / extension) | บอกได้ว่าใครเป็นคนลงมือทำงานจริง |
| การจัดการ anti-bot & proxy | ปัญหาทางเทคนิคอันดับ 1 — การถูกบล็อกมักเสียเวลามากกว่าการเขียน parser |
| ภาระงานบำรุงรักษา | สแครปเปอร์พังได้ คำถามสำคัญคือใครจะซ่อม |
| ราคาที่โปร่งใส (ราคาแพ็กเกจจริงปี 2026, ฟรีแพลน) | คำว่า “ติดต่อฝ่ายขาย” ไม่ใช่คำตอบ |
| ใช้งานง่ายแบบ no-code | ผู้ซื้อจำนวนมากไม่ใช่สายเทคนิค |
| รูปแบบการส่งออกข้อมูล & การเชื่อมต่อ | ความเข้ากันได้ของ output ส่งผลต่อ workflow ปลายน้ำทั้งหมด |
| แท็ก use case ที่เหมาะที่สุด | ช่วยให้ผู้อ่านจับคู่ผู้ให้บริการกับสถานการณ์ได้เร็ว |
เกณฑ์เหล่านี้สะท้อนสิ่งที่ผู้ใช้บ่นกันในชุมชนสาธารณะโดยตรง บน Hacker News มีการถกเถียงในปี 2025 ว่า API คือสัญญา แต่ scraping มีความเปราะบางโดยธรรมชาติ ส่วนบน GitHub มี issue ของ Firecrawl ชื่อ “All scraping engines failed!” ที่เตือนว่าแม้แต่เครื่องมือยุค AI ก็ยังเจอ edge case ได้
1. Thunderbit
 Thunderbit คือ Chrome Extension ที่ขับเคลื่อนด้วย AI ออกแบบมาสำหรับผู้ใช้ที่ไม่ถนัดเทคนิค แต่ต้องการข้อมูลที่มีโครงสร้างจากเว็บไซต์ PDF และรูปภาพ โดยไม่ต้องเขียนโค้ดหรือจัดการ selector เอง
หมวดหมู่: เครื่องมือ no-code / browser-based พร้อม API เสริม
ขั้นตอนการทำงานหลัก: เปิดหน้าเว็บ → คลิกครั้งเดียว → AI จะหาเองว่าควรดึงฟิลด์อะไรและวิ่งต่อจนออกมาเป็นตารางเสร็จสมบูรณ์ ถ้าคุณต้องการฟิลด์เฉพาะ ก็พิมพ์บอกเป็นภาษาธรรมดาได้เลย ระบบจะใช้ตามนั้น สำหรับงานส่วนใหญ่ แค่นี้ก็จบ
ฟีเจอร์เด่น:
- ตรวจจับฟิลด์อัตโนมัติ: ระบุคอลัมน์ข้อมูลบนหน้าเว็บและดึงออกมาโดยไม่ต้องตั้งค่า
- Scraping หน้าย่อย: เข้าไปยัง detail page แต่ละหน้าแล้วเติมข้อมูลลงตารางหลักให้อัตโนมัติ
- Scheduled scraping: บอกช่วงเวลาเป็นภาษาธรรมดา ระบบจะรันตามกำหนดบนคลาวด์
- โหมด Cloud และ Browser: ใช้ browser mode กับหน้าที่ต้องล็อกอิน ส่วน cloud mode เหมาะกับความเร็ว (ครั้งละ 50 หน้า)
- ฟรีตัวดึงอีเมล เบอร์โทร และรูปภาพ: เหมาะกับ workflow ด้าน lead gen โดยไม่ต้องใช้เครื่องมือเสริม
- ส่งออกฟรี: Excel, Google Sheets, Airtable, Notion, CSV, JSON — ไม่มีค่าธรรมเนียมส่งออกเพิ่ม
anti-bot & การดูแลรักษา: AI จะอ่านหน้าเว็บใหม่ทุกครั้งที่รัน จึงปรับตามการเปลี่ยนเลย์เอาต์ได้อัตโนมัติ ทำให้ลดสาเหตุพังที่พบบ่อยที่สุดสำหรับผู้ใช้ธุรกิจที่ต้อง scraping เว็บหลากหลายแบบและเปลี่ยนบ่อย มันไม่ได้ดูแลตัวเอง 100% (ไม่มีอะไรที่เป็นแบบนั้น) แต่โจมตี failure mode ที่ทำให้ทีมที่ไม่ใช่สายเทคนิคหงุดหงิดมากที่สุดได้ตรงจุด
ราคา: ฟรีแพลน (6 หน้า/เดือน) พร้อมทดลองใช้ฟีเจอร์ Pro 7 วัน Starter ราคา $15/เดือน หรือ $9/เดือนเมื่อชำระรายปี Pro ราคา $38/เดือน หรือ $24/เดือนเมื่อชำระรายปี Business เป็นราคาตามตกลง Thunderbit's Web Scraper API คิดแยกต่างหาก เริ่มที่ $29/เดือน ($16/เดือนเมื่อชำระรายปี) และให้ 600 หน่วยฟรีตั้งต้น Credits คิดตาม output row: 1 ต่อแถว, 2 เมื่อแถวนั้นมาจากหน้าย่อย และ 30 ต่อการ enrich ข้อมูลส่วนบุคคลหนึ่งครั้ง ดูรายละเอียดล่าสุดได้ที่ Thunderbit Pricing
ตัวเลือกสำหรับนักพัฒนา: Thunderbit Open API มีทั้ง Distill endpoint (webpage → Markdown) และ Extract endpoint (webpage → structured JSON ผ่าน schema)
เหมาะสำหรับ: ทีมขาย (หาลีดจากไดเรกทอรี), ทีมอีคอมเมิร์ซ (ติดตามราคา, scraping SKU คู่แข่ง), เอเจนต์อสังหาฯ (ข้อมูลประกาศ) รวมถึงนักการตลาดและทีมปฏิบัติการที่ต้องการข้อมูลเว็บที่มีโครงสร้างโดยไม่ต้องพึ่งวิศวกร
ข้อจำกัด: ไม่ใช่ตัวเลือกที่ดีที่สุดสำหรับการ monitor SERP ระดับองค์กรที่มี 100K+ หน้า หรือเว็บที่มีการป้องกันบอทรุนแรง — งานแบบนั้นเหมาะกับผู้ให้บริการ proxy และ API ในลิสต์นี้มากกว่า เพดานปริมาณงานก็ต่ำกว่าผู้ให้บริการ API infrastructure โดยเฉพาะ
2. Bright Data
 Bright Data เป็นหนึ่งในแพลตฟอร์ม web data ที่ครอบคลุมที่สุดในโลก รวมเครือข่าย proxy ขนาดใหญ่ API สำหรับ scraping, Web Scraper IDE และชุดข้อมูลสำเร็จรูปไว้ในที่เดียว
หมวดหมู่: ไฮบริด — บริการจัดการ + API infrastructure
ฟีเจอร์เด่น:
- เครือข่าย proxy มากกว่า 400M IP (residential, datacenter, mobile, ISP)
- Web Scraper API, Web Unlocker, scraping IDE แบบ browser-based
- datasets มากกว่า 350 รายการ และ pre-built scrapers มากกว่า 437 ตัว
- โครงสร้างสำหรับส่งมอบข้อมูลและการปฏิบัติตามข้อกำหนดระดับองค์กร
anti-bot & การดูแลรักษา: รองรับ Cloudflare, CAPTCHA และ JS rendering ได้ในระดับสเกลสูง ชุดข้อมูลแบบ managed ช่วยรับภาระการบำรุงรักษาไปทั้งหมด
ราคา: Web Scraper API เริ่มที่ $1.5 / 1K records แบบ PAYG และแพ็ก Scale ที่ $499/เดือน ต้นทุน proxy อาจพุ่งเมื่อใช้งานหนัก — ต้องติดตามงบอย่างใกล้ชิด
เหมาะสำหรับ: องค์กรขนาดใหญ่ที่ต้อง scraping ปริมาณสูง ซับซ้อน และมีงบรองรับ
ข้อจำกัด: เรียนรู้ยากสำหรับผู้ใช้ไม่ถนัดเทคนิค โครงสร้างราคาซับซ้อน และอาจมีค่าใช้จ่ายพุ่งขึ้นเมื่อใช้ในสเกลใหญ่
3. Oxylabs
 Oxylabs คือผู้ให้บริการ proxy และ scraping infrastructure ระดับพรีเมียม ที่มี IP pool ใหญ่ที่สุดรายหนึ่งในอุตสาหกรรม
หมวดหมู่: Scraping API + proxy infrastructure
ฟีเจอร์เด่น:
- Residential และ datacenter proxies พร้อม geo-targeting ขั้นสูง
- Web Scraper API, SERP Scraper API, E-commerce Scraper API
- AI Web Scraping API / OxyCopilot สำหรับช่วย parsing ให้ดีขึ้น
- ทดลองใช้ฟรีสูงสุด 2,000 ผลลัพธ์
anti-bot & การดูแลรักษา: แก้การบล็อกได้แข็งแรงสำหรับงาน scraping ปริมาณสูงที่ใช้ IP หนัก ๆ เหมาะมากกับการดึงข้อมูลซ้ำ ๆ ในสเกลใหญ่
ราคา: Web Scraper API เริ่มที่ $49/เดือน แพ็ก proxy และ add-on สำหรับ IP pool อาจทำให้ต้นทุนรวมสูงขึ้น
เหมาะสำหรับ: ทีมพัฒนาที่ต้องการ proxy infrastructure ที่เชื่อถือได้สำหรับการดึงข้อมูลซ้ำในระดับใหญ่ โดยเฉพาะ SERP และ product intelligence
ข้อจำกัด: ไม่มีเส้นทางแบบ no-code ที่ใช้งานได้จริงสำหรับผู้ใช้ธุรกิจ ต้นทุนรวมจะสูงขึ้นเมื่อเพิ่ม proxy และ use case ขั้นสูง
4. Zyte
 Zyte ก่อตั้งโดยผู้สร้างเฟรมเวิร์ก Scrapy แบบโอเพนซอร์ส และผสาน API สำหรับ scraping ที่มี AI ช่วยกับ Scrapy Cloud และบริการดึงข้อมูลแบบ managed
หมวดหมู่: ไฮบริด — API + managed service
ฟีเจอร์เด่น:
- Zyte API พร้อม automatic extraction ที่มี AI ช่วย
- Scrapy Cloud สำหรับ deploy และจัดการ spiders
- มี smart proxy management และ browser rendering ในตัว
- Zyte Data สำหรับองค์กรที่ต้องการบริการ extraction แบบ managed
anti-bot & การดูแลรักษา: smart proxy rotation ในตัว และฟีเจอร์ AI ช่วยลดภาระการดูแล selector
ราคา: ได้เครดิตเริ่มต้นฟรี $5 ราคา Zyte API คิดตามการใช้งาน Scrapy Cloud เริ่มที่ $9/หน่วย/เดือน
เหมาะสำหรับ: ทีม Python/Scrapy ที่ต้องการสภาพแวดล้อมบนคลาวด์แบบ managed พร้อม extraction ที่มี AI ช่วย
ข้อจำกัด: เรียนรู้ยากขึ้นสำหรับคนที่ไม่ใช่นักพัฒนา เรื่อง no-code ยังไม่แข็งแรงเท่าเครื่องมือ browser-based
5. Octoparse
 Octoparse เป็นหนึ่งในแบรนด์ no-code web scraping ที่อยู่มานานและเป็นที่รู้จักมากที่สุด สร้างบน visual point-and-click workflow builder
หมวดหมู่: เครื่องมือ no-code
ฟีเจอร์เด่น:
- ตัวสร้าง workflow แบบภาพพร้อม drag-and-drop logic
- มีทั้ง desktop app และการรันบนคลาวด์แบบตั้งเวลาได้
- รองรับ pagination, infinite scroll และหน้าที่ต้องล็อกอิน
- เทมเพลตสำเร็จรูปสำหรับเว็บไซต์ยอดนิยม
- ส่งออกเป็น CSV, Excel, JSON, HTML และ XML
anti-bot & การดูแลรักษา: มี CAPTCHA handling และ cloud scraping พร้อม IP rotation ในตัว ผู้ใช้ยังต้องอัปเดต workflow เองเมื่อเลย์เอาต์เว็บเปลี่ยน
ราคา: ฟรีตลอดกาล (10 tasks, ส่งออกได้ 50,000 แถวต่อเดือน) Standard $83/เดือน หรือ $69/เดือนเมื่อชำระรายปี Professional $299/เดือน หรือ $249/เดือนเมื่อชำระรายปี Enterprise เป็นราคาตามตกลง
เหมาะสำหรับ: นักการตลาด นักวิจัย และทีมอีคอมเมิร์ซที่อยากได้อินเทอร์เฟซสำหรับ scraping แบบเห็นภาพโดยไม่ต้องเขียนโค้ด
ข้อจำกัด: ต้องติดตั้งซอฟต์แวร์บนเดสก์ท็อป การดูแล workflow ยังตกกับผู้ใช้เมื่อเว็บเป้าหมายเปลี่ยน เพราะ workflow ทำงานบน selector ที่บันทึกไว้ ไม่ได้อ่านหน้าใหม่ทุกครั้ง
6. Apify
 Apify ไม่ได้เป็นแค่สแครปเปอร์ แต่เป็นทั้งแพลตฟอร์มและ marketplace ซึ่งทำให้มันเด่นมากเมื่อมี scraper สำเร็จรูปสำหรับเว็บที่คุณต้องการอยู่แล้ว
หมวดหมู่: แพลตฟอร์มสำหรับนักพัฒนา + marketplace
ฟีเจอร์เด่น:
- Actor marketplace มีสแครปเปอร์และ automation สำเร็จรูปประมาณ 59,000 รายการ (Apify Store, สิงหาคม 2026)
- Apify SDK สำหรับสร้าง crawler เอง
- เชื่อมต่อกับ Zapier, Google Sheets, webhook และ API ได้
- แผนแพลตฟอร์มรวม proxy management มาให้
anti-bot & การดูแลรักษา: คุณภาพขึ้นอยู่กับ Actor แต่ละตัว Actor ทางการมักดูแลดี ส่วน Actor ของชุมชนอาจพังได้โดยไม่แจ้งล่วงหน้า
ราคา: ฟรีแพลนพร้อมเครดิตใช้งาน $5 Starter เริ่มที่ $29/เดือน และมี compute credits คิดเพิ่มตามการใช้งาน
เหมาะสำหรับ: ทีมที่อยากได้ scraper สำเร็จรูปสำหรับเว็บยอดนิยมเฉพาะเจาะจง (Google Maps, Amazon, Instagram) โดยไม่ต้องสร้างใหม่จากศูนย์
ข้อจำกัด: คุณภาพแตกต่างกันมากใน Actor ของชุมชน เว็บที่ซับซ้อนหรือเฉพาะทางยังต้องพัฒนาเอง ไม่ใช่ no-code แท้ ๆ สำหรับ scraper แบบกำหนดเอง
7. ScrapingBee
 ScrapingBee คือหนึ่งใน API สำหรับนักพัฒนาที่สะอาดและใช้ง่ายที่สุดในหมวดนี้ — มุ่งทำให้การดึงหน้าเว็บ การ render และการหมุน proxy ง่ายเหมือนเรียก API ครั้งเดียว ปัจจุบันเป็นส่วนหนึ่งของกลุ่ม Oxylabs และยังแยกเป็นโปรดักต์ของตัวเองอยู่ ซึ่งควรรู้ไว้ถ้าคุณกำลัง shortlist ทั้งสองเจ้า
หมวดหมู่: Scraping API
ฟีเจอร์เด่น:
- REST API แบบเรียกครั้งเดียว (ส่ง URL แล้วรับ HTML หรือ JSON)
- headless Chrome rendering ในตัว
- รองรับ residential และ datacenter proxy rotation
- มี Google Search API และ screenshot API
- เพิ่มตัวเลือก Markdown และ AI extraction รุ่นใหม่
anti-bot & การดูแลรักษา: จัดการ JS rendering และ proxy rotation ให้อัตโนมัติ คุณต้องดูแล logic การ parse และ schema เอง
ราคา: ทดลองได้ 1,000 เครดิตฟรี แผนเริ่มที่ $49/เดือน
เหมาะสำหรับ: นักพัฒนาที่ต้องการ API ที่สะอาดและตรงไปตรงมาสำหรับ render และดึงหน้าเว็บ แล้วค่อย parse ข้อมูลเอง
ข้อจำกัด: โปรดักต์หลักยังคงเป็นการดึงหน้าเว็บ คุณต้องรับผิดชอบการ extraction, การจัดโครงสร้าง และความเสถียรของ workflow ปลายน้ำเอง
8. Scrapfly
 Scrapfly คือ API ที่โฟกัสด้าน anti-bot ชัดที่สุดในลิสต์นี้ สร้างมาสำหรับนักพัฒนาที่ต้องเจาะเว็บที่ป้องกันเข้มมาก
หมวดหมู่: Scraping API
ฟีเจอร์เด่น:
- bypass anti-bot สำหรับ Cloudflare, DataDome, PerimeterX และระบบป้องกันลักษณะเดียวกัน
- headless browser rendering
- residential proxy rotation
- ส่งข้อมูลผ่าน webhook, retry อัตโนมัติ และจับ screenshot ได้
anti-bot & การดูแลรักษา: เชี่ยวชาญกับเว็บที่ scrape ยาก รับภาระความซับซ้อนด้าน anti-bot ส่วนใหญ่ไปให้ คุณยังต้องจัดการ parsing เอง
ราคา: ฟรีแพลน 1,000 credits แผนเสียเงินเริ่มที่ $30/เดือน
เหมาะสำหรับ: นักพัฒนาที่ scrape เว็บที่มีการป้องกันบอทรุนแรง และต้องการอัตราความสำเร็จสูงโดยไม่ต้องดูแล proxy/bypass stack เอง
ข้อจำกัด: โฟกัสอยู่ที่การ fetch และ render — การดึงข้อมูลที่มีโครงสร้างคือความรับผิดชอบของคุณเอง ระบบนิเวศยังเล็กกว่า Bright Data หรือ Oxylabs
9. Firecrawl
 Firecrawl ถูกออกแบบมาสำหรับนักพัฒนาที่ต้องการเนื้อหาเว็บสะอาด ๆ ไปใช้ใน workflow ของ AI ไม่ใช่แค่ HTML ดิบ
หมวดหมู่: Scraping API สำหรับ AI / LLM pipeline
ฟีเจอร์เด่น:
- มี scrape และ crawl endpoints
- ส่งออกแบบ Markdown-first (ออกแบบมาเพื่อ RAG และการป้อนเข้า LLM)
- ดึงข้อมูลแบบมีโครงสร้างผ่าน LLM
- รองรับ JS rendering และ proxy modes
- workflow แบบ batch-friendly สำหรับระบบ agent
anti-bot & การดูแลรักษา: รองรับ rendering และ anti-bot ขั้นพื้นฐาน เน้นคุณภาพของเนื้อหามากกว่าปริมาณดิบ
ราคา: ฟรี 1,000 เครดิตฟรีต่อเดือน Hobby $19/เดือน หรือ $16/เดือนเมื่อชำระรายปี Standard $99/เดือน หรือ $83/เดือนเมื่อชำระรายปี
เหมาะสำหรับ: ทีม AI/ML และนักพัฒนาที่สร้าง RAG pipeline, knowledge base หรือแอปที่ใช้ LLM และต้องการคอนเทนต์เว็บที่สะอาด
ข้อจำกัด: เป็นโปรดักต์ที่ค่อนข้างใหม่ ฟีเจอร์ยังน้อยกว่าผู้ให้บริการระดับองค์กร ไม่ได้ออกแบบมาสำหรับการ monitor อีคอมเมิร์ซปริมาณสูง และมีเฉพาะฝั่งนักพัฒนา — ไม่มีตัวเลือก no-code
10. Nimbleway
 Nimbleway วางตัวใกล้เคียงกับแพลตฟอร์มส่งมอบข้อมูลที่มีโครงสร้าง มากกว่าจะเป็นเครื่องมือ scraping แบบ self-serve สำหรับ SMB
หมวดหมู่: Full-service / managed scraping พร้อม API layer
ฟีเจอร์เด่น:
- Nimble Browser (cloud browser สำหรับ scraping)
- Structured data API แบบเรียลไทม์สำหรับ search, e-commerce และ maps
- parsing ด้วย AI และโครงสร้างปลดล็อกเว็บในตัว
- ส่งมอบ pipeline แบบ managed
anti-bot & การดูแลรักษา: จัดการให้ทั้งหมด Nimbleway รับผิดชอบทั้งการดูแล pipeline, anti-bot และการส่งมอบข้อมูล
ราคา: แบบจ่ายตามใช้เริ่มที่ $1 ต่อ 1,000 requests สำหรับ extract, crawl และ map และ $3 ต่อ 1,000 สำหรับเทมเพลต extraction สำเร็จรูป Managed Data Services เริ่มที่ $2,500/เดือน เมื่อชำระรายปี
เหมาะสำหรับ: ธุรกิจขนาดกลางถึงใหญ่ที่ต้องการข้อมูลสะอาด มีโครงสร้าง และส่งมอบให้พร้อม โดยไม่ต้องมานั่งดูแลสแครปเปอร์เอง
ข้อจำกัด: ราคาแพงเกินไปสำหรับ workflow ของ SMB จำนวนมาก และถือว่าเกินจำเป็นสำหรับงาน scraping ง่าย ๆ หรือใช้งานครั้งเดียว
11. Browse AI
 Browse AI เด่นที่สุดเมื่อ workflow ไม่ได้เน้นแค่ extraction ครั้งเดียว แต่เน้นการ monitor ซ้ำ ๆ พร้อมการแจ้งเตือน
หมวดหมู่: เครื่องมือ no-code
ฟีเจอร์เด่น:
- ฝึก robot แบบ point-and-click
- ตรวจจับการเปลี่ยนแปลงและ monitor พร้อมแจ้งเตือน
- เชื่อมต่อกับ Google Sheets, Airtable, Zapier, webhook และ API ได้
- รองรับการดึงข้อมูลจำนวนมากและการรันตามกำหนดซ้ำ ๆ
anti-bot & การดูแลรักษา: จัดการ anti-bot ขั้นพื้นฐานได้ Robot อาจต้องสอนใหม่เมื่อโครงสร้างเว็บเปลี่ยนมาก
ราคา: ฟรีตลอดกาล (50 credits/เดือน) Personal $48/เดือน หรือ $19/เดือนเมื่อชำระรายปี Professional $87/เดือน หรือ $69/เดือนเมื่อชำระรายปี
เหมาะสำหรับ: ผู้ใช้งานธุรกิจที่ติดตามราคาคู่แข่ง, งานประกาศรับสมัครงาน หรือความพร้อมของสินค้าในระยะยาว
ข้อจำกัด: อาจมีปัญหากับเว็บที่เปลี่ยนตลอดหรือใช้ JS หนัก ๆ และต้อง retrain robot เมื่อเลย์เอาต์เปลี่ยน
12. ParseHub
 ParseHub ยังมีที่ยืนของมันสำหรับโปรเจกต์เล็ก ๆ นักเรียน และทีมที่อยากลอง scraping เป็นครั้งแรก
หมวดหมู่: เครื่องมือ no-code
ฟีเจอร์เด่น:
- extraction แบบ visual point-and-click
- รองรับหน้าที่ render ด้วย JS
- ส่งออกได้ทั้ง CSV, JSON, Excel, API และ webhook
- ฟรีแพลนที่รู้จักกันดี (5 projects, 200 pages/run)
anti-bot & การดูแลรักษา: รองรับพื้นฐาน ไม่มี proxy infrastructure ขั้นสูง Workflow อาจพังเมื่อเว็บไซต์เปลี่ยน
ราคา: มีฟรีแพลน แผนเสียเงินเริ่มที่ $189/เดือน
เหมาะสำหรับ: โปรเจกต์ขนาดเล็กที่คุมงบ หรือผู้ใช้ที่อยากทดลอง scraping โดยยังไม่อยากลงทุนโครงสร้างพื้นฐาน
ข้อจำกัด: ราคาของแผนเสียเงินค่อนข้างสูงเมื่อเทียบกับความลึกของฟีเจอร์ ความรู้สึกของโปรดักต์ดูเก่ากว่าคู่แข่งที่เกิดมาพร้อม AI และช้ากว่า/ยืดหยุ่นน้อยกว่าตัวเลือก modern cloud-first
เปรียบเทียบบริษัท Web Scraping ที่ดีที่สุด: ตารางใหญ่ฉบับรวม
ทุกอย่างที่กล่าวมารวมไว้ในที่เดียว ราคาเริ่มต้นคืออัตรารายเดือน และใส่อัตรารายปีไว้ในวงเล็บเมื่อผู้ให้บริการมีให้เลือก ส่วนคอลัมน์ “Free Tier?” ถ้าเป็น “Yes” หมายถึงมีโควตาที่ต่ออายุได้หรือไม่หมดอายุ ถ้าเป็น “Trial” หมายถึงให้ใช้ได้ครั้งเดียว
| บริษัท | หมวดหมู่ | เหมาะที่สุดสำหรับ | มี Free Tier? | ราคาเริ่มต้น | รูปแบบราคา | anti-bot | ภาระการดูแล | No-Code? | รูปแบบส่งออกหลัก |
|---|---|---|---|---|---|---|---|---|---|
| Thunderbit | No-code + API | ทีมธุรกิจ, เว็บหลากหลาย | มี (6 หน้า/เดือน) | $15/เดือน ($9/เดือนรายปี) | เครดิตคิดตามแถว; หน่วย API | ปานกลาง | 🟡 | ใช่ | Excel, Sheets, Airtable, Notion, CSV, JSON |
| Bright Data | Managed แบบไฮบริด + API | ดึงข้อมูลระดับองค์กร | มี (5K records/เดือน) | $1.5/1K records หรือ $499/เดือน | คิดตามผลลัพธ์, ตาม request, dataset | แข็งแรงมาก | 🟢 datasets / 🟠 API | บางส่วน | API outputs, การส่งมอบ dataset |
| Oxylabs | API + proxy infra | ดึงข้อมูลซ้ำที่ใช้ proxy หนัก ๆ | ทดลองใช้ | $49/เดือน | คิดตามผลลัพธ์ + แพ็ก proxy | แข็งแรงมาก | 🟠 | ไม่มี | API / กำหนดเอง |
| Zyte | Managed แบบไฮบริด + API | ทีม Scrapy/Python | มี ($5 credit) | คิดตามการใช้งาน; cloud $9/หน่วย/เดือน | API ตามการใช้งาน + cloud | แข็งแรง | 🟢 Zyte Data / 🟠 Zyte API | จำกัด | CSV, JSON, XML, storage |
| Octoparse | No-code | Workflow scraping แบบเห็นภาพ | มี (10 tasks) | $83/เดือน ($69/เดือนรายปี) | สมัครสมาชิกรายเดือน + add-on | ปานกลาง | 🟡 | ใช่ | CSV, Excel, JSON, HTML, XML |
| Apify | แพลตฟอร์ม + marketplace | สแครปเปอร์สำเร็จรูปเฉพาะเว็บ | มี (Yes) | $29/เดือน | สมัครสมาชิก + usage + Actor | ดี (แต่ต่างกัน) | 🟠 | บางส่วน | Datasets, API, integrations |
| ScrapingBee | API | render และ unblock แบบง่าย | ทดลองใช้ | $49/เดือน | เครดิตฟรีรายเดือน | ดี | 🟠 | ไม่มี | HTML, Markdown, JSON |
| Scrapfly | API | เป้าหมายที่มี anti-bot หนัก | มี (1,000 credits) | $30/เดือน | เครดิตรายเดือน | แข็งแรงมาก | 🟠 | ไม่มี | HTML, screenshots, JSON |
| Firecrawl | AI/LLM scraping API | Markdown และ AI data pipeline | มี (1K credits/เดือน) | $19/เดือน ($16/เดือนรายปี) | คิดตามเครดิต | ปานกลาง-แข็งแรง | 🟠 | ไม่มี | Markdown, HTML, JSON |
| Nimbleway | Managed + API | ข้อมูลองค์กรแบบมีโครงสร้าง | มี (5K requests/เดือน) | $1/1K requests หรือ $2,500/เดือน managed | PAYG API + แผนรายปี | แข็งแรง | 🟢 managed / 🟠 API | ไม่มี | Structured feeds, APIs |
| Browse AI | No-code | การมอนิเตอร์และแจ้งเตือนการเปลี่ยนแปลง | มี (50 credits/เดือน) | $48/เดือน ($19/เดือนรายปี) | เครดิต + ขีดจำกัดไซต์ | พื้นฐาน-ปานกลาง | 🟡 | ใช่ | Sheets, Airtable, Zapier, API |
| ParseHub | No-code | โปรเจกต์เล็กแบบฟรี | มี (200 pages/run) | $189/เดือน | ระดับแพ็กเกจสมัครสมาชิก | พื้นฐาน | 🟡 | ใช่ | CSV, JSON, Excel, API |
ระดับภาระการดูแล:
- 🟢 ต่ำที่สุด: ผู้ให้บริการรับผิดชอบงานดูแลส่วนใหญ่
- 🟡 ต่ำ-ปานกลาง: ผู้ให้บริการดูแลการ fetch และ parsing ส่วนผู้ใช้เป็นคนรัน workflow และแก้เมื่อเว็บเป้าหมายเปลี่ยน
- 🟠 ปานกลาง-สูง: ผู้ให้บริการดูแล fetch/unblock ส่วนผู้ใช้รับผิดชอบ parsing และ integration
- 🔴 สูงที่สุด: ผู้ใช้ต้องรับผิดชอบแทบทุกอย่าง
ความเสถียรและการบำรุงรักษา: อะไรพัง และใครเป็นคนแก้
หัวข้อนี้สำคัญกว่าการเทียบฟีเจอร์ใด ๆ
เหตุผลหลักที่ผู้ซื้อไม่พอใจกับผู้ให้บริการ scraping ไม่ใช่เพราะรันครั้งแรกพัง แต่เพราะครั้งที่ 5, 50 หรือ 500 พัง — แล้วต้องมีใครในทีมมารับผิดชอบความเละนี้
| ระดับการดูแล | ประเภทผู้ให้บริการ | คุณต้องดูแลอะไร | ผู้ให้บริการดูแลอะไร |
|---|---|---|---|
| 🟢 ต่ำที่สุด | Full-service (Bright Data datasets, Zyte managed, Nimbleway) | ข้อกำหนดและการตรวจสอบผลลัพธ์ | การ scraping, anti-bot, เปลี่ยนเลย์เอาต์, QA, การส่งมอบ |
| 🟡 ต่ำ-ปานกลาง | เครื่องมือ no-code (Thunderbit, Octoparse, Browse AI, ParseHub) | การรัน workflow, ตรวจผลลัพธ์ และสร้างใหม่เมื่อเครื่องมืออาศัย selector ที่บันทึกไว้ | การ fetch, parsing, hosting และ scheduling |
| 🟠 ปานกลาง-สูง | Scraping APIs (ScrapingBee, Scrapfly, Oxylabs, Apify, Firecrawl) | โค้ด integration, parsing, retry และตรวจ schema | Proxy, rendering, บางส่วนของชั้น unblock |
| 🔴 สูงที่สุด | DIY / เฟรมเวิร์กโอเพนซอร์ส | ทุกอย่าง | ไม่มีอะไรเลย |
เครื่องมือ no-code อยู่กึ่งกลางตรงนี้ ไม่มีตัวไหนลบทุก failure mode ได้หมด และเครื่องมือที่ทำงานบน selector ที่บันทึกไว้ยังคงพังเมื่อหน้าเว็บถูกสร้างใหม่ การแก้ปัญหาแบบ AI-first จึงโจมตี failure mode ที่เฉพาะเจาะจงนี้: Thunderbit อ่านหน้าเว็บใหม่ทุกครั้งแทนที่จะพึ่ง selector ตายตัวที่ผู้ใช้ต้องคอยดูแล สำหรับผู้ใช้ธุรกิจที่ต้องจัดการกับเว็บหลากหลายซึ่งความสม่ำเสมอไม่สูง วิธีนี้อยู่ด้วยง่ายกว่าวิธีใช้ visual workflow builder แบบเดิมมาก
ผู้ให้บริการแบบ full-service ยังรับภาระงานดูแลได้มากที่สุดโดยรวม แต่ก็คิดค่าบริการสูงที่สุดเช่นกัน ไม่มีมื้อกลางวันฟรี — คุณกำลังเลือกอยู่ว่าใครจะเป็นคนรับภาระงาน operation
ราคา 2026 จริง ๆ: เทียบต้นทุนแบบโปร่งใส
บทความรวมลิสต์ส่วนใหญ่หลบหัวข้อนี้ คำว่า “ติดต่อฝ่ายขาย” ไม่ใช่หน้าราคา นี่คือตัวเลขจริง ๆ ตามที่เห็นได้ โดยใช้หลักการเดียวกับตารางใหญ่ด้านบน และเพิ่มคอลัมน์สำหรับต้นทุนที่ไม่ได้ปรากฏบนราคาหน้าปก
| บริษัท | มี Free Tier? | ราคาเริ่มต้น | รูปแบบราคา | ความเสี่ยงต้นทุนแฝง |
|---|---|---|---|---|
| Thunderbit | มี (6 หน้า/เดือน) | $15/เดือน ($9/เดือนรายปี) | เครดิตคิดตามแถว | แถวจากหน้าย่อยใช้ 2 เครดิต, enrichment ใช้ 30 |
| Bright Data | มี (5K records/เดือน) | $1.5/1K records หรือ $499/เดือนในแผน Scale | คิดตามผลลัพธ์หรือ request | ค่า proxy พุ่งเมื่อใช้งานหนัก |
| Oxylabs | ทดลองใช้ (2,000 ผลลัพธ์) | $49/เดือน | คิดตาม request + proxy bundles | ค่า add-on สำหรับ IP pool |
| Zyte | มี ($5 credit) | คิดตามการใช้งาน | API usage + cloud units | ค่าระดับ rendering และความซับซ้อน |
| Octoparse | มี (10 tasks) | $83/เดือน ($69/เดือนรายปี) | สมัครสมาชิก + ค่าเสริม | Proxy, CAPTCHA และ service add-on |
| Apify | มี ($5 credit) | $29/เดือน | สมัครสมาชิก + compute + ค่า Actor | ความต่างของ Actor และ usage |
| ScrapingBee | ทดลองใช้ (1,000 credits) | $49/เดือน | คิดตามเครดิต | ตัวเลือก rendering ใช้เครดิตมากขึ้น |
| Scrapfly | มี (1,000 credits) | $30/เดือน | คิดตามเครดิต | โหมด residential และ enhanced แพงกว่า |
| Firecrawl | มี (1,000 credits/เดือน) | $19/เดือน ($16/เดือนรายปี) | คิดตามเครดิต | proxy ขั้นสูงและโหมด extraction ที่สมบูรณ์ขึ้น |
| Nimbleway | มี (5K requests/เดือน) | $1/1K requests หรือ $2,500/เดือน managed | API + แผนรายปี | แผน managed คิดรายปี |
| Browse AI | มี (50 credits/เดือน) | $48/เดือน ($19/เดือนรายปี) | เครดิต + ขีดจำกัด | เว็บไซต์พรีเมียมและเพดานจำนวนเว็บ |
| ParseHub | มี (200 pages/run) | $189/เดือน | ระดับแพ็กเกจสมัครสมาชิก | ราคาชัด แต่คุ้มค่าน้อยเมื่อขึ้นแพ็กเกจเสียเงิน |
ในบรรดาเครื่องมือที่มีราคาแพ็กเกจรายเดือนแบบคงที่ Thunderbit ($15) และ Firecrawl ($19) เป็นทางเข้าที่ถูกที่สุด ตามมาด้วย Apify ($29) และ Scrapfly ($30) ส่วน Octoparse ($83) และ ParseHub ($189) เป็นทางเข้าที่แพงที่สุดในกลุ่ม no-code ขณะที่ Bright Data และ Zyte คิดตามการใช้งาน ดังนั้น pilot เล็ก ๆ กับทั้งสองเจ้านี้อาจมีต้นทุนต่ำกว่าทุกตัว Bright Data, Oxylabs และ Nimbleway เหมาะกว่าเมื่อปริมาณงาน ความยากของเว็บเป้าหมาย และความต้องการระดับองค์กรสำคัญกว่างบที่คำนวณง่าย ๆ
บริษัท Web Scraping แบบไหนเหมาะกับคุณ? ใช้กรอบตัดสินใจนี้
ใช้ลำดับนี้เพื่อคัดตัวเลือกให้แคบลงอย่างรวดเร็ว
1. ปริมาณข้อมูลของคุณเท่าไร?
- ต่ำกว่า 1,000 หน้า/เดือน → เครื่องมือ no-code (Thunderbit, Browse AI, Octoparse, ParseHub)
- 10K+ หน้า/เดือน → APIs (Oxylabs, ScrapingBee, Apify, Scrapfly, Firecrawl)
- 100K+ หน้า/เดือน → managed ระดับองค์กร (Bright Data, Nimbleway, Zyte Data)
2. ในทีมมีนักพัฒนาหรือไม่?
- มี → เครื่องมือ API ให้คุณคุมระบบได้ (Oxylabs, ScrapingBee, Apify, Scrapfly, Firecrawl, Zyte API)
- ไม่มี → no-code (Thunderbit, Browse AI, Octoparse) หรือ full-service (Bright Data datasets, Nimbleway)
3. มีเว็บเป้าหมายกี่เว็บ?
- มีไม่กี่เว็บที่รู้จักและค่อนข้างนิ่ง → เทมเพลตและ Actor สำเร็จรูปใช้ได้ดี
- เว็บหลากหลาย เปลี่ยนบ่อย และมี long tail เยอะ → ความยืดหยุ่นแบบ AI สำคัญ (Thunderbit เด่นมากในจุดนี้)
4. เพดานงบของคุณอยู่ที่เท่าไร?
- ต่ำกว่า $50/เดือน → ฟรีแพลน (Thunderbit, ParseHub, Apify, Scrapfly, Firecrawl)
- $50–$500/เดือน → API ระดับกลางและแพ็ก no-code ที่จ่ายแล้ว
- $500+/เดือน → บริการ managed ระดับองค์กร
5. ต้องการดึงครั้งเดียวหรือ monitor ต่อเนื่อง?
- ต่อเนื่อง → ความสามารถด้าน scheduled scraping สำคัญ (Thunderbit, Browse AI, Bright Data datasets)
- ครั้งเดียว → ใช้ตัวไหนก็ได้; ให้เน้นความเร็วในการตั้งค่า
สรุปคำตอบเร็ว ๆ:
- ทีมไม่ถนัดเทคนิค, เว็บหลากหลาย, ไม่มี dev → Thunderbit
- นักพัฒนาสร้าง data pipeline ขนาดใหญ่ → Oxylabs, ScrapingBee หรือ Apify
- อยากให้คนอื่นดูแลทุกอย่าง → บริการ managed ของ Bright Data หรือ Zyte
- สร้าง pipeline ข้อมูลสำหรับ AI/LLM → Firecrawl หรือ Thunderbit API
กรณีใช้งานจริง: บริษัทไหนเหมาะกับสถานการณ์ไหน
ติดตามราคาในอีคอมเมิร์ซ
สำหรับทีมปฏิบัติการที่ติดตามราคาคู่แข่งบน Shopify store, Thunderbit คือทางลัดที่เร็วที่สุด เปิดหน้า collection แล้วคลิกครั้งเดียว AI จะเดาเองว่าควรดึงฟิลด์อะไร — โดยปกติคือชื่อสินค้า ราคา สถานะสินค้า และ URL — แล้วกรอกเป็นตารางให้ครบเอง ถ้าคุณต้องการฟิลด์ต่างออกไป ก็แค่บอกเป็นประโยคสั้น ๆ ระบบจะใช้ฟิลด์ชุดนั้นแทน จากนั้นตั้งให้รันตามกำหนดใน cloud mode ถ้าต้องเช็กแต่ละหน้า product detail page ด้วย subpage scraping จะเติมข้อมูลลงตารางให้อัตโนมัติ แล้วค่อยส่งออกไป Google Sheets เพื่อให้ workflow ด้านราคาเดินต่อจากตรงนั้น
Bright Data แก้ปัญหาเดียวกันจากอีกฝั่งหนึ่ง แทนที่จะให้คุณรัน workflow เอง คุณสามารถซื้อ e-commerce dataset แบบ managed หรือใช้ enterprise stack ได้เลย ซึ่งสะดวกกว่า แต่โครงสร้างต้นทุนต่างออกไปโดยสิ้นเชิง
การหาลีด B2B (อีเมลและเบอร์โทรศัพท์)
สำหรับโปรเจกต์ prospecting ขนาดเล็กถึงกลาง ตัวดึงอีเมลและเบอร์โทรฟรีของ Thunderbit ใช้งานได้จริงกับไดเรกทอรีสาธารณะ, หน้า local listing และเว็บไซต์ธุรกิจเฉพาะทาง จุดเด่นคือความเร็ว: ดึงรายชื่อ ส่งออก แล้วนำเข้าระบบ CRM ต่อได้โดยไม่ต้องตั้งค่าทางเทคนิค
Apify จะเด่นกว่าเมื่อแหล่งข้อมูลเป็นแพลตฟอร์มยอดนิยมขนาดใหญ่ที่มี Actor ecosystem สมบูรณ์ ถ้าคุณอยากได้ lead list จาก Google Maps ปริมาณสูง Actor สำเร็จรูปจะพาคุณเริ่มได้เร็วกว่าเริ่มจากศูนย์
การมอนิเตอร์ SERP ขนาดใหญ่
เรื่องนี้ต้องพูดตรง ๆ Thunderbit ไม่ใช่ตัวเลือกที่ดีที่สุดสำหรับการ query SERP วันละ 100K+ ครั้ง ในสเกลนั้น คุณควรมองไปที่ Oxylabs SERP APIs, Bright Data SERP products หรือ infrastructure ระดับองค์กรที่ให้ความสำคัญกับ success rate, คุณภาพ IP และการจัดการ rate มากกว่าความง่ายในการใช้งาน
ส่งข้อมูลที่ scrape ไปใช้ใน AI / LLM pipeline
ถ้าเป้าหมายของคุณคือเปลี่ยนหน้าเว็บสาธารณะให้เป็นคอนเทนต์สะอาด ๆ สำหรับ RAG หรือ workflow แบบ agent, Firecrawl คือผู้ท้าชิงที่ควรอยู่ในลิสต์แน่นอนเพราะออกแบบแบบ Markdown-first ส่วน Thunderbit ก็น่าพิจารณาเช่นกัน เพราะ Distill API แปลงเว็บเพจเป็น Markdown ได้ และ Extract API แปลงหน้าเว็บเป็น structured JSON ผ่าน schema ได้เช่นกัน — แปลว่าหนึ่งแพลตฟอร์มสามารถรองรับทั้งการ scraping สำหรับผู้ใช้ธุรกิจ (Chrome Extension) และ AI pipeline สำหรับนักพัฒนา (API layer) ถ้าอยากดูรายละเอียดว่า Thunderbit จัดการ AI data extraction for business อย่างไร เรามีบทความเจาะลึกเพิ่มเติม
เคล็ดลับเพื่อใช้งานบริษัท Web Scraping ให้คุ้มที่สุด
- เริ่มจากฟรีแพลนหรือ trial ก่อนทุ่มงบ ทุกผู้ให้บริการในลิสต์นี้มีให้ลอง
- กำหนด schema ก่อนเริ่ม scrape ตัดสินใจก่อนว่าต้องการฟิลด์ รูปแบบ และปลายทางไหน ข้อนี้ช่วยลดปัญหาปลายน้ำได้มากที่สุด
- ทดสอบกับ 50–100 หน้า เพื่อประเมินคุณภาพข้อมูลและอัตราความสำเร็จ ก่อนจะคำนวณต้นทุนในสเกลใหญ่
- ยืนยันรูปแบบการส่งออกตั้งแต่ต้น ไม่ใช่ทุกเครื่องมือจะรองรับปลายทางทุกแบบเท่ากัน ถ้าคุณต้องใช้ Airtable หรือ Notion ให้เช็กก่อนเริ่ม
- งานที่ทำซ้ำให้ตั้ง schedule แทนการ scrape แบบ manual เป็นครั้ง ๆ Thunderbit, Browse AI, Octoparse และ Bright Data รองรับทั้งหมด
- ติดตามคุณภาพข้อมูลเมื่อเวลาผ่านไป แม้แต่บริการแบบ managed ก็อาจเสื่อมคุณภาพเมื่อเว็บเป้าหมายเปลี่ยน
- เข้าใจการใช้เครดิตและ rate limit ก่อนขยาย workflow เพราะราคาตามการใช้งานอาจบานปลายได้ถ้าไม่ติดตาม
ความผิดพลาดของมือใหม่มักไม่ใช่เรื่องเทคนิค แต่เป็นเรื่องการปฏิบัติการ ทีมมักเริ่ม scrape ก่อนจะตัดสินใจว่าต้องการ output หน้าตาแบบไหน หรือจะเอาข้อมูลไปใช้ต่ออย่างไร ถ้าอยากเข้าใจเพิ่มว่า data scraping คืออะไรและทำอย่างไร เรามีคู่มือสำหรับมือใหม่อธิบายพื้นฐานไว้แล้ว
บทสรุป
วิธีซื้อของในตลาดนี้ที่ถูกต้องคือ เลือกหมวดหมู่ก่อน แล้วค่อยเลือกผู้ให้บริการ
ถ้าคุณต้องการให้คนอื่นรับผิดชอบ pipeline ทั้งหมด ให้เริ่มจากผู้ให้บริการแบบ managed อย่าง Bright Data, Zyte Data หรือ Nimbleway ถ้าคุณมีนักพัฒนาและต้องการคุมโครงสร้างพื้นฐานโดยตรง API อย่าง Oxylabs, ScrapingBee, Scrapfly, Apify และ Firecrawl จะเหมาะกว่า ถ้าคุณต้องการทางลัดสำหรับผู้ใช้งานธุรกิจที่เขียนโค้ดไม่เป็น เลเยอร์ no-code คือจุดที่ปลดล็อกประสิทธิภาพได้จริง — และนั่นคือที่ที่ Thunderbit ถูกสร้างมาเพื่ออยู่
ตัวเลือกที่เด่นที่สุดตามสถานการณ์:
- เริ่มเร็วที่สุดสำหรับทีมที่ไม่ถนัดเทคนิค: Thunderbit
- โครงสร้างพื้นฐานระดับองค์กรที่ทรงพลังที่สุด: Bright Data หรือ Oxylabs
- API สำหรับนักพัฒนาที่ใช้ง่ายที่สุด: ScrapingBee
- ดีที่สุดสำหรับ AI/LLM pipeline: Firecrawl หรือ Thunderbit API
- ตัวเลือกฟรีที่ดีที่สุดสำหรับโปรเจกต์เล็ก: ParseHub หรือ Apify free tier
สำหรับทีมที่ไม่ถนัดเทคนิคส่วนใหญ่ซึ่งต้อง scraping เว็บหลายแบบปะปนกัน Thunderbit คือจุดเริ่มต้นที่ใช้งานได้จริงที่สุด แผนฟรีช่วยลดความเสี่ยง การตั้งค่าแทบไม่มีอะไรซับซ้อน และ workflow แบบ AI-first สอดคล้องกับความจริงด้านการดูแลรักษาในปี 2026 มากกว่าเครื่องมือสร้างสแครปเปอร์แบบ visual รุ่นเก่า ลองใช้ Thunderbit Chrome Extension แล้วดูว่าแค่คลิกครั้งเดียวจะพาไปได้ไกลแค่ไหน และถ้าคุณอยากเห็นเครื่องมือทำงานก่อนติดตั้งอะไรเลย ช่อง Thunderbit YouTube Channel ก็มีวิดีโอสอนสำหรับ use case ที่พบบ่อยที่สุด
ลองใช้ Thunderbit AI Web Scraper Get Started Free
คำถามที่พบบ่อย
1. บริษัท web scraping ต่างจากเครื่องมือ web scraper อย่างไร?
บริษัท web scraping อาจให้บริการครบวงจร ทั้งโครงสร้างพื้นฐาน การบำรุงรักษา การซัพพอร์ต และการส่งมอบข้อมูล ส่วน web scraper tool คือซอฟต์แวร์ที่คุณต้องใช้งานเอง ผู้ให้บริการบางราย เช่น Bright Data และ Zyte ครอบคลุมทั้งสองโมเดล ขณะที่บางรายอย่าง Thunderbit เน้นเป็นเครื่องมือหลัก แต่มี API เพิ่มสำหรับนักพัฒนา
2. ใช้บริษัท web scraping แล้วผิดกฎหมายไหม?
การ scrape ข้อมูลสาธารณะถือว่าถูกกฎหมายโดยทั่วไปในหลายเขตอำนาจศาล แต่รายละเอียดขึ้นอยู่กับเว็บไซต์ ข้อมูลที่เก็บ และกฎหมายท้องถิ่น ควรเคารพ Terms of Service, robots.txt และกฎหมายคุ้มครองข้อมูลส่วนบุคคล เช่น GDPR และ CCPA เสมอ ผู้ให้บริการที่น่าเชื่อถือจะฝังเรื่อง compliance ไว้ในแพลตฟอร์มของตน หากต้องการอ่านเพิ่ม ดูคู่มือของเราเรื่อง web scraping legal implications
3. บริษัท web scraping มีราคาประมาณเท่าไรในปี 2026?
ตลาดมีตั้งแต่ฟรีแพลนและแผนเริ่มต้นต่ำกว่า $50/เดือน ไปจนถึงบริการ managed ระดับองค์กรที่เริ่มราว $500/เดือนและสูงกว่านั้น Thunderbit, ParseHub และ Apify มีฟรีแพลน API ระดับกลางอย่าง ScrapingBee และ Scrapfly เริ่มราว $30–$49/เดือน ส่วนผู้ให้บริการระดับองค์กรเริ่มสูงกว่า: Bright Data แผน Scale อยู่ที่ $499/เดือน และแผน managed ของ Nimbleway เริ่มที่ $2,500/เดือน
4. ใช้บริษัท web scraping โดยไม่เขียนโค้ดได้ไหม?
ได้ เครื่องมือ no-code อย่าง Thunderbit, Octoparse, Browse AI และ ParseHub ถูกออกแบบมาสำหรับผู้ใช้ที่ไม่ใช่สายเทคนิค Thunderbit ไม่ต้องเขียนโค้ดเลย: ติดตั้ง Chrome Extension, เปิดหน้าเว็บ แล้วคลิกครั้งเดียว — AI จะหาเองว่าควรดึงฟิลด์ไหนและทำงานจนเสร็จ คุณยังแค่บอกข้อมูลที่ต้องการเป็นภาษาอังกฤษธรรมดาได้ ข้อมูลจะไหลตรงไปยังสเปรดชีตหรือฐานข้อมูลของคุณ
5. บริษัท web scraping ไหนเหมาะกับธุรกิจขนาดเล็กที่สุด?
Thunderbit คือคำแนะนำเริ่มต้นที่แข็งแรงที่สุดสำหรับธุรกิจขนาดเล็กที่ต้องการข้อมูลมีโครงสร้างจากเว็บหลากหลายโดยไม่ต้องมี dev มาตั้งค่า แผนฟรีและราคาเครดิตต่อแถวช่วยให้เริ่มง่าย และคาดการณ์บิลได้ง่ายเมื่อรู้คร่าว ๆ ว่าต้องใช้กี่แถว Apify ก็น่าสนใจมากเมื่อมี Actor สำเร็จรูปสำหรับเว็บที่คุณต้องการอยู่แล้ว ส่วน ParseHub เหมาะกับโปรเจกต์ฟรีขนาดเล็กที่ปริมาณงานไม่มาก
อ่านเพิ่มเติม



