
หน้าผลการค้นหา Google Shopping หนึ่งหน้าสามารถมีโฆษณาปนกับรายการแบบออร์แกนิก ซ่อนราคาสินค้าที่หมดสต็อก และโชว์สินค้าเดียวกันซ้ำจากผู้ขายได้มากถึงห้าราย ผมใช้เวลาหลายสัปดาห์ไล่ดูเครื่องมือ 9 ตัวที่อ้างว่าสามารถแยกความยุ่งเหยิงนี้ออกมาเป็นข้อมูลที่สะอาดและใช้งานได้จริง — และคำตอบแบบตรงไปตรงมาก็คือ “ตัวที่ดีที่สุด” ขึ้นอยู่กับว่าคุณเป็นนักพัฒนาที่กำลังสร้างไปป์ไลน์ข้อมูล หรือเป็นนักการตลาดที่แค่อยากได้ตัวเลขลงสเปรดชีตภายในวันศุกร์
ความต่างนี้เห็นชัดแทบทุกที่ในงานวิจัย บน r/learnpython และ r/node ผู้คนกำลังแลกเปลี่ยนประสบการณ์เรื่อง Puppeteer, Playwright และการหมุนพร็อกซี ส่วนใน r/PPC ผู้คนกลับมองหาอะไรที่ใกล้เคียงกับ “เอาข้อมูลมาให้เลย ฉันไม่อยากแตะโค้ด” มากกว่า ดังนั้นแทนที่จะจัดอันดับทั้ง 9 เครื่องมือแบบเรียงตัวอักษร หรือแปะป้าย “ดีที่สุดโดยรวม” ให้กับตัวที่หน้าเว็บดูหวือหวาที่สุด ผมจึงให้คะแนนแต่ละตัวตาม 6 เกณฑ์ที่จับต้องได้ และเรียงลำดับตามเวิร์กโฟลว์ — เริ่มจาก SERP API แบบ managed ก่อน ถัดไปเป็นโครงสร้างพื้นฐานพร็อกซีและสแครปเปอร์ จากนั้นเป็นแพลตฟอร์ม actor สำหรับนักพัฒนา และปิดท้ายด้วยเครื่องมือเบราว์เซอร์แบบ no-code
อะไรทำให้ Google Shopping Scraper “ดีที่สุด”? เกณฑ์ที่ใช้ให้คะแนน
คำว่า “ดีที่สุด” มักถูกใช้แบบครอบจักรวาลในบทความลิสต์ต่าง ๆ ดังนั้นขออธิบายให้ชัดว่าบทความนี้หมายถึงอะไร ผมให้คะแนนทั้ง 9 เครื่องมือด้วย 6 ปัจจัยเดียวกัน แทนที่จะอ้างซ้ำตามที่หน้า marketing ของแต่ละเจ้าบอก:
- ความครอบคลุมของข้อมูล — schema ที่มีเอกสารประกอบสามารถดึงราคา ผู้ขาย เรตติ้ง จำนวนรีวิว ค่าจัดส่ง และแยกโฆษณาออกจากรายการออร์แกนิกได้จริงหรือไม่
- การรองรับ locale/geo — ระบุประเทศ ภาษา หรืออุปกรณ์เฉพาะเจาะจงได้จริงไหม หรือปล่อยให้ขึ้นอยู่กับ IP ของพร็อกซีแบบดวงล้วน ๆ
- ความซับซ้อนในการเริ่มใช้งาน — เป็นแค่ API key กับ GET request หรือเป็นงานที่ต้องคิว รอ callback หรือเป็นเวิร์กโฟลว์สองขั้นแบบ chain token หรือเป็นหน้าเว็บที่คลิกใช้งานได้
- ภาระในการดูแล — ถ้า Google เปลี่ยนโครงสร้าง HTML หรือขึ้น CAPTCHA ใครต้องรับผิดชอบ คุณหรือผู้ให้บริการ
- เส้นทางการส่งออก/เชื่อมต่อ — ได้แค่ JSON dump หรือเชื่อม Sheets, Airtable หรือ data warehouse ได้โดยตรง
- ความโปร่งใสด้านราคา — ผู้ให้บริการประกาศต้นทุนต่อหน่วยจริงให้คำนวณได้หรือไม่ หรือคุณต้อง “ติดต่อฝ่ายขาย” เพื่อรู้ว่าราคาคือเท่าไร
สิ่งหนึ่งที่ผมจะไม่ทำในบทความนี้คือแต่งตัวเลขอัตราความสำเร็จ ความเร็ว หรือเปอร์เซ็นต์ความแม่นยำขึ้นมาเอง ไม่มีใครในลิสต์นี้ทำ benchmark เทียบกับเจ้าอื่นอย่างเป็นอิสระ และคำเคลมอย่าง “สำเร็จ 99.9%” หรือ “เร็วสุดขั้ว” ก็เป็นภาษาโฆษณา ไม่ใช่ผลการวัดจริง สิ่งที่คุณจะได้แทนคือสิ่งที่เอกสารของแต่ละเจ้าพิสูจน์ได้จริง — ซึ่งเอาเข้าจริง ก็มีประโยชน์มากพอแล้ว
นักพัฒนาต้องการโค้ด แต่นักการตลาดต้องการแบบไม่ต้องเขียนโค้ด
ถ้าคุณเคยอยู่ในฟอรัมเกี่ยวกับการสแครปข้อมูลมาก่อน คุณคงรู้ว่าความต่างนี้มีอยู่จริง แต่ก็ควรพูดออกมาให้ชัด เพราะมันอธิบายลำดับของลิสต์นี้ได้ นักพัฒนาที่สร้าง data pipeline ต้องการ API key, JSON ที่คาดเดาได้, พารามิเตอร์ locale ที่ชัดเจน และ schema ที่นำไปตรวจสอบและทำให้เป็นมาตรฐานต่อได้ พวกเขาคือคนที่ถามเรื่องการหมุนพร็อกซีและการเรนเดอร์ด้วย headless browser
ส่วนทีมการตลาดและ PPC ต้องการอะไรที่ใกล้เคียงกับ “ชี้ไปที่หน้าเว็บ แล้วเอามาเป็นสเปรดชีต” มากกว่า พวกเขาไม่อยากดูแลสคริปต์ Puppeteer ทุกครั้งที่ Google ปรับเลย์เอาต์ Shopping เป็นรอบที่สามของไตรมาสนี้ (และมันจะเกิดขึ้นแน่ — Google เปลี่ยน markup ของ Shopping บ่อยพอที่แม้แต่ผู้ให้บริการ API ยังต้องออก changelog กันเป็นเรื่องปกติ)
ดังนั้นลิสต์นี้จึงไล่จากผู้ให้บริการ SERP API แบบ managed (SerpApi, Serper, SearchAPI, DataForSEO) — ได้ JSON ที่เป็นโครงสร้าง ไม่ต้องยุ่งกับพร็อกซี แต่ก็ยังต้องเขียนโค้ดอยู่ — ไปสู่โครงสร้างพื้นฐานพร็อกซีและสแครปเปอร์ (Bright Data, Oxylabs) ที่ให้การควบคุมมากขึ้นแต่ต้องตั้งค่ามากขึ้น ต่อด้วยแพลตฟอร์ม actor สำหรับนักพัฒนาที่ปรับแต่งได้เต็มที่ (Apify) และจบด้วย Thunderbit เครื่องมือ browser แบบ agentic ที่ไม่ต้องเขียนโค้ด สำหรับคนที่ไม่อยากสร้างหรือดูแลโค้ดสแครปปิงเลยจริง ๆ
9 Google Shopping Scraper ที่ควรรู้จักแบบสรุปเร็ว ๆ
| เครื่องมือ | รูปแบบการเก็บข้อมูล | ความซับซ้อนในการตั้งค่า | การรองรับ locale | เหมาะกับใคร | ภาระการดูแล |
|---|---|---|---|---|---|
| SerpApi | Managed Shopping API | ต่ำ (API key) | แข็งแกร่ง (location, gl, hl, device) | data engineer, เครื่องมือ SEO | ผู้ให้บริการดูแลให้ |
| Serper | SERP API ทั่วไป โดย Shopping เป็นหนึ่งในชนิดผลลัพธ์ | ต่ำ | ปานกลาง (มีเอกสารประเทศ/ภาษา) | นักพัฒนาที่เน้นคุมงบ | ผู้ให้บริการดูแลให้ |
| SearchAPI | Managed Shopping + Product Offers API | ต่ำ–ปานกลาง (สองขั้นสำหรับ offers) | ปานกลาง | ทีมเปรียบเทียบ offer/merchant | ผู้ให้บริการดูแลให้ |
| DataForSEO | Merchant API แบบ task-based | ปานกลาง (queue/callback) | แข็งแกร่ง | ไปป์ไลน์แบบ bulk/ตามกำหนดเวลา | ผู้ให้บริการดูแลให้ |
| Bright Data | Dataset + Scraper API + SERP API | ปานกลาง (ขึ้นอยู่กับ surface) | แข็งแกร่งมาก | ทีมข้อมูลระดับองค์กร | ดูแลร่วมกัน |
| Oxylabs | ค้นหา 2 ขั้น + API รายละเอียดสินค้า | ปานกลาง (token chaining) | แข็งแกร่งมาก | ทีมข้อมูลระดับองค์กร | ดูแลร่วมกัน |
| Scrapingdog | Endpoint สำหรับ Shopping โดยเฉพาะ | ต่ำ–ปานกลาง | ปานกลาง | นักพัฒนาที่คุมงบ | ผู้ให้บริการดูแลให้ |
| Apify | Actor/แพลตฟอร์มนักพัฒนา | ปานกลาง–สูง | แล้วแต่ actor | คนสร้าง pipeline แบบกำหนดเอง | ผู้ใช้ดูแลเอง |
| Thunderbit | การดึงข้อมูลผ่านเบราว์เซอร์แบบ no-code และ agentic | ต่ำมาก (One Click Extract) | ขึ้นอยู่กับหน้าเป้าหมาย | นักการตลาด/PPC, คนไม่เขียนโค้ด | ต่ำ ขึ้นกับหน้าเว็บ |
(โปรดตรวจสอบราคาปัจจุบัน โควตาเครดิต และ coverage ของ locale ในเอกสารล่าสุดของแต่ละเจ้าก่อนตัดสินใจใช้งาน — เรื่องพวกนี้เปลี่ยนเร็ว และหลายเจ้าในลิสต์นี้ก็ปล่อย breaking changes ในปี 2026 ไปแล้ว)
1. SerpApi — แบบ managed ฟีเจอร์แน่น และบอกเรื่อง cache แบบตรงไปตรงมา
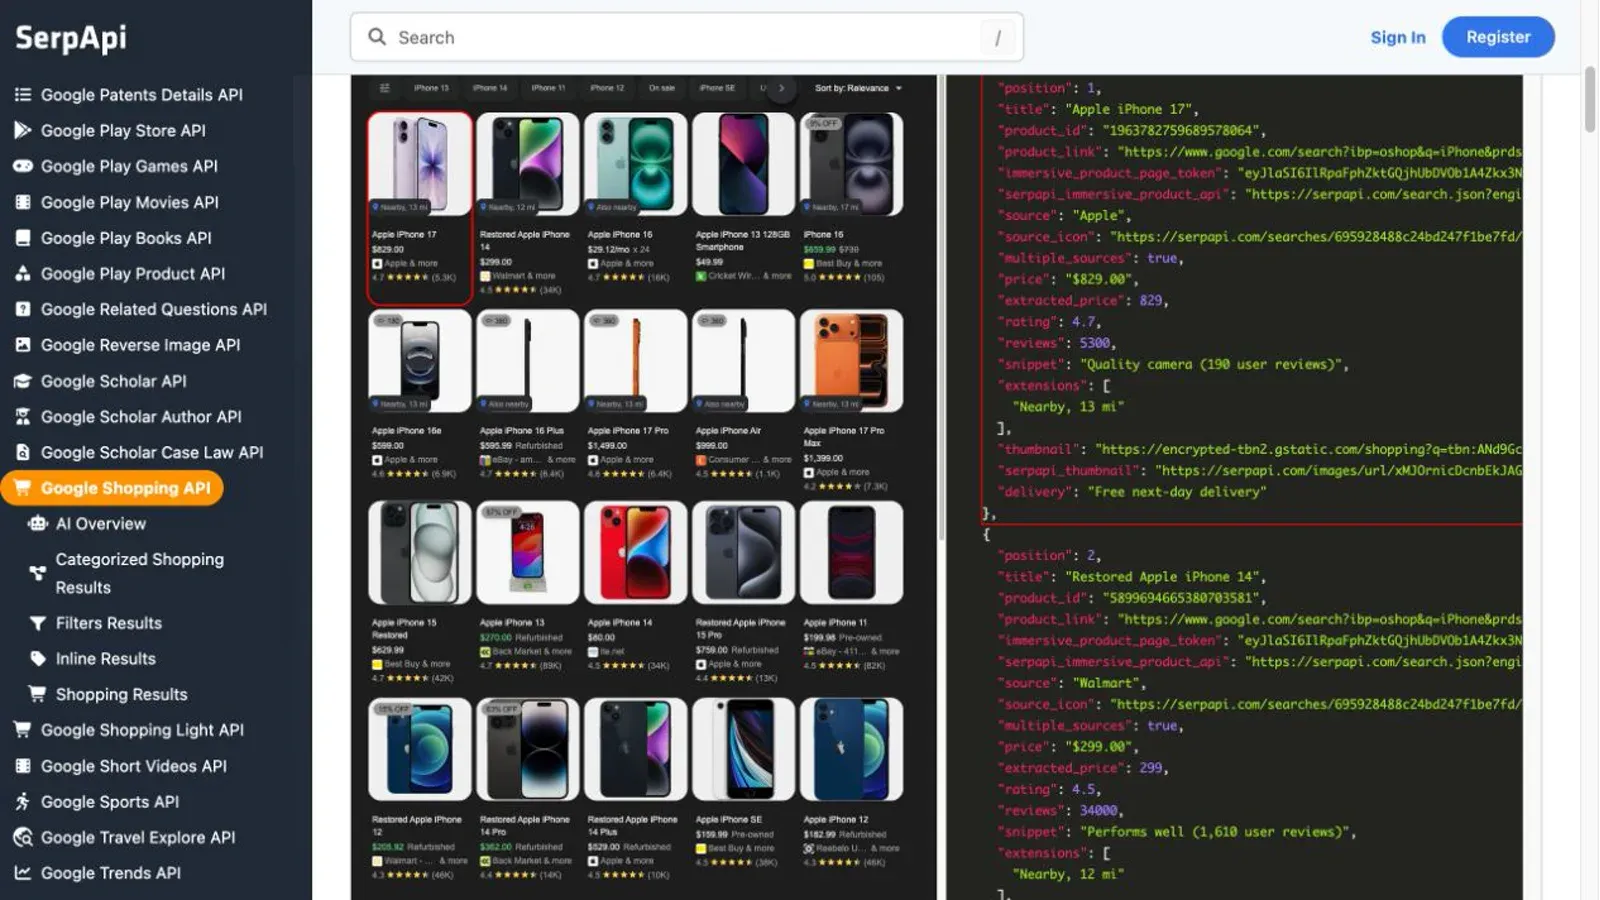
SerpApi ใช้เอนจิน Google Shopping โดยเฉพาะ (engine=google_shopping) รับ query ของคุณแล้วส่งกลับ shopping_results แบบมีโครงสร้าง — ตำแหน่ง ชื่อสินค้า product ID ราคา พร้อมตัวเลขราคาที่สกัดได้ ราคาก่อนหน้า/ผ่อนชำระ ค่าจัดส่ง สภาพสินค้า เรตติ้ง จำนวนรีวิว และรูปภาพ นี่คือ schema ที่แข็งแรงจริง ๆ และ SerpApi ยังแยกเอกสารผลลัพธ์ Shopping แบบมีสปอนเซอร์ผ่าน Google Ads Shopping schema ไว้ต่างหาก ดังนั้นคุณจึงหา placement ที่เป็นโฆษณาได้ — เพียงแต่ไม่ได้มีฟิลด์ sponsored: true/false ที่เชื่อถือได้ฝังมาใน response ของ Shopping โดยเฉพาะ
สิ่งที่ทำให้ SerpApi โดดเด่นคือความชัดเจนในเรื่องที่มักทำให้ปวดหัวทีหลัง การ target location รองรับ location ระดับเมืองหรือ uule แบบตรงเป๊ะ พร้อมพารามิเตอร์ gl (ประเทศ), hl (ภาษา) และ device (desktop, tablet, mobile) แยกต่างหาก และยังบอกตรง ๆ ว่า query เดิมอาจถูกดึงจาก cache ได้นานถึงหนึ่งชั่วโมงโดยค่าเริ่มต้น — ถ้าดึงจาก cache จะไม่คิดเงิน ส่วน no_cache=true จะบังคับให้ดึงใหม่ นี่คือข้อมูลที่ผู้ให้บริการส่วนใหญ่มักซ่อนหรือไม่ก็ไม่พูดถึง
ราคา (ตรวจสอบเมื่อ 2026-08-13) เปิดเผยต่อสาธารณะและคิดรายเดือน: Free tier 250 searches, Starter $25 สำหรับ 1,000 searches ไปจนถึง Big Data $275 สำหรับ 30,000 searches โดยจะนับเฉพาะการค้นหาที่สำเร็จเท่านั้นเมื่อหักจากโควตา — cached request และ request ที่ล้มเหลวจะไม่ถูกนับ สิ่งที่ควรรู้เพิ่มเติมคือ Google ได้ยื่นฟ้อง SerpApi ช่วงต้นปี 2026 เกี่ยวกับวิธีเข้าถึงข้อมูล; SerpApi โต้แย้งคำอธิบายนั้นและบอกว่าเข้าถึงผลลัพธ์สาธารณะที่ไม่ต้องยืนยันตัวตน นี่เป็นสถานการณ์ทางกฎหมายที่ยังดำเนินอยู่ ไม่ใช่คำตัดสิน ดังนั้นควรมองเป็นความเสี่ยงที่ต้องจับตา ไม่ใช่เหตุผลให้เลี่ยงเครื่องมือนี้ทันที
เหมาะที่สุดสำหรับ: นักพัฒนาที่ต้องการ Shopping schema ที่มีรายละเอียดมากที่สุด และต้องการควบคุม cache กับ locale อย่างชัดเจน
2. Serper — เร็ว คุมงบง่าย และชัดเจนที่สุดเรื่องความสดของข้อมูล
Serper วางตัวเองเป็น Google SERP API แบบทั่วไป โดยให้ Shopping อยู่เคียงกับ Search, Images, News, Maps และผลลัพธ์ชนิดอื่นอีกหลายแบบ ถ้าคุณกำลังดึงผลการค้นหาปกติอยู่แล้ว และต้องการเพิ่ม Shopping เข้ามาแบบไม่ต้องตั้งผู้ให้บริการตัวที่สอง นี่คือทางเลือกที่ลื่นไหลกว่า
ตัวอย่าง Shopping แบบสาธารณะส่งกลับ title, source, direct merchant link, price แบบฟอร์แมตแล้ว, delivery, rating, จำนวนเรตติ้ง, จำนวน offer, product ID และตำแหน่ง — เพียงพอสำหรับการมอนิเตอร์ product card ขั้นพื้นฐาน แต่เอกสารสาธารณะไม่ได้เปิดเผยรายละเอียดระดับ merchant-offer หรือฟิลด์ราคาที่เกี่ยวกับโปรโมชั่นลึกเท่า SearchAPI หรือ Oxylabs จุดขายที่ชัดที่สุดของ Serper คือความสดของข้อมูล: ระบุว่าทุกครั้งที่เรียกจะดึงจาก Google แบบสด ไม่มีการ cache จึงไม่ต้องคิดเรื่องการบริหาร cache แบบที่ผู้ใช้ SerpApi ต้องตัดสินใจเอง (แต่ต้องยอมจ่ายทุกครั้งที่เรียกซ้ำ ไม่ว่าจะซ้ำหรือไม่ก็ตาม)
ราคาทำงานแบบเครดิตล่วงหน้าแทน subscription — เริ่มด้วย 2,500 queries ฟรี จากนั้น $50 สำหรับ 50,000 credits และลดลงถึง $0.30 ต่อ 1,000 credits ที่แพ็กเกจบนสุด โดยเครดิตมีอายุ 6 เดือน หน้า pricing ยังบอกอย่างตรงไปตรงมาว่าบางคำขออาจใช้เวลา 2–4 วินาที “เมื่อจำเป็นต้อง retry ไปยัง Google” ซึ่งเป็น latency tail ที่มีอยู่จริงและควรวางแผนรับมือ ไม่ใช่ตัวเลข benchmark ที่ต้องไปกังวล
เหมาะที่สุดสำหรับ: ทีมที่กำลังเชื่อมต่อ SERP API แบบกว้างอยู่แล้ว และอยากได้ Shopping เป็นของแถม ไม่ใช่ผลิตภัณฑ์หลัก
3. SearchAPI — รายละเอียดระดับ offer แข็งแรง แต่เอกสารมีจุดที่ต้องระวัง
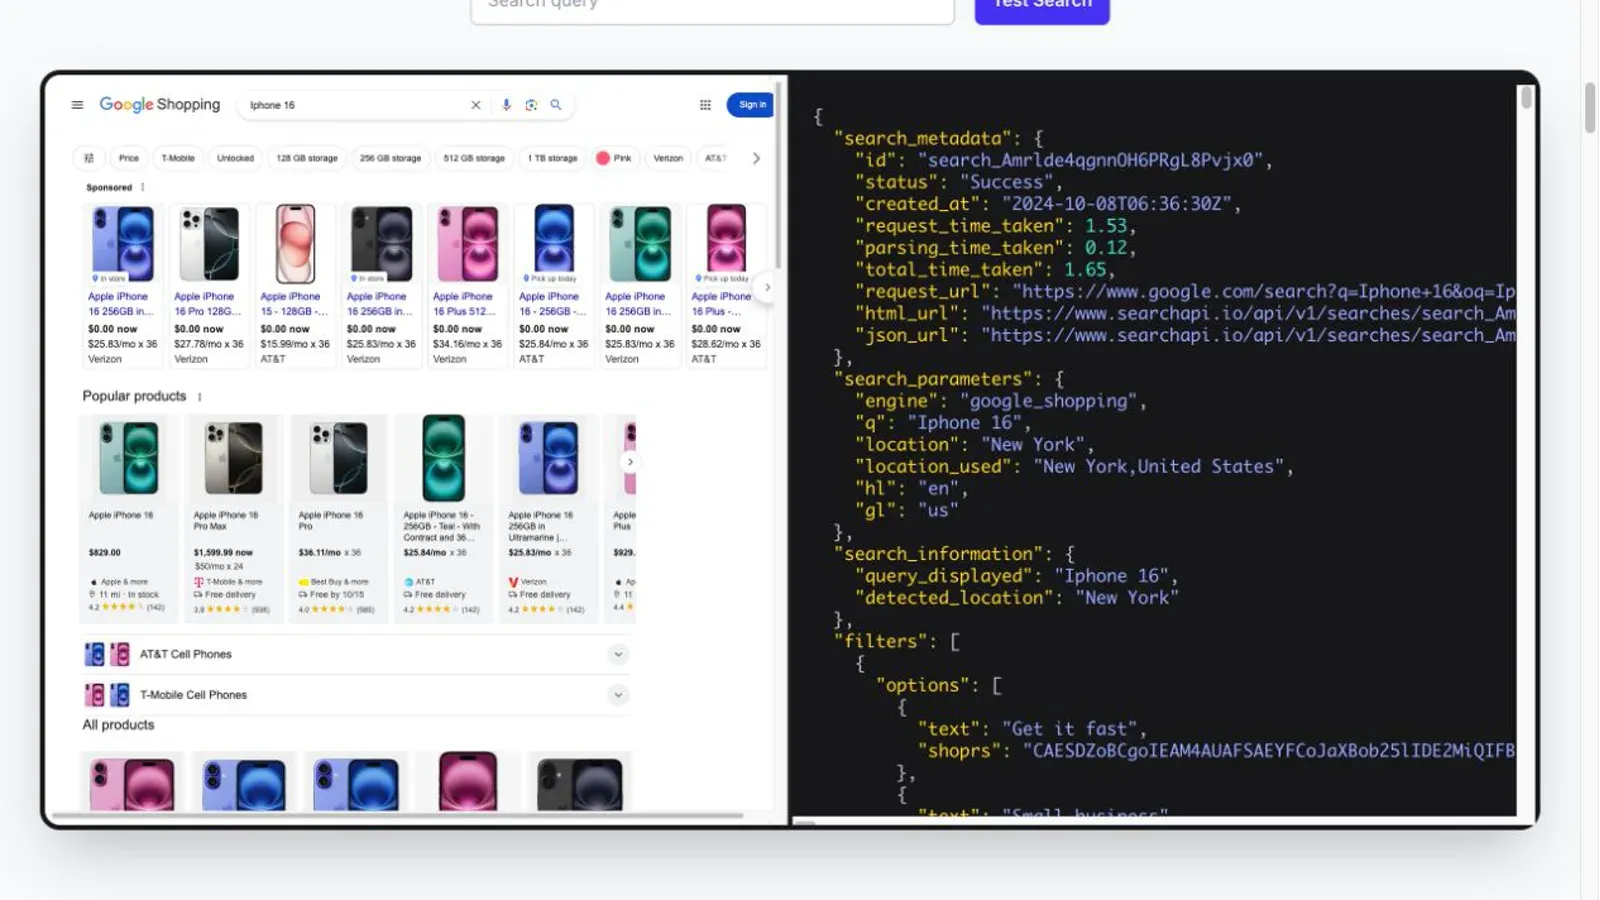
SearchAPI ใช้เวิร์กโฟลว์สองขั้นที่มีประโยชน์จริง ถ้าคุณต้องการเปรียบเทียบราคาจากฝั่งผู้ขาย Endpoint Shopping จะส่งฟิลด์การ์ดมาตามปกติ พร้อม product_token — และ token นี้จะปลดล็อก Product Offers API แยกต่างหากที่คืน offers array พร้อม merchant link, ราคา, ค่าจัดส่ง, ราคาสุทธิ, สถานะสต็อก และวิธีชำระเงินรายผู้ขาย ถ้า use case ของคุณคือ “แสดงราคาทั้งหมดที่สินค้ารุ่นนี้ขายอยู่จากผู้ขายแต่ละราย” นี่คือทางที่ตรงที่สุดในลิสต์นี้
แต่มีจุดต้องระวัง: ตั้งแต่ 15 พฤษภาคม 2026 การเปลี่ยนแปลงของ Google ทำให้ SearchAPI บังคับต้องใช้ product_token ใหม่ทุกครั้ง — พารามิเตอร์ product_id/prds แบบเก่าจะได้เพียง 400 error ธรรมดา ถ้าคุณอ้างอิงจากตัวอย่างโค้ดหรือบทเรียนเก่า ๆ จะเจอปัญหานี้แบบเงียบ ๆ จนกว่าจะสังเกตเห็น
SearchAPI ยังเตือนชัดว่า filter แบบภาษาธรรมชาติใน query เช่น “under $30” หรือ “used” เป็นเพียงคำแนะนำ ไม่ใช่ตัวกรองแบบบังคับ — Google อาจยังแสดงผลลัพธ์ที่อยู่นอกเงื่อนไขถ้าตรงกันน้อย ส่วน shoprs ที่เข้ารหัสไว้เป็นทางที่เข้มงวดกว่า และยังมีความขัดแย้งในเอกสารที่ควรรู้: SearchAPI ทำการตลาด endpoint นี้ว่าเป็น “real-time” แต่ข้อตกลงประมวลผลข้อมูลของบริษัทระบุว่ามีการ cache ผลลัพธ์เพื่อประสิทธิภาพ อีกทั้งไม่ได้ระบุ TTL แบบสาธารณะไว้ทางใดทางหนึ่ง ถ้าราคาที่เปลี่ยนเร็วมีความสำคัญกับคุณ ควรทดสอบด้วยการเรียกซ้ำก่อนสร้าง pipeline โดยตั้งสมมติฐานเรื่องความสดของข้อมูล
ราคา (ตรวจสอบเมื่อ 2026-08-13) เริ่มที่ $40/เดือนสำหรับ Developer tier ที่ $4 ต่อ 1,000 searches และลดลงตามปริมาณที่สูงขึ้น พร้อมเพดานการใช้งานรายชั่วโมงที่ระบุไว้ว่า 20% ของเครดิตรายเดือน
เหมาะที่สุดสำหรับ: ทีมที่ทำงานเปรียบเทียบระดับ seller/offer และรับมือเวิร์กโฟลว์สอง request ได้ พร้อมทดสอบความสดของข้อมูลเอง
4. DataForSEO — ข้อมูล Merchant และ Shopping ในระดับสเกล ด้วยระบบคิว
DataForSEO เป็นตัวแปลกที่สุดในกลุ่มนี้จริง ๆ เพราะมันไม่ใช่ API แบบ request/response สด ๆ — แต่เป็นระบบคิวแบบ task-based คุณส่ง task พร้อม keyword, location และ language แล้วรับ task ID กลับมา จากนั้นจะ poll เอาผลลัพธ์หรือกำหนด callback URL ก็ได้ การดึงข้อมูลมาตรฐานเท่านั้น; ไม่มีโหมด live สำหรับ Shopping endpoint หลัก ไม่ว่าจะมีภาษา marketing ว่าอย่างไร
จุดนี้สำคัญเพราะมันเปลี่ยนวิธีคิดเรื่องความซับซ้อนในการเริ่มใช้งาน มันไม่ได้ยากนัก แต่เป็นโมเดลความคิดคนละแบบกับ “เรียก API แล้วได้ JSON กลับมา” — คุณต้องจัดการสถานะของ task และเอกสารของ DataForSEO เองก็บอกว่าถ้า callback server ไม่ตอบภายใน 10 วินาที task จะถูกย้ายไปคิว “Tasks Ready” ซึ่งคุณต้อง poll เองภายหลัง
สิ่งที่ทำให้มันมีที่ยืนในลิสต์นี้คือการวิจัยแบบ bulk: Products endpoint ส่ง rank, domain, title, price, old price, rating และจำนวน vote พร้อมตัวบ่งชี้ชนิดผลลัพธ์ที่แยก google_shopping_sponsored_carousel ออกจาก google_shopping_paid และ organic results ได้ชัดเจน — นับว่าเป็นหนึ่งในการแยก sponsored/organic ที่ชัดที่สุดในลิสต์ทั้งหมด นอกจากนี้ยังเตือนตรง ๆ ว่า product_id เป็นค่าที่เปลี่ยนได้และอาจเป็น null และปัจจัยการจัดอันดับแบบ personalized (ประวัติผู้ใช้, ความชอบด้าน location) จะถูกตัดออกจากผลลัพธ์โดยตั้งใจ — เป็นจุดตรวจสอบความจริงที่ผู้ให้บริการส่วนใหญ่มักไม่พูด
ค่าบริการคิดตามบล็อกผลลัพธ์ (40 สำหรับ Products, 10 สำหรับ Sellers/Reviews) โดยคิวปกติใช้เวลาสูงสุด 45 นาที หรือคิว priority สูงสุดประมาณหนึ่งนาทีแต่ราคาเพิ่มเป็นสองเท่า ผู้ใช้ใหม่ได้เครดิตทดลอง $1 แบบไม่หมดอายุ
เหมาะที่สุดสำหรับ: ทีมที่คุ้นกับเวิร์กโฟลว์แบบคิวและ task-based และต้องการข้อมูล merchant/product จำนวนมากตามกำหนดเวลา
5. Bright Data — สามผลิตภัณฑ์ที่ใช้ป้ายชื่อเดียวกัน
ตรงนี้ผมต้องชะลอลงหน่อย เพราะ Bright Data มีหลายวิธีให้ดึงข้อมูล Google Shopping อยู่ถึงสามแบบ และแต่ละแบบไม่เหมือนกันเลย มีทั้ง dataset ที่เก็บไว้ล่วงหน้า (ทำตลาดว่าเกิน 7.4 พันล้านเรคคอร์ด ส่งเป็น JSON/CSV/Parquet เข้า cloud warehouse ของคุณตามกำหนดเวลา), Google Scraper API ที่มี scraper ID สำหรับ Shopping โดยเฉพาะ และรองรับงานแบบ synchronous หรือ async, และ SERP API ที่ยิงไปยัง URL ของ Shopping แบบสดแล้ว parse ผลลัพธ์แบบ real-time การมองทั้งสามอย่างนี้เป็นผลิตภัณฑ์เดียวคือจุดที่บทความเปรียบเทียบจำนวนมากมักทำแบบหยาบ — ผมจะไม่ทำแบบนั้น
ตัวอย่างข้อมูลของ dataset เองแสดงค่า null สำหรับ product ID, description, rating และจำนวนรีวิวในบางเรคคอร์ด — เป็นหลักฐานจาก first-party ที่ดีมากว่า “structured dataset” ไม่ได้แปลว่า “ทุกฟิลด์มีค่าตลอด” ส่วน SERP API แยก Product Listing Ads เป็นชนิดผลลัพธ์ของตัวเอง (top_pla, bottom_pla, jackpot_pla) พร้อม title, price, shop และ rank — ซึ่งเป็นการแยก sponsored-vs-organic ที่มีประโยชน์จริง หากคุณใช้งาน SERP API ตัวนี้โดยเฉพาะ ไม่ใช่ dataset
งานแบบ async ผ่าน Scraper API อาจส่งสถานะ overall เป็น “success” ได้ แต่ request บางตัวใน batch กลับล้มเหลว เอกสารระบุชัดว่าคุณต้องตรวจ errors แล้ว retry รายการเหล่านั้นแยกกัน ซึ่งเป็นรายละเอียดด้านการดูแลที่ควรวางแผนไว้ถ้าคุณรัน batch ใหญ่ ๆ
ราคา (ตรวจสอบเมื่อ 2026-08-13) แตกต่างกันมากตาม surface: dataset แสดง $250 สำหรับ 100,000 records แบบครั้งเดียว ส่วน SERP API ระบุ 5,000 requests ฟรีต่อเดือน และจ่ายตามใช้ที่ $1.50/1,000 ขณะที่ Shopping Scraper API แบบเฉพาะก็มี free tier และอัตราค่าบริการของตัวเองแยกต่างหาก อย่าเดาว่าตัวเลขเหล่านี้ใช้แทนกันได้ — ต้องดูหน้า product ที่คุณใช้งานจริง
เหมาะที่สุดสำหรับ: ทีมองค์กรที่ต้องการแพลตฟอร์มเดียวครอบคลุมทั้ง dataset ที่เตรียมไว้แล้วและ live API และยอมแยกราคาตามแต่ละ surface
6. Oxylabs — โซ่สองขั้นที่ชัดที่สุดสำหรับ search และ product detail
Oxylabs แบ่ง Shopping ออกเป็นสอง target โดยเฉพาะ: google_shopping_search สำหรับผลลัพธ์ระดับลิสต์ และ google_shopping_product สำหรับข้อมูลเชิงลึกของสินค้าแต่ละตัว เชื่อมกันด้วย product token response ของ search แยก pla (paid listing ads) ออกจาก organic product ได้อย่างชัดเจน — น่าจะเป็นการแยก sponsored/organic ที่เอกสารชัดที่สุดในลิสต์นี้ทั้งหมด — ส่วน endpoint ของ product จะเพิ่ม offer ต่อผู้ขายพร้อม numeric price, condition, tax, total price และ shipping
ข้อแม้ที่สำคัญมากคือ workflow แบบ token นี้ใช้ได้ก็ต่อเมื่อ request สำหรับ search มีทั้ง render: "html" และ parse: true ถ้าขาดอย่างใดอย่างหนึ่ง คุณจะไม่ได้ product token และขั้นตอนดึง product detail ทั้งหมดก็จะพังไป Oxylabs ยังเตือนชัดว่าคำขอ search และ product ต้องใช้ค่า localization เหมือนกันเป๊ะ — ถ้า geo_location ไม่ตรงกันระหว่างสอง call ผลลัพธ์ของ product อาจมาไม่ครบหรือผิดพลาดได้ และถ้าคุณอยากให้แผง “More stores” ถูกขยายเพื่อดึง offer เพิ่ม ต้องเปิด rendering ด้วย ซึ่งเพิ่มต้นทุนอีก
รายละเอียดที่คนมักมองข้ามคือ FAQ เรื่องราคา ของ Oxylabs นิยามคำว่า “successful” (และจึงถูกคิดเงิน) รวมทั้ง response แบบ 2xx และ 4xx เข้าไปด้วย ถ้าคำขอของคุณส่งมาไม่ถูกต้อง คุณอาจยังถูกคิดเงินอยู่ดี
เอกสารระบุว่าการรีวิวสินค้ามีเฉพาะ locale ของสหรัฐฯ และตัวควบคุม locale/language กับ locale/results-language เป็นคนละชุดจริง ๆ — ตั้งค่าตัวหนึ่งไม่ได้ตั้งอีกตัวให้อัตโนมัติ
เหมาะที่สุดสำหรับ: ทีมเทคนิคที่ต้องการทั้งข้อมูลระดับอันดับผลลัพธ์และ offer รายผู้ขาย และรับมือ token chaining กับความสอดคล้องของ locale ได้
7. Scrapingdog — endpoint เรียบง่าย แต่รายละเอียดสาธารณะค่อนข้างบาง
Scrapingdog มี endpoint สำหรับ Google Shopping โดยเฉพาะตัวเดียว รับ API key กับ query แล้วส่ง JSON ที่มี title, price และราคาที่สกัดเป็นตัวเลข, old price, rating, reviews, source/seller, delivery และ position หน้าเว็บยังระบุการกรองตามราคา แบรนด์ ประเทศ และภาษา รวมถึงหมวด response แยก “ads” สำหรับติดตามรายการที่เป็นโฆษณา — แต่ schema ของ ads และชื่อพารามิเตอร์สำหรับการกรอง locale ยังไม่ถูกอธิบายครบในหน้าสาธารณะ ดังนั้นควรเผื่อเวลา test กับ use case ของคุณเองก่อนสร้าง automation บนพื้นฐานนี้
นี่เป็นเจ้าเดียวในลิสต์ที่ตัวเลขเครดิตตามเอกสารสาธารณะยังคำนวณต่อไม่ค่อยลง: หน้าราคาแสดงจำนวนเครดิตรายเดือน (LITE ที่ $40/เดือนสำหรับ 200,000 credits, STANDARD ที่ $90/เดือนสำหรับ 1,000,000) แต่ไม่ได้บอกชัดว่าคำขอ Google Shopping หนึ่งครั้งใช้เครดิตเท่าไร อย่าเดาว่าจะ 1:1 กับตัวอย่าง general search API — ควรถามผู้ให้บริการโดยตรงก่อนคำนวณต้นทุนจริงต่อ query
เช่นเดียวกับผู้ให้บริการส่วนใหญ่ในลิสต์นี้ Scrapingdog ทำตลาดเรื่อง พร็อกซี residential แบบหมุนอัตโนมัติ และการจัดการ CAPTCHA อัตโนมัติว่าเป็นสิ่งที่ผู้ให้บริการดูแลให้ มองสิ่งนี้เป็นขอบเขตความรับผิดชอบด้าน maintenance ไม่ใช่หลักฐานว่าทุกอย่างจะเข้าถึงได้แน่นอน
เหมาะที่สุดสำหรับ: นักพัฒนาที่คุมงบ ต้องการ endpoint เฉพาะที่แคบ และพร้อมตรวจสอบค่าเครดิตกับผู้ให้บริการโดยตรงก่อนตัดสินใจ
8. Apify — ต้องดูที่ Actor ไม่ใช่ที่ตลาดรวม
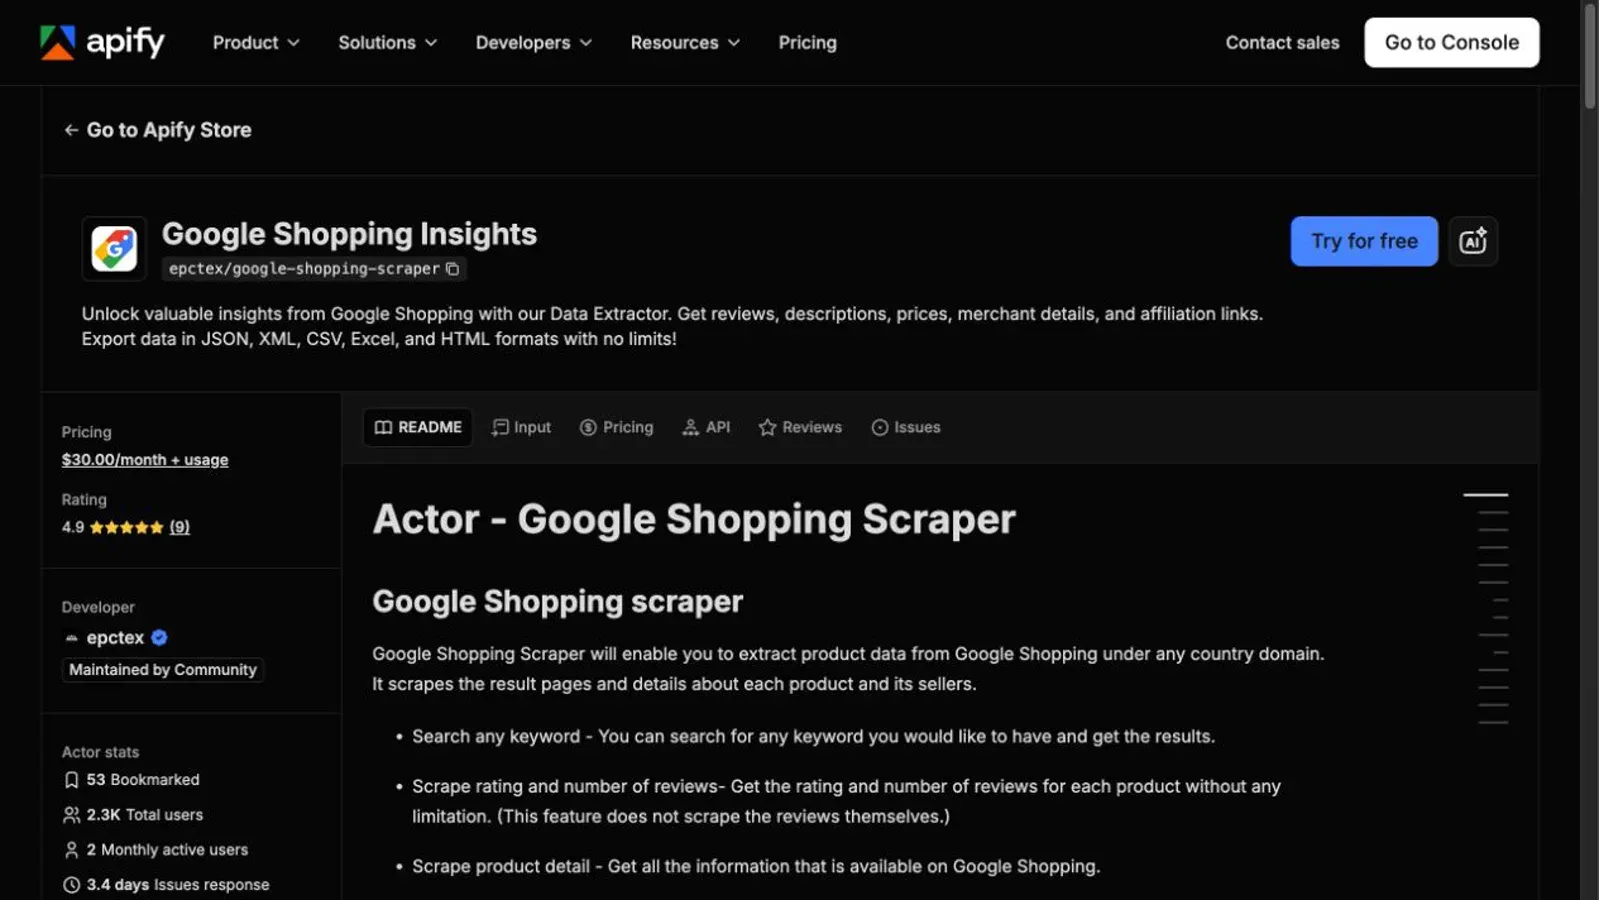
ขอพูดตรง ๆ ไว้ก่อน: Apify ไม่ใช่ Google Shopping scraper ตัวเดียว แต่เป็น marketplace ของ “Actors” ที่ดูแลกันเอง และตัวที่ผมพิจารณาอย่างใกล้ชิด (Google Shopping Insights, เผยแพร่โดย developer epctex และมีป้าย “Maintained by Community”) ทำงานต่างจากเครื่องมือที่ผู้ให้บริการดูแลเองด้านบนมาก Apify ให้ runtime, โครงสร้างพร็อกซี และเครื่องมือ dataset/export ส่วนตรรกะการดึงข้อมูล Shopping จริง ๆ — รวมถึงการดูแล — เป็นของ epctex ไม่ใช่ของ Apify เอง
ความต่างนี้สำคัญเพราะตัวอย่างผลลัพธ์อย่างเป็นทางการของ Actor ตัวนี้มีฟิลด์ price เป็น null จริง ๆ ไม่ใช่ “บางครั้ง” หรือ “เฉพาะของหมดสต็อก” — เรคคอร์ดตัวอย่างในเอกสารแสดง price: null และ withoutDiscountPrice: null อยู่เคียงกับฟิลด์ชื่อสินค้า ผู้ค้า และเรตติ้งที่มีค่าครบ นี่คือหลักฐานจาก first-party ที่ชัดที่สุดในบทความนี้เลยว่าคุณไม่ควรสมมติว่าข้อมูลราคาจะครบเสมอ และมันมาจากเอกสารของเครื่องมือนั้นเอง
คุณปรับ input ได้หลายอย่าง — includeSponsoredResults, includeComparisonPrices สำหรับราคาข้ามผู้ขาย, country code, maxItemsPerQuery — และต้องตั้งค่า proxy ที่ใช้เองหรือของ Apify เอง Results export ออกมาได้เป็น JSON, XML, CSV หรือ Excel ผ่านระบบ Dataset ของ Apify Store listing ที่ผมตรวจดูมีผู้ใช้รวมราว 2,300 ราย แต่มี monthly active users แค่ 2 ราย ณ เวลานั้น — เป็นตัวเลขที่น่าจดไว้ เพราะคำว่า “community maintained” มีทั้งข้อดีและข้อเสีย: ยืดหยุ่น แต่จะน่าเชื่อถือเท่ากับคนที่ใช้งานและรายงานปัญหาอยู่จริงเท่านั้น
เหมาะที่สุดสำหรับ: นักพัฒนาที่พร้อมประเมินกิจกรรมการดูแลของ Actor ตัวหนึ่งโดยเฉพาะ และตรวจ schema ของผลลัพธ์จริงก่อนตัดสินใจ — ไม่เหมาะกับคนที่คาดหวังว่าแบรนด์ Apify จะรับประกันพฤติกรรมที่สม่ำเสมอให้ทั้งหมด
9. Thunderbit — เก็บข้อมูลแบบไม่ต้องเขียนโค้ดสำหรับนักการตลาด
Thunderbit คืออีกฝั่งหนึ่งของลิสต์นี้: เวิร์กโฟลว์ผ่านเบราว์เซอร์แบบ no-code สำหรับคนที่อยากดูหน้าเว็บที่เห็นอยู่ แล้วแปลงให้เป็นตารางแบบมีโครงสร้าง แทนที่จะเชื่อม Google Shopping API ซึ่งทำให้มันเหมาะโดยธรรมชาติสำหรับนักการตลาด, คนทำ PPC และทีม ecommerce ขนาดเล็กที่ทำเช็กรายครั้ง มากกว่าการสร้าง backend pipeline ปริมาณสูง
สิ่งที่ได้คือการดึงข้อมูลฝั่งเบราว์เซอร์: เปิดหน้า Shopping results ที่คุณต้องการจริง ๆ ให้ Thunderbit อ่านหน้าเว็บที่แสดงผลอยู่ในคลิกเดียว แล้วส่งออกฟิลด์ไปยัง Excel, Google Sheets, Airtable หรือ Notion ได้ตรง ๆ มีข้อแม้จริงอยู่หนึ่งอย่าง แต่เป็นข้อแม้ของ Shopping มากกว่าเป็นของเครื่องมือใดเครื่องมือหนึ่ง — เพราะการดึงข้อมูลเกิดบนหน้าที่คุณเปิดอยู่ ผลลัพธ์จึงรับค่า location, language และ session จาก browser นั้นไปด้วย ควรล็อกค่าพวกนี้ก่อนจะเอาผลลัพธ์สัปดาห์นี้ไปเทียบกับสัปดาห์ที่แล้ว นี่คือปัญหาความน่าเชื่อถือของฟิลด์แบบเดียวกับที่หัวข้อถัดไปจะพูดถึง และมันใช้กับทุกตัวในลิสต์นี้
เหมาะที่สุดสำหรับ: ทีมที่ไม่ใช่สายเทคนิคและให้ความสำคัญกับการดึงข้อมูลแบบเห็นภาพ ตรวจทานได้จากเบราว์เซอร์ มากกว่า pipeline แบบ JSON ที่นักพัฒนาดูแล — และต้องการดึงหน้า Shopping เฉพาะกิจแทนการ crawl ปริมาณสูงหลายภูมิภาค
แล้วข้อมูลแบบไหนเชื่อถือได้จริง? ปัญหาความน่าเชื่อถือของฟิลด์
นี่คือส่วนที่บทความเปรียบเทียบ Google Shopping ส่วนใหญ่มักข้ามไปทั้งหมด และเป็นสิ่งสำคัญที่สุดที่ต้องเข้าใจก่อนทำ automation อะไรก็ตาม: ไม่ใช่ทุกฟิลด์จะปรากฏในทุกรายการ และการตีความคำว่า “ขาด” ว่า “ศูนย์” จะทำให้ข้อมูลของคุณเสียอย่างเงียบ ๆ
| ฟิลด์ | ความน่าเชื่อถือ | จุดที่ต้องระวัง |
|---|---|---|
| ชื่อสินค้า | สูง | ควรทำ normalization ของชื่อที่เป็น variant/bundle ก่อนจะจับคู่สินค้าข้ามแหล่งข้อมูล |
| Product ID | ตามเงื่อนไข | DataForSEO ระบุชัดว่าค่านี้เปลี่ยนได้และบางครั้งเป็น null |
| ราคา | ตามเงื่อนไข | ตัวอย่างอย่างเป็นทางการของ Apify แสดงราคาเป็น null ในเรคคอร์ดที่มีข้อมูลครบอย่างอื่น |
| ผู้ขาย/merchant | มักมี | รายการแบบหลายผู้ขายหมายความว่าสินค้าเดียวอาจมี offer หลายชุด |
| เรตติ้ง/จำนวนรีวิว | ตามเงื่อนไข | สินค้าที่ใหม่หรือยังไม่มีเรตติ้งอาจไม่มีข้อมูลนี้เลย — อย่าบังคับให้เป็นศูนย์ |
| ค่าจัดส่ง/การส่งมอบ | ไม่สม่ำเสมอ | อาจขึ้นอยู่กับปลายทาง สต็อกของผู้ขาย และ session |
| ป้าย sponsored | ขึ้นอยู่กับเครื่องมือ | Oxylabs แยก pla ออกจาก organic ได้ชัดเจน; หลายเจ้ามีแค่ตัวเลือก include/exclude sponsored โดยไม่ได้ให้ป้ายต่อแถวที่เชื่อถือได้ |
กฎปฏิบัติที่ควรจำ: ก่อนจะทำ workflow อัตโนมัติใด ๆ ให้ดึง sample จริงด้วย keyword ที่คุณใช้จริง แล้วดูว่าอะไรเป็น null, ซ้ำ หรือหายไปจริง ๆ — ไม่ใช่สิ่งที่เอกสารชวนให้คิดว่าน่าจะมี
Google Merchant Center แบบทางการ vs. Google Shopping Scraper: คุณต้องใช้อะไร?
นี่เป็นคำถามที่ทีม ecommerce ถามกันก่อนจะเริ่มเทียบผู้ให้บริการเสียอีก และควรตอบกันตรง ๆ: ถ้าคุณกำลังจัดการรายการสินค้า ราคา หรือ Shopping ads ของตัวเอง งานนี้ต้องใช้เครื่องมือ Google Merchant Center อย่างเป็นทางการ — ไม่ใช่ scraper ของบุคคลที่สาม เครื่องมือในลิสต์นี้มีไว้เพื่อสังเกต รายการของคนอื่น เช่น ราคาคู่แข่ง การมองเห็นในตลาด การวิจัยหมวดหมู่ การมอนิเตอร์ตำแหน่งโฆษณา อย่าสับสนกัน ตรวจเอกสารทางการล่าสุดของ Google โดยตรงสำหรับชื่อและขอบเขตของ API ฝั่ง first-party เพราะสิ่งเหล่านี้มีการเปลี่ยนชื่อและปรับโครงสร้างเป็นระยะ
เครื่องมือเหล่านี้รับมือระบบป้องกันบอทของ Google อย่างไร
ผมจะอธิบายเรื่องนี้ในมุม governance ไม่ใช่สอน “วิธีชนะ Google” เพราะนั่นคือวิธีคิดที่ซื่อสัตย์ที่สุด ผู้ให้บริการหลายเจ้าที่อยู่ในลิสต์นี้ — SerpApi, SearchAPI, Bright Data, Oxylabs, Scrapingdog — ระบุสาธารณะว่าพวกเขาดูแลการหมุนพร็อกซี การเรนเดอร์เบราว์เซอร์ และ การจัดการ CAPTCHA ฝั่งเขาเอง นี่คือขอบเขตความรับผิดชอบด้าน maintenance ที่มีคุณค่าจริง: แปลว่าคุณไม่ใช่คนที่ต้องมานั่งแก้ IP ถูกบล็อกตอนตีสอง แต่มันไม่ใช่ และไม่ควรถูกตีความว่าเป็นการรับประกันว่าคุณจะเข้าถึงได้ตลอดหรือเข้าถึงได้ทุกกรณี
สิ่งที่ไม่หายไปแม้ใช้ผู้ให้บริการแบบ managed เต็มรูปแบบ: การควบคุม rate และค่าใช้จ่าย, การจำแนก error, การ retry, และการมอนิเตอร์เวลาที่ Google เปลี่ยนอะไรบางอย่าง (ซึ่งจาก changelog ที่ผมเจอของทั้ง SearchAPI และ Oxylabs ดูเหมือนจะเกิดขึ้นเป็นระยะ) Bright Data ระบุความล้มเหลวแบบ partial-batch ไว้ชัด DataForSEO ระบุพฤติกรรม timeout ของ callback Oxylabs ระบุกรณี token ไม่ถูกต้อง ทั้งหมดนี้ไม่ใช่คำแนะนำเพื่อหลบเลี่ยงอะไรทั้งสิ้น — มันคือการบันทึกอย่างตรงไปตรงมาว่าใครเป็นเจ้าของ failure mode ไหน
วิธีเลือก Google Shopping Scraper ที่เหมาะกับทีมของคุณ
ไล่ตามลำดับนี้:
- ระบุตัวตนของทีมคุณให้ชัด คุณเป็นนักพัฒนาที่สร้าง pipeline หรือเป็นนักการตลาด/ops ที่อยากได้ผลลัพธ์โดยไม่แตะโค้ด
- กำหนดฟิลด์ที่ต้องใช้จริง ข้อมูลระดับอันดับผลลัพธ์ต่างจากรายละเอียดระดับ merchant/offer — SearchAPI และ Oxylabs เด่นตรงหลังเป็นพิเศษ
- ซื่อสัตย์กับกำลังการดูแลของทีม จะเป็นการ map API และจัดการ error, ตั้งค่า Actor และพร็อกซี, หรือดึงจากหน้าที่ตรวจทานได้ — เลือกแบบที่ทีมคุณรับผิดชอบได้ระยะยาวจริง
- ทดสอบพฤติกรรม locale/device ด้วย query จริง ก่อนจะผูกกับผู้ให้บริการ เพราะเอกสารสาธารณะไม่ได้ตรงกับพฤติกรรมสดเสมอ
- ตรวจสอบเส้นทางการ export ว่ามันเข้ากับสแตกที่ใช้อยู่แล้วหรือไม่ — JSON dump เข้า data warehouse ต่างจากสเปรดชีตที่นักการตลาดเปิดใช้ได้ทันทีมาก
สรุป: ควรใช้ Google Shopping Scraper ตัวไหน?
ไม่มีตัวไหนที่ “ดีที่สุด” เพียงหนึ่งเดียว และถ้าบทความแบบลิสต์บอกอย่างอื่น ก็ควรระวังไว้ก่อน ถ้าคุณเป็นนักพัฒนาที่สร้าง data pipeline และต้องการ schema ที่ละเอียดที่สุดพร้อมการควบคุม cache และ locale แบบชัดเจน ให้เริ่มที่ SerpApi ถ้าเป้าหมายจริงของคุณคือการเปรียบเทียบราคาต่อผู้ขายในระดับ offer SearchAPI หรือ workflow แบบ token chain ของ Oxylabs จะพาคุณไปถึงจุดนั้นได้ตรงกว่า ถ้าคุณทำวิจัยแบบ bulk ตามกำหนดเวลาและรับระบบคิวได้ DataForSEO จะสเกลได้ดี ถ้าคุณต้องการแพลตฟอร์มระดับองค์กรที่ครอบคลุมทั้ง dataset ที่เตรียมไว้แล้วและ query แบบสด Bright Data จะครอบคลุมพื้นที่ได้มากที่สุด — แต่อย่าลืมคิดราคาตามแต่ละ surface แยกกัน
และถ้าคุณอยู่ในทีม PPC หรือการตลาดที่ไม่อยากแตะ API key เลย หมวดที่เป็น browser-based อย่าง Thunderbit คือคำตอบตรง ๆ ของ “ฉันแค่ต้องการข้อมูล ไม่ได้อยากทำโปรเจกต์เขียนโค้ด” เพียงแต่ต้องชัดเจนว่าคุณกำลังเลือก surface ไหน: workflow บนเบราว์เซอร์ออกแบบมาสำหรับหน้าที่คุณเปิดและตรวจเอง ขณะที่ เอกสาร API ของ Thunderbit และ CLI เป็นเส้นทางสำหรับนักพัฒนาแยกต่างหาก เลือกแบบที่ตรงกับวิธีทำงานจริงของทีมคุณ
ไม่ว่าคุณจะเลือกตัวไหน ให้ดึง sample จริงก่อนเสมอ ผู้ให้บริการทุกเจ้าที่กล่าวมาที่นี่มีอย่างน้อยหนึ่งฟิลด์ที่ไม่ได้มีค่าอยู่ตลอด — ตรวจของคุณก่อนจะสร้างอะไรต่อยอดลงไป
คำถามที่พบบ่อย
การสแครปข้อมูล Google Shopping ถูกกฎหมายไหม? คำถามนี้ผมตอบแบบเหมารวมไม่ได้ และบทความลิสต์ใด ๆ ก็ไม่ควรตอบได้เช่นกัน ข้อมูลที่เปิดเผยสาธารณะและคำกล่าวอ้างเรื่อง compliance ของผู้ให้บริการไม่ได้แปลว่าทุก use case จะถูกกฎหมายโดยอัตโนมัติ ก่อนจะสร้างอะไร ให้ตรวจเงื่อนไขการใช้งานปัจจุบันของ Google อ่านกฎหมายที่เกี่ยวข้องในเขตอำนาจศาลของคุณ และมั่นใจว่าวิธีเก็บข้อมูลของคุณได้รับอนุญาต มองเรื่องนี้เป็นกรณีที่ต้อง “ไปเช็กกับที่ปรึกษากฎหมายของคุณเอง” ไม่ใช่สิ่งที่บล็อกโพสต์จะตัดสินให้ได้
SERP API ต่างจาก Google Shopping scraper อย่างไร? SERP หรือ Shopping API จะรับพารามิเตอร์แบบมีโครงสร้างแล้วส่ง JSON ที่ parse เรียบร้อยกลับมา โดยผู้ให้บริการรับภาระโครงสร้างการดึงข้อมูลส่วนใหญ่ไว้ ส่วน browser-based scraper อย่าง Thunderbit จะดึงข้อมูลจากหน้าที่คุณหรือผู้ใช้เปิดอยู่จริง ส่วนผลิตภัณฑ์แบบ dataset (เช่นบางส่วนของ Bright Data) จะส่งมอบข้อมูลที่เก็บไว้ล่วงหน้าตามกำหนดเวลา แทนการเรียกสด ทั้งสามแบบมีเป้าหมายคล้ายกันแต่ต่างกันมากในเรื่องความสดของข้อมูล การควบคุม locale และภาระที่คุณต้องดูแลจริง
ต้องเขียนโค้ดถึงจะสแครป Google Shopping ได้ไหม? ไม่เสมอไป จุดขายทั้งหมดของ Thunderbit คือเวิร์กโฟลว์แบบ no-code ที่คลิกใช้งานได้สำหรับเหตุผลนี้พอดี Apify สามารถใช้งานผ่านหน้าเว็บโดยไม่ต้องเขียนโค้ดได้เช่นกัน แม้การปรับแต่งให้ลึกจริงจะได้ประโยชน์จากความคุ้นเคยทางเทคนิคบ้าง เครื่องมือที่ใช้ API ทุกตัวในลิสต์นี้ — SerpApi, Serper, SearchAPI, DataForSEO, Bright Data, Oxylabs, Scrapingdog — อย่างน้อยต้องมีทักษะพื้นฐานของนักพัฒนา: การยืนยันตัวตน การจัดการพารามิเตอร์ และการเช็ก error
ข้อมูล Google Shopping เปลี่ยนบ่อยแค่ไหน? บ่อยกว่าที่หลายคนคิด แต่ไม่มีข้อกำหนดสากลแบบ “อัปเดตทุก X ชั่วโมง” ให้พึ่งได้ ราคาสินค้า สต็อก ตำแหน่งโฆษณา และอันดับอาจเปลี่ยนตาม session, locale และช่วงเวลาของวัน ผู้ให้บริการหลายเจ้าในลิสต์นี้มีโหมด live/real-time ก็เพราะข้อมูลแบบ cache เสื่อมสภาพเร็วมากในหมวดนี้ ถ้าการตัดสินใจของคุณขึ้นอยู่กับราคาปัจจุบัน ให้รัน query ใหม่ อย่าเชื่อผลลัพธ์จากเมื่อวาน
เรียนรู้เพิ่มเติม




