
ลิงก์เสีย หน้าเว็บกำพร้า หรือหน้า “ทดสอบ” จากปี 2019 ที่ Google ดันเก็บเข้าดัชนีไปแล้ว ถ้าคุณดูแลเว็บไซต์อยู่ คุณคงรู้ว่ามันชวนปวดหัวแค่ไหน
web crawler ที่ดีจะช่วยจับปัญหาเหล่านี้ได้ครบ แถมยังสแกนทั้งเว็บไซต์ให้เห็นภาพรวม เพื่อให้คุณแก้ไขได้ตรงจุด แต่หลายคนมักสับสนระหว่าง “เว็บครอว์เลอร์” กับ “เว็บสแครปเปอร์” ซึ่งจริง ๆ แล้วไม่ใช่เรื่องเดียวกันเลย
ผมทดสอบ crawler ฟรี 10 ตัวกับเว็บไซต์จริง บางตัวเหมาะสุด ๆ สำหรับการตรวจ SEO บางตัวเด่นเรื่องดึงข้อมูล มาดูกันว่าตัวไหนเวิร์ก และตัวไหนหลุดรอดไปไม่ผ่าน
เว็บครอว์เลอร์คืออะไร? มาทำความเข้าใจพื้นฐานกันก่อน
ขอเคลียร์ให้ชัดตั้งแต่ต้น: website crawler ไม่ใช่ web scraper ถึงแม้สองคำนี้จะถูกหยิบมาใช้ปนกันบ่อยพอ ๆ กับการโยนแป้งพิซซ่า แต่จริง ๆ แล้วหน้าที่ต่างกันโดยสิ้นเชิง ลองนึกภาพ crawler เป็นเหมือนนักทำแผนที่ของเว็บไซต์ มันจะไล่สำรวจทุกซอกทุกมุม ตามทุกลิงก์ แล้วสร้างแผนผังของทุกหน้าในเว็บ งานของมันคือ การค้นหา: หา URL, ทำแผนผังโครงสร้างเว็บไซต์ และจัดทำดัชนีเนื้อหา สิ่งนี้คือสิ่งที่เสิร์ชเอนจินอย่าง Google ทำด้วยบอทของมัน และเป็นสิ่งที่เครื่องมือ SEO ใช้ตรวจสุขภาพเว็บไซต์ของคุณ (Thunderbit Blog: What Is a Web Crawler?)
ส่วน web scraper คือฝ่ายขุดข้อมูล มันไม่ได้สนใจภาพรวมทั้งแผนที่ แต่อยากดึง “ขุมทรัพย์” ที่ต้องการออกมา เช่น ราคาสินค้า ชื่อบริษัท รีวิว อีเมล หรือข้อมูลเฉพาะอื่น ๆ scraper จะดึงฟิลด์ที่ต้องการจากหน้าที่ crawler หาเจอ (Thunderbit Blog: How to Web Crawl a Site?).
เปรียบเทียบง่าย ๆ:
- Crawler: คนที่เดินสำรวจทุกแถวในซูเปอร์มาร์เก็ต เพื่อทำรายการสินค้าทั้งหมด
- Scraper: คนที่เดินตรงไปที่ชั้นกาแฟ แล้วจดราคากาแฟออร์แกนิกแต่ละยี่ห้อ
ทำไมเรื่องนี้ถึงสำคัญ? เพราะถ้าคุณแค่ต้องการรู้ว่าบนเว็บไซต์มีหน้าอะไรบ้าง (เช่นเพื่อทำ SEO audit) คุณต้องใช้ crawler แต่ถ้าคุณอยากดึงราคาสินค้าทั้งหมดจากเว็บไซต์คู่แข่ง คุณต้องใช้ scraper หรือถ้าให้ดีก็คือเครื่องมือที่ทำได้ทั้งสองอย่าง
ทำไมต้องใช้เว็บครอว์เลอร์ออนไลน์? ประโยชน์หลักต่อธุรกิจ
แล้วทำไมต้องยุ่งกับ web crawler? คำตอบคือ เว็บไม่ได้เล็กลงเลย ตรงกันข้าม แบรนด์ระดับองค์กรกว่า 54% ใช้แพลตฟอร์ม crawler เฉพาะทาง เพื่อปรับปรุงเว็บไซต์ และเครื่องมือ SEO บางตัวครอว์ลหน้าเว็บมากถึง 7 พันล้านหน้า ต่อวัน
สิ่งที่ crawler ช่วยคุณได้มีดังนี้:
- ตรวจ SEO: หาเดดลิงก์ ชื่อหน้าไม่ครบ เนื้อหาซ้ำ หน้าเว็บกำพร้า และอื่น ๆ (SEO.ai)
- เช็กลิงก์และ QA: จับ 404 และ redirect loop ให้ได้ก่อนที่ผู้ใช้จะเจอ (Screaming Frog)
- สร้าง Sitemap: สร้าง XML sitemap อัตโนมัติสำหรับเสิร์ชเอนจินและการวางแผน (PowerMapper)
- ทำบัญชีเนื้อหา: รวบรวมรายชื่อทุกหน้า ลำดับชั้น และเมตาดาต้า
- ตรวจ Compliance และ Accessibility: เช็กทุกหน้าให้สอดคล้องกับ WCAG, SEO และข้อกฎหมาย (SiteOne Crawler)
- ประสิทธิภาพและความปลอดภัย: ระบุหน้าช้า รูปใหญ่เกินไป หรือปัญหาด้านความปลอดภัย (SiteOne Crawler)
- ข้อมูลสำหรับ AI และการวิเคราะห์: ส่งข้อมูลที่ครอว์ลได้ไปใช้กับเครื่องมือวิเคราะห์หรือ AI (Thunderbit Blog: Crawl4AI Review)
ตารางสรุปการใช้งานกับบทบาททางธุรกิจ:
| Use Case | Ideal For | Benefit / Outcome |
|---|---|---|
| SEO & Site Auditing | Marketing, SEO, Small Biz Owners | Find technical issues, optimize structure, improve rankings |
| Content Inventory & QA | Content Managers, Webmasters | Audit or migrate content, catch broken links/images |
| Lead Generation (Scraping) | Sales, Biz Dev | Automate prospecting, fill CRM with fresh leads |
| Competitive Intelligence | E-commerce, Product Managers | Monitor competitor prices, new products, stock changes |
| Sitemap & Structure Cloning | Developers, DevOps, Consultants | Clone site structure for redesigns or backups |
| Content Aggregation | Researchers, Media, Analysts | Gather data from multiple sites for analysis or trend monitoring |
| Market Research | Analysts, AI Training Teams | Collect large datasets for analysis or AI model training |
(Thunderbit Blog: How to Web Crawl a Site?)
เราคัดเลือกเครื่องมือเว็บครอว์เลอร์ฟรีที่ดีที่สุดอย่างไร
ผมใช้เวลาหลายคืนมาก ๆ (พร้อมกาแฟมากเกินกว่าจะนับได้) ไปกับการไล่ดูเครื่องมือ อ่านเอกสาร และรันทดสอบ crawl นี่คือเกณฑ์ที่ผมใช้:
- ความสามารถเชิงเทคนิค: รองรับเว็บไซต์ยุคใหม่ได้ไหม เช่น JavaScript, login, คอนเทนต์แบบไดนามิก
- ใช้งานง่ายแค่ไหน: เหมาะกับคนไม่สายเทคนิคหรือเปล่า หรือจำเป็นต้องใช้คำสั่งในเทอร์มินัล
- ข้อจำกัดของแผนฟรี: ฟรีจริงหรือแค่ให้ลองเล่น
- เข้าถึงออนไลน์ได้ไหม: เป็นเครื่องมือคลาวด์ แอปเดสก์ท็อป หรือไลบรารีโค้ด
- ฟีเจอร์เด่น: มีอะไรพิเศษ เช่น AI extraction, visual sitemap หรือครอว์ลแบบ event-driven
ผมทดสอบแต่ละตัว ตรวจรีวิวผู้ใช้ และเทียบฟีเจอร์แบบตัวต่อตัว ถ้าเครื่องมือไหนทำเอาผมอยากปิดโน้ตบุ๊กทิ้ง มันก็ไม่ได้อยู่ในลิสต์นี้
ตารางเปรียบเทียบเร็ว ๆ: 10 เว็บครอว์เลอร์ฟรีที่ดีที่สุดในภาพรวม
| Tool & Type | Core Features | Best Use Case | Technical Needs | Free Plan Details |
|---|---|---|---|---|
| Bright Data (Cloud/API) | Enterprise crawling, proxies, JS rendering, CAPTCHA solving | Large-scale data collection | Some tech skill helpful | Free tier: 5,000 records/month on the Web Scraper API, no credit card |
| Crawlbase (Cloud/API) | API crawling, anti-bot, proxies, JS rendering | Devs needing backend crawl infra | API integration | Free: up to 20,000 requests to start, no credit card; pay-per-request after |
| ScraperAPI (Cloud/API) | Proxy rotation, JS rendering, async crawl, prebuilt endpoints | Devs, price monitoring, SEO data | Minimal setup | Free: 5,000 API calls for 7 days, then 1,000/month |
| Diffbot Crawlbot (Cloud) | AI crawl + extraction, knowledge graph, JS rendering | Structured data at scale, AI/ML | API integration | Free: 10,000 credits/month for the extraction APIs; Crawl needs the Plus plan |
| Screaming Frog (Desktop) | SEO audit, link/meta analysis, sitemap, custom extraction | SEO audits, site managers | Desktop app, GUI | Free: 500 URLs per crawl, core features only |
| SiteOne Crawler (Desktop) | SEO, performance, accessibility, security, offline export, Markdown | Devs, QA, migration, documentation | Desktop/CLI, GUI | Free & open-source, 1,000 URLs in GUI report (configurable) |
| Crawljax (Java, OpenSrc) | Event-driven crawl for JS-heavy sites, static export | Devs, QA for dynamic web apps | Java, CLI/config | Free & open-source, no limits |
| Apache Nutch (Java, OpenSrc) | Distributed, plugin-based, Hadoop integration, custom search | Custom search engines, large-scale crawl | Java, command-line | Free & open-source, infra cost only |
| YaCy (Java, OpenSrc) | Peer-to-peer crawl & search, privacy, web/intranet indexing | Private search, decentralization | Java, browser UI | Free & open-source, no limits |
| PowerMapper (Desktop/SaaS) | Visual sitemaps, accessibility, QA, browser compatibility | Agencies, QA, visual mapping | GUI, easy | Free trial: 30 days, 100 pages (desktop) or 10 pages (online) per scan |
มีข้อควรระวังก่อนเลื่อนอ่านต่อ: คำว่า “ฟรี” ในคอลัมน์สุดท้ายนั้นหมายถึงหลายอย่างมาก SiteOne, Crawljax, Nutch และ YaCy เป็นโอเพนซอร์ส คือใช้ฟรีแบบไม่จำกัด ยกเว้นข้อจำกัดของเครื่องคุณเอง Screaming Frog ฟรีตลอด แต่จำกัดที่ 500 URL ต่อการ crawl หนึ่งครั้ง Bright Data, ScraperAPI และ Diffbot มี free tier ที่ใช้งานได้จริง แต่ค่อนข้างเล็ก และสำหรับ Diffbot ตัว crawler เองยังไม่รวมอยู่ในแผนฟรี ส่วน Crawlbase จะให้สิทธิ์ใช้ฟรีเป็นบล็อกแรกก่อน แล้วคิดเงินตามการใช้งานภายหลัง PowerMapper คือแบบทดลองใช้ฟรีล้วน ๆ พอครบ 30 วันก็ต้องจ่าย
Bright Data: เว็บครอว์เลอร์ระดับองค์กรบนคลาวด์
Bright Data คือ “ของหนัก” ในโลก web crawl มันเป็นแพลตฟอร์มคลาวด์ที่มีเครือข่ายพร็อกซีขนาดใหญ่ รองรับ JavaScript rendering, การแก้ CAPTCHA และมี IDE สำหรับสร้าง crawl แบบกำหนดเอง ถ้าคุณกำลังทำ data collection ขนาดใหญ่ เช่น เฝ้าดูราคาสินค้าจากเว็บไซต์อีคอมเมิร์ซหลายร้อยแห่ง Bright Data คือโครงสร้างพื้นฐานที่โคตรรับมือไหว (aimultiple.com)
จุดเด่น:
- รับมือเว็บยาก ๆ ที่มีระบบกันบอทได้ดี
- ขยายสเกลได้เหมาะกับงานระดับองค์กร
- มีเทมเพลตสำเร็จรูปสำหรับเว็บไซต์ยอดนิยม
ข้อจำกัด:
- แผนฟรีมีจริง แต่เล็ก: 5,000 records ต่อเดือนบน Web Scraper API
- อาจเกินความจำเป็นสำหรับงาน audit ง่าย ๆ
- ผู้ใช้ที่ไม่ถนัดเทคนิคอาจต้องใช้เวลาทำความเข้าใจ
ถ้าคุณต้อง crawl เว็บในสเกลใหญ่ Bright Data ก็เหมือนเช่ารถ Formula 1 แผนฟรี 5,000 records ต่อเดือนพอให้ขับวนรอบบ้านได้ แต่เกินจากนั้นก็คิดตามใช้งาน (Bright Data Pricing)
Crawlbase: เว็บครอว์เลอร์แบบ API สำหรับนักพัฒนา
Crawlbase (ชื่อเดิม ProxyCrawl) เน้นการ crawl ผ่านโปรแกรม คุณส่ง URL ไปที่ API ของเขา แล้วระบบจะคืน HTML กลับมา พร้อมจัดการพร็อกซี การระบุตำแหน่งทางภูมิศาสตร์ และ CAPTCHA เบื้องหลังให้ (Capterra)
จุดเด่น:
- อัตราสำเร็จสูงมาก (99%+)
- รับมือเว็บที่ใช้ JavaScript หนัก ๆ ได้ดี
- เหมาะกับการเอาไปต่อเข้ากับแอปหรือเวิร์กโฟลว์ของคุณเอง
ข้อจำกัด:
- ต้องเชื่อม API หรือ SDK พอสมควร
- แผนฟรี: ให้ใช้ได้สูงสุด 20,000 requests ตอนเริ่มต้น (ไม่ต้องใช้บัตรเครดิต) จากนั้นคิดตาม request
ถ้าคุณเป็นนักพัฒนาที่อยาก crawl (และอาจ scrape ด้วย) ในสเกลใหญ่โดยไม่ต้องดูแลพร็อกซีเอง Crawlbase คือทางเลือกที่ดี (Crawlbase Pricing)
ScraperAPI: ทำให้การครอว์ลเว็บไดนามิกง่ายขึ้น
ScraperAPI คือ API แบบ “ช่วยดึงมาให้หน่อย” คุณแค่ส่ง URL ไป ระบบจัดการพร็อกซี เบราว์เซอร์แบบ headless และมาตรการกันบอทให้ แล้วส่ง HTML กลับมาให้ หรือบางเว็บก็ส่งเป็นข้อมูลแบบมีโครงสร้างให้เลย จุดแข็งคือหน้าไดนามิก แต่ความฟรีค่อนข้างจำกัด: ให้ 5,000 API credits ใน 7 วันแรกโดยไม่ต้องใช้บัตร และต่อจากนั้นได้ 1,000 credits ต่อเดือนในแผนฟรีแบบต่อเนื่อง (ScraperAPI Pricing)
จุดเด่น:
- ใช้งานง่ายมากสำหรับนักพัฒนา แค่เรียก API
- รับมือ CAPTCHA, IP ban, และ JavaScript ได้
- ฟรี: 5,000 API calls ใน 7 วันแรก แล้ว 1,000 ต่อเดือน
ข้อจำกัด:
- ไม่มีรายงาน crawl แบบภาพให้ดู
- ถ้าต้องการตามลิงก์ต่อไป คุณต้องเขียนตรรกะการ crawl เอง
ถ้าคุณอยากเอา web crawl ไปผูกกับโค้ดของคุณให้เสร็จภายในไม่กี่นาที ScraperAPI คือคำตอบที่ตรงไปตรงมา
Diffbot Crawlbot: ค้นหาโครงสร้างเว็บไซต์แบบอัตโนมัติ
Diffbot Crawlbot คือจุดที่ความฉลาดเริ่มเข้ามา มันไม่ได้แค่ crawl แต่ใช้ AI จำแนกหน้าเว็บและดึงข้อมูลแบบมีโครงสร้างออกมาเป็น JSON เช่น บทความ สินค้า อีเวนต์ และอื่น ๆ ราวกับมีผู้ช่วยหุ่นยนต์ที่อ่านเว็บรู้เรื่องจริง ๆ (Diffbot Free Plan)
จุดเด่น:
- ดึงข้อมูลด้วย AI ไม่ใช่แค่ crawl อย่างเดียว
- รองรับ JavaScript และคอนเทนต์แบบไดนามิก
- ฟรี: 10,000 credits ต่อเดือน ไม่ต้องใช้บัตรครอบคลุม Extract, Natural Language, Knowledge Graph และ Search
ข้อจำกัด:
- เน้นนักพัฒนาเป็นหลัก ต้องเชื่อมต่อผ่าน API
- ไม่ใช่เครื่องมือ SEO แบบภาพ เหมาะกับงานข้อมูลมากกว่า
- ตัว Crawlbot ที่สไปเดอร์ทั้งเว็บอยู่ในแผน Plus ขึ้นไป ส่วนเครดิตฟรีครอบคลุมเฉพาะ extraction APIs (Diffbot Pricing)
ถ้าคุณต้องการข้อมูลแบบมีโครงสร้างในสเกลใหญ่ โดยเฉพาะสำหรับ AI หรือ analytics Diffbot คือของแรง
Screaming Frog: เว็บครอว์เลอร์เดสก์ท็อปฟรีสำหรับ SEO
Screaming Frog คือ crawler เดสก์ท็อปสุดคลาสสิกสำหรับการทำ SEO audit ฟรีเวอร์ชัน crawl ได้สูงสุด 500 URL ต่อการสแกน และให้ทุกอย่างครบทั้งลิงก์เสีย meta tag เนื้อหาซ้ำ sitemap และอีกมากมาย (Screaming Frog User Guide)
จุดเด่น:
- เร็ว ละเอียด และได้รับความไว้วางใจในวงการ SEO
- ไม่ต้องเขียนโค้ด แค่ใส่ URL แล้วเริ่มได้เลย
- ฟรีสำหรับการ crawl ไม่เกิน 500 URL
ข้อจำกัด:
- ใช้ได้เฉพาะเดสก์ท็อป ไม่มีเวอร์ชันคลาวด์
- ฟีเจอร์ขั้นสูง เช่น JavaScript rendering และการตั้งเวลาครอว์ล ต้องใช้ไลเซนส์แบบเสียเงิน
ถ้าคุณจริงจังกับ SEO Screaming Frog คือของที่ควรมี เพียงแต่อย่าหวังว่าจะให้มัน crawl เว็บ 10,000 หน้าได้ฟรี
SiteOne Crawler: ส่งออกเว็บไซต์แบบสแตติกและทำเอกสารได้
SiteOne Crawler คือมีดพกสวิสสำหรับงาน technical audit มันเป็นโอเพนซอร์ส ใช้ได้หลายแพลตฟอร์ม และสามารถ crawl ตรวจสอบ และส่งออกเว็บไซต์เป็น Markdown เพื่อทำเอกสารหรือใช้งานแบบออฟไลน์ได้ (SiteOne Crawler)
จุดเด่น:
- ครอบคลุม SEO, performance, accessibility, security
- ส่งออกไซต์เพื่อเก็บถาวรหรือใช้ตอนย้ายระบบ
- ฟรีและโอเพนซอร์ส ไม่มีลิมิตการใช้งาน
ข้อจำกัด:
- ค่อนข้างเทคนิคมากกว่าเครื่องมือ GUI บางตัว
- รายงานใน GUI จำกัด 1,000 URL โดยค่าเริ่มต้น แต่ปรับได้
ถ้าคุณเป็นนักพัฒนา QA หรือที่ปรึกษาที่อยากได้ข้อมูลเชิงลึกแบบจัดเต็ม และชอบโอเพนซอร์ส SiteOne คือของดีที่คนไม่ค่อยพูดถึง
Crawljax: เว็บครอว์เลอร์ Java แบบโอเพนซอร์สสำหรับหน้าไดนามิก
Crawljax เป็นเครื่องมือสายเฉพาะทาง ออกแบบมาสำหรับ crawl เว็บแอปสมัยใหม่ที่ใช้ JavaScript หนัก ๆ โดยจำลองพฤติกรรมผู้ใช้ เช่น การคลิก การกรอกฟอร์ม และอื่น ๆ มันทำงานแบบ event-driven และยังสามารถสร้างเวอร์ชันสแตติกของเว็บไดนามิกได้ด้วย (Wikipedia: Crawljax)
จุดเด่น:
- เหมาะที่สุดสำหรับ SPAs และเว็บที่ใช้ AJAX หนัก ๆ
- เป็นโอเพนซอร์สและขยายต่อได้
- ไม่มีข้อจำกัดการใช้งาน
ข้อจำกัด:
- ต้องใช้ Java และมีพื้นฐานการเขียนโปรแกรม/ตั้งค่า
- ไม่เหมาะกับผู้ใช้ที่ไม่ใช่สายเทคนิค
ถ้าคุณต้อง crawl แอป React หรือ Angular แบบเหมือนผู้ใช้จริง Crawljax คือเพื่อนแท้ของคุณ
Apache Nutch: เว็บครอว์เลอร์แบบกระจายที่ขยายสเกลได้
Apache Nutch คือคุณปู่แห่งวงการ crawler โอเพนซอร์ส มันถูกออกแบบมาสำหรับการ crawl ขนาดมหาศาลแบบ distributed เช่น การสร้างเสิร์ชเอนจินของตัวเอง หรือการทำดัชนีเป็นล้าน ๆ หน้า (Martechvibe)
จุดเด่น:
- ขยายไปถึงระดับพันล้านหน้าเมื่อใช้ร่วมกับ Hadoop
- ปรับแต่งและต่อยอดได้สูงมาก
- ฟรีและโอเพนซอร์ส
ข้อจำกัด:
- เส้นทางการเรียนรู้ค่อนข้างชัน (Java, command-line, config)
- ไม่เหมาะกับเว็บเล็กหรือผู้ใช้ทั่วไป
ถ้าคุณอยาก crawl เว็บในสเกลใหญ่และไม่กลัวการทำงานผ่าน command-line Nutch คือเครื่องมือของคุณ
YaCy: เว็บครอว์เลอร์และเสิร์ชเอนจินแบบเพียร์ทูเพียร์
YaCy เป็น crawler และเสิร์ชเอนจินแบบกระจายศูนย์ที่ไม่เหมือนใคร แต่ละอินสแตนซ์จะ crawl และจัดทำดัชนีเว็บไซต์เอง และคุณยังเข้าร่วมเครือข่าย peer-to-peer เพื่อแชร์ดัชนีกับคนอื่นได้ด้วย (TechRadar: YaCy)
จุดเด่น:
- เน้นความเป็นส่วนตัว ไม่มีเซิร์ฟเวอร์กลาง
- เหมาะกับการสร้างเสิร์ชภายในองค์กรหรืออินทราเน็ต
- ฟรีและโอเพนซอร์ส
ข้อจำกัด:
- ผลลัพธ์ขึ้นอยู่กับขอบเขตของเครือข่าย
- ต้องมีการตั้งค่าบางส่วน (Java, browser UI)
ถ้าคุณสนใจแนวคิดการกระจายศูนย์ หรืออยากมีเสิร์ชเอนจินของตัวเอง YaCy เป็นตัวเลือกที่น่าสนใจมาก
PowerMapper: ตัวสร้าง Sitemap แบบภาพสำหรับ UX และ QA
PowerMapper เน้นการทำให้โครงสร้างเว็บไซต์มองเห็นได้ชัด มัน crawl เว็บไซต์แล้วสร้าง sitemap แบบอินเทอร์แอคทีฟ แถมยังตรวจ accessibility, ความเข้ากันได้กับเบราว์เซอร์ และพื้นฐาน SEO ให้ด้วย (Slickplan Review)
จุดเด่น:
- Visual sitemap เหมาะมากสำหรับเอเจนซีและนักออกแบบ
- ตรวจ accessibility และ compliance ได้
- ใช้งานผ่าน GUI ง่าย ไม่ต้องมีทักษะเทคนิคสูง
ข้อจำกัด:
- มีแค่ทดลองใช้ฟรี 30 วัน โดยจำกัด 100 หน้าในเดสก์ท็อป / 10 หน้าในออนไลน์ต่อการสแกน
- เวอร์ชันเต็มต้องเสียเงิน
ถ้าคุณต้องนำแผนผังเว็บไซต์ไปพรีเซนต์ลูกค้า หรือตรวจ compliance PowerMapper ถือว่าใช้งานสะดวกมาก
จะเลือกเว็บครอว์เลอร์ฟรีตัวไหนให้เหมาะกับงานดี?
มีตัวเลือกเยอะขนาดนี้ แล้วจะเลือกยังไงดี? นี่คือแนวทางสั้น ๆ ของผม:
- สำหรับ SEO audit: Screaming Frog (เว็บเล็ก), PowerMapper (แบบภาพ), SiteOne (audit ลึก)
- สำหรับเว็บแอปไดนามิก: Crawljax
- สำหรับงานสเกลใหญ่หรือ search แบบกำหนดเอง: Apache Nutch, YaCy
- สำหรับนักพัฒนาที่ต้องใช้ API: Crawlbase, ScraperAPI, Diffbot
- สำหรับเอกสารหรือการเก็บถาวร: SiteOne Crawler
- สำหรับงานระดับองค์กรแต่ใช้ฟรีได้บ้าง: Bright Data, Diffbot
ปัจจัยสำคัญที่ควรคิดถึง:
- ความสามารถในการขยายสเกล: เว็บไซต์หรือ job ที่จะครอว์ลใหญ่แค่ไหน
- ความง่ายในการใช้งาน: คุณถนัดโค้ด หรืออยากได้แบบกดใช้งาน
- การส่งออกข้อมูล: ต้องการ CSV, JSON หรือเชื่อมกับเครื่องมืออื่น
- การซัพพอร์ต: มีชุมชนหรือเอกสารช่วยเหลือไหมเมื่อเจอปัญหา
เมื่อเว็บครอว์ลมาบรรจบกับเว็บสแครป: ทำไม Thunderbit จึงเป็นตัวเลือกที่ฉลาดกว่า
ดึงข้อมูลจากทุกเว็บไซต์ด้วย AI Agentic web scraper ของ Thunderbit อ่านเว็บไซต์ที่คุณต้องการครอว์ลและดึงข้อมูลแบบมีโครงสร้างได้ในคลิกเดียว — ฟรี 6 หน้า/เดือน Get Started Free
ความจริงก็คือ คนส่วนใหญ่ไม่ได้ครอว์ลเว็บเพื่อทำแผนผังสวย ๆ อย่างเดียว เป้าหมายจริงมักเป็นการได้ข้อมูลที่นำไปใช้ต่อได้ เช่น รายการสินค้า ข้อมูลติดต่อ หรือ inventory ของเนื้อหา และนั่นคือจุดที่ Thunderbit เข้ามาช่วย
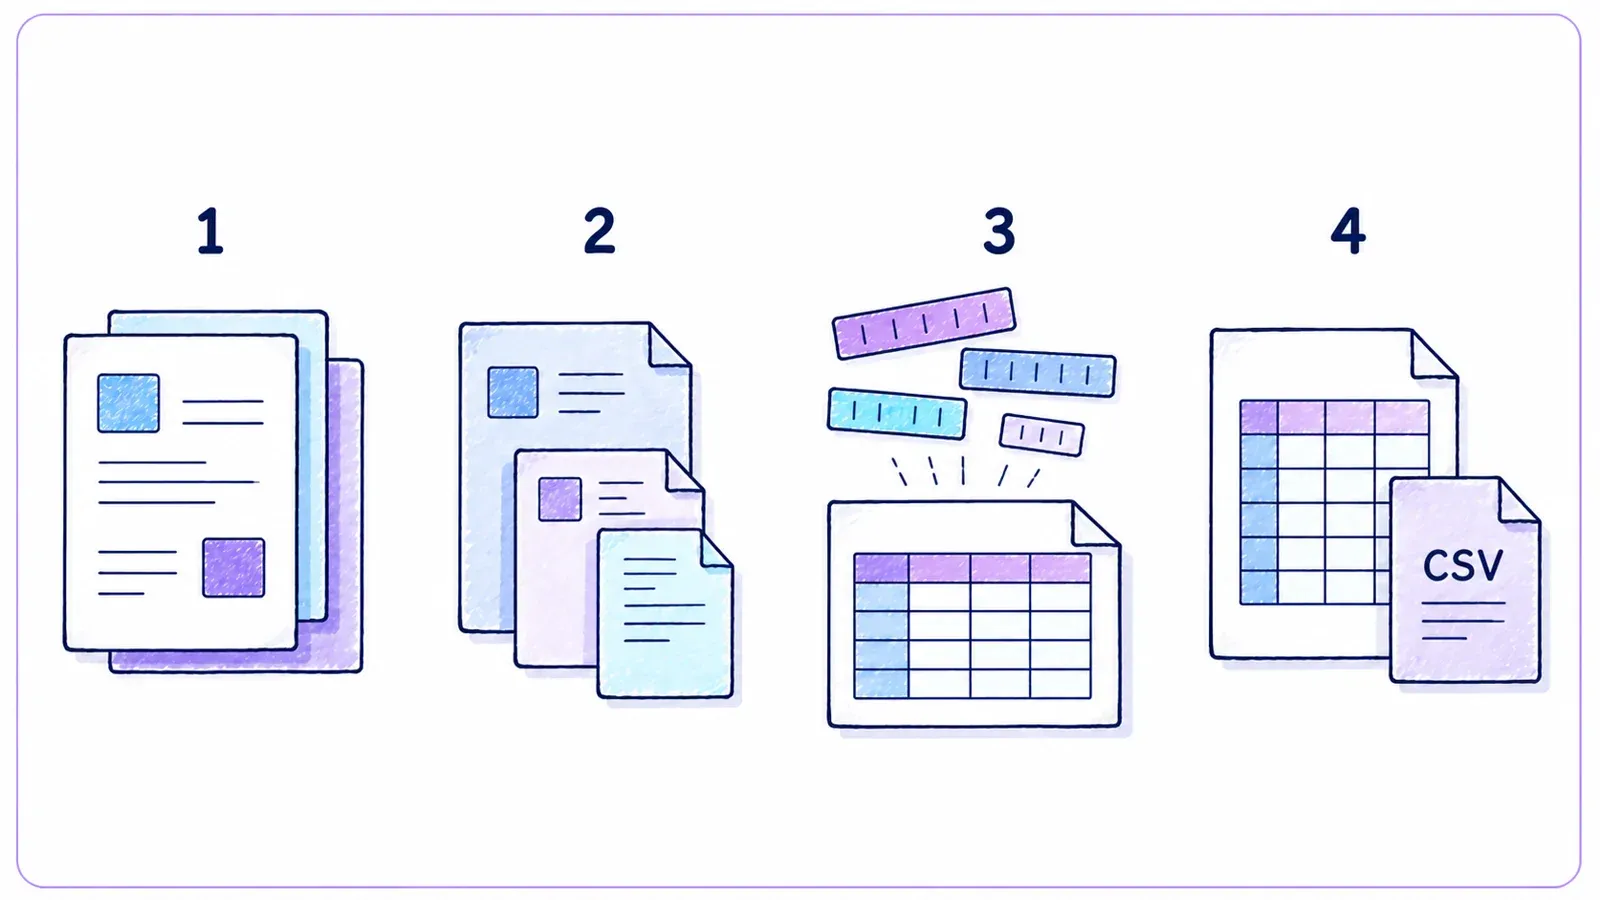
Thunderbit ไม่ใช่แค่ crawler หรือ scraper แต่มันคือ Chrome extension ที่ขับเคลื่อนด้วย AI และรวมความสามารถทั้งสองอย่างไว้ด้วยกัน วิธีทำงานมีดังนี้:
- AI Crawler: Thunderbit สำรวจเว็บไซต์เหมือน crawler ทั่วไป
- Waterfall Crawling: ถ้าเครื่องมือของ Thunderbit เข้าเว็บนั้นไม่ได้เอง เช่น ติดกำแพงกันบอทยาก ๆ มันจะสลับไปใช้บริการครอว์ลจากภายนอกให้อัตโนมัติ ไม่ต้องตั้งค่าเอง
- AI Data Structuring: พอได้ HTML แล้ว AI ของ Thunderbit จะช่วยเสนอคอลัมน์ที่เหมาะสมและดึงข้อมูลแบบมีโครงสร้าง เช่น ชื่อ ราคา อีเมล โดยไม่ต้องเขียน selector เลย
- Subpage Scraping: ถ้าต้องการรายละเอียดจากทุกหน้าสินค้า Thunderbit สามารถเข้าไปยังหน้าย่อยแต่ละหน้าให้เอง แล้วเติมข้อมูลลงตาราง
- Data Cleaning & Export: สรุป จัดหมวดหมู่ แปลภาษา และส่งออกไปยัง Excel, Google Sheets, Airtable หรือ Notion ได้ในคลิกเดียว
- No-Code ใช้ง่าย: ถ้าคุณใช้เบราว์เซอร์เป็น ก็ใช้ Thunderbit ได้ ไม่ต้องเขียนโค้ด ไม่ต้องจัดการพร็อกซี ไม่ต้องปวดหัว
ควรใช้ Thunderbit แทนครอว์เลอร์แบบเดิมเมื่อไหร่?
- เมื่อเป้าหมายสุดท้ายคือสเปรดชีตที่สะอาดและใช้งานได้จริง ไม่ใช่แค่รายการ URL
- เมื่อคุณอยากทำให้ทุกขั้นตอนอัตโนมัติ ทั้งครอว์ล ดึงข้อมูล ทำความสะอาด และส่งออกในที่เดียว
- เมื่อคุณให้ค่ากับเวลาและความสบายใจของตัวเอง
คุณสามารถ ดาวน์โหลด Chrome extension ของ Thunderbit ได้ที่นี่ แล้วดูด้วยตัวเองว่าทำไมผู้ใช้ธุรกิจจำนวนมากถึงกำลังเปลี่ยนมาใช้
ลองใช้ Thunderbit ฟรี – Agentic Web Scraper ติดตั้ง Chrome extension ฟรี แล้วเริ่มครอว์ลเว็บไซต์ใดก็ได้ในคลิกเดียว ไม่ต้องเขียนโค้ด Get Started Free
สรุป: ใช้เว็บครอว์เลอร์ฟรีให้คุ้มที่สุด
ดูว่า Agentic Web Scraping ทำงานอย่างไร AI ของ Thunderbit อ่านหน้าเว็บเหมือนคนจริง แล้วตัดสินใจเองว่าควรดึงอะไร แทนการตั้งค่าครอว์เลอร์ด้วยมือ Get Started Free
web crawler พัฒนามาไกลมาก ไม่ว่าคุณจะเป็นนักการตลาด นักพัฒนา หรือแค่คนที่อยากดูแลเว็บไซต์ให้ดี ก็มีเครื่องมือฟรีหรืออย่างน้อยก็ทดลองใช้ฟรีให้เลือก ตั้งแต่แพลตฟอร์มระดับองค์กรอย่าง Bright Data และ Diffbot ไปจนถึงโอเพนซอร์สคุณภาพอย่าง SiteOne และ Crawljax หรือเครื่องมือทำแผนผังแบบภาพอย่าง PowerMapper ตัวเลือกมีหลากหลายกว่าที่เคย
แต่ถ้าคุณกำลังมองหาวิธีที่ฉลาดกว่าและเชื่อมต่อทุกขั้นตอนได้ดีกว่า จาก “ฉันต้องการข้อมูลนี้” ไปสู่ “นี่คือสเปรดชีตของฉัน” ลอง Thunderbit ดู มันถูกสร้างมาสำหรับผู้ใช้งานธุรกิจที่ต้องการผลลัพธ์ ไม่ใช่แค่รายงาน
พร้อมจะเริ่ม crawl หรือยัง? ดาวน์โหลดเครื่องมือ สแกนดูสักรอบ แล้วคุณจะรู้ว่าก่อนหน้านี้พลาดอะไรไปบ้าง และถ้าคุณอยากเปลี่ยนจากการ crawl ไปสู่ข้อมูลที่ใช้งานได้จริงในคลิกเดียว ลองดู Thunderbit
สำหรับบทวิเคราะห์เชิงลึกและคู่มือใช้งานเพิ่มเติม แวะที่ Thunderbit Blog
ดึงข้อมูลเว็บไซต์ด้วย AI ในคลิกเดียว ตั้งค่าให้ Thunderbit ไล่ตามหน้าย่อยและรันตามกำหนดเวลา เพื่อให้ข้อมูลล่าสุดอยู่เสมอโดยไม่ต้องรันใหม่เอง Get Started Free
ลองใช้ Agentic Web Scraper Get Started Free
คำถามที่พบบ่อย
อะไรคือความแตกต่างระหว่างเว็บครอว์เลอร์กับเว็บสแครปเปอร์?
ครอว์เลอร์มีหน้าที่ค้นหาและทำแผนผังทุกหน้าบนเว็บไซต์ เหมือนการสร้างสารบัญ ส่วนสแครปเปอร์จะดึงข้อมูลเฉพาะที่ต้องการ เช่น ราคา อีเมล หรือรีวิว จากหน้าเหล่านั้น ครอว์เลอร์เป็นฝ่ายหา สแครปเปอร์เป็นฝ่ายขุด (Thunderbit Blog: What Is a Web Crawler?)
เว็บครอว์เลอร์ฟรีตัวไหนเหมาะกับคนไม่ถนัดเทคนิคมากที่สุด?
ถ้าเป็นเว็บเล็กและทำ SEO audit, Screaming Frog ใช้งานง่าย ถ้าต้องการมองเห็นโครงสร้างเป็นภาพ PowerMapper ก็ดีมากในช่วงทดลองใช้ฟรี ส่วน Thunderbit จะใช้ง่ายที่สุดถ้าเป้าหมายของคุณคือข้อมูลแบบมีโครงสร้าง และอยากได้ประสบการณ์แบบ no-code บนเบราว์เซอร์
มีเว็บไซต์ที่บล็อกเว็บครอว์เลอร์ไหม?
มี บางเว็บใช้ robots.txt หรือมาตรการกันบอท เช่น CAPTCHA หรือการแบน IP เพื่อบล็อกครอว์เลอร์ เครื่องมืออย่าง ScraperAPI, Crawlbase และ Thunderbit (ด้วย waterfall crawling) มักช่วยข้ามข้อจำกัดเหล่านี้ได้ แต่ควรครอว์ลอย่างรับผิดชอบและเคารพกฎของเว็บไซต์เสมอ (Bright Data Pricing)
เว็บครอว์เลอร์ฟรีมีข้อจำกัดเรื่องหน้าเว็บหรือฟีเจอร์ไหม?
ส่วนใหญ่มี เช่น Screaming Frog เวอร์ชันฟรีจำกัด 500 URL ต่อการ crawl หนึ่งครั้ง ส่วน PowerMapper จำกัด 100 หน้า เครื่องมือแบบ API มักจำกัดเครดิตรายเดือน ขณะที่โอเพนซอร์สอย่าง SiteOne หรือ Crawljax โดยทั่วไปไม่มีลิมิตตายตัว แต่ก็ขึ้นอยู่กับสเปกเครื่องของคุณ
การใช้เว็บครอว์เลอร์ถูกกฎหมายและสอดคล้องกับความเป็นส่วนตัวไหม?
โดยทั่วไป การ crawl หน้าเว็บสาธารณะถือว่าทำได้ แต่ควรตรวจสอบเงื่อนไขการใช้งานและ robots.txt ของเว็บไซต์นั้นเสมอ ห้าม crawl ข้อมูลส่วนตัวหรือข้อมูลที่ต้องใช้รหัสผ่านโดยไม่ได้รับอนุญาต และถ้าคุณดึงข้อมูลส่วนบุคคล ควรระวังเรื่องกฎหมายคุ้มครองข้อมูลส่วนบุคคลด้วย (Crawlbase Guide)



