
เดือนก่อน ระบบเชื่อมต่อ Stripe ของเพื่อนผมเริ่มตอบกลับ 503 แบบเงียบ ๆ ตอน 5 ทุ่มของวันศุกร์ ไม่มีใครรู้เลยจนถึงเช้าวันเสาร์ — ตอนนั้นกล่องอีเมลฝ่ายซัพพอร์ตมีข้อความโกรธ ๆ กว่า 200 ฉบับจากลูกค้าที่จ่ายเงินไม่สำเร็จ
เหตุการณ์แบบนี้ไม่ได้แปลกอะไร เกณฑ์มาตรฐานที่ถูกอ้างถึงอย่างกว้างขวาง ประเมินว่า downtime เฉลี่ยมีต้นทุนถึง 5,600 ดอลลาร์ต่อนาที ขณะที่ เหตุขัดข้องรุนแรงอาจพุ่งได้ถึงหลักล้านต่อชั่วโมง ตัวเลขจริงจะขึ้นอยู่กับทราฟฟิก อัตราแปลง มูลค่าออเดอร์ ขอบเขต SLA และต้นทุนการกู้ระบบ — แต่ภาพรวมชัดเจนว่า API ที่ไม่มีการมอนิเตอร์ไม่ใช่แค่เรื่องน่ารำคาญของทีมวิศวกร แต่มันคือความเสี่ยงทางธุรกิจ และเมื่อ องค์กรต่าง ๆ ใช้งาน API ของบุคคลที่สามเฉลี่ยถึง 131 ตัว แต่มีเพียง 16% ที่บอกว่าตัวเองรับมือความเสี่ยงจาก API บุคคลที่สามได้ดีมาก การมอนิเตอร์จึงไม่ใช่ของเสริมอีกต่อไป สิ่งที่ผมตั้งใจทำในคู่มือนี้คือสิ่งที่ยังไม่ค่อยเห็นที่อื่น: จัดกลุ่มเครื่องมือตาม use case ของคุณ ประเมินคุณภาพของ alert ไม่ใช่แค่ว่ามี alert หรือไม่ แสดงราคาจริงในปี 2026 และวัดว่าคุณเริ่มใช้งานได้เร็วแค่ไหน ไม่ใช่แค่ลิสต์โลโก้เรียงยาว ๆ อีกชุด
อีกเรื่องที่อยากย้ำ: ถ้างาน API ของคุณเกี่ยวข้องกับการเก็บข้อมูลจากเว็บ ป้อนให้ LLM สร้าง RAG monitoring หน้าเว็บคู่แข่ง หรือดึงข้อมูลราคา/สินค้าออกจากเว็บไซต์ ประเด็นเรื่อง "API tool" ไม่ควรหยุดแค่การมอนิเตอร์ uptime คุณยังต้องมีวิธีที่เชื่อถือได้ในการแปลงเว็บเพจรก ๆ ให้เป็นข้อมูลที่มีโครงสร้าง ซึ่งนั่นคือจุดที่ Thunderbit Open API เข้ามาอยู่ในคู่มือนี้: มันไม่ใช่เครื่องมือเช็ก uptime แต่เป็นหนึ่งในวิธีที่เร็วที่สุดในการแปลงเว็บไซต์ให้เป็น Markdown ที่สะอาดหรือ JSON ตาม schema ผ่าน API
API Monitoring คืออะไร และทำไมทีมของคุณควรใส่ใจ?
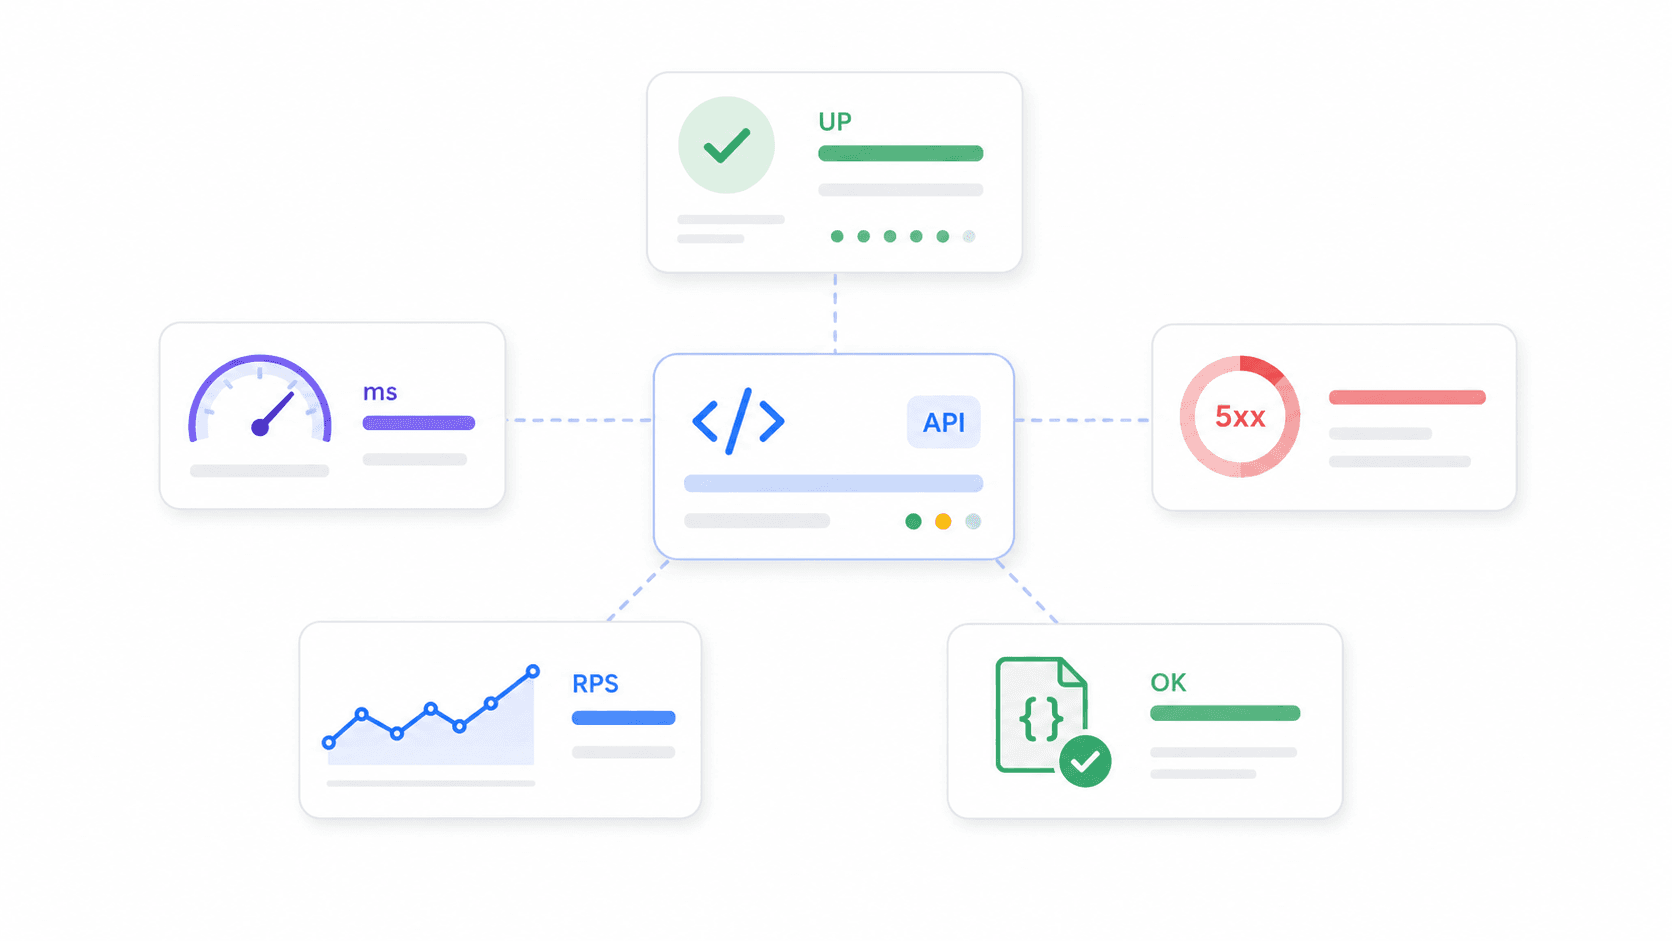
API monitoring คือการตรวจสอบ endpoint ของ API อย่างต่อเนื่องว่าใช้งานได้ไหม ตอบสนองเร็วแค่ไหน และส่งข้อมูลถูกต้องหรือเปล่า ไม่ใช่แค่ถามว่า "เซิร์ฟเวอร์ยังทำงานอยู่ไหม" แต่เครื่องมือที่ดีจะตรวจทั้ง HTTP status code, payload ของ response, latency, ใบรับรอง SSL, เวิร์กโฟลว์หลายขั้นตอน (เช่น login → search → checkout) และแม้แต่ความถูกต้องของ schema
มันต่างจากการมอนิเตอร์เว็บไซต์ทั่วไป ซึ่งดูแค่ว่าเพจโหลดขึ้นไหม และต่างจาก APM (Application Performance Monitoring) ซึ่งลงลึกไปที่ trace ระดับโค้ด การ query ฐานข้อมูล และ internals ของ runtime API monitoring อยู่ตรงรอยต่อ: มันทดสอบสิ่งที่ผู้ใช้ พาร์ตเนอร์ และอินทิเกรชันของคุณเจอจริงเมื่อเรียก endpoint
ยังมีหมวดที่เกี่ยวข้องและควรพูดถึงด้วย นั่นคือ web data APIs ซึ่งไม่ได้มอนิเตอร์ว่า API ของคุณเองปกติดีไหม แต่ช่วยให้ product หรือ workflow ของคุณเก็บข้อมูลเว็บภายนอกได้อย่างเสถียร ตัวอย่างเช่น Thunderbit Open API สามารถย่อยเว็บเพจให้เป็น Markdown ที่สะอาด ดึง field แบบมีโครงสร้างออกมาเป็น JSON และรันงานแบบ batch บนหลาย URL ได้ ถ้าโปรเจกต์ "API" ของคุณพึ่งพาข้อมูลจาก vendor หน้า product หน้า listing สาธารณะ หน้าเอกสาร หรือแหล่งข้อมูลสำหรับงานวิจัย API ดึงข้อมูลแบบนี้ก็อาจสำคัญต่อการปฏิบัติการพอ ๆ กับการเช็ก uptime
ทำไมคนที่ไม่ใช่วิศวกรควรสนใจ? เพราะ APIs คิดเป็น 71% ของทราฟฟิกเว็บแบบไดนามิก และ 62% ของผู้เชี่ยวชาญด้าน API บอกว่า API สร้างรายได้โดยตรง เมื่อ payment gateway, auth service หรือ shipping API ล่ม นั่นไม่ใช่ปัญหาโครงสร้างพื้นฐานแบบนามธรรม แต่มันคือรายได้ที่หายไป สัญญากับพาร์ตเนอร์ที่พัง เคสซัพพอร์ตที่พุ่ง และความเชื่อมั่นที่ลดลง Product manager ทีมขาย ทีม ops และ customer success ต่างก็ได้รับผลกระทบทั้งหมด
เมตริกสำคัญที่ควรจับตา:
- Uptime percentage: สัดส่วนเวลาที่ endpoint พร้อมใช้งาน
- Response time / latency: เวลาที่ endpoint ใช้ตอบกลับ (average, p95, p99)
- Error rate: สัดส่วนคำขอที่กลับ 5xx, timeout หรือ assertion failure
- Throughput: จำนวนคำขอต่อวินาที/ต่อนาที
- Correctness: API ส่งข้อมูลที่คาดไว้หรือไม่ ไม่ใช่แค่ตอบ 200 OK
เราประเมินเครื่องมือมอนิเตอร์ API ที่ดีที่สุดสำหรับปี 2026 อย่างไร
บทความแนว "เครื่องมือมอนิเตอร์ API ที่ดีที่สุด" ส่วนมากมักแค่เรียงชื่อ vendor กับฟีเจอร์ ผมอยากคัดเลือกอย่างตั้งใจมากกว่านั้น — ส่วนหนึ่งเพราะใช้เวลามากกับการอ่านฟอรัมนักพัฒนา และอีกส่วนเพราะทีม Thunderbit ช่วยผม ดึงข้อมูลราคาและฟีเจอร์จำนวนมาก จากเว็บไซต์ของแต่ละ vendor เพื่อทำตารางเปรียบเทียบจริงขึ้นมา (จะเล่าถึง workflow นี้อีกทีด้านล่าง)
สิ่งที่เราให้น้ำหนักมีดังนี้:
| เกณฑ์ | ทำไมถึงสำคัญ |
|---|---|
| ความง่ายในการติดตั้ง / เวลาไปถึง alert แรก | ทีมเล็กต้องการ coverage วันนี้ ไม่ใช่หลังจากเริ่มโปรเจกต์แพลตฟอร์มไปหลายสัปดาห์ |
| ความฉลาดของ alert และการลด noise | ถ้า alert ดังรัวจนรบกวน ทีมจะเริ่มเมิน และพลาดเหตุขัดข้องจริง |
| ความใจดีของฟรีแพลน | โปรเจกต์เสริมและสตาร์ทอัประยะแรกมักเริ่มจากของฟรี |
| ความโปร่งใสของราคา | บิล observability อาจบานปลายจาก hosts, seats, logs, synthetic runs และ data ingest |
| ความกว้างของอินทิเกรชัน | Alert ต้องไปลงในที่ที่ทีมใช้งานอยู่แล้ว เช่น Slack, PagerDuty ฯลฯ |
| ความสามารถในการสเกลและความลึกของข้อมูล | ทีมที่โตแล้วต้องมี traces, logs, APM, RBAC, SSO, retention |
| คุณภาพของ community และซัพพอร์ต | ทีมโอเพ่นซอร์สต้องการรอบการอัปเดตที่สม่ำเสมอ ส่วนองค์กรต้องการ SLA |
| ความสามารถในการดึงข้อมูลเว็บ | แอป AI, เวิร์กโฟลว์ RAG และเครื่องมือวิจัยตลาดมักต้องการข้อมูลภายนอกที่สะอาด ไม่ใช่แค่สถานะ uptime |
เรายังแยกคำแนะนำตาม use case ด้วย — นักพัฒนาคนเดียว สตาร์ทอัป อีคอมเมิร์ซ/SaaS องค์กร สายโอเพ่นซอร์ส ทีมผลิตภัณฑ์ API และทีมเว็บดาต้า/AI — เพื่อให้คุณข้ามไปยังบริบทของตัวเองได้เลย ไม่ต้องอ่านสรุปเครื่องมือ 14 ตัวแล้วเดาเอาเองว่าอันไหนใช่ แบบสำรวจปี 2025 ของ Grafana พบว่า 46% ของผู้ตอบแบบสอบถามให้ความสำคัญกับ interoperability และ 35% มองเรื่องการเปลี่ยนระบบในอนาคตได้ง่ายเป็นเกณฑ์สำคัญ ซึ่งยืนยันว่าประเด็นเหล่านี้ไม่ใช่แค่ของน่ามี
เครื่องมือมอนิเตอร์ API ที่ดีที่สุดแยกตาม use case: ตารางสรุปแบบเร็ว
นี่คือทางลัดของบทความนี้ หาแถวของคุณ แล้วค่อยเลื่อนไปอ่านรายละเอียดเครื่องมือด้านล่าง
| Use Case | เครื่องมือที่แนะนำ | จุดเด่นหลัก |
|---|---|---|
| ทีมเว็บดาต้า / AI app | Thunderbit Open API, Moesif, Apitally | แปลงเว็บไซต์เป็น Markdown สะอาดหรือ JSON โครงสร้างพร้อมใช้สำหรับ LLM, RAG, ราคา และงานวิจัย |
| นักพัฒนาคนเดียว / โปรเจกต์เสริม | UptimeRobot, Uptime Kuma, Gatus | ฟรีหรือโฮสต์เองได้ ตั้งค่าน้อย ใช้ได้เร็ว |
| สตาร์ทอัป (ทีม 5–15 คน) | Checkly, Better Stack, Postman | alert ฉลาด ตั้งค่าเร็ว ราคาเอื้อมถึง มี status page |
| อีคอมเมิร์ซ / SaaS | Datadog, New Relic, Moesif, Checkly | เมตริกทางธุรกิจ, APM/tracing, SDK ลึก, synthetic หลายขั้นตอน |
| องค์กร / multi-cloud | Datadog, New Relic, Splunk, Grafana Cloud | distributed tracing, compliance, hybrid, RBAC/SSO |
| สายโอเพ่นซอร์สล้วน ๆ | Prometheus + Grafana, Uptime Kuma, Gatus, Uptrace | ควบคุมได้เต็มที่, OTel native, ไม่ติด vendor |
| ทีมผลิตภัณฑ์ API | Moesif, Apitally, New Relic | usage ต่อผู้ใช้, เทรนด์ endpoint, anomaly alert |
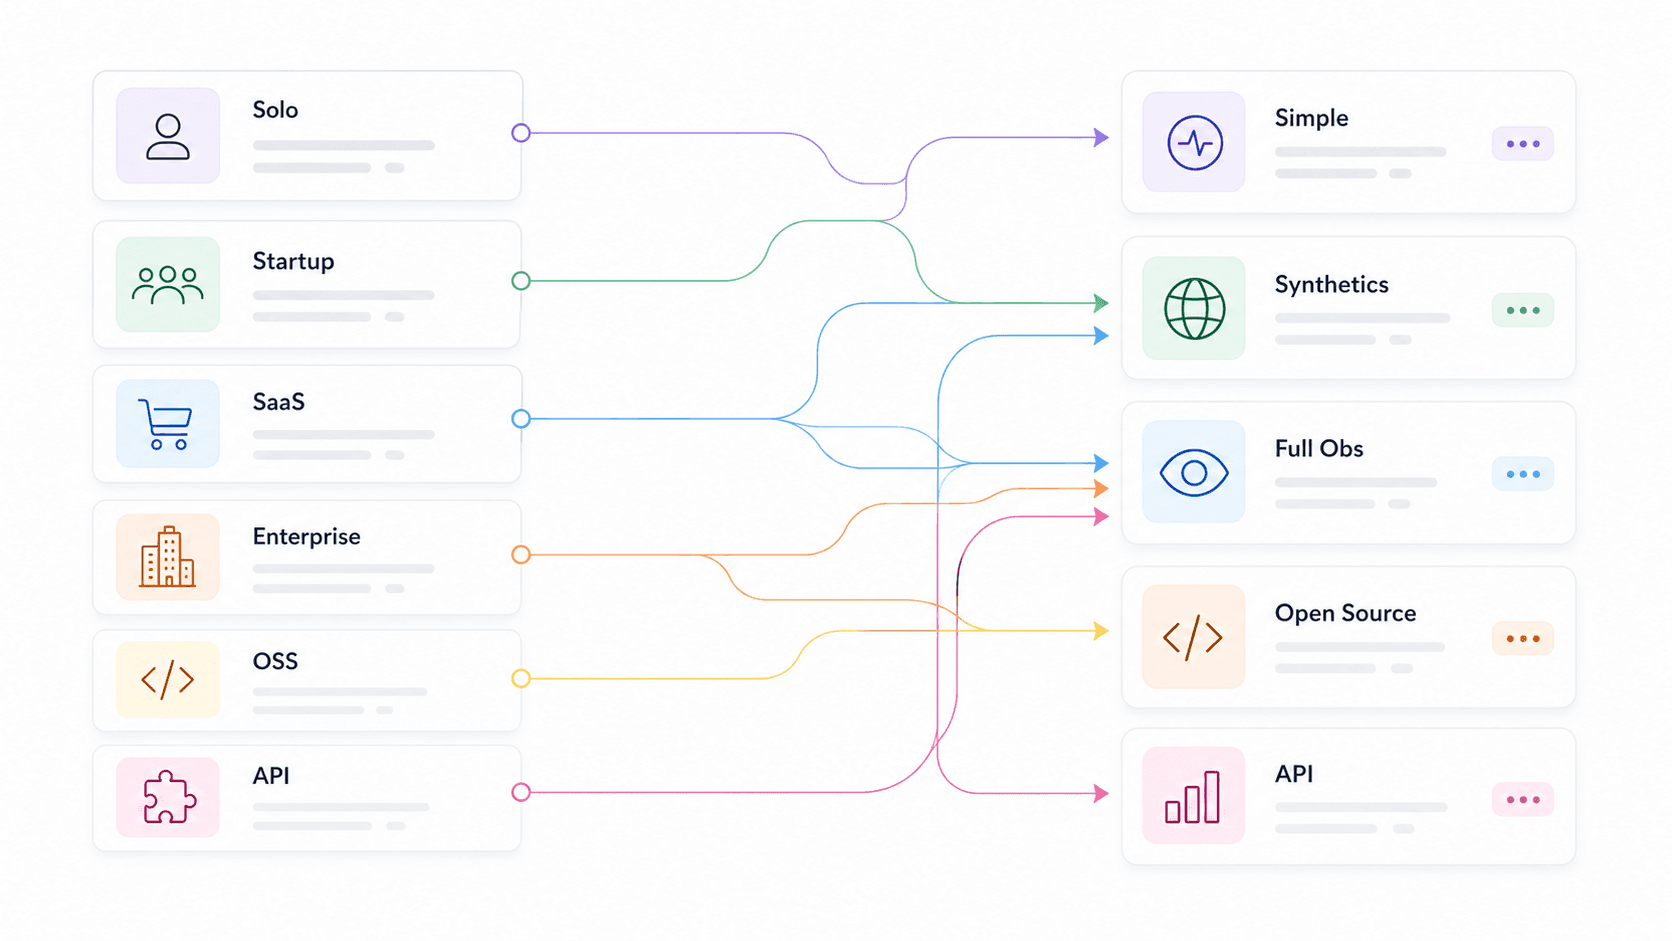
แพตเทิร์นที่เห็นชัดที่สุดคือ: เครื่องมือที่ตั้งค่าได้เร็วที่สุดมักให้ analytics แบบบางเบา ขณะที่แพลตฟอร์มที่ลงลึกที่สุดมักต้องตั้งค่ามากกว่าและต้องคุมต้นทุนให้ดี นั่นไม่ใช่ข้อเสีย แต่มันคือ trade-off ที่ควรรู้ Thunderbit อยู่ในเลนที่ต่างออกไปเล็กน้อย: มันเร็วที่สุดเมื่อโจทย์คือการแปลงเว็บเพจเป็นข้อมูลที่พร้อมใช้ผ่าน API ไม่ใช่การเตือนวิศวกรเมื่อระบบล่ม
Thunderbit Open API: เหมาะที่สุดสำหรับแปลงเว็บไซต์เป็นข้อมูล API ที่มีโครงสร้าง
เริ่มสร้างงานด้วย Thunderbit Open API ย่อยเว็บเพจเป็น Markdown ดึง JSON โครงสร้าง และประมวลผล URL จำนวนมากโดยไม่ต้องดูแลโครงสร้าง scraping เอง Get Started Free
Thunderbit Open API คือ API ที่ผมจะเลือกเป็นอันดับแรกสำหรับทีมที่เวิร์กโฟลว์ "monitoring" หรือ research พึ่งพาข้อมูลเว็บภายนอก มันไม่ใช่เครื่องมือมอนิเตอร์ uptime แบบดั้งเดิมอย่าง Checkly หรือ UptimeRobot แต่เป็นตัวแปลงเว็บเพจใด ๆ ให้กลายเป็นข้อมูลที่สะอาดและมีโครงสร้าง ซึ่งแอป เอเจนต์ แดชบอร์ด และ LLM pipeline ของคุณเอาไปใช้ได้จริง
API นี้มี workflow หลัก 3 แบบ Distill แปลงหน้าเว็บเป็น Markdown ที่สะอาดและพร้อมสำหรับ LLM Extract รับ schema แล้วคืนค่าฟิลด์ที่มีโครงสร้าง เช่น ชื่อสินค้า ราคา สถานะสินค้า ขนาดบริษัท รอบระดมทุน หรือคะแนนรีวิว Batch ให้คุณประมวลผล URL ได้สูงสุด 100 รายการแบบอะซิงโครนัสพร้อม webhook ซึ่งมีประโยชน์มากเมื่อคุณกำลังเฝ้าดูหน้าราคา แคตตาล็อกคู่แข่ง เอกสาร vendor แหล่งข่าว หรือชุดข้อมูลวิจัยขนาดใหญ่
เหตุผลที่มันควรอยู่ในคู่มือเครื่องมือ API คือทีมมักประเมินต่ำไปว่าคำว่า "ก็แค่ scrape หน้าเว็บนี้" ต้องใช้โครงสร้างพื้นฐานมากแค่ไหน เว็บไซต์ที่พึ่ง JavaScript หนัก ๆ ต้อง render บางหน้าอาจต้อง geo-routing HTML ต้องตัด nav bar, โฆษณา, modal และ boilerplate ออกก่อนจึงจะมีประโยชน์กับ LLM selector พังเมื่อเลย์เอาต์เปลี่ยน proxy rotation, anti-bot, retry, queue และการ polling ผลลัพธ์สามารถเปลี่ยนเวิร์กโฟลว์ข้อมูลเล็ก ๆ ให้กลายเป็นงานดูแลระยะยาวได้ Thunderbit รับภาระส่วนใหญ่ตรงนี้ไปหลัง API เดียว
เหมาะสำหรับ: คนสร้าง AI app, ทีม RAG, e-commerce ops, sales ops, growth team, market researcher และนักพัฒนาที่ต้องการข้อมูลเว็บไซต์ผ่าน API โดยไม่ต้องสร้างและเฝ้าระบบ scraping เอง
ราคา: ฟรี: 600 API units แบบครั้งเดียว รวมได้ถึง 600 หน้า Distill หรือ 30 หน้า Extract พร้อมคำขอพร้อมกัน 2 รายการ แผน Starter ระบุไว้ที่ 16 ดอลลาร์/เดือนแบบรายปี สำหรับ 60,000 API units/ปี และคำขอพร้อมกัน 30 รายการ ส่วน Pro ระบุไว้ที่ 40 ดอลลาร์/เดือนแบบรายปี สำหรับ 600,000 API units/ปี และคำขอพร้อมกัน 50 รายการ
ความเร็วในการเริ่มใช้งาน: ประมาณ 5–15 นาทีเพื่อรับ API key และยิงคำขอ Distill หรือ Extract แรกผ่าน cURL, SDK หรือ Thunderbit CLI
ข้อจำกัด: Thunderbit จะไม่มาแทน Datadog, New Relic, Better Stack หรือ Checkly ในเรื่องการเช็ก uptime, incident escalation, traces, logs หรือ on-call routing ควรมองมันเป็น API ที่ใช้เก็บและจัดโครงสร้างข้อมูลเว็บ — รวมถึงราคาของ vendor, docs, หน้า competitor, รายการสินค้า หรือ public dataset — ไม่ใช่ระบบที่โทรปลุกวิศวกร on-call ของคุณ
Datadog: ดีที่สุดสำหรับการมองเห็นระบบแบบเต็มสแตก
Datadog คือเครื่องมือที่ผมยังเห็นอยู่บ่อยมากในสแตกขององค์กรและ SaaS ระดับ mid-market และมีเหตุผลรองรับ มันไม่ใช่แค่ API monitoring — แต่เป็นแพลตฟอร์ม observability แบบเต็มรูปแบบที่เชื่อม synthetic API test เข้ากับ distributed trace, log, metric ของ infra และ real user monitoring ไว้ในหน้าจอเดียว
สำหรับ API monitoring โดยเฉพาะ Datadog รองรับ HTTP, SSL, DNS, WebSocket, TCP, UDP, ICMP, gRPC และ multi-step API tests anomaly detection monitors ของมันเรียนรู้แพตเทิร์นที่คาดไว้ แล้วแจ้งเตือนเมื่อค่าเบี่ยงเบน ไม่ใช่แค่ตั้ง threshold คงที่ ซึ่งยกระดับจาก "แจ้งเตือนเมื่อ latency > 500ms" ไปมาก นอกจากนี้ยังมี forecast monitor ที่คาดการณ์ล่วงหน้าว่า metric จะทะลุ threshold เมื่อไร และ composite monitor ที่รวมหลายเงื่อนไขเข้าด้วยกัน
เหมาะสำหรับ: ทีมอีคอมเมิร์ซ SaaS และองค์กรที่ต้องการมุมมองเดียวครอบคลุม API, infrastructure, logs และ traces
ราคา: รายละเอียด free tier แตกต่างตาม product Infrastructure Pro เริ่มที่ 15 ดอลลาร์/host/เดือน และ API synthetic tests ราคา 5 ดอลลาร์ต่อ 10,000 ครั้ง มี integration มากกว่า 800 รายการ
ความเร็วในการเริ่มใช้งาน: ประมาณ 15–30 นาทีสำหรับติดตั้ง agent และสร้าง synthetic test พื้นฐาน
ข้อจำกัด: อาจแพงขึ้นมากเมื่อสเกลใหญ่ — เรื่อง "บิลช็อก" เป็นประเด็นที่เจอซ้ำบ่อยใน Hacker News และ Reddit จำนวน SKU ที่มีมาก (hosts, logs, custom metrics, synthetics, users) หมายความว่าคุณต้องมีคนคอยดูบิล ไม่ใช่แค่ดูแดชบอร์ด การเรียนรู้ทั้งแพลตฟอร์มก็ไม่เบา
Checkly: ดีที่สุดสำหรับ synthetic check ที่ออกแบบมาเพื่อ dev โดยเฉพาะ
Checkly คือเครื่องมือที่ผมจะส่งให้ทีมวิศวกรของสตาร์ทอัปที่อยากให้ API check อยู่ใกล้โค้ด แนวคิดหลักของมันคือ "monitoring as code" — นิยาม API และ browser check ด้วยโปรแกรม รันจากจุดทั่วโลก เชื่อมกับ CI/CD และจัดการทุกอย่างผ่าน Git
มุม alert ของมันทำได้ดีมาก Checkly มี retry logic ที่อธิบายชัดว่าเป็น "แนวป้องกันด่านแรก" จาก false positive — คุณตั้ง retry แบบ fixed, linear หรือ exponential, retry จาก location เดิมหรือคนละ location และกำหนดเวลาสูงสุดก่อน alert จะถูกส่งได้ มันยังแยกสถานะ degraded, failed และ recovered ออกจากกัน ช่วยลดการแจ้งเตือนรัว ๆ
เหมาะสำหรับ: สตาร์ทอัปและทีม dev ที่ต้องการ API check แบบโปรแกรมได้, browser check ที่ใช้ Playwright, เชื่อม CI/CD และเริ่มได้ไว
ราคา: ข้อมูลสาธารณะล่าสุดระบุว่ามีฟรีแพลนพร้อม 10 uptime monitors, 1,000 browser checks และ 10,000 API checks Starter อยู่ราว 24 ดอลลาร์/เดือนแบบรายปี — ควรเช็กหน้าราคาอย่างเป็นทางการ ก่อนตัดสินใจ
ความเร็วในการเริ่มใช้งาน: ประมาณ 10–20 นาทีสำหรับ API check แรกและช่องทาง alert แรก
ข้อจำกัด: โฟกัสอยู่ที่ synthetic checks เป็นหลัก ไม่ใช่ตัวแทนของ APM, log analytics หรือ distributed tracing แบบลึก ถ้าคุณต้องการเชื่อมโยงความล้มเหลวของ API กับคอขวดฐานข้อมูล จะต้องมีเครื่องมืออื่นประกบด้วย
UptimeRobot: ดีที่สุดสำหรับการติดตาม uptime แบบง่ายและคุ้มราคา
UptimeRobot คือ Honda Civic ของการมอนิเตอร์ API มันทำงานอย่างใดอย่างหนึ่งได้ดี: คุณสร้าง HTTP, keyword, ping, port, SSL หรือ heartbeat monitor เลือก interval แล้วรับ alert เมื่อมันล้ม แค่นั้นเลย
เหมาะสำหรับ: นักพัฒนาคนเดียว ทีมเล็ก เอเจนซี หรือใครก็ตามที่ต้องการการติดตาม uptime และ latency แบบพื้นฐานโดยไม่ซับซ้อน
ราคา: ฟรี: 50 monitors, interval 5 นาที แพลน Solo แบบชำระรายปีราว 7 ดอลลาร์/เดือน ฟรีไม่ต้องใช้บัตรเครดิต ความเร็วในการเริ่มใช้งาน: ประมาณ 2–5 นาที — เร็วที่สุดในลิสต์นี้
ข้อจำกัด: ความฉลาดของ alert ค่อนข้างจำกัด เป็นแค่ threshold เบื้องต้น ไม่มี anomaly detection, ไม่มี distributed tracing, ไม่มี analytics เชิงลึก ถ้าคุณต้องการรู้ว่า endpoint ช้า เพราะอะไร ไม่ใช่แค่ว่าช้า UptimeRobot จะตอบโจทย์นั้นไม่ได้
Uptime Kuma: เครื่องมือมอนิเตอร์ API แบบ self-host ฟรีที่ดีที่สุด
Uptime Kuma เป็นขวัญใจสาย self-host และตัวเลขบน GitHub ก็ยืนยัน 86,637 stars, 7,831 forks, 1,060 contributors และเวอร์ชัน 2.3.2 ณ เดือนพฤษภาคม 2026 มันใช้สัญญาอนุญาต MIT รองรับ HTTP(s), keyword, JSON query, WebSocket, TCP, ping, DNS, push, Docker, status page หลายหน้า และ notification service กว่า 90 แบบ
เหมาะสำหรับ: นักพัฒนาคนเดียวและทีมที่ต้องการควบคุมได้เต็มที่ ความเป็นส่วนตัว และไม่มีค่า SaaS รายเดือน — ถ้าคุณมีเซิร์ฟเวอร์
ราคา: ฟรี ต้นทุนจริงคือ VM/container, backup, การอัปเดต และการดูแลให้ monitor เองยังออนไลน์อยู่ ความเร็วในการเริ่มใช้งาน: ประมาณ 5–15 นาทีด้วย Docker สำหรับเช็กพื้นฐาน และ 15–30 นาทีถ้าจะปรับ notification กับ status page ให้เรียบร้อย
ข้อจำกัด: คุณต้องดูแลเอง และจุดที่ต้องระวังคือถ้าคุณโฮสต์ Uptime Kuma บนโครงสร้างพื้นฐานเดียวกับสิ่งที่มันเฝ้าอยู่ cloud หรือ DNS outage จะล้มทั้งแอปและมอนิเตอร์ไปพร้อมกัน ควรโฮสต์แยกภายนอกหรือใช้คู่กับ SaaS check อีกตัว
Better Stack: ดีที่สุดสำหรับการตอบสนองเหตุขัดข้องอย่างรวดเร็ว
Better Stack (ผู้ใช้จำนวนมากยังเรียก Better Uptime อยู่) รวมการมอนิเตอร์ uptime, incident management, on-call scheduling, escalation policy และ status page ไว้ในแพลตฟอร์มเดียว มันเด่นไม่ใช่ในฐานะเครื่องมือ analytics แต่เป็นเครื่องมือ workflow ของเหตุขัดข้องที่ครอบด้วยการมอนิเตอร์
Escalation policy กำหนดได้ว่าใครต้องได้รับแจ้งก่อน หลังจากกี่นาที และตามลำดับอย่างไรจนกว่าจะมีคนรับทราบ Metadata-based routing ช่วยส่ง incident ตาม severity หรือเจ้าของงาน และเชื่อมต่อ Slack, Teams, webhook และ Zapier ได้
เหมาะสำหรับ: สตาร์ทอัปและทีมขนาดกลางที่ต้องการ monitoring + incident response + status page โดยไม่ต้องต่อเครื่องมือสามตัวเข้าด้วยกันเอง
ราคา: ฟรีแพลน: 10 monitors/heartbeats, 1 status page แพ็ก Team ราว 29 ดอลลาร์/เดือนแบบรายปี ความเร็วในการเริ่มใช้งาน: ประมาณ 5–10 นาทีผ่าน GUI wizard
ข้อจำกัด: ความลึกด้าน analytics ของ payload API, distributed tracing หรือ business KPI ยังน้อยกว่า Datadog, New Relic หรือ Moesif
Prometheus + Grafana: สแตกโอเพ่นซอร์สสำหรับมอนิเตอร์ API ที่ดีที่สุด
นี่คือชุดโอเพ่นซอร์สมาตรฐานของอุตสาหกรรม Prometheus ใช้ scrape และจัดเก็บ time-series metric Grafana (73,705 GitHub stars, 3,010 contributors) ใช้ทำแดชบอร์ดและ alerting Alertmanager ดูแล routing, grouping, deduplication, silencing และ inhibition ส่วนการเช็ก endpoint ของ API ทีมต่าง ๆ มักเพิ่ม Blackbox Exporter เพื่อ probe HTTP, HTTPS, DNS, TCP, ICMP และ gRPC
เหมาะสำหรับ: สายโอเพ่นซอร์สล้วน ทีม Kubernetes/SRE และองค์กรที่ใช้งาน Prometheus metrics เป็นมาตรฐานอยู่แล้ว
ราคา: ฟรีเมื่อโฮสต์เอง Grafana Cloud มีฟรีแพลน (100k API test executions/เดือน) และแพ็กเสียเงินตามการใช้งาน
ความเร็วในการเริ่มใช้งาน: 1–4 ชั่วโมงสำหรับ Blackbox + Prometheus + Grafana + Alertmanager แบบพื้นฐาน และอาจต้องใช้หลายวันสำหรับ HA ระดับโปรดักชันและการจูน alert
ข้อจำกัด: PromQL, YAML, relabeling, การออกแบบแดชบอร์ด, retention, storage, HA และการจูน alert คือภาระงานจริงในเชิงปฏิบัติ การแลกเปลี่ยนที่เกิดซ้ำคือ "UI น้อยลง, YAML มากขึ้น" นี่คือสแตกสำหรับทีมที่คิดเป็น metric อยู่แล้วและต้องการ control plane เดียว ไม่ใช่ทีมที่อยากให้ monitoring พร้อมใช้ก่อนเที่ยง
New Relic: ดีที่สุดสำหรับประสิทธิภาพแอป SaaS
New Relic รวม APM, monitoring ของ infrastructure, logs, distributed tracing, synthetic monitoring, alerts, dashboards และการวิเคราะห์เหตุขัดข้องด้วย AI เข้าไว้ด้วยกัน ฟรีแพลนของมัน — 100 GB/เดือนสำหรับ data ingest และ full platform user 1 คน — ใจกว้างพอจริงสำหรับทีมเล็ก
จุดที่ New Relic เด่นในเรื่อง alert fatigue คือความฉลาดของ alert ฟีเจอร์ incident intelligence มี event correlation, anomaly detection, predictive alerts, root-cause analysis และ flapping suppression New Relic เคยยกตัวอย่างว่า ประสิทธิภาพ flapping 97.2% หมายความว่ามีเพียง 28 เหตุการณ์ที่ถูกยกระดับจาก 1,000 เหตุการณ์ flapping — ตัวเลขลด noise ที่จับต้องได้ชัดเจน
เหมาะสำหรับ: ทีม SaaS และแพลตฟอร์มอีคอมเมิร์ซที่อยากให้ API monitoring เชื่อมกับ traces ระดับแอป, errors, throughput และผลกระทบต่อผู้ใช้แบบแน่น ๆ
ราคา: ฟรี 100 GB/เดือน ผู้ใช้ full 1 คน แพ็กเสียเงินคิดตามจำนวนผู้ใช้และปริมาณข้อมูล
ความเร็วในการเริ่มใช้งาน: ประมาณ 15–30 นาทีสำหรับติดตั้ง agent และทำตามขั้นตอน guided setup
ข้อจำกัด: ราคามีความซับซ้อนเมื่อสเกลใหญ่ การตั้งค่า alert ก็มีเส้นโค้งการเรียนรู้ แพลตฟอร์มทรงพลังแต่ไม่ได้เข้าใจได้ทันที
Moesif: ดีที่สุดสำหรับ API analytics และเมตริกทางธุรกิจ
Moesif ไม่ใช่ uptime monitor แบบดั้งเดิม แต่มันคือ API analytics และ product intelligence: ช่วยให้เข้าใจการใช้งาน API แยกตามลูกค้า endpoint cohort บริษัท ภูมิภาค SDK แพ็กเกจ และพฤติกรรม ถ้าคำถามของคุณคือ "ลูกค้าคนไหนได้รับผลกระทบ" มากกว่า "endpoint ล่มไหม" Moesif ถูกสร้างมาสำหรับโจทย์นี้
มันรองรับ static threshold alerts และ dynamic anomaly alerts สำหรับ metric ของ API เช่น ทราฟฟิกที่พุ่งขึ้น/ตกลง latency และการเปลี่ยนแปลงพฤติกรรม dynamic alerts ต้องใช้ข้อมูลพฤติกรรมของ API สักสองสามวันเพื่อสร้างโมเดล แต่เมื่อเรียนรู้แล้ว มันจะจับการเปลี่ยนแปลงที่ rule แบบคงที่มักพลาด
เหมาะสำหรับ: ทีมผลิตภัณฑ์ API บริษัท SaaS และแพลตฟอร์มอีคอมเมิร์ซที่ต้องเชื่อม performance ของ API กับรายได้ engagement และ retention
ราคา: มีฟรี/ทดลองใช้ แผนเสียเงินคิดตามปริมาณ API event ตัวเลขแบบ self-service ที่แน่นอนผมดึงไม่ครบจากการเก็บข้อมูลครั้งนี้ — ควรเช็กหน้าปัจจุบันอีกที
ความเร็วในการเริ่มใช้งาน: ประมาณ 20–45 นาที (การเชื่อม SDK/proxy/gateway ลึกกว่าการ ping ภายนอก)
ข้อจำกัด: เน้น analytics มากกว่า uptime monitoring แบบดั้งเดิม คุณน่าจะยังต้องใช้ Checkly, UptimeRobot หรือ Datadog synthetics ประกบสำหรับเช็กความพร้อมใช้งานจากภายนอก
Splunk: ดีที่สุดสำหรับการวิเคราะห์ log ระดับองค์กรและ compliance
Splunk คือเครื่องมือที่คุณหยิบมาใช้เมื่อการรวม log, search, correlation, ความสามารถในการตรวจสอบตามข้อกำหนด และการรองรับ hybrid/multi-cloud เป็นสิ่งที่ต่อรองไม่ได้ Splunk Observability Cloud ครอบคลุม infrastructure, APM, synthetics, real user monitoring, logs และ incident response ITSI/Event Analytics สามารถรวมเหตุการณ์สำคัญเป็น episode และลด noise ข้ามไซโลของการมอนิเตอร์ได้
งานวิจัย observability ของ Splunk เองในปี 2025 ก็น่าคิด: 73% ของผู้ตอบแบบสำรวจสาย ITOps/engineering ระบุว่า outage เกิดจากการเพิกเฉยหรือ suppression alert 59% บอกว่าจัดการเครื่องมือที่กระจัดกระจายเยอะเกินไปลำบาก และ 52% มีปัญหากับ false alert
เหมาะสำหรับ: ทีมองค์กรและ multi-cloud ที่มีข้อกำหนดเข้มงวดเรื่อง compliance, security, audit และการค้นหา log
ราคา: คิดตามการใช้งานและต้องคุยกับฝ่ายขาย ไม่มีฟรีแพลนระดับโปรดักชันแบบง่าย ๆ
ความเร็วในการเริ่มใช้งาน: บนคลาวด์อาจเริ่มได้เร็ว แต่การ deploy ระดับองค์กรอาจใช้ตั้งแต่หลายวันถึงหลายสัปดาห์
ข้อจำกัด: แพงเมื่อสเกลใหญ่ ตั้งค่าซับซ้อน และเกินความจำเป็นสำหรับนักพัฒนาคนเดียวหรือสตาร์ทอัปเล็ก ๆ
Postman: ดีที่สุดสำหรับทีมที่ทดสอบ API อยู่แล้ว
Postman เป็นแพลตฟอร์มหลักสำหรับการพัฒนาและทดสอบ API แต่ ผลิตภัณฑ์ monitoring ของมันช่วยให้ทีมตั้งเวลา collection ของ Postman และรันจาก cloud location ได้ จุดแข็งที่สุดคือการ reuse: ถ้า QA หรือทีม dev ของคุณมี collection พร้อม assertion อยู่แล้ว การแปลงสิ่งนั้นเป็น monitor เป็นขั้นตอนถัดไปที่ธรรมชาติสุด
เหมาะสำหรับ: ทีม dev และ QA ที่ใช้ Postman collection อยู่แล้ว และอยากได้ scheduled check โดยไม่ต้องซื้อ synthetic tool แยกอีกตัว
ราคา: มีฟรีแพลน ค่า overage ของ monitoring ที่ 0.75 ดอลลาร์ต่อ 1,000 calls และ add-on 50,000 calls ราคา 20 ดอลลาร์/เดือน ตรวจสอบ หน้าราคาปัจจุบัน อีกที เพราะแพ็กเกจของ Postman เปลี่ยนบ่อย
ความเร็วในการเริ่มใช้งาน: ประมาณ 10 นาทีถ้ามี collection อยู่แล้ว
ข้อจำกัด: ความสามารถด้าน monitoring เบากว่าเครื่องมือเฉพาะทางอย่าง Checkly, Datadog หรือ New Relic ตัวเลือก alert ก็ยังพื้นฐาน
เครื่องมือมอนิเตอร์ API อื่น ๆ ที่น่าดู
Gatus: แดชบอร์ดตรวจสุขภาพแบบเบา ๆ โฮสต์เองได้ และตั้งค่าผ่าน config ได้ มี 10,906 GitHub stars รองรับ HTTP, ICMP, TCP, DNS, metric ที่เป็นมิตรกับ Prometheus และ uptime badge เหมาะมากสำหรับนักพัฒนาคนเดียวที่อยากได้อะไรเรียบง่ายกว่า Prometheus แต่ชอบ YAML/config-as-code มากกว่าหน้า UI ของ Uptime Kuma
Apitally: เครื่องมือรุ่นใหม่ที่โฟกัส API traffic analytics และการติดตามคุณภาพสำหรับสตาร์ทอัป เคลมว่า ตั้งค่าได้ในไม่ถึง 5 นาที พร้อม custom alert บน 14 metric เหมาะสำหรับ API analytics เบา ๆ โดยไม่ต้องรับภาระแพลตฟอร์ม observability เต็มตัว
Sematext: มอนิเตอร์แบบ full-stack มี logs, synthetics และการมองเห็น infrastructure synthetics ราว 2 ดอลลาร์ต่อ HTTP monitor, 7 ดอลลาร์ต่อ browser monitor, ขั้นต่ำ 5 ดอลลาร์/เดือน เป็นทางเลือกที่ถูกกว่า Datadog สำหรับทีม mid-market
Uptrace: backend สำหรับ APM, tracing, metrics และ logs ที่ native กับ OpenTelemetry มี 4,198 GitHub stars ไม่ใช่ uptime checker แบบล้วน ๆ แต่เหมาะมากสำหรับทีมที่มาตรฐาน OTel และอยากได้ tracing backend แบบเป็นมิตรกับโอเพ่นซอร์ส
สร้างเองหรือซื้อใช้: ควรทำ API monitoring เองไหม?
"ผมแค่เขียนสคริปต์ ping endpoint เองเลยไม่ได้เหรอ หรือควรใช้เครื่องมือเฉพาะทาง?"
คำถามนี้เจอบ่อยมากในฟอรัมนักพัฒนา ผมอ่านกระทู้ Reddit มามากพอที่จะเห็นแพตเทิร์นชัดเจน: ทีมเริ่มจาก curl + cron มันใช้ได้ดีช่วงหนึ่ง แล้วค่อยย้ายไปใช้เครื่องมือจริงเมื่อเริ่มต้องการแดชบอร์ด ข้อมูลย้อนหลัง การเช็กหลายภูมิภาค การ routing alert ที่เชื่อถือได้ หรือความเห็นข้ามทีม
ตารางตัดสินใจแบบตรงไปตรงมา:
| ปัจจัย | สคริปต์เขียนเอง | เครื่องมือเฉพาะทาง |
|---|---|---|
| เวลาเริ่มต้น | 1–4 ชั่วโมง (พื้นฐาน); หลายวัน (ให้แข็งแรงจริง) | 5–30 นาที |
| การดูแลรักษา | ต้องดูแลไปตลอด | ผู้ให้บริการดูแลอัปเดตให้ |
| คุณภาพของ alert | พื้นฐาน (ขึ้น/ลง) | ฉลาดกว่า (เทรนด์ latency, anomaly, retry) |
| ต้นทุน | ฟรี (คิดเป็นเวลาของคุณ) | 0–500+ ดอลลาร์/เดือน |
| แดชบอร์ด | ต้องสร้างเองทั้งหมด | มีให้พร้อม ปรับแต่งได้ |
| เหมาะเมื่อ… | มี endpoint ≤3 ตัว, ทีมเน้น dev, งานอดิเรก | มี endpoint 5+ ตัว, ทีม ops/product, รายได้มีความเสี่ยง |
บทเรียนสำคัญจากฟอรั่มคือ: คนที่สร้างเองมักเสียดายภายหลังเมื่อเริ่มต้องใช้แดชบอร์ด ข้อมูลย้อนหลัง หรือการมองเห็นข้ามทีม และยังมีปัญหาเชิงเมตาอีกชั้น — "คุณต้องมอนิเตอร์ตัวมอนิเตอร์เอง" ทั้ง monitor แบบ self-host, ฐานข้อมูล, backup, เส้นทาง network และผู้ให้บริการ alert ต้องเชื่อถือได้ด้วย
สร้างเองถ้าคุณมี 2 endpoint และชอบปรับแต่งนู่นนี่ ซื้อใช้ถ้าคุณมี product ที่ต้องส่งมอบ
ตรรกะเดียวกันนี้ใช้กับการดึงข้อมูลเว็บ คุณ สามารถ เขียน scraper เอง รัน headless browser หมุน proxy ดูแล selector ทำความสะอาด HTML และสร้าง queue เองได้ แต่ถ้างานคือการป้อนข้อมูลเว็บเข้า product API, AI agent หรือ workflow งานวิจัยอย่างเชื่อถือได้ การใช้ Thunderbit Open API มักเร็วกว่าไปสร้างโครงสร้าง scraping เอง
Alert Fatigue: ทำไมคุณภาพของ alert สำคัญกว่าปริมาณ
นี่อาจเป็นเกณฑ์ที่ถูกมองข้ามมากที่สุดเวลาเลือกเครื่องมือมอนิเตอร์ API alert fatigue เกิดขึ้นเมื่อทีมได้รับ alert ที่ดังรัว ซ้ำซ้อน หรือเอาไปทำอะไรไม่ได้มากเกินไป จนเริ่มเมินทุกอย่าง — แล้วพลาดเหตุขัดข้องจริงไป
ตัวเลขน่าตกใจมาก รายงานปี 2025 ของ BigPanda พบว่าองค์กรระดับกลางโดยเฉลี่ยสร้าง 2,350 alert ต่อวัน และ 803,406 alert ต่อปี actionability ของ incident ในค่ากลางมีเพียง 18% — หมายความว่า alert ที่นำไปสู่ incident จริงและทำอะไรได้มีไม่ถึงหนึ่งในห้า แบบสำรวจของ NeuBird ปี 2026 พบว่า 77% ของทีม on-call ได้ alert อย่างน้อยวันละ 10 ครั้ง และ 80% บอกว่าครึ่งหนึ่งหรือน้อยกว่านั้นเป็น alert ที่นำไปใช้ได้จริง
เครื่องมือที่ดีที่สุดคือเครื่องมือที่ทีมของคุณเชื่อถือ alert ของมันจริง ๆ ตารางเปรียบเทียบว่าแต่ละตัวจัดการ alert intelligence อย่างไร:
| เครื่องมือ | ประเภท Alert | วิธีลด noise | ช่องทาง Alert |
|---|---|---|---|
| Datadog | ML anomaly, forecast, composite | แถบ anomaly ตามประวัติ, dynamic baseline, Watchdog AI | Slack, PagerDuty, Opsgenie, Teams, กว่า 20 ช่องทาง |
| Checkly | Threshold + degradation-based | retry ก่อนส่ง alert, retry location เดิม/ต่าง location | Slack, PagerDuty, Opsgenie, Teams, incident.io |
| New Relic | AI issue grouping, anomaly, predictive | event correlation, flapping suppression, root-cause context | Slack, PagerDuty, Teams, webhooks |
| Moesif | Behavioral anomaly | โมเดลแบบ dynamic หลังเก็บพฤติกรรมหลายวัน | Slack, PagerDuty, email, SMS |
| Better Stack | Uptime/incident/on-call | escalation policy, routing ตาม owner, delay | Slack, Teams, webhooks, Zapier |
| Prometheus + Alertmanager | Rule alerts จาก PromQL | grouping, deduplication, silencing, inhibition | Email, PagerDuty, Opsgenie, webhooks |
| Splunk | Events, episodes, service health | ITSI Event Analytics, grouping เป็น episode, ticketing | Splunk On-Call, ServiceNow, webhooks |
| Thunderbit Open API | ไม่ใช่แพลตฟอร์ม alerting | ใช้ร่วมกับ scheduler, workflow tool หรือ monitoring stack ของคุณเอง | webhook สำหรับ batch jobs; ส่วน alert จัดการภายนอก |
คำแนะนำเชิงปฏิบัติ: เริ่มจาก alert ที่น้อยกว่าแต่มั่นใจกว่า ใช้ retry-before-firing, ยืนยันจากหลายภูมิภาค, SLO burn-rate alert, deduplication และ routing ตามเจ้าของงาน แจ้งเตือนเมื่อกระทบผู้ใช้หรือกระทบ flow สำคัญทางธุรกิจ เช่น checkout ล่ม auth ล้ม หรือ payment 5xx ไม่ใช่ symptom เล็ก ๆ ภายในระบบทุกอย่าง
ฟรีแพลนและราคาในปี 2026: คุณต้องจ่ายจริงเท่าไร
หน้าราคามีการเปลี่ยน ฟรีแพลนก็เปลี่ยน ต้นทุนแฝง (hosts, seats, logs, synthetic runs, data ingest) ก็ทำให้แปลกใจได้ นี่คือส่วนที่ผมอยากให้มีในทุกบทความแนว "เครื่องมือที่ดีที่สุด" สรุปภาพปี 2026:
| เครื่องมือ | ฟรีแพลน | เริ่มเสียเงินที่ | ต้องใช้บัตรเครดิตไหม | กรณีใช้ฟรีที่ดีที่สุด |
|---|---|---|---|---|
| Thunderbit Open API | 600 API units แบบครั้งเดียว | ประมาณ 16 ดอลลาร์/เดือนแบบรายปี | ไม่ต้อง | ดึงข้อมูลเว็บสำหรับ LLM, RAG, ราคา และงานวิจัย |
| Uptime Kuma | ไม่จำกัด (โฮสต์เอง) | — | ไม่ต้อง | มอนิเตอร์เต็มรูปแบบบนเซิร์ฟเวอร์ของคุณเอง |
| UptimeRobot | 50 monitors, interval 5 นาที | ประมาณ 7 ดอลลาร์/เดือน | ไม่ต้อง | เช็ก uptime แบบพื้นฐาน |
| Better Stack | 10 monitors, 1 status page | ประมาณ 29 ดอลลาร์/เดือน | ไม่ต้อง | uptime + status page สำหรับสตาร์ทอัป |
| Checkly | 10 uptime, 10k API checks | ประมาณ 24 ดอลลาร์/เดือน | ต้องใช้ | synthetic API checks |
| Postman | บัญชีฟรี + โควตา monitoring | ประมาณ 14 ดอลลาร์/ผู้ใช้/เดือน | ไม่ต้อง | ใช้ collection เดิมซ้ำ |
| Prometheus + Grafana | ไม่จำกัด (โฮสต์เอง) | — | ไม่ต้อง | metric + visualization |
| Grafana Cloud | 100k API test executions/เดือน | 29 ดอลลาร์/เดือนแพลตฟอร์ม + usage | ควรตรวจสอบ | ทดลองใช้ synthetics แบบ managed |
| New Relic | 100 GB/เดือน, full user 1 คน | ตามผู้ใช้ + data | บางแพลนต้อง | APM + observability พื้นฐาน |
| Datadog | trial/แตกต่างตาม product | 15 ดอลลาร์/host/เดือน (Infra Pro) | มักต้อง | ทดลอง full-stack |
| Moesif | มีฟรี/ทดลองใช้ | ตาม volume | ควรตรวจสอบ | ประเมิน API analytics |
| Splunk | มี trial | ตามใบเสนอราคา | ผ่านฝ่ายขาย | proof of concept ระดับองค์กร |
| Gatus | ไม่จำกัด (โฮสต์เอง) | — | ไม่ต้อง | status dashboard แบบ YAML |
| Apitally | มีฟรี/ทดลองใช้ | ควรตรวจสอบ | ควรตรวจสอบ | API analytics แบบเบา |
| Sematext | trial/free แตกต่างกัน | ประมาณ 2 ดอลลาร์/HTTP monitor | ควรตรวจสอบ | synthetics/logs ราคาต่ำกว่า |
| Uptrace | ฟรีเมื่อโฮสต์เอง | แพ็ก cloud แตกต่างกัน | ควรตรวจสอบ | ประเมิน OTel APM |
หมายเหตุเรื่องต้นทุนแฝง: เครื่องมือ self-hosted อย่าง Uptime Kuma, Prometheus, Gatus ถือว่า "ฟรี" ในแง่ลิขสิทธิ์ แต่ VM เล็ก ๆ, backup, เวลาดูแลรักษา และ failover ภายนอกอาจกลายเป็นต้นทุนจริงได้ง่าย สำหรับ web data APIs ต้นทุนแฝงมักต่างออกไป: การดูแล headless browser, selector ที่พัง, proxy pool, workaround anti-bot และการล้าง HTML
ประมาณการสำหรับทีมเล็ก: สำหรับ 10 endpoint API และสมาชิกทีม 3 คน เส้นทาง SaaS ที่ถูกที่สุดมักเป็น UptimeRobot ฟรีหรือแพ็กถูก ๆ, Better Stack ฟรี/Team หรือ Checkly ถ้าปริมาณ execution พอเหมาะ Datadog และ New Relic อาจยังพอจ่ายได้ตอนทดลอง แต่บิลจริงขึ้นอยู่กับ host, users, logs, traces และปริมาณ synthetic run ถ้าโปรเจกต์ของคุณต้องใช้ข้อมูลเว็บไซต์เป็น API, free units ของ Thunderbit มักพอสำหรับทดสอบ workflow ก่อนตัดสินใจจ่ายแพ็กเกจ
Scorecard ความซับซ้อนในการตั้งค่า: ไปถึง alert แรกได้เร็วแค่ไหน
ยังไม่ค่อยมีบทความคู่แข่งบทไหนประเมิน time-to-value — จากสมัครใช้งานถึง alert สำคัญครั้งแรก สำหรับทีมเล็ก เรื่องนี้สำคัญกว่าความลึกของฟีเจอร์เสียอีก
| เครื่องมือ | เวลาไปถึง alert แรก | ทักษะเทคนิคที่ต้องมี | แนวทางตั้งค่า |
|---|---|---|---|
| Thunderbit Open API | ~5–15 นาที | ต่ำ–กลาง | API key, cURL/SDK/CLI |
| UptimeRobot | ~2–5 นาที | ต่ำ | GUI, คลิกเพิ่มได้เลย |
| Better Stack | ~5–10 นาที | ต่ำ | GUI wizard |
| Checkly | ~10–20 นาที | ต่ำ–กลาง | โค้ดหรือ GUI |
| Postman | ~10 นาที (ถ้ามี collection แล้ว) | ต่ำ–กลาง | collection scheduler |
| Uptime Kuma | ~5–30 นาที | กลาง | Docker + GUI |
| Gatus | ~15–45 นาที | กลาง | YAML + Docker |
| Datadog | ~15–30 นาที | กลาง | ติดตั้ง agent + GUI |
| New Relic | ~15–30 นาที | กลาง | agent + guided setup |
| Moesif | ~20–45 นาที | กลาง | SDK/proxy integration |
| Grafana Cloud Synthetics | ~15–45 นาที | กลาง | GUI, ใช้ Terraform ได้เสริม |
| Prometheus + Grafana | 1–4 ชั่วโมง | กลาง–สูง | YAML, PromQL |
| Uptrace | 30–90 นาที | กลาง–สูง | OTel SDK integration |
| Splunk | หลายชั่วโมงถึงหลายสัปดาห์ | สูง | onboarding ระดับองค์กร |
ถ้าการมอนิเตอร์ต้องออนไลน์ภายในวันนี้ ให้เริ่มจากครึ่งบนของตารางนี้ ถ้าเป้าหมายคือ observability ของแพลตฟอร์มในระยะยาว ให้แยกโปรเจกต์สำหรับครึ่งล่างไว้ต่างหาก และถ้า milestone แรกของคุณคือ "ดึงข้อมูลเว็บ 100 หน้าให้เข้าแอปได้แบบสะอาด" ให้เริ่มด้วย Thunderbit ก่อนสร้างโครงสร้าง scraping เอง
เปรียบเทียบเครื่องมือมอนิเตอร์ API ที่ดีที่สุด: ตารางรวมแบบ side-by-side
ตารางเดียวที่ควรไล่ดูก่อนตัดสินใจ:
| เครื่องมือ | Use Case ที่เหมาะที่สุด | ฟรีแพลน | ความฉลาดของ alert | เวลาเซ็ตอัป | โฮสต์ | จุดเด่น |
|---|---|---|---|---|---|---|
| Thunderbit Open API | ดึงข้อมูลเว็บ / pipeline ข้อมูล API | 600 API units | ไม่ใช่เครื่องมือ alerting | 5–15 นาที | Cloud | Distill หน้าเว็บเป็น Markdown หรือ JSON ตาม schema |
| Datadog | Enterprise/SaaS แบบ full-stack | trial/แตกต่างกัน | Anomaly, forecast, AI | 15–30 นาที | Cloud | เชื่อม synthetics กับ logs/traces/infra |
| Checkly | Synthetic สำหรับ dev-first | ให้ checks ค่อนข้างเยอะ | retries, degradation | 10–20 นาที | Cloud | Monitoring as code + Playwright |
| UptimeRobot | Uptime แบบง่าย | 50 monitors | threshold พื้นฐาน | 2–5 นาที | Cloud | เครื่องมือ basic ที่เร็วและคุ้มที่สุด |
| Uptime Kuma | ฟรีและโฮสต์เอง | ไม่จำกัด | status/threshold พื้นฐาน | 5–30 นาที | Self-hosted | UI สะอาด ไม่มีค่า SaaS |
| Better Stack | Incident response/status page | 10 monitors | escalation, routing | 5–10 นาที | Cloud | monitoring + on-call + status page |
| Prometheus + Grafana | สแตก metrics แบบโอเพ่นซอร์ส | ไม่จำกัด (โฮสต์เอง) | grouping ของ Alertmanager | 1–4 ชม. | Self-hosted/cloud | ความลึกของ ecosystem PromQL |
| New Relic | SaaS APM + API checks | 100 GB/เดือน, ผู้ใช้ 1 คน | AI grouping, flapping suppression | 15–30 นาที | Cloud | APM และ synthetics ดีมากเมื่อใช้ร่วมกัน |
| Moesif | API analytics / business metrics | ฟรี/ทดลองใช้ | behavioral anomalies | 20–45 นาที | Cloud | analytics พฤติกรรม API รายลูกค้า |
| Splunk | Logs/ compliance ระดับองค์กร | trial | ITSI episodes, AIOps | หลายวัน+ | Cloud/self-managed | ค้นหา log และ governance ระดับองค์กร |
| Postman | ทีมที่ทดสอบ API อยู่แล้ว | บัญชีฟรี | alert พื้นฐาน | 10 นาที | Cloud | ใช้ collection ทดสอบเดิมซ้ำ |
Thunderbit ช่วยเร่งการประเมินเครื่องมือ API ได้อย่างไร
ขอเปิดเผยตรง ๆ: Thunderbit ไม่ใช่เครื่องมือมอนิเตอร์ API แต่มันคือ agentic web scraper และ Open API สำหรับแปลงเว็บเพจเป็น Markdown สะอาดหรือ JSON ที่มีโครงสร้าง ซึ่งทำให้มันมีประโยชน์ในอีกช่วงหนึ่งของการตัดสินใจเลือกเครื่องมือมอนิเตอร์: การเก็บข้อมูลราคา แพ็กเกจ ข้อจำกัด ฟีเจอร์ เอกสาร และรายการอินทิเกรชันของ vendor ก่อนตัดสินใจเลือกแพลตฟอร์ม
แทนที่จะเปิดหน้าราคา 10+ เจ้า คัดลอกชื่อแพ็กเกจ, จำนวน monitor, interval, integration และเงื่อนไขการใช้บัตรเครดิตลงสเปรดชีตด้วยมือ เราใช้ Thunderbit Chrome Extension ดึงข้อมูลเชิงโครงสร้างจากหน้าราคาและหน้าฟีเจอร์ของแต่ละเครื่องมือ Thunderbit จะอ่านแต่ละหน้าและแนะนำ field ให้ เช่น ชื่อแพ็กเกจ รายละเอียดฟรีแพลน ราคาที่ต้องจ่าย อินทิเกรชันที่รองรับ แล้วจัดผลลัพธ์ออกมาเป็นสเปรดชีตที่ export ได้
สำหรับ workflow ของนักพัฒนา Thunderbit Open API ให้แนวคิดเดียวกันในเชิงโปรแกรม ใช้ Distill เมื่ออยากได้ Markdown สะอาดสำหรับ LLM หรือ RAG ใช้ Extract เมื่ออยากให้คืนฟิลด์เฉพาะในรูป JSON ใช้ Batch เมื่อจำเป็นต้องประมวลผลรายการ URL จำนวนมาก เช่น หน้าราคา หน้าเอกสาร หน้าสินค้า หรือหน้าคู่แข่ง แล้วรับผลแบบอะซิงโครนัส
เวิร์กโฟลว์:
- เปิดหน้าราคาของ vendor (Datadog, Checkly, UptimeRobot ฯลฯ)
- คลิก "One Click Extract" — AI ของ Thunderbit จะอ่านหน้า แกะโครงสร้าง และเติมตารางให้ในครั้งเดียว
- ใช้ subpage scraping ดึงทั้งหน้าราคา หน้าฟีเจอร์ และหน้าเอกสารของ vendor แต่ละราย
- Export ไป Google Sheets, Excel, Airtable, Notion หรือ CSV
สำหรับทีมที่ทำงานแบบ API-first workflow ผ่าน API ก็ตรงไปตรงมาเช่นกัน:
- รับ API key ฟรีจาก Thunderbit
- เรียก Distill endpoint เพื่อดึง Markdown สะอาดจากหน้า public ใดก็ได้
- เรียก Extract endpoint พร้อม schema description เพื่อรับ JSON โครงสร้าง
- ใช้ Batch endpoint และ webhook สำหรับรายการ URL ขนาดใหญ่
- ส่งผลลัพธ์เข้าแอป สเปรดชีต data warehouse vector database หรือ workflow มอนิเตอร์ของคุณ
ถ้าต้องเปรียบเทียบ vendor มากกว่า 10 เจ้า การคัดลอกวางเองอาจกินเวลา 2–3 ชั่วโมงได้ง่าย ๆ เมื่อรวมหน้าราคาย่อย หน้าฟีเจอร์ และหน้าอินทิเกรชันเข้าไปด้วย Thunderbit ช่วยลดเวลาการดึงข้อมูลรอบแรกเหลือประมาณ 15–30 นาที ที่เหลือใช้ตรวจทานและตัดสินใจ ถ้าทีม ops, procurement, research หรือ AI product ของคุณกำลังประเมินเครื่องมือแบบเร่งด่วน นี่คือทางลัดที่ใช้งานได้จริง คุณดู workflow แบบนี้เพิ่มเติมได้ในคู่มือ web scraping without coding สำรวจ Thunderbit API pricing หรือดูวิดีโอสาธิตที่ YouTube channel
วิธีเลือกเครื่องมือมอนิเตอร์ API ที่ดีที่สุดสำหรับทีมของคุณ
คำว่า "ดีที่สุด" ขึ้นอยู่กับขนาดทีม ความลึกทางเทคนิค งบประมาณ และความหมายของคำว่า failure สำหรับ product ของคุณ
นักพัฒนาคนเดียวไม่จำเป็นต้องใช้ Splunk องค์กรที่อยู่ภายใต้ข้อกำกับไม่ควรพึ่ง cron job ทีมผลิตภัณฑ์ API อาจต้องการ analytics แบบ Moesif มากกว่าการ ping เช็ก uptime ทีมอีคอมเมิร์ซควรให้ความสำคัญกับการเช็กเส้นทางสำคัญอย่าง login, search, add-to-cart, checkout และ payment authorization ส่วนทีม AI หรือ data product อาจต้องใช้ web data extraction แบบ Thunderbit ก่อนถึงจะต้องมี observability เต็มรูปแบบ
หลักการสามข้อที่ยืนหยัดได้ตลอดการค้นคว้าของผม:
- เลือกเครื่องมือให้ตรง use case ตารางสรุปแบบเร็วมีเหตุผลของมัน — เริ่มจากตรงนั้น
- ให้ความสำคัญกับคุณภาพของ alert มากกว่าปริมาณ alert ถ้าทีมคุณเมิน alert แปลว่าคุณไม่ได้มี monitoring คุณมี noise
- อย่าประเมินความเร็วในการเริ่มใช้งานต่ำเกินไป มอนิเตอร์ที่ออนไลน์ได้วันนี้และส่ง alert ที่เชื่อถือได้ ดีกว่าแพลตฟอร์มสมบูรณ์แบบที่ปล่อยให้ checkout ไม่มีการเฝ้าดูไปอีกเดือน
ถ้าคุณกำลังเทียบหลายเครื่องมือพร้อมกันและอยากเร่งการรีเสิร์ช ลองใช้ Thunderbit เพื่อดึงข้อมูล vendor แบบ bulk ลงสเปรดชีตเดียว ถ้าคุณกำลังสร้าง API product, RAG pipeline, AI agent หรือ workflow ด้าน market intelligence ที่ต้องใช้ข้อมูลเว็บสะอาด เริ่มจาก Thunderbit Open API ได้เลย มันอาจไม่เลือกเครื่องมือมอนิเตอร์แทนคุณ แต่จะพาคุณไปถึงการตัดสินใจได้เร็วขึ้น และยังช่วยให้ product ของคุณมีชั้นข้อมูลเว็บที่เชื่อถือได้
คำถามที่พบบ่อยเกี่ยวกับเครื่องมือมอนิเตอร์ API ที่ดีที่สุด
เครื่องมือมอนิเตอร์ API ฟรีที่ดีที่สุดในปี 2026 คืออะไร?
ถ้าต้องการความง่ายแบบ SaaS UptimeRobot ให้ฟรี 50 monitors ที่ interval 5 นาที โดยไม่ต้องใช้บัตรเครดิต ถ้าต้องการควบคุมเอง Uptime Kuma เป็นโอเพ่นซอร์ส ใช้ได้ไม่จำกัด และมี UI สะอาดพร้อม notification service กว่า 90 แบบ สำหรับทีมที่ต้องการความลึกด้าน metric และมีทักษะทางเทคนิคเพียงพอ Prometheus + Grafana + Alertmanager คือสแตกโอเพ่นซอร์สที่ดีที่สุด — แม้การตั้งค่าจะใช้เวลาหลายชั่วโมง ไม่ใช่ไม่กี่นาที
ถ้าเป้าหมายของคุณไม่ใช่การมอนิเตอร์ uptime แต่เป็นการดึงข้อมูลเว็บผ่าน API Thunderbit Open API มีฟรีแพลน 600 API units แบบครั้งเดียว ซึ่งพอสำหรับทดลองดึงเพจเป็น Markdown หรือ JSON ตาม schema ก่อนขยายการใช้งาน
API monitoring ต่างจาก APM อย่างไร?
API monitoring ตรวจความพร้อมใช้งานของ endpoint, response time, error และความถูกต้องจากภายนอก — มันจำลองประสบการณ์ของผู้ใช้หรืออินทิเกรชัน APM (Application Performance Monitoring) ลงลึกเข้าไปในแอปพลิเคชัน: trace ระดับโค้ด, query ฐานข้อมูล, runtime error, queue latency และ dependency ของ service เครื่องมืออย่าง Datadog และ New Relic มีทั้งสองอย่าง ส่วน UptimeRobot และ Uptime Kuma เน้นตรวจ uptime ภายนอก
Thunderbit Open API แตกต่างจากทั้งสองแบบ เพราะมันคือ API สำหรับดึงข้อมูลเว็บ ช่วยแปลงเว็บไซต์ภายนอกให้เป็น Markdown หรือ JSON ตามโครงสร้าง ซึ่งมีประโยชน์กับแอป LLM, workflow งานวิจัย, pricing intelligence และ data pipeline
ควรตรวจสอบ API บ่อยแค่ไหน?
API สำคัญต่อรายได้ใน production เช่น checkout, auth, payments มักควรตรวจทุก 1 นาที API ภายในหรือ API ที่ทราฟฟิกไม่สูงนักอาจตรวจทุก 5 นาทีได้ แต่ความถี่อย่างเดียวไม่พอ — ควรใช้ retry, หลายภูมิภาค และ assertion ที่มีความหมาย เพื่อให้แต่ละการตรวจทั้งเร็วและเชื่อถือได้ การตรวจทุก 1 นาทีที่แจ้งเตือนมั่ว แย่กว่าการตรวจทุก 5 นาทีที่คุณเชื่อใจได้
สำหรับ workflow ดึงข้อมูลเว็บ ความถี่ขึ้นอยู่กับความถี่ที่แหล่งข้อมูลเปลี่ยน หน้า pricing อาจดึงวันละครั้งหรือสัปดาห์ละครั้ง ข้อมูล inventory, travel หรือ marketplace ที่เปลี่ยนเร็วอาจต้องรีเฟรชรายชั่วโมงหรือบ่อยกว่านั้น Batch API และ webhook ของ Thunderbit มีประโยชน์มากเมื่อคุณต้องประมวลผล URL จำนวนมากตามตารางเวลา
จะมอนิเตอร์ API ได้ไหมโดยไม่ต้องเขียนโค้ด?
ได้ UptimeRobot, Better Stack และ Uptime Kuma ใช้งานผ่าน GUI ล้วนได้ Checkly รองรับทั้ง GUI และการตั้งค่าด้วยโค้ด Postman ใช้ interface แบบ collection ส่วน Prometheus/Grafana มักต้องใช้ YAML และ PromQL Datadog กับ New Relic เริ่มผ่าน guided setup ได้ แต่จะทรงพลังขึ้นเมื่อมีการ instrumentation ลึกขึ้น
ถ้าคุณอยากดึงข้อมูลเว็บไซต์โดยไม่เขียนโค้ด Chrome Extension ของ Thunderbit คือทางเลือก no-code ถ้าคุณอยากอัตโนมัติเวิร์กโฟลว์เดียวกันจากแอป Thunderbit Open API ก็ให้ endpoint อย่าง Distill, Extract และ Batch สำหรับนักพัฒนา
จะลด alert fatigue จาก API monitoring ได้อย่างไร?
เลือกเครื่องมือที่มี alert ฉลาด: anomaly detection (Datadog, New Relic), retry-before-firing (Checkly), behavioral anomalies (Moesif) หรือ grouping/silencing (Prometheus Alertmanager) เริ่มจาก alert ที่น้อยกว่าแต่มั่นใจกว่า และโฟกัสที่ผลกระทบต่อผู้ใช้ ใช้ SLO burn-rate alert แทน threshold แบบคงที่ deduplicate ข้าม service route ตาม owner และวัด actionability — ถ้า alert ของคุณนำไปสู่การลงมือจริงน้อยกว่า 20% ให้ลด noise ก่อน
ลองใช้ Thunderbit Open API สำหรับดึงข้อมูลเว็บ Get Started Free
อ่านเพิ่มเติม



