TechCrunch-scraper













Lås upp TechCrunch-data med två klick
Enkel TechCrunch-scraping i två klick
Att manuellt kopiera artikeltitlar, författare, publiceringsdatum eller hela artikeltexter från TechCrunch är tidskrävande. Med Thunderbit slipper du allt manuellt arbete. Peka bara på den data du behöver så räknar AI:n ut resten. Två klick senare extraherar du strukturerad data utan att skriva en enda kodrad eller krångla med komplicerade inställningar.
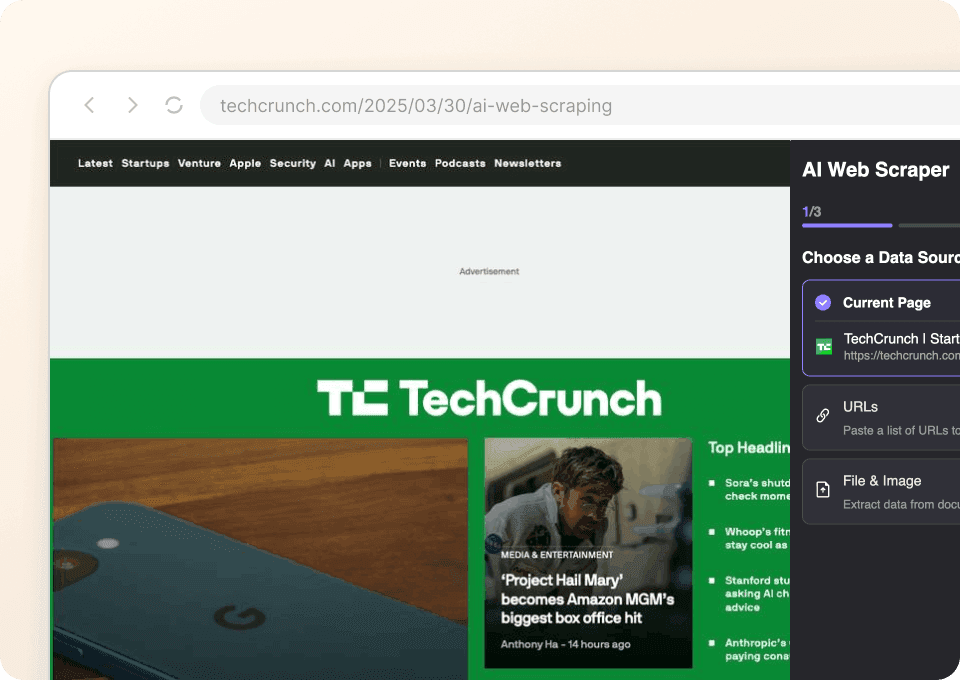
Få ren TechCrunch-data direkt
Att hämta rå HTML från TechCrunch tar dig ingenstans — du behöver ren, strukturerad data. Thunderbit städar och formaterar automatiskt datan medan den extraheras, så att du direkt kan analysera artikelkategorier, följa författare eller jämföra publiceringsdatum. Exportera direkt till Google Sheets, Notion eller Airtable och börja arbeta med organiserad data på en gång — ingen manuell rensning behövs.

Extrahera från vilken webbplats som helst, inte bara TechCrunch
Varför lära sig ett nytt verktyg för varje webbplats? Thunderbit fungerar på praktiskt taget alla sajter, inklusive TechCrunch. Med över 50 färdiga mallar kan du komma igång ännu snabbare. Oavsett om du samlar in artikelinnehåll, författarprofiler eller publiceringstaggar är Thunderbit din enda lösning för webbdatautvinning över hela webben.
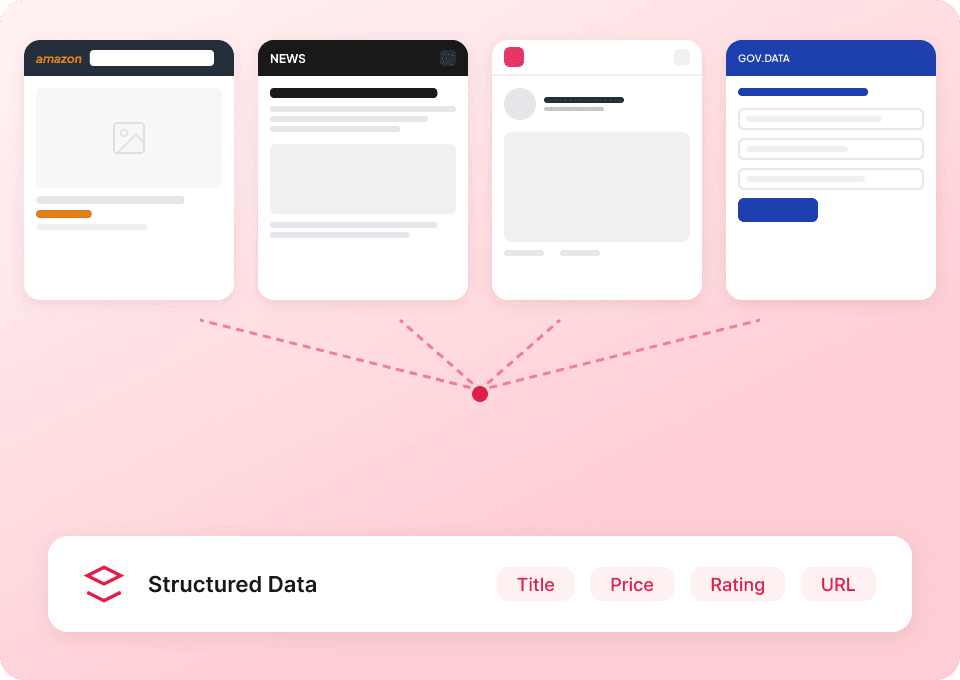
Svårt att extrahera TechCrunch effektivt?
Se hur Thunderbit förenklar dataextraktion från TechCrunch jämfört med traditionella metoder.
Traditionella scrapers
Det gamla sättet att arbetaThunderbit
Det smartare valet


Vanliga frågor
Relaterat användningsområden
Utforska fler användningsområden för Thunderbits web scraper.

Investing.com-scraper
Hämta aktiedata — symboler, priser, volym och börsvärde — från Investing.com på bara 2 klick och exportera sedan direkt till Google Sheets, Notion eller Excel. Öppna valfri Investing.com-sida och låt AI identifiera fälten åt dig.
Läs mer ->
Substack-scraper
Extrahera Substack-prenumerantantal, artikelrubriker och publiceringsbeskrivningar med 2 klick — exportera sedan till Excel, Google Sheets eller Notion. Ingen kod behövs; Thunderbits AI sköter struktureringen åt dig.
Läs mer ->
PubMed-scraper
Thunderbits PubMed-scraper hjälper dig att extrahera strukturerad data från PubMeds sökresultat och artikelsidor med hjälp av AI. Skrapa aktuell medicinsk forskning, evidens från kliniska studier, abstract, författare, affilieringar, publiceringsdatum och länkar, och exportera sedan till Excel, Google Sheets, Airtable eller Notion.
Läs mer ->
Enkel ESPN-scraper
Spåra idrottares namn, matchdatum och resultat från ESPN med bara 2 klick med Thunderbits AI — ingen kod, ingen konfiguration. Exportera direkt till Excel, Google Sheets eller Notion och börja använda din sportsdata direkt.
Läs mer ->
Artikelskrapare för text, författare och datum
Samla in rubriker, författarnamn, datum, sammanfattningar, brödtext, länkar och media från offentliga artikelsidor. Håll ihop varje artikels uppgifter i en tydlig rad, även när nyhetssajter använder olika layouter.
Läs mer ->
Nyhets-scraper: Knyt rubriker till fullständiga artikeluppgifter
Samla rubriker från ämnes-, sektions- eller söksidor och öppna sedan artikellänkar för synliga bylines, publiceringsdatum, sammanfattningar, avdelningar och käll-URL:er. Berätta för Thunderbit vilka artikeluppgifter som är viktiga på vanlig svenska innan körningen.
Läs mer ->Redo att växla upp din dataextraktion?
Gå med över 200 000 yrkespersoner som redan använder Thunderbit för att automatisera sina arbetsflöden för web scraping.
Gratis provperiod ger obegränsade credits för 8 webbsidor.



