Artikelskrapare för text, författare och datum













Samla in artikeldata trots föränderliga sidlayouter
Läs fält utifrån betydelse, schemalägg upprepade körningar och använd samma arbetsflöde på offentliga webbplatser.
Anpassa dig när artikelayouten ändras
Thunderbit läser synliga rubriker, bylines, datum, sammanfattningar och artikeltext utifrån deras betydelse. Arbetsflödet blir mindre beroende av fasta sidpositioner när en nyhetssajt ändrar layout.
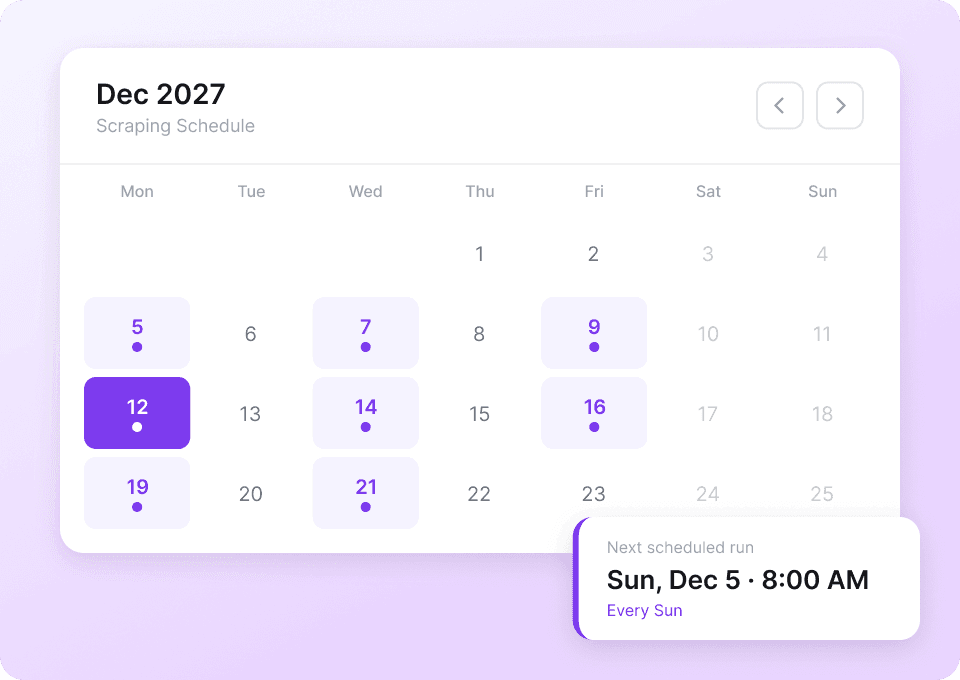
Kör artikelskrapningen enligt schema
Ställ in en upprepad körning för en offentlig nyhets-, blogg- eller kategorisida som du återkommer till. Thunderbit kan samla in de senaste synliga artiklarna och skicka nya rader till din valda fil eller app.
Använd ett arbetsflöde på valfri offentlig sajt
Använd samma arbetsflöde på alla offentliga webbplatser med artiklar. Namnge fälten du behöver och låt Thunderbit placera varje sida i samma kolumner.
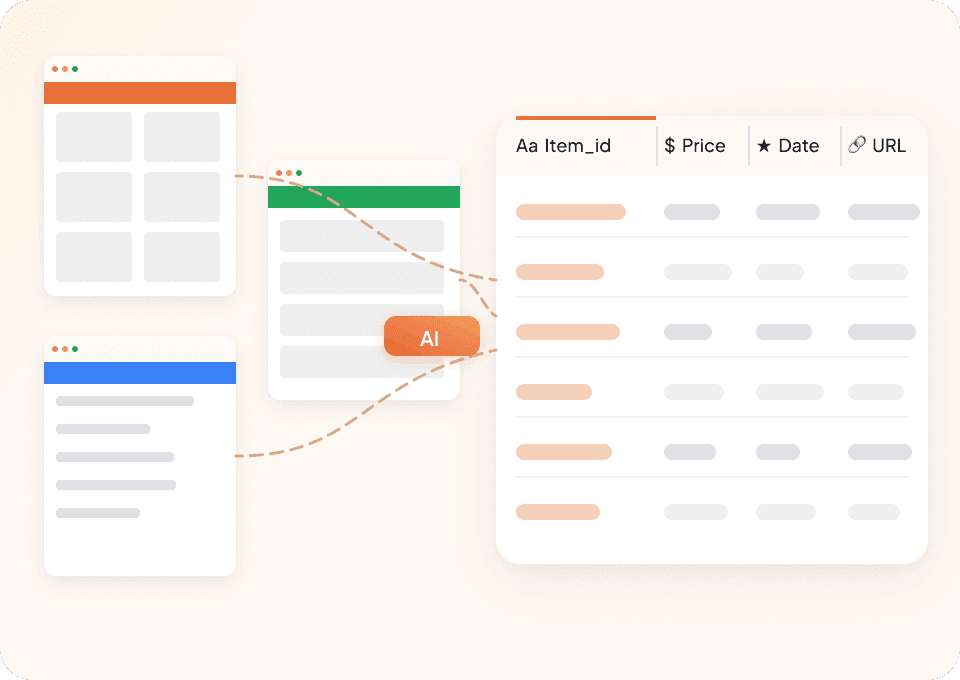
Ett arbetsflöde för artiklar över olika sidlayouter
Fasta selektorer följer positioner. Thunderbit AI letar efter de artikel-fält du namnger.
En selektorkarta för varje utgivare
Varje siddesign kräver separat underhållArtikeldata organiseras av Thunderbit
Den begärda posten förblir konsekventVilken data kan du extrahera från en artikel?
Välj bland 30 synliga fält för innehåll, författare, utgivare, datum, länkar, ämnen, media och sidmetadata.
- Rubrik
- Alternativ rubrik
- Artikelns brödtext
- Artikelsammanfattning
- Författarnamn
- Författar-URL
- Författarorganisation
- Utgivarens namn
- Utgivarens URL
- Publiceringsdatum
- Ändringsdatum
- Artikelavsnitt
- Nyckelord
- Antal ord
- Språk
- Kanonisk URL
- Huvudobjektets URL
- Bild-URL
- Bildtext
- Bildkälla
- Video-URL
- Ljud-URL
- Datumrad
- Om ämnen
- Nämnanden
- Citeringslänkar
- Licens-URL
- Länkar till relaterade artiklar
- Sidans titel
- Metabeskrivning
Hear editors and research teams discuss article data
In these user videos, editors and researchers gather article text, bylines, dates, and source links for review.


Frågor om att skrapa offentliga artiklar
Nyhetssajter använder olika layouter och siduppgifter, så vilka fält du får beror på vilken artikelsida du fångar.
Continue from articles to the pages around them
Explore news, author, and publisher scrapers when your research also needs indexes, profiles, or related stories.

Investing.com-scraper
Hämta aktiedata — symboler, priser, volym och börsvärde — från Investing.com på bara 2 klick och exportera sedan direkt till Google Sheets, Notion eller Excel. Öppna valfri Investing.com-sida och låt AI identifiera fälten åt dig.
Läs mer ->
Substack-scraper
Extrahera Substack-prenumerantantal, artikelrubriker och publiceringsbeskrivningar med 2 klick — exportera sedan till Excel, Google Sheets eller Notion. Ingen kod behövs; Thunderbits AI sköter struktureringen åt dig.
Läs mer ->
TechCrunch-scraper
Extrahera artiklar, startup-uppdateringar, rubriker, länkar, datum, författare och sammanfattningar från TechCrunch med bara 2 klick — helt utan kod. Exportera direkt till Excel, Google Sheets eller Notion och förvandla rånyheter till strukturerad data som går att agera på.
Läs mer ->
PubMed-scraper
Thunderbits PubMed-scraper hjälper dig att extrahera strukturerad data från PubMeds sökresultat och artikelsidor med hjälp av AI. Skrapa aktuell medicinsk forskning, evidens från kliniska studier, abstract, författare, affilieringar, publiceringsdatum och länkar, och exportera sedan till Excel, Google Sheets, Airtable eller Notion.
Läs mer ->
Enkel ESPN-scraper
Spåra idrottares namn, matchdatum och resultat från ESPN med bara 2 klick med Thunderbits AI — ingen kod, ingen konfiguration. Exportera direkt till Excel, Google Sheets eller Notion och börja använda din sportsdata direkt.
Läs mer ->
Nyhets-scraper: Knyt rubriker till fullständiga artikeluppgifter
Samla rubriker från ämnes-, sektions- eller söksidor och öppna sedan artikellänkar för synliga bylines, publiceringsdatum, sammanfattningar, avdelningar och käll-URL:er. Berätta för Thunderbit vilka artikeluppgifter som är viktiga på vanlig svenska innan körningen.
Läs mer ->Redo att växla upp din dataextraktion?
Gå med över 200 000 yrkespersoner som redan använder Thunderbit för att automatisera sina arbetsflöden för web scraping.
Gratis provperiod ger obegränsade credits för 8 webbsidor.



