Thunderbits PubMed-scraper hjälper dig att omvandla PubMed-sidor till rena, strukturerade dataset med hjälp av AI. Du kan extrahera aktuell medicinsk forskning, evidens från kliniska studier, abstract, författare, affilieringar, publiceringsdatum, PMID och länkar till artiklar, och sedan exportera till Excel, Google Sheets, Airtable eller Notion. Du öppnar bara PubMed i Chrome, låter AI föreslå de bästa kolumnerna och kör sedan skrapningen.
🧬 Vad är PubMed-scraper
PubMed-scraper är en AI-webbscraper byggd för PubMed | US National Library of Medicine. Med Thunderbit (ett AI-webbscraper-tillägg för Chrome) kan du gå till vilken resultatsida som helst i PubMed, klicka på AI Suggest Columns och sedan på Scrape för att extrahera strukturerad data utan att skriva kod.
🔎 Vad kan du skrapa med PubMed
PubMed är fullt av värdefull biomedicinsk metadata, men den är inte alltid redo för analys direkt. Thunderbits AI Web Scraper (https://thunderbit.com/) hjälper dig att samla in och strukturera PubMed-listningar och berika dem med artikelspecifika detaljer via Subpage Scraping (öppna varje artikelsida och lägg till fält som abstract, affilieringar, DOI och mer).
Nedan finns två vanliga arbetsflöden som du kan köra på några minuter.
📈 Skrapa PubMeds trendande medicinska forskning
Använd det här arbetsflödet för att bevaka vad som trendar inom medicinsk forskning på PubMeds trendsida. Det är användbart för att hålla sig uppdaterad, bygga interna sammanställningar, följa konkurrenters publikationer eller mata in data i en litteraturövervakningsprocess.
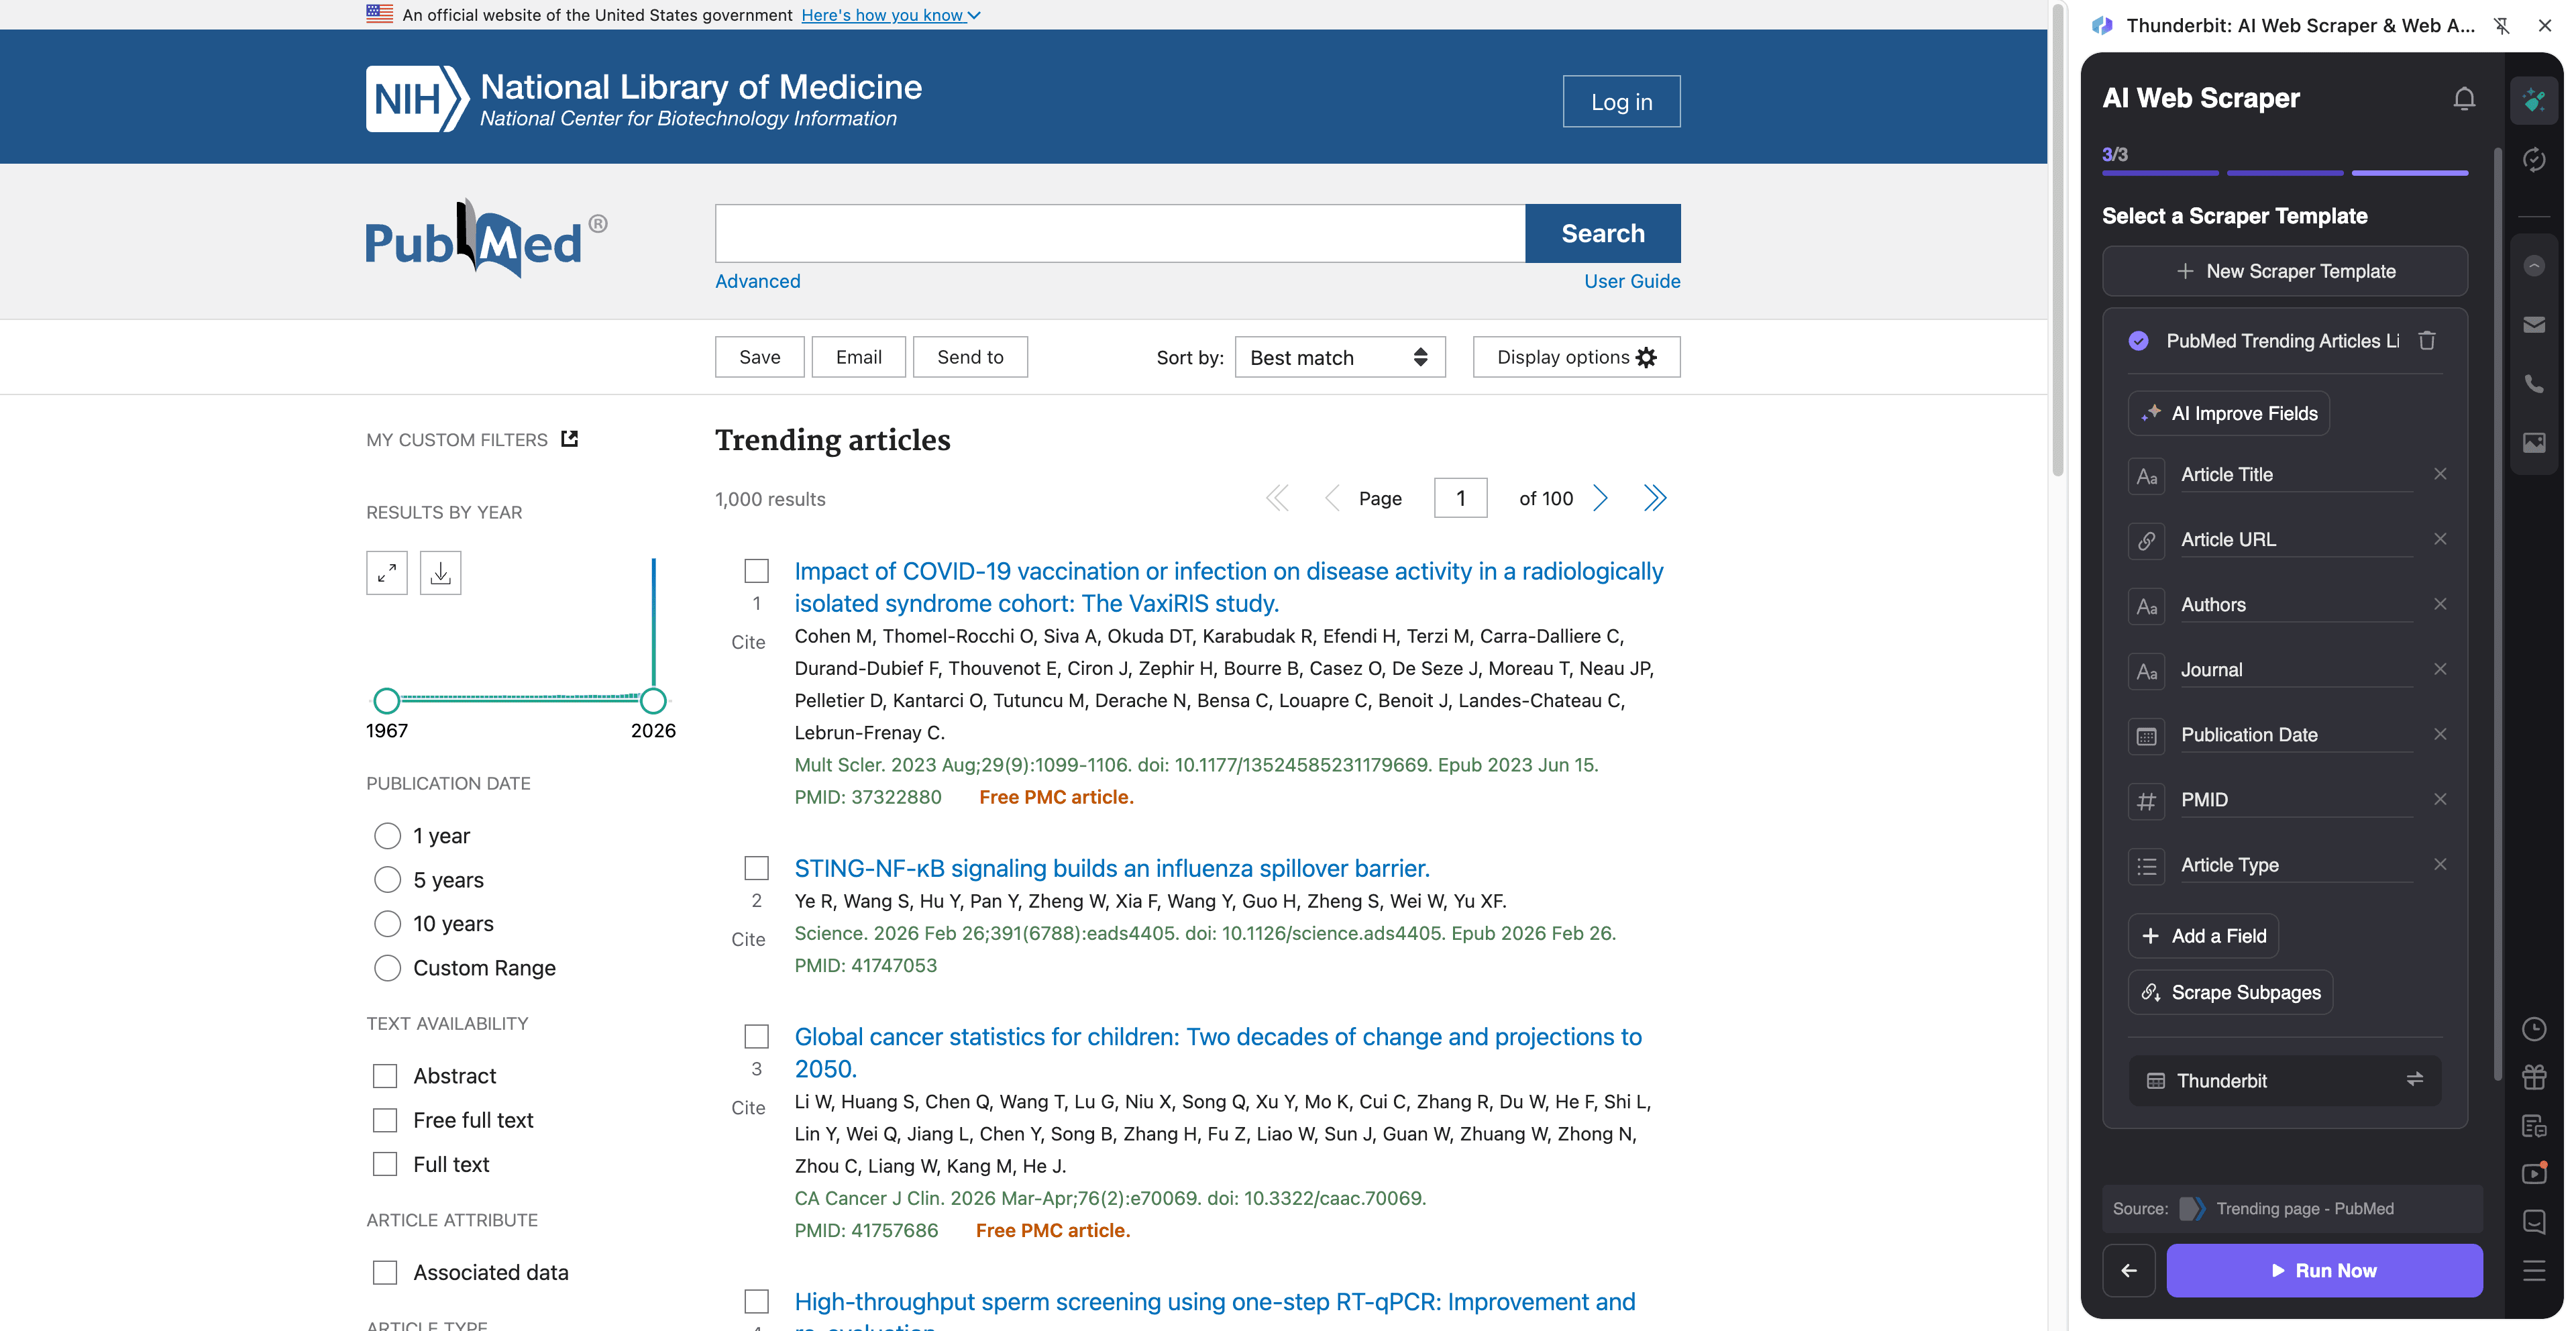
Exempelsida: PubMed Trending
Steg:
- Ladda ner Thunderbit Chrome Extension och skapa ett konto.
- Gå till målsidan, till exempel: PubMed Trending.
- Klicka på AI Suggest Columns så att AI kan föreslå de bästa kolumnnamnen och datatyperna.
- Klicka på Scrape för att extrahera data och exportera sedan till Excel, Google Sheets, Airtable eller Notion.
Kolumnnamn
| Kolumn | Beskrivning |
|---|---|
| 🧾 Artikelrubrik | Rubriken för den trendande PubMed-artikeln. |
| 🔗 Artikel-URL | Direktlänk till PubMeds poster. |
| 🆔 PMID | PubMed-identifierare för posten (användbar som stabil nyckel). |
| 🏛️ Tidskrift | Namnet på tidskriften där artikeln är publicerad. |
| 📅 Publiceringsdatum | Publiceringsdatumet som visas i listningen. |
| ✍️ Författare | Författarlistan som visas på resultatkortet. |
| 🧪 Artikeltyp | Publiceringstyp när den finns tillgänglig (t.ex. Review, Clinical Trial). |
| 🏷️ Nyckelord / ämnen | Synliga ämnestaggar eller nyckelord i listningen (om sådana finns). |
| 📝 Utdrag / sammanfattning | Kort textutdrag som visas i listningen (om sådant finns). |
| 🧷 DOI | DOI när den finns tillgänglig (fångas ofta bäst via subpageskrapning). |
| 🧑🔬 Affilieringar | Författarnas affilieringar (vanligen extraherade via subpageskrapning). |
| 📄 Abstract | Abstracttext (vanligen extraherad via subpageskrapning). |
🧫 Skrapa PubMed för evidens från kliniska studier
Använd det här arbetsflödet för att extrahera evidens kopplad till kliniska studier från PubMeds sökresultat och berika sedan varje rad genom att besöka artikelsidan för att hämta abstract, studiesignaler och den metadata du behöver för granskning.
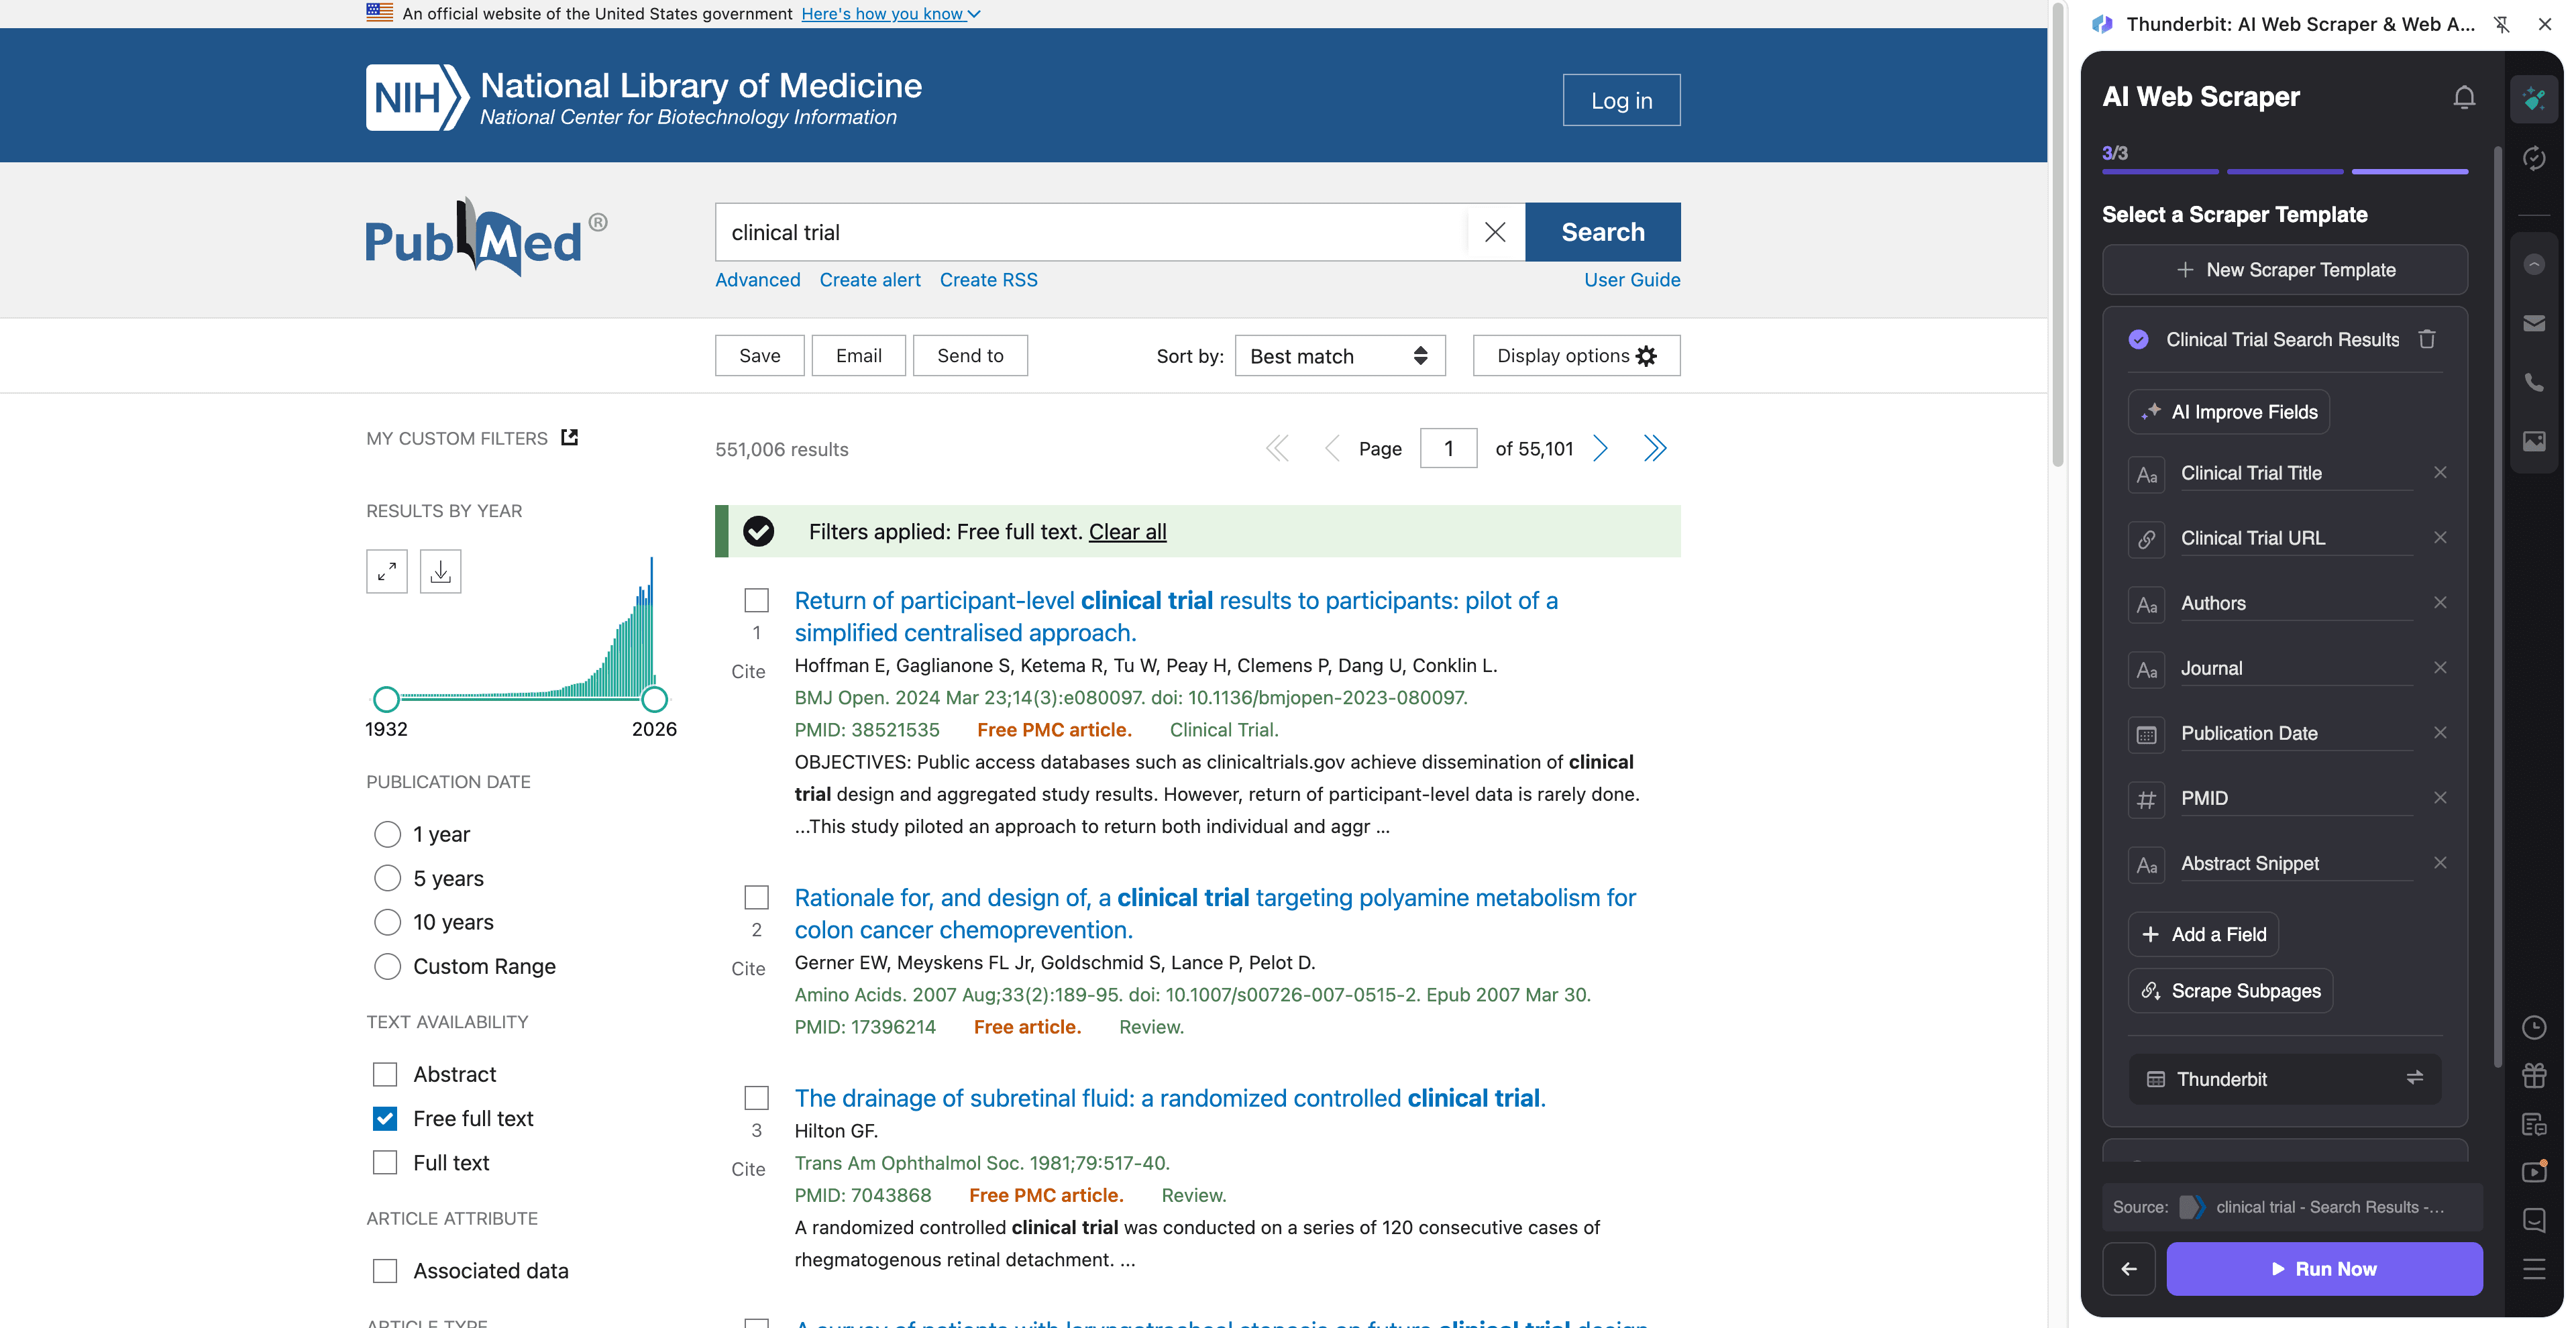
Exempelsida: Clinical trial search results
Steg:
- Ladda ner Thunderbit Chrome Extension och skapa ett konto.
- Gå till målsidan, till exempel: Clinical trial search results.
- Klicka på AI Suggest Columns för att generera rekommenderade fält (du kan byta namn på dem eller lägga till egna).
- Klicka på Scrape för att samla in resultaten och använd sedan Scrape Subpages för att berika varje rad med abstract, affilieringar, DOI och mer.
Kolumnnamn
| Kolumn | Beskrivning |
|---|---|
| 🧾 Titel | Artikelrubriken från sökresultaten. |
| 🔗 PubMed-URL | Länk till artikelsidan i PubMed för berikning via subpages. |
| 🆔 PMID | PubMed-identifierare för deduplicering och referenser. |
| 🧑⚕️ Författare | Författarna som listas i resultatutdraget. |
| 🏛️ Tidskrift | Tidskriftsnamn och citeringsinformation som visas i resultaten. |
| 📅 Datum | Publiceringsdatum (eller ePub-datum) som visas i listningen. |
| 🧪 Publiceringstyp | Signaler som Clinical Trial, Randomized Controlled Trial, Meta-Analysis (ofta tydligare på artikelsidan). |
| 🧾 Abstract | Hela abstracttexten (bäst via subpageskrapning). |
| 🧬 MeSH-termer | Medical Subject Headings när de finns tillgängliga (ofta på artikelsidan). |
| 🧷 DOI | DOI för att länka till förlagssidor och referenshanterare. |
| 🏥 Affilieringar | Författarnas affilieringar för institutionsanalys (subpageskrapning). |
| 🌍 Land / institution | Tolkat från affilieringar med Field AI Prompts (valfritt). |
| 🔍 Nyckelord för klinisk studie | AI-märkta signaler som ”randomiserad”, ”dubbelblind”, ”placebo” (valfritt via Field AI Prompt). |
| 📎 Länkar till fulltext | Utgående länkar till förlag eller fri fulltext när sådana finns. |
🎯 Varför använda PubMed-verktyget
Att skrapa PubMed handlar om hastighet, konsekvens och att göra forskningsdata användbar i ditt arbetsflöde. I stället för att kopiera referenser en och en kan du bygga ett strukturerat dataset som du kan filtrera, tagga och dela.
Vanliga skäl till att team skrapar PubMed:
- Medical affairs- och pharma-team: Följ nya publikationer inom ett terapiområde, bevaka konkurrenters studier och bygg evidenstabeller för interna granskningar.
- Biotech- och clinical operations-team: Samla publikationer kopplade till kliniska studier, kartlägg institutioner och forskare, och håll en levande bibliografi.
- Healthcare marketing- och content-team: Identifiera trendande ämnen, tongivande tidskrifter och nya nyckelord för innehållsplanering.
- Akademiska forskare och bibliotekarier: Bygg dataset för litteraturöversikter, ta bort dubbletter via PMID och exportera till kalkylblad för granskning.
- Datateam: Skapa strukturerade indata för vidare analys, dashboards eller interna kunskapsbaser.
Thunderbit är särskilt användbart när du behöver mer än själva listningssidan. Med Subpage Scraping kan du extrahera abstract, affilieringar, DOI, MeSH-termer och länkar till fulltext i stor skala.
🧩 Så använder du PubMed Chrome Extension
- Installera Thunderbit Chrome Extension: Hämta den från Chrome Web Store och skapa ditt konto.
- Navigera till en PubMed-sida: Öppna PubMed, en trendsida som Trending, eller en sökning som clinical trial results.
- Aktivera AI-driven scraper: Klicka på AI Suggest Columns för att generera fält, justera datatyper (text/datum/url) och lägg till valfria Field AI Prompts (för märkning, formatering eller för att extrahera studiesignaler).
- Skrapa och exportera: Klicka på Scrape. Om du behöver abstract/affilieringar/MeSH, kör Scrape Subpages för att berika varje rad och exportera sedan till Excel, Google Sheets, Airtable eller Notion.
Tips på vidare läsning om du bygger ett återkommande arbetsflöde:
- How to Scrape Any Website Using AI
- What Is Data Scraping and How to Do It in 2025
- How to Scrape Website Data into Excel using AI
- What Is List Crawling and How to Do It Using AI
💳 Priser för PubMed
Thunderbit använder ett enkelt kreditsystem:
- 1 kredit = 1 utgående rad i din resultattabell (till exempel en PubMed-post).
- Dataexport är gratis: ladda ner CSV/JSON eller skicka till Excel, Google Sheets, Airtable eller Notion.
Du kan börja med:
- Gratisnivå: skrapa 6 sidor per månad (sidbaserad gräns på Free).
- Gratis provperiod: skrapa 10 sidor gratis, vilket är perfekt för att testa PubMeds trendsidor och några sidor med kliniska sökresultat.
Om du skrapar regelbundet (veckovis bevakning, evidensuppdateringar eller stora sökningar) ger betalda planer fler krediter. Årsplanen är vanligtvis mer kostnadseffektiv eftersom den inkluderar rabatt jämfört med att betala månad för månad.
Du kan läsa mer på Thunderbit Pricing.
❓ FAQ
-
Vad är den AI-drivna PubMed-scrapern?
Den AI-drivna PubMed-scrapern är ett arbetsflöde i Thunderbit som extraherar strukturerad data från PubMeds sökresultat och artikelsidor. Du kan använda AI för att föreslå kolumner, skrapa listningar och berika varje rad genom att besöka artikelsidor för abstract, affilieringar, DOI och mer. -
Vad är Thunderbit?
Thunderbit är ett AI-webbscraper-tillägg för Chrome, utformat för affärs- och forskningsflöden där du behöver strukturerad data från webbplatser. Det hjälper dig att extrahera, märka upp och exportera data snabbt, utan att bygga eller underhålla skrapningsskript. -
Kan man skrapa PubMeds trendsidor och vanliga sökresultat?
Ja. Du kan skrapa PubMed Trending, vanliga sökningar med nyckelord och filtrerade resultatsidor (till exempel frågor med fokus på kliniska studier). Thunderbits AI anpassar sig till olika layouter genom att läsa sidan och föreslå fält. -
Kan Thunderbit extrahera abstract, affilieringar och MeSH-termer?
Ja, och det är här Subpage Scraping är som mest användbart. Du kan först skrapa resultatlistan och sedan låta Thunderbit öppna varje PubMed-post för att extrahera abstract, affilieringar, MeSH-termer, DOI och annan metadata i samma tabell. -
Hur fungerar paginering och oändlig scroll i PubMed?
Thunderbit stödjer skrapning av paginering, inklusive navigering av typen ”nästa sida”. Om PubMed ändrar hur resultaten laddas är AI-baserad extrahering mer robust än fasta selektorer, eftersom sidan läses om från början vid varje körning. -
Vilka format kan jag exportera PubMed-data till?
Du kan exportera till CSV eller JSON, eller skicka datasetet till Excel, Google Sheets, Airtable eller Notion. Det är användbart för granskningsflöden, evidenstabeller, dashboards och samarbete med andra. -
Hur många PubMed-poster kan jag skrapa gratis?
På Free-nivån kan du skrapa 6 sidor per månad, vilket ofta räcker för mindre övervakningsuppgifter. Med gratis provperiod kan du skrapa 10 sidor gratis för att validera din kolumnsättning och strategi för berikning via subpages. -
Kan jag anpassa kolumner för specifika behov av evidensutvinning?
Ja. Du kan byta namn på kolumner, ställa in datatyper (text/datum/url) och lägga till Field AI Prompts för att extrahera eller märka information som studiedesign, population, intervention, kontroll, utfall eller land från affilieringar. Det hjälper dig att gå längre än rå skrapning och arbeta mer strukturerat med evidens. -
Är det okej att skrapa PubMed?
PubMed är en offentlig resurs, och många team samlar bibliografisk metadata för forskning och analys. Du bör ändå följa tillämpliga lagar, respektera webbplatsens villkor och använda ansvarsfulla skrapningsmetoder, särskilt om du kör stora och frekventa jobb.
📚 Läs mer
- Hämta tillägget: Thunderbit Chrome Extension Download Page
- Utforska guider på Thunderbit Blog
- Lär dig grunderna: What Is Data Scraping and How to Do It in 2025
- Bygg listarbetsflöden: What Is List Crawling and How to Do It Using AI
- Exportera till kalkylblad: How to Scrape Website Data into Excel using AI
- Om du även skrapar PDF:er i forskningsarbete: How to Scrape Data from PDF using AI