
Någonstans just nu sitter någon och skriver in "Thunderbit vs Browserless" i Google och väntar sig en tydlig jämförelse sida vid sida. Problemet? Det är ungefär som att jämföra en matleveransapp med ett kommersiellt kök — båda har med mat att göra, men de är byggda för helt olika personer som gör helt olika saker.
Jag vet det här eftersom mitt team byggde Thunderbit, och jag har tillbringat flera år i SaaS- och automationsvärlden med att se verktyg klumpas ihop trots att de egentligen inte borde jämföras direkt. När jag såg att den här sökningen började få fart ville jag skriva den ärliga guiden som faktiskt hjälper dig att välja — inte en marknadsföringsduell, utan en nykter genomgång av vad varje verktyg gör, vem det passar för och när du kanske till och med vill använda båda. Kodfria dataverktyg och utvecklarfokuserad webbläsarautomatisering har båda vuxit snabbt de senaste åren, och utifrån kan gränserna lätt verka otydliga. Så låt mig gå igenom det jag har lärt mig.
Först och främst: Thunderbit och Browserless är olika typer av verktyg
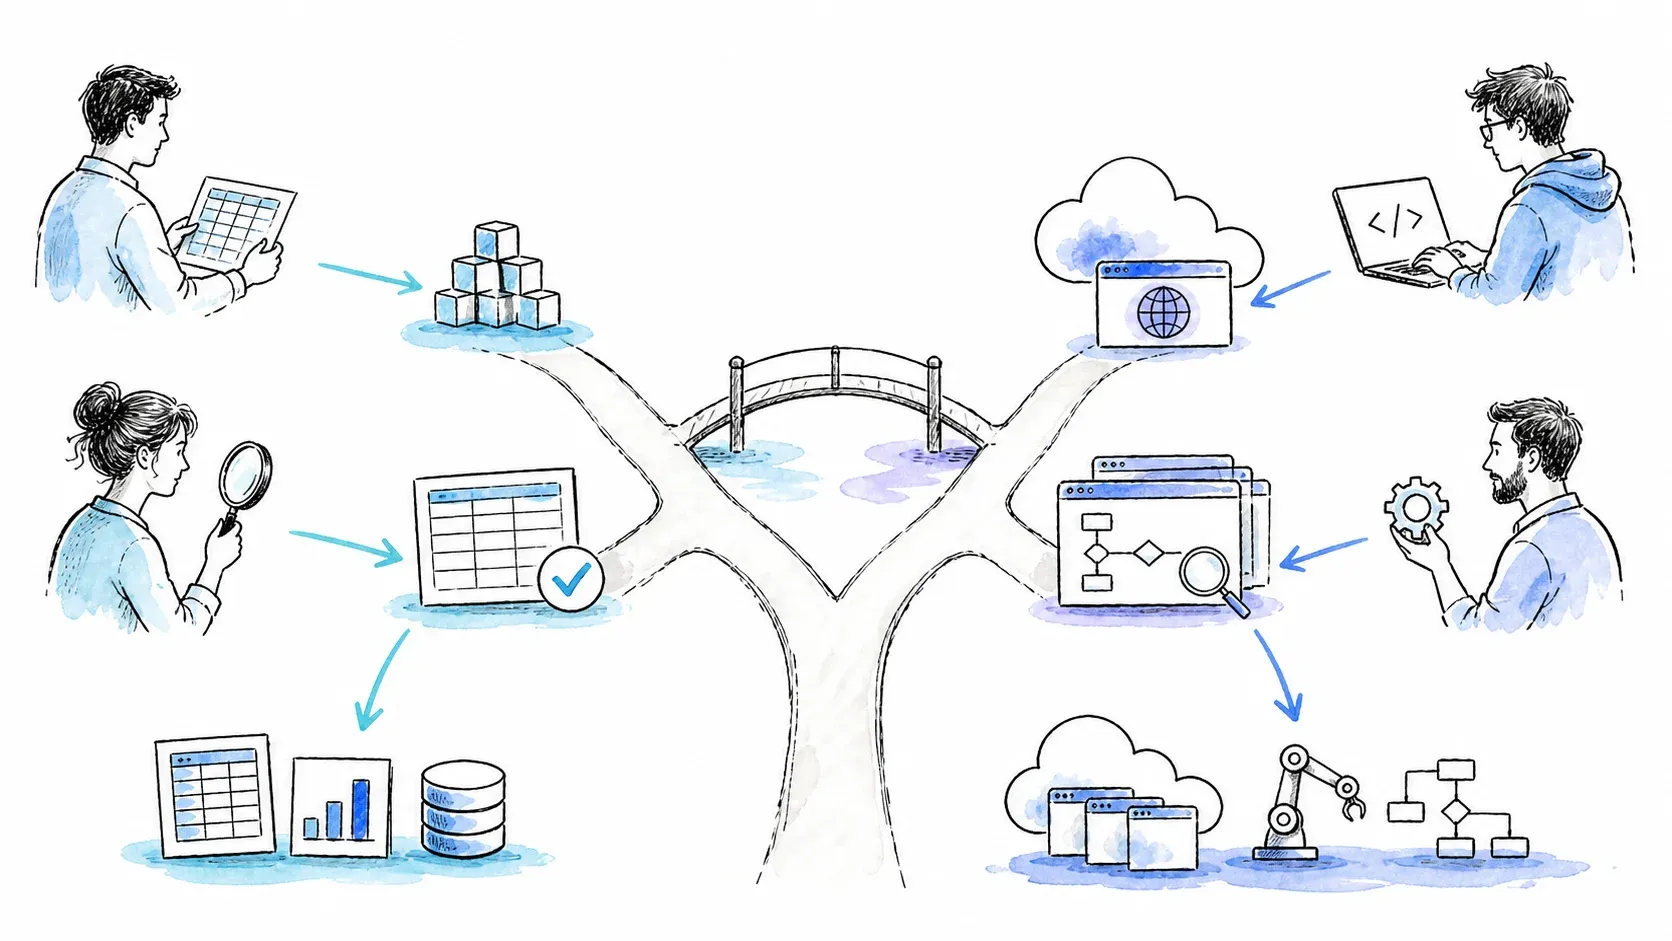
Innan vi jämför en enda funktion eller ett enda pris vill jag rädda dig från onödig förvirring. Thunderbit och Browserless är inte direkta konkurrenter på samma sätt som till exempel två CRM-plattformar är. De ligger på olika nivåer i stacken för webbaserad data.
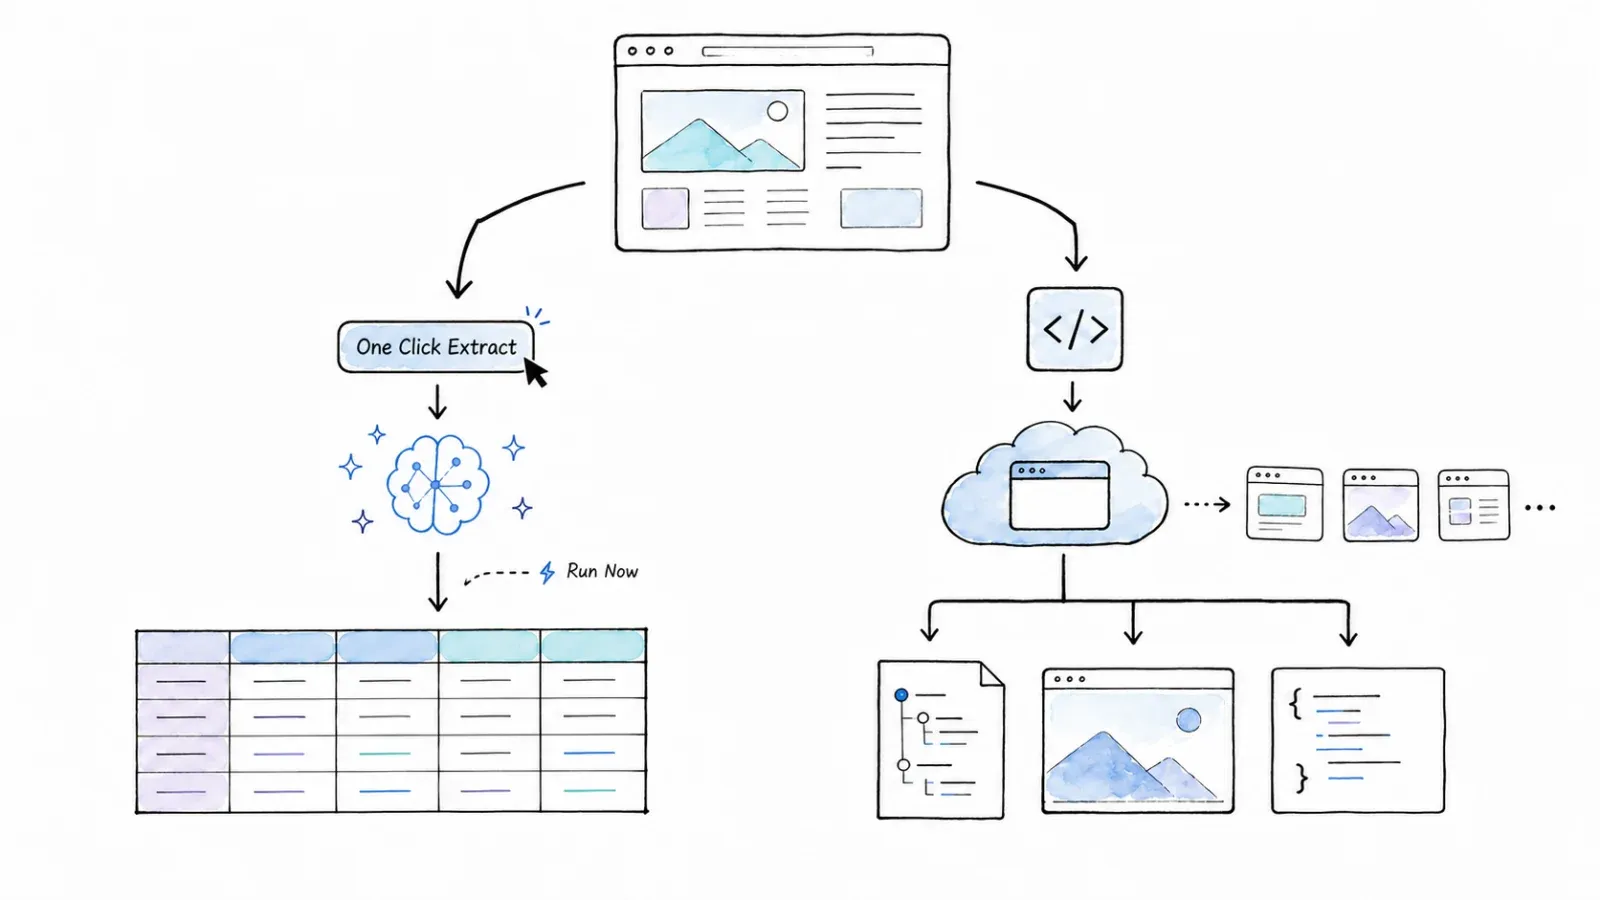
Thunderbit är en agentisk web scraping-lösning och automationsplattform byggd främst för affärsanvändare. Du installerar ett Chrome- eller Edge-tillägg, öppnar en webbsida, låter AI föreslå datakolumner, klickar på skrapa och exporterar strukturerad data till Excel, Google Sheets, Airtable eller Notion. Det finns också ett Open API, MCP Server och CLI för utvecklare, men tyngdpunkten ligger på resultatet: att få ut ren, strukturerad data utan att skriva kod.
Thunderbit är en agentisk web scraper: på en kompatibel, auktoriserad sida klickar du på One Click Extract, och agenten upptäcker, läser och analyserar sidan för att avgöra vad som ska hämtas. Run Now startar direkt, men om du inte gör något startar uppgiften automatiskt — så standardflödet kräver bara ett medvetet klick, utan kod, selektorer eller schemainställningar.
Browserless är hanterad headless-browser-infrastruktur byggd för utvecklare. Det ger dig molnbaserade Chrome-instanser som din Puppeteer-, Playwright- eller CDP-kompatibla kod ansluter till via WebSocket eller REST API. Tyngdpunkten ligger på programmerbar webbläsarkörning — att köra webbläsarsessioner i stor skala, ta skärmbilder, generera PDF:er, hantera botdetektering och ge utvecklare full kontroll över vad som händer inne i webbläsaren.
Här är en snabb tabell som gör skillnaden tydlig:
| Dimension | Thunderbit | Browserless |
|---|---|---|
| Primär användare | Affärsanvändare, operations, sälj, marknad | Utvecklare, DevOps, QA-ingenjörer |
| Gränssnitt | Chrome/Edge-tillägg, webbapp, point-and-click | REST/WebSocket API, BrowserQL, dashboardverktyg |
| Kärnvärde | AI-föreslagen strukturerad dataextraktion | Hanterad headless Chrome/Chromium i skala |
| Installationstid | Minuter (installera tillägg, öppna en sida) | Minuter till timmar (skriv skript, konfigurera API-nycklar) |
| Resultat | Strukturerade rader → Excel, Google Sheets, Airtable, Notion | Renderad HTML, strukturerad JSON, skärmbilder, PDF:er via API |
| Egen hosting | Nej | Ja (Docker, VPC, air-gapped) |
Varför spelar det här roll? För om du är marknadsförare och behöver en lista med leads i ett kalkylark före lunch, behöver du inte starta en hel flotta av headless browsers. Och om du är utvecklare som kör 500 webbläsarsessioner i en CI-pipeline behöver du inte agentiska extraktioner. Nedan jämför vi dem ändå på pris, användningsområden och inlärningskurva — för även om de är olika kategorier måste du fortfarande välja rätt verktyg (eller båda).
Vad är Thunderbit?

Thunderbit är en AI-driven plattform för web scraping och automatisering, utformad så att icke-tekniska användare — tänk säljare, operationschefer, marknadsförare och analytiker — kan hämta strukturerad data från webbplatser utan att skriva en rad kod.
Det vanligaste flödet ser ut så här: du installerar Thunderbit Chrome extension, går till en sida och klickar på "One Click Extract." Agenten läser och analyserar sidan, bestämmer hur extraktionen ska göras och startar sedan automatiskt om du inte väljer "Run Now" för omedelbar körning. Därefter exporterar du datan till Excel, Google Sheets, Airtable eller Notion. Det finns också stöd för paginering, extraktion av undersidor, schemaläggning och återanvändbara mallar.
Thunderbit har också ett Open API (med Distill- och Extract-endpoints), en MCP Server för AI-agentflöden och en CLI. Men kärnan i produkten är den kodfria, webbläsarbaserade upplevelsen. Om du någon gång har önskat att du bara kunde peka på en webbsida och säga "ge mig den datan i ett kalkylark" är det precis det här som är tanken.
Vad är Browserless?
Browserless är en hanterad headless-browser-plattform som låter utvecklare köra Chrome i molnet, så att de slipper hantera webbläsarinfrastruktur själva. "Headless browser" betyder helt enkelt en webbläsare utan synligt fönster — den styrs helt av kod.
Utvecklare kopplar sina Puppeteer-, Playwright- eller CDP-kompatibla skript till Browserless fjärrinstanser via WebSocket eller REST API. I stället för att starta en lokal Chrome-process (som slukar minne och CPU) körs webbläsaren på Browserless servrar. Browserless erbjuder också BrowserQL, ett GraphQL-baserat automationslager med inbyggda åtgärder för navigation, klick, skrivande, scrollning, extraktion, skärmbilder, PDF:er, CAPTCHA-hantering med mera. Deras REST APIs stöder renderat innehåll, selektorkonfigurerad strukturerad scraping, Smart Scrape, skärmbilder, PDF:er och egna Puppeteer-funktioner.
Browserless är dock inte strikt "kod endast". Det finns dashboards och sandbox-miljöer, en AI-kodgenerator, MCP integration samt kopplingar för n8n, Make och Zapier. Men kärnan är utvecklarfokuserad: du skriver logiken, Browserless levererar webbläsarmotorn och infrastrukturen. Det finns också ett self-hosted alternativ (Docker, VPC, air-gapped) för team som behöver datalokalisering eller kontroll över infrastrukturen — även om den publika Docker-bilden och den kommersiella molnprodukten inte är helt identiska i funktionalitet.
Thunderbit vs Browserless i korthet: jämförelse sida vid sida
Här är en mer komplett jämförelse över de dimensioner som faktiskt spelar roll:
| Dimension | Thunderbit | Browserless |
|---|---|---|
| Målgrupp | Affärsanvändare, icke-kodare, operations, sälj, marknad | Utvecklare, DevOps, QA-ingenjörer |
| Gränssnitt | Chrome/Edge-tillägg, webbapp, API, MCP, CLI | REST/WebSocket API, BrowserQL, dashboard, MCP, n8n/Make/Zapier |
| AI-driven extraktion | Ja — One Click Extract, fältinstruktioner | Ingen inbyggd agentisk extraktion; erbjuder Smart Scrape och BrowserQL-extraktion |
| Tid till första resultat | Minuter (installera tillägg, öppna sida, skrapa) | Minuter till timmar (skaffa API-nyckel, skriv/konfigurera skript, kör) |
| Kod krävs | Nej (tillägg/webbapp); valfritt (API/MCP/CLI) | Ja för kärnflöden; lågkod via MCP/integrationer |
| Datautmatning/export | Strukturerade rader → Excel, CSV, Google Sheets, Airtable, Notion | Renderad HTML, strukturerad JSON, skärmbilder, PDF:er, egna utdata via API |
| Paginering/undersidor | Inbyggt, konfigurerbart i UI | Definieras av användaren i kod eller BrowserQL |
| Schemaläggning | Stöds på kvalificerade planer/yta | Hanteras av användaren (via kod, cron eller tredjepartsorkestrering) |
| Botdetektering/stealth | Hanterad rendering på stödda sidor; ingen garanti | BrowserQL stealth, residential/datacenter-proxies, CAPTCHA-hantering; ingen garanti |
| Egen hosting | Nej | Ja (Docker, VPC, air-gapped; SSPL/kommersiell dual licens) |
| Integrationer | Direkt export till affärsverktyg; API/MCP/CLI för utvecklarflöden | Puppeteer/Playwright/CDP, MCP, n8n, Make, Zapier, agent-SDK:er |
| Primära användningsområden | Lead scraping, marknadsresearch, ad hoc-datainsamling, schemalagd extraktion | Webbläsartestning, automation, skärmbilder/PDF:er, anti-bot scraping, agentanvändning av verktyg |
Om du är säljare och behöver lead-data i ett kalkylark före lunch är Thunderbit byggt för dig. Om du är utvecklare och behöver köra 500 headless-webbläsarsessioner i en CI-pipeline är Browserless byggt för dig. Överlappet finns i "att få data från webbsidor", men tillvägagångssättet och upplevelsen är som natt och dag.
Kunskapsnivå och inlärningskurva: Thunderbit vs Browserless
I undersökningen dök en fråga upp gång på gång: "Vilket verktyg passar min kunskapsnivå?" Så här vill jag vara tydlig.
Vad du behöver kunna för att använda Thunderbit
Du behöver inte kunna koda. Thunderbit browser extension är byggt så att du kan installera det, öppna en webbsida, klicka på en knapp och få strukturerad data. One Click Extract låter agenten läsa och analysera sidan, bestämma utdata och starta extraktionen automatiskt. För de flesta affärsanvändare tar flödet från installation till exporterad data bara några minuter.
Löpande underhåll är i regel lättare eftersom AI:n hjälper till med schemaförslag och anpassar sig till stödda sidor, så du slipper underhålla CSS-selektorer eller XPath-uttryck i kod. Dokumentationen är visuell, med guider och tutorials för affärsanvändare. För mer komplexa programflöden eller tung speciallogik har no-code-gränssnittet sina gränser — då kommer API, MCP eller CLI in.
Vad du behöver kunna för att använda Browserless
Browserless förväntar sig att du är bekväm med JavaScript eller Python, känner till Puppeteer eller Playwright och är van vid API-nycklar och WebSocket-anslutningar. Du skriver skripten som talar om för webbläsaren vad den ska göra — navigera, klicka, vänta, extrahera och ta skärmbilder. Tiden från registrering till första resultat beror på din erfarenhet, men även för en van utvecklare tar det vanligtvis längre att få ett nytt skript att fungera mot ett verkligt mål än att använda ett point-and-click-flöde.
När en målsida ändrar struktur uppdaterar du selektorer och logik i kod. Dokumentationen är utvecklarorienterad: kodexempel, API-referens och en aktiv GitHub community (cirka 13 500+ stjärnor enligt mitten av 2026). För utvecklare är den här flexibiliteten en fördel — du kontrollerar varje detalj i webbläsarsessionen.
Snabb jämförelsetabell: inlärningskurva
| Faktor | Thunderbit | Browserless |
|---|---|---|
| Tekniska förkunskaper | Inga — webbläsartillägg, point-and-click | JavaScript/Python, kännedom om API:er |
| Tid till första resultat | Några minuter (installera → AI-förslag → skrapa) | Varierar: 15 min till över en timme (API-nyckel → skript → kör) |
| Löpande underhåll | Lägre för stödda sidor (AI-assisterat schema) | Högre (underhåll skript, uppdatera selektorer i kod) |
| Dokumentationsstil | Visuella guider, tutorials för affärsanvändare | Utvecklardokumentation, kodexempel, API-referens |
| Community/support | Direkt support | Aktiv GitHub, utvecklargemenskap |
Inget av verktygen är "bättre" här — det beror på vem du är. En icke-teknisk användare kommer sannolikt uppleva Browserless som överdrivet. En utvecklare som vill ha full kontroll kan däremot tycka att Thunderbits no-code-gränssnitt blir begränsande för komplex automatisering.
Thunderbit vs Browserless-pris: vad kostar de?
Priset är en av de vanligaste beslutsfaktorerna — och en av de mest föränderliga. Planer, priser och gränser ändras. Jag delar den bästa informationen som finns tillgänglig i mitten av 2026, men kontrollera alltid respektive verktygs officiella prissida innan du bestämmer dig.
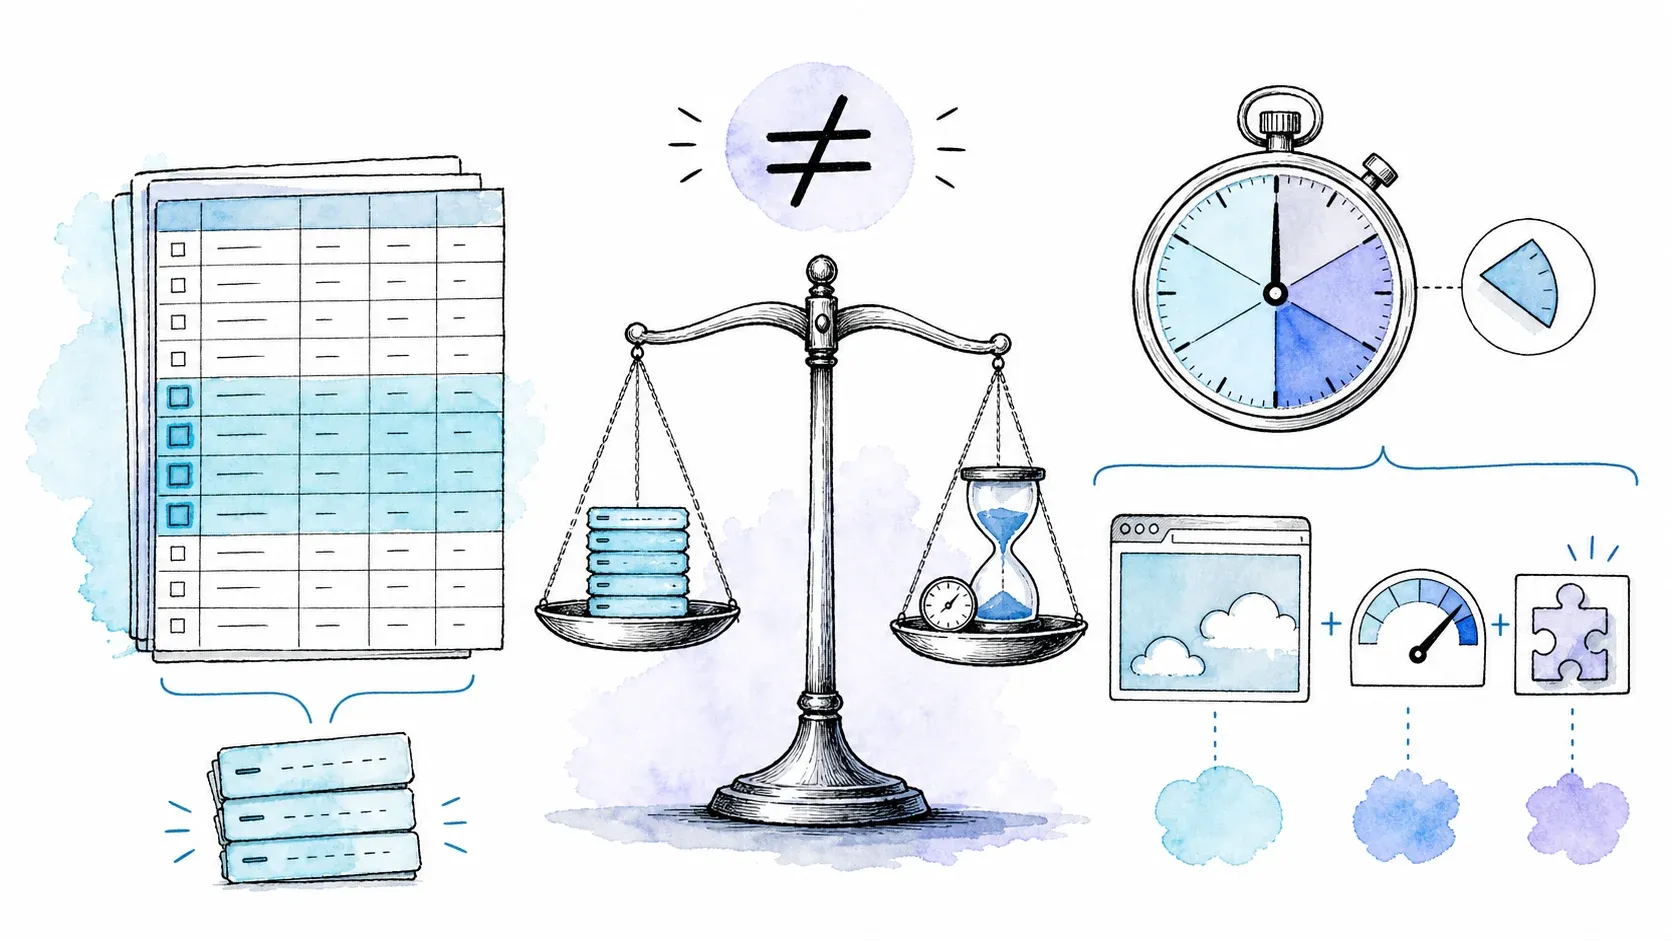
Den strukturella skillnaden är viktig: Thunderbit debiterar per sidkredit (kopplat till resultat-rader och operationer), medan Browserless debiterar per compute-enhet (kopplat till webbläsarsessionens tid och eventuella avgifter för bandbredd/CAPTCHA). Dessa enheter är inte utbytbara, så en direkt krona-för-krona-jämförelse kräver att du vet exakt vilken typ av arbetsbelastning du har.
Thunderbit-priser i översikt
Ögonblicksbild från Thunderbits prissida:
| Plan | Månadsvis | Årsvis (effektiv) | Krediter |
|---|---|---|---|
| Free | $0 | $0 | 6 sidor/månad |
| Starter | $15/mån | ~ $9/mån (faktureras årsvis) | 500/mån eller 5 000/år |
| Pro 1 | $38/mån | ~ $24/mån (faktureras årsvis) | 3 000/mån eller 30 000/år |
| Pro 2 | $75/mån | ~ $48/mån (faktureras årsvis) | 6 000/mån eller 60 000/år |
| Pro 3 | $125/mån | ~ $96/mån (faktureras årsvis) | 10 000/mån eller 120 000/år |
| Pro 4 | $249/mån | ~ $192/mån (faktureras årsvis) | 20 000/mån eller 240 000/år |
| Business | Anpassad | Anpassad | Anpassad |
En standardresultatrad kostar 1 kredit; en rad från en undersida kostar 2 krediter. Thunderbit har också separat API-prissättning för utvecklarflöden (Distill: 1 API-enhet/sida, Extract: 20 API-enheter/sida). Free-planen låter dig testa flödet, även om utrymmet är begränsat.
Browserless-priser i översikt
Ögonblicksbild från Browserless prissida för molntjänsten:
| Plan | Årsvis (effektiv månadskostnad) | Månadsvis | Enheter/månad | Samtidighet (årsvis/månadsvis) | Maxsession |
|---|---|---|---|---|---|
| Free | $0 | $0 | 1 000 | 2 / 2 | 1 min |
| Prototyping | $25/mån | $35/mån | 20 000 | 10 / 5 | 15 min |
| Starter | $140/mån | $200/mån | 180 000 | 40 / 30 | 30 min |
| Scale | $350/mån | $500/mån | 500 000 | 100 / 80 | 60 min |
| Enterprise | Anpassad | Anpassad | Anpassad | Anpassad | Anpassad |
En webbläsaranslutning kostar 1 enhet per påbörjat 30-sekundersintervall — delvisa intervall avrundas uppåt. Trafik via residential-proxy ger 6 enheter/MB; datacenter-proxy ger 2 enheter/MB. CAPTCHA-hantering förbrukar också extra enheter. Betalda planer inkluderar överförbrukning till $0.0015–$0.0020 per enhet. Self-hosted Docker-bilden finns under SSPL/kommersiell dual licens, men den öppna källkodsversionen innehåller inte alla kommersiella funktioner (BrowserQL, avancerad stealth, replay med mera), och du betalar fortfarande för din egen infrastruktur.
Prisjämförelse sida vid sida
| Thunderbit (kodfritt) | Browserless (moln) | |
|---|---|---|
| Gratis nivå | 6 sidor/månad | 1 000 enheter |
| Billigaste betalplan | $15/mån (Starter, 500 krediter) | $25–$35/mån (Prototyping, 20 000 enheter) |
| Mellansegment | $38–$75/mån (Pro 1–2) | $140–$200/mån (Starter) |
| Högre segment | $125–$249/mån (Pro 3–4) | $350–$500/mån (Scale) |
| Debiteringsenhet | Sidkrediter (resultatrader) | Compute-enheter (30-sekundersintervall + proxy/CAPTCHA) |
| Egen hosting | Nej | Ja (SSPL/kommersiell licens) |
Thunderbits prissättning är utformad för affärsanvändare som vill ha förutsägbara kostnader per skrapad sida. Browserless prissättning är byggd för utvecklare som behöver beräkningstid för webbläsarsessioner. Om du försöker jämföra dem per uppgift behöver du uppskatta hur många krediter eller enheter just ditt flöde förbrukar — och uträkningen kommer att se helt olika ut för en leadlista med 10 rader jämfört med en crawl på 10 000 sidor.
Thunderbit vs Browserless: användningsfall och rekommendationer
Det här är avsnittet jag önskar att alla jämförelseartiklar hade: en praktisk "välj detta om…"-guide. För varje scenario ger jag en rekommendation och en kort motivering.
| Användningsfall | Bättre val | Varför |
|---|---|---|
| Skrapa säljleads (kataloger, företagslistor) | Thunderbit | Kodfritt, One Click Extract, export till Sheets/Excel/Airtable. En säljare kan extrahera leads på några minuter. |
| Webbläsartestning i CI/CD i stor skala | Browserless | Byggt för programmatisk Puppeteer/Playwright-körning, parallella sessioner och pipeline-integration. |
| Marknadsresearch och konkurrentbevakning | Beroende | Thunderbit för kodfri schemalagd extraktion; Browserless + egna skript för komplexa renderade sidor. |
| AI-agenters interaktion med webben (Claude, LangChain) | Beroende | Thunderbit via MCP/API för strukturerad extraktion; Browserless via REST/WebSocket för rå webbläsarkontroll. |
| Sajter med stark botdetektering / många CAPTCHA | Browserless | BrowserQL stealth, proxies, CAPTCHA-hantering — även om inget verktyg kan garantera åtkomst. |
Skrapa säljleads
Om du jobbar med sälj, operations eller rekrytering och behöver en lista med namn, e-postadresser eller företagsuppgifter från en katalog- eller listningssida är Thunderbit det mest raka alternativet. Du öppnar sidan, låter AI föreslå fälten, skrapar och exporterar till Google Sheets eller Airtable. Ingen kod, ingen infrastruktur. Browserless kan tekniskt sett göra samma sak, men då måste du skriva och underhålla ett anpassat skript — och för de flesta affärsanvändare är det ett stopp redan där. (Läs mer om det här flödet i vår guide om AI lead generation.)
CI/CD-webbläsartestning och QA-automatisering
Browserless är byggt för detta. Om ditt team kör automatiserade webbläsartester i en CI/CD-pipeline behöver du parallella headless-webbläsarsessioner, inte ett gränssnitt för dataextraktion. Thunderbit är inte byggt för det här användningsfallet.
Marknadsresearch och konkurrentbevakning
Det beror på ditt team. Om du har en icke-teknisk analytiker som behöver bevaka konkurrenters priser eller produktlistningar är Thunderbits schemalagda extraktion (på planer där det stöds) med direkt export det enklare valet. Om målsidorna är tungt renderade, kräver komplexa interaktioner eller behöver avancerad stealth, får en utvecklare med Browserless och egna skript mer kontroll. (För mer om web scraping utan kod har vi skrivit en separat guide.)
AI-agents webinteraktion
Båda verktygen har MCP-integrationer och API-gränssnitt för agentflöden. Thunderbits MCP Server och API är inriktade på strukturerade extraktionsuppgifter — agenten ber om data, Thunderbit returnerar rena rader. Browserless MCP och agent SDK-anslutningar är inriktade på rå webbläsarkontroll — agenten navigerar, klickar, fyller i formulär eller hanterar komplexa sidinteraktioner. Rätt val beror på om din agent behöver strukturerad data eller full kontroll över webbläsaren.
Sajter med stark botdetektering och mycket CAPTCHA
Browserless erbjuder mer tydliga kontroller här: BrowserQL stealth mode, fingeravtryckssanering, residential- och datacenter-proxies samt CAPTCHA-hantering. Thunderbits hanterade rendering klarar vissa anti-bot-utmaningar på stödda sidor, men det är inte byggt som ett generellt verktyg för att kringgå botdetektering. Browserless egen dokumentation medger också att avancerad fingerprinting eller interaktiva CAPTCHA fortfarande kan stoppa automatisering — inget verktyg garanterar framgång på alla sajter.
När du kan använda båda: det kompletterande flödet
Många jämförelseartiklar hoppar över det här helt, men du kanske inte behöver välja.
Många organisationer har både tekniska och icke-tekniska databehov. En utvecklare i teamet kan använda Browserless för att hantera komplexa renderade sidor, köra webbläsartester eller bygga en datapipeline för storskalig extraktion. Samtidigt kan en affärsanalytiker eller säljare använda Thunderbits browser extension för snabba, ad hoc-extraktioner — till exempel att hämta en leadlista från en ny katalog, kontrollera konkurrenters priser eller samla in kompletterande data från en källa som inte motiverar ett helt utvecklingsprojekt.
Ett annat scenario: en utvecklare bygger en schemalagd crawl med Browserless för löpande bevakning, och en person i operations-teamet använder Thunderbit för att snabbt hämta data från en ny källa som just dök upp på ett möte — inget ärende, ingen väntan, ingen kodgranskning.
Det här är inte en påtvingad mersäljning — det är bara så blandade team faktiskt arbetar. Om ditt team har både kodare och icke-kodare som behöver webbaserad data kan det spara tid för alla att använda båda verktygen där de är som starkast.
Thunderbit vs Browserless: sammanfattning av för- och nackdelar
Thunderbit: för- och nackdelar
Fördelar:
- Ingen kod krävs i kärnflödet
- One Click Extract läser sidan och föreslår ett strukturerat schema
- Snabb tid till första resultat för icke-tekniska användare
- Direkt export till affärsvänliga format (Excel, Google Sheets, Airtable, Notion)
- Webbläsartillägget fungerar på sidan du redan besöker
- Lägre underhåll för stödda sidor (AI-assisterade schemaförslag)
- API, MCP och CLI finns för utvecklarflöden
Nackdelar:
- Inte byggt för programmatisk CI/CD eller webbläsartestning
- Mindre flexibilitet för komplex speciallogik eller flerstegsautomatisering i webbläsaren
- Ingen möjlighet till self-hosting
- agentiska extraktioner kan kräva manuell justering på ovanliga eller komplexa sidor
- Mindre utvecklargemenskap än Browserless
Browserless: för- och nackdelar
Fördelar:
- Full programmerbar kontroll över webbläsarsessioner
- Stöder Puppeteer, Playwright och CDP-kompatibla klienter
- Avancerad botdetekteringshantering (BrowserQL stealth, proxies, CAPTCHA-hantering)
- Self-hosted-alternativ för datalokalisering och kontroll över infrastrukturen
- Skalar samtidighet för stora arbetslaster (beroende på plan)
- Stark utvecklargemenskap (~13 500+ GitHub stars)
- Integrationer för MCP, n8n, Make, Zapier och agent-SDK:er
- SOC 2 Type II-efterlevnad anges (Trust Center)
Nackdelar:
- Kräver kodningskunskaper i kärnflöden
- Högre underhåll (skript går sönder när målsidor ändras)
- Brantare inlärningskurva för icke-utvecklare
- Utdata kräver extra logik för strukturering och export (ingen inbyggd agentisk extraktion eller bestående visuell tabell)
- Egen hosting flyttar ansvar för infrastruktur, patchning, övervakning och licensiering till operatören
- SSPL/kommersiell dual licens för öppen källkod-bilden — inte OSI-godkänd öppen källkod
Slutsatsen: så väljer du rätt verktyg för ditt team
Thunderbit och Browserless löser olika problem för olika människor. Thunderbit är för affärsanvändare som vill ha strukturerad data snabbt, utan kod, exporterad till de verktyg de redan använder. Browserless är för utvecklare som behöver skalbar, programmerbar webbläsarinfrastruktur med full kontroll över vad som händer i webbläsaren.
Här är en snabb beslutsguide:
- Välj Thunderbit om: du jobbar med sälj, operations, marknad eller research; du inte kodar; du vill ha data i ett kalkylark eller Airtable på några minuter; du behöver AI-stödd fältselektion och direkt export. (Testa här)
- Välj Browserless om: du är utvecklare eller DevOps-ingenjör; du skriver Puppeteer-/Playwright-skript; du behöver webbläsartestning, anti-bot-hantering, skärmbilder/PDF:er eller self-hosted infrastruktur. (Se plattformen)
- Överväg båda om: ditt team består av både tekniska och icke-tekniska personer som behöver webbaserad data, och du vill att varje grupp ska använda det verktyg som passar deras arbetsflöde.
Det finns ingen universell vinnare här — bara rätt verktyg för rätt jobb.
FAQ: Thunderbit vs Browserless
Kan Thunderbit ersätta Browserless (eller tvärtom)?
Inte direkt, eftersom de riktar sig till olika målgrupper och användningsfall. Thunderbit är en hanterad extraktionsplattform för affärsanvändare som vill ha strukturerad data utan kod. Browserless är programmerbar webbläsarinfrastruktur för utvecklare som behöver anpassad kontroll över webbläsaren. Överlappet finns i enkel web scraping, men tillvägagångssätt, gränssnitt och resultat är fundamentalt olika. En säljare skulle inte använda Browserless för leadlistor, och en utvecklare skulle inte använda Thunderbit för webbläsartestning i CI/CD.
Behöver jag kodkunskaper för att använda Thunderbit?
Nej. Webbläsartillägget och Web App är byggda för icke-tekniska användare — installera, öppna en sida, klicka på One Click Extract, låt uppgiften starta automatiskt och exportera. För utvecklare som vill ha programmatisk åtkomst erbjuder Thunderbit också ett Open API, MCP Server och CLI.
Kan Browserless exportera data till Google Sheets eller Excel?
Inte inbyggt. Browserless returnerar webbläsarutdata — renderad HTML, strukturerad JSON (via Smart Scrape, BrowserQL eller egna funktioner), skärmbilder och PDF:er. För att få in datan i ett kalkylark behöver du skriva extra kod eller använda ett separat verktyg för att strukturera och exportera den. Thunderbit har däremot inbyggd export till Excel, Google Sheets, Airtable och Notion.
Är Browserless gratis att använda?
Browserless erbjuder en gratis nivå med 1 000 enheter per månad (inte 1 000 sessioner — en enda session kan förbruka flera enheter). Den öppna Docker-bilden kan self-hostas, men den körs under SSPL/kommersiell dual licens och innehåller inte alla kommersiella funktioner. Betalda planer ger fler enheter, högre samtidighet och fler funktioner. Kontrollera den officiella prissidan för aktuella uppgifter.
Vilket verktyg är bäst för att skrapa LinkedIn eller liknande skyddade sajter?
Inget av verktygen garanterar åtkomst till någon specifik sida. Respektera alltid plattformarnas användarvillkor, krav på behörighet och gällande lagstiftning. Browserless stealth-funktioner och CAPTCHA-hantering är utformade för att hantera botdetektering, medan Thunderbits Browser Mode kan fungera inom en auktoriserad lokal webbläsarsession. För skyddade sajter är den viktigaste faktorn om du har legitim åtkomst och agerar inom plattformens regler — inte vilket skrapverktyg du använder. (För mer sammanhang, se vårt inlägg om scraping LinkedIn.)
Läs mer
- Hur du bemästrar automatiserad dataextraktion med Thunderbit
- Guide till webbläsarautomatisering: automatisera webbplatsåtgärder utan att skriva kod
- Jag körde Playwright och Puppeteer genom samma scrapingtest
- Topp 10 no-code web scrapers för automatiserade lösningar
- Vad är web scraping? Allt du behöver veta




