
Zillow sitter på 160 miljoner amerikanska fastighetsregister, och att få ut den datan i stor skala är en av de mest efterfrågade — och mest frustrerande — uppgifterna inom fastighetsdata. Om du någon gång har försökt skrapa Zillow och bara hamnat framför en CAPTCHA-sida i stället för bostadsannonser, är du långt ifrån ensam.
Jag har lagt mycket tid på att undersöka och testa olika sätt att skrapa Zillow — både med Python och med no-code-verktyg som vi har byggt på Thunderbit. Den här guiden täcker båda spåren. Oavsett om du vill ha en komplett genomgång i Python med anti-bot-strategier, eller bara behöver 200 annonser i ett kalkylblad före lunch, finns det något här för dig. Vi går igenom varför Zillow-data är värdefull, hur sajten är uppbyggd bakom kulisserna, en steg-för-steg-guide i Python, exakt varför skrapare går sönder, och hur du kan automatisera återkommande skrapningar för prisbevakning.
Varför skrapa Zillow-data överhuvudtaget?
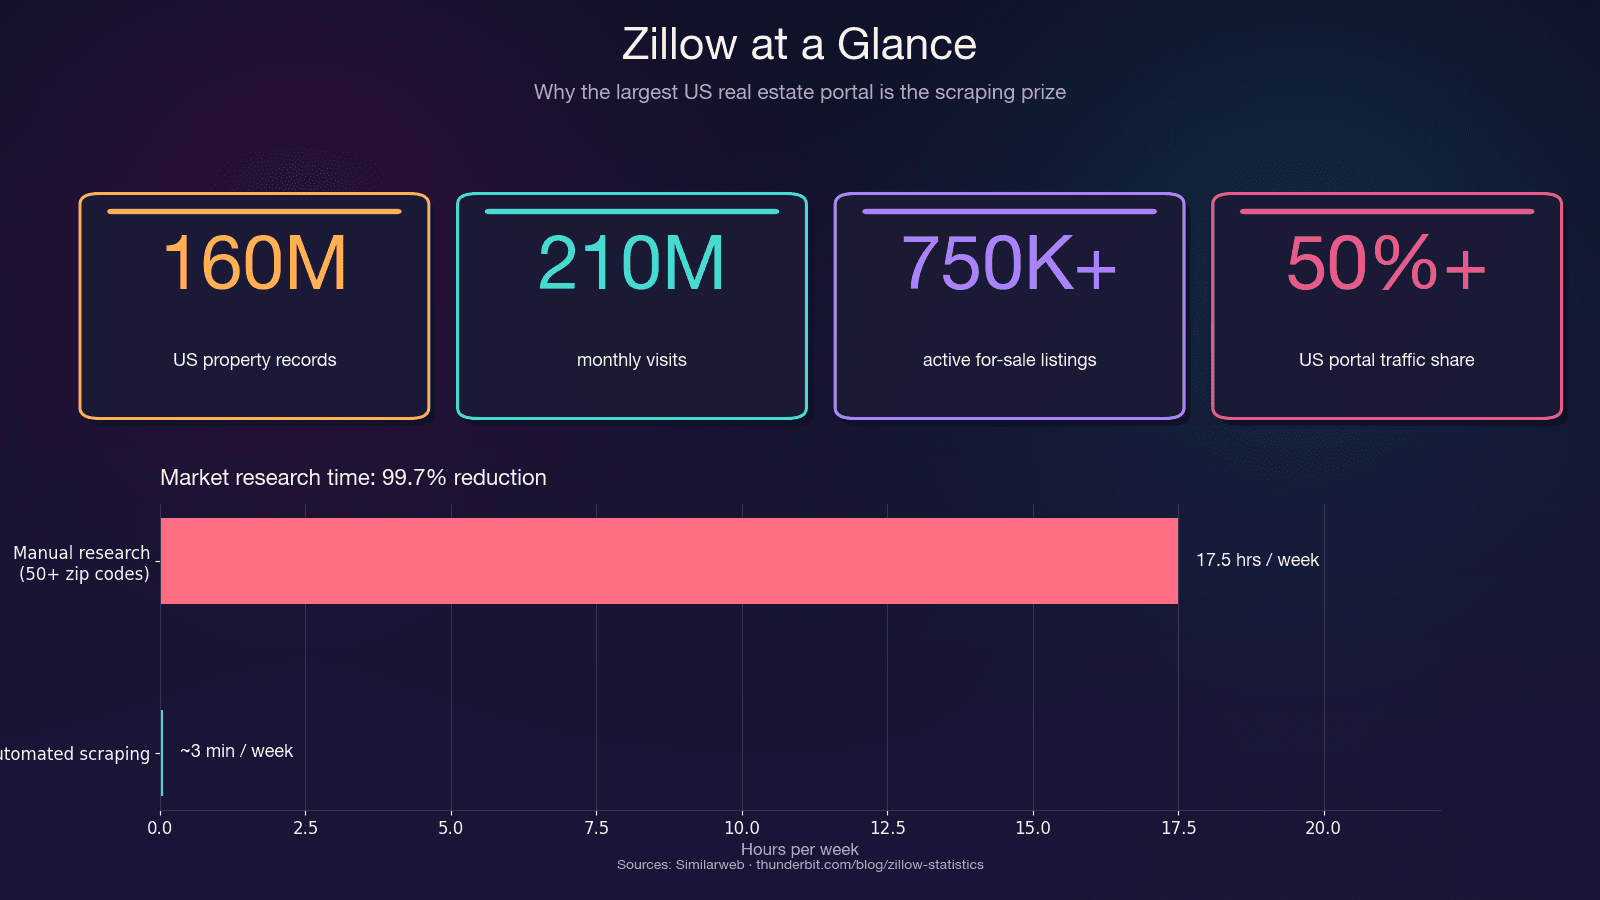
Zillow är den största samlingsplatsen för bostadsdata i USA. Sajten drar in 210 miljoner besök per månad och har omkring 750 000+ aktiva bostäder till salu plus 1,9 miljoner hyresannonser. Plattformen står för mer än 50 % av all trafik till amerikanska fastighetsportaler — mer än dubbelt så mycket som närmaste konkurrent.
Innan du hoppar in i Python-kod är det viktigt att veta att skrapning av Zillow med Python inte är det enda alternativet, och att välja fel metod kan kosta dig timmar. Python-verktyg som httpx och BeautifulSoup kräver medelhög teknisk nivå, manuell hantering av headers och proxies, kör i måttlig hastighet (1–3 sekunder per sida) och behöver regelbundet underhåll, även om de är gratis; Selenium eller Playwright förbättrar anti-bot-hanteringen genom att rendera JavaScript, men är långsammare (5–15 sekunder per sida) och fortfarande underhållskrävande; scraping-API:er som ScraperAPI eller ScrapFly är snabbare med inbyggt anti-bot-stöd och måttligt underhållsbehov, men kostar 30–599 dollar per månad; Zillows officiella API via Bridge Interactive är snabbt och kräver lite underhåll, men är begränsat och kostar runt 500 dollar per månad; och no-code-verktyg som Thunderbit är nybörjarvänliga, snabba, kräver inget underhåll tack vare AI-anpassning och erbjuder vanligtvis en freemium-modell.
Tidsbesparingen i sig är betydande. Manuell research över 50+ postnummerområden kan lätt sluka 15–20 timmar i veckan. Automatiserad skrapning gör samma jobb på några minuter — en minskning av tidsåtgången med 99,7 %.
Alla sätt att skrapa Zillow: Python vs API vs no-code (jämförelse)
Innan du hoppar in i Python-kod, vet att "skrapa Zillow med Python" inte är enda vägen. Att välja fel metod kostar timmar. Här är en sida-vid-sida-jämförelse så att du kan välja rätt själv:
| Metod | Kunskapsnivå | Anti-bot-hantering | Hastighet | Underhåll | Kostnad |
|---|---|---|---|---|---|
| Python + httpx/BeautifulSoup | Medelnivå | Manuell (headers, proxies) | Måttlig (1–3 s/sida) | Hög (selectors går sönder) | Gratis |
| Python + Selenium/Playwright | Medelnivå | Bättre (renderar JS) | Långsam (5–15 s/sida) | Hög | Gratis |
| Scraping API (ScraperAPI, ScrapFly) | Medelnivå | Inbyggt | Snabb | Medel | 30–599 $/mån |
| Zillows officiella API (Bridge Interactive) | Nybörjare–medelnivå | N/A | Snabb | Låg | ~500 $/mån, begränsad åtkomst |
| No-code-verktyg (Thunderbit) | Nybörjare | Inbyggt (AI anpassar sig) | Snabb | Inget (AI läser om sidan) | Freemium |
Om du behöver data direkt utan att skriva kod, börja med Thunderbit. Om du vill förstå tekniken bakom eller behöver full anpassning, fortsätt läsa för Python-genomgången.
Det 2-minuterssnabba sättet: skrapa Zillow med Thunderbit (ingen kod behövs)
Innan vi går på djupet med Python finns här vägen för dig som bara behöver Zillow-data snabbt — ingen Python-installation, ingen proxykonfiguration, inget underhåll av selectors. Vi byggde det här arbetsflödet på Thunderbit just för att kunna hämta strukturerad fastighetsdata utan tekniskt overhead.
Svårighetsgrad: Nybörjare
Tidsåtgång: ~2 minuter
Du behöver: Chrome-webbläsare, Thunderbit Chrome Extension (gratisversionen räcker)
Steg 1: Installera Thunderbit och öppna Zillow
Installera Thunderbit-tillägget från Chrome Web Store. Gå till en Zillow-sida med sökresultat — till exempel en sökning efter bostäder i Houston, TX.
Steg 2: Klicka på "AI Suggest Fields"
Öppna Thunderbit-sidopanelen och klicka på "AI Suggest Fields." AI:n läser sidan och föreslår automatiskt kolumner som pris, adress, antal sovrum, badrum, yta, Zestimate, annons-URL och mer. I mina tester identifierar den vanligtvis 20+ fält utan någon manuell konfigurering.
Steg 3: Klicka på "Scrape"
Tryck på Scrape-knappen. Data fylls i som en strukturerad tabell i tillägget. Thunderbit hanterar Zillows paginering automatiskt — både klickbaserad och oändlig scroll.
Steg 4: Berika med skrapning av undersidor
Vill du ha detaljer som skattehistorik, skolbetyg eller prisutveckling? Använd "Scrape Subpages" för att berika tabellen. Thunderbit följer varje annons-URL och hämtar de extra fälten — ingen extra kod krävs.
Steg 5: Exportera
Exportera till Google Sheets, Excel, Airtable eller Notion. Exporten är gratis.
Varför Thunderbit fungerar bra för Zillow
Den verkliga fördelen här är robusthet. Thunderbits AI läser sidans struktur på nytt varje gång du skrapar. När Zillow ändrar sin layout (vilket händer ofta) finns inga sköra CSS-selectors som måste fixas. AI:n anpassar sig automatiskt. Det här löser faktiskt den "inbyggt bräckliga" naturen hos kodade skrapare som frustrerar så många användare.
Vilken data kan du skrapa från Zillow? (20+ fält)
De flesta guider hämtar pris och adress och stannar där. Zillow-listningar innehåller faktiskt mycket mer data än många tror — här är en referenstabell:
| Fält | Var det finns | Svårighetsgrad att extrahera |
|---|---|---|
| Annonspris | Sök + detaljsida | Lätt |
| Adress / postnummer | Sök + detaljsida | Lätt |
| Zestimate | Sök + detaljsida | Lätt |
| Prishistorik (varje händelse) | Detaljsida | Svårt (nästlad JSON) |
| Skattehistorik | Detaljsida | Svårt (nästlad JSON) |
| Sovrum / badrum / kvadratmeter | Sök + detaljsida | Lätt |
| Byggår | Detaljsida | Lätt |
| Avgift till bostadsrättsförening | Detaljsida | Medel |
| Walk Score / Transit Score | Detaljsida (iframe) | Svårt (kräver JS-rendering) |
| Skolbetyg | Detaljsida | Medel |
| Tomtstorlek | Detaljsida | Lätt |
| Dagar på Zillow | Sök | Lätt |
| Mäklare / förmedling | Sök + detaljsida | Medel |
| MLS-nummer | Detaljsida | Lätt |
| Bostadstyp | Sök + detaljsida | Lätt |
| Latitude / longitude | __NEXT_DATA__ JSON | Medel |
| Beskrivningstext | Detaljsida | Lätt |
| Bild-URL:er | Sök + detaljsida | Medel |
| Rent Zestimate | Detaljsida | Medel |
| Närliggande jämförbara försäljningar | Detaljsida | Svårt |
De "svåra" fälten — prishistorik, skattehistorik, jämförbara försäljningar — ligger i nästlad JSON på detaljsidorna. Python-delen längre ner visar exakt hur du extraherar dem. Och om du hellre vill slippa kodandet, känner Thunderbits AI Suggest Fields automatiskt igen de flesta av dessa kolumner, och Subpage Scraping hämtar detaljsidans fält åt dig automatiskt.
Så sätter du upp din Python-miljö för att skrapa Zillow
Svårighetsgrad: Medelnivå
Tidsåtgång: ~5 minuter för installation, ~30 minuter för hela guiden
Du behöver: Python 3.8+, Chrome-webbläsare (för att inspektera sidor), en texteditor eller IDE
Installera de bibliotek som behövs:
pip install httpx beautifulsoup4 pandas lxml
Det här gör varje paket:
- httpx — HTTP-klient med bättre prestanda än
requestsoch stöd för async - beautifulsoup4 + lxml — HTML-parsning
- pandas — export av data till CSV/Excel
- Valfritt: selenium eller playwright om du behöver rendera JavaScript-tunga sidor
Förstå Zillows sidstruktur innan du skrapar
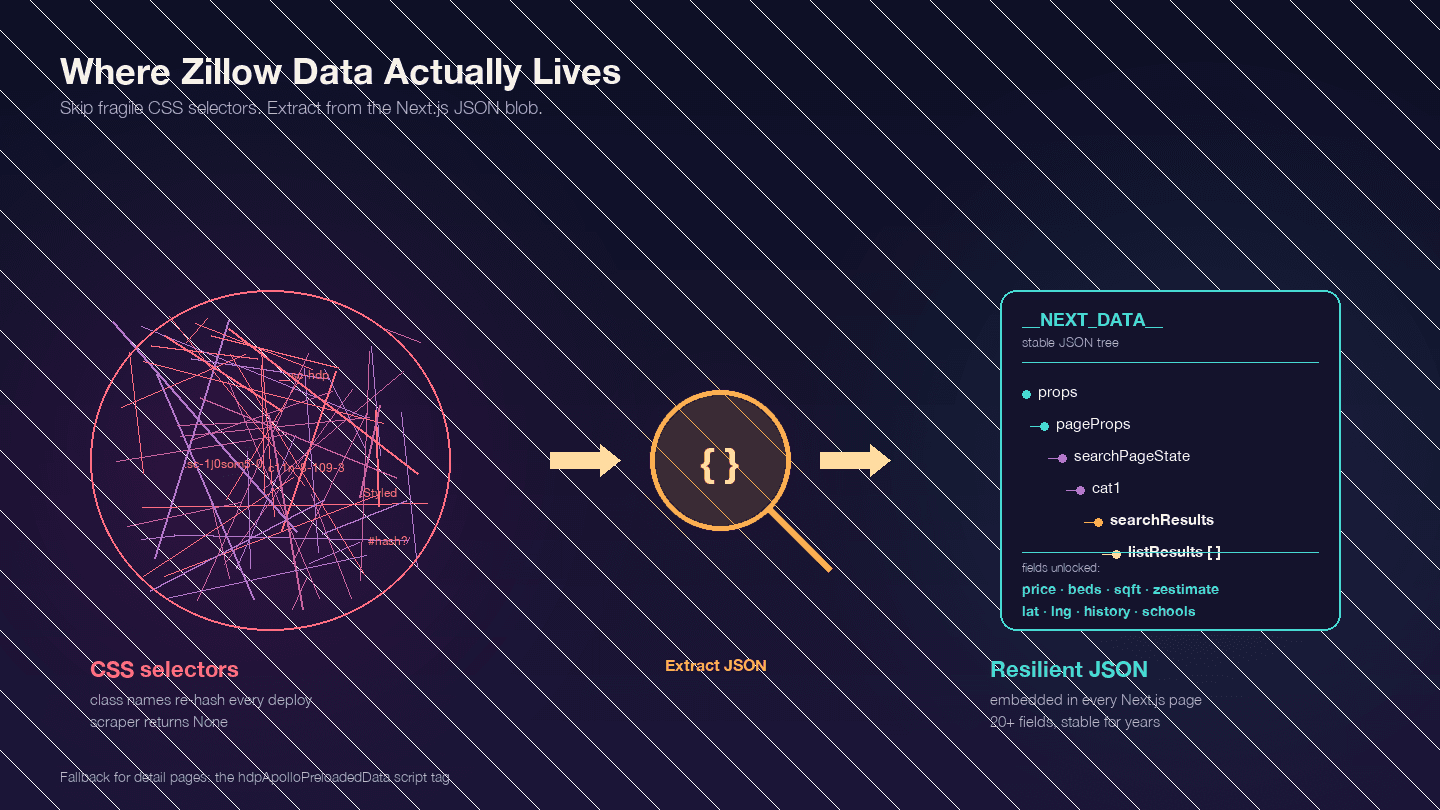
Det här är det viktigaste att förstå innan du skriver någon kod alls. Zillow är en Next.js-applikation — bekräftat av ingenjörsinlägg från anställda på Zillow. Det betyder att det mesta av datan du vill åt inte ligger i de synliga HTML-elementen. Den är inbäddad i ett JSON-blobb i <script id="__NEXT_DATA__">.
Öppna vilken Zillow-sida som helst för en bostad, tryck F12, gå till Elements och sök efter __NEXT_DATA__. Du hittar då ett enormt JSON-objekt som innehåller all listdata — priser, koordinater, fastighetsdetaljer, prishistorik, skatteuppgifter, skolbetyg och mycket mer.
Varför spelar detta roll? Zillows CSS-klassnamn är hashade (skapade av styled-components) och ändras vid varje deployment. En klass som StyledPropertyCardHomeDetailsList-c11n-8-109-3__sc-1j0som5-0 får en helt annan hash nästa vecka. Alla skrapare som bygger på CSS-selectors kommer därför att gå sönder regelbundet.
JSON-metoden via __NEXT_DATA__ är mycket stabilare eftersom den inte alls är beroende av HTML-strukturen.
Viktiga JSON-sökvägar för sökresultat:
| Sökväg | Innehåll |
|---|---|
props.pageProps.searchPageState.cat1.searchResults.listResults | Array med sökresultat |
props.pageProps.searchPageState.cat1.searchResults.mapResults | Resultat för kartvy |
props.pageProps.searchPageState.cat1.searchList.totalPages | Totalt antal tillgängliga sidor |
På detaljsidor använder vissa __NEXT_DATA__ och andra ett alternativt script-tag med hdpApolloPreloadedData. Koden nedan hanterar båda.
Steg för steg: Så skrapar du Zillow med Python
Steg 1: Sätt HTTP-headers för att undvika direkta blockeringar
Om du skickar en enkel httpx.get() till Zillow får du en CAPTCHA-sida, inte listdata. Zillow använder PerimeterX (HUMAN Security) tillsammans med Cloudflare — båda bedömda till 8/10 i svårighetsgrad i scraping-benchmarks. Systemet kontrollerar din TLS-fingerprint, dina HTTP-headers och IP-rykte.
Här är de minsta headers som fungerar per 2025:
import httpx

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
                   "(KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,"
              "image/avif,image/webp,*/*;q=0.8",
    "Accept-Language": "en-US,en;q=0.9",
    "Accept-Encoding": "gzip, deflate, br",
    "Sec-Ch-Ua": '"Chromium";v="124", "Google Chrome";v="124", "Not-A.Brand";v="99"',
    "Sec-Ch-Ua-Platform": '"Windows"',
    "Sec-Fetch-Dest": "document",
    "Sec-Fetch-Mode": "navigate",
    "Sec-Fetch-Site": "none",
    "Sec-Fetch-User": "?1",
    "Upgrade-Insecure-Requests": "1",
}
Sec-Ch-Ua-headersen är avgörande. Många guider utelämnar dem — och det är just därför deras kod inte fungerar mot PerimeterX.
Steg 2: Skrapa sökresultat från Zillow
Zillows sök-URL:er följer ett förutsägbart mönster. För Houston, TX:
- Sida 1:
https://www.zillow.com/houston-tx/ - Sida 2:
https://www.zillow.com/houston-tx/2_p/ - Sida 3:
https://www.zillow.com/houston-tx/3_p/
Varje sida innehåller ungefär 41 annonser. Zillow begränsar resultat till 20 sidor (~820 annonser). För större datamängder måste du dela upp efter geografi (mer om det senare).
Här är koden för att skrapa sökresultat genom att extrahera data från __NEXT_DATA__ JSON:
from bs4 import BeautifulSoup
import json
import time
import random

def scrape_zillow_search(url):
    """Skrapa annonsdata från en Zillow-sida med sökresultat."""
    response = httpx.get(url, headers=headers, timeout=15)

    if response.status_code != 200:
        print(f"Fick status {response.status_code} för {url}")
        return []

    soup = BeautifulSoup(response.text, "lxml")
    script_tag = soup.find("script", {"id": "__NEXT_DATA__"})

    if not script_tag:
        print("Ingen __NEXT_DATA__ hittades — troligen blockerad av CAPTCHA")
        return []

    next_data = json.loads(script_tag.string)

    try:
        results = (
            next_data["props"]["pageProps"]["searchPageState"]
            ["cat1"]["searchResults"]["listResults"]
        )
    except KeyError:
        print("Oväntad JSON-struktur — Zillow kan ha ändrat format")
        return []

    listings = []
    for item in results:
        listing = {
            "zpid": item.get("zpid"),
            "address": item.get("addressStreet"),
            "city": item.get("addressCity"),
            "state": item.get("addressState"),
            "zipcode": item.get("addressZipcode"),
            "price": item.get("unformattedPrice") or item.get("price"),
            "beds": item.get("beds"),
            "baths": item.get("baths"),
            "sqft": item.get("area"),
            "zestimate": item.get("zestimate"),
            "days_on_zillow": item.get("daysOnZillow"),
            "listing_url": item.get("detailUrl"),
            "img_src": item.get("imgSrc"),
            "property_type": item.get("hdpData", {}).get("homeInfo", {}).get("homeType"),
            "latitude": item.get("latLong", {}).get("latitude"),
            "longitude": item.get("latLong", {}).get("longitude"),
        }
        listings.append(listing)

    return listings
För att skrapa flera sidor, loopa med pauser:
all_listings = []
base_url = "https://www.zillow.com/houston-tx/"

for page in range(1, 6):  # Första 5 sidorna
    url = base_url if page == 1 else f"{base_url}{page}_p/"
    print(f"Skrapar sida {page}...")

    page_listings = scrape_zillow_search(url)
    all_listings.extend(page_listings)

    # Slumpmässig paus mellan 3–7 sekunder
    delay = random.uniform(3, 7)
    time.sleep(delay)

print(f"Totalt antal skrapade annonser: {len(all_listings)}")
Du bör nu se strukturerad listdata samlas i all_listings. Om du får tomma resultat, kolla avsnittet "Varför skrapare går sönder" längre ner.
Steg 3: Skrapa Zillows detaljsidor för fastigheter
Sökresultat ger dig grunderna. Detaljsidorna innehåller den djupare datan: prishistorik, skattehistorik, skolbetyg, mäklarinfo och fastighetsbeskrivningar. Varje annons-URL från steg 2 pekar på en detaljsida.
Zillows detaljsidor använder två möjliga dataformat. Här är kod som hanterar båda:
def scrape_zillow_detail(url):
    """Skrapa detaljerad fastighetsdata från en Zillow-annons."""
    response = httpx.get(url, headers=headers, timeout=15)

    if response.status_code != 200:
        return None

    soup = BeautifulSoup(response.text, "lxml")

    # Försök med __NEXT_DATA__ först (vanligast)
    script_tag = soup.find("script", {"id": "__NEXT_DATA__"})
    if script_tag:
        next_data = json.loads(script_tag.string)
        try:
            cache_str = next_data["props"]["pageProps"]["componentProps"]["gdpClientCache"]
            cache = json.loads(cache_str)
            first_key = next(iter(cache))
            prop = cache[first_key]["property"]
            return extract_property_fields(prop)
        except (KeyError, StopIteration):
            pass

    # Reservlösning: hdpApolloPreloadedData
    apollo_tag = soup.find("script", {"id": "hdpApolloPreloadedData"})
    if apollo_tag:
        raw = json.loads(apollo_tag.string)
        api_cache = json.loads(raw["apiCache"])
        for key, value in api_cache.items():
            if "ForSale" in key or "property" in str(value)[:100]:
                prop = value.get("property", value)
                return extract_property_fields(prop)

    return None


def extract_property_fields(prop):
    """Extrahera strukturerade fält från ett Zillow-property-JSON-objekt."""
    return {
        "zpid": prop.get("zpid"),
        "zestimate": prop.get("zestimate"),
        "rent_zestimate": prop.get("rentZestimate"),
        "description": prop.get("description"),
        "year_built": prop.get("yearBuilt"),
        "lot_size": prop.get("lotSize"),
        "hoa_fee": prop.get("monthlyHoaFee"),
        "mls_id": prop.get("mlsid"),
        "broker_name": prop.get("brokerName") or prop.get("attributionInfo", {}).get("brokerName"),
        "price_history": [
            {
                "date": event.get("date"),
                "event": event.get("event"),
                "price": event.get("price"),
            }
            for event in prop.get("priceHistory", [])
        ],
        "tax_history": [
            {
                "year": record.get("time"),
                "tax_paid": record.get("taxPaid"),
                "value": record.get("value"),
            }
            for record in prop.get("taxHistory", [])
        ],
        "schools": [
            {
                "name": school.get("name"),
                "rating": school.get("rating"),
                "distance": school.get("distance"),
            }
            for school in prop.get("schools", [])
        ],
    }
Loopa igenom dina annons-URL:er med pauser:
detail_data = []
for listing in all_listings[:10]:  # Börja med 10 för att testa
    detail_url = listing.get("listing_url")
    if not detail_url:
        continue

    if not detail_url.startswith("http"):
        detail_url = f"https://www.zillow.com{detail_url}"

    print(f"Skrapar detaljsida: {detail_url}")
    detail = scrape_zillow_detail(detail_url)

    if detail:
        detail_data.append({**listing, **detail})

    time.sleep(random.uniform(3, 8))
Efter det här steget bör du ha en lista med dictionaries som innehåller både söknivådata och detaljnivådata för varje bostad.
Steg 4: Hantera paginering för att skrapa flera sidor
För områden med fler än 820 annonser (20-sidorsgränsen) måste du dela upp geografiskt. Zillows interna API accepterar mapBounds-parametrar. Strategin: dela kartan i kvadranter och skrapa varje del för sig.
def split_bounds(bounds):
    """Dela kartgränser i 4 kvadranter."""
    mid_lat = (bounds["north"] + bounds["south"]) / 2
    mid_lng = (bounds["east"] + bounds["west"]) / 2

    return [
        {"north": bounds["north"], "south": mid_lat, "east": bounds["east"], "west": mid_lng},
        {"north": bounds["north"], "south": mid_lat, "east": mid_lng, "west": bounds["west"]},
        {"north": mid_lat, "south": bounds["south"], "east": bounds["east"], "west": mid_lng},
        {"north": mid_lat, "south": bounds["south"], "east": mid_lng, "west": bounds["west"]},
    ]
För de flesta användningsfall — bevakning av 50–200 annonser i ett specifikt område — räcker standardpaginering via URL. Kvadrantmetoden är för skrapningar på stads- eller delstatsnivå.
Steg 5: Exportera din skrapade Zillow-data
Spara allt till CSV med pandas:
import pandas as pd

df = pd.DataFrame(detail_data)
df.to_csv("zillow_houston_listings.csv", index=False)
print(f"Exporterade {len(df)} annonser till zillow_houston_listings.csv")
För JSON-export:
with open("zillow_houston_listings.json", "w") as f:
    json.dump(detail_data, f, indent=2)
Om du vill hoppa över exportsteget helt exporterar Thunderbit gratis till Google Sheets, Airtable och Notion — praktiskt om du vill få in datan i ett samarbetsvänligt format direkt.
Varför Zillow-scrapers går sönder (och hur du bygger mer robusta sådana)
Det här är överlevnadsguiden.
Enligt min erfarenhet går skrapare sönder på Zillow av tre specifika skäl — och varje problem har en konkret lösning.
PerimeterX och CAPTCHA: varför dina förfrågningar ger tom data
Zillows PerimeterX-integration kontrollerar flera signaler samtidigt: TLS-fingerprint, HTTP-headers, IP-rykte och förfrågningsmönster. När den upptäcker automatisering visar den en CAPTCHA-sida med "Press & Hold" i stället för listdata.
Det exakta felscenariot: Du skickar en begäran med standardheaders från Python. HTML-svaret innehåller PerimeterX-challenge-skript i stället för fastighetsdata — och din BeautifulSoup-parsning hittar inget __NEXT_DATA__-tagg.
Lösningen: Använd de fullständiga browser-liknande headers från steg 1. Om du gör fler än några dussin förfrågningar behöver du också proxyrotation (beskrivs nedan). För tung skrapning kan du överväga ett bibliotek som curl_cffi med impersonate="chrome" — det är den enda Python-HTTP-klienten som kan efterlikna en riktig Chrome-TLS-fingerprint.
Dynamiska CSS-selectors: varför BeautifulSoup returnerar None
Om du använder CSS-selectors som .list-card-price eller klassnamn med hashvärden kommer din skrapare att gå sönder varje gång Zillow släpper ny kod.
Zillow använder styled-components, som genererar klassnamn som StyledPropertyCardHomeDetailsList-c11n-8-109-3__sc-1j0som5-0. Hash-delen ändras vid varje build.
Lösningen: Använd inte CSS-selectors alls. Extrahera data från __NEXT_DATA__-JSON-blocket som i koden ovan. Den metoden har varit stabil i åratal eftersom JSON-strukturen ändras mycket mer sällan än HTML-markupen.
Om du måste använda HTML-parsning, leta efter data-test-attribut (t.ex. data-test="property-card") eller använd delsträngsmatchning för klasser som [class*="PropertyCard"]. Men JSON-extraktion är den mer pålitliga vägen.
Proxyrotation och exponentiell backoff: kod som överlever IP-blockeringar
Datacenter-IP:er blir omedelbart blocklistade av Zillow. Du behöver residential proxies för pålitlig åtkomst. Säker takt: 1 begäran per 3–8 sekunder per IP, och håll dig under cirka 500 förfrågningar per timme.
Här är en retry-decorator med exponentiell backoff och jitter:
import random
import time

def backoff_with_jitter(attempt, base_delay=2, max_delay=60):
    """AWS-liknande exponentiell backoff med full jitter."""
    delay = min(max_delay, base_delay * (2 ** attempt))
    return random.uniform(0, delay)

def fetch_with_retry(url, max_retries=5):
    for attempt in range(max_retries):
        try:
            response = httpx.get(url, headers=headers, timeout=15)
            if response.status_code == 200:
                return response
            if response.status_code in (403, 429):
                delay = backoff_with_jitter(attempt, base_delay=5)
                print(f"Blockerad ({response.status_code}). Försöker igen om {delay:.1f}s...")
                time.sleep(delay)
                continue
        except Exception as e:
            if attempt == max_retries - 1:
                raise
            time.sleep(backoff_with_jitter(attempt))
    return None
Och en enkel proxy-pool för rotation:
class ProxyPool:
    def __init__(self, proxies):
        self.proxies = proxies
        self.index = 0
        self.failures = {}

    def get_next(self):
        proxy = self.proxies[self.index % len(self.proxies)]
        self.index += 1
        return {"http://": proxy, "https://": proxy}

    def report_failure(self, proxy):
        self.failures[proxy] = self.failures.get(proxy, 0) + 1
        if self.failures[proxy] > 3:
            self.proxies.remove(proxy)

# Användning:
pool = ProxyPool(proxies=[
    "http://user:pass@residential1.example.com:8080",
    "http://user:pass@residential2.example.com:8080",
])
För proxy-leverantörer erbjuder DataImpulse residential proxies för cirka 1 dollar/GB (det billigaste alternativet), medan IPRoyal och Smartproxy är bra mellanklassval på 4–7 dollar/GB.
Det underhållsfria alternativet
Om du skrapar Zillow regelbundet och tröttnat på att fixa trasiga selectors eller hantera proxy-pooler, läser Thunderbits AI sidstrukturen på nytt vid varje skrapning. Inga selectors att underhålla, ingen proxykonfiguration. Det löser verkligen den skörhetsproblematik som gör kodade skrapare till ett återkommande huvudbry.
Automatisera Zillow-skrapning: schemaläggning och prisbevakning
Varenda fastighetsinvesterare jag pratat med vill ha detta, och ingen annan Zillow-guide täcker det: återkommande automatiska skrapningar för prisbevakning.
För Python-användare: cron-jobb och detektering av prisändringar
Sätt upp ett cron-jobb som kör din skrapare varje vecka och markerar prisändringar:
import pandas as pd
from datetime import datetime

def detect_price_changes(new_data, historical_file, threshold=0.05):
    """Jämför ny skrapning med historisk data och flagga ändringar > tröskel."""
    try:
        old = pd.read_csv(historical_file)
    except FileNotFoundError:
        new_data.to_csv(historical_file, index=False)
        print("Första körningen — sparade baslinjedata.")
        return pd.DataFrame()

    merged = new_data.merge(old, on="zpid", suffixes=("_new", "_old"))
    merged["price_change_pct"] = (
        (merged["price_new"] - merged["price_old"]) / merged["price_old"]
    )
    alerts = merged[merged["price_change_pct"].abs() > threshold]

    # Lägg till ny data med tidsstämpel
    new_data["scraped_at"] = datetime.now().isoformat()
    new_data.to_csv(historical_file, mode="a", header=False, index=False)

    return alerts
Lägg till detta i din crontab för veckovisa körningar på måndagar kl. 06:00:
0 6 * * 1 cd /path/to/scraper && python zillow_monitor.py
Ett praktiskt exempel: bevaka 50 annonser i Austin, TX varje vecka. Varje måndag skrapar scriptet aktuella priser, jämför med föregående vecka och skriver ut en CSV som markerar alla prissänkningar större än 5 %.
För icke-kodare: Thunderbits Scheduled Scraper
Thunderbits Scheduled Scraper låter dig beskriva intervallet i vanlig text ("varje måndag kl. 9"), ange dina Zillow-sök-URL:er och klicka på Schedule. Data exporteras automatiskt till Google Sheets vid varje körning. Ingen Python, ingen cron, ingen server att underhålla. Det här är särskilt användbart för mäklare eller operationsteam som behöver stabil prisbevakning utan stöd från utvecklare.
Tips för att skrapa Zillow ansvarsfullt
Några saker att tänka på för att hålla dig på rätt sida av gränsen:
- Skrapa bara data som är offentligt tillgänglig. Gå inte in på sidor bakom inloggning eller autentisering.
- Håll rimlig begärandetakt. 3–8 sekunder mellan förfrågningar. Överbelasta inte servern.
- Skrapa inte personlig eller privat användardata. Mäklarnamn och förmedlingsuppgifter i annonser är offentliga; användarkontodata är det inte.
- Lagra och använd data etiskt. Marknadsanalys, investeringsanalys och leadgenerering är legitima användningsområden. Spam är det inte.
- Juridisk kontext: hiQ v. LinkedIn-domen slog fast att skrapning av offentligt tillgänglig data inte bryter mot CFAA. Meta v. Bright Data-domen (2024) bekräftade liknande principer. När det är sagt begränsar Zillows användarvillkor automatiserad åtkomst, och de upprätthåller detta genom IP-blockeringar och CAPTCHA i stället för rättsliga åtgärder. Kontrollera alltid aktuell vägledning och respektera robots.txt.
Välj rätt metod för att skrapa Zillow med Python
Den bästa vägen beror på din situation:
Behöver du data snabbt, utan kod? Thunderbit tar dig från en Zillow-sökresultatsida till ett strukturerat kalkylblad på ungefär 2 minuter. AI:n anpassar sig till layoutändringar, hanterar paginering och exporterar gratis. Installera Chrome Extension och testa på en Zillow-sökning.
Vill du ha full kontroll? Använd Python-koden i den här guiden. Extrahera från __NEXT_DATA__-JSON (inte CSS-selectors) för stabilitet. Sätt rätt browser-liknande headers. Rotera residential proxies och använd exponentiell backoff för tillförlitlighet.
Skala upp? Scraping-API:er som ScrapFly (99 % lyckandefrekvens på Zillow) eller ScraperAPI hanterar proxy- och CAPTCHA-infrastrukturen åt dig, för 30–599 dollar i månaden beroende på volym.
Följa priser över tid? Sätt upp ett cron-jobb med skriptet för prisförändringar, eller använd Thunderbits Scheduled Scraper för ett underhållsfritt upplägg.
Datan finns där. Den enda frågan är hur mycket teknisk tid du vill lägga på att få ut den. För mer om att få in webbdata i kalkylblad, kolla vår guide om att skrapa data från webbplatser till Excel eller vår sammanställning av Zillow-statistik för den senaste plattformsdatan. Du kan också titta på guider på Thunderbits YouTube-kanal.
Prova Thunderbit för Zillow-skrapning Get Started Free
Vanliga frågor
Kan man skrapa Zillow med Python gratis?
Ja — httpx, BeautifulSoup och pandas är alla gratis och öppen källkod. Nackdelen är tiden: du måste själv hantera headers, proxyrotation och underhåll av selectors. Räkna med 4–8 timmar för första uppsättningen och 4–10 timmar per månad i underhåll när Zillow ändrar sin sajt. Thunderbit har också en gratisversion om du vill undvika kodningsbördan helt.
Har Zillow ett officiellt API?
Zillow avvecklade sitt kostnadsfria publika API i september 2021. Åtkomst går nu via Bridge Interactive, som kräver godkännande, kostar ungefär 500 dollar per månad och riktar sig till licensierade fastighetsproffs. För de flesta användare — investerare, forskare, mäklare som gör marknadsanalys — är skrapning det praktiska alternativet. Zillow publicerar fortfarande gratis forskningsdata som nedladdningsbara CSV-filer på zillow.com/research/data/, inklusive Zillow Home Value Index och Zillow Observed Rent Index.
Hur undviker jag att bli blockerad när jag skrapar Zillow?
Tre saker: (1) använd realistiska webbläsarheaders inklusive Sec-Ch-Ua — det här är den header som de flesta guider missar, och det är den PerimeterX tittar på först; (2) rotera residential proxies — datacenter-IP:er blocklistas direkt; (3) extrahera data från __NEXT_DATA__-JSON i stället för HTML-selectors för att undvika att layoutändringar bryter koden. Håll begärandetakten på 1 per 3–8 sekunder per IP. Eller använd ett verktyg som Thunderbit som hanterar anti-bot-skydd automatiskt.
Vad är det bästa sättet att skrapa Zillow utan att koda?
Thunderbits AI Web Scraper är snabbaste vägen. Installera Chrome Extension, gå till en Zillow-sökresultatsida, klicka på "AI Suggest Fields" för att identifiera kolumner automatiskt och klicka sedan på "Scrape." Exportera till Google Sheets, Excel, Airtable eller Notion utan kod. AI:n läser om sidan från grunden varje gång, så den går inte sönder när Zillow uppdaterar sin layout.
Hur ofta ändrar Zillow sin webbstruktur, och hur påverkar det scrapers?
Zillow släpper uppdateringar ofta — ibland varje vecka. Eftersom de använder styled-components ändras CSS-klassnamn vid varje deployment, och skrapare byggda på CSS-selectors går därför sönder regelbundet. Det mest robusta tillvägagångssättet i Python är att extrahera från __NEXT_DATA__-JSON-blocket, som ändras mycket mer sällan. För ett underhållsfritt alternativ läser Thunderbits AI om sidstrukturen vid varje skrapning och anpassar sig automatiskt till layoutändringar.
Läs mer
- Hur du gör web scraping utan att bli blockerad i Python
- Python Web Scraping: undvik blockeringar med smart proxy-användning
- Hur du skrapar data från en webbplats med Python effektivt
- Hur du skriver en web scraper med Python: från start till mål
- Omfattande guide till web scraping i Python: steg för steg




