
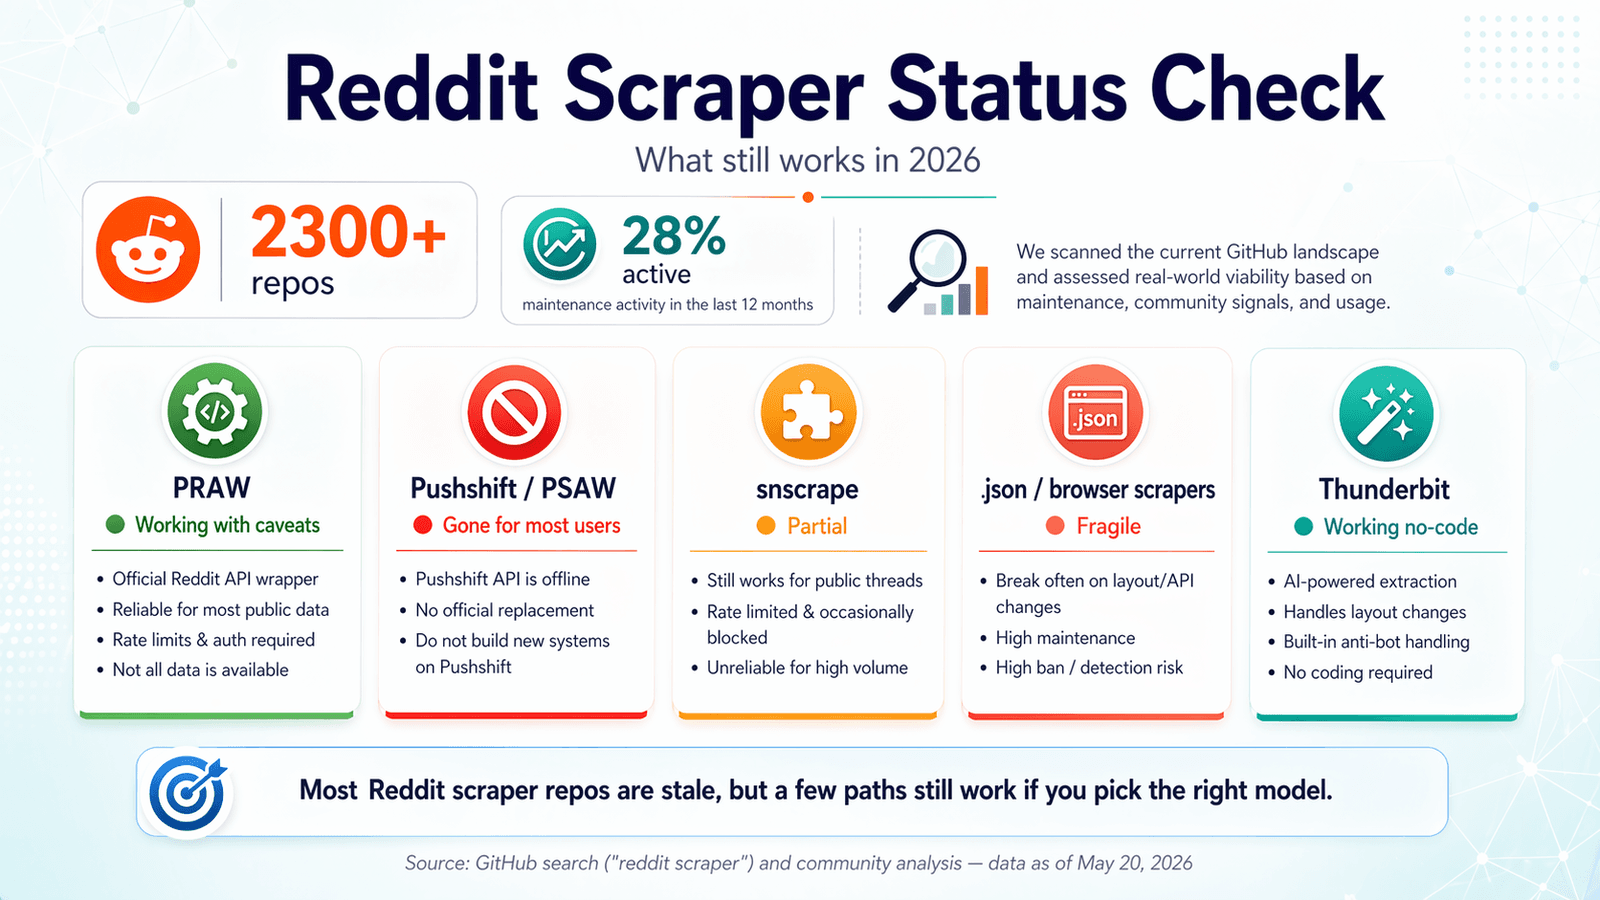
GitHub visar just nu över 2 300 Reddit scraper-repos. Det låter som en buffé. Haken: bara cirka 28 % visar någon form av aktivitet under de senaste tolv månaderna. Jag har tillbringat de senaste veckorna med att gräva igenom dessa repos, testa endpoints, läsa issue-köer och jämföra med Reddits egna policyuppdateringar. Målet: rädda dig från att klona ett repo, brottas med OAuth och upptäcka vid midnatt att allt tyst gick sönder redan 2024. Reddit scraper GitHub-landskapet 2026 är en kyrkogård av goda intentioner blandad med ett fåtal faktiskt användbara verktyg. Den här guiden går igenom vad som fortfarande fungerar, vad som gick sönder, när du ska skippa kod helt och hållet och hur du håller dig på rätt sida av Reddits allt striktare tillämpning. Om du letar efter en genväg är Thunderbit no-code-alternativet vi byggde just för den här typen av problem — men jag ska också vara ärlig med var kodbaserade lösningar fortfarande är mer rimliga.
Vad är ett Reddit Scraper GitHub-repo, och varför är så många trasiga?
Ett "reddit scraper github"-repo är vanligtvis ett öppen källkod-projekt i Python (eller ibland JavaScript) som automatiserar hämtning av inlägg, kommentarer, användardata eller media från Reddit. De brukar delas in i fyra läger:
- API-wrappers (som PRAW): använder Reddits officiella API, kräver OAuth och följer Reddits regler.
- Pushshift/PSAW-baserade verktyg: användes för att komma åt Pushshifts enorma Reddit-arkiv för historiska data.
- Scrapers för offentliga
.json-endpoints: lägger till.jsoni Reddit-URL:er eller anropar publika endpoints utan autentisering. - Webbläsarbaserade scrapers: använder Playwright, Selenium eller webbläsartillägg för att ladda Reddit-sidor och extrahera det renderade innehållet.
Varför gick så många sönder? Tre skäl.
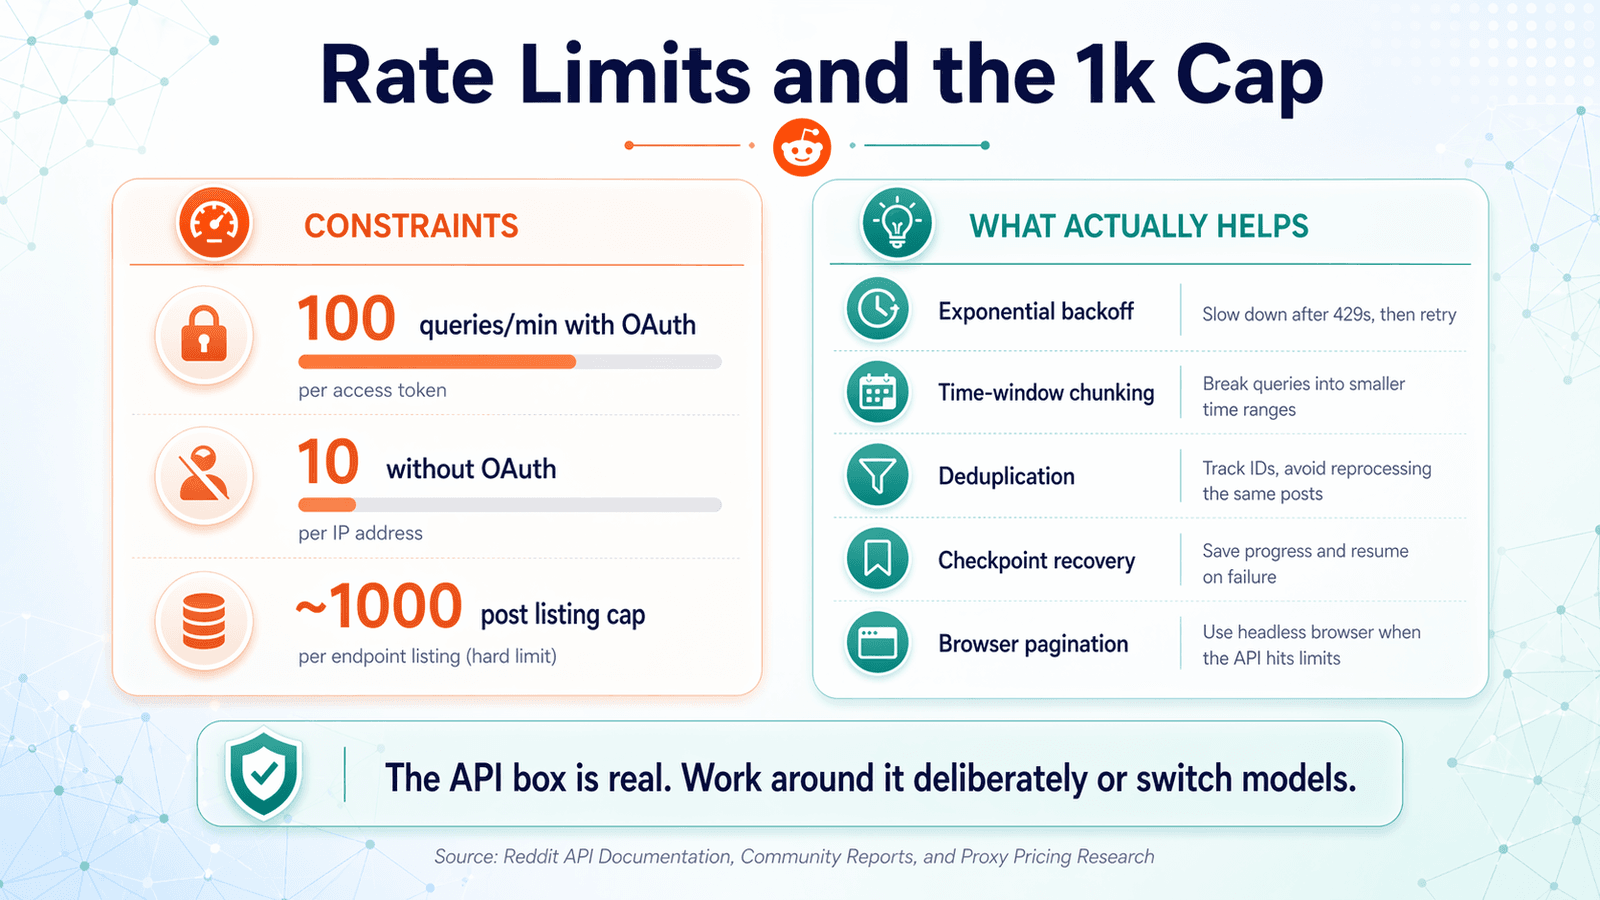
- Reddits API-prisändring i mitten av 2023. De fria API-gränserna sjönk till 100 frågor per minut med OAuth och bara 10 utan. Högre kommersiell användning kostar nu 0,24 dollar per 1 000 API-anrop. Många repos byggdes för en värld där API-åtkomst i princip var obegränsad — och den världen är borta.
- Pushshifts publika åtkomst drogs in. Pushshift var ryggraden för historisk Reddit-forskning. När Reddit begränsade den förlorade en stor del av alla "historiska scraper"-repos sin huvudsakliga datakälla. Vissa README-filer får fortfarande verktygen att se levande ut, men beroendet under huven är borta för vanliga användare.
- Reddit har skärpt både policy och tillämpning. 2024 års robots.txt-uppdatering, 2025 års Public Content Policy och mars 2026 års Responsible Builder Policy visar alla att Reddit inte längre behandlar mass-scraping som ofarligt bakgrundsbrus. De har till och med lämnat in klagomål mot Anthropic och SerpApi för obehörig dataåtkomst.
Slutsatsen: sök på "reddit scraper github" så får du hundratals träffar. Datum för senaste commit och antal öppna issues berättar en helt annan historia.
Reddit Scraper GitHub-kontroll 2026: Vad fungerar fortfarande?
De flesta konkurrerande artiklar skrevs 2023 eller 2024 och uppdaterades aldrig. Forumanvändare fortsätter att stöta på fel i repos som fungerade för ett år sedan — en användares bön, "Keep running into Reddit API limitation error :\ Any ideas how I can get past this?" är i princip Reddit scraper-upplevelsen 2026 i ett nötskal.
Jag körde en färskhetsgranskning, verifierad i april 2026. Här är vad jag hittade.
PRAW: Den officiella Python-wrapppern
Status: ✅ Fungerar fortfarande, med förbehåll.
PRAW (Python Reddit API Wrapper) är fortfarande den mest pålitliga open source-grunden för Reddit-scraping. Det underhålls aktivt — 4 099 stjärnor, senaste push den 20 april 2026, bara 6 öppna issues och PyPI listar praw 7.8.1 (släppt i oktober 2024).
Styrkor: Officiellt, väldokumenterat och abstraherar bort det mesta av Reddits API-komplexitet.
Begränsningar 2026:
- Striktare krav på OAuth. Du behöver en registrerad Reddit-app med en godkänd beskrivning av användningsfallet.
- Lägre hastighetsgränser sedan 2024 (100 frågor/min med OAuth, 10 utan).
- Den hårda gränsen på cirka 1 000 inlägg per listning kvarstår. Trådar i communityn på r/redditdev och Stack Overflow bekräftar: det går inte att hämta mer än 1 000 inlägg per listing-endpoint.
PRAW är det säkraste valet om du kan hålla dig inom API:ets ramar.
Det är bara inte längre en fri bulk-scraper.
Om du vill ha en praktisk genomgång av den officiella API-vägen passar den här videon bra till det här avsnittet:
Pushshift / PSAW: Arkivet som blev mörkt
Status: ❌ Publik åtkomst borta.
PSAW var den självklara Python-wrapppern för Pushshift, som tidigare var det enklaste sättet att få historiska Reddit-data. År 2026 är repot arkiverat, README:n säger bokstavligen "THIS REPOSITORY IS STALE," och nyliga öppna issues innehåller guldkorn som "Pushshift.io UNABLE to connect" och "The code not working. Possibly due to pushshift api."
Akademisk åtkomst kan fortfarande finnas via särskilda kanaler, men för den som söker "reddit scraper github" i dag är Pushshift/PSAW inte ett gångbart alternativ. Om du behöver djupa historiska Reddit-data måste du titta på godkänd akademisk datatillgång eller licensierade vägar.
snscrape (Reddit-modulen): Delvis och opålitlig
Status: ⚠️ Delvis — intermittent trasig, i stort sett utan underhåll.
snscrape har 5 337 stjärnor, men senaste pushen var den 15 november 2023. README:n säger fortfarande att Reddit-scraping stöds "via Pushshift." Öppna Reddit-relaterade issues inkluderar "Error reddit scraping" och "Reddit scraper returns no submissions before 2022-11-03," utan någon meningsfull reparationsaktivitet på senare tid.
Det kan fungera för små, engångshämtningar i vissa miljöer, men det är inte tillförlitligt för produktion eller återkommande körningar. Betrakta det som legacy.
Playwright och scrapers för .json-endpoints: Workarounden som fungerar (ibland)
Status: ✅ Fungerar, men är skör.
Tanken här är enkel: använd en headless webbläsare (Playwright, Puppeteer) för att ladda Reddit-sidor och skrapa det renderade innehållet, eller lägg till .json i Reddit-URL:er för att få strukturerad data utan det officiella API:et.
Styrkor: Ingen API-nyckel behövs, kan kringgå gränsen på 1 000 inlägg, ger åtkomst till renderat innehåll.
Svagheter: Går sönder när Reddit ändrar frontend-layout eller JSON-struktur, kan trigga anti-bot-skydd och kräver mer teknisk installation. I mina egna tester den här månaden gav direkta anrop till offentliga Reddit .json-endpoints 403-svar. Det betyder inte att alla miljöer blockeras, men det betyder att .json-genvägen inte längre är något du ska utgå ifrån bara "funkar".
Repos som yars är uppfriskande ärliga om detta: README:n varnar användare för att "Use with rotating proxies, or Reddit might gift you with an IP ban." Det sammanfattar i princip april 2026 i en enda mening.
Om du utvärderar vägen med webbläsarautomatisering är den här Playwright-guiden ett starkt komplement till avsnittet nedan:
Thunderbit: AI-driven webbläsarscraping (ingen kod, ingen API-nyckel)
Status: ✅ Fungerar — anpassar sig automatiskt efter sidändringar.
Thunderbit tar ett helt annat grepp. Det är ett Chrome-tillägg som använder AI för att läsa Reddit-sidor, föreslå datafält (inläggstitel, författare, röster, tidsstämpel, URL osv.) och extrahera strukturerad data med två klick. Ingen OAuth-installation, ingen API-nyckelregistrering, ingen Python-miljö, ingen beroendehantering. AI:n läser sidan på nytt varje gång, så när Reddit ändrar layout anpassar sig Thunderbit automatiskt i stället för att gå sönder i tysthet.
Export gratis till CSV, Google Sheets, Airtable eller Notion. Hanterar paginering och undersidor (t.ex. att skrapa en subreddit-listning och sedan besöka varje inlägg för att hämta kommentarer). För den som vill ha Reddit-data utan att underhålla ett GitHub-repo är det här den väg som ger minst motstånd.
(Full transparens: vi byggde Thunderbit, så jag är partisk — men jag ska vara tydlig med var kodbaserade lösningar fortfarande är mer rimliga längre fram i artikeln.)
Sammanfattande tabell sida vid sida
| Verktyg / kategori | Fungerar fortfarande (april 2026)? | API-nyckel krävs? | Noteringar |
|---|---|---|---|
| PRAW | ✅ Ja, med förbehåll | Ja (OAuth) | Den bäst underhållna open source-grunden. Begränsas av hastighetsgränser och taket på 1 000 inlägg. |
| Pushshift / PSAW | ❌ Nej (för de flesta användare) | N/A | Publik åtkomst borta. Repot arkiverat. |
| snscrape (Reddit-modul) | ⚠️ Delvis / opålitlig | Nej | Dokumenterar fortfarande Reddit "via Pushshift." Underhållet har stått still sedan 2023. |
| .json / scrapers för publika endpoints | ⚠️ Delvis | Nej | Kan fungera, men direkta anrop blockeras allt oftare. Proxy-beroende. |
| Playwright / webbläsarscrapers | ✅ Ja, men skör | Vanligtvis nej | Mest gångbara DIY-workarounden utan API. Sidändringar och anti-bot-kontroller spelar fortfarande roll. |
| Thunderbit | ✅ Ja | Nej | AI-/webbläsararbetsflöde. Ingen OAuth, inga selektorer. Bäst för icke-utvecklare. |
Hastighetsgränser, taket på 1 000 inlägg och vad som faktiskt hjälper
Det här är den vanligaste smärtpunkten för alla som använder ett reddit scraper github-projekt. Foruminlägg är fulla av frustration: "tired of runs dying halfway through because of rate limits," "Why am I only getting around 1,000 items?" De två kärnbegränsningarna är Reddits API-hastighetsgränser (anrop per minut) och listningstaket på cirka 1 000 inlägg (API:et returnerar bara de senaste cirka 1 000 inläggen per listing-endpoint).
Bästa praxis för hantering av hastighetsgränser
Reddits nuvarande offentliga baslinje: 100 frågor per minut med OAuth, 10 utan. Så här hanterar du det i praktiken:
- Exponentiell backoff. Om du får ett svar om hastighetsgräns, vänta och försök igen efter allt längre fördröjning varje gång (1 s, 2 s, 4 s, 8 s …). Slamma inte bara endpointen.
- Läs
X-Ratelimit-Remaining-huvuden. Reddits API-svar innehåller headers som visar hur många anrop du har kvar och när fönstret återställs. Planera dina anrop utifrån dessa värden, inte på chans. - Roterande user-agents. Vissa repos föreslår detta för att undvika upptäckt. Det kan hjälpa, men använd det etiskt — inte för att kringgå avstängningar du faktiskt förtjänat.
- Logga allt. Lägg in loggning för API-svar, hastighetsgräns-headrar och fel. När din scraper dör klockan 02.00 är loggar din bästa vän.
Så bryter du gränsen på 1 000 inlägg
Den mest trovärdiga workarounden för API:ets listningstak på cirka 1 000 objekt är uppdelning i tidsfönster:
- Fråga ett tidssegment med parametrarna
beforeochafter. - Flytta fönstret framåt (eller bakåt).
- Upprepa.
- Avduplicera på inläggs-ID.
Det här är inte elegant, men det är ärligare än att låtsas att en enda anropsloop kan hämta godtycklig historik från en listing-endpoint. För verkligt historiska data behöver du godkänd akademisk åtkomst eller en licensierad väg — Pushshift är inte längre standardsvaret.
Webbläsarbaserad scraping (Playwright eller Thunderbit) kringgår det här taket helt, eftersom den skrapar det som faktiskt renderas på sidan, inte det API:et returnerar. Thunderbits pagineringsfunktion låter dig klicka dig igenom sidor och samla in data över så många sidor du behöver.
Avduplicering och felåterhämtning
De flesta reddit scraper github-repos hanterar inte avduplicering eller felåterhämtning direkt ur lådan. Användare klagar uttryckligen på att "none had deduping, rate limit avoidance after errors, checking if files are already downloaded." Här är vad du ska göra:
- Avduplicering: Hasha varje inläggs-ID (eller ID + innehåll). Lagra redan sedda hashvärden i en enkel SQLite-databas eller till och med i en flatfil. Kontrollera om hashen redan finns innan du skriver in den. Detta är särskilt viktigt när du delar upp i tidsfönster eller kör om misslyckade jobb.
- Felåterhämtning: Spara framsteg till en checkpoint-fil efter varje N poster. Om körningen misslyckas kan du fortsätta från senaste checkpoint i stället för från början. Det gör ett 3-timmarsjobb som dör efter 2 timmar till en återupptagbar körning på 1 timme.
Hur olika angreppssätt hanterar dessa begränsningar
| Angreppssätt | Hantering av hastighetsgränser | >1 000 inlägg? | Automatisk avduplicering? | Felåterhämtning? |
|---|---|---|---|---|
| PRAW (rå) | Manuell (sova/försöka igen) | ❌ (API-tak) | ❌ | ❌ |
| PRAW + uppdelning i tidsfönster | Manuell | ✅ (workaround) | ❌ | ❌ (om du inte lägger till det) |
Playwright .json-scraping | N/A (inget API) | ✅ | ❌ | ❌ |
| Thunderbit (webbläsarscraping) | Inbyggd (AI-taktning) | ✅ (paginering) | N/A (visuell granskning) | Inbyggd |
När ett Reddit Scraper GitHub-repo inte är svaret: no-code-vägen
De flesta reddit scraper github-artiklar utgår från att du kan Python. Men många av dem som söker Reddit-scrapinglösningar är marknadsförare, säljare, forskare eller indiegrundare som inte skriver Python dagligen. För den gruppen innebär ett GitHub-repo dolda kostnader:
- Att sätta upp OAuth-uppgifter och en Reddit-utvecklarapp
- Att hantera Python-virtuella miljöer och beroendekonflikter
- Att felsöka kryptiska felmeddelanden när PRAW:s interna delar ändras
- Att hantera återkallade API-nycklar om Reddit anser att ditt användningsfall inte är godkänt
- Att underhålla skriptet varje gång Reddit ändrar något
Det här är inte hypotetiskt. bulk-downloader-for-reddit har 2 563 stjärnor och 107 öppna issues. Nyliga rapporter inkluderar "Struggling to install," "PRAW module error," och "Exception not allowing to even authenticate."
Använd ett GitHub-repo om...
- Du behöver anpassad scrapinglogik (t.ex. specifik traversering av kommentarsträd, anpassad NLP-pipelineintegration).
- Du vill integrera i en befintlig Python-datapipeline.
- Du behöver skrapa i mycket stor skala med anpassad lagring (databas, data warehouse).
- Du är bekväm med att underhålla kod och hantera brytande ändringar.
Använd ett no-code-verktyg om...
- Du behöver Reddit-data snabbt — inom minuter, inte timmar av installation.
- Du vill slippa hantera API-nycklar, OAuth-appar eller Python-miljöer.
- Du vill exportera direkt till kalkylblad, Notion eller Airtable för omedelbar användning.
- Du vill att verktyget ska anpassa sig automatiskt när Reddits layout ändras.
Thunderbit passar perfekt i no-code-spåret. Användare kan skrapa Reddit-inlägg, kommentarer och användardata med två klick och AI-föreslagna fält, exportera gratis till CSV/Google Sheets/Airtable/Notion och hantera paginering utan att skriva kod. Dess webbläsarbaserade scraping innebär ingen OAuth-installation och ingen registrering av API-nyckel.
Snabb genomgång: skrapa Reddit med Thunderbit, steg för steg
- Installera Thunderbit Chrome Extension.
- Navigera till Reddit-sidan du vill skrapa (subreddit, sökresultat, användarprofil).
- Klicka på "AI Suggest Fields." Thunderbit läser sidan och föreslår kolumner — inläggstitel, författare, röster, tidsstämpel, URL osv.
- Justera fälten vid behov och klicka sedan på "Scrape."
- Granska datatabellen. Klicka eventuellt på "Scrape Subpages" för att besöka varje inlägg och hämta kommentarer eller ytterligare detaljer.
- Exportera till ditt önskade mål: Google Sheets, Excel, Airtable, Notion, CSV eller JSON.
Två minuter. Noll rader kod. Om du vill se det i praktiken, kolla in Thunderbits YouTube-kanal.
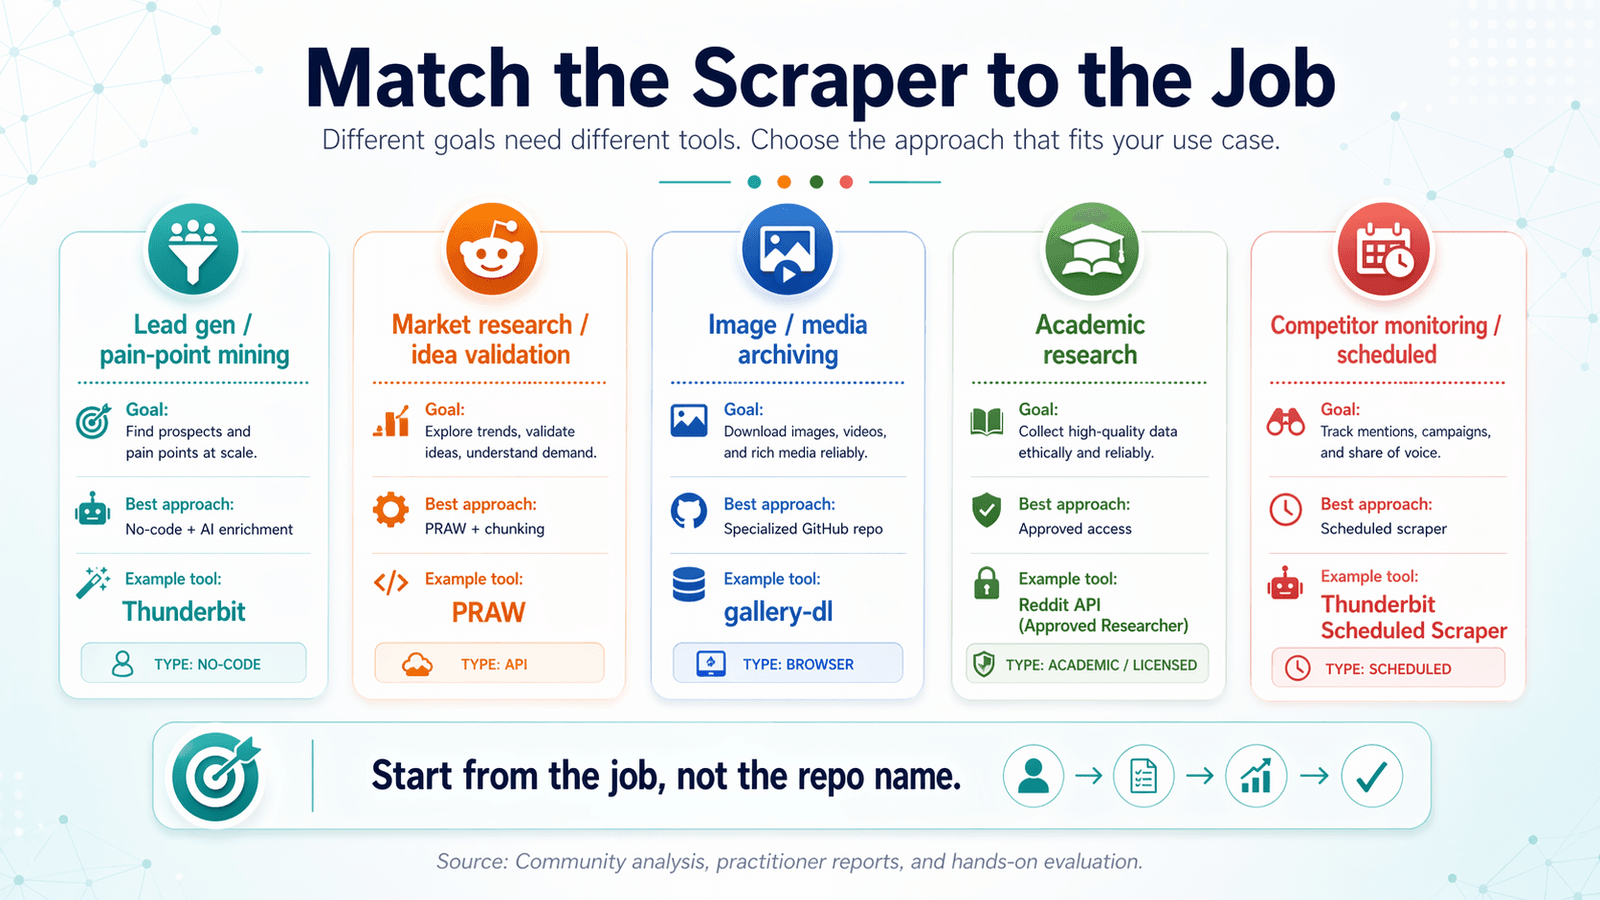
Matcha Reddit-scrapern med uppgiften: en beslutsmatris för användningsfall
De flesta reddit scraper github-artiklar organiserar efter verktyg. Det är bakvänt.
Börja med ditt mål och arbeta bakåt till rätt verktyg.
Leadgenerering och kartläggning av smärtpunkter
Vad du behöver: Inlägg + kommentarer med nyckelordsfiltrering, AI-taggning/etikettering, export till CRM-klara format.
Bästa angreppssätt: No-code-scraper med AI-berikning.
Rekommenderat verktyg: Thunderbit (AI-etikettering + export till Google Sheets/Airtable för CRM-import).
Exempelarbetsflöde: Skrapa en subreddit efter inlägg som nämner en specifik smärtpunkt. Använd Thunderbits Field AI Prompt för att kategorisera känslan eller tagga ämnen. Exportera till ditt säljteams Airtable eller Google Sheet.
Marknadsundersökning och idévalidering
Vad du behöver: Inläggstitlar i hög volym + poäng, trenddata på subreddit-nivå.
Bästa angreppssätt: PRAW med uppdelning i tidsfönster för volym, eller Thunderbit för snabba hämtningar.
Exempel: Skrapa r/SaaS eller r/startups för trendande ämnen och uppvotesmönster under de senaste 90 dagarna.
Arkivering av bilder och media
Vad du behöver: Media-URL:er, avduplicering, schemalagda körningar.
Bästa angreppssätt: Specialiserat GitHub-repo (t.ex. bulk-downloader-for-reddit) + cron-jobb.
Notera: Avduplicering är viktigt här — samma bild som publiceras i flera subreddits är vanligt.
Akademisk forskning och historiska data
Vad du behöver: Historiska data, fullständiga kommentarsträd, stora datamängder.
Bästa angreppssätt: Godkänd akademisk åtkomst eller licensierad dataväg. Pushshift är inte längre standardsvaret.
Verklighetscheck: Det här är det svåraste användningsfallet 2026 på grund av Pushshift-begränsningar och Reddits stramare datapolicyer.
Konkurrentövervakning och schemalagd scraping
Vad du behöver: Återkommande scraping med fasta intervall, förändringsdetektion.
Bästa angreppssätt: Thunderbits Scheduled Scraper (beskriv tidsintervallet på vanlig engelska, ange URL:er, klicka på Schedule) eller cron + skript för kodbaserade användare.
Beslutsmatris för användningsfall
| Användningsfall | Vad du behöver | Bästa angreppssätt | Exempelverktyg |
|---|---|---|---|
| Leadgen / kartläggning av smärtpunkter | Inlägg + kommentarer, nyckelordsfiltrering, AI-taggning | No-code-scraper + AI-berikning | Thunderbit |
| Marknadsundersökning / idévalidering | Inläggstitlar i hög volym + poäng, data på subreddit-nivå | PRAW + uppdelning i tidsfönster eller Thunderbit | PRAW eller Thunderbit |
| Arkivering av bild/media | Media-URL:er, avduplicering, schemalagda körningar | Specialiserat GitHub-repo + cron | bulk-downloader-for-reddit |
| Akademisk forskning | Historiska data, fullständiga kommentarsträd | Godkänd akademisk åtkomst eller Playwright | Pushshift academic API (om tillgängligt) |
| Konkurrentövervakning / schemalagd | Återkommande scraping, förändringsdetektion | Scheduled Scraper | Thunderbit Scheduled Scraper eller cron + skript |
Så utvärderar du ett Reddit Scraper GitHub-repo innan du bestämmer dig
Innan du klonar ett repo och börjar felsöka, kör den här femminuterskontrollen. Den sparar dig timmar.
Femminuterskontroll av repo-hälsa
- Datum för senaste commit. Om det är mer än 6 månader sedan, gå försiktigt fram. Reddits API ändras ofta.
- Förhållandet mellan öppna och stängda issues. Ett stort antal obesvarade issues är en varningssignal. Kontrollera om nyliga issues nämner autentiseringsfel, 403:or eller Pushshift-avbrott.
- LICENSE-fil. Kontrollera att en sådan finns. Ingen licens = juridiskt oklart (mer om detta nedan).
- Beroenden. Är de nödvändiga biblioteken uppdaterade? Använder det föråldrade paket? En
requirements.txtfull av låsta versioner från 2022 är en varningsflagga. - README-kvalitet. Förklarar den installationen tydligt? Finns det användningsexempel? Dålig dokumentation = mer felsökning för dig.
- Stjärnor kontra forks kontra nylig aktivitet. Många stjärnor men låg nylig aktivitet kan betyda att projektet var populärt men nu är övergivet. Jämför stjärnorna med
pushed_at-datumet.
Ett snabbt exempel: PSAW har 364 stjärnor — ser trovärdigt ut vid första anblick. Men repot är arkiverat och README:n säger "THIS REPOSITORY IS STALE."
Stjärnor ensamma berättar inte hela historien.
Tips för att få ut mer av din Reddit Scraper GitHub-installation
Om du ändå väljer kodvägen, så här sparar du dig huvudvärk.
Använd alltid en virtuell miljö
En virtuell miljö håller din scrapers beroenden isolerade så att de inte krockar med andra Python-projekt. Ett kommando: python -m venv venv och sedan aktivera den innan du installerar något. Det här är grundläggande hygien, men jag har sett tillräckligt många GitHub-issues med rubriken "module not found" för att veta att det är värt att upprepa.
Förvara uppgifter säkert
Lägg aldrig in din Reddit API-klient-ID eller hemlighet direkt i skriptet. Använd miljövariabler eller en .env-fil, och lägg till .env i din .gitignore. Om du råkar pusha uppgifter till GitHub, rotera dem direkt — bottar skannar efter exponerade API-nycklar.
Logga allt
Lägg in loggning för API-svar, hastighetsgräns-headrar och fel. När något går sönder är loggar skillnaden mellan "jag vet exakt vad som hände" och "jag har ingen aning om varför det slutade fungera."
Schemalägg och automatisera med eftertanke
Om du kör återkommande scraping, använd cron (Linux/Mac) eller Task Scheduler (Windows) — men övervaka för fel. Ett cron-jobb som tyst misslyckas i två veckor är värre än ingen automatisering alls.
Alternativ: Thunderbits Scheduled Scraper låter dig beskriva intervallet på vanlig svenska, utan att behöva cron-syntax.
Bästa praxis för laglighet och etik vid Reddit-scraping
Det här är inte en slentrianmässig friskrivning. Reddit har aggressivt tillämpat sina villkor sedan API-ändringarna 2023, och scraping av personuppgifter medför verklig juridisk risk.
Här är det som faktiskt spelar roll.
Reddits användarvillkor: vad de faktiskt säger
Reddits User Agreement (reviderad till och med 31 mars 2026) förbjuder uttryckligen åtkomst till, sökning i eller insamling av data från tjänsterna med automatiserade medel, om det inte tillåts enligt villkoren eller genom ett separat avtal. Data API Terms och Developer Terms lägger till mer detaljer: Reddit kan övervaka och granska utvecklares användning, ändra eller avbryta åtkomst och permanent blockera åtkomst vid överdriven eller missbrukande användning. Kommersiell användning kräver i allmänhet uttryckligt godkännande.
Mars 2026 års Responsible Builder Policy går längre: godkännande krävs innan du får åtkomst till Reddit-data via API:et, icke-godkänd kommersialisering och AI-/datagruvningsanvändning är förbjudna, och tillämpningen kan omfatta återkallade tokens, avstängning av appar eller konton samt avstängning av tillhörande bottar eller domäner.
Efterlevnad av robots.txt
Reddits nuvarande robots.txt är ovanligt restriktiv:
User-agent: *
Disallow: /
Det är ett generellt förbud för alla automatiserade user-agents. Den hänvisar också till Public Content Policy. Detta är mycket striktare än de tillåtande robots.txt-mönster som vissa utvecklare fortfarande antar från äldre web scraping-normer.
Bästa praxis: kontrollera alltid robots.txt innan du skrapar, även om ditt verktyg inte gör det automatiskt.
Personuppgifter och integritet (GDPR/CCPA)
Om du skrapar användarnamn, inläggshistorik eller någon annan personligt identifierbar information kan GDPR (EU) och CCPA (Kalifornien) vara tillämpliga. Bästa praxis: anonymisera eller aggregera personuppgifter innan lagring. Bygg inte profiler av enskilda användare utan rättslig grund.
Licenser för GitHub-repos: kontrollera innan du bygger
Många reddit scraper github-repos använder MIT- eller Apache-licenser (tillåtande), men vissa saknar licensfil helt — vilket juridiskt betyder "all rights reserved." Innan du forkar, modifierar eller bygger vidare på ett repo ska du alltid kontrollera LICENSE-filen. Ingen licens = juridiskt oklart, oavsett hur många stjärnor det har.
Tillämpningen är verklig 2025–2026
Reddits tillämpning tog inte slut 2023. Reddit lämnade in ett klagomål mot Anthropic 2025 med påståenden om obehörig scraping/användning av Reddit-innehåll, och gick också vidare mot Reddit v. SerpApi i slutet av 2025. Det här är tecken på att Reddit är berett att driva juridisk tillämpning, inte bara teknisk blockering.
Att välja rätt Reddit Scraper GitHub-angreppssätt 2026
Reddit scraper GitHub-landskapet har förändrats dramatiskt sedan 2023. De flesta repos är föråldrade. Hastighetsgränser och taket på 1 000 inlägg är verkliga begränsningar. Pushshift är borta för vanliga användare. Och Reddits policystack är mer tydlig — och mer aktivt tillämpad — än någonsin.
Kortversionen:
- PRAW är fortfarande den mest pålitliga open source-grunden om du kan acceptera Reddits API-begränsningar och vill bygga egen logik.
- Pushshift/PSAW är inte längre standardsvaret.
- snscrapes Reddit-modul är legacy och opålitlig.
- .json- och public-endpoint-scrapers är sköra och blockeras ofta 2026.
- Webbläsarbaserade verktyg — vare sig det är Playwright-repos eller no-code-alternativ som Thunderbit — är den mest praktiska vägen för många användare, särskilt icke-utvecklare.
Utgå från ditt användningsfall, inte från verktyget. Kör den fem minuter långa repo-hälsokontrollen innan du bestämmer dig för något GitHub-projekt.
Och om du hellre vill hoppa över installationen och börja skrapa Reddit på några minuter, testa Thunderbit.
Testa Thunderbit för Reddit-scraping Get Started Free
Vanliga frågor
Vilka är de bästa open source-Reddit-scrapers på GitHub 2026?
PRAW är fortfarande den mest pålitliga API-wrapppern, med aktivt underhåll och bra dokumentation. URS är ett trovärdigt, underhållet CLI-verktyg byggt på PRAW. Playwright-baserade scrapers fungerar för icke-API-scraping, och snscrapes Reddit-modul fungerar delvis men är i stort sett utan underhåll. Kontrollera alltid datum för senaste commit och öppna issues innan du använder något repo — de flesta av de 2 300+ Reddit scraper-repos på GitHub är inaktuella.
Är det lagligt att skrapa Reddit?
Att skrapa offentligt tillgänglig data befinner sig i en juridisk gråzon, men Reddits egna villkor är restriktiva. User Agreement, Data API Terms, Public Content Policy, Responsible Builder Policy och robots.txt motverkar alla obehörig mass-scraping. Kommersiell vidareanvändning av skrapad data kan kräva Reddits uttryckliga tillstånd. Om du skrapar personuppgifter kan GDPR och CCPA också bli aktuella.
Hur kommer jag förbi Reddits API-hastighetsgränser?
Använd exponentiell backoff, övervaka X-Ratelimit-Remaining-huvuden och överväg uppdelning i tidsfönster för att hålla dig inom gränserna. Webbläsarbaserad scraping (Playwright eller Thunderbit) kringgår API-hastighetsgränser eftersom den skrapar renderade sidor, men har egna kompromisser (sidladdningshastighet, anti-bot-skydd). Det finns inget magiskt trick som tar bort hastighetsgränser helt — de tillämpas på serversidan.
Kan jag skrapa Reddit utan API-nyckel?
Ja. Playwright-baserade scrapers och .json-URL-tricket kräver inga API-nycklar. Thunderbit kräver inte heller någon API-nyckel eftersom det skrapar via webbläsaren. Kompromisserna: .json-endpoints blockeras allt oftare (och ger 403 i många miljöer per april 2026), och webbläsarbaserad scraping är långsammare och mer resurskrävande än API-anrop.
Vad hände med Pushshift för Reddit-scraping?
Pushshifts publika API-åtkomst togs bort efter Reddits data-licensändringar med start 2023. PSAW-wrapppern är arkiverad och inaktuell. Begränsad akademisk åtkomst kan finnas via vissa godkända kanaler, men för de flesta som söker "reddit scraper github" i dag är Pushshift inte längre ett gångbart alternativ. Om du behöver djupa historiska Reddit-data, undersök Reddits godkända akademiska eller licensierade datavägar.
Läs mer




