
Varje gång någon frågar mig ”är det lagligt att skrapa Instagram?” brukar svaret delas upp i tre läger: ”helt okej”, ”absolut olagligt” och ”det beror på”. Det tredje lägret är det enda som faktiskt hjälper.
Förvirringen är verklig, eftersom svaret beror på vilken data du samlar in, var du och personerna i datan befinner er, hur du kommer åt den och varför du vill ha den. I den här artikeln reder vi ut begreppen. Jag går igenom de viktigaste domstolsavgörandena, skillnaden mellan att bryta mot en plattformsregel och att bryta mot lagen, en jämförelse mellan olika jurisdiktioner och ett praktiskt beslutsflöde så att du kan bedöma din egen situation. Det här är inte juridisk rådgivning — jag är skribent inom teknik, inte jurist — men det bör ge dig en tydligare karta över läget.
Vad betyder egentligen ”skrapa Instagram”?
Först en definition.
Instagram-skrapning innebär att man använder programvara för att automatiskt samla in offentligt synlig information från Instagrams webbplats eller app — till exempel profilbio, inläggstexter, kommentarer, hashtagganvändning, antal följare och engagemangsstatistik.
Det är inte samma sak som att använda Instagrams officiella Graph API, som har egna begränsningar, godkännanderegler och restriktioner för användningsområden. Skrapning använder inte den officiella API-vägen, utan hämtar data direkt från webbsidor eller appens gränssnitt.
Vanliga användningsområden:
- Leadgenerering: Hitta potentiella kunder eller influencers utifrån offentliga profiler och engagemangsmönster.
- Bevakning av konkurrenter: Följa hur ofta konkurrenter publicerar, deras engagemangsgrad och innehållsstrategi.
- Marknadsundersökningar: Analysera hashtagtrender, sentiment eller geografiska mönster i offentliga inlägg.
- Akademisk forskning: Studera offentlig diskurs, visuell kultur eller sociala nätverksdynamiker för en uppsats eller artikel.
Den här artikeln fokuserar på legalitetsfrågan — inte på hur man gör rent tekniskt. Om du vill veta om just ditt användningsfall kan leda till stämning, avstängning eller böter, fortsätt läsa.
Är det lagligt att skrapa Instagram? Det korta svaret
Att skrapa offentligt tillgänglig Instagram-data är generellt inte ett federalt brott enligt nuvarande amerikansk praxis — men ”inte ett brott” och ”helt okej” är två väldigt olika påståenden.
Tre olika rättsliga nivåer är relevanta, och mycket av förvirringen uppstår när de blandas ihop:
- Lagar om datoråtkomst (t.ex. amerikanska Computer Fraud and Abuse Act, CFAA): Är åtkomsten till datan ”obehörig”?
- Integritetsregler (t.ex. GDPR, CCPA): Innehåller datan personuppgifter, och har du en laglig grund för att behandla dem?
- Avtal/Användarvillkor: Förbjuder Instagrams villkor det du gör, och vad händer om du bryter mot dem?
Varje nivå har olika konsekvenser, olika sätt att drivas vidare och olika risknivåer. En skrapning kan vara fullt möjlig enligt en nivå men problematisk enligt en annan.
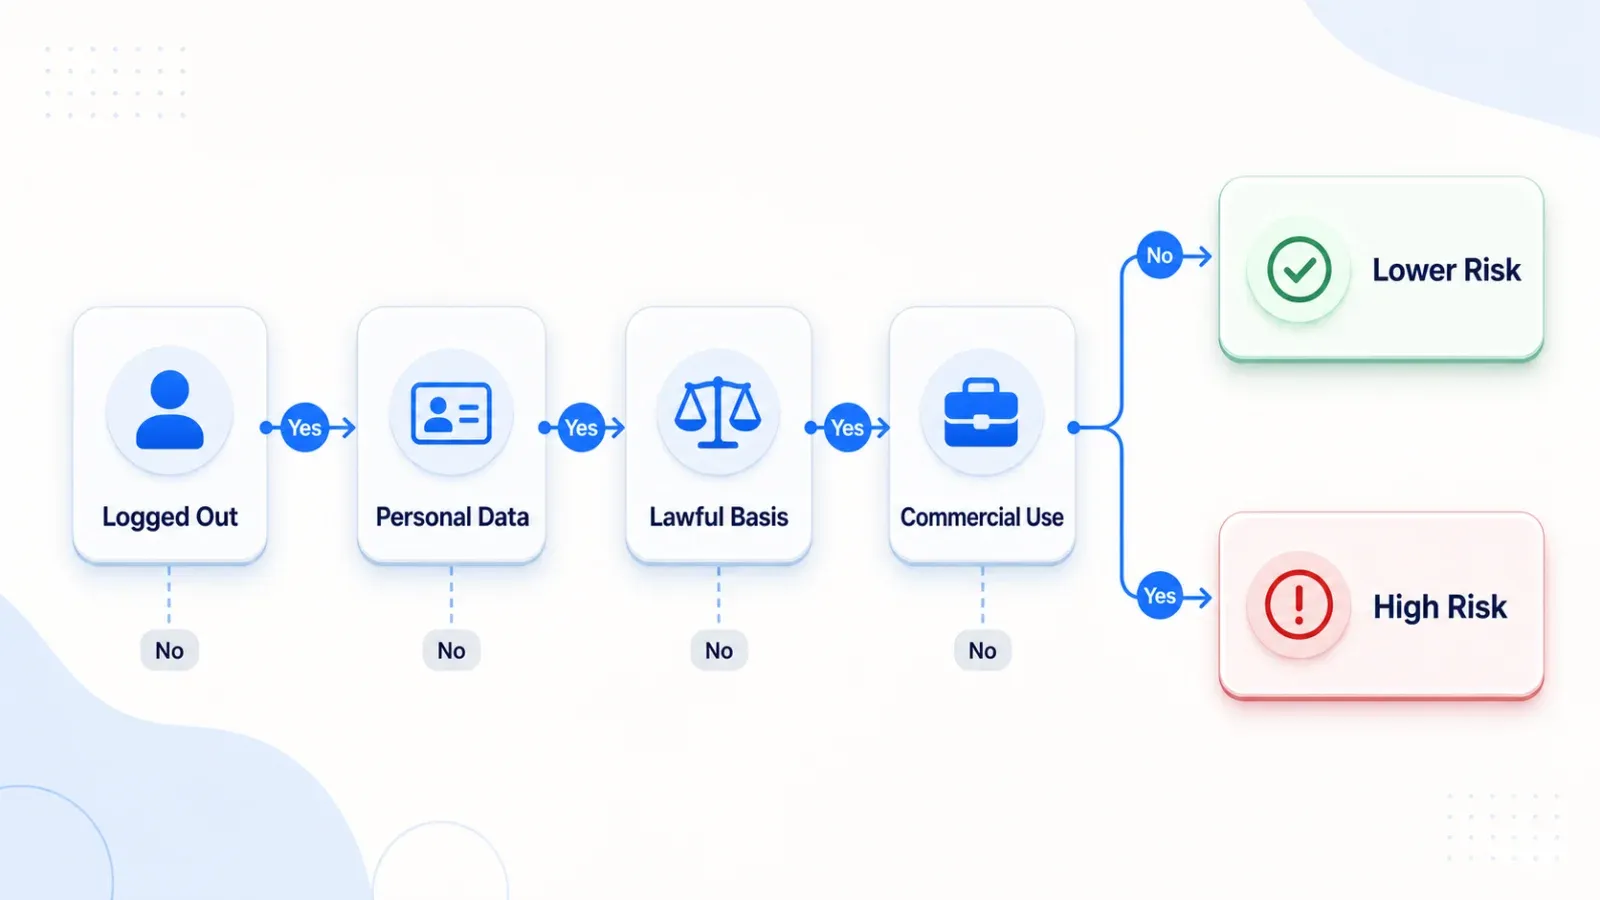
”Är min skrapning laglig?” — ett beslutsflöde du faktiskt kan följa
Jag har läst dussintals artiklar i ämnet. De listar alla samma juridiska faktorer i täta stycken — men ingen ger dig ett sätt att faktiskt bedöma din egen situation på under en minut. Här är ett beslutsflöde:
| Steg | Fråga | Om JA → | Om NEJ → |
|---|---|---|---|
| 1 | Är datan offentligt synlig utan inloggning? | Gå vidare till steg 2 | ⚠️ Hög risk — kan vara förenat med CFAA / åtkomstskydd |
| 2 | Innehåller datan personuppgifter (namn, foton, bios, e-postadresser)? | Gå vidare till steg 3 (GDPR/CCPA gäller) | Lägre risk — gå vidare till steg 4 |
| 3 | Har du en laglig grund enligt GDPR/CCPA (berättigat intresse, samtycke m.m.)? | Gå vidare till steg 4 | ⛔ Fortsätt inte utan juridisk rådgivning |
| 4 | Är användningen kommersiell (vidareförsäljning av data, leadgenerering, SaaS-produkt)? | Högre risk för tillsyn — granska villkorsrisk och tidigare cease-and-desist-fall | Lägre risk — särskilt för personligt eller akademiskt bruk |
| 5 | Undviker du tekniska kringgående åtgärder och överdriven automatiserad åtkomst? | Lägre praktisk risk | Ökar juridisk, plattforms- och kontorisk |
Det här är ingen frisedel — det är ett ramverk för riskbedömning. Om du svarade ”ja” på steg 1, 3 och 5, och ”nej” på steg 4, befinner du dig i en lägre riskzon. Om du är inloggad, samlar in personuppgifter utan laglig grund, säljer dem kommersiellt och struntar i plattformens skydd, staplar du risk på risk.
För affärsflöden är den lägre riskvägen ofta att helt undvika Instagram-insamling och i stället använda tillåtna offentliga källor som företagswebbplatser, creators landningssidor, e-handelsidor, kataloger eller licensierade datamängder. Flödet gäller oavsett vilket verktyg du använder.
Steg 1: Är datan offentligt synlig?
Testet med privat fönster: öppna ett inkognitofönster (utan att vara inloggad på Instagram), gå till sidan och titta. Om du kan se datan är den offentligt tillgänglig i praktisk åtkomstbemärkelse. Amerikanska fall som hiQ v. LinkedIn behandlar offentligt tillgänglig data som går att se utan inloggning annorlunda än data bakom åtkomstskydd när det gäller CFAA — men det är inte samma sak som ett allmänt tillstånd.
Instagram ändrar också vad som är synligt utan inloggning över tid. Kontrollera vad som faktiskt är offentligt i dag innan du antar att din mål-data kan nås utan konto.
Steg 2: Innehåller den personuppgifter?
Personuppgifter definieras brett enligt GDPR och CCPA: användarnamn, profilbilder, biografier, e-postadresser, platsmarkeringar och till och med slutsatser som dras från bilder eller bildtexter. Om du skrapar Instagram-profiler samlar du nästan säkert in personuppgifter.
Offentlig synlighet innebär inte att du undantas från integritetslagstiftning — en av de mest seglivade missuppfattningarna i detta område.
Steg 3: Har du en laglig grund?
Enligt GDPR artikel 6 behöver du en dokumenterad laglig grund innan du behandlar personuppgifter. ”Berättigat intresse” är den vanligaste grunden som åberopas vid skrapning, men det kräver en formell intresseavvägning — ditt intresse mot den registrerades rättigheter. Samtycke är ett annat alternativ, men opraktiskt vid skrapning i större skala.
Enligt CCPA har invånare i Kalifornien rättigheter kopplade till sina personuppgifter, inklusive rätt att få veta, radera och välja bort försäljning/delning. Om du är ett kvalificerat företag som samlar in data om personer i Kalifornien gäller dessa skyldigheter.
Ingen laglig grund + personuppgifter = pausa och ta juridisk rådgivning.
Steg 4: Är användningen kommersiell?
Kommersiell användning — att sälja vidare datamängder, bygga leadgenereringsprodukter eller mata en SaaS-tjänst — drar oftast till sig mest uppmärksamhet från Meta. Personliga projekt och akademisk forskning innebär lägre praktisk risk, även om risken inte är noll.
Steg 5: Respekterar du rate limits och plattformens skydd?
Kringgå inte CAPTCHA, inloggningsväggar, bot-skydd eller kontobegränsningar. Även när datan verkar offentlig ökar aggressiv automatiserad åtkomst riskerna för plattformsingripanden, avtalsproblem, integritetsproblem och operativa problem.
Offentlig vs privat data: den viktigaste gränsen
Allt hänger på en distinktion: offentlig kontra privat data.
| Lägre risk att skrapa | Skrapa inte |
|---|---|
| Offentliga profilbios och visningsnamn | Inlägg/Stories från privata konton |
| Offentliga bildtexter och kommentarer | Direktmeddelanden (DM) |
| Offentlig hashtagganvändning | Innehåll bakom inloggningsväggar |
| Offentliga engagemangssiffror (likes, kommentarsantal) | Data från fejkade/inköpta konton |
| Offentliga profilbilder (med integritetsreservationer) | Följarlistor i stor skala (gråzon) |
Gråzoner är vanliga. Följare-/följarlistor, taggad platsdata och konton som tillhör barn befinner sig i juridiskt osäkert territorium. Även om de tekniskt sett är synliga kan skrapning i stor skala väcka integritetsfrågor eller leda till åtgärder från plattformen. När du är osäker, välj att inte samla in det.
Resonemanget i amerikansk rätt om datoråtkomst bygger på fall som hiQ v. LinkedIn, men håll räckvidden smal: det handlar om åtkomstbehörighet enligt CFAA, inte om att varje offentlig profil på sociala medier fritt får samlas in och återanvändas. Integritetslagstiftning som GDPR fungerar enligt ett annat ramverk.
Brott mot användarvillkor vs straffrättsligt ansvar: den största missuppfattningen om Instagram-skrapning
Jag säger det rakt ut:
Att bryta mot Instagrams användarvillkor är inte ett brott.
Instagrams användarvillkor anger att användare inte får skapa konton eller komma åt/samla in information på otillåtna sätt, inklusive automatiserad insamling utan Instagrams uttryckliga tillstånd. Metas Automated Data Collection Terms kräver också uttryckligt skriftligt tillstånd.
Det här är avtalsregler — överenskommelser mellan dig och Instagram. Bryter du mot dem kan det leda till kontostängning och i extrema fall civilrättsliga stämningar. Det är inte straffrättsliga bestämmelser.
Här är den juridiska hierarkin, förenklat:
| Juridisk nivå | Vad det är | Konsekvens vid överträdelse |
|---|---|---|
| Avtalsrätt (villkor) | Avtal mellan dig och Instagram | Kontostängning, civil talan för avtalsbrott |
| Lagstadgad rätt (CFAA) | Federal lag om datoråtkomst | Möjligt straffrättsligt ansvar — men kraftigt inskränkt av Van Buren v. US (2021) |
| Regulatorisk rätt (GDPR/CCPA) | Integritetsregler | Böter upp till 4 % av global omsättning (GDPR); olika sanktioner enligt CCPA |
Det är den viktiga skillnaden: en plattformsregel kan skapa konto- och avtalsrisk utan att automatiskt bli en lag om datorbrott.
Nyansen är viktig eftersom Meta v. Bright Data (januari 2024) gick Bright Data till mötes när det gällde Metas avtalsbrottsteori för inloggningsfri skrapning av offentlig Facebook- och Instagram-data. Men avgörandet var snävt: inloggningsfri åtkomst, offentlig data, ett specifikt faktaunderlag och en amerikansk distriktsdomstol. Det gav inte grönt ljus för skrapning bakom inloggningsväggar, insamling via fejkade konton, privat data, integritetsbrott eller all kommersiell återanvändning av Instagram-data.
Vad som faktiskt händer om du skrapar Instagram: en riskmatris
Många frågar ”Kan Instagram stämma mig?” och ”Blir mitt konto bannat?” Här är den ärliga bilden:
| Konsekvens | Vad som händer | Allvarlighetsgrad | Sannolikhet |
|---|---|---|---|
| Kontostängning/suspension | Omedelbart, normalt ingen överklagandeprocess | Låg-medel | HÖG vid aggressiv skrapning |
| Cease & desist-brev | Juridisk varning från Metas ombud | Medel (juridiska kostnader för svar) | MEDEL vid kommersiell användning |
| Civilrättslig stämning (avtalsbrott) | Skadeståndskrav, föreläggande | Hög | LÅG (främst vid hög volym/kommersiella upplägg) |
| CFAA-åtal | Straffrättsliga anklagelser | Mycket hög | MYCKET LÅG (kraftigt begränsad efter Van Buren) |
| GDPR-böter | Upp till 4 % av global omsättning | Mycket hög | LÅG-MEDEL vid skrapning av EU-personuppgifter |
De två mest sannolika följderna är kontobegränsningar och cease-and-desist-brev. Den bästa kontrollen är inte ett tekniskt kringgående; det är tydlig avgränsning: undvik inloggad eller spärrad insamling, minimera personuppgifter, dokumentera syfte och laglig grund och använd officiella eller samtyckta vägar när det går.
Meta har på sin privacy progress page sagt att de blockerar miljarder misstänkta obehöriga skrapningsförsök per dag över Facebook, Instagram och WhatsApp. Det är Metas eget påstående, och jag kan inte oberoende verifiera siffran, men det visar hur seriöst de ser på tillsynen.
Land för land: var är det lagligt att skrapa Instagram?
Lagligheten beror på jurisdiktion, och inga två länder behandlar detta exakt likadant. Här är jämförelsetabellen som, så vitt jag kan se, ingen annan har publicerat i ett lättöverskådligt format:
| Jurisdiktion | Viktiga lagar | Skrapning av offentlig data | Skrapning av personuppgifter | Risk enbart p.g.a. villkor | Särskilt fall/avgörande |
|---|---|---|---|---|---|
| USA | CFAA, delstatliga CFAA-varianter | Lägre CFAA-risk för offentlig data utan inloggning i vissa fall, men starkt faktaberoende | CCPA/CPRA kan gälla för kvalificerade företag och invånare i Kalifornien | Avtals-/konto-/civilrisk kan ändå kvarstå | hiQ v. LinkedIn (2022), Van Buren v. US (2021), Meta v. Bright Data (2024) |
| EU | GDPR, databasdirektivet | Lägre integritetsrisk när personuppgifter inte ingår; andra rättigheter kan ändå spela in | Kräver laglig grund enligt art. 6 | Avtal och plattformsåtgärder kan ändå spela in | Tillsynsåtgärder enligt GDPR; särskild kategori-data i bilder/bios |
| Storbritannien | UK GDPR, DPA 2018 | Liknar EU | Kräver laglig grund; ICO:s vägledning uppdaterad april 2026 | Avtal och plattformsåtgärder kan ändå spela in | ICO:s vägledningsdokument |
| Kanada | PIPEDA, provinsiella lagar | Lägre risk när personuppgifter inte ingår | Samtycke och andra integritetsskyldigheter kan gälla | Avtal och plattformsåtgärder kan ändå spela in | Begränsad praxis specifikt om skrapning |
| Brasilien | LGPD | Lägre risk när personuppgifter inte ingår | Kräver laglig grund | Avtal och plattformsåtgärder kan ändå spela in | Framväxande tillsyn; inget större skrapningsfall ännu |
| Australien | Privacy Act 1988 | Lägre risk när personuppgifter inte ingår | Australian Privacy Principles (APP) kan gälla | Avtal och plattformsåtgärder kan ändå spela in | Begränsad praxis specifikt om skrapning |
Ett mönster framträder i alla sex jurisdiktioner. I varje jurisdiktion är skrapning av icke-personlig offentlig data det lägsta riskfallet. Så fort personuppgifter kommer in i bilden träder integritetslagstiftning in — och ”datan var offentligt synlig” är inte ett försvar enligt GDPR, UK GDPR eller LGPD. Det är en faktor, men inte en laglig grund i sig.
För läsare som tänker på datalokalisering och gränsöverskridande insamling: var datan samlas in, behandlas och lagras kan spela roll. Om du använder ett tredjepartsverktyg eller en leverantör för tillåtna offentliga källor, kontrollera region, lagringstid och integritetskontroller innan du samlar in personuppgifter.
Viktiga juridiska milstolpar för risker med Instagram-skrapning
Några juridiska och plattformspolitiska milstolpar förklarar varför svaret fortfarande är nyanserat:
- 2017: hiQ v. LinkedIn — distriktsdomstol utfärdar ett preliminärt förbud som hindrar LinkedIn från att blockera hiQ:s skrapning av offentliga profiler. Första stora amerikanska avgörandet som gynnar skrapning av offentlig data.
- 2018: GDPR träder i kraft i EU och etablerar världens mest omfattande ramverk för skydd av personuppgifter.
- 2020: CCPA träder i kraft i Kalifornien. Meta lämnar in Meta v. BrandTotal och riktar in sig på skrapning av Facebook-data.
- 2021: Van Buren v. United States — USA:s högsta domstol snävar in CFAA:s bestämmelse om att ”överskrida behörig åtkomst”. Det här är en avgörande vändpunkt för skrapningsrätt.
- 2022: hiQ v. LinkedIn — 9th Circuit fastställer slutligt att skrapning av offentlig data inte bryter mot CFAA.
- 2024: Meta v. Bright Data — Northern District of California slår fast att Facebooks/Instagrams villkor inte förbjöd Bright Datas inloggningsfria skrapning av offentlig data. Snävt men betydelsefullt.
- 2024 och framåt: Meta fortsätter sin offentliga anti-skrapningslinje. På sin privacy progress page säger Meta att de blockerar miljarder misstänkta obehöriga skrapningsförsök per dag över Facebook, Instagram och WhatsApp. Betrakta det som Metas eget tillsynspåstående, inte som ett oberoende verifierat mått.
Hur Van Buren v. US ändrade kalkylen för skrapning av offentlig data
Före Van Buren fanns det ett reellt argument för att skrapning av vilken webbplats som helst, mot ägarens vilja, kunde vara ett federalt brott enligt CFAA. Lagtexten om att ”överskrida behörig åtkomst” var tillräckligt bred för att vissa åklagare och kärande försökte tänja den till att omfatta brott mot användarvillkor.
Högsta domstolen stoppade detta. I Van Buren antog domstolen ett ”grindarna upp kontra grindarna nere”-synsätt: CFAA gäller när någon kringgår en teknisk åtkomstspärr (som en inloggningsvägg eller ett lösenord), inte när man helt enkelt kommer åt information som är fritt tillgänglig men som webbplatsägaren helst inte vill att man ska se.
För skrapning är den praktiska effekten betydande. Om datan ligger bakom en inloggning eller annan åtkomstkontroll ökar CFAA-risken snabbt. Om datan ligger på en offentlig sida som vem som helst kan besöka i ett inkognitofönster är CFAA-argumentet i regel svagare, även om integritets-, avtals-, IP- och plattformsrisker kan kvarstå.
De flesta konkurrentartiklar hänvisar till hiQ men förklarar Van Buren dåligt. De kompletterar varandra, och Van Buren är sannolikt viktigare eftersom det är ett Högsta domstolsavgörande med nationell räckvidd, inte ett avgörande från en appellationsdomstol.
Metas verktygslåda för tillsyn
Meta har inte stått stilla. Utifrån Metas egna offentliga uttalanden omfattar deras verktyg för tillsyn bland annat:
- Rate limits och datagränser för att minska automatiserad insamling.
- Mönsterdetektering för ovanligt insamlingsbeteende.
- Kontobegränsning eller avstängning när Meta bedömer att automation bryter mot villkoren.
- Cease-and-desist-brev, stämningar och begäran om borttagning vid skrapning i hög volym eller med kommersiellt syfte.
Även om du bara bryr dig om juridisk risk spelar plattformsåtgärder roll. Metas offentliga hållning är tydlig: automatiserad insamling från deras plattformar utan tillstånd bryter mot deras regler, och de satsar mycket på att stoppa den.
Skrapning av Instagram för akademisk forskning: vad studenter och forskare behöver veta
Doktorander och akademiska forskare befinner sig i en annan riskkategori — ofta lägre än kommersiell vidareförsäljning av data, men inte noll.
Lägre risk än kommersiell skrapning, ja. Automatiskt undantagna, nej.
Fair use-analys för Instagram-data
I USA tar fair use-doktrinen (17 U.S.C. § 107) hänsyn till fyra faktorer:
- Syfte och karaktär för användningen: Icke-kommersiell, utbildande och transformativ användning talar för fair use. Akademisk forskning brukar stå sig väl här.
- Arten av det upphovsrättsligt skyddade verket: Faktabaserad data (följarsiffror, inläggsdatum) är mindre skyddad än kreativt innehåll (foton, bildtexter). Att skrapa kreativt innehåll är mer riskfyllt.
- Mängden som används: Att skrapa en hel offentlig profil är något annat än att skrapa några få datapunkter. Minimera det du samlar in.
- Påverkan på marknaden: Om din forskning inte konkurrerar med Instagrams kommersiella erbjudanden talar det här faktorn till din fördel.
Akademisk forskning hamnar oftast på den gynnsamma sidan av denna analys, men det är ingen garanti — särskilt inte om du skrapar stora mängder kreativt innehåll (bilder, videor, fullständiga bildtexter).
IRB-aspekter
Om din forskning innehåller data om identifierbara människor — och Instagram-profiler är per definition identifierbara — kan ditt universitets Institutional Review Board (IRB) behöva granska och godkänna din datainsamlingsplan. Detta gäller även om datan är offentligt synlig. Kontrollera med din IRB innan du börjar skrapa.
Plattformspecifika forskningsprogram
Meta erbjuder Content Library and API för godkända forskare, vilket ger tillgång till offentligt tillgängligt innehåll från Facebook, Instagram och Threads. Ansökningar granskas oberoende. Om du är berättigad är detta en lägre risk och officiell väg för akademisk Instagram-forskning.
(Obs: Metas CrowdTangle-verktyg, som var populärt bland forskare, har i stort sett avvecklats. Content Library/API är dess efterföljare.)
Dataminimering för forskare
Praktiska råd:
- Samla bara in de datapunkter du behöver för din forskningsfråga. Skrapa inte hela profiler ”för säkerhets skull”.
- Anonymisera datamängder så tidigt som möjligt — ta bort användarnamn, sudda profilbilder, aggregera i stället för att redovisa på individnivå.
- Fastställ en lagringspolicy: hur länge ska du spara datan, och när ska den raderas?
- Dokumentera metod och laglig grund (för GDPR-efterlevnad om det är relevant).
För forskning utanför Instagram-specifik insamling gäller dataminimering: samla bara in de fält som behövs för det angivna syftet, undvik att lagra onödig råtext och dokumentera lagringstid och åtkomstkontroller.
Lägre-risk-checklista innan du samlar in Instagram-data
Nu när det juridiska landskapet är kartlagt kommer här en praktisk checklista för att minska risken:
- Skrapa bara offentligt synlig data. Använd testet med inkognitofönster. Om du inte kan se den utan inloggning, skrapa den inte.
- Kringgå aldrig inloggningsväggar eller använd fejkade konton. Här skjuter CFAA-, avtals- och plattformsriskerna i höjden.
- Behandla tekniska spärrar och kontokontroller som stopp-skyltar. CAPTCHA, inloggningsväggar, kontobegränsningar och anti-botsystem är tydliga varningssignaler.
- Minimera insamlingen av personuppgifter. Samla bara in det du faktiskt behöver. Om du inte behöver användarnamn, samla inte in dem.
- Ha en policy för lagring och radering av data. Vet hur länge du ska behålla datan och när du ska ta bort den.
- Dokumentera din lagliga grund om du samlar in personuppgifter (särskilt enligt GDPR). ”Berättigat intresse” kräver en skriftlig intresseavvägning, inte bara en vag avsikt.
- Använd officiella, licensierade, samtyckta eller icke-Instagram-baserade källor där de passar. Den lägsta risken är ofta att inte samla in från Instagram alls.
En notis om verktyg och alternativ
Thunderbit är byggt för tillåtna arbetsflöden på öppna webben utanför Metas produkter. Det tillhandahåller inte datainsamling från Facebook, Instagram, Threads, Messenger, WhatsApp eller Meta Ad Library, kontokoppling eller funktioner för att kringgå skydd.
För många affärsfrågor ger offentliga företagswebbplatser, kataloger, e-handelssidor, licensierade datamängder och andra källor utanför Meta den information som behövs, med tydligare villkor och integritetsskyldigheter. Välj en källa som uttryckligen tillåter den tänkta användningen och minimera sedan den information du sparar.
Viktigaste slutsatserna
- Att skrapa offentligt tillgänglig Instagram-data är inte automatiskt olagligt enligt nuvarande amerikansk praxis, men ”inte olagligt” och ”riskfritt” är två helt olika saker.
- Tre juridiska nivåer spelar roll: lagar om datoråtkomst (CFAA), integritetsregler (GDPR/CCPA) och avtal/användarvillkor. Blanda inte ihop dem.
- Brott mot användarvillkor är inte brott. Det kan leda till kontostängning och civilrättsliga stämningar, men inte straffrättsligt åtal (efter Van Buren).
- Integritetslagstiftning gäller även offentlig data. Om du samlar in personuppgifter behöver du en laglig grund — särskilt enligt GDPR och CCPA.
- Jurisdiktion spelar roll. Det juridiska läget skiljer sig tydligt mellan USA, EU, Storbritannien, Kanada, Brasilien och Australien.
- Beslutsflödet är din vän. Gå igenom det för varje datainsamlingsprojekt: offentlig åtkomst → personuppgifter → laglig grund → användningsfall → plattformsregler.
- Akademiska forskare har lägre men inte obefintlig risk. Använd Metas Content Library/API om du är berättigad, minimera insamlingen, anonymisera tidigt och kontrollera med din IRB.
- Överväg alternativa datakällor. För många affärsfall ger offentliga webbplatser, kataloger och creatorsidor den data du behöver utan plattformsrisker kopplade till Instagram. Välj en källa som uttryckligen tillåter den avsedda användningen.
- Rådgör med jurist vid kommersiell användning med höga insatser. Den här artikeln är en karta, inte ett juridiskt utlåtande.
Vanliga frågor om laglig Instagram-skrapning
Kan Instagram stämma mig för att skrapa offentlig data?
Meta kan skicka ett cease-and-desist-brev eller väcka civil talan för brott mot användarvillkoren. Men amerikanska domstolar — inklusive i Meta v. Bright Data (2024) — har bedömt att Instagrams villkor inte förbjöd inloggningsfri skrapning av offentlig data i vissa sammanhang, och Van Buren v. US (2021) snävar avsevärt in CFAA-ansvaret för åtkomst till offentlig information. Sannolikheten för en stämning är låg vid småskalig, icke-kommersiell användning, men inte noll — särskilt inte vid kommersiell verksamhet.
Är det lagligt att skrapa Instagram i Europa?
Att skrapa offentligt tillgänglig, icke-personlig data är vanligtvis ett lägre integritetsrisk-scenario, men Instagram-data innehåller ofta personuppgifter. Om personuppgifter ingår behöver du en laglig grund enligt GDPR artikel 6 — till exempel berättigat intresse med dokumenterad intresseavvägning. Böter vid bristande efterlevnad kan uppgå till 4 % av global årsomsättning. ICO:s vägledning (uppdaterad april 2026) kräver att organisationer fastställer och dokumenterar sin lagliga grund innan behandling.
Kommer mitt Instagram-konto att stängas av för skrapning?
Kontobegränsningar är en av de mest sannolika följderna av aggressiv skrapning. Instagrams policy för kontobegränsning beskriver otillåten skrapning som automation som används för att samla in information i strid med villkoren. Att undvika skrapning från personliga konton minskar exponeringen för avstängning, men gör inte Instagram-insamling juridiskt eller avtalsmässigt riskfri.
Är det lagligt att skrapa Instagram för akademisk forskning?
Generellt lägre risk än kommersiell vidareförsäljning, särskilt för icke-kommersiell forskning om offentlig data, men inte automatiskt undantaget. Fair use eller fair dealing kan vara relevant, men forskare bör kontrollera IRB-krav när de hanterar identifierbara mänskliga subjektdata, praktisera dataminimering och överväga att använda Metas Content Library and API om de är berättigade.
Vad är skillnaden mellan att skrapa Instagram och att använda Instagram API?
Det officiella Instagram Graph API ger strukturerad åtkomst för godkända affärs- och creator-konton, men det har begränsningar, granskningskrav och policyrestriktioner. Skrapning samlar in data som syns på webbplatsen utanför den officiella API-vägen. Båda vägarna har juridiska aspekter: API-användning styrs av Metas utvecklarvillkor, medan inloggningsfri skrapning av offentlig data har fått positiv behandling i vissa snäva amerikanska fall men kan ändå utlösa problem kring villkor, integritet, immaterialrätt och plattformsåtgärder. För de flesta affärsfall är det officiella API:t, samtyckt data, licensierad data eller offentliga källor utanför Instagram lägre risk.
Läs mer




