
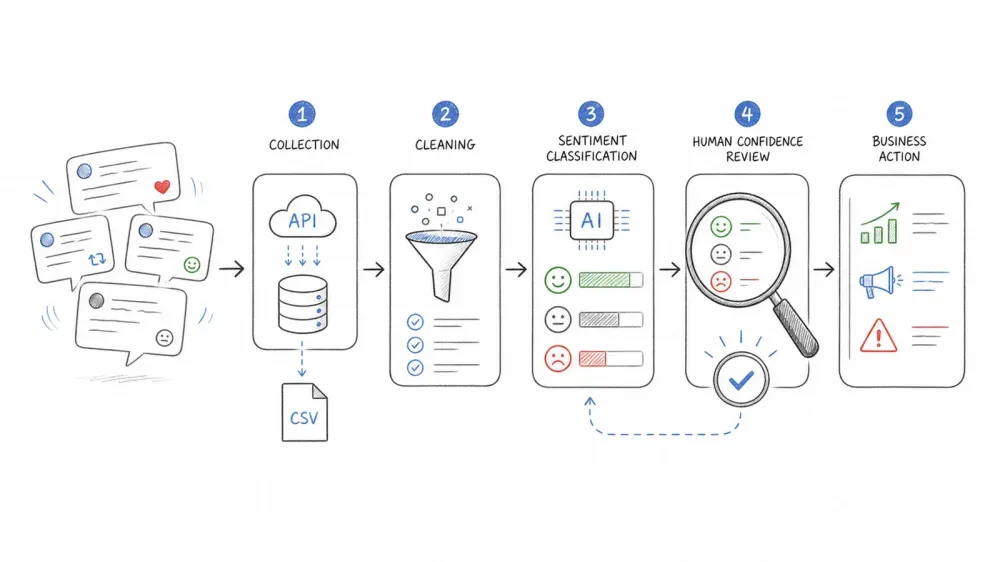
Öppna ett kalkylark med 300 råa inlägg så blir problemet tydligt direkt: kopiera, klistra in, läs, kisar, gissa, upprepa — och ändå vet du kanske fortfarande inte om folk älskade eller hatade lanseringen du följer.
Det är just den typen av misslyckande som Twitter sentimentanalys är till för. Men här är problemet: de flesta guider om ämnet är fast i 2022. De utgår från fri API-tillgång som inte längre finns, rekommenderar modeller som snubblar på sarkasm och emoji, och hoppar över de förbehandlingssteg som faktiskt avgör om resultaten betyder något. Jag har tillbringat mycket tid i SaaS- och automationsvärlden (bland annat med att bygga Thunderbit), och jag har sett landskapet för Analys av sociala medier förändras rejält. Den ärliga, uppdaterade vägen omfattar både Python och no-code-flöden, med metoder för datainsamling och modeller som speglar verkligheten 2026.
Vad är Twitter-sentimentanalys?
Twitter sentimentanalys är processen att automatiskt klassificera inlägg på X som positiva, negativa eller neutrala utifrån text, emoji och sammanhang. Tänk på det som att lära en maskin att läsa ett inlägg och svara: "Är den här personen glad, missnöjd eller någonstans mittemellan?"
Sentimentanalys skiljer sig dock från generell social listening. Social listening handlar om att följa vad folk pratar om — ämnen, trender och volym. Sentimentanalys är lagret ovanpå som poängsätter och klassificerar: den berättar hur människor känner inför det de säger. Begreppet har rötter i datorlingvistik och forskning om opinionsanalys som går tillbaka decennier, men har först under de senaste åren blivit ett bredare affärsverktyg.
Det finns några vanliga nivåer av klassificering:
- Binär: Positiv eller negativ (enklast, men tappar nyanser)
- Ternär: Positiv, neutral eller negativ (det vanligaste standardvalet)
- Finfördelad: Mycket positiv → mycket negativ (användbart för forskning och detaljerad varumärkesuppföljning)
Och det finns närliggande men distinkta uppgifter — som känsloidentifiering (arg, ledsen, glad), ståndpunktsanalys (för eller emot ett påstående), aspektbaserad sentimentanalys (vad någon tycker om pris kontra kvalitet) och sarkasm-/ironiidentifiering. TweetEval-benchmarken behandlar dessa som separata uppgifter, och det med rätta: en enda sentimentpoäng kan inte besvara alla affärsfrågor. Om du följer en produktlansering vill du troligen ha aspektbaserad sentimentanalys ("älskar kameran, hatar batteriet"). Om du övervakar en kris vill du ha känsloläge och volym, inte bara polaritet.
Varför Twitter-sentimentanalys är viktig för ditt företag
X bygger på konversation i realtid, så reaktioner på lanseringar, liveevenemang och nyheter kan samlas på väldigt kort tid. För företag är just den hastigheten poängen. Sentimentanalys förvandlar en brandvägg av ostrukturerad text till strukturerad data som ett team kan granska och agera på.
De vanligaste användningsområdena ser ut så här:
| Användningsområde | Team | Affärsresultat |
|---|---|---|
| Övervakning av varumärkesrykte | PR, marknadsföring | Fånga negativa toppar innan de blir virala |
| Feedback på produktlanseringar | Produkt, marknadsföring | Se vad som fungerar och vad som inte gör det i realtid |
| Konkurrensanalys | Strategi, marknadsföring | Jämför varumärkesuppfattning mot konkurrenter över samma tidsfönster |
| Krisdetektering | PR, drift | Utlös mänsklig granskning när negativ volym ökar snabbt |
| Kampanjresultat | Marknadsföring | Mät sentimentförändring per kreativet, kanal eller tid |
| Marknads- och aktiesentiment | Finans, forskning | Följ publikens stämning kring rapporter, händelser eller policy |
| Politisk och policyrrelaterad forskning | Forskning, myndigheter | Mät allmän opinion kring frågor i stor skala |
För att göra det konkret: X:s Sammanfattning av Super Bowl 2026 rapporterade 16 miljoner inlägg från 4 miljoner skribenter, 5 miljarder visningar och 605 miljoner videovisningar kring ett enda evenemang — med hälften av samtalet i realtid. Det är en skala där manuell läsning är omöjlig och automatiserad sentimentpoängsättning blir avgörande.
Och det handlar inte bara om volym. X:s egen BrandRanx-metodik kombinerar volym, engagemang och sentiment — vilket understryker att sentiment blir som starkast när det kombineras med andra signaler, inte används isolerat.
Slutsatsen: om ditt team fattar beslut baserat på allmän uppfattning — produkt, varumärke, kampanj eller kris — är sentimentanalys på X-data en av de snabbaste återkopplingslooparna som finns.
X API 2026: Så får du faktiskt tag i inläggsdata
Det är här de flesta guider går sönder. Om du någon gång har följt en Tweepy-baserad guide, klistrat in koden och stött på en betalvägg eller ett kryptiskt fel är du inte ensam. De gamla nivåerna Free / Basic / Pro finns inte längre. X:s API är nu pay-per-usage med förbetalda krediter, med kostnader per endpoint och spårning av användning i realtid.
En ärlig jämförelse av alla aktuella metoder för datainsamling:
| Metod | Kostnad (2026) | Volym | Kunskapsnivå | Kommentarer |
|---|---|---|---|---|
| X API v2 (pay-per-use) | $0,005 per läst inlägg | Upp till 2 miljoner inläggsläsningar/månad (självbetjäning) | Medel (Python) | Officiell, reproducerbar, kompatibel |
| Full-Archive Search | $0,005 per returnerat inlägg; $0,010 per fullarchive-räkningsförfrågan | Bakåt till mars 2006 | Medel–avancerad | Finns för pay-per-use och Enterprise |
| Filtered Stream | Inläggsläsningar debiteras vid leverans | Realtime, kontinuerligt | Medel–avancerad | Bäst för insamling i realtid |
| Färdiga dataset (Kaggle, Sentiment140) | $0 | Statisk, endast historisk | Nybörjare | Bra för lärande, inte för liveanalys |
| snscrape, Twint, Twikit m.fl. | $0 | Opålitligt / går ofta sönder | Avancerad | snscrape har inte fungerat för X-sökning sedan 2023; Twint är arkiverat; Twikit använder inofficiella metoder |
| Ditt eget X-arkiv | $0 | Endast dina egna inlägg | Nybörjare | Användbart för personlig analys |
Några saker att känna till:
- De gamla nivåerna Free/Basic/Pro är borta. Följ inte guider som refererar till dem som om de vore aktuella.
- snscrape är dött för X. Underhållaren bekräftade 2024 att Twitter-sökning via scraping inte längre fungerar. Twint är arkiverat. Twikit använder inofficiell scraping och cookies — aktivitet är inte detsamma som tillstånd.
- X:s villkor förbjuder scraping via webbläsare utan skriftligt förhandsgodkännande. Det betyder att Selenium, Playwright och webbläsartillägg inte är kompatibla genvägar för API-tillgång på X.
X API v2: Vad du faktiskt får
En vanlig läsning av ett inlägg kostar $0,005 per returnerat inlägg. Läsningar av användare kostar $0,010 styck. Så 10 000 unika inläggsläsningar landar på ungefär $50 innan andra resurskostnader. Självbetjäningsgränsen är 2 miljoner inläggsläsningar per månad. Priser kan ändras — kontrollera alltid Developer Console.
För sentimentarbete vill du ha mer än bara id och text. Ett användbart minimischema inkluderar created_at, lang, author_id, conversation_id, referenced_tweets, entities, context_annotations och public_metrics. Spara det råa svaret samt en oföränderlig logg över din fråga, endpoint, UTC-fönster och sidnumrerings-token. Utan det är din datamängd inte reproducerbar.
En annan detalj: X:s migrering av sökindex den 4 maj 2026 förändrade vilken datamängd man faktiskt ser. Keyword REST search returnerar inte längre reposts, medan Filtered Stream är oförändrad. Om du jämför resultat före och efter det datumet kan du räkna på olika populationer.
Färdiga dataset: Bra för lärande, inte för liveanalys
Sentiment140 (1,6 miljoner tweets, distant-supervised etiketter) och olika Kaggle-dataset är gratis och utmärkta för utbildning och benchmarkning. Men Sentiment140 samlades in 2009. TweetEvals sentimentdel bygger på SemEval-data från 2013–2016. De kan inte bevisa att din modell fungerar på språk, slang eller händelser från 2026.
En notis om Thunderbit och X-data
Jag vill vara tydlig här, eftersom vi byggde Thunderbit: Thunderbit är ett AI-drivet web scraping- och automationsverktyg som fungerar på många kompatibla webbplatser. Men X:s nuvarande villkor förbjuder scraping via webbläsare utan samtycke. Därför kommer jag inte att positionera Thunderbit som ett sätt att kringgå kostnader eller åtkomstbegränsningar i X API — det vore missvisande. För X-data ska du använda det officiella API:t, en auktoriserad leverantör eller ditt eget kontos arkiv. Där Thunderbit passar in i ett sentimentflöde är i nästa steg: strukturering, märkning och export av data du redan har samlat in via en tillåten väg. Mer om det senare.
Välja rätt sentimentmodell: VADER vs. TextBlob vs. RoBERTa
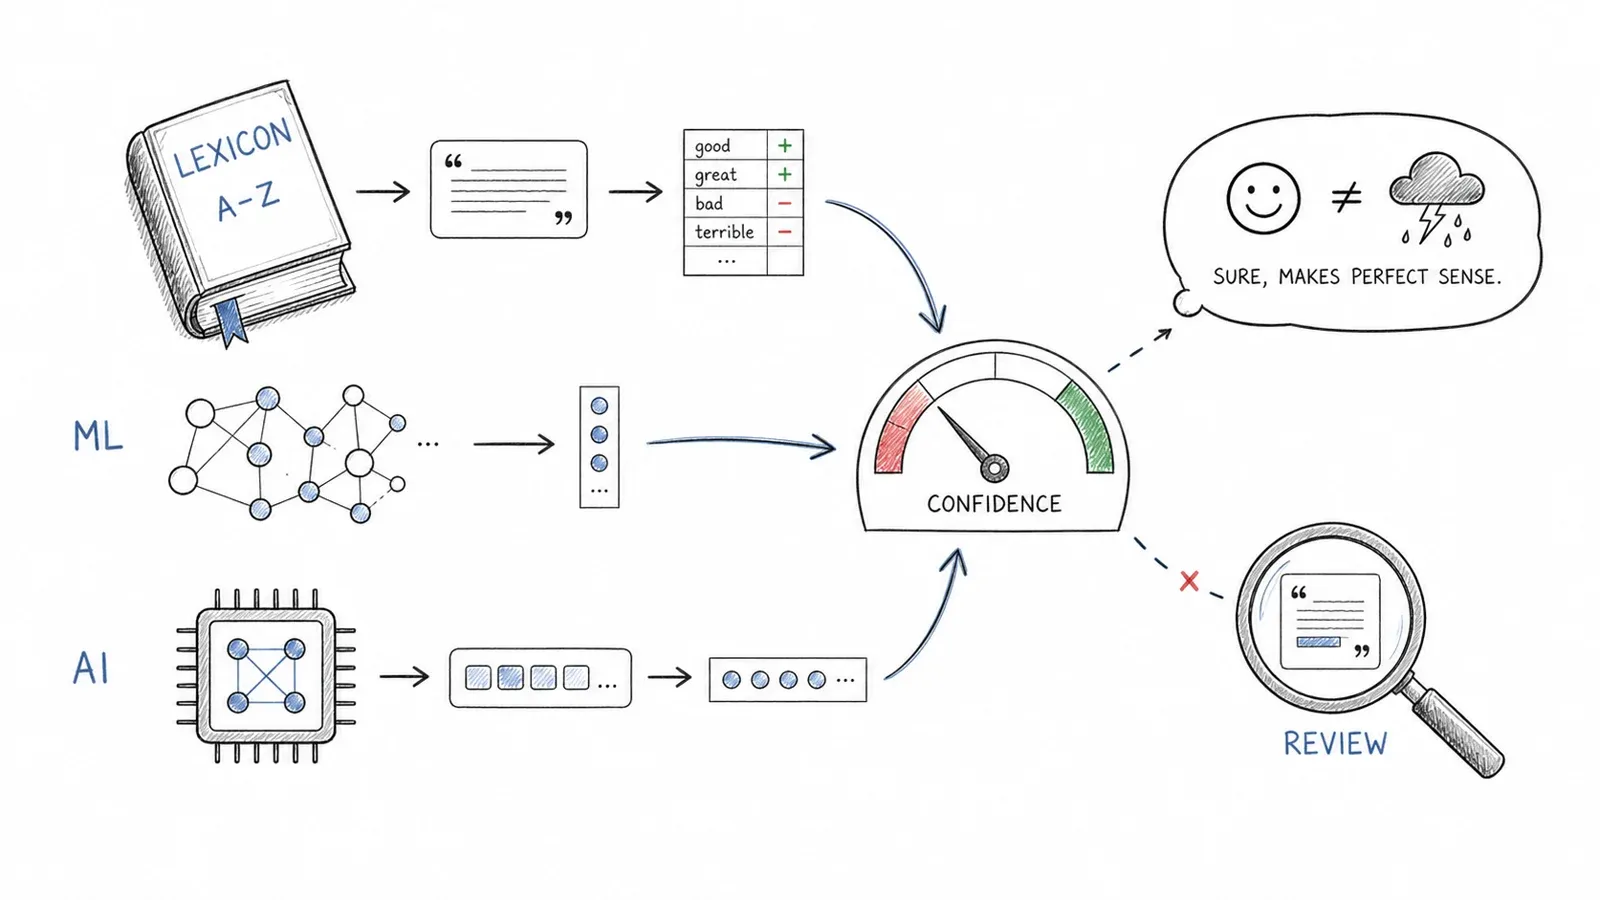
Vilken modell du väljer spelar större roll än de flesta guider medger. Och det största hålet i konkurrerande guider är att nästan ingen tar upp transformerbaserade modeller finjusterade på tweets — där några av de starkaste praktiska baslinjerna numera finns.
Här kommer en jämförelse sida vid sida. Jag låter medvetet bli att lägga in universella F1-siffror i tabellen, eftersom resultaten skiljer sig beroende på dataset, split, etikettdefinition, tidsperiod och mått. I stället beskriver jag den relativa prestationen och pekar på benchmarkar där du kan verifiera själv.
| Modell / bibliotek | Ansats | Klarar sarkasm? | Klarar slang/emoji? | Relativ träffsäkerhet på tweets | Komplexitet i uppsättning |
|---|---|---|---|---|---|
| VADER (NLTK) | Regelbaserad lexikonmetod | Svagt | Visst emoji-stöd | Lägst | Mycket låg |
| TextBlob | Mönsterbaserad | Svagt | Nej | Lägre | Mycket låg |
| Naive Bayes / Logistic Regression (TF-IDF) | Klassisk ML | Nej | Nej | Medel | Medel |
| CardiffNLP RoBERTa | Transformer (finjusterad på tweets) | Bättre (men inte perfekt) | Ja | Högst av dessa | Medel (HuggingFace-pipeline) |
VADER: Snabbt och enkelt, men begränsat
VADER är en regelbaserad lexikonmetod byggd för social text. Den är snabb, lätt att tolka, kräver ingen träningsdata och hanterar viss emoji och emotikoner. Den tar hänsyn till negation, förstärkningsord, skiljetecken och versaler. För en snabb och smutsig baslinje, eller när beräkningskraft och transparens är viktigt, är VADER användbart. Där det faller kort: sarkasm, slang, kontextberoende betydelse och allt som kräver förståelse bortom enskilda ord. Dess standardtrösklar för compound score (≥0,05 = positiv, ≤-0,05 = negativ) är just standardvärden, inte universella affärströsklar — justera dem på din egen valideringsmängd.
TextBlob: Ännu enklare, ännu mer begränsad
TextBlob är en liten pedagogisk baslinje. Dess standardmodell PatternAnalyzer är inte tränad på tweetliknande text. Den är användbar för ditt allra första NLP-experiment, men inte för sentimentanalys i produktion.
Klassisk ML: Naive Bayes, Logistic Regression, SVM
En TF-IDF-pipeline för ord och tecken, tillsammans med logistic regression eller LinearSVC, är fortfarande en värdefull övervakad baslinje. Den är billig, tolkningsbar och visar ofta om en transformer faktiskt tillför tillräckligt mycket för att motivera sin komplexitet. Huvudregeln: anpassa vektoriseringen först efter train/validation-splittet för att undvika läckage av vokabulär och IDF.
Dessa modeller presterar bättre än regelbaserade metoder på stora märkta dataset, men de missar fortfarande sammanhang, sarkasm och slang.
CardiffNLP RoBERTa: 2026 års standard för tweet-sentiment
cardiffnlp/twitter-roberta-base-sentiment-latest är en underhållen, tweet-anpassad modell för tre klasser och en rimligt stark baslinje för 2026. Den förtränades på en stor tweetkorpus och finjusterades för sentiment, så den hanterar emoji, slang och vardagligt språk betydligt bättre än regelbaserade eller klassiska ML-metoder.
Här är ett minimalt HuggingFace-kodexempel för att köra den:
from transformers import pipeline

classifier = pipeline(
    "text-classification",
    model="cardiffnlp/twitter-roberta-base-sentiment-latest",
    top_k=None,
)
scores = classifier("@user Love waiting three hours for support 😒 http")
print(scores)
Några saker att ha i åtanke:
- Utdata är en modells poäng, inte en kalibrerad affärssannolikhet. Kalibrera eller lägg till en abstentionströskel på ett aktuellt märkt stickprov.
- Kontextuella modeller presterar oftast bättre än regelbaserade system på många tweet-uppgifter, men sarkasm, blandade mål, saknat trådsammanhang, dialekt och kodspråk är fortfarande strukturella felkällor. Lovar inte att någon modell "förstår sarkasm" — det är mer korrekt att säga att den hanterar det bättre, inte perfekt.
- Alternativ inkluderar BERTweet, TimeLMs och flerspråkiga Twitter-XLM-R-modeller, beroende på språk och uppgift.
Så, kan Twitter sentimentanalys faktiskt vara korrekt? Ja — när modell, förbehandling, etikettdefinition och utvärderingsurval matchar uppgiften. Ett generiskt VADER-skript kopierat från en guide från 2019 är en baslinje, inte ett bevis på produktionskvalitet.
Ett riktigt preprocessing-flöde för tweets (inte bara text.lower())
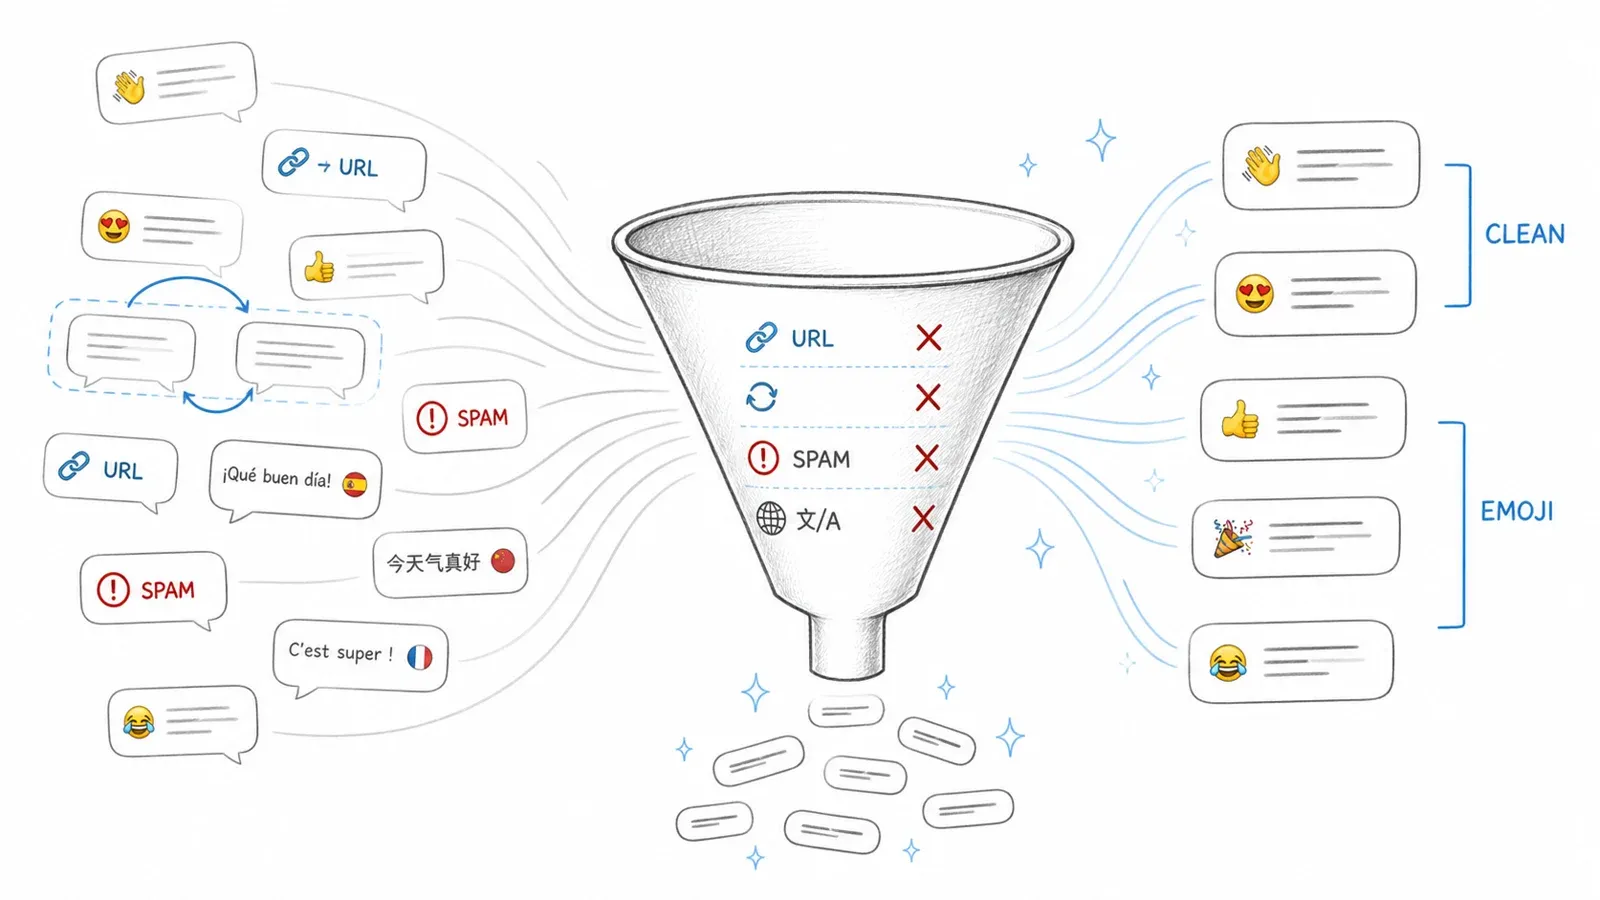
Mata en sentimentmodell med råa URL:er, @omnämnanden och HTML-entiteter så kan även en hygglig modell spotta ur sig skräp. De flesta guider (inklusive de högst rankade) gör bara texten gemen innan de skickar den till modellen. Det saboterar precisionen i tysthet — särskilt för klassisk ML, där kvaliteten på förbehandlingen kan vara lika viktig som modellvalet.
Vad du ska rensa bort (och varför det spelar roll)
| Element | Vad du ska göra | Varför |
|---|---|---|
| URL:er | Ersätt med en platshållare som http | URL:er är brus för sentiment; att ta bort texten runt dem kan förstöra sammanhanget |
| @omnämnanden | Ersätt användarnamn med @user | Behåller struktur men tar bort läckage av personidentitet |
| Emoji/emotikoner | Behåll för moderna tokenizers; testa att omvandla emoji till text för sparsamma modeller | Emoji bär stark sentimentinformation — att radera dem är att kasta bort data |
| Hashtags | Behåll tokenen; lägg eventuellt till en uppdelad kopia (t.ex. #ClimateChangeIsReal → Climate Change Is Real) | Hashtags innehåller ofta själva åsikten |
| Negation | Behåll not, no, never, kontraktioner och kontrastord | Generella stoppordslistor tar ofta bort dessa och vänder sentimentet |
| Versaler/skiljetecken | Behåll för VADER och kompatibla modeller | VADER använder versaler och skiljetecken som features |
| RT-prefix | Ta bort RT-markören | Det är metadata, inte sentiment |
| Reposts/duplicat | Identifiera exakta och nära duplicat före split | Duplicat mellan train och test orsakar läckage |
Före och efter: vad förbehandling faktiskt gör med ett inlägg
Här är ett konkret exempel:
| Steg | Text |
|---|---|
| Rått inlägg | RT @BrandX: Wow, #CustomerServiceFail 😡😡 https://t.co/abc123 I've been waiting 3 hrs ngl this is awful |
| Efter borttagning av URL | RT @BrandX: Wow, #CustomerServiceFail 😡😡 http I've been waiting 3 hrs ngl this is awful |
| Efter normalisering av omnämnande | RT @user: Wow, #CustomerServiceFail 😡😡 http I've been waiting 3 hrs ngl this is awful |
| Efter borttagning av RT | @user: Wow, #CustomerServiceFail 😡😡 http I've been waiting 3 hrs ngl this is awful |
| Efter segmentering av hashtag | @user: Wow, #CustomerServiceFail Customer Service Fail 😡😡 http I've been waiting 3 hrs ngl this is awful |
| Efter emoji-till-text (för sparsamma modeller) | @user: Wow, #CustomerServiceFail Customer Service Fail angry_face angry_face http I've been waiting 3 hrs ngl this is awful |
| Slutligt (för CardiffNLP RoBERTa) | @user Wow, #CustomerServiceFail Customer Service Fail 😡😡 http I've been waiting 3 hrs ngl this is awful |
Lägg märke till att för en transformer som CardiffNLP RoBERTa behåller du emoji, skiljetecken och versaler — modellen tränades på text som ser ut så. För en TF-IDF-modell kan du däremot vilja omvandla emoji till text, göra texten gemen och lemmatisera.
Copy-paste Python-kod för preprocessing
En ren, modulär funktion för preprocessing kompatibel med transformer-modeller:
import html
import re
import unicodedata

URL_RE = re.compile(r"https?://\S+|www\.\S+", re.I)
MENTION_RE = re.compile(r"(?<!\w)@[A-Za-z0-9_]+")

def normalize_social_text(text: str) -> str:
    """Normalisera ett inlägg för transformerbaserade sentimentmodeller."""
    text = html.unescape(text)
    text = unicodedata.normalize("NFC", text)
    text = URL_RE.sub("http", text)
    text = MENTION_RE.sub("@user", text)
    text = re.sub(r"\bRT\b", "", text)
    return " ".join(text.split())
För klassiska ML-pipelines skulle du utöka detta med gemener, emoji-till-text-konvertering (med biblioteket emoji eller demoji), hashtag-segmentering (med wordninja eller ekphrasis), slangnormalisering, borttagning av stoppord och lemmatisering (via spaCy eller NLTK). Principen är enkel: anpassa preprocessing till modellen. BERTweet använder till exempel sin egen dokumenterade normaliseringskonvention — tvinga inte alla modeller genom samma pipeline.
Steg för steg: Twitter sentimentanalys med Python
Det här är hela arbetsflödet, där vi binder ihop allt ovan. Du kan följa detta från början till slut.
Innan du börjar:
- Svårighetsgrad: Medel (viss Python-vana förutsätts)
- Tidsåtgång: Cirka 30–60 minuter för hela pipelinen; cirka 10 minuter för den snabba transformer-vägen
- Det du behöver: Python 3.8+, en gratis Google Colab eller lokal miljö,
pandas,transformers,scikit-learn,matplotlib,seabornoch eventuelltwordcloud
Steg 1: Samla in din tweetdata
Jag använder Sentiment140-datasetet i den här guiden (gratis, 1,6 miljoner tweets, tillgängligt på Kaggle). Det är perfekt för lärande och benchmarkning, även om det är historiskt.
Om du vill ha live-data använder du X API v2:s pay-per-use-nivå. En vanlig inläggsläsning kostar $0,005. För 10 000 inlägg blir det ungefär $50.
Läs in datasetet:
import pandas as pd

columns = ["target", "id", "date", "flag", "user", "text"]
df = pd.read_csv(
    "training.1600000.processed.noemoticon.csv",
    encoding="latin-1",
    names=columns,
)
# Etiketter: Sentiment140 använder 0 = negativ, 4 = positiv
df["label"] = df["target"].map({0: "negative", 4: "positive"})
print(df[["text", "label"]].head())
Du bör se en DataFrame med rå tweettext och en etikettkolumn.
Steg 2: Rensa och förbehandla dina tweets
Tillämpa förbehandlingsfunktionen från tidigare avsnitt:
df["clean_text"] = df["text"].apply(normalize_social_text)
print(df[["text", "clean_text"]].head())
Kontrollera några rader för att bekräfta att URL:er ersätts, omnämnanden normaliseras och RT-prefix tas bort.
Steg 3: Välj modell och klassificera sentiment
Väg A: Klassisk ML med TF-IDF + Logistic Regression
Det här är vägen för dig som vill förstå grunderna. Dela upp data, anpassa vektoriseringen endast på träningsmängden och träna en logistic regression-klassificerare:
from sklearn.model_selection import train_test_split
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report

X_train, X_test, y_train, y_test = train_test_split(
    df["clean_text"], df["label"], test_size=0.2, random_state=42
)
vectorizer = TfidfVectorizer(max_features=50000, ngram_range=(1, 2))
X_train_tfidf = vectorizer.fit_transform(X_train)
X_test_tfidf = vectorizer.transform(X_test)

clf = LogisticRegression(max_iter=1000)
clf.fit(X_train_tfidf, y_train)
y_pred = clf.predict(X_test_tfidf)
print(classification_report(y_test, y_pred))
Du bör se en klassificeringsrapport med precision, recall och F1 för varje klass. På Sentiment140 presterar logistic regression med TF-IDF vanligtvis helt okej — men kom ihåg att datasetet är från 2009 och använder distant supervision (emotikoner som etiketter), så behandla inte dessa siffror som ditt produktionsbenchmark.
Väg B: CardiffNLP RoBERTa via HuggingFace
För bästa noggrannhet på tweettext använder du den förtränade transformern:
from transformers import pipeline

classifier = pipeline(
    "text-classification",
    model="cardiffnlp/twitter-roberta-base-sentiment-latest",
    top_k=None,
)

sample_tweets = [
    "@user Love waiting three hours for support 😒 http",
    "@user This new update is absolutely fantastic, best one yet!",
    "@user The event was okay, nothing special.",
]
for tweet in sample_tweets:
    result = classifier(tweet)
    print(f"Tweet: {tweet}\nScores: {result}\n")
Du ser en lista med etikettpoäng (negativ, neutral, positiv) för varje tweet. Det sarkastiska inlägget ("Love waiting three hours...") bör få högre negativ poäng än vad en regelbaserad modell skulle förutsäga — även om ingen modell är perfekt här.
Steg 4: Utvärdera resultaten
Skapa nu en heatmap för confusion matrix för den klassiska ML-vägen:
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.metrics import confusion_matrix

cm = confusion_matrix(y_test, y_pred, labels=["negative", "positive"])
sns.heatmap(cm, annot=True, fmt="d", xticklabels=["negative", "positive"],
            yticklabels=["negative", "positive"], cmap="Blues")
plt.xlabel("Förutsagd")
plt.ylabel("Faktisk")
plt.title("Confusion Matrix: Logistic Regression på Sentiment140")
plt.show()
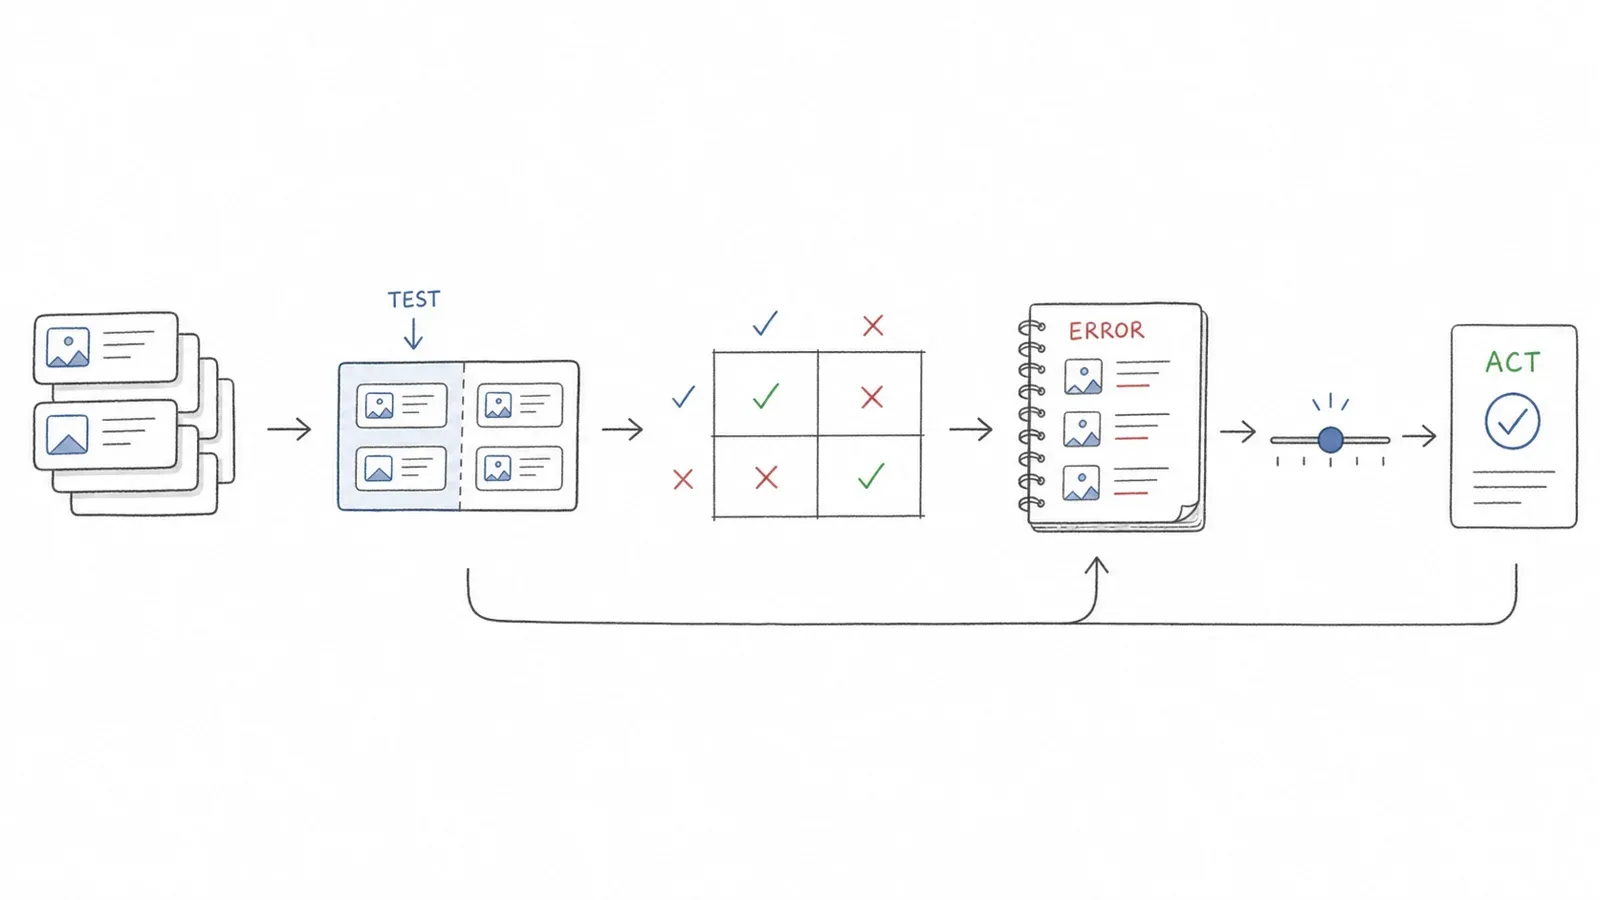
För transformer-vägen märker du upp ett litet aktuellt stickprov manuellt (50–100 tweets), kör modellen och jämför. Rapportera macro F1, precision och recall per klass samt confusion matrix. Om du gör detta för ett riktigt projekt, kontrollera också kalibrering och sätt en abstentionströskel för tvetydiga fall.
Steg 5: Testa edge cases
Prova några tweets som testar sarkasm, emoji och slang:
edge_cases = [
    "Oh great, another update that breaks everything 🙄",
    "ngl this product slaps 🔥🔥🔥",
    "The camera is amazing but the battery life is trash",
    "Just got my order. It's... fine. I guess.",
]
for tweet in edge_cases:
    clean = normalize_social_text(tweet)
    result = classifier(clean)
    print(f"Tweet: {tweet}\nScores: {result}\n")
Se var modellen träffar rätt och var den kämpar. Inlägg med blandade mål ("camera is amazing but battery is trash") är en känd utmaning — aspektbaserad sentimentanalys är en separat uppgift.
Twitter sentimentanalys utan att skriva kod
Alla vill inte skriva Python, och det är helt okej. Om du är marknadsförare, varumärkesansvarig eller operativ ledare som behöver sentimentinsikter utan att röra kod, finns det en väg för dig.
En ärlig brasklapp: no-code-verktyg byter anpassning mot snabbhet. De är perfekta för snabb varumärkesövervakning, men inte för forskningskvalitet eller egen modellträning.
No-code-alternativ i överblick
| Verktyg | Bäst för | Inbyggt sentiment? | Prisnivå |
|---|---|---|---|
| AWS Comprehend | Textanalys i enterprise-skala | Ja | Pay-per-use |
| Brandwatch / Sprinklr | Komplett suite för social listening | Ja | Enterprise-prissättning |
| Google Sheets + NLP-tillägg | Snabb och lätt analys | Via tillägg | Gratis–lågt |
| Thunderbit + kalkylark | Strukturera och märka data från kompatibla sidor | AI Field Prompt för utforskande etiketter | Gratisnivå finns |
No-code-flöde: Samla data, klassificera i ett kalkylark
Ett praktiskt arbetsflöde för den som redan har tweetdata (insamlad via det officiella X API:t, en auktoriserad leverantör eller det egna arkivet):
- Exportera din tweetdata till ett kalkylark. Om du använde X API kan du exportera JSON till CSV eller använda ett verktyg som Thunderbit för att strukturera och exportera data från kompatibla sidor där du har tillstånd att automatisera.
- Öppna i Google Sheets. Klistra in eller importera tweettexten i en kolumn.
- Tillämpa en sentimentklassificerare. Använd ett Google Sheets NLP-tillägg (kontrollera tilläggsbutiken för aktuella alternativ) eller en tjänst som AWS Comprehend. Vissa tillägg låter dig klassificera sentiment direkt i en cellformel.
- Granska och visualisera. Använd Google Sheets inbyggda diagram för att skapa ett stapeldiagram över sentimentfördelning eller ett linjediagram över sentiment över tid.
Thunderbits AI Field Prompt kan också lägga till en promptbaserad sentimentetikett vid extraktion på kompatibla sidor — användbart för utforskande övervakning. Men för reviderade eller högriskbeslut bör du validera ett stickprov och använda en dokumenterad modell.
När ska du välja no-code kontra Python?
| Scenario | Rekommenderad väg |
|---|---|
| Snabb varumärkeskoll, liten volym | No-code (kalkylark + tillägg) |
| Teamdashboard, veckorapportering | No-code eller low-code |
| Storskalig analys, egna modeller | Python |
| Akademisk forskning, reproducerbarhet | Python |
| Realtidsövervakning i stor skala | Python + API + schemalagd pipeline |
Visualisera dina Twitter sentimentresultat
De flesta guider stannar vid en klassificeringsrapport. Men om du vill kommunicera insikter till ett team eller fatta ett beslut behöver du visualiseringar.
Stapeldiagram över sentimentfördelning
Det mest grundläggande men universellt användbara resultatet:
import matplotlib.pyplot as plt
import seaborn as sns

sentiment_counts = df["label"].value_counts()
sns.barplot(x=sentiment_counts.index, y=sentiment_counts.values, palette="coolwarm")
plt.xlabel("Sentiment")
plt.ylabel("Antal tweets")
plt.title("Sentimentfördelning")
plt.show()
Word cloud per sentimentklass
Separata word clouds för positiva och negativa tweets visar vad folk faktiskt säger:
from wordcloud import WordCloud

for sentiment in ["positive", "negative"]:
    text = " ".join(df[df["label"] == sentiment]["clean_text"])
    wc = WordCloud(width=800, height=400, background_color="white").generate(text)
    plt.figure(figsize=(10, 5))
    plt.imshow(wc, interpolation="bilinear")
    plt.axis("off")
    plt.title(f"Word Cloud: {sentiment.capitalize()} Tweets")
    plt.show()
Sentiment över tid: diagrammet ingen annan visar dig
Det här är visualiseringen som förvandlar rådata till en berättelse. Om du har tidsstämplar kan du följa hur sentimentet förändras under ett event, en lansering eller en kris:
df["date"] = pd.to_datetime(df["date"])
df["day"] = df["date"].dt.date
sentiment_map = {"positive": 1, "neutral": 0, "negative": -1}
df["score"] = df["label"].map(sentiment_map)
daily = df.groupby("day")["score"].mean()

plt.figure(figsize=(12, 5))
daily.plot()
plt.xlabel("Datum")
plt.ylabel("Genomsnittligt sentimentscore")
plt.title("Sentiment över tid")
plt.axhline(0, color="gray", linestyle="--")
plt.show()
En plötslig dipp på lanseringsdagen? Det är din signal att gräva i de negativa inläggen och ta reda på vad som gick fel.
Confusion matrix heatmap
Redan visad i utvärderingssteget ovan. Poängen: titta på var modellen blandar ihop positivt med negativt (eller tvärtom). Det är de inlägg som är värda att läsa manuellt.
För icke-kodare: diagram i Google Sheets eller Notion
Om du har exporterat din sentimentmärkta data till ett kalkylark kan du skapa diagram över sentimentfördelning och trender direkt i Google Sheets, Notion eller vilket BI-verktyg som helst. Ingen Python behövs.
Vanliga fallgropar i Twitter sentimentanalys (och hur du undviker dem)
I verkliga sentimentflöden dyker samma misstag upp om och om igen.
Sarkasm och ironi
Den största precisionstjuven. "Love waiting three hours for support 😒" ser positivt ut för en regelbaserad modell. Transformer-modeller gör det bättre, men sarkasm är fortfarande strukturellt svårt — särskilt när inlägget saknar sammanhang (tråden, författarens historik, händelsen). För högriskanvändning, kombinera modellens output med mänskliga stickprovskontroller.
Blinda fläckar för emoji och slang
Om din förbehandling tar bort emoji i stället för att omvandla dem till text (för sparsamma modeller) eller behålla dem (för transformers), kastar du bort några av de starkaste sentiment-signalerna i datan. Detsamma gäller slang — "ngl this slaps" är positivt, men en modell tränad på formell engelska förstår inte det.
Föråldrade API-guider och trasiga scrapers
Om en guide använder Tweepy med API v1.1 är den föråldrad. Om den rekommenderar snscrape har det inte fungerat för X-sökning sedan 2023. Kontrollera alltid datum och API-version i varje guide du följer.
Överanpassning till ett enda dataset
Sentiment140 är bra för träning, men det är från 2009. En EMNLP-granskning 2024 av 20 dataset för sociala medier fann att borttagning av duplicat sänkte F1 i 14 av 19 testade dataset och ändrade modellrankningar i 17 av 19. Använd tidsbaserade split, event-separerade split och helst också författarseparerade split. Testa modellen på aktuella tweets för att se om den generaliserar.
Att behandla sentimentscore som facit
En modells poäng är inte en kalibrerad sannolikhet. Utlös inte automatiska svar eller publika beslut enbart baserat på ett sentimentscore. Kräv alltid mänsklig granskning för beslut som påverkar individer eller krishantering.
Integritet, plattformspolicy och ansvarsfull användning
Det här avsnittet är inte valfritt.
X:s Developer Policy betonar integritet, användarkontroll, borttagning av innehåll och begränsningar för matchning utanför X. Praktiska regler:
- Samla bara in nödvändiga fält.
- Aggregera resultat i stället för att publicera råa användarnamn.
- Spara inläggs-ID och hämtningstidsstämplar för efterlevnad.
- Ta bort eller uppdatera lagrat innehåll efter borttagning, skyddsförändringar eller berättigade begäranden.
- Dra inte slutsatser om känsliga egenskaper hos individer.
- Koppla inte sentimentscore till CRM-identiteter utan tillåten grund och samtycke.
- Träna eller finjustera inte en grundmodell på X-innehåll där det är förbjudet enligt restricted-use-regler.
- Dokumentera urvalsstorlek, söktermer, tidsfönster, språkfilter och exkluderingar.
- Automatisera aldrig ett offentligt svar enbart utifrån ett sentimentscore.
Sentimentanalys är ett kraftfullt verktyg, men det kommer med verkligt ansvar. Behandla det därefter.
Slutsats och viktigaste lärdomar
Twitter sentimentanalys fungerar 2026 — men bara om du uppdaterar ditt arbetssätt så att det matchar verkligheten. Det gamla receptet (fri API-tillgång, endast gemener i förbehandlingen, VADER eller Naive Bayes, ingen utvärdering) är trasigt. Det som faktiskt fungerar:
- Få din data via en tillåten väg. Använd X API v2 (pay-per-use), en auktoriserad leverantör eller ett transparent dataset. Lita inte på trasiga scrapers eller webbläsargenvägar.
- Förbehandla för modellen, inte bara för syns skull. Behåll emoji, negation och versaler för transformers. Normalisera URL:er och omnämnanden. Matcha din pipeline mot modellens träningsdata.
- Jämför en billig baslinje med en tweet-specifik transformer. TF-IDF + logistic regression är fortfarande en bra rimlighetskontroll. CardiffNLP RoBERTa är dagens starka standardval för tweet-sentiment.
- Utvärdera ärligt. Rapportera macro F1, mått per klass och en confusion matrix. Använd ett aktuellt, manuellt märkt stickprov. Sätt en abstentionströskel för tvetydiga fall.
- Visualisera för beslut, inte bara för att det ska se bra ut. Diagram över sentiment över tid och word clouds berättar en historia som en klassificeringsrapport inte kan.
- Behåll människor i loopen. Ingen modell är perfekt på sarkasm, blandade mål eller kontextberoende betydelse. För högriskanvändning, kombinera modelloutput med mänsklig granskning.
Om du precis har börjat: hämta ett gratis dataset, öppna Google Colab och kör HuggingFace-pipelinen. Du får fungerande sentimentscore på under tio minuter. Om du vill samla in och strukturera webdata utan kod för andra delar av arbetsflödet kan Thunderbit hjälpa dig på kompatibla sidor där du har tillstånd att automatisera.
Och om du bygger detta för en portfolio eller en jobbintervju: att lägga till en jämförelse med transformer, ett riktigt preprocessing-flöde och ett sentiment-över-tid-diagram gör direkt att ditt projekt sticker ut från bootcamp-standard.
Läs mer
- Så bemästrar du automatiserad datainsamling med Thunderbit
- 6 bästa Twitter-(x.com)-scrapers 2026
- Så scrapar du tweets från Twitter med Python 2025
- Så använder du Twitter AI-scraping för bättre datainsikter
- Twitter (X) statistik 2026: användare, demografi och annonser
Vanliga frågor
Är Twitter sentimentanalys korrekt?
Det beror på modellen och hur du utvärderar. Regelbaserade verktyg som VADER presterar i den lägre änden på tweetdata. Transformer-modeller som CardiffNLP RoBERTa presterar betydligt bättre — men de exakta siffrorna varierar beroende på dataset, split, etikettdefinition och mått. Kvaliteten på förbehandlingen spelar också roll. Utvärdera alltid på ett aktuellt, manuellt märkt stickprov i stället för att lita på ett enda benchmarktal.
Kan jag göra Twitter sentimentanalys gratis?
Ja. Använd ett gratis dataset (Sentiment140 på Kaggle), en gratis Python-miljö (Google Colab) och en förtränad HuggingFace-modell. För live-data tar X API ut $0,005 per inläggsläsning, så insamling i liten skala är överkomlig. Thunderbit erbjuder en gratisnivå för att strukturera data på kompatibla sidor.
Vilket är det bästa Python-biblioteket för Twitter sentimentanalys?
För snabb prototypning: VADER via NLTK. För bäst noggrannhet på tweets: HuggingFace-biblioteket transformers med CardiffNLP:s RoBERTa-modell. För klassiska ML-baslinjer: scikit-learn med TF-IDF. Rätt val beror på volym, krav på precision och din beräkningsbudget.
Hur hanterar jag sarkasm i Twitter sentimentanalys?
Transformer-modeller hanterar sarkasm bättre än regelbaserade eller klassiska ML-modeller eftersom de bearbetar sammanhang, inte bara enskilda ord. Men ingen modell är perfekt på sarkasm — forskning visar att även mänskliga annotatörer ofta är oense om sarkastisk avsikt. För kritiska användningsfall bör du kombinera modelloutput med mänsklig granskning och överväga att använda sarkasmspecifika dataset för utvärdering.
Kan jag analysera Twitter sentiment utan att koda?
Ja. Samla in din data via en tillåten väg (X API, auktoriserad leverantör eller ditt eget arkiv), exportera till Google Sheets och använd en no-code-sentimentklassificerare via ett NLP-tillägg för Sheets eller en tjänst som AWS Comprehend. Thunderbit kan också lägga till promptbaserade sentimentetiketter under datastrukturering på kompatibla sidor. För mer om no-code-dataflöden, se vår guide om AI-verktyg för Google Sheets.



