
Det finns något särskilt tillfredsställande i att se en web scraping-crawler susa genom sidor och samla in data som annars hade tagit timmar, eller dagar, att få ihop för hand. Men om du någon gång har sett en scraping plötsligt misslyckas — kanske blev du utloggad, eller så blockerades åtkomsten utan förvarning — har du sannolikt stött på den moderna webben osynliga grindvakter: cookies. Under mina år med att bygga automationsverktyg och arbeta med sälj-, e-handels- och researchteam har jag sett cookies avgöra om ett dataprojekt lyckas eller faller platt. De är webbscrapings osjungna hjältar, och ibland skurkar, och rätt hantering är skillnaden mellan en smidig resa och ett skeppsbrott.
Låt oss gå igenom varför cookies spelar så stor roll för web scraping, huvudvärken med att hantera dem på gammaldags vis, och hur AI-drivna verktyg som Thunderbit förändrar spelplanen för företagsanvändare. Jag delar också praktiska bästa praxis för att hålla dina cookies — och din data — säker, trygg och kompatibel.
Varför hantering av webbscraping-cookies är viktig för företagsanvändare
Vad är data scraping och hur gör man det 2025 Get Started Free
Cookies handlar inte bara om att spåra vad du lägger i din kundvagn på nätet. I web scraping-världen är de limmet som håller din session ihop. Oavsett om du skrapar för leadgenerering, prisbevakning eller marknadsresearch är det cookies som låter din scraper:
- Förbli inloggad på medlemssidor eller dashboards
- Komma åt personanpassad data (tänk: din anpassade vy i ett CRM- eller lagersystem)
- Behålla en session mellan flera förfrågningar, så att du inte kastas ut efter första sidan
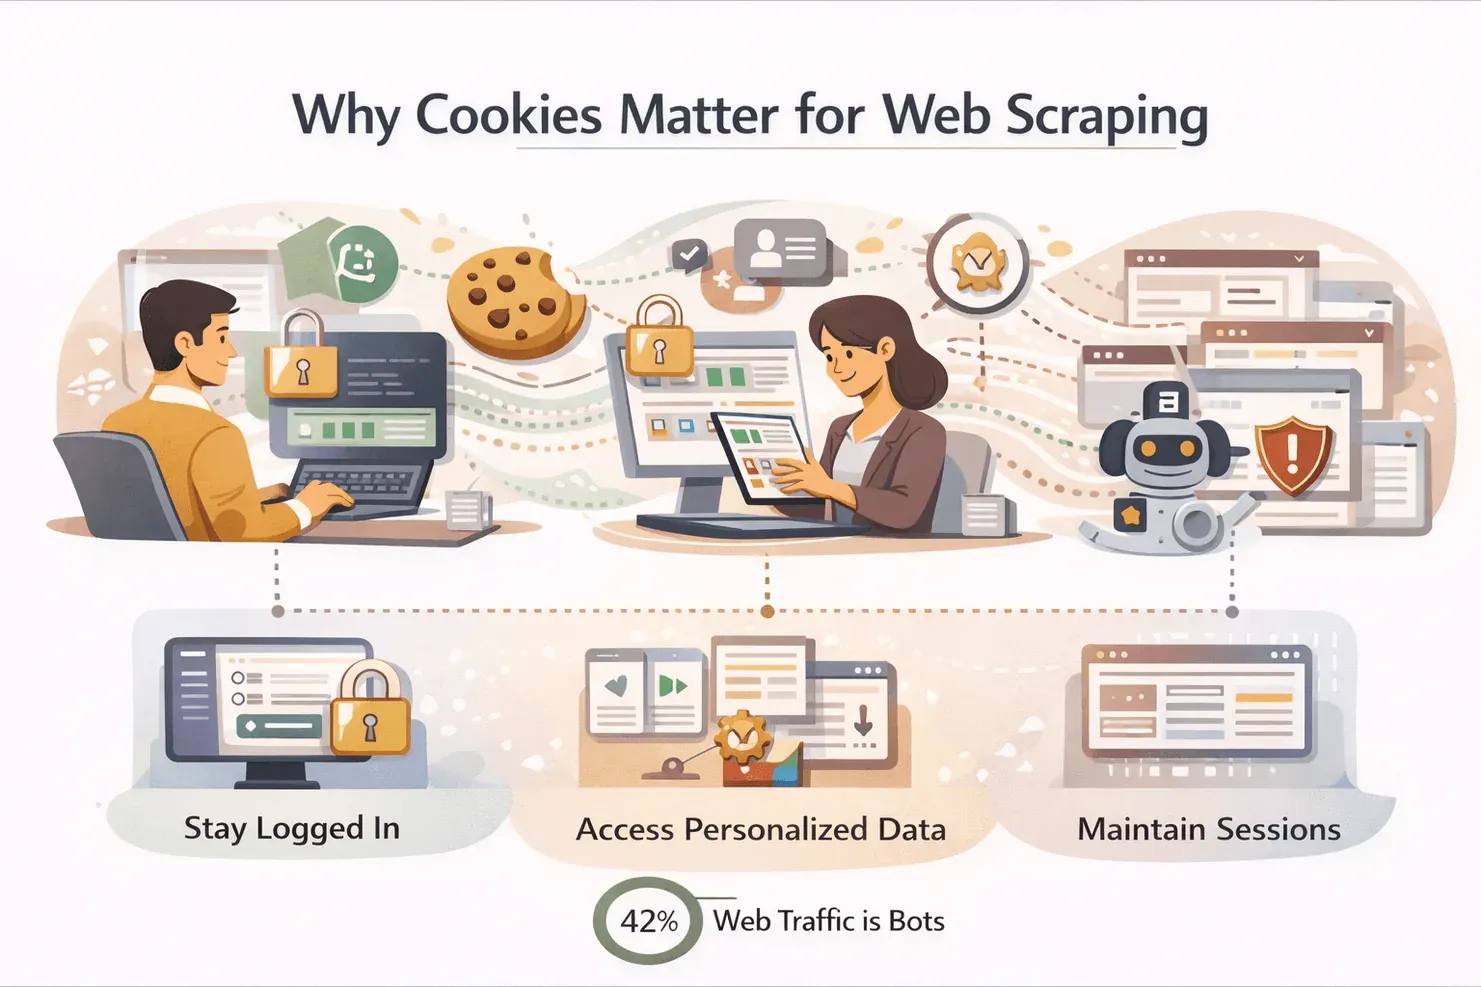
Enligt branschrapporter är session cookies avgörande för att autentisera inloggningar och bevara användarspecifika vyer. Med bots som står för 42 % av all webbtrafik enligt Akamai — och AI-drivna botaktiviteter som ökar med ungefär 300 % fram till 2025 — lutar webbplatser allt mer mot cookiekontroller och sessionsfingeravtryck för att skilja människor från automatisering.
Vad händer om du hanterar cookies fel? Du riskerar:
- Att bli utloggad mitt i en scraping (hej då, data)
- Att få ofullständig eller generell data i stället för den personanpassade information du behöver
- Att trigga säkerhetsblockeringar eller till och med kontoban — särskilt på webbplatser med strikta anti-bot-regler
Jag har sett team förlora dagar av arbete för att en session cookie gick ut eller inte uppdaterades, vilket gjorde att deras scraper bara samlade in inloggningssidor. Kort sagt är robust cookiehantering ryggraden i stabil och pålitlig web scraping.
De dolda utmaningarna med traditionell hantering av webbscraping-cookies
Låt oss vara ärliga: att hantera cookies för hand är ungefär lika roligt som att montera IKEA-möbler utan instruktioner. Med traditionella scrapingverktyg måste du ofta:
- Logga in manuellt via webbläsaren
- Exportera cookies (med webbläsarens DevTools eller ett plugin)
- Lägga in dessa cookies i din scraper-kod
- Upprepa processen varje gång cookies går ut eller webbplatsen ändrar sitt inloggningsflöde
Om du arbetar med inloggningar i flera steg (tänk: 2FA, omdirigeringar eller CAPTCHAs) blir allt ännu rörigare. Och om du kör scrapers över flera trådar eller proxies måste du synkronisera cookies mellan dem — annars bryter du sessioner eller väcker misstankar hos webbplatsens säkerhetssystem (källa).
Smärtpunkterna:
- Hög uppsättningstid: Att skripta inloggningar och cookiefångst är tidskrävande
- Frekvent underhåll: Cookies går ut, webbplatser ändras, skript går sönder
- Felbenäget: Missar du en cookieuppdatering kan hela din scraping fallera
Även avancerade verktyg som Selenium eller Puppeteer kräver specialkod för att behålla cookies. Och om du glömmer att uppdatera din session kan du bli blockerad eller börja skrapa fel data (källa). Det är inte konstigt att så många företagsanvändare ger upp innan de ens kommit igång.
Thunderbit: automatiserar webbscraping-cookies för tillförlitlig datautvinning
Ladda ner Thunderbits Chrome-tillägg Get Started Free
Det är här Thunderbit kommer in. Som någon som har tillbringat år i SaaS och automation ville jag bygga ett verktyg som gjorde cookiehuvudvärk till ett minne blott. Så här hanterar Thunderbit cookies åt dig:
- Browser Scraping-läge: Thunderbit körs som ett Chrome-tillägg och använder därför din faktiska webbläsarsession och dina cookies. Om du kan se det i Chrome kan Thunderbit skrapa det — ingen manuell cookieexport behövs (källa).
- Automatisk cookiefångst: Logga bara in som vanligt, klicka på “AI Suggest Fields” eller “Scrape”, och Thunderbit ärver dina sessionscookies i bakgrunden.
- Hanterar inloggningar i flera steg: Om en webbplats använder 2FA, omdirigeringar eller andra komplexa flöden, slutför bara stegen i webbläsaren. Thunderbit plockar upp den slutliga sessionen automatiskt.
- Molnscraping för offentlig data: För öppna webbplatser är Thunderbits molnläge blixtsnabbt (upp till 50 sidor åt gången), men för allt bakom en inloggning är webbläsarläget din bästa vän.
Det praktiska resultatet: färre scrapingjobb som blir utloggade, färre trasiga sessioner efter att en webbplats uppdaterat sitt autentiseringsflöde, och betydligt mindre tid åt att exportera cookies manuellt från DevTools. Det är inte magi — sajter med aggressivt bot-skydd slår fortfarande tillbaka — men friktionen minskar tydligt när du slutar pilla med cookies för hand.
Testa Thunderbit för enkel cookiehantering
Öka cookieprecision och effektivitet med AI
Traditionella scrapers är sköra — en ändring i en webbplats cookie-schema eller inloggningsflöde, och ditt skript är körd. AI-drivna verktyg som Thunderbit tar detta till nästa nivå:
- Automatisk cookieigenkänning: Thunderbits AI “ser” och förstår sidan och identifierar automatiskt vilka cookies som behövs för varje förfrågan.
- Automatisk sessionsuppdatering: Om en session cookie går ut kan AI:n be dig autentisera på nytt och uppdatera cookie-lagret direkt.
- Anpassar sig till webbplatsändringar: När en webbplats justerar sin inloggnings- eller cookielogik anpassar sig Thunderbits AI — ingen anledning att skriva om skript eller leta efter nya cookienamn.
- Minskar mänskliga misstag: Inga fler glömda cookieuppdateringar eller att råka skrapa som utloggad användare.
Det betyder högre upptid, färre avbrott och mer korrekt data — särskilt för företagsanvändare som behöver tillförlitlig och aktuell information (källa).
Bästa praxis för säker och kompatibel hantering av webbscraping-cookies
Cookies kan innehålla känslig sessionsdata, så säker hantering är inte bara smart — det krävs ofta enligt lag. Så här håller du dig säker och följer reglerna:
- Kryptera cookie-lagring: Spara aldrig cookies i klartext eller i oskyddade filer. Använd krypterade databaser eller säkra cookie-jars (källa).
- Använd alltid HTTPS: Cookies med attributet
Secureska bara skickas över krypterade anslutningar (källa). - Sätt HttpOnly-flaggor: Det hindrar cookies från att nås av skadlig JavaScript och minskar risken för XSS (källa).
- Begränsa cookie-retention: Behåll bara cookies så länge de behövs för autentisering. Radera gamla eller oanvända cookies regelbundet.
- Följ GDPR och CCPA: Enligt GDPR räknas cookies som kan identifiera användare som personuppgifter. Ha alltid en laglig grund för att använda cookies och respektera användares opt-out eller begäran om radering av data.
- Respektera webbplatsens regler: Kontrollera alltid sajtens användarvillkor och robots.txt innan du skrapar. Vissa webbplatser kräver uttryckligt samtycke för cookieanvändning.
Genom att följa dessa bästa praxis minskar du juridiska risker och håller din data — och dina användare — säkra.
Jämförelse av cookiehantering: manuellt, automatiserat och AI-drivet
Låt oss bryta ned för- och nackdelarna med olika strategier för cookiehantering:
| Ansats | Uppstart | Tillförlitlighet | Säkerhet | Efterlevnad & underhåll |
|---|---|---|---|---|
| Manuell (Python, cURL) | Hög (specialskript, manuell cookiefångst) | Varierar (går sönder vid webbplatsändringar) | Utvecklaren måste implementera kryptering/flaggar | Benägen för fel, kräver frekventa uppdateringar |
| Automatiserade verktyg | Medel (konfigurera verktyg, hantera inloggningsuppgifter) | Bra för stabila webbplatser | Inkluderar ofta standardiserad säkerhet | Kräver fortfarande övervakning, vissa manuella steg |
| AI-driven (Thunderbit) | Låg (kodfritt, webbläsarbaserat) | Hög (anpassar sig till webbplatsändringar, uppdaterar automatiskt) | Krypterad lagring, säkra sessioner | Inbyggd efterlevnad, minimalt underhåll |
AI-drivna verktyg som Thunderbit kräver minst arbete och levererar de mest robusta, framtidssäkra resultaten (källa).
Vanliga fallgropar att undvika när du hanterar webbscraping-cookies
Även med bra verktyg är det lätt att göra misstag. Se upp för dessa vanliga fallgropar:
- Utgångna eller saknade cookies: Uppdatera alltid sessionscookies före en större scraping. Om din scraper börjar returnera inloggningssidor har dina cookies sannolikt gått ut (källa).
- Osäker lagring: Spara aldrig cookies i klartext och dela dem inte via e-post eller chatt. Använd krypterad lagring.
- Ignorera cookie-attribut: Se till att din scraper respekterar flaggorna
SecureochHttpOnly. - Nonchalera webbplatsregler: Om du inte hanterar cookie-banners eller samtyckes-popups kan din scraper blockeras.
- Samtidighetsproblem: Om du skrapar parallellt måste alla trådar dela rätt cookie-lager.
- Hårdkodade antaganden: Lås inte din scraper till specifika cookienamn eller värden — webbplatser ändrar sådant hela tiden.
Felsökningstips: Om din scraper slutar fungera, kontrollera cookievärden, jämför förfrågningar från webbläsare och skript, och prova webbläsarautomation för knepiga webbplatser.
Steg-för-steg-guide: Så sätter du upp säker och effektiv cookiehantering i Thunderbit
Redo att börja använda dessa bästa praxis? Så här hanterar du cookies säkert med Thunderbit:
- Välj rätt läge: För inloggningsskyddade eller personanpassade sidor, använd läget Browser Scraping. För offentlig data, använd Cloud Scraping för bättre hastighet.
- Logga in som vanligt: Öppna Chrome och logga in på målsidan precis som du brukar. Slutför eventuell 2FA eller samtyckessteg.
- Aktivera automatisk cookiefångst: Klicka på Thunderbit-tillägget och tryck sedan på “AI Suggest Fields” eller “Scrape.” Thunderbit använder automatiskt dina sessionscookies — ingen manuell export behövs (källa).
- Verifiera din session: Kontrollera förhandsvisningen i Thunderbits sidopanel så att du ser rätt innehåll (inloggat läge).
- Kör en test-scraping: Börja med en liten batch för att bekräfta att du får förväntad data.
- Övervaka och autentisera igen: För schemalagda eller långkörande jobb, håll koll på när sessionen går ut. Om du blir utloggad är det bara att logga in igen — Thunderbit uppdaterar cookies automatiskt.
- Exportera säkert: När du exporterar data håller Thunderbit dina cookies säkra och exponerar dem aldrig i dina utdatafiler.
Det var allt — ingen kod, ingen manuell cookiekrångel, bara pålitlig och säker scraping.
Starta säker web scraping med Thunderbit
Viktiga lärdomar för företagsteam som använder webbscraping-cookies
- Cookies är avgörande för stabil, autentiserad och personanpassad web scraping. Felhantering kan leda till dataförlust, blockerade konton eller juridiska problem.
- Manuell cookiehantering är felbenägen och tidskrävande. AI-drivna verktyg som Thunderbit automatiserar processen, minskar uppstartstiden och ökar tillförlitligheten.
- Säker lagring och efterlevnad spelar roll. Kryptera alltid cookies, använd HTTPS och följ GDPR/CCPA-reglerna.
- AI-driven cookiehantering anpassar sig till webbplatsändringar, minskar mänskliga fel och håller ditt dataflöde igång.
- Undvik vanliga misstag: Uppdatera cookies regelbundet, lagra dem inte osäkert och respektera webbplatsregler.
Inför de här rutinerna — krypterad lagring, respektera Secure/HttpOnly, uppdatera sessioner enligt ett känt schema — så slutar de flesta vardagliga cookieproblem att uppstå. Om det fortfarande känns som fel plats att lägga veckan på att hantera cookies manuellt, sköter Thunderbits Chrome-tillägg insamlingen och uppdateringen direkt i din egen webbläsarsession. Fler fördjupningar om cookies och blockering finns på Thunderbit Blog.
Testa AI-driven cookiehantering med Thunderbit Get Started Free
Vanliga frågor
1. Varför är cookies så viktiga för web scraping?
Cookies håller din scraper inloggad, bevarar sessionsstatus och ger åtkomst till personanpassat eller skyddat innehåll. Utan korrekt cookiehantering kan din scraper bli utloggad, blockerad eller samla in ofullständig data (källa).
2. Vilka risker finns med att hantera cookies fel under scraping?
Felhantering av cookies kan leda till dataförlust, avbrutna scrapingjobb, kontoban eller till och med juridiska problem om cookies lagras osäkert eller används i strid med integritetslagar (källa).
3. Hur automatiserar Thunderbit cookiehantering?
Thunderbit använder din aktiva Chrome-session för att ärva cookies automatiskt — ingen manuell export eller kod krävs. Det hanterar autentisering, sessionsuppdatering och anpassar sig till webbplatsändringar med hjälp av AI (källa).
4. Vilka är bästa praxis för att lagra cookies säkert?
Kryptera alltid cookie-lagring, använd HTTPS för datatransport, sätt flaggorna HttpOnly och Secure, och lagra aldrig cookies i klartext eller dela dem på osäkra sätt (källa).
5. Hur kan jag se till att min cookiehantering följer GDPR och CCPA?
Behandla cookies som personuppgifter: samla bara in det som behövs, inhämta användarsamtycke där det krävs och respektera opt-out eller begäran om radering. Granska regelbundet dina cookiepolicys så att de ligger i linje med föränderliga regelverk (källa).
6. Hur förändrar AI-baserade webbläsaragenter bilden för cookiehantering? Den nyare generationen av verktyg — Thunderbits Chrome-tillägg, plus open source-agenter som Browser Use som kör ovanpå Playwright — hoppar över det manuella steget med cookieexport helt genom att arbeta från en live, inloggad webbläsarprofil. Cookies, localStorage och sessionsstatus följer med automatiskt; om sessionen går ut autentiserar du på nytt i webbläsaren och scrapen fortsätter. Nackdelen är att du tappar en del av den finmaskiga kontroll du får av att skriva cookie-huvuden för hand i Python. För företagsanvändare som kör inloggningsskyddade scrapingjobb är den kompromissen oftast värd det.
Redo att ta din web scraping till nästa nivå? Testa Thunderbit gratis och låt AI hantera cookies — så kan du fokusera på den data som verkligen spelar roll.
Läs mer




