
Webben växer i en takt som får min morgonkaffe att kännas långsam — och tro mig, jag dricker den snabbt. År 2026 är webbdatautvinning inte bara en ”bra att ha”-grej för teknikintresserade; det är hemliga ingrediensen bakom prospektering inom försäljning, prisbevakning för e-handel, marknadsundersökningar och till och med analys av fastigheter. Med över 49 % av företagen som nu använder web scraping-verktyg varje vecka kan rätt bibliotek eller verktyg vara skillnaden mellan timmar av tråkigt manuellt arbete och ett kalkylblad fullt av handlingsbara insikter — levererade innan konkurrenterna ens hunnit äta lunch.
Men här blir det intressant: web scraping-bibliotek 2026 finns i alla möjliga former och smaker, från kodfria AI-tillägg för Chrome till avancerade ramverk för utvecklare. Oavsett om du är säljare som bara vill få ut leads till Excel, operationsansvarig som bevakar 500 produkter, eller en Python-expert som bygger en egen crawler, finns det ett verktyg för dig. Jag har tillbringat år inom SaaS och automation (och alldeles för många sena nätter för att vilja erkänna) med att utforska dessa bibliotek — så låt oss gå igenom de 10 bästa web scraping-biblioteken du bör känna till i år, och hur du väljer det som gör ditt jobb enklare.
Vad gör ett web scraping-bibliotek kraftfullt 2026?
Extrahera data från vilken webbplats som helst med AI Get Started Free
Innan vi dyker in i listan, låt oss prata om vad som faktiskt spelar roll när du väljer ett web scraping-bibliotek. Enligt min erfarenhet har de bästa verktygen 2026 några saker gemensamt:
- Enkel att använda: Kan en icke-kodare få resultat på några minuter? Eller kräver det en doktorsexamen i Python?
- Hantering av dynamiskt innehåll: Klarar det moderna sajter med mycket JavaScript? Eller faller det ihop så fort HTML:en blir mer än statisk?
- Språk- och plattformsstöd: Fungerar det i ditt favoritpråk — Python, JavaScript, Java — eller till och med direkt i webbläsaren?
- Skalbarhet: Klarar det hundratals (eller tusentals) sidor utan att svettas?
- Integration och export: Spelar det bra med Excel, Google Sheets, Notion eller din datakedja?
- AI och automation: År 2026 är AI-drivna verktyg som bara fungerar med naturliga språkprompter ett stort plus — särskilt för affärsanvändare som helst slipper kod.
Verkligheten är att affärsteam vill ha snabbhet, precision och så lite uppsättning som möjligt. Ju mindre tid du lägger på att laga trasiga scrapers eller brottas med kod, desto mer tid har du att agera på datan. Och med AI och webbläsarautomation på frammarsch kan även icke-tekniska användare nu samla in data som tidigare krävde hjälp av en utvecklare (PromptCloud).
Okej — nu till det riktigt bra.
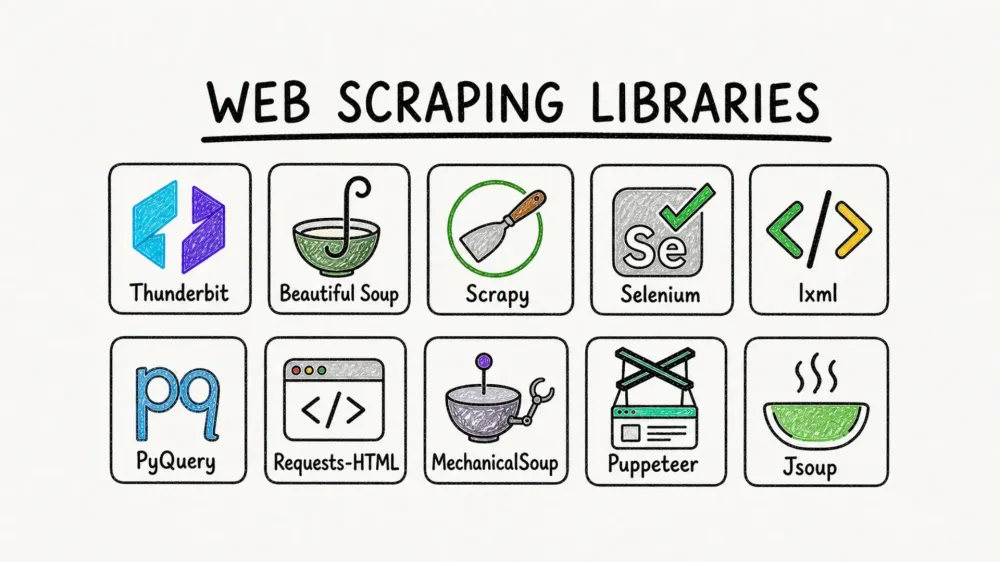
Topp 10 kraftfulla web scraping-bibliotek att använda 2026
- Thunderbit för kodfri, AI-driven web scraping direkt i webbläsaren
- Beautiful Soup för enkel HTML-tolkning och datarensning i Python
- Scrapy för storskalig och snabb crawling med pipelines
- Selenium för webbläsarautomation och scraping av dynamiska sajter med mycket JavaScript
- lxml för blixtsnabb XML/HTML-tolkning i Python
- PyQuery för jQuery-liknande HTML-selektion i Python
- Requests-HTML för allt-i-ett HTTP, HTML-tolkning och JS-rendering i Python
- MechanicalSoup för att automatisera formulär och enkla webbläsaruppgifter i Python
- Puppeteer för headless Chrome-automation i Node.js
- Jsoup för robust HTML-tolkning i Java
1. Thunderbit

Thunderbit är mitt förstahandsval för alla som vill skrapa webdata utan att skriva en enda rad kod. Denna AI-drivna Chrome-tilläggslösning låter dig beskriva vad du vill ha (“Hämta alla produktnamn, priser och bilder från den här sidan”), och AI:n löser resten. Inga mallar, ingen installation — klicka bara en gång, justera kolumnerna om du vill, och extraktionen körs oavsett om du rör något eller inte.
Därför sticker Thunderbit ut 2026:
- Kodfritt gränssnitt med naturligt språk: Vem som helst kan använda det — sälj, drift, marknad, fastigheter. Ingen Python behövs.
- Automatisk fältdetektering: AI:n bygger kolumnuppsättningen direkt utifrån sidans struktur.
- Skrapa undersidor: Behöver du mer detaljer? Thunderbit kan besöka varje undersida (som produkt- eller profilsidor) och berika din tabell automatiskt (Thunderbit Blog).
- Färdiga mallar för populära sajter: Amazon, Zillow, Shopify och fler — skrapa med ett klick.
- Export till Excel, Google Sheets, Notion, Airtable: Datan hamnar där teamet faktiskt arbetar.
- Stöd för 34 språk: Perfekt för globala team.
- Moln- eller webbläsarskrapning: Välj det som passar ditt arbetsflöde — molnläge går blixtsnabbt för publika sajter, medan webbläsarläget hanterar inloggningar.
Thunderbit används av över 200 000 användare världen över, och gratisnivån låter dig skrapa upp till 6 sidor (eller 10 med en testboost). Om du vill se hur modern web scraping ser ut i praktiken är det här jag skulle börja.
Testa Thunderbit AI Web Scraper gratis
2. Beautiful Soup
Beautiful Soup är ett klassiskt Python-bibliotek som älskas av data scientists och analytiker för sin enkelhet och styrka när det gäller att tolka stökig HTML. Om du någon gång försökt extrahera data från en sida med trasiga taggar eller konstig formatering, då är Beautiful Soup din vän.
Det som gör Beautiful Soup bra:
- Hanterar oregelbunden HTML: Perfekt för att rensa upp och extrahera data från ”fula” webbsidor (Beautiful Soup Docs).
- Lätt att lära sig: Även nybörjare i Python kommer snabbt igång.
- Flexibelt: Fungerar bra med HTTP-klienter som Requests och kan kombineras med lxml för bättre prestanda.
- Typiska användningsområden: Snabb dataextraktion, rensning av webdata, integration i små skript.
Om du jobbar med statiska sidor eller behöver hantera rörig markup är Beautiful Soup ett stabilt val.
3. Scrapy
Scrapy är tungviktaren bland Python-verktyg för web scraping. Det är ett fullfjädrat ramverk för att bygga skalbara crawlers och datapipelines. Om du behöver skrapa tusentals sidor, följa länkar och bearbeta data i stor skala är Scrapy byggt för just det.
Därför är Scrapy ett toppval:
- Mycket modulärt: Bygg komplexa spiders, pipelines och middlewares (Scrapy Docs).
- Klarar stora projekt: Perfekt för marknadsanalys, konkurrensbevakning eller andra jobb där du behöver crawla och extrahera från många sajter.
- Asynkront och snabbt: Utformat för hög hastighet och effektivitet.
- Stor community: Massor av plugins, guider och stöd.
Scrapy har en viss inlärningskurva, men för stora uppgifter är det en riktig motor.
4. Selenium
Selenium är standardverktyget för att automatisera webbläsare. Det används till allt från testning av webbappar till att skrapa sajter som kräver inloggning, klick eller hantering av popup-fönster. Om du behöver interagera med JavaScript-tunga eller mycket dynamiska sajter kan Selenium efterlikna en riktig användare (ScrapingBee Selenium Guide).
Seleniums styrkor:
- Automatiserar riktiga webbläsare: Chrome, Firefox, Safari, Edge — du väljer.
- Hanterar inloggningar, popup-fönster och användaråtgärder: Perfekt för scraping efter autentisering eller när du måste igenom fler steg.
- Stöd för flera språk: Python, Java, C# och fler.
- Bäst för: Sajter som blockerar enkla scrapers, eller när du behöver simulera verkligt användarbeteende.
Det är lite tyngre än HTTP-baserade bibliotek, men ibland behöver man helt enkelt en riktig webbläsare.
5. lxml
lxml är en högpresterande XML- och HTML-parser för Python. Om hastighet är din högsta prioritet (tänk: att tolka tusentals stora dokument) är lxml svår att slå (Python HTML Parser Performance).
Varför lxml är en favorit:
- Otroligt snabbt: Slår de flesta andra Python-parsers, särskilt på stora filer.
- Robust: Klarar både XML och HTML och fungerar bra ihop med andra verktyg.
- Bra för: Bearbetning av stora datamängder, eller att kombinera med Beautiful Soup eller Scrapy för extra kraft.
Om du skrapar i stor skala eller behöver hantera enorma filer är lxml ett måste i verktygslådan.
6. PyQuery
PyQuery tar jQuery:s selector-syntax till Python. Om du gillar hur enkelt det är att välja element med $('.class') i jQuery, låter PyQuery dig göra samma sak i dina scraping-skript (PyQuery Docs).
PyQuery i korthet:
- jQuery-liknande selectors: Intuitivt för alla som kan frontend.
- Kompakt och läsbar kod: Gör komplexa urval enkla.
- Integreras med lxml: Snabbt och effektivt under huven.
- Bäst för: Projekt där du vill ha snabb, jQuery-lik HTML-manipulation i Python.
Det är en utmärkt brygga för dig som går från webbutveckling till dataextraktion.
7. Requests-HTML
Requests-HTML är ett Python-bibliotek som kombinerar enkelheten i Requests (för HTTP) med inbyggd HTML-tolkning och till och med JavaScript-rendering.
Det som gör Requests-HTML speciellt:
- Allt-i-ett: Hämta sidor, tolka HTML och rendera JavaScript i ett och samma paket.
- Nybörjarvänligt: Perfekt för små och medelstora scraping-projekt.
- Bra för: Snabba skript, sajter med viss dynamik och användare som vill ha enkelhet.
Om du precis har börjat eller behöver ett flexibelt verktyg för mindre uppdrag är Requests-HTML ett starkt val.
8. MechanicalSoup
MechanicalSoup är ett Python-bibliotek som automatiserar webbformulär och enkla webbläsarinteraktioner. Det bygger på Beautiful Soup och Requests, vilket gör det enkelt att logga in, fylla i formulär och navigera i grundläggande arbetsflöden (ScrapingBee MechanicalSoup Guide).
Varför MechanicalSoup är användbart:
- Automatiserar formulär och inloggningar: Bra för att skrapa data bakom autentisering.
- Enkelt API: Lätt för nybörjare att komma igång med.
- Bäst för: Upprepade webbläsaruppgifter, enkla flöden och sajter där full webbläsarautomation är onödigt mycket.
Det är inte lika kraftfullt som Selenium för komplexa sajter, men det är betydligt lättare och enklare för grundläggande behov.
9. Puppeteer
Puppeteer är ett Node.js-bibliotek för att styra headless Chrome eller Chromium. Det är en favorit för att skrapa JavaScript-tunga, mycket interaktiva webbplatser (Scrape.do Puppeteer Guide).
Puppeteers superkrafter:
- Full webbläsarautomation: Klicka, scrolla, fyll i formulär och interagera precis som en användare.
- Hanterar dynamiskt innehåll: Perfekt för sajter som laddar data via JavaScript.
- Bra för: E-handel, sociala medier eller andra sajter där traditionella scrapers går bet.
Om du är JavaScript-utvecklare eller behöver skrapa den ”moderna webben” är Puppeteer ett måste.
10. Jsoup
Jsoup är guldstandarden för HTML-tolkning i Java. Det är som Beautiful Soup, fast för Java-utvecklare (Baeldung Jsoup Guide).
Därför gillar Java-team Jsoup:
- Enkelt men kraftfullt API: Extrahera och manipulera data med bara några rader kod.
- Hanterar stökig HTML: Rensar upp och tolkar även dåligt formaterade sidor.
- Bäst för: Att integrera scraping i Java-baserade affärsappar eller backend-flöden.
Om din stack är Java är Jsoup det självklara valet.
Jämförelsetabell för web scraping-bibliotek
Här är en snabb jämförelse sida vid sida av alla 10 bibliotek:
| Bibliotek | Språk | Enkelhet | Dynamiskt innehåll | AI/kodfritt | Typiska användningsområden | Bäst för |
|---|---|---|---|---|---|---|
| Thunderbit | Chrome-tillägg | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | Ja | Försäljning, drift, research, fastigheter | Icke-kodare, affärsanvändare |
| Beautiful Soup | Python | ⭐⭐⭐⭐ | ⭐ | Nej | HTML-tolkning, datarensning | Python-nybörjare, analytiker |
| Scrapy | Python | ⭐⭐⭐ | ⭐⭐ | Nej | Storskalig crawling, pipelines | Utvecklare, stora dataprojekt |
| Selenium | Flera | ⭐⭐ | ⭐⭐⭐⭐⭐ | Nej | Webbläsarautomation, inloggningar | QA, dynamiska sajter |
| lxml | Python | ⭐⭐⭐ | ⭐ | Nej | Snabb tolkning, stora filer | Power users, stora datamängder |
| PyQuery | Python | ⭐⭐⭐⭐ | ⭐ | Nej | jQuery-liknande selektion | Webbutvecklare, korta skript |
| Requests-HTML | Python | ⭐⭐⭐⭐ | ⭐⭐ | Nej | Snabba skript, JS-rendering | Nybörjare, små projekt |
| MechanicalSoup | Python | ⭐⭐⭐⭐ | ⭐⭐ | Nej | Formulärautomation, inloggningar | Enkla webbläsaruppgifter |
| Puppeteer | Node.js | ⭐⭐⭐ | ⭐⭐⭐⭐⭐ | Nej | JS-tunga sajter, automation | JS-utvecklare, dynamisk scraping |
| Jsoup | Java | ⭐⭐⭐⭐ | ⭐ | Nej | HTML-tolkning i Java | Java-team, backend-flöden |
Så väljer du rätt web scraping-bibliotek för ditt företag
Vad är data scraping och hur gör man 2025 Get Started Free
Så vilket bibliotek ska du använda? Här är mitt råd, efter år av försök, misstag och alldeles för många sena felsökningspass:
- Icke-kodare eller affärsanvändare: Börja med Thunderbit. Det AI-drivna, kodfria upplägget gör att du kan få resultat på minuter i stället för dagar. Om ditt team bara vill ha data i Excel eller Sheets, gör det inte mer komplicerat än nödvändigt.
- Python-utvecklare: Beautiful Soup och Requests-HTML är bra för mindre uppgifter. Scrapy är din vän för större projekt. Kombinera med lxml eller PyQuery för extra kraft.
- Behöver du hantera inloggningar eller dynamiskt innehåll? Selenium (flera språk) eller Puppeteer (Node.js) är dina bästa alternativ.
- Java-team: Jsoup är det tydliga förstavalet för att integrera scraping i Java-appar.
- Behöver du automatisera formulär eller enkla arbetsflöden? MechanicalSoup är lättviktigt och enkelt att använda.
Viktiga faktorer att tänka på:
- Teknisk nivå: Kodfria verktyg som Thunderbit passar perfekt för team utan teknisk bakgrund. Utvecklare kanske föredrar flexibiliteten i kodbaserade bibliotek.
- Datakomplexitet: För enkla, statiska sidor är Beautiful Soup eller Jsoup utmärkta. För dynamiska sajter med mycket JavaScript, välj Selenium eller Puppeteer.
- Skala: Scrapy och lxml glänser vid stora jobb med höga hastighetskrav.
- Integration: Thunderbits direkta export till Sheets, Notion och Airtable sparar massor av tid i affärsflöden.
Vill du läsa mer om hur du väljer rätt verktyg? Kolla in PromptClouds guide.
Se Thunderbits priser och gratisnivå
Slutsats: Lås upp webbdatan med rätt verktyg
Web scraping 2026 är inte längre bara för kodare eller data scientists. Med explosionen av AI-drivna och kodfria verktyg kan alla team — från försäljning till research — ta del av webben som en dataguldgruva. Rätt bibliotek kan spara dig hundratals timmar per år (Browsercat), öka precisionen och ge ditt företag ett verkligt försprång.
Mitt råd? Börja med dina behov — snabbhet, skala och teknisk komfort — och testa några alternativ. Thunderbits gratisnivå är ett utmärkt sätt att prova sig fram, och öppenkällkods-bibliotek som Beautiful Soup eller Scrapy finns alltid där om du vill kavla upp ärmarna.
Vill du fördjupa dig? Kolla in Thunderbit Blog för fler guider, eller prenumerera på vår YouTube-kanal för praktiska genomgångar.
Lycka till med scraping — och må din data alltid vara ren, strukturerad och redo att användas.
Testa Thunderbit AI Web Scraper gratis Get Started Free
Vanliga frågor
1. Vad är det enklaste web scraping-biblioteket för icke-kodare 2026?
Thunderbit är förstahandsvalet för icke-kodare. Dess AI-drivna Chrome-tillägg låter användare skrapa data med naturliga språkprompter — ingen kod behövs.
2. Vilket bibliotek är bäst för att skrapa JavaScript-tunga eller dynamiska webbplatser?
Puppeteer (Node.js) och Selenium (flera språk) är bäst för dynamiska sajter som renderas med JavaScript. De automatiserar riktiga webbläsare och klarar komplexa interaktioner.
3. Vad är skillnaden mellan Beautiful Soup och Scrapy?
Beautiful Soup är utmärkt för att tolka och extrahera data från enstaka sidor eller mindre projekt, särskilt när HTML:en är stökig. Scrapy är ett fullskaligt ramverk för att bygga skalbara crawlers och bearbeta stora datamängder.
4. Kan jag exportera insamlad data direkt till Google Sheets eller Notion?
Ja — Thunderbit erbjuder direkt export till Google Sheets, Notion, Airtable och Excel. De flesta kodbibliotek kräver att du själv skriver exportlogik.
5. Hur väljer jag rätt web scraping-bibliotek för mitt företag?
Tänk på din tekniska nivå, hur komplexa sajterna är, hur mycket data du ska hämta och vilka integrationsbehov du har. Kodfria verktyg som Thunderbit passar perfekt för affärsteam, medan utvecklare ofta föredrar bibliotek som Scrapy, Beautiful Soup eller Puppeteer för mer kontroll.
Läs mer



