
Förra veckan skickade en kollega ett leverantörsavtal på 47 sidor och bad mig att “bara få ut pris-tabellerna i ett kalkylblad”. Jag stirrade på PDF:en i ungefär tre sekunder innan jag stängde den och öppnade en PDF-scraper i stället. Den instinkten kom inte av lathet — den kom av åratal av att se människor slösa bort hela eftermiddagar på att brottas med data ur filer som aldrig var tänkta att släppa ifrån sig den.
Siffrorna bekräftar frustrationen. Airbases undersökning från 2024 av 745 finansproffs visade att 38 % av teamen lägger mer än en fjärdedel av sin totala tid på manuella uppgifter. SAP Concur:s rapport om AP-automation tillägger att 60 % av fakturaregistreringarna i ERP- eller bokföringssystem fortfarande görs för hand.
PDF:er finns överallt — fakturor, kontrakt, finansiella rapporter, inskannade kvitton — och alldeles för mycket av arbetet sker fortfarande via copy-paste. År 2026 spänner PDF-scrapers från gratis Python-bibliotek till AI-drivna no-code-verktyg, och att välja fel kan kosta dig dagar i stället för att spara dem. Jag testade 12 av de bästa PDF-scrapersen inom tabellutvinning, OCR, pris och användarvänlighet så att du kan hitta rätt lösning på några minuter.
Vad är en PDF Scraper (och varför ska du bry dig)?
En PDF scraper är mjukvara som automatiskt extraherar text, tabeller, fält och strukturerad data från PDF-filer. Om du någon gång har försökt kopiera en tabell från en PDF till Excel och sett kolumnerna kollapsa till en enda rörig rad, då känner du redan till problemet.
PDF scrapers och web scrapers blandas ofta ihop, så en snabb distinktion hjälper. En web scraper läser HTML, som åtminstone har strukturella taggar — rubriker, tabeller, divar. En PDF scraper utgår från ett visuellt sidbeskrivningsformat. Adobe förklarar själv tydligt att PDF är byggt för att bevara sidans utseende konsekvent mellan olika enheter, inte för att exponera en ren tabell- eller semantisk struktur. Därför förstör copy-paste rader, kolumner och läsordning.
Var sparar PDF scraping egentligen tid?
- Fakturahantering: hämta leverantörsnamn, fakturanummer, totalsummor, skatt och radposter
- Finansiella rapporter: extrahera tabeller från årsredovisningar, rapporter och upplysningar
- Skannade dokument: rädda kontaktuppgifter eller transaktionsdata ur PDF:er som bara består av bilder
- Migrering av äldre arkiv: omvandla gamla arkiv till sökbara, strukturerade register
Affärseffekten handlar om mer än ett enskilt arbetsflöde. Gartner beskriver fortfarande dålig datakvalitet som något som kostar organisationer minst 12,9 miljoner dollar per år i genomsnitt. Och i februari 2025 sa Gartner att 63 % av organisationerna antingen saknar, eller är osäkra på om de har, rätt datastyrningsrutiner för AI. Fram till 2026 menar Gartner att organisationer kommer att överge 60 % av AI-projekt som inte stöds av AI-redo data. Om PDF:er fortfarande är platsen där mycket av rådata lever, blir kvaliteten på dokumentutvinning direkt kopplad till AI-redohet.
Adobes undersökning från 2025 bland finansproffs visade att 61 % regelbundet redigerar PDF-baserade dokument och 64 % regelbundet signerar dem. PDF Association noterar också att PDF rankades som det 3:e mest populära filformatet på webben i CommonCrawl-data. PDF:er är här för att stanna.
Hur vi utvärderade de bästa PDF Scrapers
Innan vi går igenom verktygen är här ramen jag använde. De åtta kriterierna nedan speglar direkt de problem jag oftast ser i forum, GitHub-ärenden och produktrecensioner:
| Kriterium | Vad det mäter | Varför användare bryr sig |
|---|---|---|
| PDF-typer som stöds | Inbyggd text, skannade/bildbaserade, blandade | Många verktyg faller redan innan extraktionen ens börjar |
| Noggrannhet i tabellutvinning | Enkla, utan ramar, flersidiga, sammanslagna celler | Det vanligaste klagomålet vid PDF-utvinning |
| OCR-förmåga | Inbyggd, tillägg eller ingen | Skannade PDF:er är oanvändbara utan OCR |
| Exportformat | Excel, CSV, JSON, Sheets, Notion, API:er | Data är värdelös om den inte kan lämna verktyget snyggt |
| Inställningsnivå | No-code, low-code eller kod först | Team behöver väldigt olika nivåer av kontroll |
| Pris / gratisnivå | Offentligt pris, testperiod, realistisk startpunkt | Faktureringsmodellerna varierar kraftigt |
| Automatisering / integrationer | Zapier, API, schemaläggning, webhooks | Manuella exportflöden skalar inte |
| Bästa användningsområde | Vad verktyget faktiskt är bra på | De flesta verktyg är inte bra på allt — de är arbetsflödesspecifika |
För att hålla det överskådligt delas de 12 verktygen in i tre kategorier: no-code AI-scrapers, mallbaserade eller SaaS-baserade dokumenttolkare, samt utvecklarbibliotek / API:er / open source-verktyg.
De 12 bästa PDF Scrapers i korthet
Här är huvudjämförelsen så att du snabbt kan hitta din profil och hoppa till rätt avsnitt:
| Verktyg | Typ | Tabellutvinning | Inbyggd OCR | No-code | Gratisnivå | Bäst för |
|---|---|---|---|---|---|---|
| Thunderbit | AI no-code scraper | ✅ AI-driven | ✅ Ja | ✅ Ja | ✅ Gratis krediter | Företagsanvändare, varierande layouter |
| Tabula | Open source desktop | ✅ Bra (text-PDF:er) | ❌ Nej | ✅ GUI | ✅ Helt gratis | Enkla text-PDF:er med mycket tabeller |
| Parseur | Hybrid SaaS | ⚠️ Mall + AI | ✅ Ja | ✅ Ja | ⚠️ Begränsad | Återkommande faktura-/e-posttolkning |
| Nanonets | AI IDP SaaS | ✅ Stark | ✅ Ja | ✅ Low-code | ⚠️ Testkrediter | Dokumentautomatisering i hög volym |
| Adobe Acrobat | PDF-produktivitetssvit | ⚠️ Grundläggande | ✅ Ja | ✅ Ja | ❌ Export är betald | Tillfällig PDF-till-Excel |
| PyMuPDF | Python-bibliotek | ⚠️ Manuell parsning | ❌ Nej (Tesseract valfritt) | ❌ Kod krävs | ✅ Helt gratis | Utvecklare, texttunga PDF:er |
| Camelot | Python-bibliotek för tabeller | ✅ Stark (lattice + stream) | ❌ Nej | ❌ Kod krävs | ✅ Helt gratis | Utvecklare, komplexa tabeller |
| Docparser | Mallbaserad SaaS | ⚠️ Mallbaserad | ✅ Ja | ✅ Ja | ⚠️ Testperiod | Återkommande dokument + Zapier-flöden |
| pdfplumber | Python-bibliotek | ✅ Bra (detaljerad) | ❌ Nej | ❌ Kod krävs | ✅ Helt gratis | Utvecklare, finmaskig kontroll |
| AWS Textract | Moln-API | ✅ Stark | ✅ Ja | ❌ API krävs | ⚠️ Begränsad gratisnivå | Pipelines i företagsklass |
| Docling | Open source Python | ✅ Bra | ✅ Via integration | ❌ Kod krävs | ✅ Helt gratis | LLM/RAG-pipelines |
| Parsio | Hybrid SaaS | ⚠️ AI-assisterad | ✅ Ja | ✅ Ja | ⚠️ Begränsad | Återkommande dokumenttyper |
Vill du ha noll setup? Börja i no-code- eller SaaS-raderna. Behöver du maximal kontroll? Börja i utvecklar-raderna. Arbetar du med skannade PDF:er? Uteslut alla rader där OCR = Nej.
1. Thunderbit
 Thunderbit är den PDF scraper jag skulle ge till alla som säger “jag behöver bara få ut datan ur den här PDF:en” och inte vill höra talas om Python, mallar eller API-nycklar. Det är en AI-driven web data agent — ett Chrome-tillägg — som läser PDF:er, bilder och webbplatser och sedan matar ut strukturerad data. Inga mallar, ingen kod.
Vi byggde Thunderbit för att klara det scenario som ställer till det för de flesta verktyg: du får PDF:er från fem olika leverantörer, alla med lite olika layout, och du behöver samma fält från alla. AI:n läser varje dokument på nytt, föreslår kolumnnamn och datatyper via funktionen “AI Suggest Fields”, och extraherar datan till en strukturerad tabell. Inbyggd OCR hanterar skannade PDF:er och bilder direkt, med stöd för 34 språk.
Nyckelfunktioner:
- One Click Extract tar fram kolumner och datatyper från alla PDF-layouter — ingen manuell konfiguration
- Inbyggd OCR för skannade PDF:er och bilder
- Export till Excel, Google Sheets, Airtable, Notion, CSV och JSON — helt gratis
- AI-etikettering och omformatering: AI:n kan översätta, kategorisera eller strukturera om data under extraktionen, inte bara efteråt
- Tabellutvinning läser layouten visuellt (som en människa) och anpassar sig till tabeller utan ramar, oregelbundna format och flera leverantörer
Så här extraherar du en PDF med Thunderbit:
- Installera Thunderbit Chrome Extension
- Öppna eller ladda upp din PDF i webbläsaren
- Klicka på “One Click Extract” — AI:n läser dokumentet och identifierar kolumnnamn och typer
- Klicka på “Scrape” — datan extraheras till en strukturerad tabell
- Exportera till Google Sheets, Excel, Airtable, Notion, CSV eller JSON
Pris: Gratisnivå med krediter (cirka 6 sidor gratis, 10 med test). Starter-plan från ungefär 15 dollar/månad eller cirka 9 dollar/månad vid årlig fakturering. Krediter baseras på rader (1 kredit = 1 utdat rad). Se Thunderbit Pricing för detaljer.
Bäst för: Icke-tekniska användare som hanterar varierande PDF-layouter (fakturor från flera leverantörer, rapporter i blandade format) och vill ha resultat med ett enda klick.
Fördelar: Enklast att komma igång med i den här listan; inbyggd OCR; direkt export till Sheets, Notion, Airtable och Excel; fungerar på varierande layouter utan mallar.
Nackdelar: Kreditbaserad prissättning kräver en minut för att översätta till kostnad per sida; färre tredjepartsrecensioner än större SaaS-leverantörer.
Testa Thunderbit för PDF-extraktion Ladda upp fakturor från fem olika leverantörer och låt AI:n räkna ut kolumnerna för varje layout — ingen per-mall-konfiguration. Get Started Free
2. Tabula
 Tabula är det klassiska gratisalternativet för tabellutvinning ur textbaserade PDF:er, och det är samtidigt tydligt ett äldre projekt vid det här laget. Repo:t anger att det drivs av volontärer, och desktop-applikationen kommer troligen inte att få uppdateringar inom den närmaste framtiden. Den senaste desktop-versionen är fortfarande 1.2.1 från 2018, medan tabula-java senast släppte 1.0.5 år 2021.
Nyckelfunktioner:
- Punkt-och-klick-GUI för att markera tabellområden
- Kör lokalt — data lämnar aldrig din dator
- Inget konto, ingen prenumeration, ingen registrering
Pris: Helt gratis, för alltid. Open source.
Bäst för: Användare som har enkla, textbaserade PDF:er med tydligt avgränsade tabeller och vill ha en gratis lokal lösning.
Fördelar: Gratis; lokalt; väldigt enkelt för grundläggande tabeller.
Nackdelar: Ingen OCR (skannade PDF:er går bort); svag på tabeller utan ramar; ingen automation eller API; inget molnalternativ; i praktiken ounderhållet.
3. Parseur
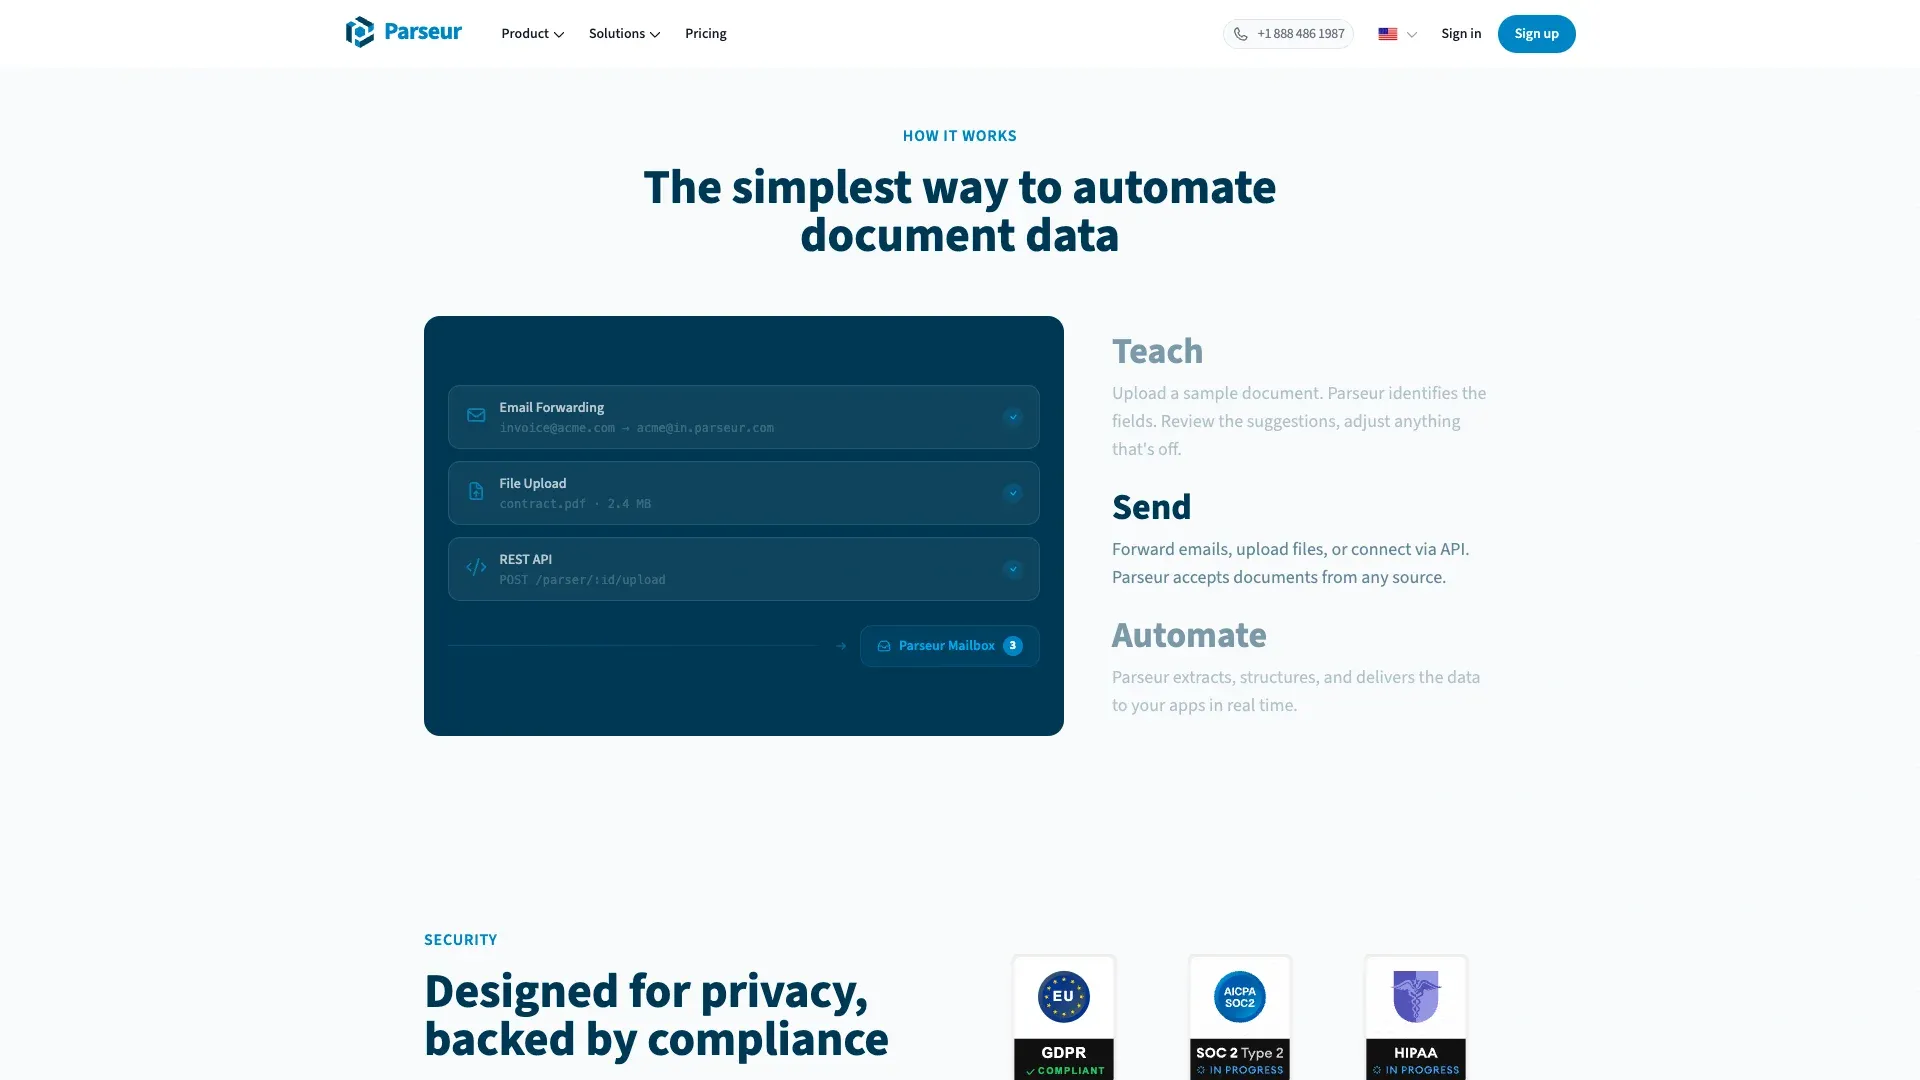 Parseur är den starkaste hybridlösningen i SaaS-gruppen eftersom den kombinerar AI-tolkning, malltolkning och dynamisk OCR. Det gör den mer flexibel än en ren zonbaserad tolkare, men fortfarande mer strukturerad än en helt generell AI-scraper.
Nyckelfunktioner:
- Inbyggd OCR med stöd för 60+ språk (160+ experimentella)
- Integrationer med Zapier, Make, Power Automate, API, webhooks, Google Sheets
- Bra för fakturor, fraktsedlar, orderbekräftelser och återkommande dokumenttyper
Pris: Gratisnivå på ungefär 20 sidor/månad. Lägsta självtjänstnivån ligger runt 39 dollar/månad. Normaliserad kostnad på minsta planen är ungefär 390 dollar per 1 000 sidor, även om den effektiva kostnaden sjunker vid högre volymer.
Bäst för: Team som får samma typ av dokument om och om igen och vill automatisera utan kod.
Fördelar: Inbyggd OCR; stark automationsstack; hanterar återkommande layouter bra.
Nackdelar: Varje ny eller förändrad layout kan kräva mallarbete eller AI-fallback; komplexa tabellstrukturer är fortfarande svårare.
4. Nanonets
 Nanonets ligger närmare en intelligent dokumenthanteringsplattform (IDP) än en enkel PDF scraper — och det är både dess styrka och dess komplexitet. Företaget ändrade pris den 31 januari 2025 och gick över till förbetalda användningskrediter i stället för en enkel sidbaserad plan.
Nyckelfunktioner:
- AI-driven tabellutvinning och fältidentifiering
- Inbyggd OCR med stöd för 40+ språk
- Arbetsflödesautomation med godkännandesteg
- Bred integrationsstack för företag
Pris: Krediter vid registrering. Användningsbaserad fakturering. En grov uppskattning baserad på officiell dokumentation om blockpriser är cirka 300–380 dollar per 1 000 sidor för ett enkelt extraktionsflöde.
Bäst för: Medelstora till stora team som behandlar tusentals dokument per månad (AP-automation, logistik, försäkringsärenden).
Fördelar: Stark AI-extraktion; företagsintegrationer; arbetsflödesautomation.
Nackdelar: Prissättningen är svårare att förutsäga; inlärningskurva för avancerade flöden; begränsad gratisnivå.
5. Adobe Acrobat
 Adobe Acrobat är det grundläggande PDF-verktyget nästan alla känner igen. Det är starkt för OCR och konvertering, men är egentligen inte en scraper i samma mening som resten av listan.
Nyckelfunktioner:
- Inbyggd OCR i Pro
- Export till Word, Excel, PowerPoint, HTML, TXT och bildformat
- Bred OCR-support för flera språk
Pris: Acrobat Standard för 14,99 dollar/månad; Acrobat Pro för 19,99 dollar/månad. Reader är gratis, men exportfunktioner kräver betald plan.
Bäst för: Användare som ibland behöver konvertera en PDF till Word eller Excel och redan har Adobe-abonnemang.
Fördelar: Bred tillit; inbyggd OCR; många har det redan.
Nackdelar: Tabellutvinning är grundläggande på komplexa layouter; ingen automation eller API för batchbearbetning; inte byggt som en “scraper”.
6. PyMuPDF
 PyMuPDF (även kallat “fitz”) är fortfarande det snabbaste allmänna Python-biblioteket för PDF-utvinning i den här genomgången. Den aktuella versionen är 1.27.2.2 från mars 2026, och benchmarks visar fortsatt att det är betydligt snabbare än många andra Python-bibliotek för PDF.
Nyckelfunktioner:
- Extremt snabb råtextextraktion
- Bildutvinning och åtkomst till metadata
- Valfri OCR via Tesseract (även om dokumentationen noterar att OCR är cirka 1 000 gånger långsammare än standardextraktion)
- Tabellidentifiering via
find_tables()
Pris: Helt gratis, open source.
Bäst för: Utvecklare som bygger pipelines och främst arbetar med texttunga, inbyggda PDF:er.
Fördelar: Väldigt snabbt; lättviktigt; aktiv community; stark textextraktion.
Nackdelar: Ingen inbyggd OCR; tabellutvinning kräver manuell parslogik; kod krävs.
7. Camelot
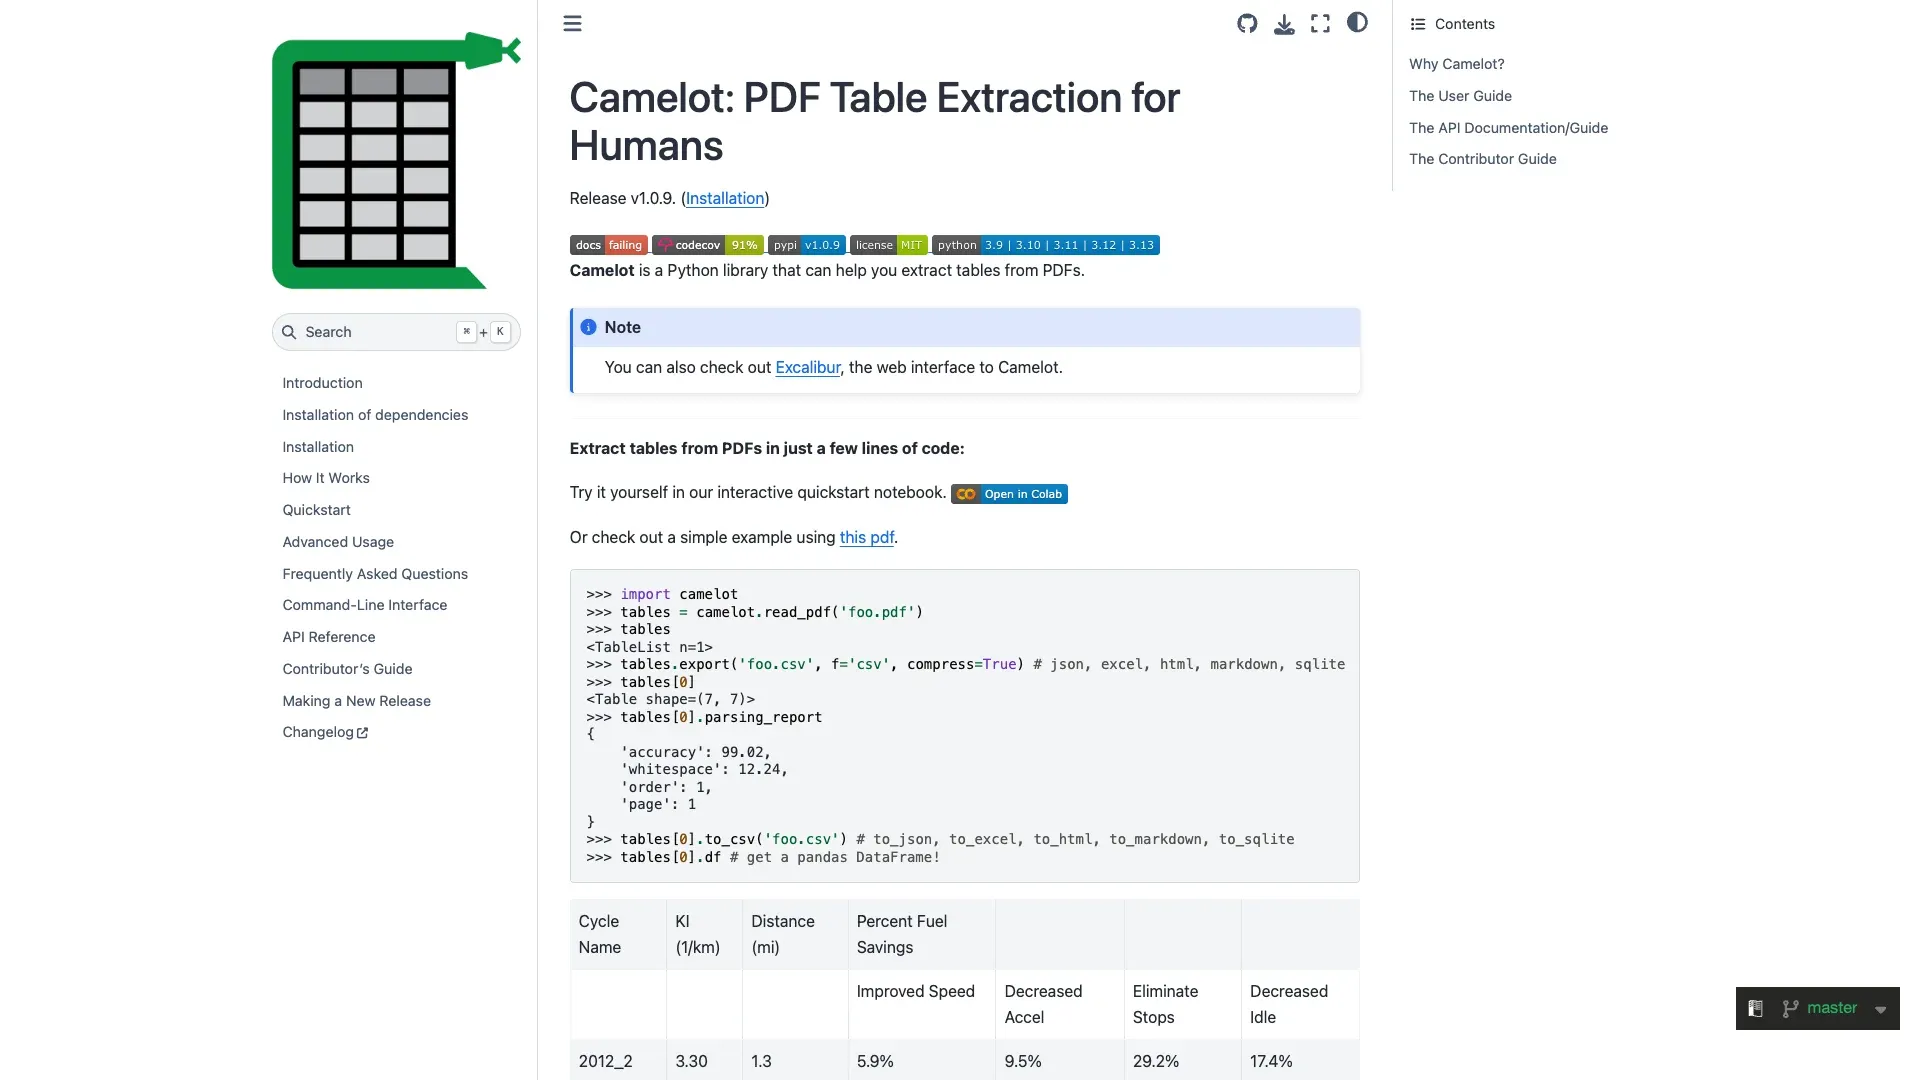 Camelot är fortfarande ett av de mest välkända Python-verktygen för tabellutvinning eftersom det är tabell-först snarare än dokumentgenerellt. Det nuvarande repo:t underhålls, med v1.0.9 släppt i augusti 2025.
Nyckelfunktioner:
- Två extraktionslägen:
latticeför tabeller med ramar,streamför tabeller utan ramar / med whitespace - Noggrannhetsmått i parsingsrapporten — en av Camelots mest användbara funktioner för automationsflöden
- Export till pandas DataFrames, CSV, JSON, Excel
Pris: Helt gratis, open source.
Bäst för: Utvecklare som behöver exakt tabellutvinning från strukturerade, textbaserade PDF:er.
Fördelar: Mycket hög träffsäkerhet i tabeller; två extraktionslägen; noggrannhetspoäng.
Nackdelar: Ingen OCR; bara textbaserade PDF:er; kod krävs; kan vara långsam på stora dokument.
8. Docparser
 Docparser är det mest tydligt regelstyrda SaaS-verktyget i urvalet. Det använder zonbaserad OCR, ankarord och fasta parsingsregler i stället för att försöka bete sig som en layoutgenerell AI-läsare.
Nyckelfunktioner:
- Inbyggd OCR
- Integrerar med Zapier, Workato, Power Automate, Google Sheets, Salesforce och REST API
- Bra för att skicka extraherad data in i affärsflöden
Pris: Starter för 39 dollar/månad; Professional för 74 dollar/månad; Business för 159 dollar/månad. 14 dagars gratis test. Debiteras per dokument, så normaliserad kostnad per 1 000 sidor beror på dokumentlängd — ungefär 78–390 dollar på starter-nivån.
Bäst för: Team som behöver automatisera återkommande dokumentflöden med tät integration i verktyg som Zapier eller Salesforce.
Fördelar: Inbyggd OCR; starka arbetsflödesintegrationer; bra för stabila layouter.
Nackdelar: Mallbaserat — varje ny layout kräver uppsättning; tabellutvinning beror på zondefinitioner; starkast på sida 1.
9. pdfplumber
 pdfplumber är fortfarande det mest detaljrika utvecklarbiblioteket i listan. Den aktuella versionen är 0.11.9 från januari 2026, och repo:t säger att det är under aktiv utveckling.
Nyckelfunktioner:
- Finmaskig kontroll över teckenobjekt, linjer, rektanglar och strategier för tabellidentifiering
- Beskärningsbaserad filtrering och visuell felsökning
- Exporterar data som Python-listor/dictionaries för enkel manipulation
Pris: Helt gratis, open source.
Bäst för: Python-utvecklare som behöver detaljerad och anpassningsbar logik för tabellutvinning.
Fördelar: Utmärkt låg-nivå-kontroll; bra noggrannhet på komplexa tabeller; aktiv utveckling.
Nackdelar: Ingen OCR; brantare inlärningskurva än Camelot; kod krävs.
10. AWS Textract
 AWS Textract är det mest företagsnära API:t i listan. Det är byggt för skala, dokumentvariation och programmatiskt bruk snarare än bekvämlighet i ett GUI.
Nyckelfunktioner:
- AI-driven utvinning av tabeller och formulär
- Inbyggd OCR med handskriftsstöd (närmast i listan, men fortfarande ofullkomligt)
- Skalbarhet i företagsklass
- Smidig integration i AWS-ekosystemet
Pris: Debitering per sida. Gratisnivå: 1 000 sidor/månad i 3 månader. Därefter: text-only OCR för 1,50 dollar/1 000 sidor; tabeller för 15 dollar/1 000 sidor; formulär + tabeller för 65 dollar/1 000 sidor; utgiftshandlingar för 10 dollar/1 000 sidor.
Bäst för: Företagsteam som processar 10 000+ dokument/månad via en API-pipeline.
Fördelar: Noggrann utvinning av formulär och tabeller; inbyggd OCR; skalbarhet i företagsklass.
Nackdelar: Endast API; inget visuellt gränssnitt; kostnaderna stiger snabbt i avancerade lägen; inlåsning i AWS-ekosystemet.
11. Docling
 Docling är det mest framtidsorienterade open source-verktyget här eftersom det är direkt inriktat på dokument-till-LLM-pipelines. Den aktuella versionen är 2.90.0 från 17 april 2026, och projektet utvecklas snabbt.
Nyckelfunktioner:
- Exporterar till Markdown, HTML, WebVTT, DocTags och förlustfri JSON
- OCR-stöd via flera integrerade motorer
- Byggt för LangChain, LlamaIndex, CrewAI, Haystack och liknande ekosystem
- Stark tillväxt i communityn
Pris: Helt gratis, open source.
Bäst för: Utvecklare som bygger LLM/RAG-appar och behöver konvertera PDF:er till strukturerad, AI-redo Markdown.
Fördelar: Ren Markdown-utmatning; OCR via integration; byggt för moderna AI-flöden; aktiv utveckling.
Nackdelar: Kod krävs; riktar sig främst till utvecklare; mindre polerat GUI och färre exportalternativ än SaaS-verktyg.
12. Parsio
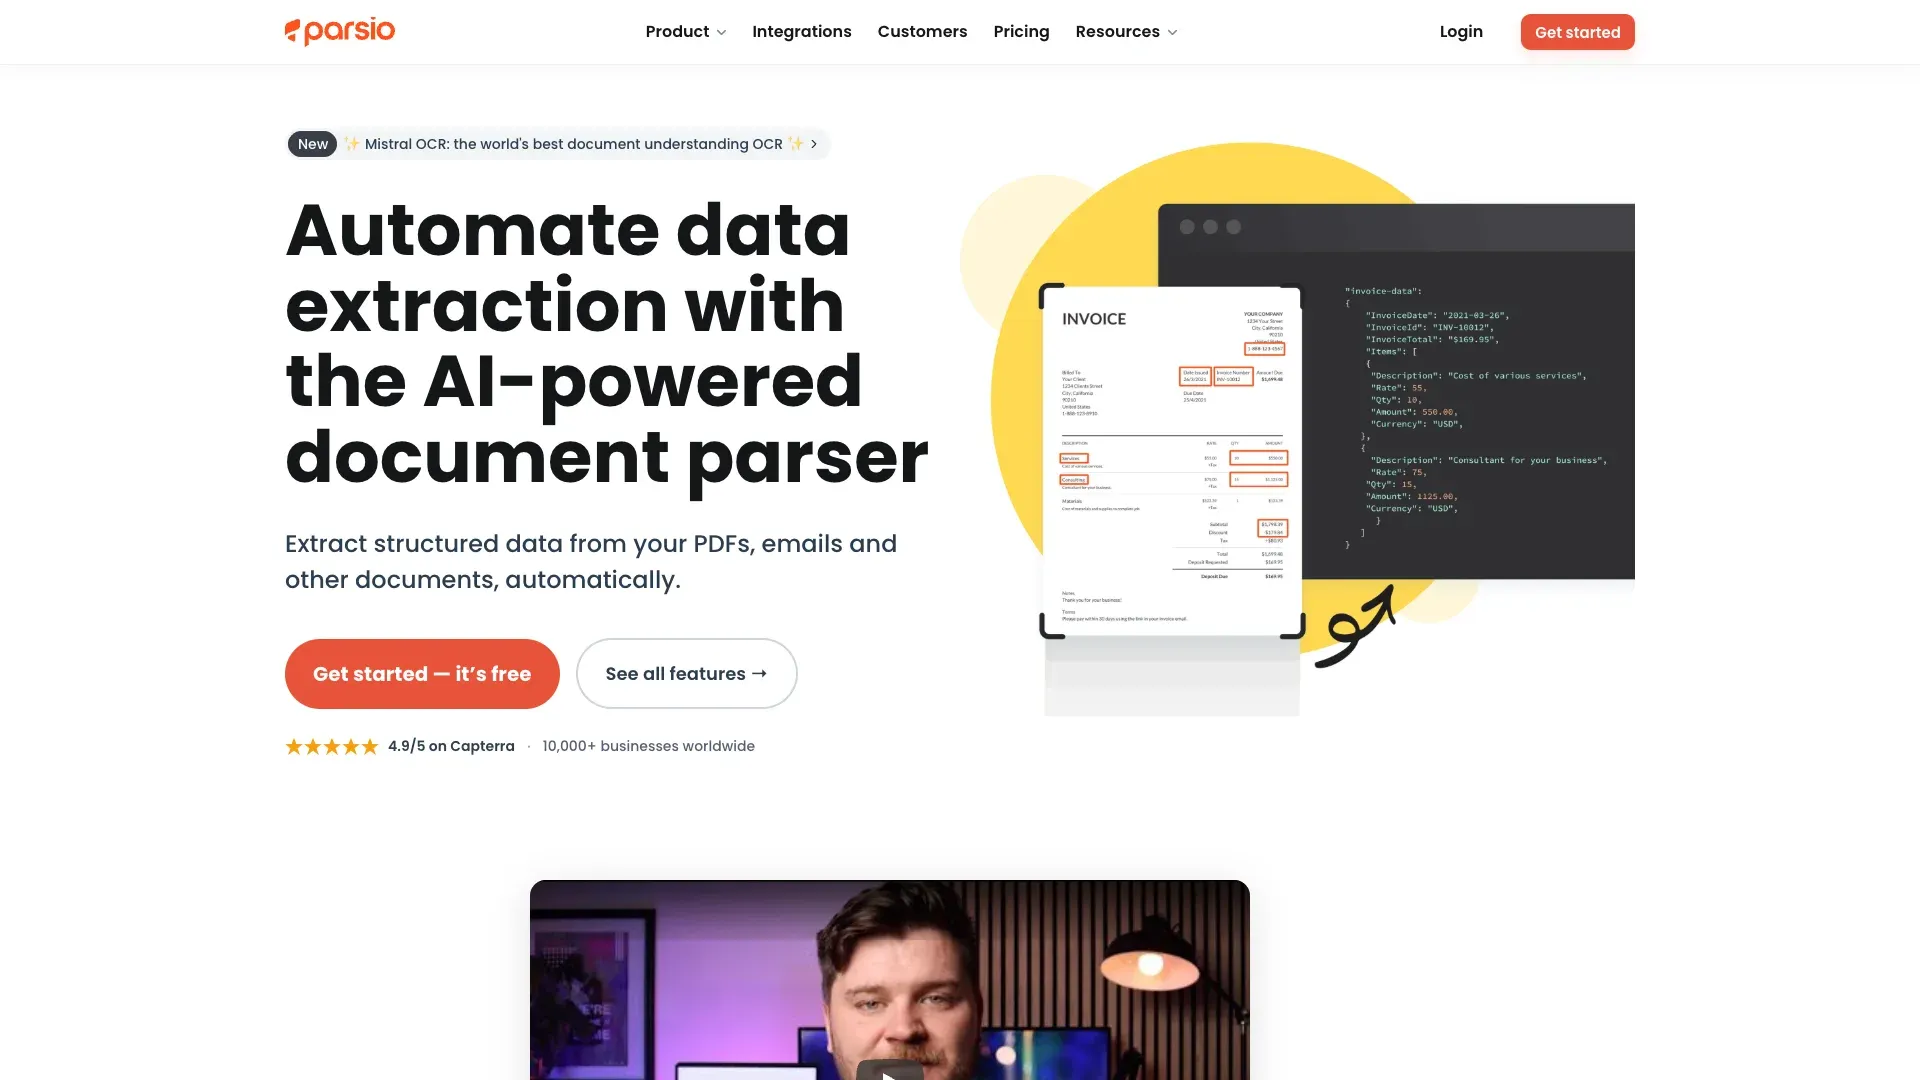 Parsio är en hybrid-SaaS-tolkare som kombinerar mallar, OCR, AI-tolkning och GPT-driven parsning. Den ligger andligt mellan Parseur och Docparser: mer flexibel än rena zonlösningar, men fortfarande optimerad för återkommande dokumentflöden.
Nyckelfunktioner:
- Inbyggd OCR
- AI-assisterad fältidentifiering
- Integrationer med Google Sheets, webhooks, API, Zapier, Make, n8n, Pabbly
Pris: Sandbox med 30 krediter. Starter för 41 dollar/månad för 1 000 krediter; Growth för 124 dollar/månad; Business för 249 dollar/månad. Ett parsat dokument eller en PDF-sida kan kosta 1, 2 eller 5 krediter beroende på parsingsläge, så den normaliserade uppskattningen på starter-planen är ungefär 41–205 dollar per 1 000 sidor.
Bäst för: Små till medelstora team som hanterar återkommande dokumenttyper (fakturor, kvitton) och vill ha en no-code SaaS-lösning med lätt AI-stöd.
Fördelar: Inbyggd OCR; bred dokumenttäckning; bred automationsstack.
Nackdelar: Tredjepartsomdömen är begränsade; prissättningen blir mindre tydlig mellan olika parsingslägen; inte lika tydligt differentierad som Parseur eller Nanonets.
Tabellutvinning i fokus: hur de bästa PDF Scrapers hanterar verkliga tabeller
Tabellutvinning är den enskilt mest diskuterade smärtpunkten bland PDF scraper-användare — och med god anledning. Nya benchmarks som OmniDocBench (1 651 sidor över 10 dokumenttyper) och akademisk forskning om heterogen tabellutvinning bekräftar att “tabellutvinning” inte är en enda enhetlig uppgift. Det är ett spektrum.
Enkla tabeller (tydliga ramar, en sida)
De flesta verktyg klarar detta bra. Tabula, Camelot, pdfplumber, Thunderbit och AWS Textract presterar alla väl här. Om dina PDF:er bara har enkla tabeller med ramar fungerar nästan vilket verktyg som helst i den här listan.
Tabeller utan ramar och med whitespace
Här blir skillnaderna tydliga. Utan linjer har regelbaserade parser svårt att upptäcka kolumngränser. Camelots stream-läge och pdfplumbers anpassade parameterjusteringar är starka för utvecklare som kan fintrimma inställningar. AI-drivna verktyg som Thunderbit, Nanonets och AWS Textract tolkar layouten visuellt, vilket ofta fungerar bättre för icke-utvecklare som jobbar med inkonsekventa format.
Tabeller som sträcker sig över flera sidor
Ett vanligt felcase. Mallverktyg och enkla extraktorer behandlar ofta varje sida som en separat tabell om inte arbetsflödet uttryckligen kopplar ihop dem igen. AI-först-verktyg har ett övertag här eftersom de kan tolka kontinuitet semantiskt, inte bara geometriskt — även om ingen leverantör ska betraktas som perfekt i den här typen av problem.
Sammanfogade celler och nästlade rubriker
Det svåraste scenariot. EMNLP-papperet från 2024 om heterogen tabellinformationsutvinning rapporterar F1-intervall från 74,2 till 96,1 beroende på metod och scenario. AI-drivna verktyg (Thunderbit, Nanonets, AWS Textract) tenderar att överträffa regelbaserade parser här eftersom de tolkar layout semantiskt i stället för att förlita sig på linjer.
OCR-jämförelse: vilka PDF Scrapers klarar skannade dokument?
OCR är skiljelinjen mellan verktyg som kan hantera riktiga affärs-PDF:er och verktyg som bara klarar ideala, maskinellt genererade dokument. Här är matrisen:
| Verktyg | Inbyggd OCR | Stöd för skannade PDF:er | OCR på flera språk | Stöd för handskrift |
|---|---|---|---|---|
| Thunderbit | ✅ Inbyggd | ✅ Ja | ✅ 34 språk | ⚠️ Begränsat |
| Adobe Acrobat | ✅ Inbyggd | ✅ Ja | ✅ Stark | ⚠️ Begränsat |
| AWS Textract | ✅ Inbyggd | ✅ Ja | ✅ Flera stora språk | ✅ Närmast, men ofullkomligt |
| Nanonets | ✅ Inbyggd | ✅ Ja | ✅ 40+ språk | ⚠️ Begränsat |
| Parseur | ✅ Inbyggd | ✅ Ja | ✅ 60+ språk | ❌ Nej |
| Parsio | ✅ Inbyggd | ✅ Ja | ✅ Flera språk | ⚠️ Begränsat |
| Docparser | ✅ Inbyggd | ✅ Ja | ✅ Ja | ⚠️ Begränsat |
| Docling | ✅ Via integration | ✅ Ja | Beror på motor | ⚠️ Begränsat |
| Tabula | ❌ Ingen | ❌ Nej | N/A | N/A |
| PyMuPDF | ❌ (Tesseract valfritt) | ❌ Kräver tillägg | Beror på motor | Beror på motor |
| Camelot | ❌ Ingen | ❌ Nej | N/A | N/A |
| pdfplumber | ❌ Ingen | ❌ Nej | N/A | N/A |
Inget verktyg hanterar handskrift pålitligt i alla fall år 2026. AWS Textract är det närmaste företags-API:t, men handskrift är fortfarande en funktion att använda med försiktighet. Om dina PDF:er är skannade men maskinskrivna fungerar alla verktyg med inbyggd OCR bra. Är de handskrivna, ha realistiska förväntningar.
AI-driven vs regelbaserad vs mallbaserad: tre generationer av PDF scraping
Det enklaste sättet att förstå PDF scraper-marknaden 2026 är som tre generationer:
Generation 1: Regelbaserad (Tabula, Camelot, pdfplumber)
Dessa fungerar bäst på strukturerade, textbaserade PDF:er med konsekventa layouter. De är kraftfulla i händerna på utvecklare, men sköra när layouter varierar. Om dina dokument är förutsägbara är de fortfarande utmärkta — och gratis.
Generation 2: Mallbaserad (Parseur, Docparser, Parsio)
Användare definierar zoner eller fält per dokumenttyp. Perfekt för återkommande format som fakturor från samma leverantör. Nackdelen: varje ny layout eller layoutförändring kräver uppsättning eller underhåll.
Generation 3: AI-/LLM-driven (Thunderbit, Nanonets, AWS Textract, Docling för LLM-pipelines)
AI läser dokumentet semantiskt, anpassar sig till nya layouter utan mallar och kan samtidigt märka upp och omvandla data. Det är hit marknaden är på väg. Everest Groups IDP-bedömning för 2025 och ACL:s multimodala tabellforskning från 2025 pekar båda mot LLM- och agentbaserad extraktion som nästa standard.
För icke-tekniska användare spelar detta stor praktisk roll: om dina PDF:er kommer från många olika källor (leverantörer, partners, kunder) blir mallbaserade verktyg en underhållsbörda. AI-drivna verktyg hanterar variation direkt. Det är den nischen Thunderbit byggdes för — företagsanvändare som har många olika PDF:er och noll intresse av att skriva Python eller underhålla extraktionsmallar.
AI PDF-utvinning för varierande layouter En enda schema behöver inte passa alla leverantörer — AI:n läser varje dokument och räknar ut strukturen själv. Get Started Free
Prisgenomgång: vad de bästa PDF Scrapers faktiskt kostar
Det här är jämförelsen ingen annan publicerar, och den som användare frågar mest om. Här är den ärliga bilden:
| Verktyg | Gratisnivå | Startpris för betald plan | Est. kostnad per 1 000 sidor | Open source? |
|---|---|---|---|---|
| Thunderbit | ✅ Gratis krediter | ~$15/mån ($9/mån årligen) | ~$18–$30 | Nej |
| Tabula | ✅ Obegränsad | Gratis för alltid | $0 | Ja |
| Camelot | ✅ Obegränsad | Gratis för alltid | $0 | Ja |
| PyMuPDF | ✅ Obegränsad | Gratis för alltid | $0 | Ja |
| pdfplumber | ✅ Obegränsad | Gratis för alltid | $0 | Ja |
| Docling | ✅ Obegränsad | Gratis för alltid | $0 | Ja |
| Parseur | ⚠️ ~20 sidor/mån | ~$39/mån | ~$390 (lägsta nivå) | Nej |
| Nanonets | ⚠️ Krediter vid registrering | Användningsbaserat | ~$300–$380 | Nej |
| Docparser | ⚠️ 14 dagars test | $39/mån | ~$78–$390 | Nej |
| Parsio | ⚠️ 30 krediter | $41/mån | ~$41–$205 | Nej |
| Adobe Acrobat | ❌ (export är betald) | $19.99/mån Pro | Inte sidmätt | Nej |
| AWS Textract | ⚠️ 1 000 sidor/mån (3 månader) | Pay-per-use | $1.50–$65 | Nej |
Den dolda kostnadsavvägningen spelar större roll än listpriset. Open source-Pythonverktyg är gratis i dollar, men de kostar utvecklartid att sätta upp, underhålla och felsöka. Mallbaserade SaaS-verktyg är enkla vid låg variation, men dyra när layouter förändras. AI no-code-verktyg som Thunderbit kostar krediter per rad, men minskar uppsättningstiden drastiskt. Moln-API:er som AWS Textract är billigast i skala — men bara när du redan har teknisk kompetens på plats.
När jag tänker på “verklig kostnad” räknar jag också in lönen för personen som gör jobbet. En timme av en dataanalytikers tid som går åt till att konfigurera mallar eller skriva Python är inte gratis, även om mjukvaran är det.
Vilken PDF Scraper ska du välja?
Här är en snabb beslutsguide:
| Din situation | Rekommenderat verktyg |
|---|---|
| Icke-teknisk, varierande PDF-layouter, vill ha snabba resultat | Thunderbit, Nanonets |
| Återkommande fakturor/kvitton i samma format | Parseur, Docparser, Parsio |
| Utvecklare som bygger en datapipeline | PyMuPDF, Camelot, pdfplumber |
| Företag, 10 000+ dokument/månad, behöver API | AWS Textract, Nanonets |
| Bygger LLM/RAG-applikation | Docling |
| Tillfällig PDF-till-Excel, har redan Adobe | Adobe Acrobat |
| Gratis, lokalt, tabellfokuserat, utan kod | Tabula |
Om du är en företagsanvändare som bara vill få ut data ur PDF:er utan att skriva kod eller sätta upp mallar, börja med Thunderbit. Det läser varje PDF på nytt med AI och exporterar till verktygen du redan använder. Om dina dokument upprepas i igenkännbara layouter passar Parseur eller Docparser bättre. Och om du vill ha teknisk kontroll är open source-stacken fortfarande kostnadsbotten.
Avslutning
PDF scraping 2026 är inte längre ett enda problem med ett enda svar. Rätt verktyg beror på om du är utvecklare, affärsanalytiker eller ett företagsteam — och om dina PDF:er är prydliga textfiler eller kaotiska skannade bilder från ett dussin leverantörer.
Om du vill se hur AI-driven PDF-utvinning fungerar i praktiken kan du prova Thunderbits gratisnivå. Jag tror att du blir förvånad över hur mycket du kan få ut ur en PDF med bara några klick. Och om Thunderbit inte är den perfekta matchningen, testa några andra på listan. Det har aldrig funnits en bättre tid att sluta kopiera och klistra från PDF:er och i stället faktiskt använda datan i dem.
För mer om datautvinning och automation, kolla in våra guider om att extrahera data från webbplatser till Excel, bästa verktygen för datautvinning, AI-driven datautvinning för företag och hur man konverterar bilder till Excel. Du kan också se steg-för-steg-genomgångar på Thunderbit YouTube-kanal.
Testa Thunderbit gratis Tabeller, OCR och rapporter i blandade format i ett enda pass. Gratisplanen räcker för att testa om den klarar dina dokument. Get Started Free
Vanliga frågor
1. Vad är den bästa gratis PDF scraper:n?
För icke-utvecklare är Tabula det enklaste helt gratis GUI-verktyget för textbaserade PDF-tabeller. För utvecklare är Camelot, pdfplumber, PyMuPDF och Docling alla starka gratisval. För ett no-code-alternativ med gratisnivå är Thunderbit den bästa startpunkten.
2. Kan PDF scrapers hantera skannade dokument?
Endast verktyg med inbyggd OCR kan hantera skannade PDF:er direkt. Det inkluderar Thunderbit, Adobe Acrobat, AWS Textract, Nanonets, Parseur, Docparser, Parsio och Docling (med integrerade OCR-motorer). Tabula, Camelot och pdfplumber kan inte hantera skannade PDF:er på egen hand — de kräver extern OCR som Tesseract.
3. Hur exakt är tabellutvinning från PDF:er?
Det beror mycket på tabellens komplexitet. De flesta verktyg hanterar enkla tabeller med ramar bra. Tabeller utan ramar, sammanslagna celler och flersidiga tabeller är betydligt svårare. AI-drivna verktyg som Thunderbit, Nanonets och AWS Textract tenderar att överträffa regelbaserade parser på varierande layouter, medan regelbaserade verktyg fortfarande kan vara utmärkta på stabila, textbaserade PDF:er.
4. Behöver jag kunna koda för att extrahera data ur PDF:er?
Nej. Verktyg som Thunderbit, Parseur, Docparser, Parsio, Nanonets och Adobe Acrobat kan användas utan kod. Tabula har också ett GUI. Pythonbibliotek som PyMuPDF, Camelot, pdfplumber och Docling kräver kod.
5. Kan jag exportera PDF-data direkt till Excel eller Google Sheets?
De flesta verktyg stöder export till CSV eller Excel som minimum. Thunderbit exporterar också direkt till Google Sheets, Airtable och Notion gratis. Parseur, Docparser och Parsio stöder export till affärsflöden via integrationer som Zapier, webhooks och API:er.
Testa AI PDF-extraktion med Thunderbit Get Started Free
Läs mer



