
Förra månaden började en väns Stripe-integration plötsligt returnera 503:or klockan 23 på en fredag. Ingen märkte något förrän på lördagsmorgonen — då supportinkorgen hade fyllts med över 200 arga mejl från kunder vars köp inte gick igenom.
Den typen av berättelse är långt ifrån ovanlig. En ofta citerad benchmark uppskattar genomsnittlig driftstoppkostnad till 5 600 dollar per minut, medan allvarliga avbrott kan kosta miljontals dollar per timme. Den exakta siffran beror på trafik, konverteringsgrad, ordervärde, SLA-exponering och kostnaden för återställning — men riktningen är tydlig: oövervakade API:er är en affärsrisk, inte bara ett irritationsmoment för utvecklingsteamet. Och med organisationer som nu i genomsnitt använder 131 tredjeparts-API:er och endast 16 % som uppger att de har hög förmåga att minska risken från tredjeparts-API:er, är övervakning inte längre valfritt. Det jag ville göra med den här guiden var något jag inte sett någon annanstans: strukturera verktyg efter ditt användningsområde, utvärdera larmkvalitet (inte bara om larm finns), visa faktisk prissättning för 2026 och mäta hur snabbt du faktiskt kan komma igång. Inte ännu en enkel logolista.
En sak till: om ditt API-arbete handlar om att samla in webdata, mata LLM:er, bygga RAG-system, övervaka konkurrenters sidor eller extrahera pris- och produktdata från webbplatser, bör samtalet om ”API-verktyg” inte sluta vid uptime-övervakning. Du behöver också ett pålitligt sätt att förvandla röriga webbsidor till strukturerad data. Där passar Thunderbit Open API in i den här guiden: det är inte en uptime-monitor, men det är ett av de snabbaste sätten att göra om webbplatser till ren Markdown eller schemabaserad JSON via ett API.
Vad är API-övervakning (och varför ska teamet bry sig)?
API-övervakning innebär att man kontinuerligt kontrollerar att API-endpoints är tillgängliga, snabba och returnerar rätt data. Inte bara ”är servern uppe?” — en bra monitor validerar HTTP-statuskoder, svarspayload, latens, SSL-certifikat, flerstegsflöden (som login → sök → checkout) och till och med att schemat stämmer.
Det skiljer sig från generell webbplatsövervakning (som kontrollerar om en sida laddas) och från APM (Application Performance Monitoring), som går djupare in i kodnivåns traces, databasfrågor och interna runtime-detaljer. API-övervakning ligger i gränslandet: den testar det som användare, partners och integrationer faktiskt upplever när de anropar era endpoints.
Det finns också en närliggande kategori som är värd att nämna: web data APIs. De övervakar inte om ditt eget API mår bra; de hjälper din produkt eller ditt arbetsflöde att samla in extern webdata på ett tillförlitligt sätt. Till exempel kan Thunderbit Open API göra om en webbsida till ren Markdown, extrahera strukturerade fält som JSON och köra batchjobb över många URL:er. Om ditt ”API”-projekt är beroende av färska leverantörsdata, produktsidor, offentliga listningar, dokumentsidor eller forskningskällor, kan den typen av datakälla-API vara lika driftkritiskt som själva uptime-kontrollerna.
Varför ska icke-utvecklare bry sig? För att API:er står för 71 % av den dynamiska webbtrafiken och 62 % av API-proffs säger att API:er direkt genererar intäkter. När en betalningsgateway, autentiseringstjänst eller frakt-API fallerar är det inte ett abstrakt infrastrukturproblem — det är förlorade intäkter, trasiga partneravtal, fler supportärenden och urholkat förtroende. Produktchefer, sälj, drift och kundteam har alla ett intresse här.
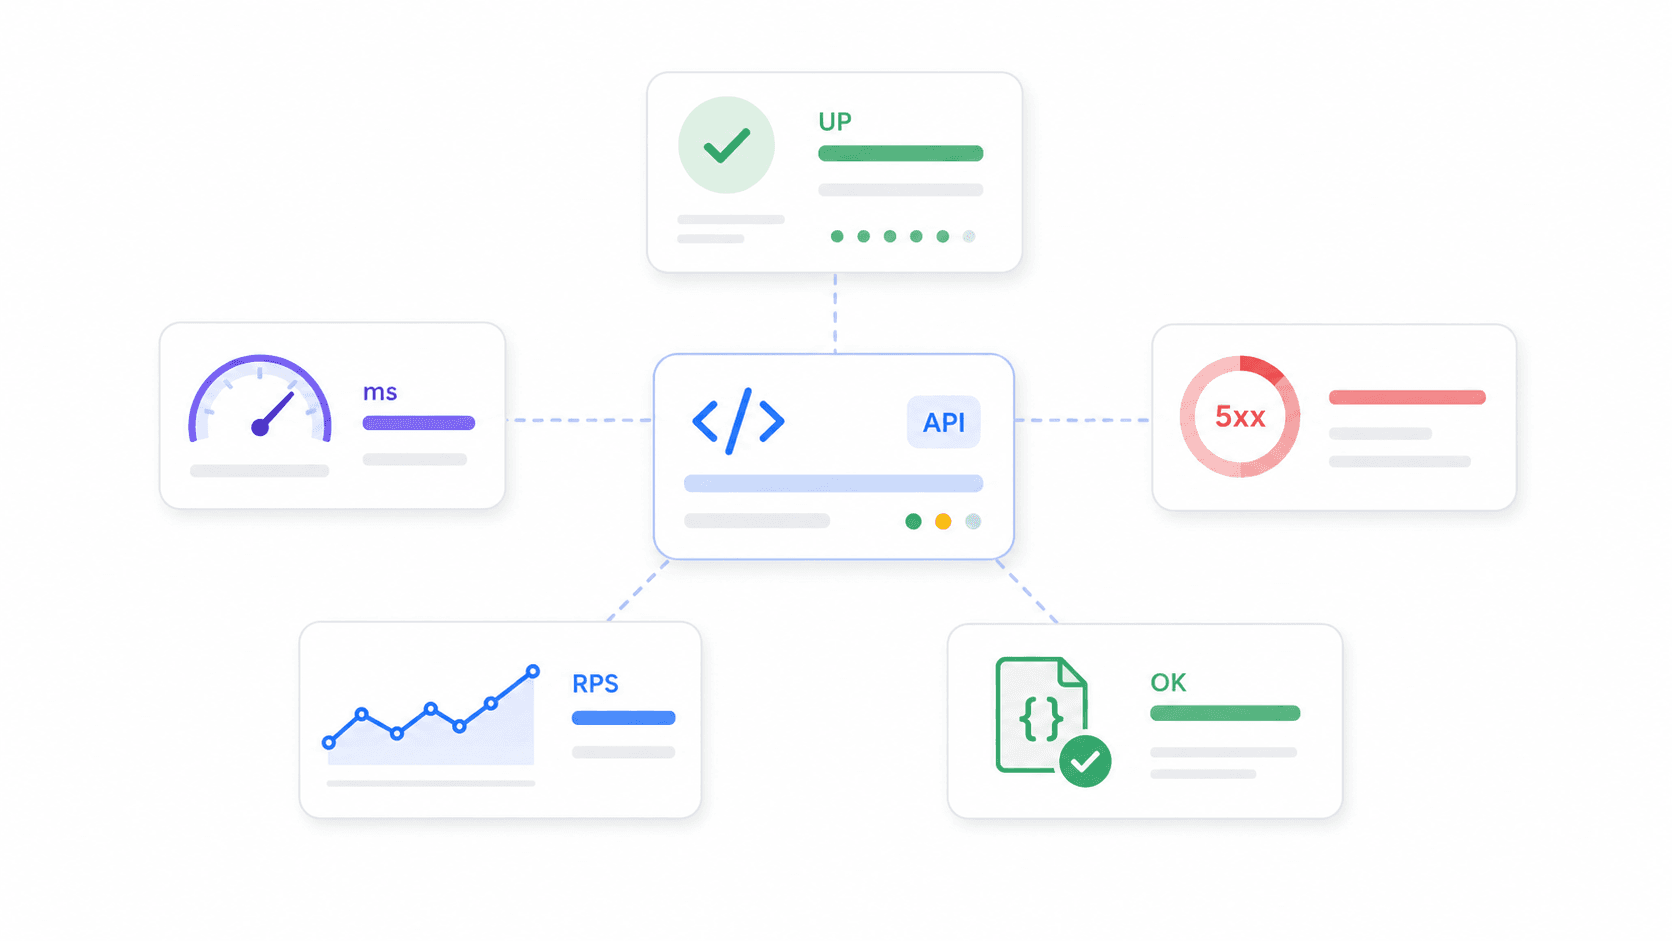
Nyckelmått att hålla koll på:
- Uptime-procent: andelen tid en endpoint är tillgänglig
- Svarstid / latens: hur lång tid endpointen tar att svara (snitt, p95, p99)
- Felfrekvens: andelen förfrågningar som returnerar 5xx, timeouts eller assertion-fel
- Genomströmning: antal förfrågningar per sekund/minut
- Korrekthet: om API:t returnerar förväntad data, inte bara 200 OK
Så utvärderade vi de bästa verktygen för API-övervakning 2026
De flesta artiklar om ”bästa API-övervakningsverktygen” radar bara upp leverantörsnamn och funktioner. Jag ville vara mer metodisk i urvalet — dels för att jag ägnat mycket tid åt att läsa utvecklarforum, dels för att Thunderbit-teamet hjälpte mig att extrahera priser och funktionsdata i bulk från leverantörernas webbplatser för att bygga en riktig jämförelse (mer om det arbetsflödet senare).
Det här vägde vi in:
| Kriterium | Varför det är viktigt |
|---|---|
| Enkel installation / tid till första larm | Små team behöver täckning idag, inte efter ett plattformsprojekt |
| Larmintelligens & brusreducering | Om larmen är stökiga slutar teamet lyssna och missar riktiga incidenter |
| Generös gratisnivå | Sidoprojekt och tidiga startups börjar ofta gratis |
| Pristransparens | Observability-kostnader kan dra iväg via hosts, användare, loggar, syntetiska körningar och datainhämtning |
| Integrationsbredd | Larm måste landa där teamen redan jobbar (Slack, PagerDuty osv.) |
| Skalbarhet & datadjup | Mogna team behöver traces, loggar, APM, RBAC, SSO och retention |
| Community & supportkvalitet | Öppen källkod kräver bra release-takt; enterprise kräver SLA:er |
| Förmåga att extrahera webdata | AI-appar, RAG-flöden och marknadsanalysverktyg behöver ofta ren extern data, inte bara endpoint-uptime |
Vi segmenterade också rekommendationerna efter användningsfall — solo-utvecklare, startup, e-handel/SaaS, enterprise, open-source-purist, API-produktteam och team för webdata/AI-appar — så att du kan hoppa direkt till din situation i stället för att läsa 14 verktygsbeskrivningar och gissa vilket som passar. Grafanas undersökning från 2025 visade att 46 % av respondenterna nämnde interoperabilitet och 35 % nämnde hur lätt det är att byta i framtiden som urvalskriterier, vilket bekräftar att det här inte bara är ”trevliga att ha”-faktorer.
Bästa API-övervakningsverktygen per användningsfall: Snabbvalstabellen
Det här är genvägen. Hitta din rad och hoppa sedan vidare till verktygsavsnitten längre ner för hela genomgången.
| Användningsfall | Rekommenderade verktyg | Det som skiljer dem åt |
|---|---|---|
| Webdata / AI-appteam | Thunderbit Open API, Moesif, Apitally | Gör om webbplatser till ren Markdown eller strukturerad JSON för LLM:er, RAG, prisbevakning och researchflöden |
| Solo-utvecklare / sidoprojekt | UptimeRobot, Uptime Kuma, Gatus | Gratis eller self-hosted, minimal konfiguration, snabb start |
| Startup (team på 5–15 personer) | Checkly, Better Stack, Postman | Smart larmhantering, snabb start, prisvärt, status-sidor |
| E-handel / SaaS | Datadog, New Relic, Moesif, Checkly | Affärsmått, APM/tracing, djupa SDK:er, flerstegs-synthetics |
| Enterprise / multi-cloud | Datadog, New Relic, Splunk, Grafana Cloud | Distribuerad tracing, compliance, hybridmiljöer, RBAC/SSO |
| Open-source-purister | Prometheus + Grafana, Uptime Kuma, Gatus, Uptrace | Full kontroll, OTel-native, inget vendor lock-in |
| API-produktteam | Moesif, Apitally, New Relic | Kundspecifik användning, endpoint-trender, avvikelselarm |
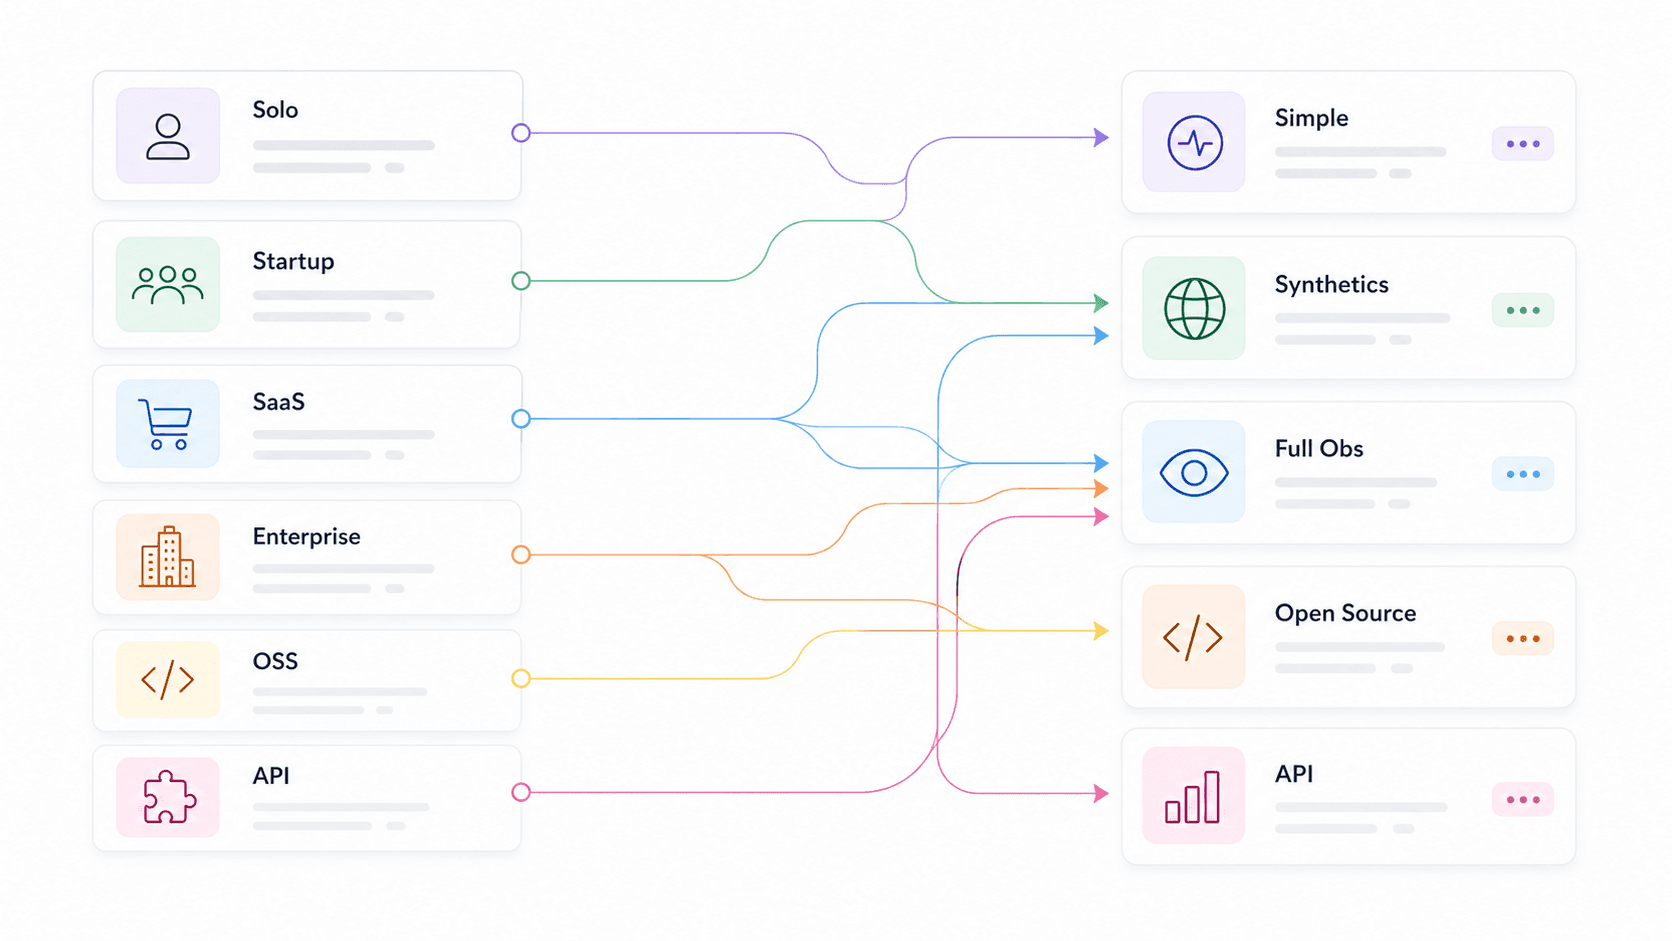
Det tydligaste mönstret: verktyg som är snabbast att komma igång med brukar ha svagare analysdjup, medan de mest avancerade plattformarna kräver mer konfiguration och kostnadsdisciplin. Det är inte en brist — det är en avvägning man måste känna till. Thunderbit ligger lite vid sidan av den här skalan: det är som snabbast när uppgiften är att göra om webbsidor till API-redo data, inte att pinga ingenjörer när något ligger nere.
Thunderbit Open API: Bäst för att göra om webbplatser till strukturerad API-data
Kom igång med Thunderbit Open API Gör om sidor till Markdown, extrahera strukturerad JSON och batchbearbeta URL:er utan att underhålla egen scraping-infrastruktur. Get Started Free
Thunderbit Open API är det API jag skulle sätta först för team vars ”övervakning” eller researchflöde är beroende av extern webdata. Det är inte ett traditionellt uptime-verktyg som Checkly eller UptimeRobot. I stället gör Thunderbit om vilken webbsida som helst till ren, strukturerad data som appar, agenter, dashboards och LLM-pipelines faktiskt kan använda.
API:t har tre kärnflöden. Distill omvandlar en sida till ren Markdown, anpassad för LLM:er. Extract tar ett schema och returnerar strukturerade JSON-fält som produktnamn, pris, tillgänglighet, företagsstorlek, finansieringsstadie eller betyg. Batch låter dig bearbeta upp till 100 URL:er asynkront med webhooks, vilket är användbart när du övervakar prissidor, konkurrentkataloger, leverantörsdokumentation, nyhetskällor eller stora researchlistor.
Anledningen att det hör hemma i en guide om API-verktyg är att team ofta underskattar hur mycket infrastruktur som krävs för ”bara skrapa den här sidan”. JavaScript-tunga sajter behöver rendering. Vissa sidor kräver georouting. HTML måste rensas från navigering, annonser, modaler och standardtext innan den blir användbar för en LLM. Selektorer går sönder när layouter ändras. Proxyrotation, anti-bot-hantering, retries, köhantering och polling av resultat kan göra ett litet dataflöde till ett underhållsprojekt. Thunderbit absorberar mycket av det arbetet bakom ett enda API.
Bäst för: Byggare av AI-appar, RAG-team, e-handelsdrift, sales ops, growth-team, marknadsanalytiker och utvecklare som behöver webdata via ett API utan att själva bygga och bevaka en scraping-stack.
Prissättning: Gratis: 600 engångs-API-enheter, inklusive upp till 600 Distill-sidor eller 30 Extract-sidor, med 2 samtidiga förfrågningar. Starter listas till 16 dollar/månad vid årsbetalning för 60 000 API-enheter/år och 30 samtidiga förfrågningar. Pro listas till 40 dollar/månad vid årsbetalning för 600 000 API-enheter/år och 50 samtidiga förfrågningar.
Installationshastighet: cirka 5–15 minuter för att få en API-nyckel och köra en första Distill- eller Extract-förfrågan med cURL, SDK:er eller Thunderbit CLI.
Nackdelar: Thunderbit ersätter inte Datadog, New Relic, Better Stack eller Checkly för uptime-kontroller, incidenteskalering, traces, loggar eller on-call-routing. Se det som API:t du använder för att samla in och strukturera webdata — inklusive leverantörspriser, dokumentation, konkurrentsidor, produktlistningar eller offentliga dataset — inte systemet som väcker din jourhavande ingenjör.
Datadog: Bäst för fullständig insyn i hela stacken
Datadog är det verktyg jag oftast ser i enterprise- och mid-market-SaaS-stackar, och det av goda skäl. Det är inte bara API-övervakning — det är en full observability-plattform som kopplar ihop syntetiska API-tester med distribuerade traces, loggar, infrastrukturmätningar och real user monitoring i en och samma vy.
För API-övervakning stöder Datadog HTTP, SSL, DNS, WebSocket, TCP, UDP, ICMP, gRPC och flerstegs-API-tester. Dess anomaly detection-monitors lär sig förväntade mönster och larmar vid avvikelser i stället för statiska trösklar — ett rejält steg upp från ”varna när latensen > 500 ms”. Det finns också forecast-monitors som förutspår när en metric kommer att passera en gräns, samt composite-monitors som kombinerar flera villkor.
Bäst för: E-handel, SaaS och enterprise-team som vill ha en enda överblick över API:er, infrastruktur, loggar och traces.
Prissättning: Gratisnivåns detaljer varierar per produkt. Infrastructure Pro börjar på 15 dollar/host/månad; API-syntetiska tester kostar 5 dollar per 10 000 körningar. Över 800 integrationer.
Installationshastighet: cirka 15–30 minuter för agentinstallation plus ett grundläggande syntetiskt test.
Nackdelar: Kan bli dyrt i stor skala — ”bill shock” är ett återkommande tema på Hacker News och Reddit. Det stora antalet priskomponenter (hosts, loggar, custom metrics, synthetics, användare) gör att någon måste hålla koll på fakturan, inte bara instrumentpanelen. Lärandetröskeln är också hög för hela plattformen.
Checkly: Bäst för utvecklarvänliga syntetiska checks
Checkly är verktyget jag skulle ge till ett startup-team som vill ha API-checks nära sin kod. Kärnidén är ”monitoring as code”: definiera API- och browser-checks programatiskt, kör dem från globala platser, integrera med CI/CD-pipelines och hantera allt via Git.
Larmkvaliteten är stark här. Checklys retry-logik beskrivs uttryckligen som ”första försvarslinjen” mot falska positiva — du kan konfigurera fasta, linjära eller exponentiella retries, retries från samma eller annan plats och maxlängd på retry innan larm utlöses. Det skiljer också mellan degraded, failed och recovered, vilket hjälper till att minska brusiga larm.
Bäst för: Startups och utvecklingsteam som vill ha programmerbara API-checks, Playwright-baserade browser-checks, CI/CD-integration och snabb uppstart.
Prissättning: Senaste publika data visar en gratisplan med 10 uptime-monitors, 1 000 browser checks och 10 000 API checks. Starter ligger runt 24 dollar/månad vid årsbetalning — kontrollera den officiella prissidan innan köp.
Installationshastighet: cirka 10–20 minuter för en första API-check och en larmkanal.
Nackdelar: Fokuserar på syntetiska checks. Ersätter inte djup APM, logganalys eller distribuerad tracing. Om du behöver koppla ett API-fel till en flaskhals i databasen, behöver du ett annat verktyg vid sidan av.
UptimeRobot: Bäst för enkel och prisvärd uptime-övervakning
UptimeRobot är Honda Civicen bland API-övervakningsverktyg. Det gör en sak bra: du skapar en HTTP-, keyword-, ping-, port-, SSL- eller heartbeat-monitor, väljer intervall och får larm när den faller. Punkt.
Bäst för: Solo-utvecklare, små team, byråer eller alla som behöver grundläggande uptime- och latensspårning utan onödig komplexitet.
Prissättning: Gratis: 50 monitors, 5-minutersintervall. Betald Solo börjar runt 7 dollar/månad vid årsbetalning. Inget kreditkort krävs för gratisnivån. Installationshastighet: cirka 2–5 minuter — snabbast i den här listan.
Nackdelar: Begränsad larmintelligens. Enkla tröskellarm, ingen anomalidetektion, ingen distribuerad tracing, ingen djup analys. Om du behöver veta varför en endpoint är långsam (inte bara att den är långsam), hjälper inte UptimeRobot dig hela vägen.
Uptime Kuma: Bästa gratis, self-hostade verktyget för API-övervakning
Uptime Kuma är älsklingen i self-hosting-communityn, och GitHub-siffrorna bekräftar det: 86 637 stjärnor, 7 831 forks, 1 060 contributors, och version 2.3.2 per maj 2026. Det är MIT-licensierat, stöder HTTP(s), keyword, JSON query, WebSocket, TCP, ping, DNS, push, Docker, flera statussidor och över 90 notifieringstjänster.
Bäst för: Solo-utvecklare och team som vill ha full kontroll, integritet och noll löpande SaaS-kostnad — om ni har en server.
Prissättning: Gratis. Den verkliga kostnaden är er VM/container, backup, uppdateringar och att se till att själva monitorn hålls uppe. Installationshastighet: cirka 5–15 minuter med Docker för en grundläggande check; 15–30 minuter med notifieringar och snygg status-sida.
Nackdelar: Ni äger underhållet. Och här är den viktiga fallgropen: om ni kör Uptime Kuma på samma infrastruktur som ni övervakar, slår ett moln- eller DNS-avbrott ut både appen och monitorn. Host den externt eller kombinera med en SaaS-check.
Better Stack: Bäst för snabb incidenthantering
Better Stack (ofta fortfarande kallat Better Uptime av användare) kombinerar uptime-övervakning med incidenthantering, on-call-schemaläggning, eskaleringspolicyer och statussidor i en enda plattform. Det är starkast inte som analysverktyg, utan som ett incidentflöde ovanpå övervakning.
Eskaleringspolicyer definierar vem som får larm, i vilken ordning och med vilka fördröjningar tills någon bekräftar. Metadata-baserad routning skickar incidenter efter allvarlighetsgrad eller ansvar. Det integrerar med Slack, Teams, webhooks och Zapier.
Bäst för: Startups och medelstora team som vill ha övervakning + incidentrespons + statussidor utan att pussla ihop tre olika verktyg.
Prissättning: Gratisnivå: 10 monitors/heartbeats, 1 statussida. Team börjar runt 29 dollar/månad vid årsbetalning. Installationshastighet: cirka 5–10 minuter via GUI-guide.
Nackdelar: Mindre djup i analys av API-payloads, distribuerad tracing eller affärskritiska KPI:er jämfört med Datadog, New Relic eller Moesif.
Prometheus + Grafana: Bästa open-source-stack för API-övervakning
Det här är den branschstandardiserade open-source-kombon. Prometheus samlar in och lagrar tidsseriemått. Grafana (73 705 GitHub-stjärnor, 3 010 contributors) levererar dashboards och larm. Alertmanager hanterar routning, gruppering, deduplicering, silencing och inhibition. För API-endpoint-checks lägger team till Blackbox Exporter för HTTP-, HTTPS-, DNS-, TCP-, ICMP- och gRPC-probing.
Bäst för: Open-source-purister, Kubernetes-/SRE-team och organisationer som redan standardiserat på Prometheus-mått.
Prissättning: Gratis self-hosted. Grafana Cloud har en gratisnivå (100 000 API-testkörningar/månad) och betalda planer baserade på användning.
Installationshastighet: 1–4 timmar för en grundläggande Blackbox + Prometheus + Grafana + Alertmanager-installation. Dagar för produktionsklar HA och finjusterade larm.
Nackdelar: PromQL, YAML, relabeling, dashboarddesign, retention, lagring, HA och larmtuning är verkligt operativt arbete. Den återkommande avvägningen är ”mindre UI, mer YAML”. Det här är stacken för team som redan tänker i metrics och vill ha ett kontrollplan — inte för team som vill ha övervakning i drift innan lunch.
New Relic: Bäst för SaaS-applikationers prestanda
New Relic kombinerar APM, infrastrukturövervakning, loggar, distribuerad tracing, syntetisk övervakning, larm, dashboards och AI-assisterad incidentanalys. Gratisnivån — 100 GB/månad datainhämtning och 1 fullständig plattanvändare — är faktiskt generös för små team.
Det är inom larmintelligens New Relic verkligen glänser i diskussionen om larmtrötthet. Dess incident intelligence omfattar eventkorrelation, anomalidetektion, prediktiva larm, root cause-analys och undertryckning av fladdrande larm. New Relic har publicerat ett exempel där 97,2 % effektivitet i flapping innebär endast 28 synliga problem per 1 000 flappande incidenter — en konkret siffra för brusreducering.
Bäst för: SaaS-team och e-handelsplattformar som vill att API-övervakning ska vara tätt integrerad med applikationsnivåns traces, fel, genomströmning och användarpåverkan.
Prissättning: Gratis: 100 GB/månad, 1 full användare. Betalda planer använder per-användare- och databasera prissättning.
Installationshastighet: cirka 15–30 minuter för agentinstallation och guidad setup.
Nackdelar: Prissättningen kan bli komplex i stor skala. Larmkonfigurationen har en inlärningskurva — plattformen är kraftfull men inte självklar direkt.
Moesif: Bäst för API-analys och affärsmått
Moesif är inte en traditionell uptime-monitor. Det är API-analys och produktintelligens: att förstå API-användning per kund, endpoint, kohort, företag, geografi, SDK, plan och beteende. Om din fråga är ”vilken kund påverkas?” snarare än ”är endpointen uppe?”, är Moesif byggt för det.
Det stöder statiska tröskellarm och dynamiska anomalilarm för API-mått som trafiktoppar/-fall, latens och beteendeförändringar. De dynamiska larmen behöver några dagars API-beteende för att bygga en modell, men när de väl är tränade fångar de förändringar som statiska regler missar.
Bäst för: API-produktteam, SaaS-bolag och e-handelsplattformar som behöver koppla API-prestanda till intäkter, engagemang och retention.
Prissättning: Gratis/testperiod finns; betalda planer skalar med mängden API-händelser. Självbetjäningspriser i dollar var inte fullt ut möjliga att hämta i min research — kontrollera aktuell sida.
Installationshastighet: cirka 20–45 minuter (SDK/proxy/gateway-integration är djupare än en extern ping).
Nackdelar: Mer fokuserat på analys än klassisk uptime-övervakning. Du vill sannolikt kombinera Moesif med Checkly, UptimeRobot eller Datadog synthetics för externa tillgänglighetskontroller.
Splunk: Bäst för enterprise-logganalys och compliance
Splunk är verktyget du tar fram när logginsamling, sökning, korrelation, revisionsbar compliance och stöd för hybrid-/multi-cloud är helt avgörande. Splunk Observability Cloud täcker infrastruktur, APM, synthetics, real user monitoring, loggar och incidentrespons. ITSI/Event Analytics kan gruppera viktiga händelser till episoder och minska brus mellan övervakningssilor.
Splunks egen observability-forskning från 2025 är rätt nedslående: 73 % av respondenter inom ITOps/engineering rapporterade avbrott på grund av ignorerade eller undertryckta larm, 59 % kämpade med för många olika verktyg, och 52 % hade problem med falska larm.
Bäst för: Enterprise- och multi-cloud-team med hårda krav på compliance, säkerhet, revision och logsökning.
Prissättning: Användningsbaserad och offertstyrd. Ingen enkel gratisnivå för produktion.
Installationshastighet: Moln-onboarding kan gå snabbare, men enterprise-implementation tar ofta dagar till veckor.
Nackdelar: Dyrt i stor skala. Komplex installation. Överdrivet för solo-utvecklare och små startups.
Postman: Bäst för team som redan testar API:er
Postman är främst en plattform för API-utveckling och testning, men dess monitoring-produkt låter team schemalägga Postman-collections och köra dem från molnplatser. Det starkaste argumentet är återanvändning: om ert QA- eller dev-team redan har Postman-collections med assertioner är det ett naturligt nästa steg att göra dem till monitorer.
Bäst för: Utvecklings- och QA-team som redan använder Postman-collections och vill ha schemalagda checks utan att köpa ett separat syntetiskt verktyg.
Prissättning: Gratisnivå finns. Överskridande övervakning kostar 0,75 dollar per 1 000 anrop; tilläggspaket med 50 000 anrop kostar 20 dollar/månad. Kontrollera nuvarande plansida — Postmans paket förändras över tid.
Installationshastighet: cirka 10 minuter om collections redan finns.
Nackdelar: Övervakningsfunktionerna är lättare än hos dedikerade verktyg som Checkly, Datadog eller New Relic. Larmalternativen är grundläggande.
Andra API-övervakningsverktyg värda att titta på
Gatus: Lättviktig, self-hosted, konfigurationsdriven hälsodashboard. 10 906 GitHub-stjärnor, stöder HTTP, ICMP, TCP, DNS, Prometheus-vänliga metrics och uptime-badges. Perfekt för solo-utvecklare som vill ha något enklare än Prometheus men föredrar YAML/config-as-code framför Uptime Kumas UI.
Apitally: Ett nyare verktyg med fokus på API-trafikanalys och kvalitetsuppföljning för startups. Påstår sig ha setup på under 5 minuter med anpassade larm över 14 mätvärden. Bra för lättviktig API-analys utan att ta steget till en full observability-plattform.
Sematext: Full-stack-övervakning med loggar, synthetics och insyn i infrastrukturen. Synthetics runt 2 dollar per HTTP-monitor, 7 dollar per browser-monitor, 5 dollar/månad i lägsta avgift. Ett billigare alternativ till Datadog för mid-market-team.
Uptrace: OpenTelemetry-native backend för APM, tracing, metrics och loggar. 4 198 GitHub-stjärnor. Inte en ren uptime-checker, men idealisk för team som standardiserar på OTel och vill ha en open-source-vänlig tracing-backend.
Bygga själv eller köpa: Ska du rulla din egen API-övervakning?
”Ska jag bara skriva ett skript som pingar mina endpoints, eller använda ett dedikerat verktyg?”
Den frågan dyker upp hela tiden i utvecklarforum. Jag har läst tillräckligt många Reddit-trådar för att se mönstret tydligt: team börjar med curl + cron, det fungerar ganska bra ett tag, och sedan byter de när de behöver dashboards, historik, multi-region-checks, tillförlitlig larmroutning eller insyn mellan team.
En ärlig beslutsmatris:
| Faktor | Eget skript | Specialiserat verktyg |
|---|---|---|
| Installationstid | 1–4 timmar (grundläggande); dagar (robust) | 5–30 minuter |
| Underhåll | Du äger det för alltid | Leverantören sköter uppdateringar |
| Larmkvalitet | Grundläggande (uppe/nere) | Smart (latens-trender, anomalier, retries) |
| Kostnad | Gratis (din tid) | 0–500+ dollar/mån |
| Dashboard | Byggs från grunden | Färdig, anpassningsbar |
| Bäst när… | ≤3 endpoints, utvecklingstungt team, hobbyprojekt | 5+ endpoints, drift-/produktteam, intäkter står på spel |
Det viktigaste från forumen: de som bygger själva ångrar det ofta när de behöver dashboards, historisk data eller insyn mellan team. Och så finns meta-problemet — ”du behöver övervakning på din övervakning.” En self-hosted monitor, databas, backup, nätverksväg och larmleverantör måste också vara tillförlitliga.
Bygg själv om du har 2 endpoints och gillar att skruva. Köp om du har en produkt att leverera.
Samma logik gäller för web data extraction. Du kan skriva en scraper, köra headless browsers, rotera proxies, underhålla selektorer, städa HTML och bygga en kö. Men om jobbet är att pålitligt mata webdata till en API-produkt, AI-agent eller research-workflow går det oftast snabbare att använda Thunderbit Open API än att bygga egen scraping-infrastruktur.
Larmtrötthet: Därför slår larmkvalitet larmmängd
Det här är kanske det mest underskattade kriteriet när man väljer ett API-övervakningsverktyg. Larmtrötthet uppstår när team får så många brusiga, duplicerade eller icke-åtgärdbara larm att de börjar ignorera alla — och sedan missar riktiga incidenter.
Siffrorna är slående. BigPandas rapport från 2025 visade att medianorganisationen genererade 2 350 larm per dag och 803 406 larm per år. Medianens incident-actionability var bara 18 % — vilket betyder att färre än ett av fem larmbaserade incidenter faktiskt gick att agera på. NeuBirds undersökning från 2026 visade att 77 % av on-call-team får minst 10 larm per dag och 80 % säger att hälften eller färre av dessa är åtgärdbara.
Det bästa övervakningsverktyget är det vars larm du faktiskt litar på. Så här hanterar verktygen larmintelligens:
| Verktyg | Larntyp | Metod för brusreducering | Larmkanaler |
|---|---|---|---|
| Datadog | ML-anomali, prognos, komposit | Historiska anomaliband, dynamiska baslinjer, Watchdog AI | Slack, PagerDuty, Opsgenie, Teams, 20+ |
| Checkly | Tröskel + degraderingsbaserad | Retry innan utlöst larm, retries från samma/annan plats | Slack, PagerDuty, Opsgenie, Teams, incident.io |
| New Relic | AI-gruppering av problem, anomalier, prediktion | Eventkorrelation, suppression av flapping, root cause-kontekst | Slack, PagerDuty, Teams, webhooks |
| Moesif | Beteendeanomali | Dynamiska modeller efter flera dagars beteende | Slack, PagerDuty, e-post, SMS |
| Better Stack | Uptime/incident/on-call | Eskaleringspolicyer, ägarbaserad routning, fördröjningar | Slack, Teams, webhooks, Zapier |
| Prometheus + Alertmanager | PromQL-regellarm | Gruppering, deduplicering, silencing, inhibition | E-post, PagerDuty, Opsgenie, webhooks |
| Splunk | Händelser, episoder, servicehälsa | ITSI Event Analytics, episodsammanslagning, ticketing | Splunk On-Call, ServiceNow, webhooks |
| Thunderbit Open API | Ingen larmplattform | Använd med egen scheduler, workflow-verktyg eller övervakningsstack | Webhooks för batchjobb; larm hanteras externt |
Praktiskt råd: Börja med färre, mer pålitliga larm. Använd retries innan utlöst larm, bekräftelse från flera regioner, SLO burn-rate-larm, deduplicering och ägarstyrd routning. Larma på användarpåverkan och affärskritiska flöden (checkout-fel, auth-fel, betalnings-5xx), inte på varje intern symptom.
Gratisnivåer och prissättning 2026: Vad du faktiskt betalar
Prissidor ändras. Gratisnivåer skiftar. Dolda kostnader (hosts, användare, loggar, syntetiska körningar, datainhämtning) kan överraska. Det här är avsnittet jag önskar fanns i varje ”bästa verktyg”-artikel. Läget 2026:
| Verktyg | Gratisnivå | Betald från | Kreditkort krävs? | Bästa gratisanvändning |
|---|---|---|---|---|
| Thunderbit Open API | 600 engångs-API-enheter | ~16 dollar/mån vid årsbetalning | Nej | Webdata-extraktion för LLM:er, RAG, prisbevakning och research |
| Uptime Kuma | Obegränsat (self-host) | — | Nej | Full övervakning, egen server |
| UptimeRobot | 50 monitors, 5-minutersintervall | ~7 dollar/mån | Nej | Enkla uptime-kontroller |
| Better Stack | 10 monitors, 1 statussida | ~29 dollar/mån | Nej | Startup-uptime + statussida |
| Checkly | 10 uptime, 10k API-checks | ~24 dollar/mån | Ja | Syntetiska API-checks |
| Postman | Gratis konto + monitorutrymme | ~14 dollar/användare/mån | Nej | Återanvändning av befintliga collections |
| Prometheus + Grafana | Obegränsat (self-host) | — | Nej | Metrics + visualisering |
| Grafana Cloud | 100k API-testkörningar/mån | 29 dollar/mån plattform + användning | Verifiera | Hanterad synthetics-testning |
| New Relic | 100 GB/mån, 1 full användare | Per användare + data | Vissa planer | APM + grundläggande observability |
| Datadog | Test/förändras per produkt | 15 dollar/host/mån (Infra Pro) | Ofta ja | Full-stack utvärdering |
| Moesif | Gratis/test finns | Volymbaserat | Verifiera | Utvärdering av API-analys |
| Splunk | Testversioner finns | Offertbaserat | Säljprocess | Enterprise proof of concept |
| Gatus | Obegränsat (self-host) | — | Nej | YAML-driven statusdashboard |
| Apitally | Gratis/test finns | Verifiera | Verifiera | Lättviktig API-analys |
| Sematext | Test/free varierar | ~2 dollar/HTTP-monitor | Verifiera | Billigare synthetics/loggar |
| Uptrace | Gratis self-hosted | Molnnivåer varierar | Verifiera | Utvärdering av OTel APM |
Om dolda kostnader: Self-hostade verktyg (Uptime Kuma, Prometheus, Gatus) är ”gratis” i licenstermer, men en liten VM, backup, underhållstid och extern failover kan lätt bli den verkliga kostnaden. För webdata-API:er ser den dolda kostnaden annorlunda ut: underhåll av headless browsers, trasiga selektorer, proxy-pooler, anti-bot-lösningar och HTML-rensning.
Uppskattning för små team: För 10 API-endpoints och 3 teammedlemmar är den billigaste SaaS-vägen oftast UptimeRobot gratis eller låg betald nivå, Better Stack gratis/Team eller Checkly om exekveringsvolymen passar. Datadog och New Relic kan vara prisvärda för utvärdering, men den faktiska fakturan beror på hosts, användare, loggar, traces och antal syntetiska körningar. Om ditt projekt behöver webbdata som ett API räcker Thunderbits gratis API-enheter gott för att testa arbetsflödet innan du binder upp dig på en betald plan.
Komplexitetspoängkort: Hur snabbt till första larmet?
Ingen konkurrentartikel jag hittat utvärderar time-to-value — hur lång tid det tar från registrering till första meningsfulla larm. För mindre team spelar det här ofta större roll än funktionsdjup.
| Verktyg | Tid till första larm | Teknisk nivå som krävs | Konfigurationssätt |
|---|---|---|---|
| Thunderbit Open API | ~5–15 minuter | Låg–medel | API-nyckel, cURL/SDK/CLI |
| UptimeRobot | ~2–5 minuter | Låg | GUI, klicka för att lägga till |
| Better Stack | ~5–10 minuter | Låg | GUI-guide |
| Checkly | ~10–20 minuter | Låg–medel | Kod eller GUI |
| Postman | ~10 minuter (med collections) | Låg–medel | Collection-schemaläggare |
| Uptime Kuma | ~5–30 minuter | Medel | Docker + GUI |
| Gatus | ~15–45 minuter | Medel | YAML + Docker |
| Datadog | ~15–30 minuter | Medel | Agentinstallation + GUI |
| New Relic | ~15–30 minuter | Medel | Agent + guidad setup |
| Moesif | ~20–45 minuter | Medel | SDK-/proxy-integration |
| Grafana Cloud Synthetics | ~15–45 minuter | Medel | GUI, Terraform valfritt |
| Prometheus + Grafana | 1–4 timmar | Medel–hög | YAML, PromQL |
| Uptrace | 30–90 minuter | Medel–hög | OTel SDK-integration |
| Splunk | Timmar till veckor | Hög | Enterprise-onboarding |
Om övervakningen måste vara live innan arbetsdagen är slut, börja i den övre halvan av tabellen. Om målet är hållbar plattformsobservability, planera ett separat projekt för den nedre halvan. Och om ditt första mål är ”få ren data från de här 100 webbsidorna in i en app”, börja med Thunderbit innan du bygger egen scraping-infrastruktur.
Jämförelse av de bästa API-övervakningsverktygen: Full översikt sida vid sida
En tabell att skumma igenom innan du bestämmer dig:
| Verktyg | Bästa användningsfall | Gratisnivå | Larmintelligens | Installationstid | Hosting | Styrka |
|---|---|---|---|---|---|---|
| Thunderbit Open API | Webdata-extraktion/API-dataflöden | 600 API-enheter | Inte ett larmverktyg | 5–15 min | Moln | Gör om sidor till Markdown eller extraherar schemabaserad JSON |
| Datadog | Full-stack enterprise/SaaS | Test/varierar | Anomali, prognos, AI | 15–30 min | Moln | Korrelaterar synthetics med loggar/traces/infra |
| Checkly | Dev-first synthetics | Generösa check-baserade | Retries, degradering | 10–20 min | Moln | Monitoring as code + Playwright |
| UptimeRobot | Enkel uptime | 50 monitors | Enkla trösklar | 2–5 min | Moln | Snabbast billiga grundmonitor |
| Uptime Kuma | Gratis self-hosted | Obegränsat | Grundläggande status/tröskel | 5–30 min | Self-hosted | Rent gränssnitt, ingen SaaS-avgift |
| Better Stack | Incidenthantering/statussidor | 10 monitors | Eskaleringar, routning | 5–10 min | Moln | Övervakning + on-call + statussida |
| Prometheus + Grafana | Open-source metrics-stack | Obegränsat (self-host) | Alertmanager-gruppering | 1–4 tim | Self-hosted/moln | Djup i PromQL-ekosystemet |
| New Relic | SaaS APM + API-checks | 100 GB/mån, 1 användare | AI-gruppering, flapping-suppression | 15–30 min | Moln | Stark APM + synthetics tillsammans |
| Moesif | API-analys/affärsmått | Gratis/test | Beteendeanomalier | 20–45 min | Moln | Kundspecifik API-beteendeanalys |
| Splunk | Enterprise-loggar/compliance | Test | ITSI-episoder, AIOps | Dagar+ | Moln/self-managed | Enterprise logsökning och styrning |
| Postman | Team som redan testar API:er | Gratis konto | Enkla monitorderlarm | 10 min | Moln | Återanvänd API-testcollections |
Så kan Thunderbit snabba upp din utvärdering av API-verktyg
Full transparens: Thunderbit är inte ett API-övervakningsverktyg — det är en agentisk web scraper och Open API för att göra om webbsidor till ren Markdown eller strukturerad JSON. Det gör det användbart i en annan del av beslutet kring övervakningsverktyg: att samla in leverantörspriser, planbegränsningar, funktionspåståenden, dokumentationsdetaljer och integrationslistor innan du väljer plattform.
I stället för att manuellt öppna 10+ leverantörers prissidor, kopiera plannamn, monitorgränser, kontrollintervall, integrationer och kreditkortskrav till ett kalkylark använde vi Thunderbit Chrome Extension för att extrahera strukturerad data från varje verktygs pris- och funktionssidor. Thunderbits AI läser varje sida och föreslår fält — plannamn, detaljer om gratisnivå, pris, stödda integrationer — och strukturerar sedan resultatet till ett exporterat kalkylark.
För utvecklarflöden ger Thunderbit Open API samma idé programmässigt. Använd Distill när du vill ha ren Markdown för LLM:er eller RAG. Använd Extract när du behöver specifika fält som JSON. Använd Batch när du behöver bearbeta en lista med prissidor, dokumentations-URL:er, produktsidor eller konkurrentsidor och få resultaten asynkront.
Arbetsflödet:
- Öppna en leverantörs prissida (Datadog, Checkly, UptimeRobot osv.)
- Klicka på ”One Click Extract” — Thunderbits AI läser sidan, förstår strukturen och fyller en tabell i ett svep
- Använd undersidesskrapning för att hämta varje leverantörs pris-, funktions- och dokumentsidor
- Exportera till Google Sheets, Excel, Airtable, Notion eller CSV
För API-först-team är API-flödet lika rakt på sak:
- Skaffa en gratis API-nyckel från Thunderbit
- Anropa Distill-endpointen för ren Markdown från vilken publik sida som helst
- Anropa Extract-endpointen med schemabeskrivningar för strukturerad JSON
- Använd Batch-endpoints och webhooks för större URL-listor
- Skicka resultatet till din app, ditt kalkylark, ditt warehouse, din vector database eller ditt monitoring-workflow
För en jämförelse mellan 10+ leverantörer kan manuell copy-paste lätt ta 2–3 timmar när man räknar med prisundersidor, docs och integrationssidor. Thunderbit kortade vår första extraktion till ungefär 15–30 minuter, med återstående tid för verifiering och bedömningar. Om ditt drift-, inköps-, research- eller AI-produktteam utvärderar verktyg under tidspress är det en praktisk genväg. Du kan läsa mer om den här typen av arbetsflöde i vår guide om web scraping utan kod, utforska Thunderbits API-prissättning eller kolla in vår YouTube-kanal för genomgångar.
Så väljer du rätt API-övervakningsverktyg för ditt team
Det ”bästa” API-övervakningsverktyget beror på teamstorlek, teknisk nivå, budget och vad ett fel faktiskt betyder för er produkt.
En solo-utvecklare behöver inte Splunk. Ett reglerat enterprise bör inte förlita sig på ett cron-jobb. Ett API-produktteam kan behöva kundanalys i Moesif-stil snarare än enkla uptime-pings. Ett e-handelsteam bör prioritera kritiska checks för login, sök, lägg i varukorg, checkout och betalningsauktorisering. Ett AI- eller datateam kan behöva webdataextraktion i Thunderbit-stil innan det behöver full observability.
Tre principer som höll hela vägen i min research:
- Matcha verktyget med användningsfallet. Snabbvalstabellen finns av en anledning — börja där.
- Prioritera larmkvalitet framför larmmängd. Om teamet ignorerar larmen har ni ingen övervakning. Ni har brus.
- Underskatta inte installationshastighet. En monitor som går live idag och skickar pålitliga larm är bättre än en perfekt plattformsplan som lämnar checkout oövervakad i en månad till.
Om du jämför flera verktyg samtidigt och vill snabba upp researchen, testa Thunderbit för att extrahera leverantörsdata i bulk till ett enda kalkylark. Om du bygger en API-produkt, RAG-pipeline, AI-agent eller market intelligence-workflow som behöver ren webdata, börja med Thunderbit Open API. Det väljer inte övervakningsverktyget åt dig — men det tar dig snabbare till beslutet och kan ge din egen produkt ett pålitligt webdatalager.
Vanliga frågor om de bästa API-övervakningsverktygen
Vilket är det bästa gratisverktyget för API-övervakning 2026?
För enkel SaaS-användning erbjuder UptimeRobot 50 gratis monitors med 5-minutersintervall utan krav på kreditkort. För self-hostad kontroll är Uptime Kuma open source, obegränsat och har ett rent gränssnitt med över 90 notifieringstjänster. För team som vill ha djup i metrics och redan har teknisk kompetens är Prometheus + Grafana + Alertmanager den bästa open-source-stacken — även om installationen tar timmar, inte minuter.
Om ditt mål inte är uptime-övervakning utan att extrahera webdata via ett API, har Thunderbit Open API en gratisnivå med 600 engångs-API-enheter, vilket räcker för att testa page-to-Markdown-distillering eller schemabaserad JSON-extraktion innan du skalar upp.
Vad är skillnaden mellan API-övervakning och APM?
API-övervakning kontrollerar endpoint-tillgänglighet, svarstid, fel och korrekthet utifrån — den simulerar vad en användare eller integration upplever. APM (Application Performance Monitoring) går djupare in i applikationen: traces på kodnivå, databasfrågor, runtime-fel, kölatens och tjänstberoenden. Verktyg som Datadog och New Relic erbjuder båda; UptimeRobot och Uptime Kuma fokuserar på externa uptime-kontroller.
Thunderbit Open API är annorlunda än båda: det är ett API för webdataextraktion. Det hjälper dig att göra om externa webbplatser till Markdown eller strukturerad JSON, vilket är användbart för LLM-appar, researchflöden, prisintelligens och datapipelines.
Hur ofta bör jag övervaka mina API:er?
Produktionens intäktskritiskt API:er (checkout, auth, betalningar) bör vanligtvis kontrolleras varje minut. Interna eller lågtrafikerade API:er kan ofta kontrolleras var femte minut. Men frekvensen är inte hela bilden — använd retries, flera regioner och meningsfulla assertions så att varje kontroll är både snabb och tillförlitlig. En 1-minutskontroll som ger falska larm är sämre än en 5-minuterskontroll du kan lita på.
För arbetsflöden som extraherar webdata beror frekvensen på hur ofta källan ändras. Prissidor kan behöva daglig eller veckovis extraktion. Snabbrörlig lager-, rese- eller marknadsplatsdata kan behöva uppdateras varje timme eller oftare. Thunderbits batch-API och webhooks är användbara när du behöver bearbeta många URL:er enligt schema.
Kan jag övervaka API:er utan att skriva kod?
Ja. UptimeRobot, Better Stack och Uptime Kuma kan användas helt via GUI. Checkly stödjer både GUI och kodbaserad setup. Postman använder ett collection-baserat gränssnitt. Prometheus/Grafana kräver oftast YAML och PromQL. Datadog och New Relic kan starta via guidad setup men blir kraftfullare med djupare instrumentering.
Om du vill extrahera webbdata utan att skriva kod är Thunderbits Chrome Extension vägen utan kod. Om du vill automatisera samma workflow från en applikation ger Thunderbit Open API utvecklare Distill-, Extract- och Batch-endpoints.
Hur minskar jag larmtrötthet från API-övervakning?
Välj verktyg med smart larmhantering: anomalidetektion (Datadog, New Relic), retry innan utlöst larm (Checkly), beteendeanomalier (Moesif) eller gruppering/undertryckning (Prometheus Alertmanager). Börja med färre, mer säkra larm fokuserade på användarupplevd påverkan. Använd SLO burn-rate-larm i stället för statiska trösklar, deduplicera mellan tjänster, routa efter ägarskap och mät actionability — om färre än 20 % av larmen leder till faktisk åtgärd, minska bruset först.
Testa Thunderbit Open API för webdataextraktion Get Started Free
Läs mer



