
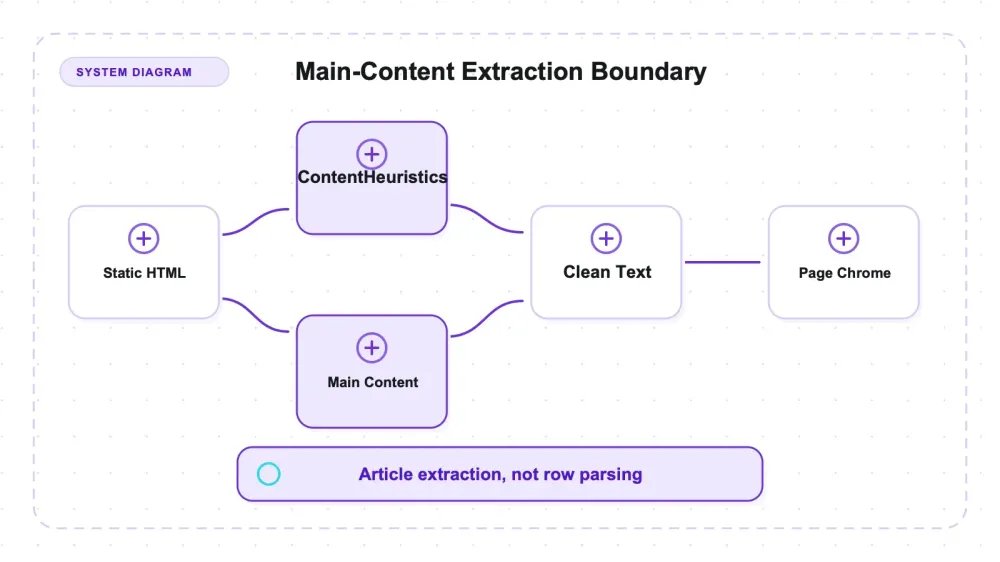
trafilatura — это Python-экстрактор контента без браузера. Среди размеченных примеров в этой статье у него один-единственный соперник по качеству извлечения из одного и того же HTML — Mozilla Readability: trafilatura пропустила 1 из 17 размеченных служебных блоков, тогда как Readability — 5. Инструменты с браузерной основой здесь упоминаются только в контексте требований к развёртыванию и не проходили проверку качества на этих страницах.
Её основная задача — извлечение основного содержимого: на вход подаётся HTML, на выходе получаются текст и метаданные, ориентированные на статью, а всё лишнее на странице отфильтровывается по эвристикам. Результат можно сериализовать в JSON и другие форматы, но инструмент не формирует заданную пользователем табличную схему и не создаёт повторяющиеся типизированные записи каталога. Тестировалась версия 2.1.0. JavaScript она не выполняет, а сравнение с Readability показывает скорее баланс между точностью и полнотой, чем безоговорочное преимущество по всем параметрам.
Где находится trafilatura и от чего она сознательно отказывается
trafilatura позиционируется как Python- и CLI-инструмент для сбора текста и метаданных из веба — для обхода, парсинга и извлечения — с выводом в CSV, JSON, HTML, Markdown, TXT или XML. Заявка широкая. Но на практике ядро инструмента заметно уже и точнее: он берёт HTML-документ и возвращает основной текст, очищенный от окружающих элементов страницы.
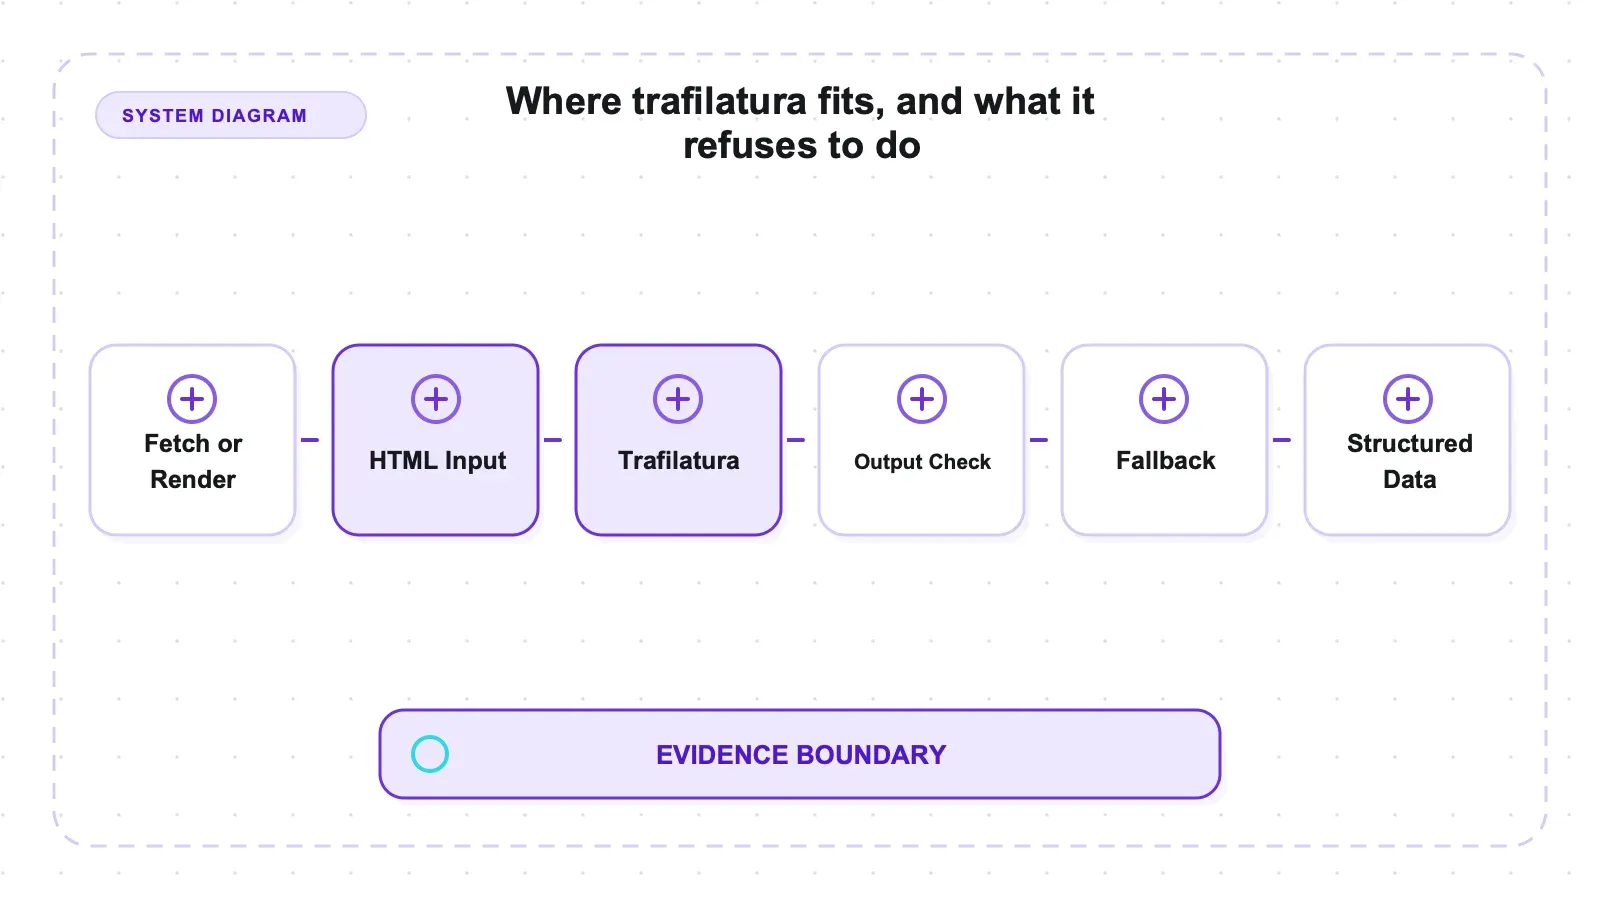
Вот удобная мысленная модель, потому что она объясняет и силу, и границы инструмента. Большинство скрейперов, которые вы направляете на страницу, работают через селекторы: вы говорите «возьми элемент с классом product-price», и они возвращают то, что лежит по этому адресу. trafilatura работает наоборот. Она читает весь документ и сама решает, какие блоки — это реальная статья, а какие — служебная оболочка, используя эвристики контента, а не написанный вами селектор. Поэтому для очистки страницы ей не нужны отдельные правила под каждый сайт. И именно поэтому она не может выдать вам структурированный каталог: здесь нет схемы, нет типизированных строк, только «вот значимый текст». Это экстрактор, а не целевой парсер.
Кроме того, ей не нужен отдельно скачиваемый браузерный runtime. В дереве зависимостей есть платформенные wheel-пакеты вроде lxml, так что фразу «без установки браузера» не стоит путать с установкой только из исходников или вовсе без нативного кода.
Установка: небольшой набор зависимостей, без браузера
pip install trafilatura в чистом virtualenv на Python 3.14 установил 17 пакетов; крупнейшим wheel по размеру был lxml — 8.6 MB, согласно pip-install-trafilatura.log. Отдельная установка браузера или последующая команда для его загрузки не потребовалась.
Для сравнения: пакет Scrapling в этой же исследовательской базе потребовал четыре отдельных запуска pip, прежде чем его fetcher’ы начали работать, и в итоге установил 26 пакетов, два из которых — это драйверные wheel-пакеты Playwright по 42.2 MB (tools/scrapling/artifacts/logs/pip-install-scrapling.log) — и это ещё до загрузки бинарника браузера. У комплекта Crawlee отдельная загрузка Chromium составила около 81.7 MiB (tools/crawlee/research-materials.md). Эти инструменты решают более широкую задачу, так что это не совсем честный бой по возможностям; но именно это и увидят ваш диск и ваш CI-кэш. А версия, которую мне выдал pip (2.1.0), совпадает с актуальным релизом, так что к цифрам ниже не нужно добавлять пометку «тестировали устаревшую версию».
Практика: что экстрактор реально вернул
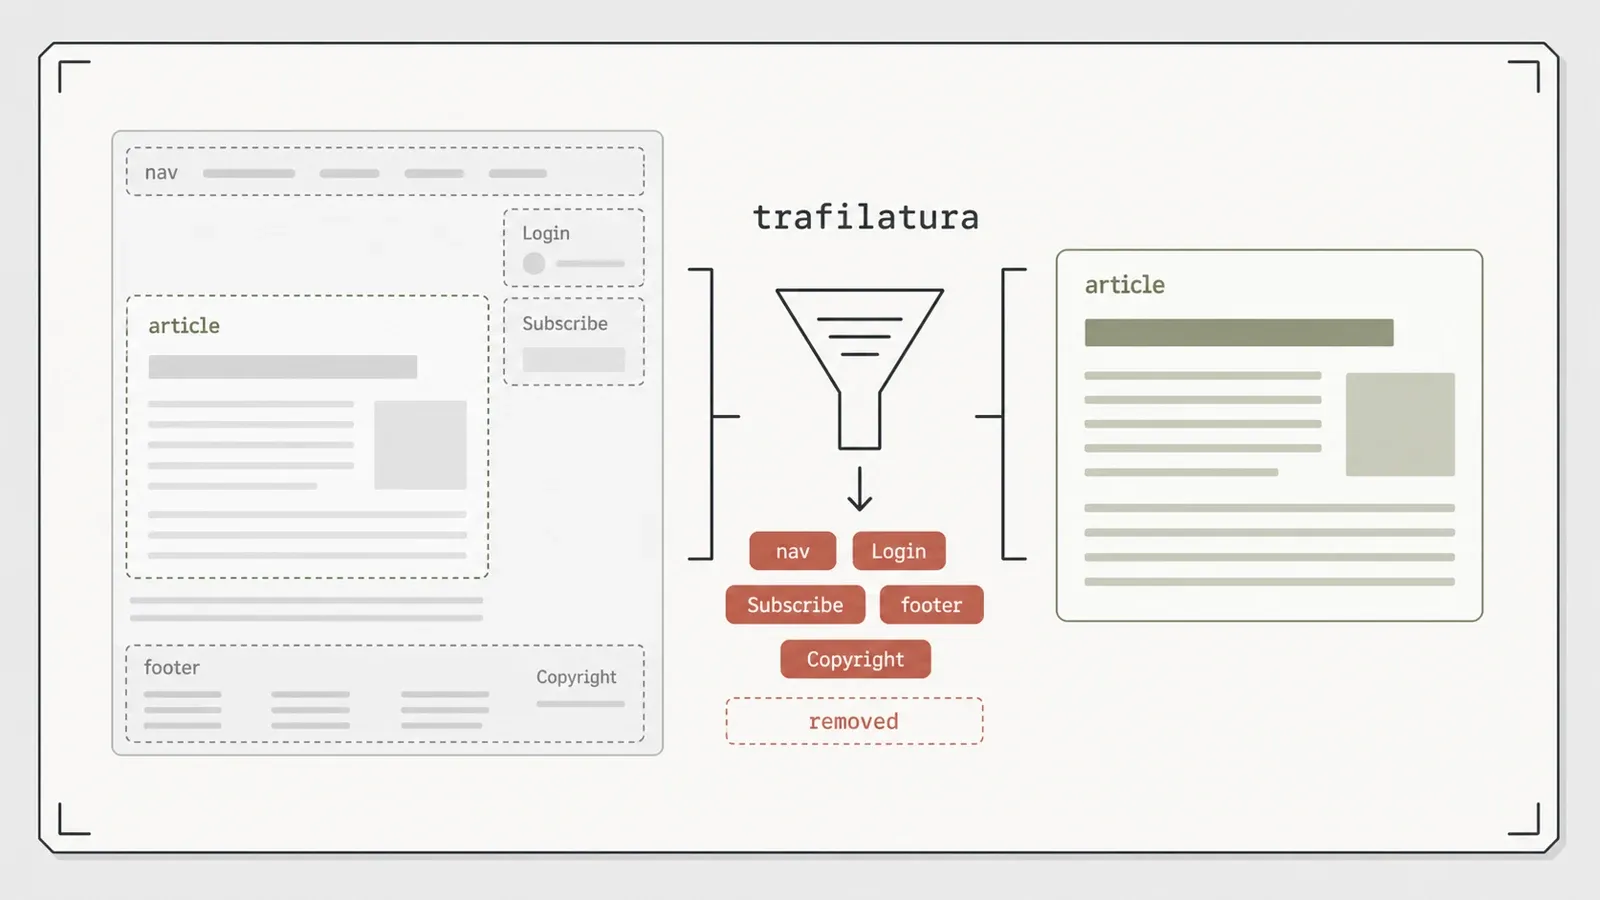
Я прогнал её на наборах, которые проверяли и сильную сторону, и предел возможностей; сырые результаты сохранены в репозитории бенчмарка. Тест со статьёй — тот самый случай, который меня убедил.
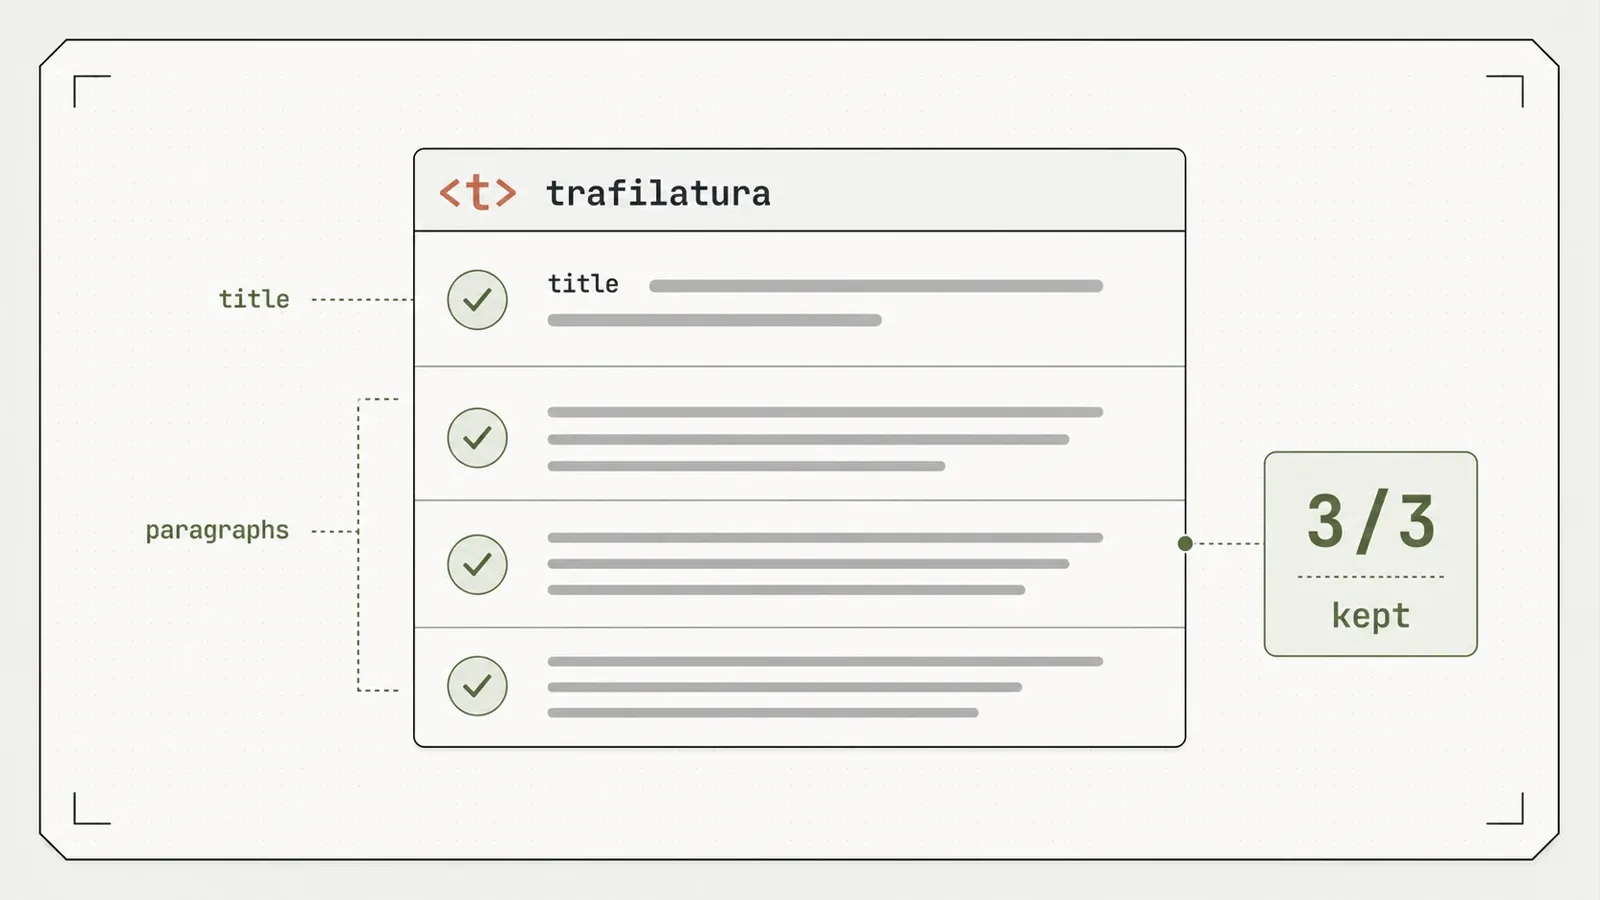
Я взял локальный пример статьи и обернул реальное содержимое шумом: окно логина, навязчивую кнопку «Subscribe», навигационные ссылки, футер с копирайтом — стандартный служебный мусор, который наивный скрейпер тащит вместе с основным текстом. trafilatura вернула заголовок и все 3 из 3 абзацев, и все маркеры служебного мусора — Login, Subscribe, Copyright — исчезли из результата. Помимо текста, она корректно извлекла автора и дату из метаданных страницы. Полный результат в форматах .txt, .md и .json лежит в results/local_article.json.
Тот же сохранённый HTML был выгружен как обычный текст, Markdown и JSON. Из статьи не следует, что все три формата были получены одним одновременным вызовом; это альтернативные сериализации одного пути извлечения. JSON здесь упаковывает извлечённый текст и метаданные, а не пользовательские повторяющиеся записи.
Ниже — весь первый прогон в одном месте, чтобы можно было проверить утверждения, а не верить на слово:
| Пример | Что вернулось | Время | Доказательство |
|---|---|---|---|
| Локальная статья, обёрнутая в навигацию / логин / subscribe / copyright | заголовок + 3/3 абзаца, утечки служебных блоков нет, автор Thunderbit Research Lab, дата 2026-07-09 | 0.007 s | local_article.json |
| Локальный каталог товаров | 12 названий товаров и 12 цен как плоский текст, 0 структурированных строк, 478 символов | 0.064 s | local_catalog_extraction.txt |
| Страница, возвращающая HTTP 500 | fetch_url вернул None, без исключения | 30.012 s | local_failure_500.json |
| Страница продукта Books to Scrape (публичная) | 1,324 символа чистого текста, плюс Markdown-версия | 0.753 s | public_books_product.txt / .md |
Каждая строка взята из artifacts/raw/trafilatura-test-summary.json в пакете trafilatura — версия 2.1.0, Python 3.14, macOS arm64, один запуск на одной машине. Воспринимайте времена как наблюдения, а не как полноценный бенчмарк.
На тесте с 500-м ответом fetch_url вернул None примерно через 30 секунд, тогда как соседние локальные эндпоинты отвечали быстро. Этот прогон подтверждает задержку, но не доказывает, что её вызвали retry/backoff, фиксированный таймаут или какой-то другой внутренний путь. В этой статье не проверялся поддерживаемый параметр таймаута на уровне вызова для fetch_url; подтверждённый способ контроля — использовать клиент, управляемый вызывающей стороной, и передавать полученный HTML в trafilatura.
Те же тесты показывают ещё три границы.
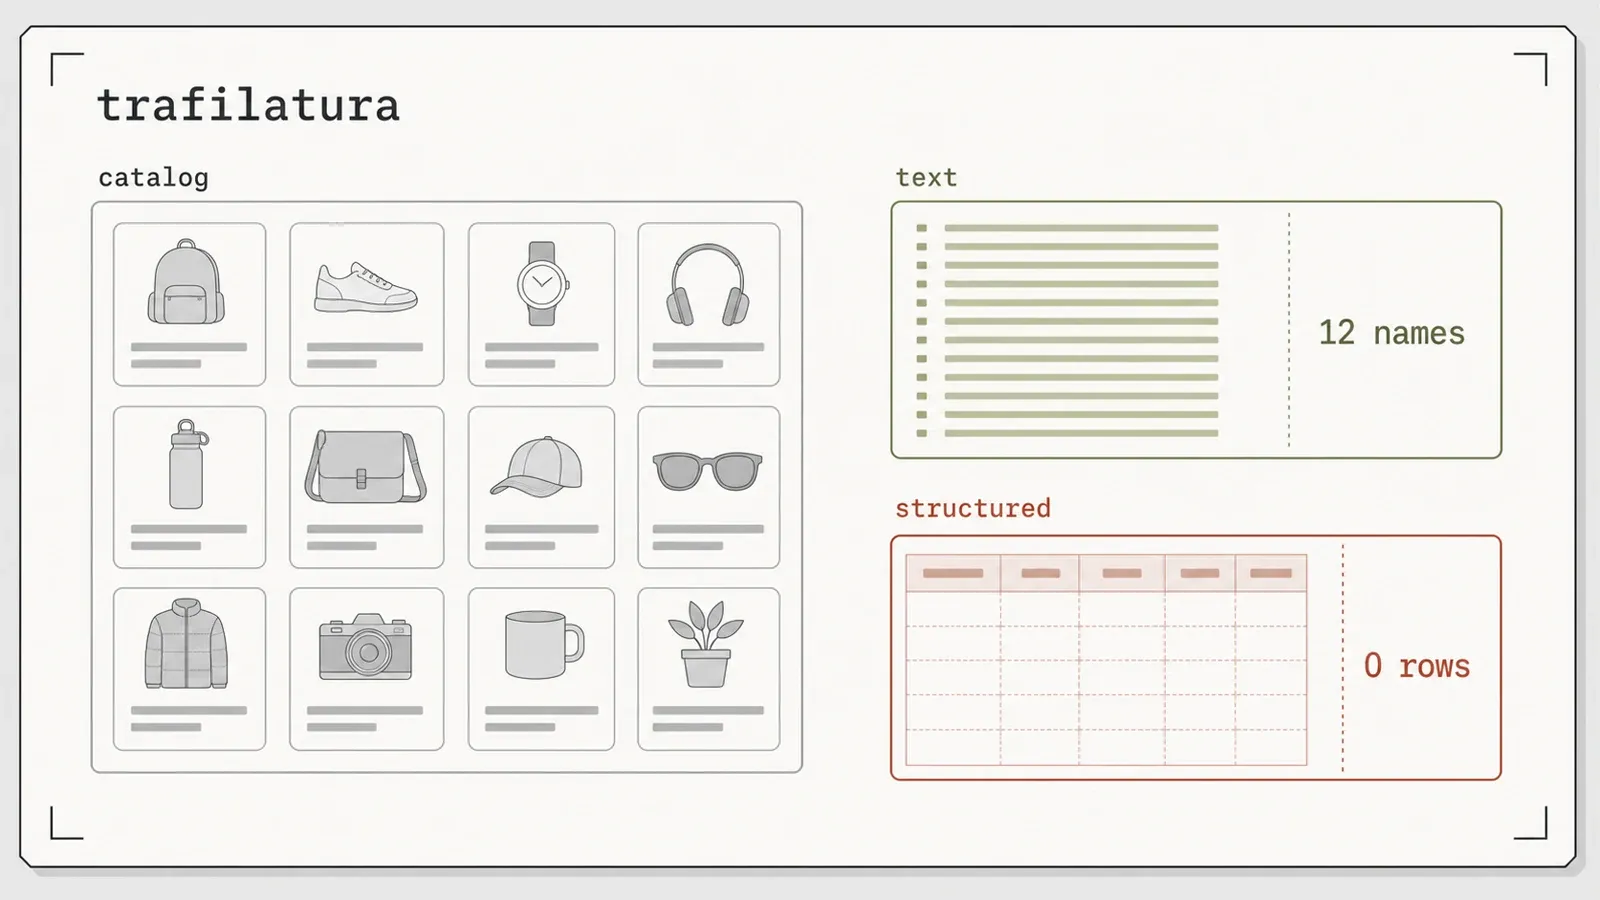
Первая и главная: trafilatura — это экстрактор контента, а не структурный скрейпер. Я прогнал её на примере каталога товаров. Она вернула все 12 названий товаров — как текст — и ровно 0 структурированных строк (478 символов плоского текста, согласно results/local_catalog_extraction.txt). Цены тоже сохранились — от $18.00 до $51.00, каждая на своей строке под названием товара. Внутри результата есть всё нужное, но ничто не оформлено как поле. Если вам нужен формат [{name, price, rating}, …], это не тот инструмент, и никакая настройка это не изменит — это решение на уровне дизайна, а не баг.
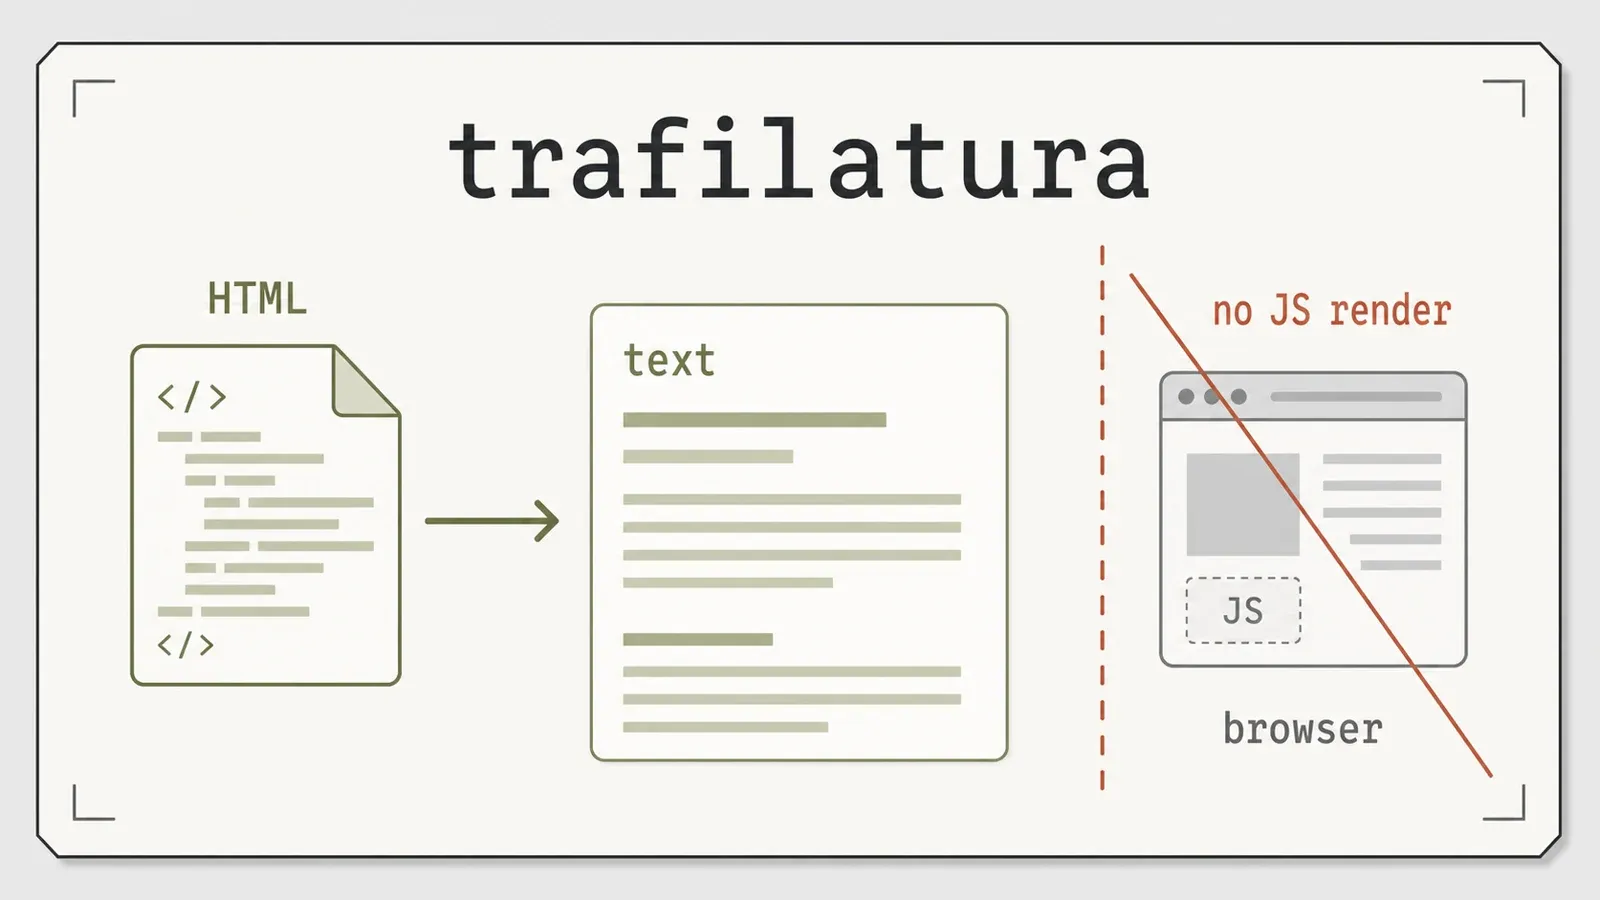
Вторая: она не рендерит JavaScript. Инструмент работает только со статическим HTML. Если направить его на страницу, которая собирается на клиенте, вы получите то, что сервер отдал до выполнения JS, а это часто вообще не то, что нужно. Если ваши цели сильно завязаны на JavaScript, придётся подключать отдельный рендерер; trafilatura эту часть за вас не сделает.
Третья — оговорка по моим собственным данным: первый публичный тест извлечения использовал блок описания товара, а не настоящую новостную статью, потому что в публичной песочнице нет новостных страниц. Результат по очистке статьи выше получен на контролируемом локальном примере. Я ему доверяю — удаление служебного мусора очевидно, — но не хотел выдавать товарную страницу за доказательство качества новостного извлечения, поэтому в пакете это было оставлено как открытый пробел. Повторный прогон 2026-07-14 закрыл его, и результаты приведены в следующем разделе.
Проверка служебного мусора на реальных страницах
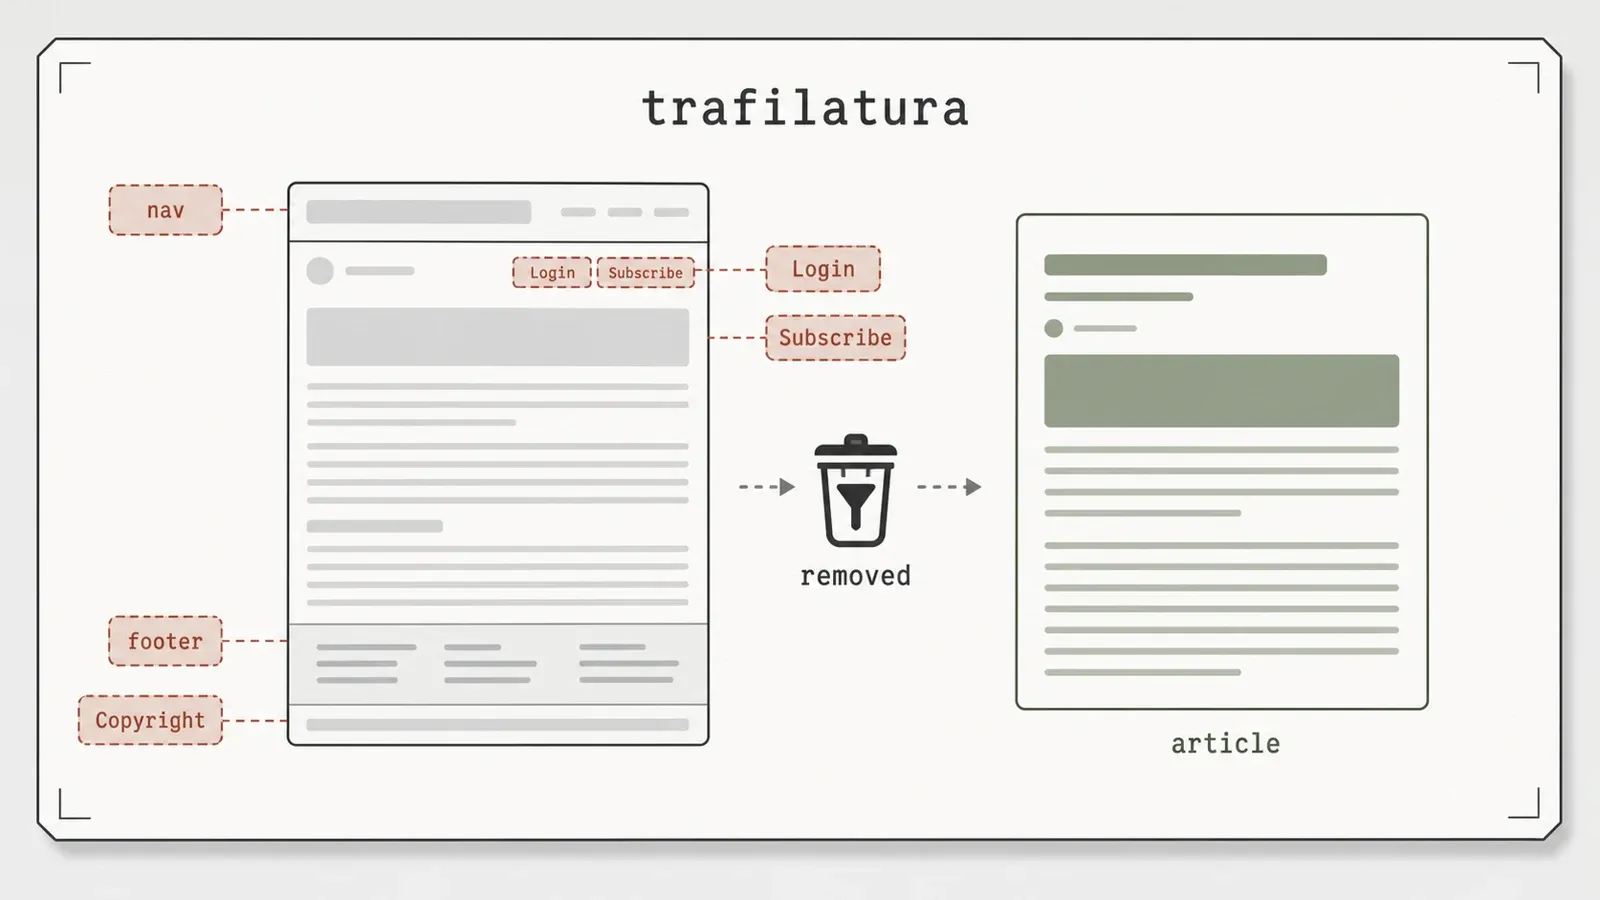
Две реальные страницы были один раз загружены, сохранены как офлайн-фикстуры с SHA-256-хэшами и затем снова прогнаны без доступа к сети. Время и размеченная эталонная разметка не фиксировались. Это проверка удаления служебного мусора на реальных страницах, а не оценка полноты.
| Фикстура статьи | Сырой HTML | Извлечённый текст | Соотношение body/raw | Удалённые маркеры страницы | title | date | hostname | author | sitename |
|---|---|---|---|---|---|---|---|---|---|
| Wikipedia, «Web scraping» | 230,049 bytes | 26,673 bytes | 0.116 | 4 из 4 | yes | 2005-09-17 | wikipedia.org | null | null |
| Wikinews, «7th Heaven» (архив) | 79,716 bytes | 2,200 bytes | 0.028 | 5 из 5 | yes | 2005-11-29 | wikinews.org | null | null |
Обе строки взяты из artifacts/results/trafilatura-fidelity-summary.json. Проверялись маркеры «Jump to content», «Privacy policy», «Powered by MediaWiki», «This page was last edited», а также «free news source» на странице Wikinews — все они были удалены и нигде не просочились на обеих страницах.
Соотношение body/raw показывает степень сокращения, а не точность; пропущенное содержимое статьи отдельно не оценивалось. author и sitename на этих двух шаблонах MediaWiki оказались null, тогда как контролируемая локальная фикстура автора содержала. Это сбой, наблюдаемый именно на шаблонах MediaWiki, а не доказательство надёжности извлечения byline в целом. Извлечённые даты приведены в том виде, как их вернул инструмент, и не проверялись по эталону.
Два экстрактора, одни и те же байты HTML, один скрипт оценки
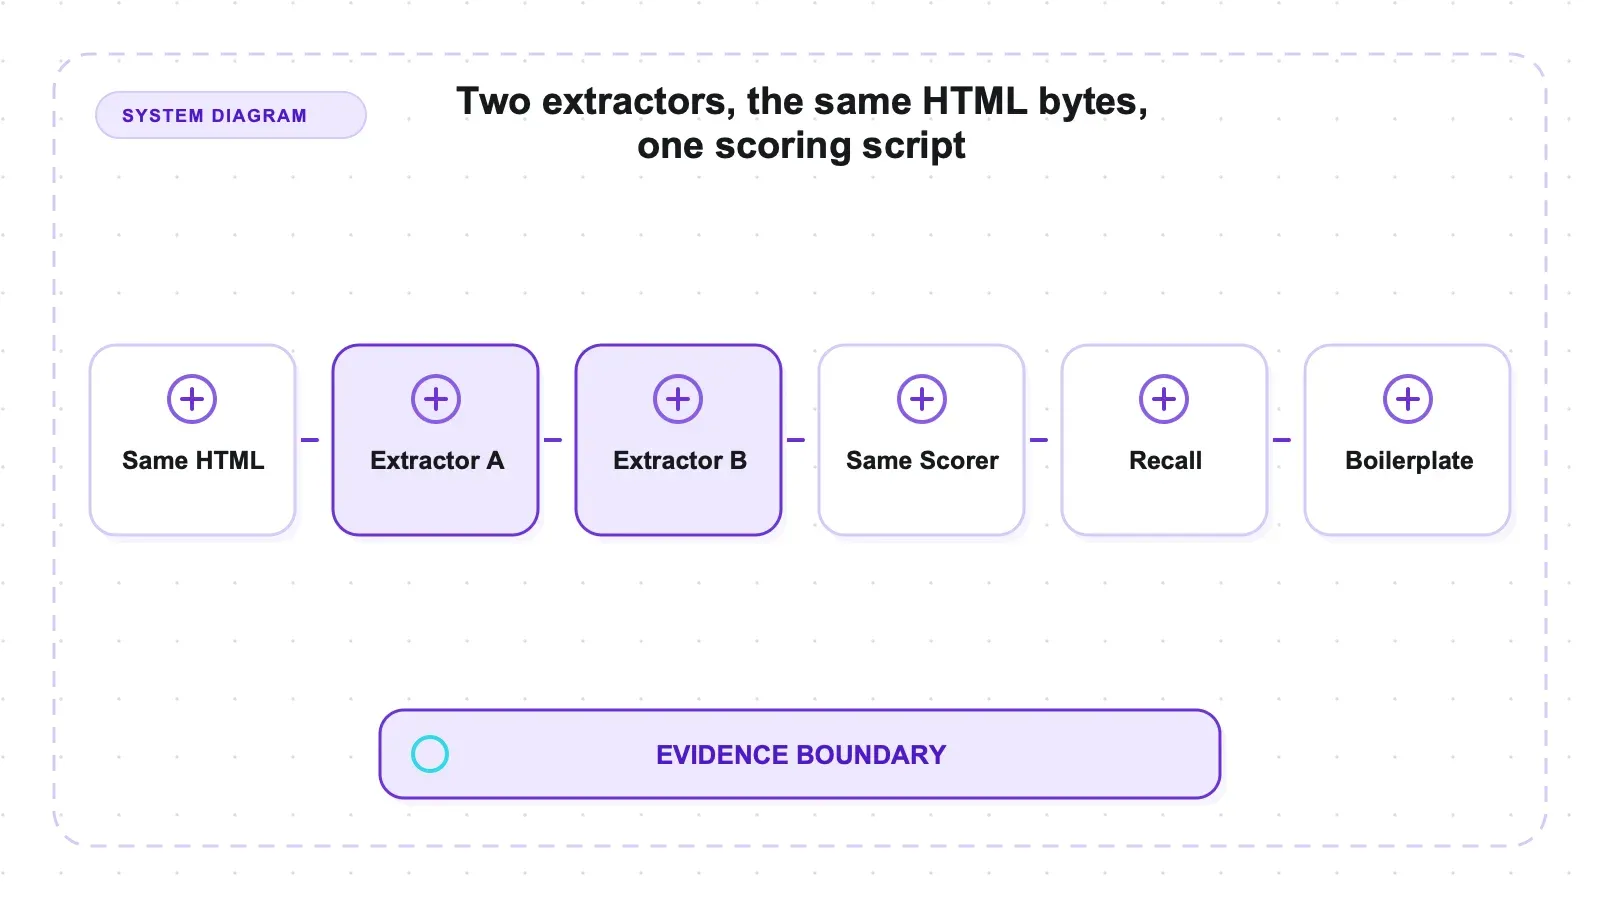
В этой исследовательской базе есть ровно одно сравнение trafilatura на одном и том же тестовом стенде, и его строила не собственная команда trafilatura. Его собрал пакет mozilla-readability как контрольную ветку: 22 вручную размеченные фикстуры, где каждый текстовый блок помечен как ARTICLE или BOILERPLATE, а каждое слово содержит уникальный sentinel-токен, чтобы любое извлечённое слово можно было однозначно сопоставить с конкретным размеченным блоком. Обе программы получили идентичные байты HTML. Readability работала под jsdom 29.1.1 на Node v22.22.3; trafilatura использовала свой собственный парсер.
| Метрика (micro-averaged, набор content-fidelity) | trafilatura 2.1.0 | @mozilla/readability 0.6.0 | Доказательство |
|---|---|---|---|
| Восстановлено единиц статьи | 40 из 40 | 40 из 40 | comparison.json |
| Утечка служебных единиц | 1 из 17 | 5 из 17 | comparison.json |
| Токены служебного мусора в результате | 3 | 41 | comparison.json |
| Точность по токенам | 0.939 | 0.902 | comparison.json |
| F1 по токенам | 0.969 | 0.948 | comparison.json |
Recall по неповествовательному контенту, фикстура f6_nonprose | 7 из 8 | 8 из 8 | comparison.json |
F1 на очень короткой статье, фикстура f3_short_120 | 0.571 | 0.800 | comparison.json |
Источник: tools/mozilla-readability/artifacts/raw/comparison.json в этой исследовательской базе — 11 фикстур в наборе content-fidelity, 40 единиц статьи и 17 единиц служебного текста. Это синтетические примеры, сознательно смещённые в сторону сложных случаев, поэтому читать их нужно как иллюстрацию механики, а не как рейтинг на реальном корпусе.
Ни один из инструментов не выигрывает безусловно, и именно это расхождение здесь самое интересное. trafilatura лучше удерживает чистоту текста — один пропущенный служебный блок против пяти у Readability, три загрязняющих токена против 41. Это и есть та часть, которая определяет, не заполнится ли контекстное окно вашей LLM боковыми ссылками. Но Readability возвращает то, что trafilatura отбрасывает: на неповествовательной фикстуре trafilatura потеряла <figcaption>, который Readability сохранила, а на очень короткой статье она получила 0.571 против 0.800 у Readability. Агрессивная очистка — это компромисс, а не бесплатная победа. Если у вас в корпусе много коротких заметок, подписей к изображениям и страниц с таблицами, этот компромисс будет работать против вас.
Как превратить сравнение в тест выбора
Сначала определите, какая ошибка для вашего пайплайна обходится дороже. Если служебная оболочка тратит downstream-токены или засоряет поиск, больший вес должны иметь утечки служебных блоков и количество загрязняющих токенов. Если недопустима потеря подписи, короткой заметки или неповествовательного блока, больший вес должен быть у полноты извлечения в зависимости от формы страницы. Общий набор фикстур позволяет увидеть этот компромисс, но не подсказывает, какие веса нужны именно для архива редакции, корпуса документации или retrieval-пайплайна.
Широкий контекст стресс-теста есть в сравнении памяти и некорректного HTML для десяти библиотек.
Проводите bake-off на сохранённом HTML, а не на живых URL, чтобы оба экстрактора получили идентичные байты. Включите обычные длинные статьи, короткие заметки, материалы с большим количеством подписей к изображениям, документы с таблицами или кодом и шаблоны от каждого издателя, которого вы реально обрабатываете. До запуска отметьте небольшое число обязательных единиц контента и известных служебных блоков. Затем отдельно оценивайте пустой результат, восстановление обязательных единиц, утечку нежелательных блоков и поля метаданных. Один общий балл «качества» может скрыть именно тот тип сбоя, который критичен в работе.
Также проверяйте контракт результата дальше по цепочке. JSON у trafilatura может содержать извлечённый контент и метаданные, но JSON-сериализация — это не то же самое, что типизированная табличная схема. Для текста статьи проверяйте минимальную длину тела и обязательные маркеры вместо того, чтобы принимать любой непустой результат. Для метаданных различайте отсутствие значения и неверное значение, а вместе с исходным URL и версией экстракции сохраняйте всё необходимое, чтобы промахи можно было повторно воспроизвести.
Отдельно нужно тестировать и этап получения страницы. Наблюдение с 30-секундной задержкой относится к fetch_url, а не к извлечению из уже имеющегося HTML, и внутренний механизм этого поведения не был установлен. Если важны дедлайны, повторные попытки, авторизация или правила прокси, используйте клиент, поведение которого вы контролируете, сохраняйте итоговые байты ответа и передавайте их в экстрактор. Так можно отделить сбои на этапе получения данных от ошибок выбора контента и сделать сравнения повторяемыми.
И наконец, измеряйте свойства развёртывания на целевой платформе. Установка на Python 3.14 из 17 пакетов не требовала отдельного браузера, но из этого не следуют пропускная способность, рост памяти, доступность wheel-пакетов на всех архитектурах или поведение при параллельных воркерах. В статье показан полезный механизм баланса точности и полноты относительно Readability; пригодность для продакшена всё равно зависит от корпуса и runtime-тестов.
Для внешней проверки, не основанной на этой базе, собственная страница оценки trafilatura и публичный article-extraction-benchmark от ScrapingHub обе ставят её выше readability-lxml по word-F1 примерно на ~181 реальной странице — направление то же, что и в таблице выше. Одна оговорка, которую часто опускают в обзорах, ссылающихся на этот бенчмарк: широко цитируемый F1 у trafilatura (~0.945) относится к более старой ветке 0.5.1, а не к тестируемой здесь версии 2.1.0.
Плюсы и минусы
Плюсы:
- Меньше утечек размеченного служебного текста, чем у Readability, на общем наборе фикстур: 1 блок из 17 против 5.
- Корректно извлекла автора и дату на локальной фикстуре, а также title/date/hostname на обеих реальных страницах статьи.
- Один и тот же HTML можно сериализовать как текст, Markdown или JSON.
- Установка — 17 пакетов, без отдельного браузерного runtime.
- Ошибки происходят тихо:
fetch_urlпри HTTP 500 возвращаетNone, а не бросает исключение. - Тестируемая версия совпадает с актуальной (2.1.0) — без расхождения версий.
- Лицензия Apache-2.0 — permissive и удобна для коммерческого использования.
Минусы:
- Не структурный скрейпер: тест каталога вернул 12 названий и 12 цен как текст и 0 типизированных строк. Никакой схемы, никаких полей.
- Нет рендеринга JavaScript — только статический HTML; для client-side страниц нужен отдельный рендерер.
authorиsitenameвернулись как null на обеих реальных страницах MediaWiki, так что извлечение byline не гарантировано.- Агрессивная очистка имеет цену: был потерян
<figcaption>, который сохранила Readability, и на очень короткой статье результат 0.571 против 0.800 у Readability. - Тихий 500 ждал 30.012 секунды, прежде чем вернуть
None; если важен контроль по дедлайну, используйте свой fetcher. - Встроенный crawler/sitemap spider и форматы вывода CSV/XML в этом прогоне не проверялись, поэтому я ничего о них не утверждаю.
Для кого это и кому лучше пройти мимо
trafilatura рассчитана на извлечение основного текста из статей. Она подходит для построения текстовых корпусов, читаемых архивов или входных данных для NLP из статического HTML, если эвристическая очистка вас устраивает. Сравнение на общем наборе фикстур показывает меньшую утечку служебного текста, чем у Readability, тогда как Readability лучше сохраняла короткие и неповествовательные случаи.
Лучше отказаться от неё, если вам нужна структурная выгрузка — товарные строки с ценой, типизированные записи, поля key: value, — потому что она отдаёт текст, а не таблицы (тест каталога восстановил все 12 названий и все 12 цен, но 0 строк). Также не стоит выбирать её, если ваши цели рендерят контент в браузере и вы не готовы подключать отдельный рендерер: trafilatura читает статический HTML и на этом останавливается. И дважды подумайте, если в вашем корпусе в основном короткие заметки, подписи к изображениям и страницы с таблицами: именно там на размеченных примерах её очистка начинала резать по живому контенту (F1 0.571 на очень короткой статье, потерянный <figcaption>). Подбирайте инструмент под задачу: полный текст статьи — да; структурированный JSON, JS-страницы или заметки на 100 слов — лучше искать другое решение.
Альтернативы, включая место Thunderbit
trafilatura — это self-hosted библиотека под Apache-2.0 без платы за каждый вызов со стороны вендора; при этом вычисления, трафик, получение страниц, мониторинг и сопровождение остаются на стороне оператора. Она умеет извлекать статьеподобный текст из переданного HTML, но не выполняет браузерный рендеринг и не строит пользовательские повторяющиеся схемы строк.
Для сравнения по тем же фикстурам у всех шести экстракторов смотрите сравнение извлечения по шести библиотекам.
Managed-сервис может вынести получение страниц, рендеринг и формирование схемы за границу вендора. Мы разрабатываем Thunderbit, но не запускали его на этих фикстурах, поэтому эта статья не даёт оснований сравнивать качество, рендеринг, задержки, антибот-защиту или стоимость. Выбор здесь — между self-hosted контролем HTML-to-content и hosted-подходом, где получение данных и структурное извлечение находятся за внешней границей.
Связанные обзоры бенчмарков: полное сравнение open-source скрейперов, обзор Crawl4AI с браузерной основой для Markdown и обзор Firecrawl с self-hosted Markdown.
Попробовать Thunderbit для извлечения веб-данных
Вердикт
Стоит рассмотреть trafilatura, если задача — извлечение статей из статического HTML и ваш приоритет — отсечь размеченный служебный мусор. На общем наборе фикстур она пропустила одну размеченную служебную единицу против пяти у Readability. Но это преимущество сопровождалось более низкой полнотой на очень коротких и неповествовательных примерах, так что решать должна структура корпуса.
Она не выполняет JavaScript и не выдаёт пользовательские повторяющиеся строки. На двух страницах MediaWiki author и sitename были null — это наблюдение, ограниченное данным шаблоном. Readability сохранила подпись, которую trafilatura отбросила, и получила более высокий балл на фикстуре f3_short_120; видимые данные подтверждают именно «более низкий F1 на очень короткой фикстуре», а не число символов и не утверждение, что вывод был испорчен.
Попробовать Thunderbit для извлечения веб-данных Get Started Free
FAQ
Какую структуру возвращает trafilatura?
Она может сериализовать извлечённый контент и метаданные в JSON, Markdown, текст, HTML, XML или CSV. Это структурированная сериализация, но не пользовательская схема повторяющихся строк вроде «название товара, цена, рейтинг». На фикстуре каталога значения вернулись как плоский контент, а не как типизированные строки.
Можно ли с помощью trafilatura выгрузить каталог товаров в структурированные строки?
Нет. Это экстрактор контента, а не структурный скрейпер. На фикстуре каталога он вернул все 12 названий товаров как плоский текст и 0 структурированных строк — названия есть в выводе, но это не поля. Если вам нужны типизированные записи вроде name/price/rating, используйте парсер на селекторах или API извлечения по схеме.
Рендерит ли trafilatura JavaScript?
Нет. Она работает только со статическим HTML. Если направить её на страницу, собранную на клиенте, вы получите то, что сервер отдал до выполнения JavaScript, а это часто не тот контент, который нужен. Для JS-heavy целей подключайте отдельный рендерер.
Сложно ли установить trafilatura?
В протестированном virtualenv на Python 3.14 установка подтянула 17 пакетов и не потребовала отдельного браузерного runtime. Самым крупным wheel был lxml размером 8.6 MB. Отдельно один локальный вызов к 500-й ошибке возвращал None 30.012 секунды; если вам нужен гарантированный дедлайн, используйте HTTP-клиент, которым управляете вы.
Можно ли использовать trafilatura в коммерческих проектах бесплатно?
Да, у неё лицензия Apache-2.0, а это permissive-лицензия, удобная для коммерческого использования. Как всегда, перед внедрением проверьте актуальную лицензию в репозитории.




