
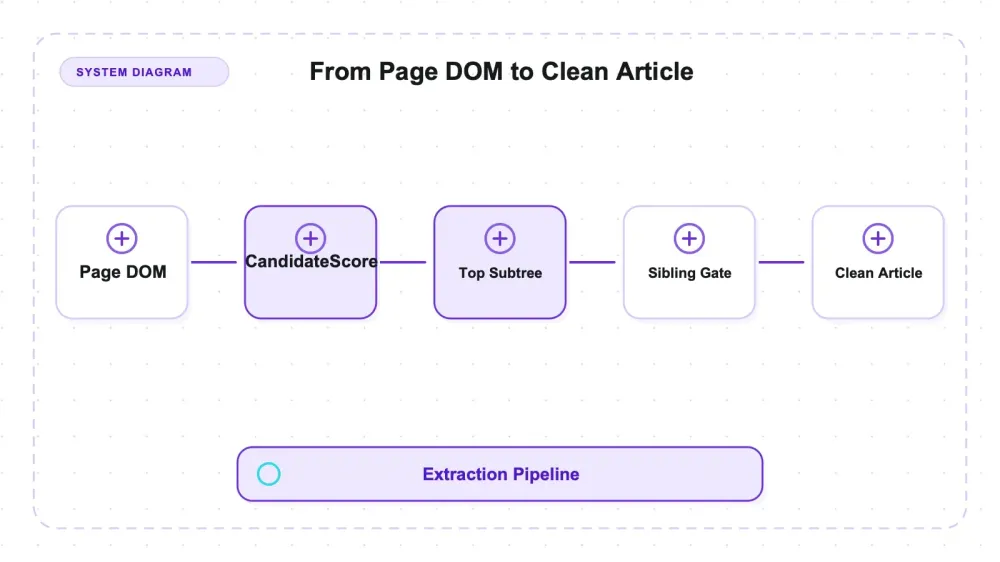
Mozilla's Readability — это автономная JavaScript-версия экстрактора, который лежит в основе Firefox Reader View. Пакет выходит под лицензией Apache-2.0 как @mozilla/readability и вынимает контент статьи прямо из живого DOM. Поэтому в Node ему нужен DOM-движок, например jsdom. Он не загружает страницы, не выполняет их JavaScript и не занимается извлечением схемы данных.
Проверялась версия npm latest — 0.6.0, опубликованная 3 марта 2025 года; на момент проверки 27 июля 2026 года в репозитории было 11 361 звезда (последний push — 9 июля 2026-го, так что main заметно опережает опубликованный пакет). Я запускал её в jsdom 29.1.1 на Node v22.22.3, macOS arm64, на 22 размеченных HTML-fixture'ах, собранных специально для этого теста, и все цифры ниже получены именно в такой конфигурации. На практике это самый неприхотливый инструмент в этой категории: две минуты на установку, никаких бинарников, никакого браузера в кеше, одинаковый результат при каждом прогоне. Интересен он не тем, как его запускать, а тем, что его ошибки можно предсказать по нескольким константам в исходниках — и одна из этих констант влияет сильнее, чем подсказывает документация.
На 22 контролируемых синтетических fixture'ах Readability восстановил все 74 размеченных блока статьи. Но этот ограниченный результат не означает, что он никогда не теряет текст статьи: в публичном real-page-бенчмарке recall равен 0.982, а известные типы ошибок здесь не воспроизвелись. Самой заметной ошибкой на fixture'ах стала лишняя вставка соседнего блока, пропущенная через source-level link-density gate с порогом 0.25. Насколько серьёзно выглядит эта проблема, зависит от тестового окружения.
Что такое readability.js на самом деле — и чем оно не является
Readability — это rule-based скоринг DOM. Он обходит кандидатные элементы, присваивает каждому content score, поднимает эти оценки к родителям, выбирает поддерево с наибольшим баллом, а затем запускает очистку, убирая то, что похоже на служебную часть страницы. В этом и состоит вся стратегия извлечения статьи — без модели, без обучающих данных, без правил под каждый сайт. Именно поэтому он работает на странице, которую никогда не видел, и именно поэтому его сбои можно предсказать по исходникам — в этом и есть весь кайф.
Три вещи, которыми он не является, и все три часто вводят людей в заблуждение:
- Не загрузчик. Он принимает
document, а не URL. Загрузка, ретраи, антибот-защита и заголовки — это уже ваша забота. - Не рендерер. JavaScript он не исполняет. Видит только тот DOM, который вы ему передали.
- Не структурный экстрактор. На выходе вы получите
title,byline,excerpt,content(HTML),textContent,length,siteName. Никакой схемы, никаких типизированных строк, никакого{name, price}.
Четыре константы делают большую часть работы
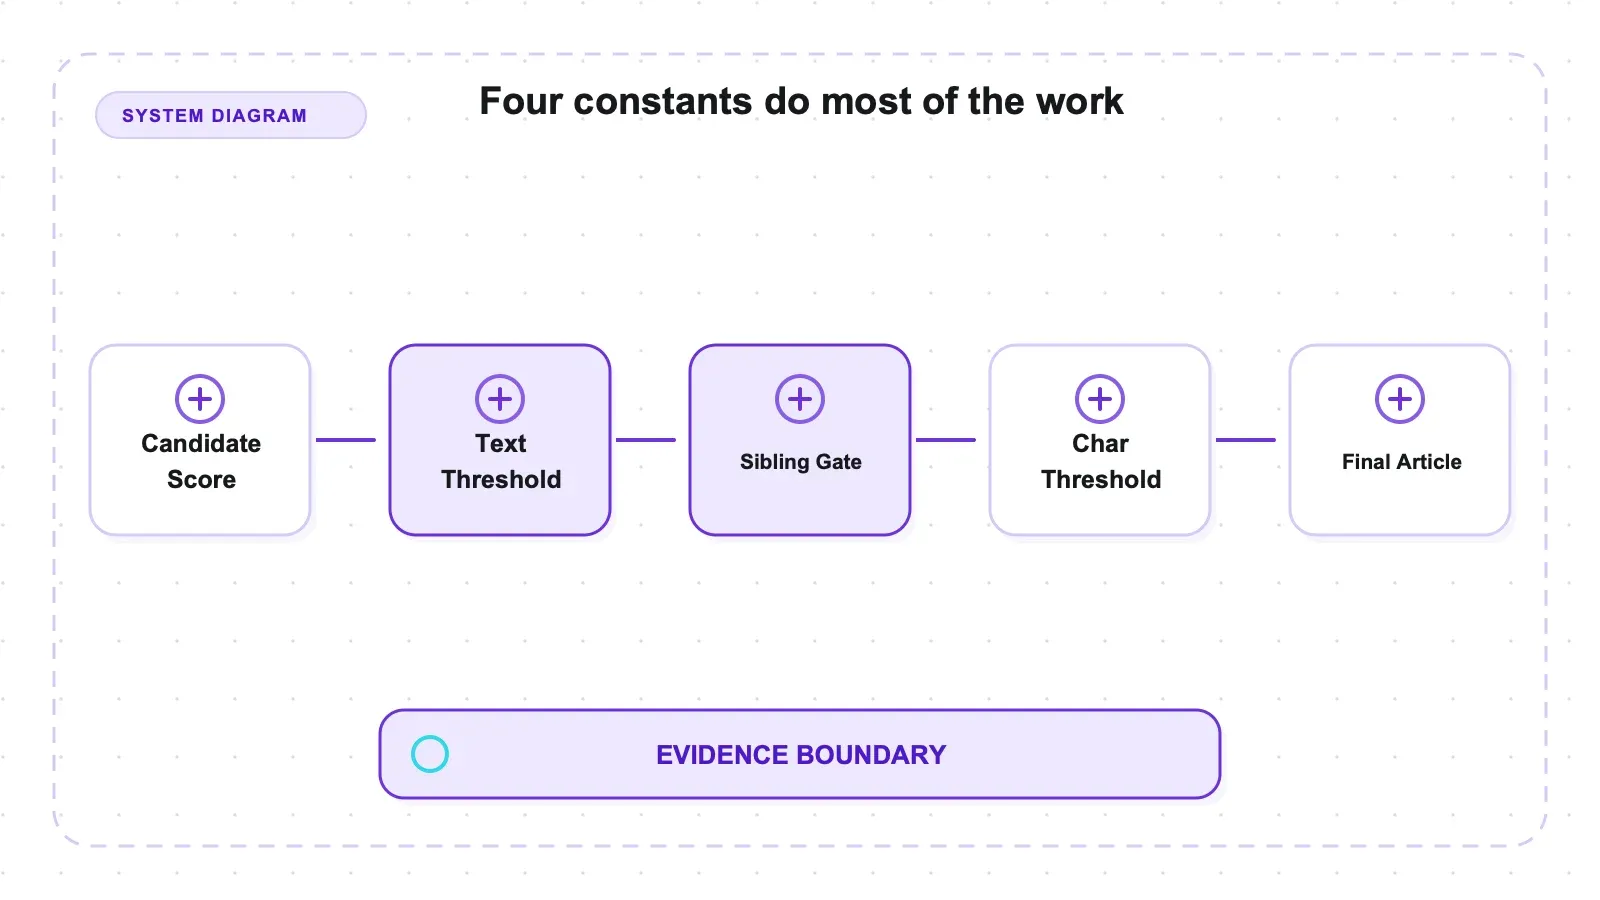
Если читать Readability.js в node_modules, о поведении библиотеки узнаёшь больше, чем из любой страницы документации. Большую часть того, как она работает, объясняют четыре механизма:
- Content score для каждого scored paragraph:
1 + (commaCount + 1) + min(floor(len / 100), 3). Абзацы короче 25 символов вообще не считаются. Баллы передаются предкам с делителями: родитель получает полный score, дед — половину, более дальние предки —level · 3. DEFAULT_CHAR_THRESHOLD = 500— минимальная длина статьи для «успешного» парсинга. Ниже этого порога запускается повторный проход с менее агрессивной очисткой.- Регулярка
unlikelyCandidates— отсеивает классы и id с подстроками вродеcomment,footer,menu,related,sidebar,social,sponsor. Такие узлы удаляются ещё до скоринга. - Sibling-append gate в
grabArticle— после выбора лучшего кандидата рассматриваются его соседи. Сосед попадает в итог, если его собственный score выше порога, илиnodeLength > 80 && linkDensity < 0.25, илиnodeLength < 80 && nodeLength > 0 && linkDensity === 0 && внутри есть точка.
Link density считается как Σ(linkText.length · coef) / textLength, где coef = 0.3 для ссылок с href вида # и 1 для остальных. Именно этот gate объясняет утечки соседних блоков, которые были измерены здесь; это не весь алгоритм извлечения.
Настройка и зависимость, которой нет в рекламном описании
npm install @mozilla/readability jsdom — и можно работать. Две минуты, никаких бинарников, никаких загрузок после установки, никакого браузера в кеше. По оси установки всё почти идеально.
Но фраза «без зависимостей» относится к алгоритму, а не к runtime. Readability работает с живым document, а в Node это значит, что DOM-реализацию вы предоставляете сами — здесь это jsdom версии 29.1.1. jsdom не маленький, и для большинства пайплайнов именно он, а не извлечение, становится основной стоимостью цикла. Это нужно закладывать в расчёт.
Ещё один подводный камень, из-за которого мне пришлось прогнать тест заново: Readability.parse() мутирует переданный DOM. Если дважды парсить один и тот же jsdom-документ, второй вызов увидит уже «разобранную» структуру. В моём harness каждый парс строит свежий jsdom. Если вы переиспользуете один document ради экономии времени, именно на этом месте у вас потом и появится баг-репорт.
Как я это тестировал
Я не гонял это по живым новостным сайтам. На живых страницах вы получаете score, но не понимаете почему; а для heuristic-алгоритма именно «почему» и составляет ценность. Вместо этого я сгенерировал 22 HTML-fixture'а с 91 размеченным блоком (74 article, 17 boilerplate), где каждое слово внутри блока начиналось с уникального sentinel string этого блока. Словари блоков не пересекаются, так что любой извлечённый токен однозначно указывает на один блок, а «recovered» или «leaked» становится точной проверкой принадлежности, а не размытой подгонкой.
Шаг извлечения и шаг оценки намеренно разделены. Node runner выводит только сырой извлечённый текст, булевы значения isProbablyReaderable и измеренную link density. Все precision и recall рассчитываются уже потом, по этому сырому тексту, отдельным скриптом и по меткам. Ни одна метрика не задаётся вручную в самом harness — только так я доверяю своим числам.
Затем я прогнал те же байты через trafilatura 2.1.0 для сравнения в том же testbed. Каждый fixture парсился три раза; все 22 раза текст был byte-identical.
Каждый этап можно проверить, а не верить только сводной таблице. tests/build_fixtures.mjs создаёт аннотированный HTML и ground truth; tests/run_readability.mjs записывает extraction и output предиктора; tests/metrics.py считает метрики уже постфактум. Сырые результаты Readability, вычисленные метрики и сравнение на одинаковом input хранятся в artifacts/raw/. Такое разделение важно, когда результат выглядит подозрительно: можно понять, вернул ли парсер неожиданный текст, ошиблась ли разметка, или же код оценки что-то неправильно классифицировал. Повторный прогон на этом наборе подтверждает изложенные здесь утверждения, но это всё ещё проверка harness'а — не доказательство того, что на реальном продакшен-трафике распределение ошибок будет таким же.
Ограничение по охвату здесь принципиально: это синтетические controlled pages, а не реальный корпус. Авторитетные цифры по реальным страницам берутся из публичного article-extraction-benchmark, где readability_js 0.6.0 — ровно та версия, что тестировалась здесь, — получает word-F1 0.947 ± 0.005 (precision 0.914 ± 0.008, recall 0.982 ± 0.003) примерно на 181 реальной странице. Я ссылаюсь на это, но не воспроизводил результат.
Здесь используются строки из бенчмарка по текущему релизу; устаревшие исторические строки исключены. Контролируемые fixture'ы дают покомпонентное разложение, показывающее, какой shape контента запускает какое правило, а не заменяют публичный real-page corpus.
В синтетическом наборе recall оказался идеальным
74 из 74. Во всех 22 fixture'ах Readability не потерял ни одного размеченного блока статьи — а на 11 чистых синтетических страницах, где статья смешивалась с boilerplate, микроусреднённый token recall составил 1.000. Ни одно предложение статьи не пропало.
К этому результату стоит добавить две оговорки:
Это чистые синтетические одноколоночные страницы. В реальных статьях структура глубже, реклама врезается прямо в середину текста, а иногда первый абзац теряется из-за артефакта скоринга — такой класс ошибок отмечен в трекере (#437, #901, а также пропуски контента до таблицы в #922). Мои fixture'ы не вызвали ни одну из этих проблем, так что я не утверждаю, что они исправлены, — я говорю лишь, что мой тест до них не дошёл. На реальных страницах recall для этой версии равен 0.982, а не 1.000.
Но именно направление результата и важно. Проблема Readability не в том, что он выбрасывает вашу статью. Проблема в том, что он прихватывает с ней лишнее.
Число precision и почему для него нужны три формулировки
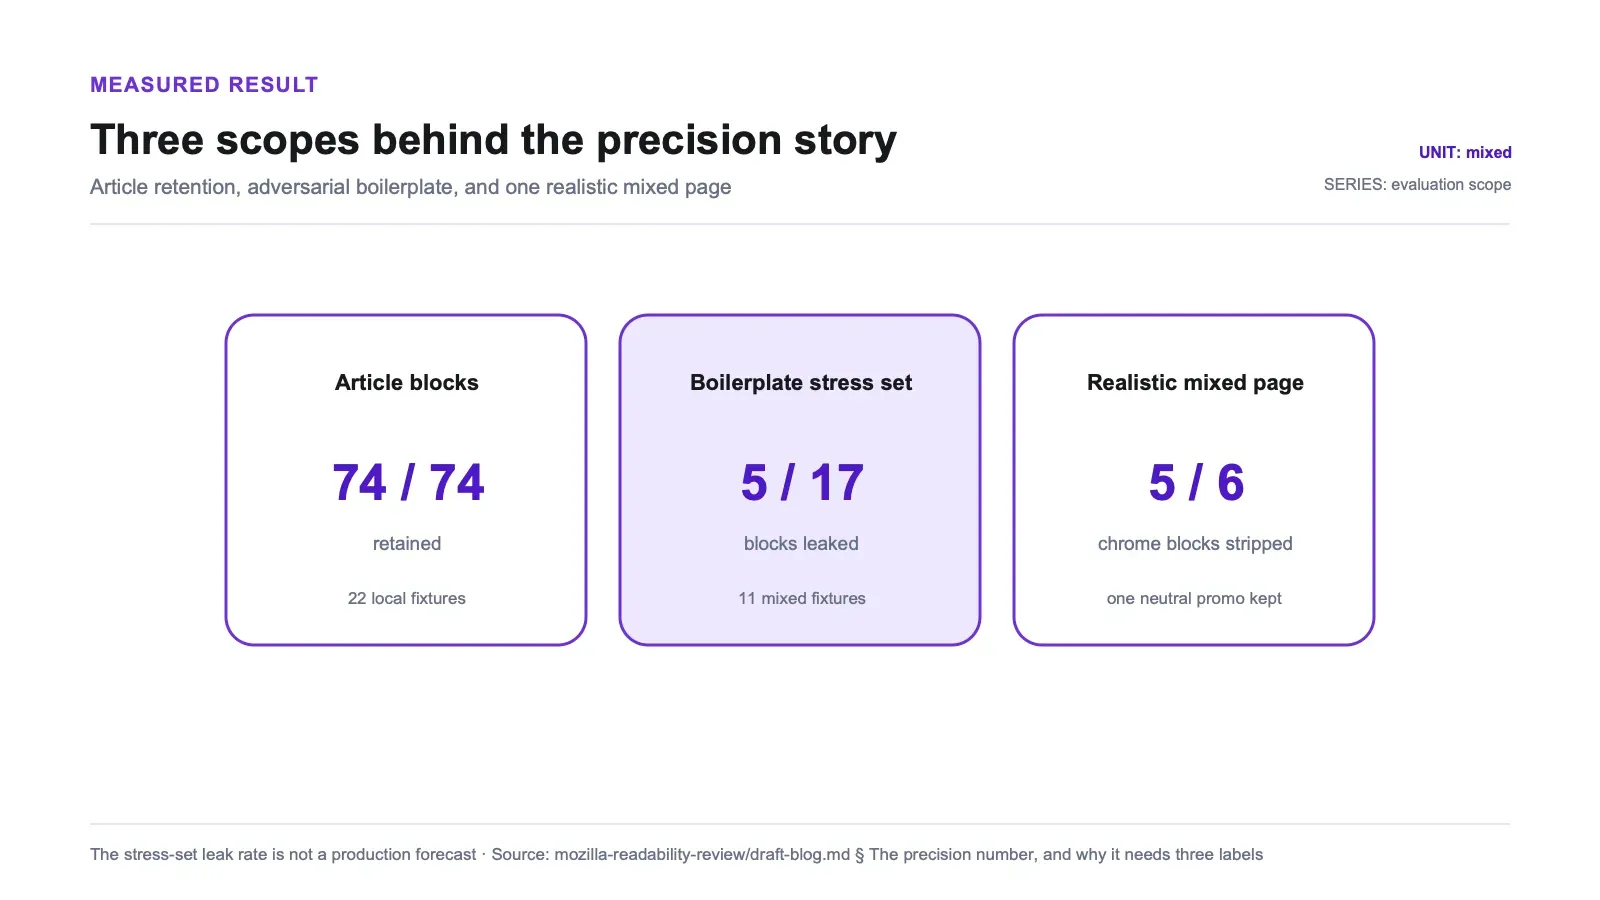
Одно число легко процитировать и трудно защитить. На 11 смешанных fixture'ах Readability сохранил 5 из 17 boilerplate-блоков — утечка 0.294.
Это не реальная утечка в продакшен-условиях. Три разных набора измеряют три разных вещи, и только один из них описывает обычные страницы:
| Что измеряет число | Результат |
|---|---|
| Набор fixture'ов с adversarial weighting — 6 из 11 смешанных страниц были специально сделаны, чтобы сломать sibling gate | 5 из 17 boilerplate-блоков сохранены (0.294) |
Одна реалистичная страница — тело в <article>, вокруг навигация, рекламный баннер, sidebar, комментарии, footer и один promo-блок без явного класса | 5 из 6 chrome-блоков удалены; 1 сохранён |
| ~181 реальная страница, публичный бенчмарк (не мой прогон) | precision 0.914, recall 0.982, word-F1 0.947 — readability_js 0.6.0 |
Первую строку следует читать как стресс-тест, а не как прогноз. Readability не «протекает» на 29% boilerplate в реальном мире. На реалистичной странице всё, что имело класс, совпадающий с regex unlikelyCandidates — nav-menu, ad-banner, sidebar, comments, site-footer — было чисто удалено, все пять блоков. Единственным выжившим оказался блок, который я специально заставил обойти этот regex.
Порог 0.25: место, где заканчивается удаление boilerplate
Правило добавления соседних блоков описано в исходниках. Но, насколько мне удалось выяснить, никто не измерял, где именно оно переключается. Поэтому я построил градиент: один нейтрально размеченный <p class="teaser-block"> вне <article>, однозначно побеждающая статья из четырёх абзацев, и менялись только длина promo-блока и его link density. Плотности считаются по формуле самого Readability и измеряются во время выполнения, а не предполагаются заранее:
| Promo-блок | Длина inner-text | Больше 80 символов | Измеренная link density | Результат |
|---|---|---|---|---|
| Без ссылок | 126 | да | 0.000 | сохранён |
| Одна короткая ссылка | 126 | да | 0.143 | сохранён |
| Одна более длинная ссылка | 126 | да | 0.278 | удалён |
| Половина текста — ссылки | 126 | да | 0.476 | удалён |
| Одно предложение, заканчивается точкой | 60 | нет | 0.000 | сохранён |
| Тот же текст, но без точки | 59 | нет | 0.000 | удалён |
В исходнике используется порог 0.25; мои измерения зажали его с двух сторон: 0.143 сохраняется, 0.278 удаляется. Отдельная ветка сохраняла предложение длиной 60 символов с точкой в конце и удаляла версию длиной 59 символов без точки. Recall статьи в каждой ветке оставался 4/4, так что эти примеры изолируют именно эффект precision.
За пределами test harness'а этот gate по сути говорит: длинный, низкоссылочный, нейтральный текст рядом со статьёй — это и есть статья. А это описывает массу вещей, которые статьёй не являются: блок «Related reading» в виде обычного абзаца, рекламный текст на подписку, заметку редактора, спонсорский тизер, который маркетинг написал полными предложениями, а ссылку убрал ради трекинга.
В RAG-индексе такой promo-абзац с низкой ссылочной плотностью может превратиться в извлечённый chunk, и тогда retrieval или generation начнут воспринимать его как часть статьи. Source rule делает такой режим отказа вполне правдоподобным; при этом в этом обзоре не проводилась end-to-end оценка retrieval или цитирования модели.
Для жёсткой site-specific фильтрации заранее отфильтровывайте известные DOM-контейнеры, сохраняйте ancestry исходного узла для сравнения до сериализации или применяйте после извлечения аккуратно проверенные текстовые фильтры. Один только возвращённый HTML уже может не показывать, находился ли узел изначально вне основного контейнера. Через публичные options этот sibling gate не настраивается.
Три предположения, которые не выдержали проверки fixture'ами
Fixture'ы опровергли три предположения: что charThreshold отбрасывает короткие статьи, что для работы нужны семантические теги и что короткий неповествовательный контент исчезает. Ниже — только существенные наблюдения; никакого preregistration здесь не требуется.
charThreshold = 500 — это не обрыв
Расхожее мнение гласит, что статья короче 500 символов вернёт null. Но это не так. Я прогнал длину body от 120 до 1500 символов при значениях charThreshold 200, 500 и 1000:
| Длина body | Парсинг успешен при каждом пороге | Длина извлечённого текста |
|---|---|---|
| 120 | да | 161 |
| 300 | да | 342 |
| 460 | да | 509 |
| 520 | да | 569 |
| 800 | да | 841 |
| 1500 | да | 1555 |
Плоско. Одинаковая длина извлечённого текста при всех трёх настройках порога и при любом размере body. Порог не решает, вернуть ли результат — он решает, повторять ли попытку с выключенной частью cleanup-флагов; на чистой странице убирать нечего, поэтому результат одинаковый в любом случае. Настоящая граница для null — это «вообще нет извлекаемого текста».
И именно это и даёт реальный сбой, причём более неприятный, чем ложный null. Я подал почти пустую страницу — nav bar и короткую четырёхсловную надпись. Она успешно распарсилась, и возвращённый «article» включал nav. Если реальной статьи нет, Readability всё равно отдаёт boilerplate, помеченный как статья. Если вы сканируете большие объёмы и считаете не-null результатом признак «на странице был контент», это ошибочное предположение.
Семантические теги тут не решают задачу
Я ожидал падения recall, когда убрал semantic scaffolding. Один и тот же текст статьи, две оболочки: в первой <main><article><h1> и говорящие имена классов, во второй <div class="x1">, а абзацы — простые <div>. Итог: 4 из 4 блоков статьи восстановлены в обоих случаях, и в обоих случаях не утёк ни один boilerplate-блок. Когда статья очевидно является самым плотным текстовым блоком на странице, скоринг по длине и запятым находит её и без семантической помощи. Фраза «Readability нужен <article>» — это миф.
Честное ограничение этой гипотезы: на странице у меня был один очевидный content block. Там, где семантика действительно могла бы помочь, — это страницы с двумя конкурирующими плотными поддеревьями, и такой tie-break я не тестировал.
Неповествовательный контент сохраняется целиком
Правило «абзацы короче 25 символов не считаются» заставляло ожидать потерь в таблицах и подписях к изображениям. И снова неверно — это правило влияет на scoring, а не на retention. Когда контейнер побеждает, всё, что внутри него, идёт вместе с ним:
| Тип контента внутри статьи | Readability | trafilatura |
|---|---|---|
| Прозаические абзацы (×2) | сохранено | сохранено |
| Ячейки таблицы данных (×2) | сохранено | сохранено |
Кодовый блок <pre> | сохранено | сохранено |
Однострочный <p> короче 25 символов (×2) | сохранено | сохранено |
<figcaption> | сохранено | удалено |
| Итого | 8/8 | 7/8 |
Вот здесь более жёсткий очиститель проигрывает. Если ваши страницы — это документация, туториалы или что-то с code blocks и подписями к иллюстрациям, поведение Readability «сохраняем всё победившее поддерево» — это плюс.
isProbablyReaderable говорит «нет», а parse() — «да`
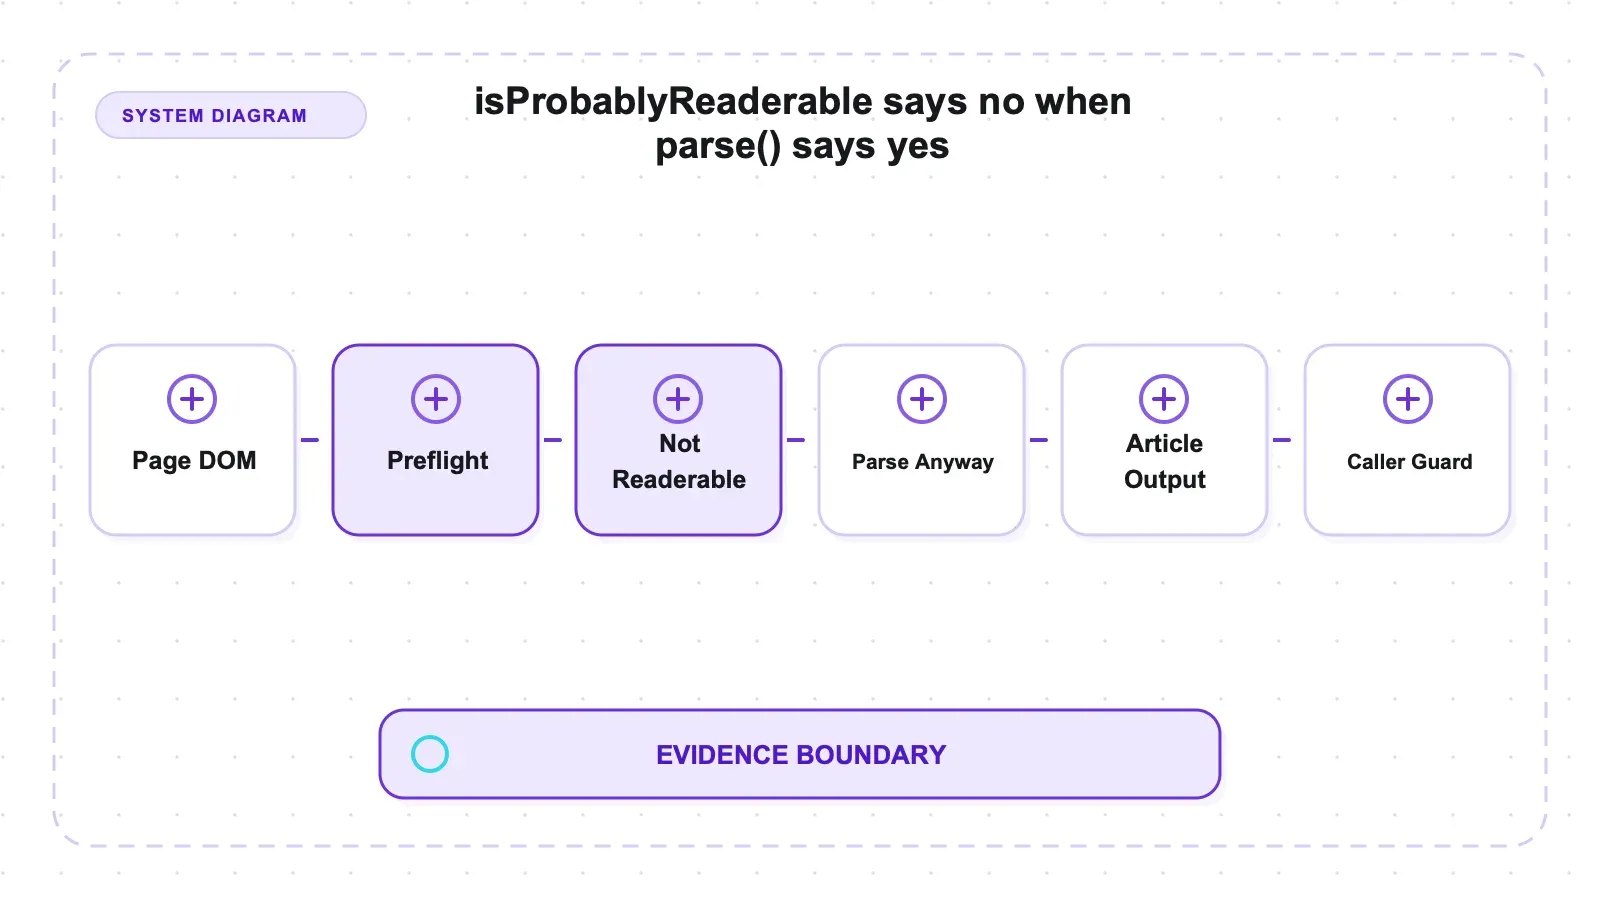
В README рекомендуется сначала вызывать isProbablyReaderable(doc) как дешёвую предварительную проверку перед полным parse. В моих тестах этот gate отбрасывал три разных формы страниц, которые затем parse() обрабатывал без проблем:
| Вид страницы | Вердикт предиктора | parse() | Что это исправляет |
|---|---|---|---|
Контент только в элементах <li> | false | успешно | ничего — false при любом minScore 1–80 и любом minContentLength 40–200 |
| Десять абзацев, каждый короче 140 символов | false | успешно | minContentLength ≤ 100 (minScore ничего не меняет) |
| Один абзац на 408 символов | false | успешно | minScore ≤ 10 (score ≈16.4) |
| Обычная статья (контроль) | true | успешно | — |
У этих трёх сбоев разные причины, и только две из них настраиваются. Случай с <li> — структурный: предиктор считает только узлы p, pre и article (плюс родительские div > br), так что страница, чей контент живёт в list items, вообще ничего не совпадает, получает ноль баллов и не восстанавливается никакой настройкой порога — такой shape уже описан в issue #662. Случай с множеством коротких абзацев — это gate minContentLength, который пропускает каждый абзац до скоринга, поэтому десять вполне содержательных абзацев в сумме дают ноль; уменьшение этого значения помогает, а minScore — нет. Случай с одним абзацем — арифметика: score равен sqrt(408 − 140) ≈ 16.4, то есть ниже стандартного minScore 20 — одиночному абзацу нужно 540 символов (140 + 20²), чтобы самостоятельно пройти порог.
В README честно предупреждают, что у предиктора бывают false negatives. Я бы добавил практическое правило: не используйте его как единственный фильтр. Если страница важна, парсите её и проверяйте длину результата. Сам parse не настолько дорог, если сравнивать с уже оплаченной вами сборкой jsdom.
Одни и те же байты, два экстрактора
Прогон trafilatura 2.1.0 по тем же самым fixture'ам читается чище, чем сравнение двух чисел, полученных на разных testbed'ах, потому что input буквально один и тот же:
| Метрика (11 смешанных fixture'ов) | @mozilla/readability | trafilatura |
|---|---|---|
| Recall блоков статьи | 1.000 | 1.000 |
| Сохранённые boilerplate-блоки | 5/17 (0.294) | 1/17 (0.059) |
| Token F1 (micro) | 0.948 | 0.969 |
| Recall неповествовательного контента | 8/8 | 7/8 |
| Очень короткая статья (120 символов), token F1 | 0.800 | 0.571 |
Ни один инструмент не доминирует во всех этих fixture'ах. Trafilatura сохранила меньше соседних блоков, тогда как Readability лучше удерживал короткий и неповествовательный контент. Абсолютный token precision у обоих инструментов занижен неразмеченным текстом заголовков, поэтому block-level leak count — более чистый прямой сигнал. Публичный real-page-бенчмарк действительно даёт схожий порядок word-F1, но корпуса и метрики разные, так что это не кросс-testbed валидация.
Надёжность, коротко: я прогнал заведомо поломанную копию канонической страницы (не закрытый <p>, перепутанные <b>/<i>, лишний </div>) — и recall остался 3/3 без утечек, как у корректной версии. За это спасибо jsdom, который чинит HTML5-дерево ещё до того, как Readability его увидит. Ни один fixture не вызвал падения парсера.
Плюсы и минусы
Плюсы
- Recall статьи — сильная сторона: 74/74 размеченных блоков восстановлены на 22 синтетических fixture'ах, token recall 1.000 на смешанном наборе.
- Блоки страницы, помеченные regex-классами, удаляются надёжно — навигация, рекламный баннер, sidebar, комментарии и footer на реалистичной странице исчезли все (5 из 6).
- Неповествовательный контент сохраняется полностью: таблицы, код в
<pre>, подписи к изображениям и строки короче 25 символов все выжили (8/8), тогда как trafilatura потеряла подпись. - Не требуется семантическая разметка — нейтральный
<div>-article оценивался так же, как версия с<article>/<main>. - Короткие статьи не отвергаются ошибочно: чистый контент восстанавливался вплоть до 120 символов, одинаково при
charThreshold200/500/1000. - Полная детерминированность: все 22 fixture'а трижды возвращали одинаковый текст.
- Установка за две минуты, Apache-2.0, а версия в npm совпадает с той, что я тестировал (0.6.0), так что здесь нет устаревших наблюдений.
Минусы
- Sibling-append gate можно обмануть: длинная, низкоссылочная, нейтрально размеченная promo-проза неотличима от текста статьи и прилипает при
linkDensity < 0.25. - На бедных по контенту страницах он возвращает boilerplate как статью, а не
null— почти пустой fixture вернулся вместе с nav bar в качестве body. isProbablyReaderableдаёт false negatives на трёх разных формах страниц, и одну из них невозможно исправить настройкой.- На runtime нужен полноценный DOM — фраза «без зависимостей» скрывает стоимость jsdom, который и доминирует в цикле.
parse()мутирует входной документ, так что DOM для каждой страницы нужно строить заново.- Никакой загрузки, никакого рендеринга JavaScript, никакого структурированного output. Это лишь один этап пайплайна, а не весь пайплайн.
- Пропуски на реальных страницах, упомянутые в трекере (начальный абзац и выпадение контента перед таблицей), на моих fixture'ах не воспроизвелись, так что я не могу сказать, редкие они или просто мои страницы до них не дошли.
Кому он подходит, а кому лучше пройти мимо
Берите Readability, если HTML уже у вас на руках и вам нужно вытащить из него статью чисто на JavaScript, внутри Node-сервиса, где добавлять Python-зависимость неудобно. (Я не собирал timing как полноценное распределение, так что скорость не оцениваю, кроме одного наблюдения: в цикле доминирует сборка jsdom, а не извлечение.) Reader mode, офлайн-архивирование статей, email-рассылки, кнопки «clean view», browser extensions, пайплайны для документации с code blocks и подписями — это именно его сценарий, и цифры recall показывают, что он там хорош. Поведение к тому же читается прямо из исходников, а это стоит больше, чем кажется, когда нужно объяснить коллеге, почему прошёл именно этот блок.
Не берите его, если вас оценивают по точности удаления boilerplate, и особенно если вы подаёте текст в LLM-index, где лишний promo-абзац потом станет retrievable chunk. Не берите его, если страницы рендерят контент на клиенте: он читает только тот DOM, который вы ему дали, и JavaScript не запускает. Не берите его, если вам нужен {title, price, sku}, а не проза — никакая настройка не превратит content extractor в schema-driven extractor. И если вы обрабатываете страницы, где вопрос «есть ли здесь вообще статья» — реальный, не доверяйте non-null как ответу.
Альтернативы и место Thunderbit в этом стеке
Это не наезд на бесплатную Apache-2.0 библиотеку, которую поддерживает Mozilla — Readability это инфраструктурный компонент, он много лет встроен в Firefox и для reader-mode extraction он неслучайно стал эталоном. Если нужен более широкий обзор, я веду сводку в обзоре open-source scrapers и более общий разбор в лучшими инструментами для web scraping.
Сравнение тех же fixture'ов для всех шести экстракторов см. в сравнении шести библиотек для extraction.
Примечание автора: Thunderbit — это наш управляемый вариант для rendering по URL и извлечения. На этих fixture'ах он не запускался, поэтому никакого заявления о совпадающем качестве здесь не подразумевается. Вопрос выбора — уже ли у вас есть DOM и нужен локальный article extraction, или вам нужны загрузка, рендеринг и structured output как сервис. Self-hosting убирает vendor usage fee, но всё равно оставляет расходы на инфраструктуру и поддержку.
Честный компромисс такой: Readability бесплатен, прозрачен и полностью в ваших руках — вы можете посмотреть на точный gate, который решил исход, а это в managed API обычно недоступно. Managed stack стоит денег и скрывает механизм, зато он закрывает стадии fetch-render-structure, которые иначе пришлось бы собирать самому. Если вам интересна AI-assisted часть этого спектра, я отдельно писал о scraping любого сайта с AI и о AI crawlers. Выбирайте по тем стадиям, которые действительно хотите контролировать сами.
Попробовать Thunderbit для извлечения веб-данных
Итог
Readability — хороший кандидат, если у вас уже есть DOM, вы работаете в JavaScript/Node и предпочитаете иногда получить лишний соседний блок, чем выкинуть нужный контент. В этом наборе fixture'ов он восстановил все 74 размеченных блока статьи и сохранил таблицы, код и подписи. Но результат ограничен синтетическими одноколоночными страницами; на реальных страницах recall равен 0.982, известные пропуски рядом с началом статьи и таблицами здесь не воспроизвелись, а на бедных по контенту страницах он может вернуть boilerplate как статью.
Просто правильно оцени слабое место. Главная зона ошибок в этих fixture'ах — precision, и она находится в конкретной, документированной строке исходников: соседний блок длиннее 80 символов и с link density ниже 0.25 будет добавлен в статью, нравится вам это или нет. Я наблюдал переключение на 0.143 против 0.278 на идентичном тексте. В real-page-бенчмарке указаны precision 0.914 и recall 0.982. Если ты отправляешь извлечённый текст в индекс, из которого модель потом будет цитировать, проверяй и сохранённый boilerplate, и пропавший body-текст, а не исходи из того, что одного из этих классов ошибок точно нет.
Попробовать Thunderbit для извлечения веб-данных Get Started Free
Часто задаваемые вопросы
Удаляет ли Mozilla Readability весь boilerplate?
Нет, и число сильно зависит от того, что именно измерять. В публичном real-page-бенчмарке readability_js 0.6.0 показывает precision 0.914 — то есть примерно 8.6% возвращаемого текста не относится к body content. На одном моём реалистичном test page он удалил 5 из 6 chrome-блоков (nav, ad, sidebar, comments, footer — всё исчезло), сохранив только promo-абзац с нейтральным классом. А в наборе fixture'ов, специально смещённом в сторону блоков, созданных для обхода heuristic'а, он сохранил 5 из 17 — но это стресс-тест, а не реальная частота.
Нужен ли jsdom, чтобы использовать readability.js в Node?
Да, либо любая другая DOM-реализация. Readability написан на чистом JavaScript, но работает с живым объектом document, так что в Node DOM нужно предоставить самому — в моём случае это был jsdom 29.1.1. Описание «без зависимостей» относится к алгоритму, а не к runtime. И ещё: parse() мутирует переданный документ, поэтому для каждой страницы лучше строить свежий DOM, а не переиспользовать один и тот же.
Что на самом деле делает опция charThreshold?
Не то, что думает большинство. Она не заставляет короткие статьи возвращать null — я извлекал чистые статьи длиной всего 120 символов, и длина результата была одинаковой при charThreshold 200, 500 и 1000. Этот порог лишь определяет, запускать ли повторный проход с отключёнными cleanup-флагами; на чистой странице убирать нечего, поэтому вывод одинаковый. Настоящий случай null — это страница без извлекаемого текста, а даже страница только с nav всё равно вернулась не-null и была воспринята как статья.
Стоит ли вызывать isProbablyReaderable перед parse()?
Используйте его как подсказку, а не как жёсткий фильтр. Он возвращал false на трёх формах страниц, которые parse() затем успешно обрабатывал: контент в <li>, десять абзацев короче 140 символов каждый и один абзац на 408 символов. Случай с <li> нельзя исправить настройкой, потому что предиктор считает только узлы p, pre и article; многократные короткие абзацы требуют уменьшить minContentLength; один длинный абзац требует снизить minScore, поскольку одиночному абзацу нужно 540 символов, чтобы пройти стандартный порог. Если страница важна, парсите её и проверяйте результат.
Readability или trafilatura для извлечения статей?
На одинаковых байтах fixture'ов trafilatura сохраняла меньше boilerplate (1/17 блоков против 5/17), а Readability лучше удерживал короткий контент и сохранил <figcaption>, который trafilatura удалила. Выбор зависит от допустимой ошибки и runtime. Публичный бенчмарк — это отдельный контекст, а не валидация именно этого fixture-результата.




