
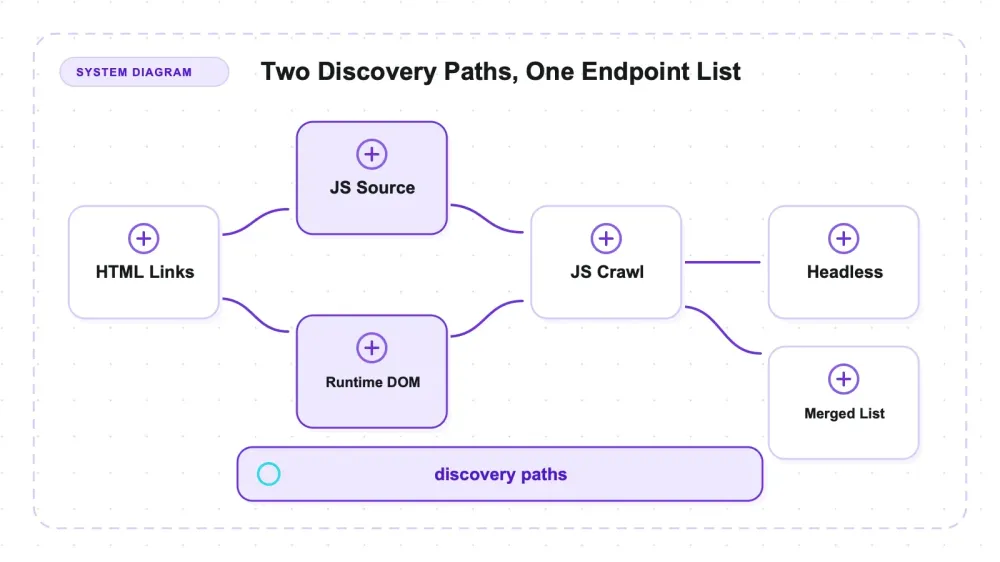
Katana — это краулер ProjectDiscovery для поиска конечных точек: Go-бинарник под лицензией MIT, который получает на вход целевой адрес и выдаёт список URL и endpoint’ов для следующего инструмента в цепочке. Он работает либо в browserless-режиме по HTTP, либо с -headless, который запускает Chromium. В официальной документации headless-подход подаётся как вариант с более широким охватом; этот тест показывает, что тип конечной точки не менее важен, чем их количество.
Я собрал небольшой сайт с тремя намеренно разными классами endpoint’ов и проверил, какой режим на v1.6.1 при -d 4 находит каждый из них. Обычный HTML дал 4/4 ссылок и полную цепочку из трёх переходов во всех четырёх конфигурациях. Разница проявилась там, где endpoint’ы были доступны либо через JavaScript-исходник, либо через изменения DOM во время выполнения.
На этом тестовом стенде headless находил класс, который появляется в runtime DOM и который пропускали проверенные browserless-режимы, а стандартный режим с -jc находил литералы в JS-файлах, которые оба headless-прогона пропускали. Ни одна строка в матрице из четырёх команд не покрывала оба класса сразу. Дополнительные практические границы задавали scope, resume и поведение known-files.
Что такое katana на самом деле
Краулер katana — projectdiscovery/katana на GitHub — написан на Go и распространяется под MIT-лицензией. Я тестировал v1.6.1 27 июля 2026 года; версия важна, потому что результаты по покрытию и known-files ниже относятся именно к этой сборке.
Здесь особенно важна сама категория инструмента. Endpoint-discovery crawler — это не инструмент для извлечения полей. Если вам нужен Go web crawler, который выдаёт названия товаров и цены в виде структурированного JSON, katana находится совсем не в том отделе — он с радостью сообщит, что /products/1138 существует, но не скажет ничего о содержимом страницы. Так и задумано, и оценивать его как инструмент для extraction — это всё равно что проверять металлоискатель по умению определять стоимость украшений.
Его родная среда — offensive security, reconnaissance и автоматизированные пайплайны: STDIN на вход, URLs на выход, дальше — в следующий инструмент. Отсюда и очевидная оговорка: все измерения здесь проводились на тестовом стенде на 127.0.0.1, который я написал сам. Запускайте katana только на тех хостах, которые вам принадлежат или на которые у вас есть явное разрешение на тестирование, и нигде больше. Речь не об обходе чьей-то защиты; речь о том, сколько endpoint-сферы сайта конкретная команда реально перечисляет.
Три режима и то, что каждый из них видит
Стандартный режим — это Go HTTP-клиент. Он скачивает страницу, парсит HTML, следует за href и никогда не запускает браузер. Быстро, дёшево, но слепо ко всему, что появляется только после выполнения JavaScript.
-jc (-js-crawl) добавляет JavaScript-парсер поверх этого browserless-пути. Он скачивает связанные .js-файлы и вытаскивает из исходника строковые литералы, похожие на URL. Без выполнения кода, только чтение. Есть ещё -jsl (jsluice), который в README описан как более тяжёлый и более прожорливый по памяти парсер — я его не тестировал, поэтому ничего не могу сказать о том, меняет ли он картину покрытия.
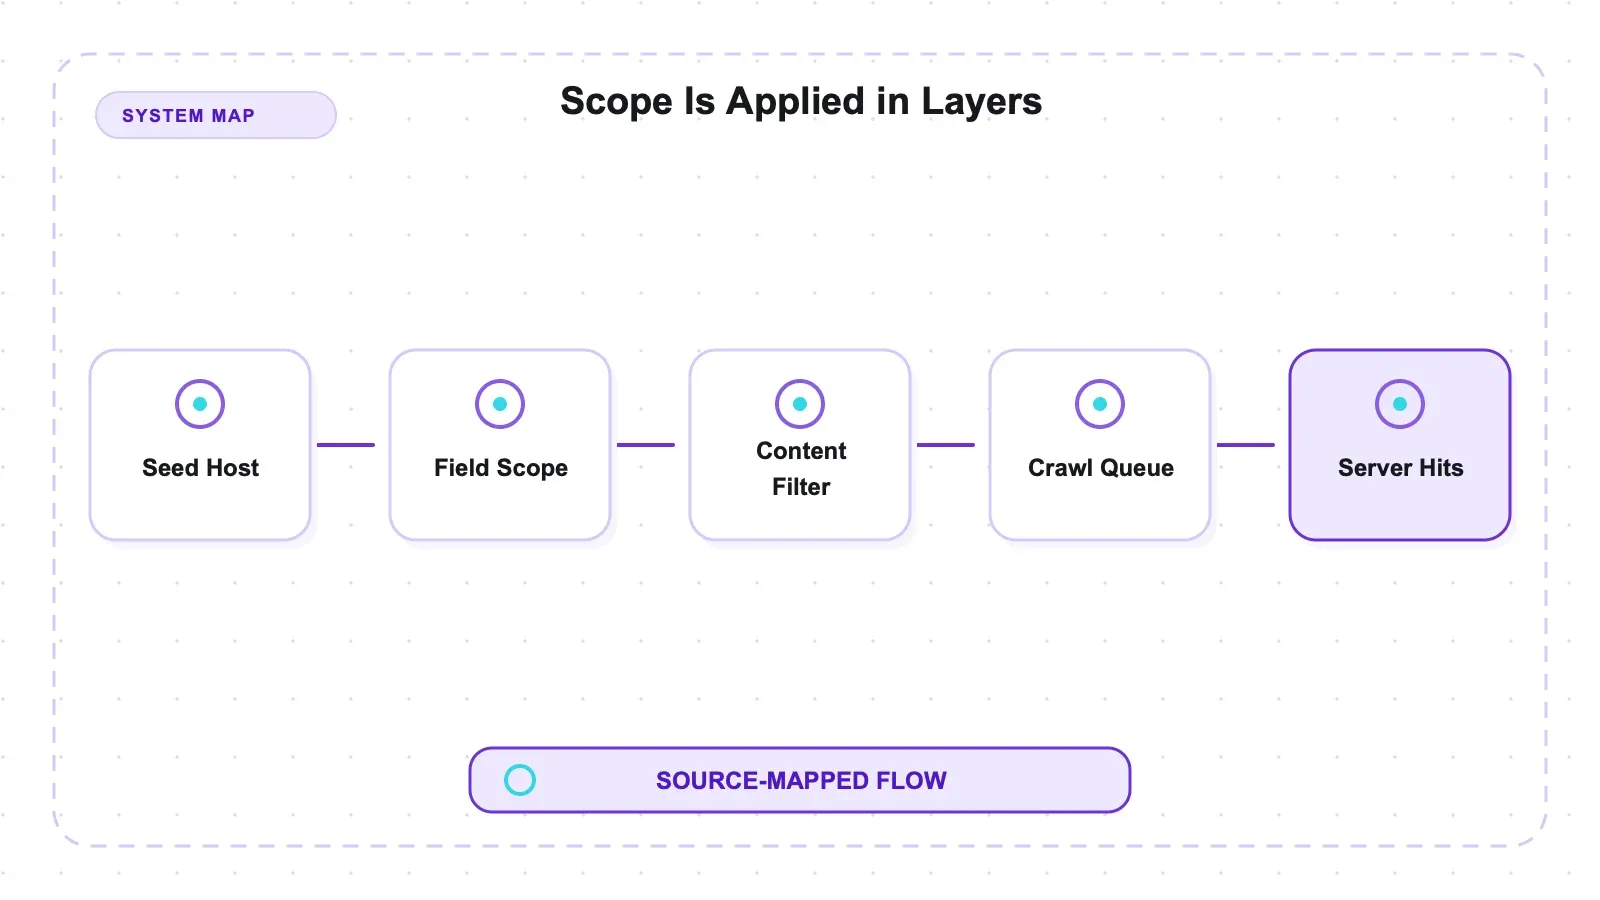
-headless запускает Chromium и исполняет скрипты страницы. На этом стенде это был единственный протестированный режим Katana, который восстановил путь, собранный из фрагментов и вставленный в runtime DOM. Этот результат не доказывает, что любой парсер или любой будущий режим Katana сможет получить то же самое.
Дальше идёт модель scope, и это как раз тот блок, который я бы запомнил до того, как вводить что-либо в продакшене.
| Flag | Что он управляет | Значения / по умолчанию |
|---|---|---|
-fs (field scope) | какие хосты участвуют | dn, rdn, fqdn или пользовательский regex — по умолчанию rdn |
-cs и -cos | URL-regex’ы, которые фильтруют внутри этого field scope | — |
-kf | known files: robots.txt и sitemap.xml | в README указано, что нужен минимум depth 3 |
-d | глубина | по умолчанию 3 |
-resume | продолжает прерванный crawl | — |
Порядок здесь не декоративный: именно он решает, расширит ли regex по хосту обход или молча сведёт его к пустому результату.
Настройка: один бинарник, одна звёздочка
Есть три способа установки, и только один из них требует toolchain:
| Способ установки | Что нужно заранее |
|---|---|
Из исходников: go install github.com/projectdiscovery/katana/cmd/katana@latest | требуется Go 1.25 или новее |
| Предсобранные бинарники на странице релиза | toolchain не нужен |
| Docker-образ | toolchain не нужен |
У меня он оказался в ~/go/bin/katana и при каждом запуске сообщал Current version: v1.6.1. Пока что это классическая приятная история Go: один файл, без runtime-обвязки.
Звёздочка касается headless-режима, где браузер — это отдельная зависимость, не входящая в сам бинарник:
Где запускается -headless | Что ему нужно |
|---|---|
| На моей машине | katana сам нашёл уже установленный Chromium; версию браузера я не фиксировал и путь к нему не задавал |
| На пустом сервере, по инструкции проекта для Ubuntu | перед headless нужно выполнить apt install google-chrome-stable |
| Через Docker | headless запускается с -system-chrome |
На голом сервере это удобство исчезает. Как только -headless появляется в командной строке, закладывайте бюджет не только на бинарник, но и на браузер.
Есть ещё одна мелочь, которую стоит знать, если вы запускаете это в CI: katana при старте делает version-check запрос в GitHub. -duc отключает его. На ноутбуке это шум; на air-gapped или rate-limited runner’е это лишний сетевой round trip на каждый запуск. В моих замерах использовался -duc, чтобы цифры отражали именно crawling, а не телефонный звонок домой.
Как я это тестировал
Три класса endpoint’ов, подобранные специально так, чтобы режимы расходились. Всё находится на локальном тестовом сервере, а ground truth был зафиксирован до запуска любого crawl, так что recall измеряется относительно заранее заданного набора, а не того, что katana случайно вывел в stdout.
- Класс A — обычный HTML.
/page/a,/page/b,/page/c, плюс цепочка из трёх переходов/depth/1 → /depth/2 → /depth/3. Любой краулер должен это находить. - Класс B — литералы в JS-файле.
/api/js-endpoint-7и/api/js-endpoint-8существуют только как строковые литералы внутри подключённого/static/app.js. Их можно прочитать без браузера, если кто-то вообще читает JS. - Класс C — только runtime DOM. Путь собирается во время выполнения из фрагментов (
'endpoint' + (6 * 7)) и вставляется в DOM скриптом. Строка/runtime-only/endpoint42нигде не встречается подряд ни в одном байте, который отправляет сервер — ни в HTML, ни в JS-исходнике. Только выполнение кода раскрывает её.
Плюс robots.txt, sitemap.xml с двумя <loc> endpoint’ами, которых больше нигде нет, маршрут, возвращающий 500, битая ссылка и ссылка вне scope, ведущая на второй сервер под другим hostname.
Не менее важен и сам инструмент измерения: сервер считает что реально было запрошено, поэтому выводы по scope и resume опираются на фактические хиты, а не на stdout katana. Сырые прогоны лежат в репозитории benchmark’ов, если хотите проверить арифметику.
Разрыв в покрытии, который никто обычно не считает
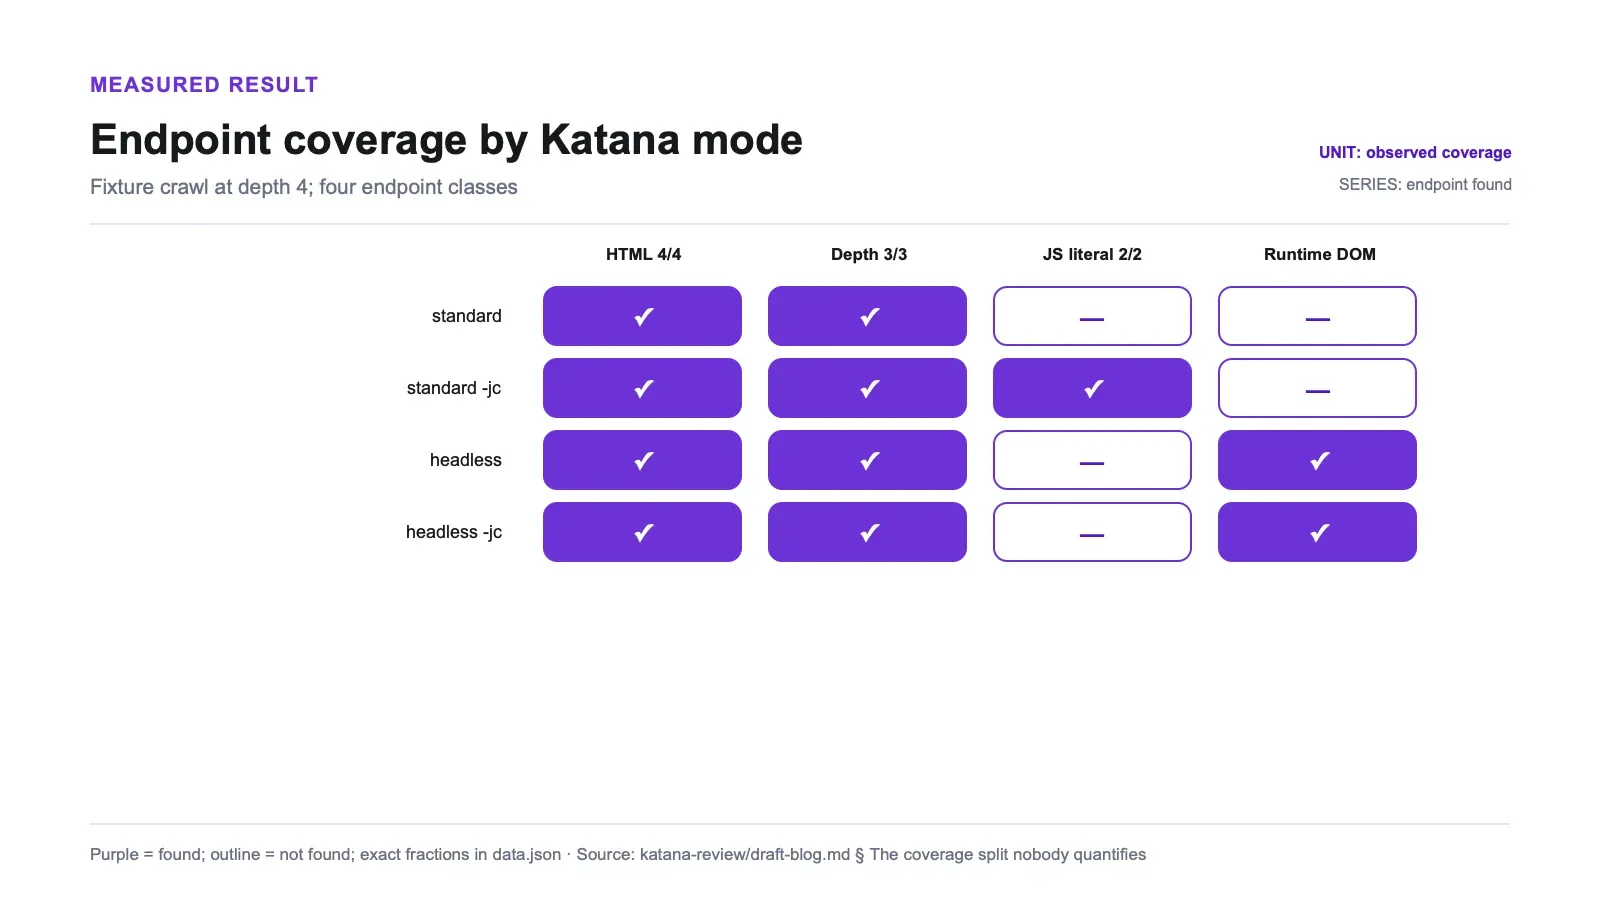
Матрица по режимам и классам endpoint’ов при -d 4:
| Режим | HTML-ссылки (A) | Depth-chain (A) | JS-file literals (B) | Runtime-DOM (C) |
|---|---|---|---|---|
| standard | 4/4 | 3/3 | 0/2 | not found |
standard -jc | 4/4 | 3/3 | 2/2 | not found |
-headless | 4/4 | 3/3 | 0/2 | found |
-headless -jc | 4/4 | 3/3 | 0/2 | found |
Если читать два последних столбца как пару, проблема сразу бросается в глаза. Класс B нашёл только один вариант — стандартный режим с -jc. Класс C нашли только два варианта — оба headless-прогона. Строки, где были бы хиты в обоих столбцах, нет. Полная матрица лежит в discovery-summary.json, где вычисляемое поле headless_jc_covers_both равно false.
Практический вывод такой: формула «просто используйте headless для лучшего покрытия» для этого теста неполная. Headless не добавил класс B поверх стандартного результата; он восстановил класс C, но пропустил класс B. Чтобы покрыть все заложенные в этот стенд классы, потребовались два crawl’а и merge:
katana -u https://target.example -jc -d 4 -silent -o pass-jc.txt
katana -u https://target.example -headless -d 4 -silent -o pass-headless.txt
sort -u pass-jc.txt pass-headless.txt > endpoints.txt
Строка -headless -jc — та, по которой мне больше всего хотелось бы получить ответ upstream. Добавление JavaScript-парсера к headless-запуску ничего не дало — всё ещё 0/2 по классу B в каждом прогоне, включая свежую повторную проверку. Я сообщаю поведение, а не утверждаю, что понял механизм; я не встраивался внутрь katana, чтобы выяснить, почему browser-path перестаёт приносить JS-file literals. Воспринимайте это как воспроизводимое наблюдение и хороший повод для GitHub issue, а не как диагноз. (И ещё деталь рядом: комбинация -hl -jc завершалась корректно с кодом возврата 0 на v1.6.1 под macOS ARM, хотя исторически это было не всегда так.)
Официальная документация описывает headless как вариант с лучшим покрытием, и здесь он действительно помог для runtime-rendered класса. Однако в проверенной документации не был явно описан этот split между source-literal и runtime-DOM, поэтому воспринимайте матрицу как повод проверить оба пути на своих классах endpoint’ов, а не как универсальную таксономию.
Сколько headless стоит по времени
Три последовательных прогона каждого режима на почти пустой машине:
| Режим | p50 | min–max | mean |
|---|---|---|---|
| standard | 13.08s | 13.07–13.17s | 13.11s |
-headless | 66.82s | 66.78–67.68s | 67.09s |
Это соотношение 5.1x, и интервалы даже близко не пересекаются — мой самый медленный standard-прогон (13.17s) всё равно был быстрее самого быстрого headless-прогона (66.78s) более чем на 53 секунды (cost-summary.json). Это не шум измерений.
Одно замечание по этим 13 секундам: мой стенд специально содержит маршрут с 500 и битую ссылку, и standard-режим тратит на обе стандартный хвост -timeout 10 с ретраями. Я не подкручивал timeout, чтобы приукрасить быстрый режим; значит, при тонкой настройке gap у standard, скорее всего, стал бы ещё больше, а не меньше.
Это соотношение — локальный сигнал о ёмкости, а не прогноз для продакшена. Реальные цели отличаются по latency, ошибкам, выполнению скриптов и планированию, а этот стенд включает стандартный таймаут-хвост. Используйте измеренную разницу 5.1x, чтобы решить, нужен ли headless отдельный бюджет и отдельный поднабор целей, а затем проверьте этот план на representative authorized hosts.
Scope выдержан, но один флаг молча ничего не сделал
Для теста scope использовались два сервера: основной на 127.0.0.1 и второй, доступный как localhost на другом порту и обслуживающий путь, который существует только там. Поэтому hit по этому пути доказывает, что out-of-scope host действительно был запрошен, а не просто напечатан.
| Конфигурация | Out-of-scope host был запрошен? | Хиты на втором сервере |
|---|---|---|
default (-fs rdn) | no | 0 |
-fs fqdn | no | 0 |
-cs localhost | no | 0 |
| `-fs '(127.0.0.1 | localhost)'` | yes |
Дисциплина scope — это хорошая новость: по умолчанию katana оставался в рамках, а расширение требовало явного действия. Для инструмента, который направляют на чужую инфраструктуру, это правильное поведение по умолчанию.
Самая интересная строка — -cs localhost. Она не расширила crawl до второго хоста — и при этом вывела вообще ноль URL. Поскольку -cs фильтрует внутри field scope, а field scope всё ещё был привязан к основному хосту, regex ничего не совпал, и crawl вернул пустой набор вместо ошибки. Если вы когда-либо писали regex области обхода, называя хост, который хотели включить, и смотрели на пустой output-файл, вот в чём дело (scope-summary.json). Чтобы добавить хост, задавайте -fs. Чтобы сузить уже имеющиеся хосты, используйте -cs/-cos.
Resume крупнее, чем кажется по флагу
В README флаг описан как -resume string resume scan using resume.cfg, что звучит так, будто файл лежит в рабочем каталоге. Но это не так. На моей машине checkpoint записывался в ~/.config/katana/resume-<xid>.cfg — я это измерил, а не прочитал на странице документации, потому что путь там не указан.
Внутри оказался более важный сюрприз. Файл содержал map InFlightUrls ровно с одним элементом: seed URL. Ни visited set, ни frontier. Вот что произошло, когда я прервал crawl сигналом SIGINT через три секунды и затем возобновил его:
| Прогон | Уникальных путей |
|---|---|
| Полный baseline crawl | 11 |
| Получено до прерывания | 10 |
| Повторно получено при resume | все 11, включая все 10, которые уже были завершены |
Resume вышел на тот же финальный набор endpoint’ов, так что ничего не сломано. Но granularity checkpoint’а — на уровне seed input, а не на уровне URL — in-memory dedup-фильтр не сохраняется, поэтому при возобновлении single-seed crawl снова обходится этот seed с нуля (resume-summary.json). Если вы подаёте katana список из 500 хостов, resume должен сэкономить вам те хосты, которые полностью завершились; такое поведение при multi-seed следует из того, как хранится состояние, но я измерял только single-seed случай. Если вы глубоко обходите один огромный сайт, resume даёт вам корректность, а не экономию времени.
Known files: запросили, но потом бросили
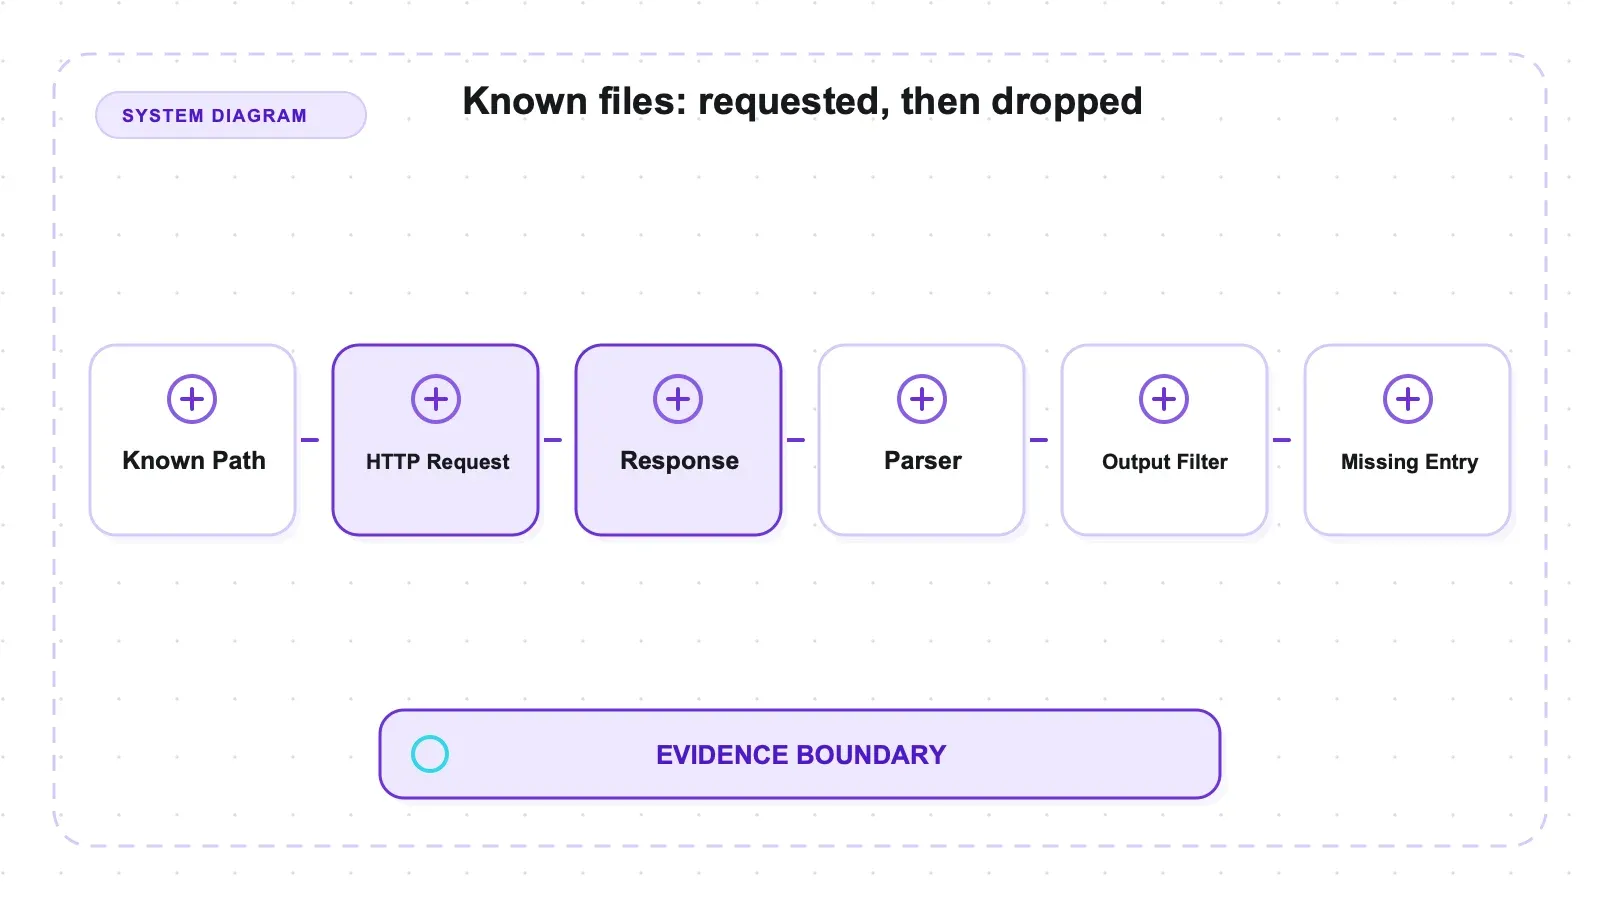
-kf all -d 3 действительно запросил оба файла — robots.txt и sitemap.xml появились в server hit log — а затем восстановил 0 из 2 endpoint’ов, перечисленных в <loc> элементах этой sitemap. Recall 0.0.
Прежде чем записать это в ограничение инструмента, я попытался убедиться, что проблема не на моей стороне. Во всех вариантах было одно и то же:
| Что пробовал | Восстановленные endpoint’ы из sitemap <loc> |
|---|---|
-kf all | 0/2, recall 0.0 |
-kf sitemapxml | 0/2, recall 0.0 |
-kf robotstxt | 0/2, recall 0.0 |
| depth 3 | 0/2, recall 0.0 |
| depth 4 | 0/2, recall 0.0 |
| depth 5 | 0/2, recall 0.0 |
с добавленным -jc | 0/2, recall 0.0 |
прямой seed на /sitemap.xml | 0/2, recall 0.0 |
Документированное требование — использовать -kf и идти минимум на три уровня глубины — было выполнено каждый раз. Так что это не история про забытый флаг.
Сначала идёт полезное решение: на этом IP-literal стенде не стоит автоматически считать, что запрос known files означает, будто URL’ы из <loc> действительно попали в crawl. Проверьте recall или извлеките и подайте эти URL’ы самостоятельно.
Путь в коде v1.6.1 согласуется с этим наблюдением, хотя во время прогона я его не инструктировал. В sitemapxml.go на v1.6.1 функция NewNavigationRequestURLFromResponse строит navigation request’ы для <loc> из ответа без заполненного RootHostname. Затем запрос проходит в ValidateScope; в scope.go на v1.6.1 ветка для IP-literal сравнивает host URL с этим пустым root и может его отклонить. Команда с пользовательским -fs '(127.0.0.1|localhost)' пошла по другой ветке scope в отдельном тесте, так что это предсказанное исходником спасение, а не измеренный обход -kf. Попытка подтверждения была заблокирована периодическими проблемами с dialing в known-files client на этом хосте; поэтому результат остаётся 0/2.
Что бы я сделал в продакшене до получения подтверждения по флагу: сам скачал бы sitemap, вытащил из него <loc> URL’ы и передал их katana как seed list. Две строки shell, без участия scope validation.
Один момент вёл себя именно так, как обещано, и заслуживает отдельного предложения: маршрут с 500 и битая ссылка были запрошены, залогированы и просто пропущены дальше. Все browserless-прогоны завершились с кодом возврата 0. Краулер, который ломается на первом плохом ответе, бесполезен без присмотра, а katana так себя не ведёт.
Проверка покрытия под конкретную цель перед развёртыванием
Матрица из тестового стенда полезна прежде всего как шаблон для проверки собственных авторизованных целей. До запуска Katana определите классы endpoint’ов: обычные ссылки, литералы в подключённых скриптах, маршруты, создаваемые только после выполнения кода, и записи из known files — это четыре разумные стартовые категории. Для каждой категории держите небольшой набор ground truth. Без такого списка более объёмный stdout-файл может выглядеть как лучшее покрытие, даже если какая-то категория просто исчезла.
Сначала измеряйте browserless и headless как два отдельных прогона. Сохраняйте точные команды, версию Katana, сборку браузера, коды возврата и output. Нормализуйте и сравнивайте наборы endpoint’ов, а не количество строк. Если standard -jc на вашем образце ничего уникального не даёт, headless-only политика может оказаться достаточной; если наборы расходятся, как здесь, держите оба прохода отдельно и объединяйте результаты после сбора. Добавлять оба флага в одну команду не следует считать эквивалентом объединения, пока target-specific diff этого не подтвердит.
Проверяйте scope по evidence вне stdout Katana. Поставьте canary URL на хост, который должен остаться исключённым, и смотрите request log на том сервере. Если обход должен расширяться на второй хост, протестируйте и его. Здесь прогон -cs localhost дал пустой output, потому что content-scope filtering не расширил field scope; пользовательский запуск -fs '(127.0.0.1|localhost)' действительно обратился ко второму серверу. Фиксировать точное регулярное выражение важно, потому что изменение на один символ может поменять не только отображение, но и сам regex.
Тестируйте прерывание и known files отдельно от recall по discovery. Для resume прервите representative seed после нескольких страниц, сохраните путь к сгенерированному checkpoint и посчитайте, сколько уже завершённых URL’ов будет запрошено снова. Для -kf проверьте и то, что robots/sitemap были запрошены, и то, что заложенные <loc> URL’ы действительно были поставлены в очередь. Это разные утверждения. В этом стенде файлы были получены, но два sitemap endpoint’а отсутствовали, поэтому для понимания границы нужны были и logs запросов, и output endpoint’ов.
Наконец, зафиксируйте локальный baseline по стоимости на последовательных прогонах на почти пустой машине, а затем повторите замер на representative hosts. Сохраняйте min, max и median, а не только коэффициент. Фигура 5.1x здесь включает поведение этого стенда при ошибках и таймаутах; она говорит вам, что headless заслуживает отдельного бюджета, но не сообщает, сколько времени займёт production inventory.
Плюсы и минусы
Плюсы:
- Идеальный recall на обычном HTML во всех режимах — 4/4 ссылок и полная цепочка 3/3, без какой-либо настройки.
-jcдействительно работает без браузера: 2/2 endpoint’ов восстановлены из строковых литералов в подключённом JS-файле, без стоимости браузера.-headless— единственное, что нашло endpoint, собранный во время выполнения — класс, который по определению невидим для source parsing.- Scope по умолчанию консервативен. Out-of-scope host не был запрошен ни в default, ни при
-fs fqdn, ни при-cs. - Один Go-бинарник, MIT-лицензия, предсобранные сборки и Docker-образ, pipeline-friendly I/O.
- Устойчивость к ошибкам: 500-ответы и битые ссылки не останавливают crawl.
Минусы:
- Ни один одиночный запуск не покрыл одновременно JS-file и runtime-DOM endpoint’ы. Для полного покрытия нужны два прогона и merge.
-jcничего не дал в сочетании с-headless— 0/2 по классу B в каждом headless-прогонах.- Headless стоит примерно в 5.1 раза дороже по времени (66.82s против 13.08s p50, без пересечения диапазонов).
-resumeповторно обходит уже завершённые страницы внутри одного seed. Он восстанавливает набор endpoint’ов, а не ваше затраченное время.- Known files запросили robots.txt и sitemap.xml, но восстановили 0/2 sitemap
<loc>endpoint’ов на IP-цели. - Для headless тихо нужен Chromium на машине; история про «один бинарник» заканчивается на браузере.
- Только discovery. Никакого структурированного extraction, никакого преобразования контента, никакой схемы полей.
Не тестировались, а значит, не входят в покрытие этих цифр: -jsluice, отдельный тест cutoff по глубине на -d 1/-d 2, multi-seed resume, автоматическое заполнение форм и любой реальный JavaScript-heavy или защищённый production-сайт. Все цифры получены на одной машине (macOS arm64) на локальном тестовом стенде.
Для кого это и кому стоит пройти мимо
Если ваша задача — собрать inventory endpoint’ов для инфраструктуры, к которой у вас есть разрешение на доступ, у katana правильная форма пайплайна: STDIN/STDOUT, переносимый бинарник, browserless и browser-backed режимы. Двухпроходное объединение оказалось необходимым для заложенных в этот стенд классов; нужно ли оно для ваших целей — это уже надо проверять на representative pages.
Пропустите его, если вам нужны данные, а не адреса. Katana никогда не выдаст вам таблицу товаров; он выдаёт URL’ы, где товары могут находиться, а извлекает данные кто-то другой. Пропустите его и в том случае, если вам нужна одна команда, которая делает всё до конца — двухпроходное объединение вполне удобно в пайплайне, но раздражает в интерактивной строке. И если ваша enumerация опирается на sitemap <loc> endpoint’ы при работе с IP-целями, проверьте, что именно вы получаете, прежде чем доверять output, потому что на моём стенде этот путь ничего не дал.
Альтернативы и граница extraction
Katana бесплатный, с MIT-лицензией и self-hosted. Он оставляет discovery, выбор режима, развёртывание браузера и объединение результатов на вашей стороне границы.
В open source полезнее сравнивать инструменты по задаче, а не по языку. Colly — это другой вариант на Go, но он представляет собой библиотеку, которую вы компилируете со своими callback’ами, и JavaScript он вообще не рендерит. Crawl4AI запускает настоящий браузер и выдаёт Markdown для LLM-пайплайнов — это уже совсем другой формат результата. Если вы выбираете сразу между несколькими инструментами, наш обзор open-source scraper’ов раскладывает категории рядом друг с другом.
Раскрытие информации: Thunderbit — продукт издателя и в этом тесте Katana не проверялся. Он относится к категории managed extraction downstream, превращая страницы в текст или структурированные записи, а не перечисляя endpoint-сферу авторизованной цели. В одном workflow могут использоваться обе категории, но этот обзор даёт доказательства только поведения Katana в discovery.
Попробовать Thunderbit для извлечения веб-данных
Итог
Используйте katana, когда конечный результат — список endpoint’ов для целей, которые вам разрешено сканировать, и когда вы можете проверить покрытие режимов на этих целях. В этом стенде standard -jc восстановил заложенные JS-file literals, а headless восстановил runtime-DOM endpoint; проверенные browserless-режимы Katana этот runtime-path не нашли. Scope по умолчанию также не запрашивал второй хост, а browserless-прогоны проходили мимо 500 и битой ссылки.
Ограничения здесь операционные: для смешанных классов endpoint’ов может понадобиться двухпроходное объединение, headless занял примерно в пять раз больше локального времени, resume для одного seed повторно запросил уже завершённые пути, а recall по known-files на IP-цели составил 0/2. Это результаты стенда v1.6.1, а не гарантия для любого сайта. Но их достаточно, чтобы определить проверки, которые стоит повторить в production-оценке.
Попробовать Thunderbit для извлечения веб-данных Get Started Free
FAQ
Где katana хранит файл resume и пропускает ли он страницы, которые я уже обошёл?
Checkpoint оказался в ~/.config/katana/resume-<xid>.cfg, а не в resume.cfg в рабочем каталоге, как можно подумать по help-тексту флага. И нет, завершённые страницы он не пропускает: файл хранит только in-flight seed URL’ы, поэтому при возобновлении single-seed crawl снова запрашиваются все 11 базовых путей, включая 10 уже завершённых. Финальный набор endpoint’ов тот же, но время не экономится.
Почему -kf all запросил мой sitemap.xml, но не обошёл URL’ы внутри него?
Для IP-цели такой результат согласуется скорее с границей scope validation, чем с ошибкой флага. В коде v1.6.1 парсер sitemap у Katana строит каждый <loc> request без передачи root hostname, а DNS-scope check для IP-literal hosts затем может отклонить этот URL; во время прогона я этот механизм не инструктировал и не подтверждал. На всех вариантах флага, глубины и seed’ов, которые я пробовал, recall оставался 0. Пользовательский host regex в -fs проходит по другой ветке валидации, и исходник подсказывает, что именно он должен помочь — но на моей машине я не смог подтвердить это на -kf, поэтому относитесь к этому как к непроверенной гипотезе. Самостоятельно извлечь <loc> URL’ы и подать их в katana как seed list — это подход, которому я бы доверял сегодня.
Что нужно сохранять при отчёте о тесте покрытия Katana?
Фиксируйте точную версию Katana и команду, включая побитово точное выражение -fs; определяйте классы endpoint’ов до запуска; сохраняйте server-side hit logs вместе со stdout; и отделяйте измеренное поведение от гипотез, основанных на исходниках. Для headless-прогонов дополнительно фиксируйте сборку браузера — в этом тесте этого сделано не было, что ограничивает воспроизводимость.
Стоит использовать -jc, -headless или оба?
Выбор зависит от тех классов endpoint’ов, которые вам нужны. В этом стенде standard -jc нашёл литералы, хранящиеся в JS-файле, а headless — endpoint, вставленный в runtime DOM. Ни один режим по отдельности не покрыл оба класса, поэтому для смешанных целей обоснованным выбором был двухпроходный запуск с дедупликацией.
Остановит ли crawl одна ошибка URL? В этом контролируемом прогоне — нет. Katana продолжал работу после ответа 500 и после битой ссылки и всё равно вернул остальные достижимые пути. Но это не заменяет production error accounting: ведите логи неудачных запросов и задавайте допустимый уровень ошибок, чтобы частично успешный crawl не был принят за полное покрытие.




