
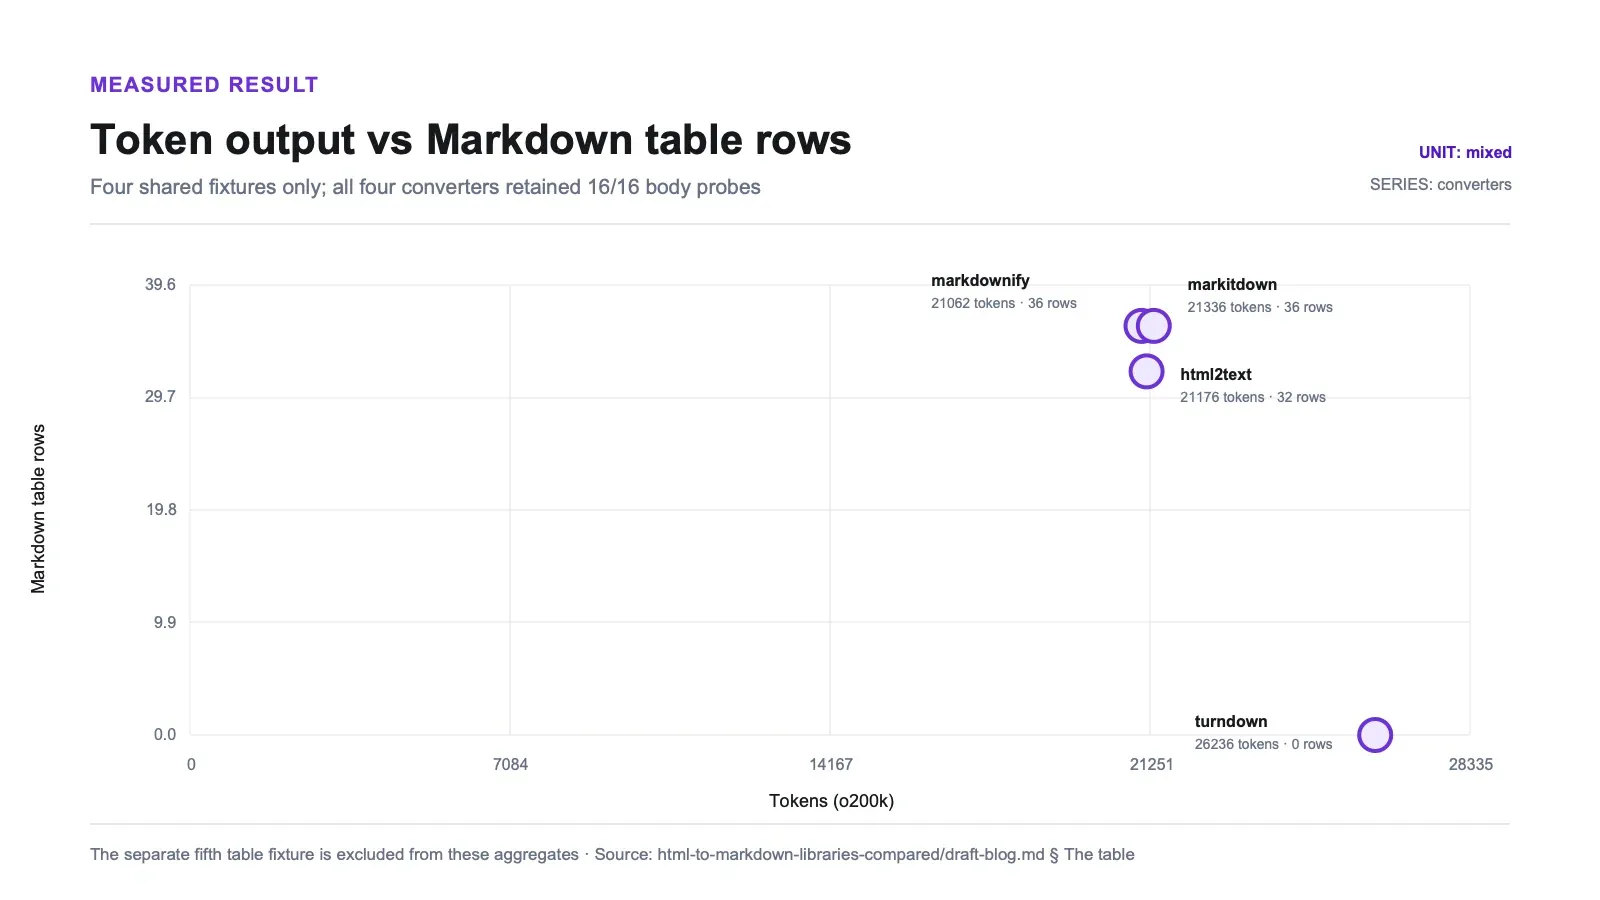
turndown оказался самым популярным по числу звёзд из четырёх протестированных библиотек на момент снимка метаданных: у него 11 386 звёзд на GitHub. На четырёх общих HTML-примерах он по умолчанию сгенерировал 0 Markdown-таблиц и использовал на 24,6% больше токенов, чем markdownify при тех же входных данных.
При этом все четыре решения восстановили все проверочные фрагменты текста. Разница — полностью в том, что происходит со структурой, и во что эта структура обходится дальше.
Что измеряли и на каких примерах
У этой базы исследования уже был набор для markitdown с пятью HTML-файлами и заранее зарегистрированными контрольными строками — точными фрагментами текста, за сохранением которых следили, а также служебными строками для выявления «обвязки» страницы. Для сводного сравнения используются четыре общих для всех конвертеров примера: каталог книжного магазина, сайт с цитатами, таблица хоккейной статистики и статья Википедии про веб-скрапинг. Пятый пример, Nothing but tables, используется только как отдельный тест с упором на таблицы и не входит в сводные 24,6%.
Четвёрка участников: turndown 7.2.4 (Node), markdownify 1.2.3, html2text 2025.4.15 и markitdown, где использованы опубликованные показатели без изменений. Страницы: каталог книжного магазина, сайт с цитатами, таблица хоккейной статистики и статья Википедии о веб-скрапинге.
Ниже все названия метрик совпадают с собственными полями артефактов markitdown, поэтому строки можно ставить рядом без попытки свести разные определения одного и того же термина.
Таблица
| Конвертер | Проверки текста | Длина результата | Токены (o200k) | Байтов на токен | Строки Markdown-таблиц | Ссылки |
|---|---|---|---|---|---|---|
| turndown | 16/16 | 95,188 | 26,236 | 3.63 | 0 | 611 |
| markdownify | 16/16 | 76,868 | 21,062 | 3.65 | 36 | 599 |
| html2text | 16/16 | 76,452 | 21,176 | 3.61 | 32 | 545 |
| markitdown | 16/16 | 76,995 | 21,336 | 3.61 | 36 | 598 |
Четыре примера — те же, что использовались и для markitdown. Полные данные по каждому примеру находятся в fiveway-scores.json. Токены считались через o200k_base; строки таблиц markitdown пересчитывались из его собственного сохранённого Markdown тем же счётчиком, что и у остальных.
Сохранение текста — ничья. Все шестнадцать контрольных фрагментов текста в четырёх примерах прошли через каждый конвертер. Если вам важно только «дойдёт ли текст», любой из этих четырёх отвечает «да».
Со структурой — уже не ничья. На четырёх общих примерах markdownify и markitdown оба выдают по 36 строк Markdown-таблиц; html2text — 32; turndown — ни одной. В отдельном диагностическом примере, где были почти одни таблицы, markdownify выдал 62 строки, а html2text — 59; эти строки не входят в итоговую сводку выше.
Стоимость в токенах у turndown выше на 24,6%, и причина не в таблицах. Сначала я думал именно так, но покадровые цифры показывают другое — об этом ниже.
Что turndown делает с таблицей
Ниже — пример с хоккейной статистикой, те же строки, показанные тремя способами.
turndown:
Team Name

Year

Wins

Losses

Boston Bruins

1990

44

24
markdownify:
| Team Name | Year | Wins | Losses | ... |
| --- | --- | --- | --- | --- |
| Boston Bruins | 1990 | 44 | 24 | ... |
html2text:
Team Name  |  Year  |  Wins  |  Losses  | ...
---|---|---|---|---
Boston Bruins  |  1990  |  44  |  24  | ...
Все значения переживают преобразование turndown, поэтому он и получает 16/16 по проверкам. Но при этом теряется принадлежность каждого значения конкретному столбцу. Если читать результат turndown, число 44 — это просто число на строке; восстановить, что это количество побед Boston, нельзя без подсчёта позиций и надежды на то, что ни одна ячейка не пустая. В этом примере некоторые ячейки действительно пустые, так что даже подсчёт позиций не спасает.
Для модели, которая читает такой вывод, это разница между таблицей, по которой можно отвечать на вопросы, и списком чисел, по которому она будет лишь гадать.
Это не столько дефект, сколько известное ограничение: базовая версия turndown не обрабатывает таблицы, а для этого существует turndown-plugin-gfm. Но в стандартную установку он не входит, а 11 386 звёзд намекают, что очень многие пользуются именно дефолтной конфигурацией.
Откуда на самом деле берётся разница в токенах
Параграф выше я написал, исходя из предположения, что разрыв в 24,6% объясняется расплющенными таблицами, которые превращаются в длинный текст. Но когда я посмотрел на цифры по каждому примеру отдельно, оказалось, что это не так.
| Пример | токены turndown ÷ токены markdownify |
|---|---|
| Сайт с цитатами (без таблиц) | 0.99× |
| Каталог книжного магазина | 1.06× |
| Хоккейная статистика (одна большая таблица) | 1.37× |
| Wikipedia (в основном текст, 9 строк таблицы) | 1.29× |
| Только таблицы | 0.78× |
В примере, где были только таблицы, turndown оказался на 22% экономичнее — потому что и сама Markdown-обвязка из вертикальных черт тоже занимает токены, а turndown её вообще не генерирует. То есть простое «сплющивание таблицы» само по себе не означает перерасход токенов.
На статью Википедии приходится 74% общего веса, и там всего девять строк таблицы. Разрыв в 15 378 символов не может быть объяснён таблицами. Дело вот в этом:
(function(){var className="client-js vector-feature-language-in-header-enabled…
.mw-parser-output cite.citation{font-style:inherit;word-wrap:break-word}…
(RLQ=window.RLQ||[]).push(function(){mw.config.set({"wgHostname":"mw-web…
turndown не вырезает содержимое <script> и <style>. markdownify и html2text — вырезают. Если считать по маркерам, встречающимся только внутри этих элементов, то у turndown в выводе набирается 10 маркеров script и 84 маркера style по всем примерам; у двух других — ноль и там, и там. На странице Википедии восемь строк встроенного JavaScript и CSS от MediaWiki дают 14 644 символа — 95% всего разрыва (script-style-stripping.json).
Вот это и есть вывод, на который я бы реально опирался. Сплющенная таблица — это проблема структуры, которую видно сразу. А вот JavaScript-конфиг в Markdown — это чистые издержки без всякой полезной информации, и на реальной странице он перекрывает вообще всё остальное в этом сравнении.
html2text пишет таблицы, которые можно не узнать
html2text получил 32 строки там, где markdownify и markitdown — 36, а первая версия моего счётчика присудила ему всего 1.
Это была ошибка моего правила подсчёта, а не библиотеки. html2text выводит Team Name | Year | Wins без внешних вертикальных черт — это нормальный вариант Markdown-таблицы, но для регулярки, которая требует ^\|.*\|$, он невидим. Я написал именно такую регулярку, запустил её и уже был готов заявить, что html2text таблицы не умеет.
Но умеет. Исправленный счётчик использует эвристику: последовательность строк с вертикальными чертами и строкой-разделителем внутри. По этому правилу html2text поднимается с 1 до 32. Это всё ещё не полноценный Markdown-парсер, так что числа строк нужно воспринимать как измерения по явно описанному счётчику, а не как универсальный результат рендеринга.
Это полезно знать, если вы сами потом прогоняете Markdown через регулярки: две из этих четырёх библиотек ставят внешние вертикальные черты, а одна — нет.
Про лицензию, о которой обычно забывают
| Конвертер | Лицензия | Установка | Холодный импорт | Звёзды | Последний релиз |
|---|---|---|---|---|---|
| turndown | MIT | 3 npm-пакета, 8,8 МиБ | 0,056 с | 11 386 | 2026-04-03 |
| markdownify | MIT | 5 пакетов, 1,8 МиБ | 0,046 с | 2 235 | 2026-06-30 |
| html2text | GPL-3.0-or-later | 1 пакет, 0,2 МиБ | 0,077 с | 2 168 | 2025-04-15 |
| markitdown | См. метаданные пакета | В этом запуске не измерялось | Не измерялось | — | — |
install-and-import.json. Каждая библиотека устанавливалась в собственное пустое окружение. Лицензии подтверждены по трём источникам: метаданным в реестре, репозиторию GitHub и файлу METADATA самого установленного пакета, где указано License-Expression: GPL-3.0-or-later.
Самая лёгкая библиотека в этом сравнении по установке — 1 пакет, 0,2 МиБ — распространяется под GPL-3.0-or-later. Насколько это критично для проекта, зависит от того, как именно софт объединяется и распространяется. Рассматривайте это как этап проверки для того, кто отвечает за лицензирование; это не юридическая консультация. markitdown здесь отмечен как не измерявшийся, потому что его установка и лицензия не были зафиксированы именно этим артефактом.
Такой компромисс легко упустить, потому что лицензия — это единственное свойство, которое не видно в бенчмарке.
При этом все три решения заметно легче, чем библиотеки для извлечения статей из той же категории — те занимают от 21 до 70 МиБ. Конвертер — гораздо более лёгкая сущность, чем экстрактор, и это стоит отдельно учитывать в бюджете зависимостей.
Две ошибки, которые пришлось исправить, прежде чем таблица стала честной
Цифры выше — уже третья версия. Первые две были неверны по причинам, которые стоит назвать, потому что обе легко воспроизвести.
Пять примеров против четырёх. markitdown обработал только четыре из этих пяти файлов; остальные три инструмента — все пять. Если суммировать результаты каждого инструмента по своему набору, markdownify получал 98 строк таблиц против 36 у markitdown, и это выглядело как разрыв в возможностях. Но если сравнивать одни и те же четыре, получается 36 против 36 — абсолютная ничья. Пятый пример как раз и был самым «табличным», так что ошибка пошла в худшую сторону: завышала новичков относительно действующего решения почти в три раза.
Два счётчика, одна колонка. Опубликованное у markitdown поле md_table_rows считалось его собственным кодом, который я не читал. Сравнивать это число с моим было бы всё равно что сравнивать два разных счётчика, а не два конвертера. Markdown-вывод хранится у него на диске, так что исправление было таким: прогнать один и тот же счётчик по всем четырём — и когда я это сделал, пересчёт markitdown в точности совпал с его опубликованным значением по каждому примеру (0, 0, 27, 9). Определения совпали; я просто не мог знать этого без проверки.
Обе ошибки не видны в готовом выводе. Обе дали бы уверенную, но неправильную таблицу.
Кому что подходит
Если вы кормите модель или сохраняете структурированный контент со страниц вроде этих? Начните с markdownify. По нашему счётчику он делит с markitdown лидерство по числу строк таблиц, попадает в нижний кластер по токенам, имеет лицензию MIT и ставится всего в 1,8 МиБ. Но обязательно проверьте его на ваших собственных типах страниц, прежде чем стандартизировать.
Если вам важен размер зависимостей до килобайтов, и вы ничего не распространяете? html2text. Один пакет, 0,2 МиБ, таблицы сохраняются. Сначала проверьте вопрос с GPL и помните, что последний релиз был в апреле 2025 года.
Если вы уже работаете в Node-стеке? turndown, но вместе с turndown-plugin-gfm — и обязательно убирайте <script> и <style> из HTML до передачи, потому что turndown этого не делает. Эти два пропуска стоят четверть лишних токенов и структуру таблицы, а без просмотра вывода это не заметно.
Если вы уже конвертируете другие форматы документов? markitdown умеет PDF, Office и многое другое, а его HTML-результат вполне конкурентен со специализированными конвертерами. Иногда одна зависимость вместо двух — это уже плюс.
Где здесь место для управляемого API
Все четыре инструмента работают только с HTML, который у вас уже есть. Ни один не забирает страницу сам, не рендерит JavaScript и не проходит антибот-защиту — а для многих реальных сайтов это как раз более сложная половина задачи.
Наш собственный стек для разработчиков в Thunderbit закрывает именно эту часть. POST /distill принимает URL и возвращает чистый Markdown, готовый для LLM, с уже выполненными рендерингом и загрузкой страницы; POST /extract возвращает структурированный JSON, согласованный с вашей JSON Schema, — это уже другой формат результата, то есть строки вместо Markdown-таблицы, которую потом пришлось бы парсить. Оба варианта доступны через MCP-сервер и CLI (npx @thunderbit/thunderbit-cli). Цены указаны на странице тарифов Thunderbit.
Честное сравнение такое: если HTML уже у вас на руках и вам нужен Markdown, markdownify бесплатен и хорошо справляется, а эта таблица показывает, какие из его конкурентов тоже справляются. Если же вам нужно сначала получить страницы, или нужны структурированные строки, а не текст — это уже другая покупка.
Для более широкого обзора у нас есть подборка web scraping API с облачными вариантами и основная статья про open-source scraper о self-hosted решениях. Как конвертировать HTML в Markdown на Python — это практический разбор, а что именно пытается стандартизировать llms.txt — про то, куда движется весь этот класс решений.
Попробовать Thunderbit для извлечения веб-данных
Итог
Для этой нагрузки из четырёх примеров лучший вариант по умолчанию — markdownify: тот же результат по числу строк таблиц, что и у markitdown, если считать по общему счётчику; токенов — всего на 1,3% больше, чем у других эффективных конвертеров; лицензия MIT; установка занимает 1,8 МиБ.
Именно разрыв между популярностью и измеренным поведением здесь и есть главный вывод. turndown — отличная библиотека, которую очень многие поставили без плагина, отвечающего за таблицы, и это проявляется как четверть лишних токенов и структура таблицы, которой больше не существует. Ни одна из этих цифр не видна, пока вы их не посчитаете.
Если запомнить только одно: прежде чем доверять выходу конвертера модели, проверьте, что он делает с таблицей. Три из этих четырёх решений ведут себя разумно. Самое популярное — нет, если вы не попросили его отдельно.
Попробовать Thunderbit для извлечения веб-данных Get Started Free
Часто задаваемые вопросы
Правда ли, что turndown не поддерживает таблицы?
В базовой версии — да. Таблицы добавляет turndown-plugin-gfm, отдельный пакет, а обычный npm install turndown его не включает. Без плагина каждая ячейка проходит как отдельный абзац — значения остаются, а связи между строками и столбцами исчезают. На четырёх примерах это дало 0 Markdown-таблиц и на 24,6% больше токенов, чем у markdownify при том же содержимом.
Почему сначала казалось, что у html2text нет таблиц?
Потому что мой счётчик требовал внешние вертикальные черты, а html2text их не выводит. Team Name | Year | Wins — это корректный Markdown и он рендерится нормально; просто это другой стиль по сравнению с | Team Name | Year |. Исправленный счётчик ищет последовательность строк с вертикальными чертами и строкой-разделителем, как это сделал бы парсер, и тогда html2text поднимается с 1 до 32 строк. Если вы сами постобрабатываете Markdown регулярками, именно на этом различии можно споткнуться.
GPL у html2text — это действительно проблема?
Зависит от того, как вы объединяете и распространяете софт. GPL-3.0-or-later может накладывать обязательства, которых нет у MIT, поэтому перед выбором для распространяемого продукта подключите того, кто отвечает за лицензирование. Это не юридический совет, а контрольная точка по комплаенсу; лицензию подтвердили по метаданным реестра, репозиторию и файлу METADATA установленного пакета.
Насколько эти токены показательны для других страниц?
Разрыв в 24,6% в основном связан с тем, что turndown оставляет содержимое <script> и <style>, так что масштаб зависит от того, сколько такого кода есть на странице — много на современном CMS-сайте, почти ноль на статической странице. Таблицы работают в другую сторону: в примере, где были только таблицы, turndown оказался на 22% дешевле, потому что не генерирует pipe-обвязку. Байтов на токен у всех четырёх было в диапазоне 3,61–3,65, то есть плотность вывода одинаковая, а отличается именно объём. Если число важно для бюджета, измерьте свой собственный корпус.
Что здесь не тестировали?
Реальное разнообразие — четыре примера это всё-таки четыре примера. Вложенные списки, списки определений, сноски и формулы. Некорректный HTML, где конвертеры традиционно расходятся сильнее всего. Обратную конвертацию Markdown обратно в HTML. docling, у которого на диске есть те же примеры, но в опубликованном запуске не выводятся эти поля, поэтому он здесь отсутствует, а не оценён приблизительно. И конфигурацию: html2text запускался с body_width=0, потому что его значение по умолчанию 78 принудительно переносит каждую строку, а это изменило бы все символы и все токены в этой таблице.




