
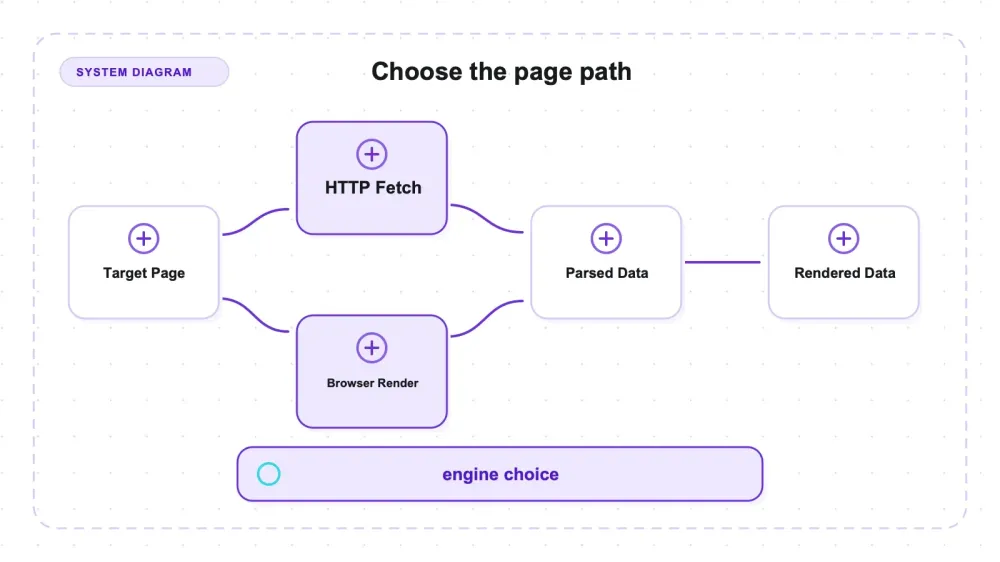
Чем Crawlee на деле удобен, так это тем, что его оркестрация обхода поддерживает и HTTP-разбор, и запуск в браузере. Поэтому один и тот же URL может дать разные результаты — всё зависит от выбранного краулера и от того, когда страница считается готовой.
На публичной странице Quotes to Scrape JS CheerioCrawler нашёл 0 нужных цитат, а PlaywrightCrawler — 10 после ожидания .quote. Жизненный цикл обхода в целом похож, но это не была простая замена одного класса на другой в одну строку: в обработчике Cheerio использовался $, а в обработчике Playwright — page, явное ожидание и извлечение данных уже на стороне браузера.
Что такое Crawlee на самом деле
Crawlee (проект apify/crawlee, версия 3.17.0) — это библиотека для веб-скрапинга и автоматизации браузера для Node.js и TypeScript. Она поддерживает HTTP-обход на базе Cheerio или JSDOM, а также браузерный обход на базе Playwright или Puppeteer. Проект распространяется под лицензией Apache-2.0; перед использованием в своём продукте проверьте уведомления и требования по указанию авторства.
Главная ментальная модель здесь — разделять «получить страницу» и «прочитать страницу». Первый путь скачивает сырой HTML и не выполняет JavaScript. Второй запускает Chromium и может исполнять скрипты страницы, но ему всё равно нужно корректное условие готовности; при этом он всё ещё может не увидеть контент, который появляется только после взаимодействия, ленивой загрузки, в shadow DOM, из-за неудачного API-запроса или из-за антибот-защиты. Crawlee даёт сопоставимые жизненные циклы для этих двух путей, но это не взаимозаменяемые DOM-примитивы.
Именно это важно понять до того, как ты напишешь хоть один селектор: выбор между этими двумя движками решает, вернёт ли твой скрапер данные или пустоту на конкретном сайте.
Ключевые возможности: два движка, один API
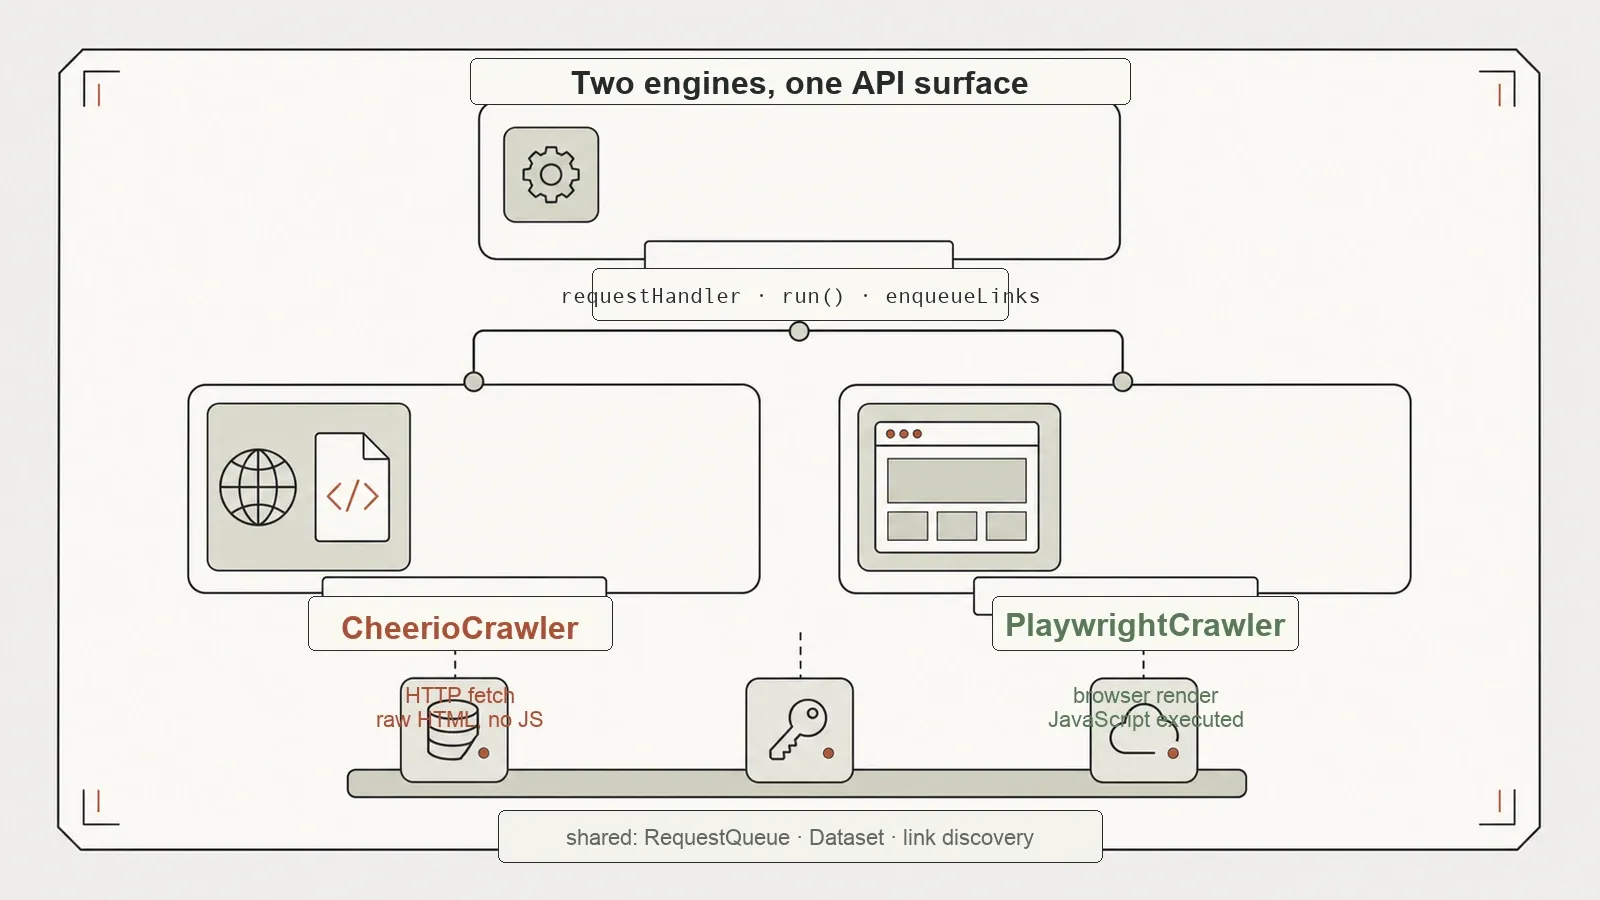
CheerioCrawler загружает HTML и парсит его через Cheerio; PlaywrightCrawler управляет Chromium и умеет делать скриншоты. Оба используют requestHandler, имеют run() и разделяют общие концепции обхода, такие как очереди и обнаружение ссылок. Но контекст обработчика у них разный: в протестированном Cheerio-пути данные извлекались через $, а в браузерном — через page, waitForSelector и $$eval. Основа очереди и жизненного цикла может остаться знакомой, но код извлечения нередко придётся адаптировать или переписать.
Под капотом Crawlee даёт всю инфраструктуру, которая нужна реальному обходу. RequestQueue управляет фронтиром URL-адресов, устраняет дубликаты и отслеживает выполненные запросы. enqueueLinks находит и ставит в очередь новые URL (с фильтрацией по селектору и по тому же хосту), чтобы обход мог разрастаться сам. Dataset собирает извлечённые записи для экспорта. По умолчанию Crawlee сохраняет всё это локально в папку storage/ на диске — удобно для возобновления работы, и немного раздражает в первый раз, когда в проекте неожиданно появляется папка storage/ (в моём тестовом окружении запись перенаправлялась во временную директорию, а сохранение на диск было отключено, чтобы тест оставался чистым).
Каждый из этих элементов сам по себе не выглядит чем-то особенным. Суть в том, что они общие для обоих движков: очередь, обнаружение ссылок и набор данных работают одинаково, независимо от того, обходишь ли ты сайт по HTTP или через браузер. Ты изучаешь один API и получаешь два способа загрузки страниц.
Настройка: браузер, который ставится отдельно
В проверенной установке после установки пакетов исполняемый файл Chromium не был включён автоматически.
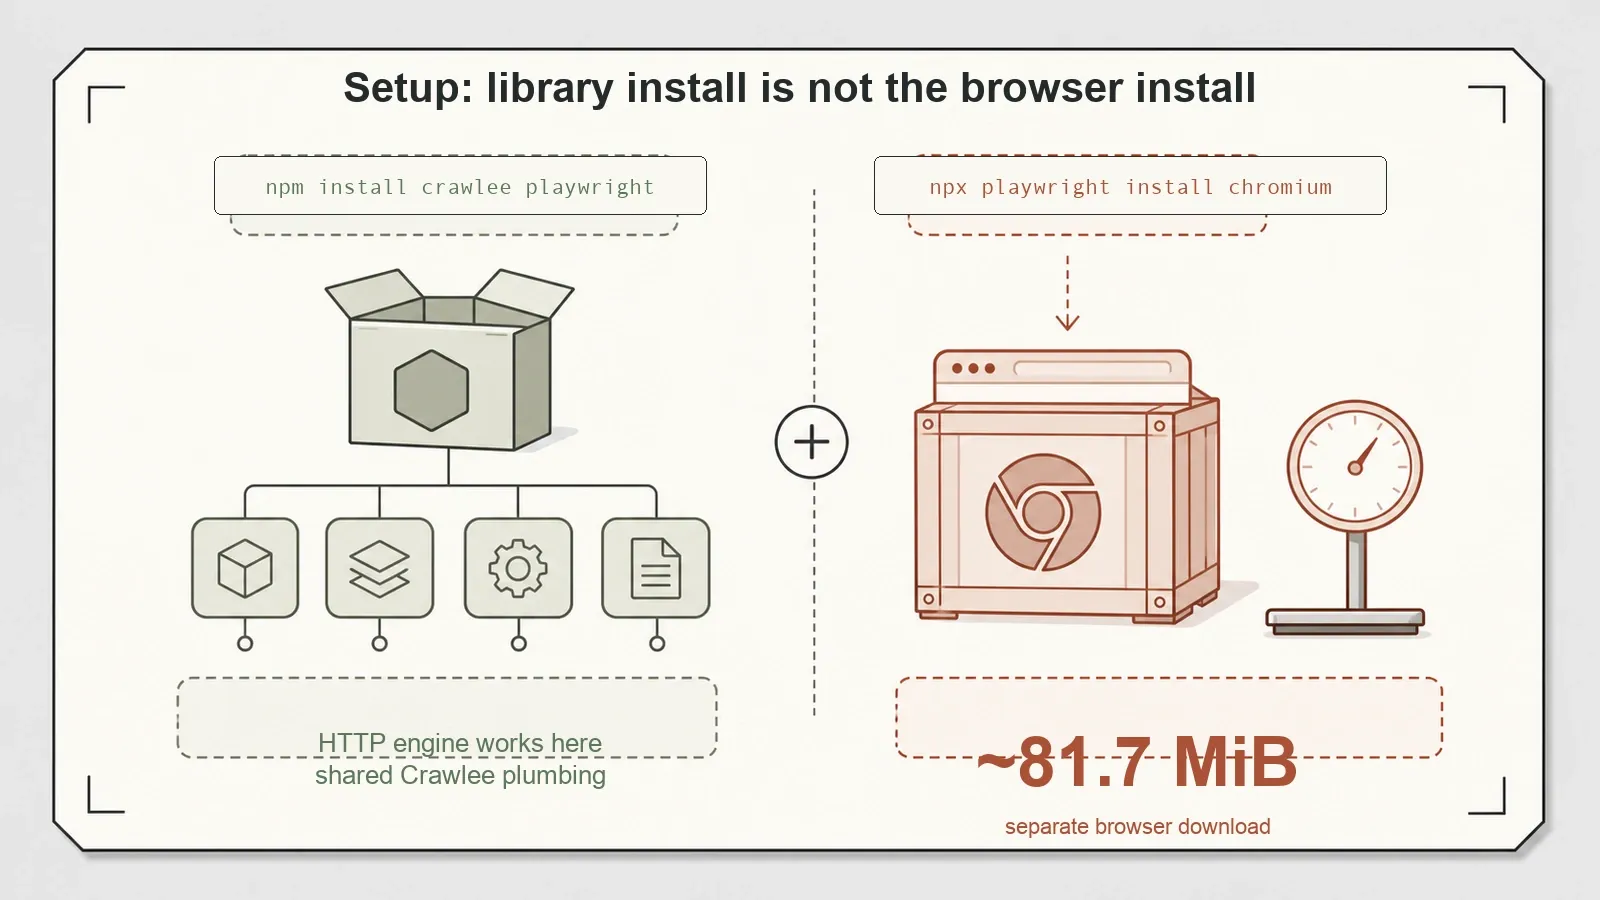
npm install crawlee playwright у меня установился без проблем — 85 пакетов, 0 уязвимостей, всё спокойно. Если на этом остановиться и запустить CheerioCrawler, всё будет работать, потому что HTTP-обходу браузер не нужен.
В этом окружении Chromium пришлось ставить отдельно через npx playwright install chromium; без этого PlaywrightCrawler не запускался. По наблюдениям, размер браузерной нагрузки был примерно 82 МиБ, но в исходных заметках не зафиксировано, шёл ли речь о размере загрузки или о размере на диске. Это наблюдение относится к конкретной машине, а не является фиксированным свойством продукта. Путь установки и поведение пакетов могут меняться, поэтому в этой статье не утверждается, что пропуск браузера всегда одинаков или навсегда не документирован.
Планируй тестовую установку как два шага: сначала установи Node-пакеты, затем установи браузер, который использует путь Playwright. Перед развёртыванием перепроверь актуальные инструкции по настройке Crawlee и Playwright для нужных версий и платформы.
Практика: одна и та же страница, два очень разных ответа
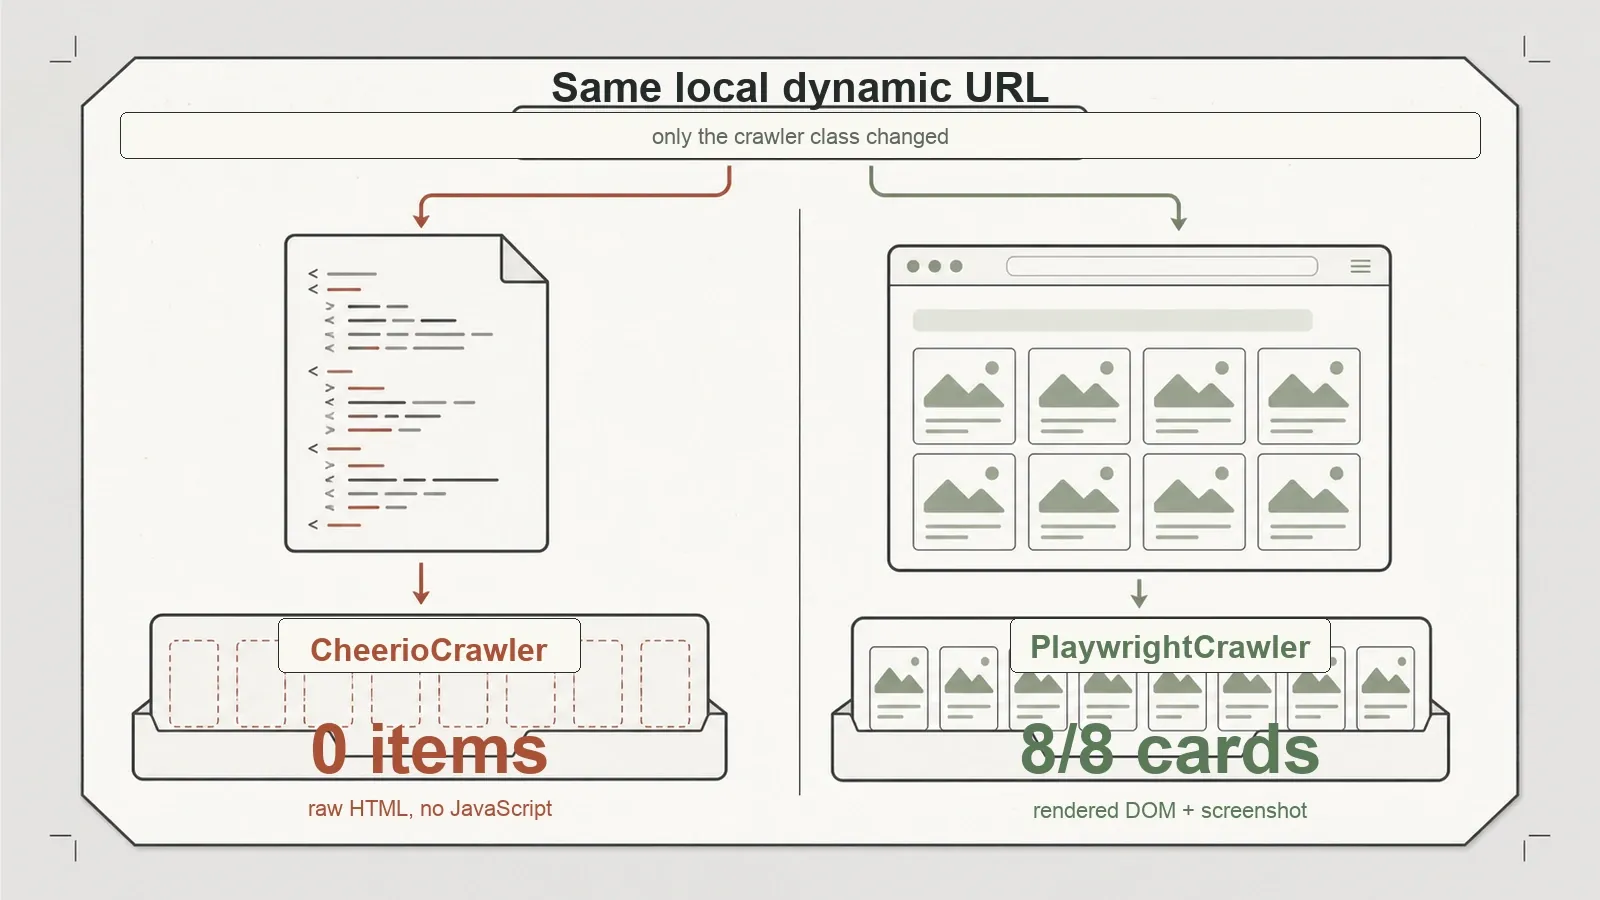
В основном тесте один и тот же JavaScript-рендеренный пример прогонялся через оба краулера. URL и целевые поля были одинаковыми; примитивы извлечения — нет.
На локальном примере CheerioCrawler вернул 0 целевых карточек, потому что в сыром HTML их не было. PlaywrightCrawler дождался #dynamic-products article.product-card, а затем вернул все 8 ожидаемых карточек и сделал скриншот. Этот результат подтверждает полноту нужных полей на уровне фикстуры после указанного ожидания; он не означает, что браузер видит абсолютно любое состояние страницы. Исходники и скриншот лежат в репозитории бенчмарка.
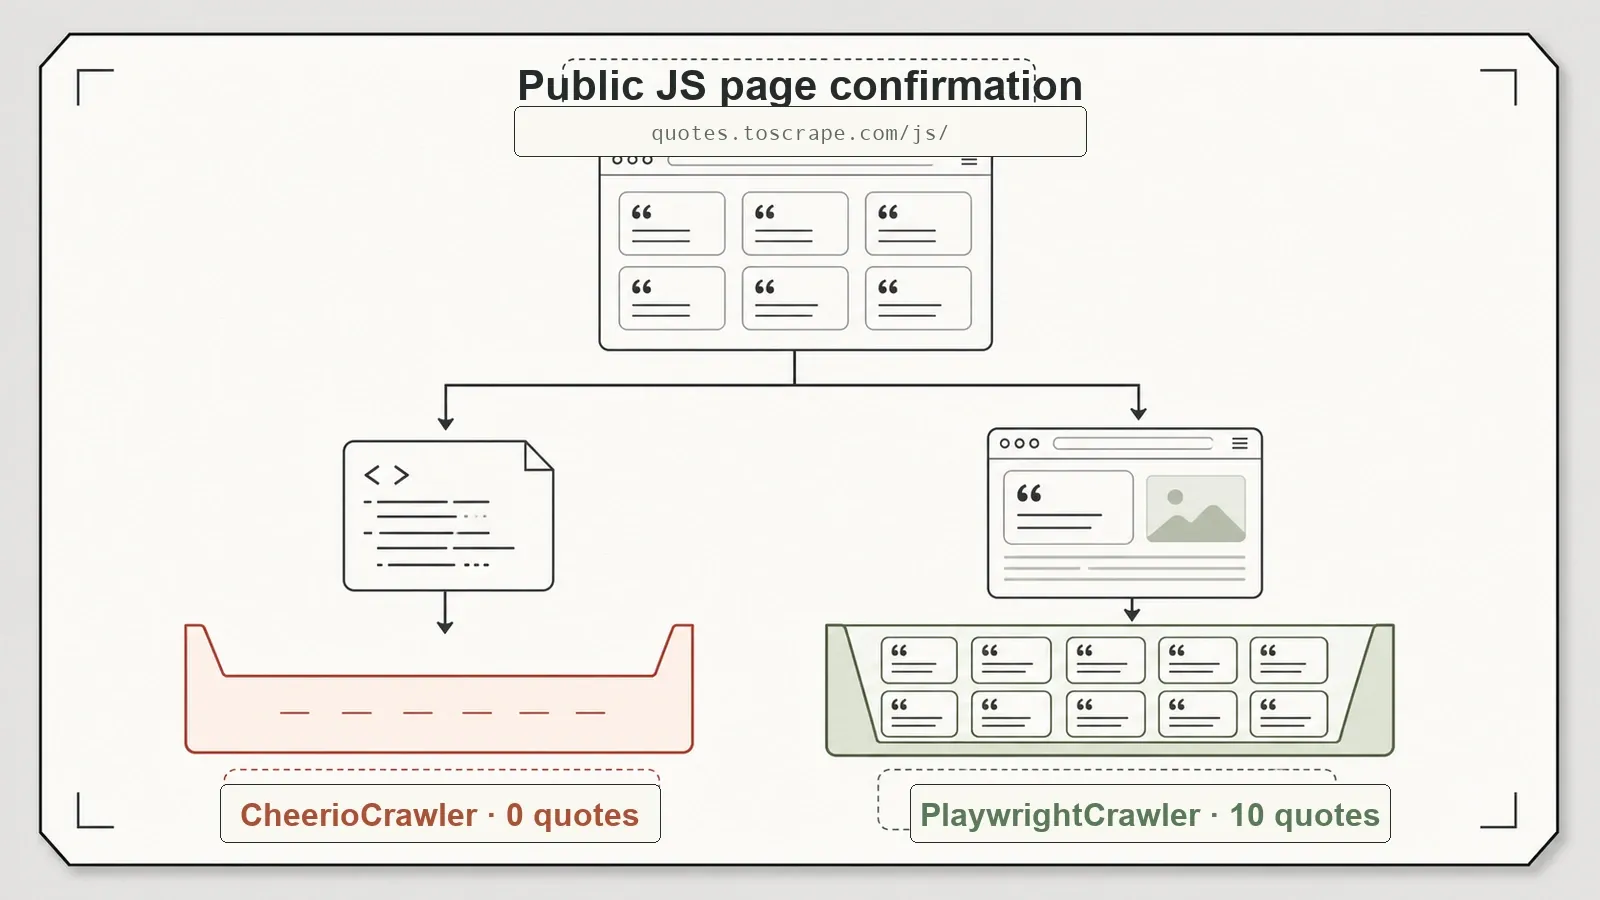
На публичной странице Quotes to Scrape JS CheerioCrawler нашёл 0 нужных цитат, а PlaywrightCrawler дождался .quote и извлёк 10. Это подтверждает ту же границу между HTTP и браузером на публичной цели, при этом класс краулера, контекст обработчика, условие ожидания и примитив извлечения в двух вариантах отличаются.
Практический вывод здесь более узкий: сначала проверяй обязательные поля в HTTP-пути, а если в сыром ответе их нет — переходи к браузерному краулеру. Но и браузерный обработчик тоже должен ждать состояние, связанное именно с этими полями.
HTTP-путь на контролируемых статических каталогах и статьях вернул все ожидаемые записи, корректно декодировал все восемь элементов из прямого JSON-ответа, прошёл по графу из 11 страниц и направил один ответ 500 в failedRequestHandler. Это отдельные проверки возможностей, а не один общий балл точности. На публичной странице Books to Scrape настроенный селектор в smoke-тесте вернул 20 товаров.
| Тест | Движок | Результат |
|---|---|---|
| Статическое извлечение: каталог + пагинация | CheerioCrawler | 12/12 ожидаемых товаров |
| Извлечение статьи | CheerioCrawler | заголовок + 3/3 абзаца |
| Транспорт: прямой JSON-ответ | CheerioCrawler | 8/8 ожидаемых товаров |
| Обход: граф внутренних ссылок | CheerioCrawler | 11 страниц, глубины {0:1, 1:3, 2:7} |
| Обработка ошибок: HTTP 500 | CheerioCrawler | статус дошёл до обработчика ошибок |
| Рендеринг: локальная фикстура | CheerioCrawler | 0 целевых карточек в сыром HTML |
| Рендеринг: локальная фикстура | PlaywrightCrawler | 8/8 после ожидания целевого селектора |
| Рендеринг: Quotes JS | CheerioCrawler | 0 целевых цитат в сыром HTML |
| Рендеринг: Quotes JS | PlaywrightCrawler | 10 после ожидания целевого селектора |
Полные тайминги и числа по каждому тесту есть в results/crawlee-test-summary.json.
Теперь честные оговорки: один запуск на одной машине — это не полноценный бенчмарк, и я не буду делать вид, что это не так. Это измерения, а не эталонный тест: одна машина, по одному запуску каждого сценария, поэтому более высокая стоимость браузерного пути на одну страницу — это «заметно медленнее, чем под-секундные прогоны Cheerio», а не официальная цифра. И ещё есть ряд вещей, которые в этом прогоне я не проверял: ротацию прокси, сессии, массовые запуски на сотни и тысячи страниц, сохранение и возобновление RequestQueue после сбоя, движок Puppeteer и удобство экспорта через Dataset/KeyValueStore (экспорт я здесь писал вручную). Я могу подтвердить двухдвижковую модель и точность на уровне фикстур. Но не могу подтвердить масштабирование или устойчивость к блокировкам — и не буду этого утверждать.
Что общее, а что должно меняться
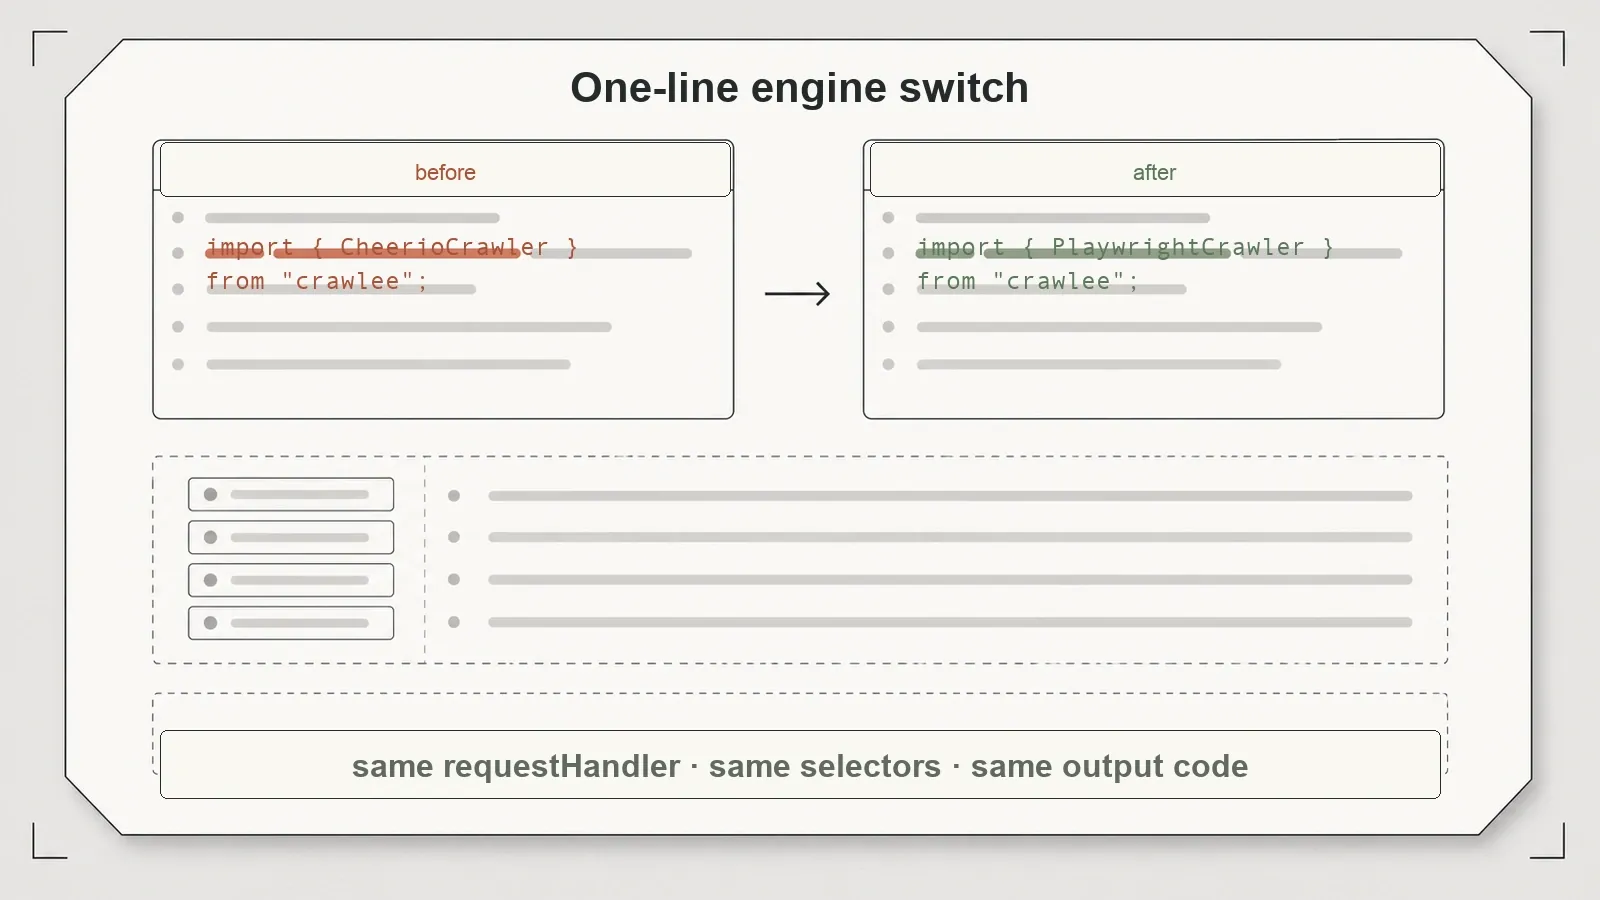
Общая часть — это оркестрация обхода. Оба класса краулеров принимают requestHandler и имеют run(). Очереди, метаданные запросов, обнаружение ссылок, хуки ошибок и концепции хранения можно выстраивать одинаково для любого из путей исполнения. Это снижает объём инфраструктуры, которую команде приходится переучивать, когда для одной цели нужен браузер.
Но поверхность доступа к странице — не общая. Обработчик CheerioCrawler получает доступ в стиле Cheerio, например через $, и может работать с телом ответа без браузера. Тестируемый обработчик PlaywrightCrawler получает page; он ждёт селектор и выполняет запросы по DOM браузера. Даже если оба обработчика возвращают одну и ту же схему записи, делают они это через разные API. Повторно используемый адаптер мог бы частично скрыть эту разницу, но в данном тесте его не было.
Это важно и для оценки трудозатрат. Смена класса краулера может сохранить очередь, набор данных и политику URL, но селекторы, проверки готовности, скриншоты, шаги взаимодействия и обработка ошибок всё равно могут измениться. Поэтому в статье «общая инфраструктура обхода» рассматривается как подтверждённое преимущество, а идея «миграции в одну строку» — как неподтверждённое обещание.
Практический сценарий выбора движка
Начинай с HTTP-пути, если в возвращаемом HTML или прямом JSON-ответе уже есть нужные поля. Задай контракт полноты — обязательные ключи, минимальное количество элементов или целевой селектор — и явно падай, если он не выполнен. Пустой массив ещё не означает, что на странице нет данных; в двух JavaScript-примерах здесь он означал лишь то, что выбранное представление не содержало нужных элементов.
| Условие для цели | С чего начать | Когда переходить дальше |
|---|---|---|
| Нужные поля уже есть в возвращаемом HTML | CheerioCrawler | Отсутствуют обязательные селекторы или поля |
| В воспроизводимом JSON-ответе уже лежат данные | CheerioCrawler | Запрос зависит от состояния, доступного только в браузере |
| Страница добавляет нужные элементы после выполнения скриптов | PlaywrightCrawler | Не применимо; задай проверку готовности под конкретную цель |
| Набор целей заранее неизвестен | Сначала HTTP + валидация полноты | Валидация завершилась типизированной ошибкой «представление неполное» |
Если выполнение действительно необходимо, передавай такую типизированную ошибку в браузерный обработчик. В этом наборе тестов локальная страница ждала #dynamic-products article.product-card, а публичная страница с цитатами — .quote. Эти условия входят в контракт извлечения. Общего load-события недостаточно, чтобы доказать, что данные приложения уже пришли, и тест не подтверждает универсальное правило ожидания.
После перехода на браузер сохраняй стабильную схему вывода, даже если DOM-примитивы различаются. Фиксируй, какой движок дал результат, какое условие готовности прошло и была ли успешной валидация обязательных полей. Так fallback с HTTP на браузер остаётся наблюдаемым процессом, а не скрытым превращением неполных данных в якобы валидные записи.
Наконец, установку браузера и его эксплуатационные затраты нужно считать частью инфраструктурных вводных. Наблюдение про примерно 82 МиБ полезно только как ориентир для локальной среды; точный размер браузерной сборки, платформу, поведение кэша и влияние образа измеряй у себя. Ротация прокси, сессии, сохранение состояния, восстановление после падения и длительная параллельность всё равно требуют отдельных тестов, прежде чем на основе этой фикстуры принимать продакшен-решение.
Плюсы и минусы
Плюсы:
- HTTP- и браузерные краулеры разделяют общие концепции жизненного цикла, но дают разные контексты извлечения под каждый движок.
- HTTP-извлечение на статических каталогах, статьях и JSON API показало точность 1.0 на фикстурах.
- Общая инфраструктура для обоих движков:
RequestQueue,enqueueLinksс управлением глубиной,Dataset. - Браузерный путь выполнил скрипты фикстуры и восстановил все ожидаемые элементы в двух JavaScript-тестах.
- Корректная обработка ошибок — HTTP 500 не приводил к падению.
- Лицензия Apache-2.0; downstream-пользователям стоит проверить требования по уведомлениям и указанию авторства.
Минусы:
- В протестированном окружении браузерному движку требовалась отдельная установка Chromium; без неё
PlaywrightCrawlerне запускался. - HTTP-путь не может показать целевые элементы, которых нет в сыром HTML; без проверки полноты это выглядит как валидный пустой результат.
- Браузерный путь добавляет отдельный бинарник браузера и даёт более высокую локальную стоимость на одну страницу в этом прогоне; размер и время зависят от сборки и платформы.
- При обычном запуске на диске остаётся папка
storage/. - Только Node/TypeScript — если ваш стек на Python, это не поможет.
Для кого это — и кому лучше пройти мимо
Crawlee подходит командам на Node или TypeScript, которым нужны и HTTP-, и браузерный обход под общими концепциями очередей и жизненного цикла. Практичный подход такой: сначала пробуй HTTP-краулер, проверяй обязательные поля и при типизированной ошибке полноты переключайся на браузерный обработчик с условием готовности, завязанным на конкретную цель. Код доступа к DOM в обработчике зависит от движка, даже если очередь и обнаружение ссылок общие.
Пересмотри ожидания или ищи другое решение, если ты работаешь на Python (Crawlee — это Node/TS; есть отдельный Python-порт, но в этом обзоре тестировалась именно Node-версия), если все твои цели статические и тебе нужен более лёгкий однозадачный HTTP-скрапер, или если тебе нужно подтверждённое поведение на масштабе — ротация прокси, пул сессий, возобновление после сбоя — чего в этом практическом тесте не было. И если ты выбираешь PlaywrightCrawler, сначала установи Chromium, иначе он просто не запустится.
Альтернативы, включая место Thunderbit
Crawlee — это open-source решение, которое ты разворачиваешь и поддерживаешь сам. У него нет платы за каждый запрос как у вендора, но вычисления браузера, трафик, прокси, хранилище, наблюдаемость и разработка остаются операционными расходами. Ты сам отвечаешь за выбор краулера, бинарник браузера, состояние хранилища и логику готовности.
Связанный обзор: обзор scrapy-playwright.
Управляемый сервис извлечения переносит ответственность за сбор и формирование схемы на поставщика. Мы разрабатываем Thunderbit, но не запускали его на этих фикстурах, поэтому эта статья не даёт сравнения по качеству, задержке, возможностям или цене. Ключевой выбор здесь — хочешь ли ты контроль в рамках своего процесса с Crawlee или внешний сервис с оплатой за запрос.
Связанные обзоры бенчмарков: полное сравнение open-source скраперов, Playwright против Puppeteer на одних и тех же страницах и обзор Scrapy без браузерного повторного запроса.
Попробовать Thunderbit для извлечения веб-данных
Итог
Crawlee — сильный кандидат для команд на Node или TypeScript, которым нужна общая оркестрация обхода и для HTTP, и для браузера. Протестированные обработчики не были взаимозаменяемыми: при переходе на Playwright потребовались page, ожидание целевого селектора и извлечение данных уже на стороне браузера. Прокси, сессии, сохранение состояния, восстановление после падения и поведение на больших объёмах остаются открытыми вопросами.
Попробовать Thunderbit для извлечения веб-данных Get Started Free
Частые вопросы
В чём на самом деле разница между двумя краулерами Crawlee?
CheerioCrawler загружает HTML по HTTP и не исполняет JavaScript. PlaywrightCrawler управляет Chromium и может выполнять скрипты страницы и делать скриншоты, но за счёт более высокой локальной стоимости на одну страницу. У них общие концепции жизненного цикла, но не одинаковые контексты обработчика: в этом тесте путь HTTP использовал $, а путь Playwright — page, ожидание целевого селектора и браузерную обработку DOM.
Почему PlaywrightCrawler не запускается после установки Crawlee?
В протестированном окружении установка пакета не добавляла исполняемый браузер. Проблему запуска решала установка Chromium через npx playwright install chromium. По наблюдениям, размер был около 82 МиБ, но исходное измерение не сохранило, был ли это размер загрузки или размер на диске, поэтому перепроверь это для своей платформы и сборки.
Может ли CheerioCrawler скрапить страницы, рендерящиеся JavaScript?
Он не исполняет JavaScript страницы. Но он всё ещё может запросить доступную JSON-точку, которую использует клиент, как показывает пример с прямым ответом. Если нужные данные появляются только после выполнения кода в браузере, используй браузерный краулер и условие готовности, привязанное к этим полям.
Насколько точен Crawlee для обычного статического извлечения? На контролируемых фикстурах обработчики получили 12/12 ожидаемых товаров каталога, 3/3 ожидаемых абзаца статьи и 8/8 ожидаемых элементов из прямого JSON. Это проверки полноты на фикстурах, а не общий показатель точности для любых не тестировавшихся сайтов.
Можно ли использовать Crawlee бесплатно в коммерческих проектах? Да, он опубликован под лицензией Apache-2.0. Проверь актуальную лицензию в репозитории и изучи требования по уведомлениям и указанию авторства для своего способа распространения.
Перед внедрением в продакшен протестируй то, что эта фикстура не покрывает: повторяющуюся параллельность на репрезентативных страницах, поведение прокси и сессий, восстановление очереди после прерывания, очистку браузерных процессов и экспорт набора данных при сбоях. Сохрани в результатах версию браузера и путь установки. Два класса краулеров уменьшают расхождение в оркестрации, но не убирают необходимость в проверках готовности, ресурсных лимитах и обработке операционных сбоев, зависящих от движка.




