
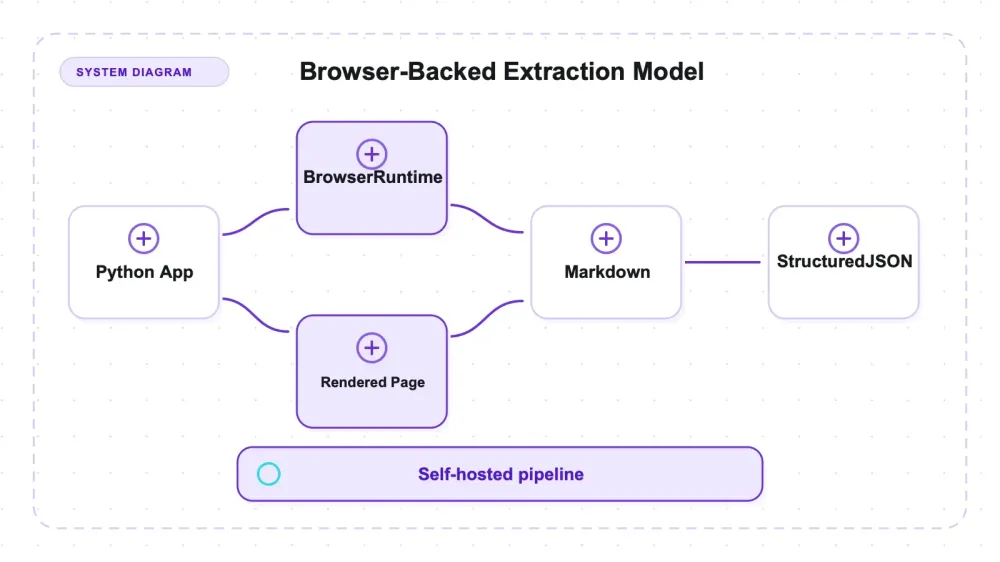
Некоторые сторонние сравнения скраперов приписывают Crawl4AI «адаптивный интеллект» — то есть селекторы, которые якобы учатся на сайте и сами восстанавливаются после изменения разметки. В проверенном API я такого поведения не нашёл. По сути, Crawl4AI предлагает генерацию Markdown на базе браузера и извлечение данных через CSS/XPath. Scrapling действительно даёт отдельную функцию адаптивных селекторов, но с ограничениями, которые описаны в его собственном обзоре.
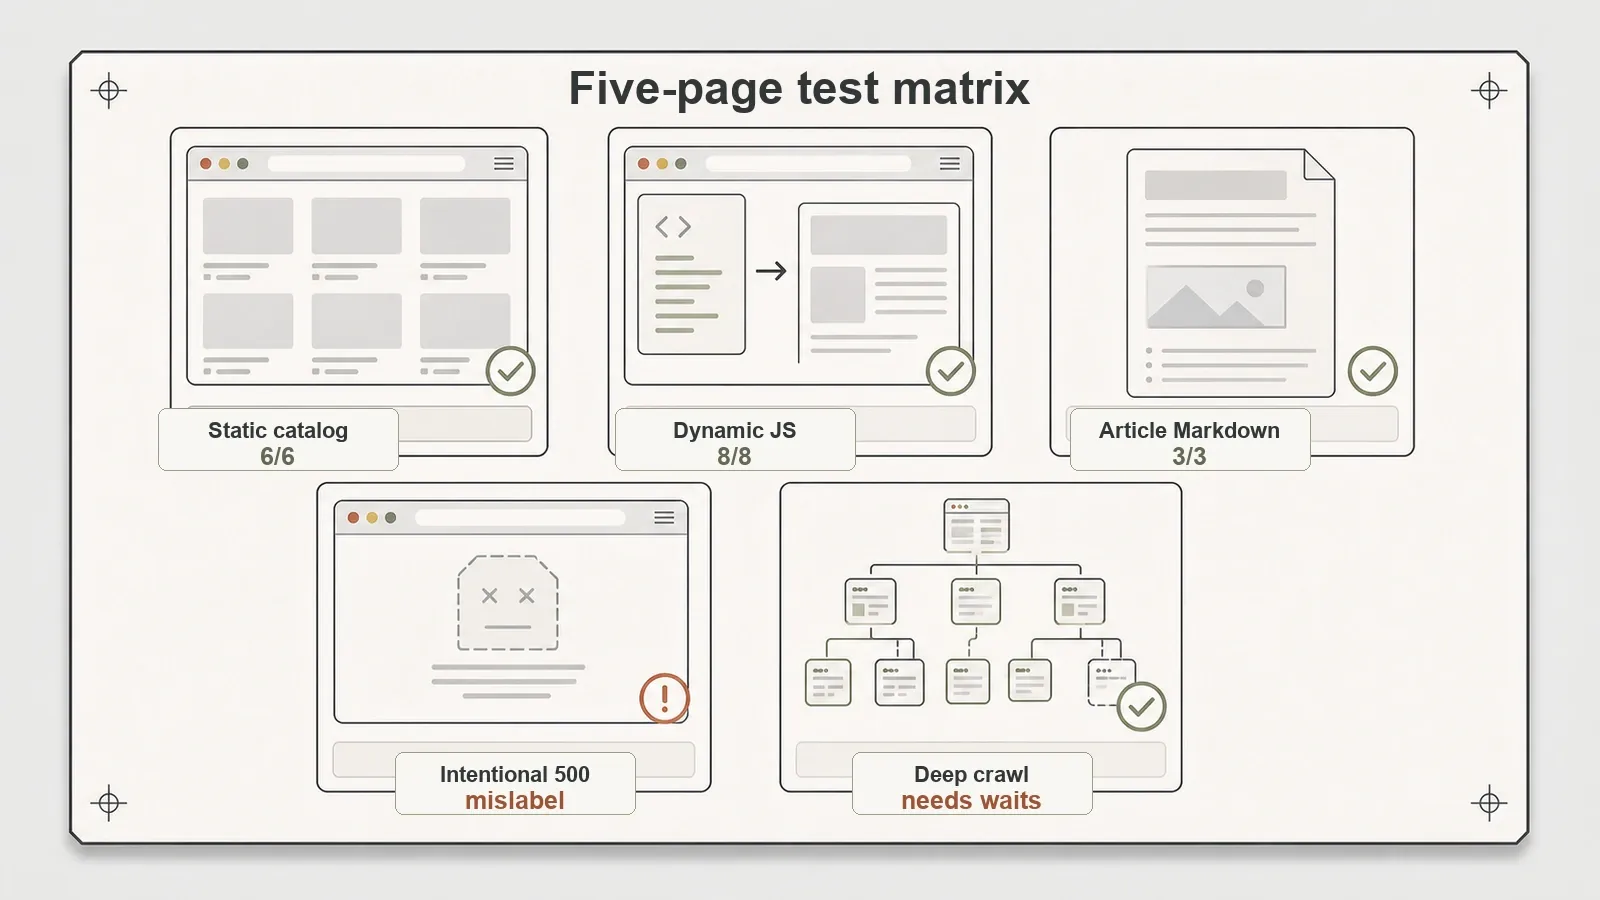
Я протестировал Crawl4AI версии 0.9.0 на пяти типах страниц с известным эталоном: статический каталог, каталог, отрисованный JavaScript, статья с лишней обвязкой, намеренный HTTP 500 и связанный многостраничный граф. В проверенных путях Markdown и schema результат совпал с фикстурами. Сырой Markdown сохранял служебную обвязку, для глубокого обхода требовались ожидания под конкретную страницу, а обычный 500 получал ошибочную антибот-метку.
Что такое Crawl4AI на самом деле
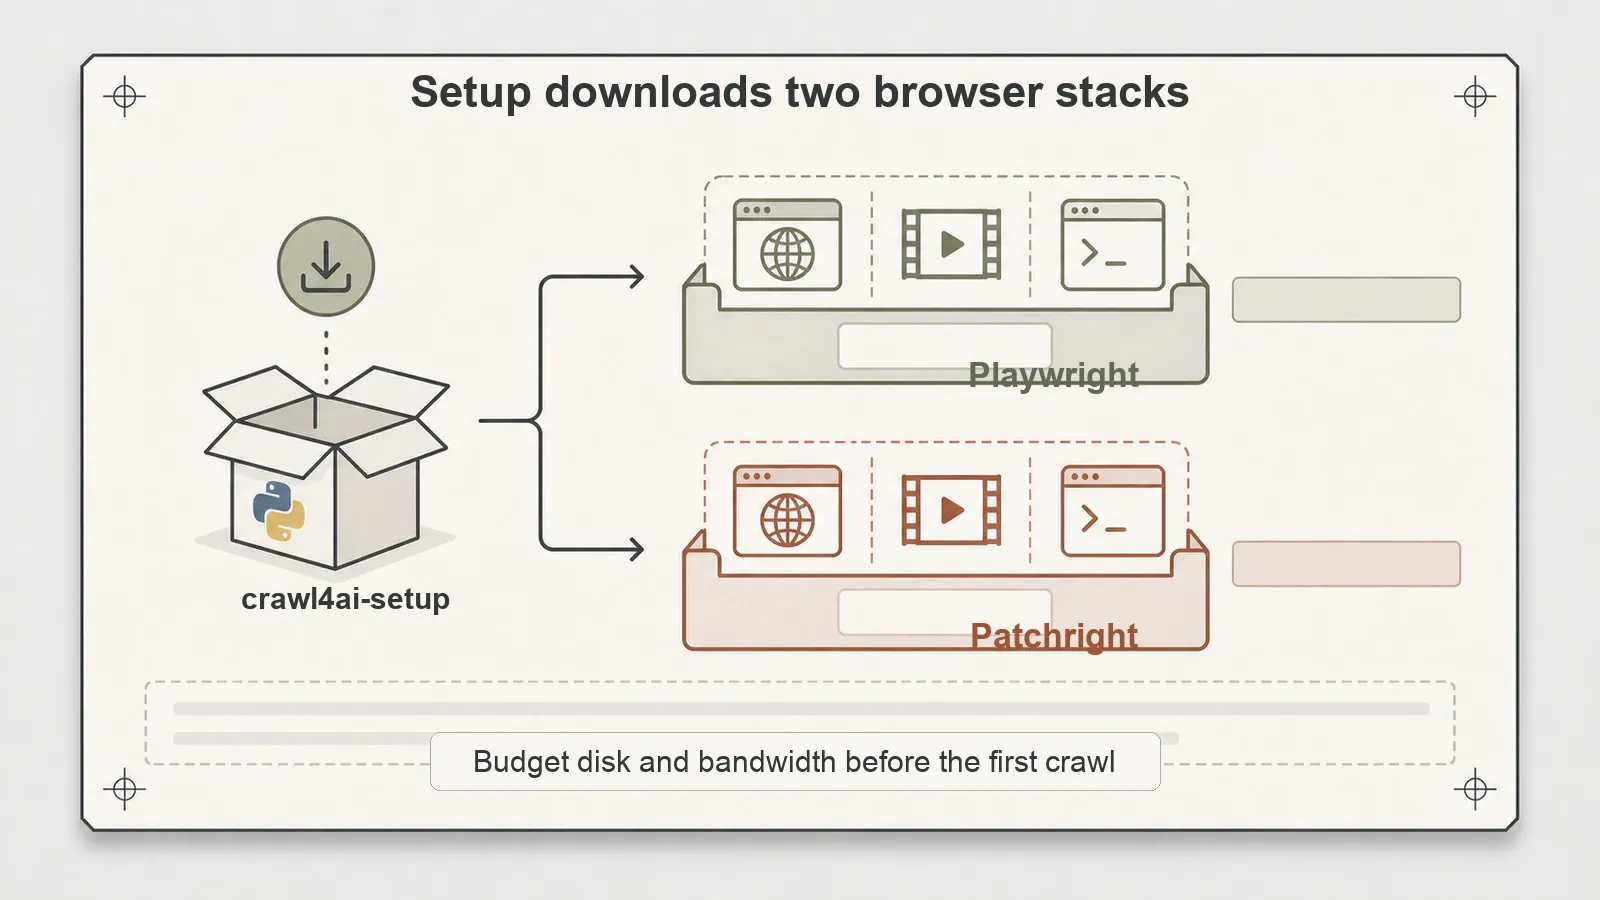
Начнём с того, что чаще всего путают при установке. Crawl4AI — это не маленький Python-парсер. Первый запуск crawl4ai-setup тихо скачивает сразу два полноценных браузерных стека — Playwright и Patchright — и как только это понимаешь, вся логика инструмента встаёт на место: это управляемый headless-браузер с конвертером в Markdown сверху, замаскированный под скрапер.
Официально это open-source библиотека под Apache-2.0 для преобразования веб-страниц в Markdown для RAG-пайплайнов, агентов и рабочих процессов с данными. Я тестировал v0.9.0. В его базовые примитивы входят AsyncWebCrawler, BrowserConfig, CrawlerRunConfig, генерация Markdown и стратегии извлечения через CSS/XPath или LLM, согласно официальному quick start.
Вот важная ментальная модель. Большинство библиотек-парсеров отправляют HTTP-запрос и разбирают полученные байты; Crawl4AI управляет настоящим браузером. Рендеринг встроен изначально, поэтому установка тяжелее, чем у чистого HTTP-парсера, а надёжное извлечение асинхронно загружаемых элементов может всё равно потребовать явного ожидания. Ничего из протестированного здесь не переписывает селекторы после редизайна. К заявлению о самовосстановлении стоит относиться как к ошибке стороннего сравнения, если нет конкретного официального источника и воспроизводимого API.
Ключевые возможности и как они устроены внутри
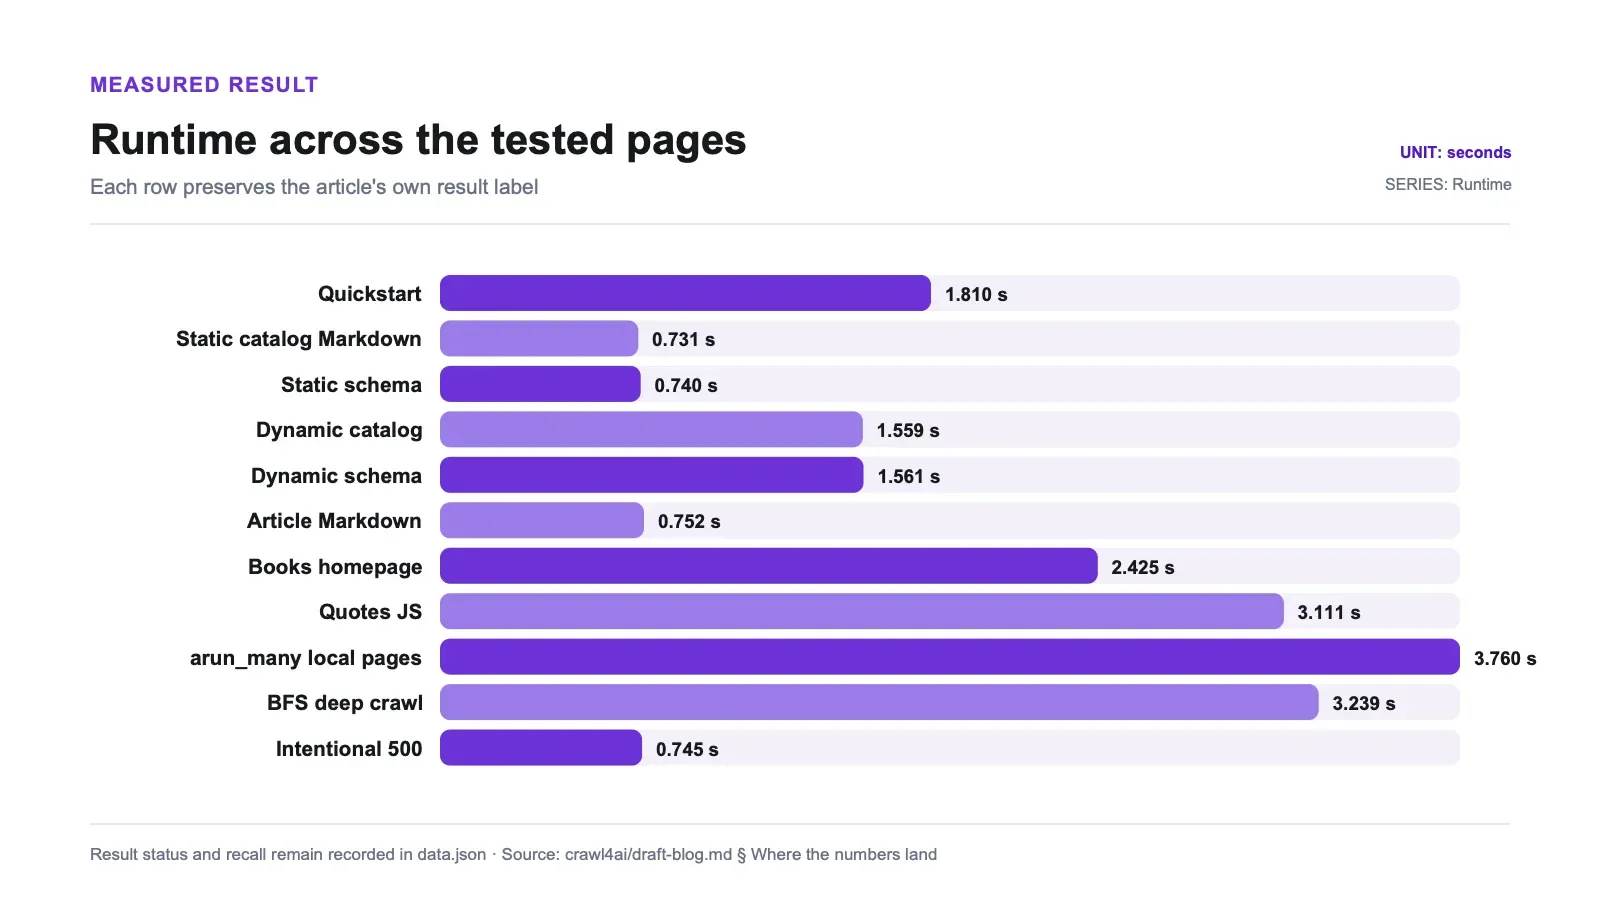
Путь одной страницы — это сердце инструмента. Вы указываете AsyncWebCrawler URL, он загружает страницу в браузере и возвращает Markdown. На официальном quickstart для example.com этот цикл занял 1.81 секунды и вернул чистый ответ 200. Ничего экзотического, зато видно, что базовый сценарий работает почти без настройки — без schema, без ожиданий, без конфигурации браузера.
Видео-урок (1:02:38): Crawl4AI Official Tutorial, Full 1hr with Quickstart Examples.
Структурированное извлечение — вторая опора и ближайшее к «пониманию» страницы, что есть у Crawl4AI. Хотя по сути это не выводы модели, а просто схема, которую вы задаёте сами. Вместо того чтобы выгружать только Markdown, вы передаёте CSS-схему через JsonCssExtractionStrategy и получаете JSON-объекты с ровно теми полями, которые запросили. На моём локальном статическом каталоге инструмент вернул 6 чистых JSON-записей — название товара, категорию, цену, рейтинг и URL карточки — и всё это полностью совпало с 6 ожидаемыми товарами. Вот и разница между «вот страница как текст» и «вот данные в виде строк», и Crawl4AI умеет делать и то и другое за один проход. Но селекторы вы прописываете сами; инструмент сопоставляет только то, что ему дали, а не выводит schema за вас.
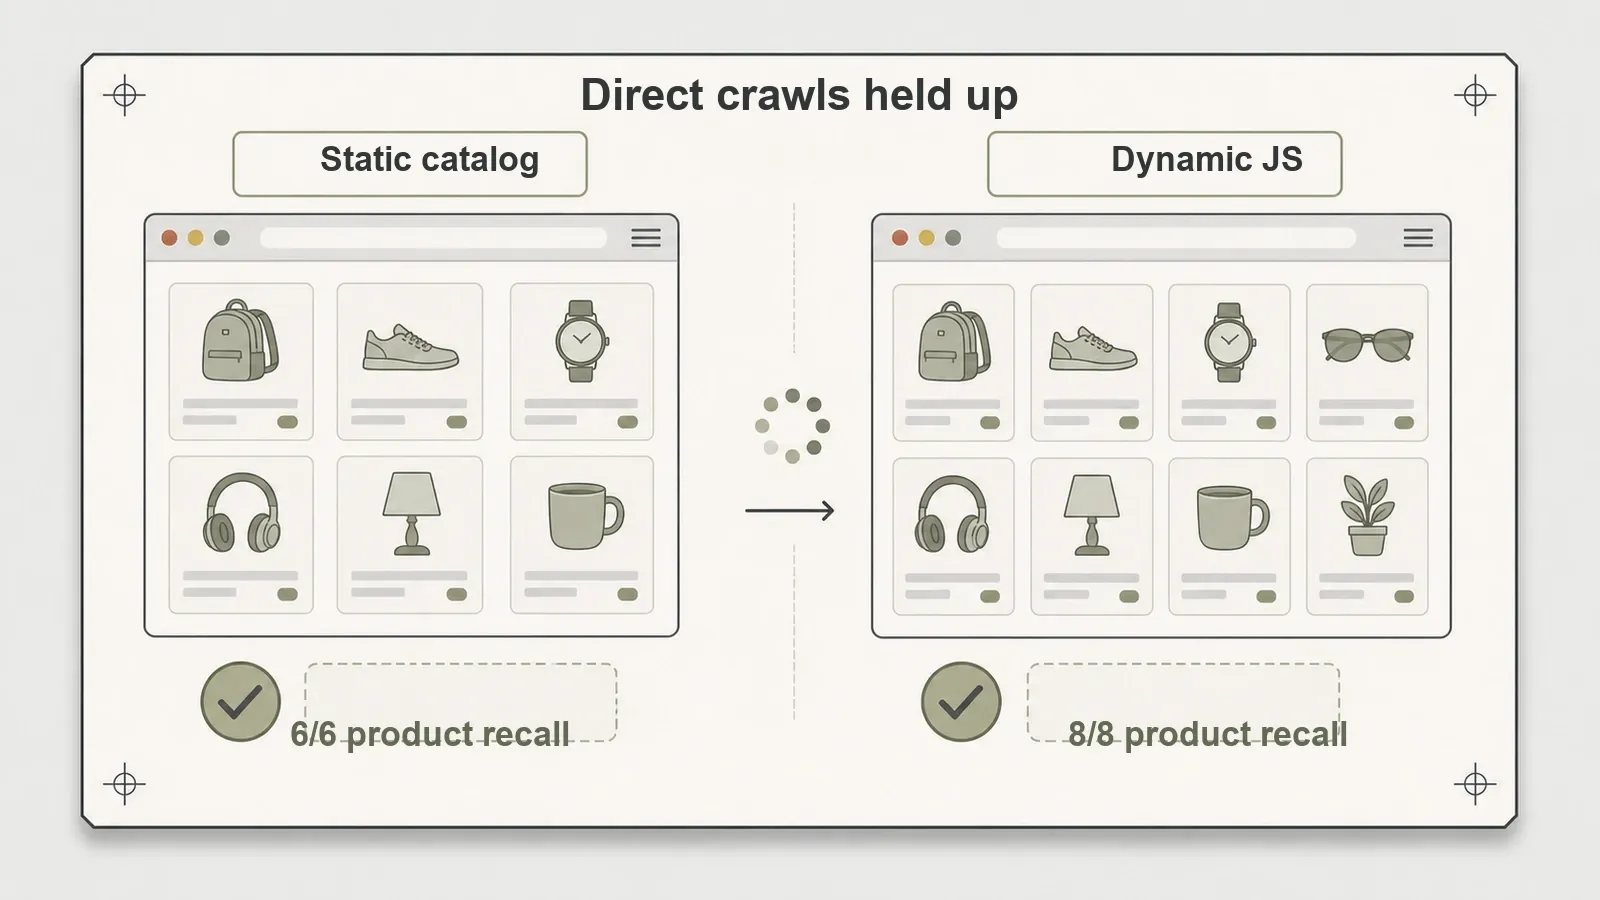
Динамический рендеринг — как раз тот случай, где браузерная основа реально выручает. Если указать JavaScript-страницу каталога с wait_for="css:.product-card", инструмент ждёт, пока завершится клиентский рендер, и только потом вытаскивает данные. В моей локальной JS-фикстуре это дало 8/8 по полноте извлечения как в Markdown, так и в schema-выводе, примерно за 1.56 секунды. На публичной странице Quotes to Scrape JS он поймал уже отрендеренные цитаты и сохранил пригодный скриншот — то, чего обычный HTTP-запрос никогда бы не увидел, потому что в исходном HTML просто нечего разбирать.
Дальше — масштабирование и обход. arun_many() одновременно обработал шесть локальных страниц детализации с полной полнотой 6/6 за 3.76 секунды. Кроме того, Crawl4AI идёт со стратегиями deep crawl — BFS, DFS, BestFirst — которые проходят по графу ссылок с ограничением глубины, количеством страниц, фильтрацией и скорингом. BFS deep crawl обошёл граф ссылок моей тестовой главной страницы и забрал пять страниц. И вот здесь обещания начинают расходиться с реальностью — ниже покажу, где именно.
Установка: та часть, которую никто не пишет в начале README
Установка на моей машине прошла с одной стороны легче, чем ожидалось, а с другой — тяжелее. pip install -U crawl4ai и smoke test успешно прошли на Python 3.14.2 в macOS arm64. Спецификация PyPI >=3.10 уже включает 3.14; этот результат подтверждает только проверенную установку и рабочий сценарий, а не общую совместимость.
Сложность — в шаге настройки. crawl4ai-setup скачивает браузерные компоненты для и Playwright, и Patchright — Chrome for Testing, FFmpeg, Headless Shell. Если у тебя ноутбук с ограниченным диском или платный/лимитированный интернет, это вполне ощутимая цена, и в документации она упомянута скорее мимоходом, чем на первом плане. Затем crawl4ai-doctor успешно отработал и обошёл crawl4ai.com за 14.65 секунды — это нормальный end-to-end smoke test, но не бенчмарк чего-либо, поэтому по этому числу не стоит судить о скорости.
Практический вывод для твоей оценки установки: закладывай бюджет не только на pip install, но и на скачивание браузера. Это больше похоже на развёртывание headless-браузерной среды, чем на добавление обычной библиотеки в скрипт. Два браузерных стека окажутся на диске ещё до того, как ты обработаешь хотя бы одну реальную страницу, и это разовый расход, который приходится нести независимо от того, понадобится ли тебе когда-нибудь stealth-слой Patchright.
Практика: что сработало, а что я бы отметил отдельно
Стоит аккуратно зафиксировать четыре наблюдения — именно такие нюансы маркетинговые страницы обычно сглаживают, а в одном случае ещё и неверно подписывают.
Две публичные демо-страницы тоже отработали успешно. На главной Books to Scrape Crawl4AI сгенерировал 13,476 символов Markdown за 2.43 секунды. Публичная JS-страница Quotes вернула 1,666 символов отрендеренного Markdown примерно за 3.1 секунды. Ни один из этих примеров не говорит ничего о масштабировании, враждебных сайтах, долгой стабильности, сессиях, прокси, ретраях или поведении памяти.
Статья показывает важную оговорку по качеству Markdown. Crawl4AI корректно захватил заголовок и все 3/3 абзаца основного текста — это хорошо. Но сырой Markdown также сохранил навигацию, связанные ссылки, строку подписки и футер. Это не баг; без content filter или целевого селектора «преобразовать эту страницу в Markdown» честно означает всю страницу. Вывод здесь такой: нужно различать сырой Markdown и чистое извлечение статьи. Если нужен именно второй вариант, стоит использовать content filter вроде PruningContentFilter или target selector — но я пока не прогонял их через жёсткий стресс-тест, поэтому не буду называть конкретные цифры чистоты.
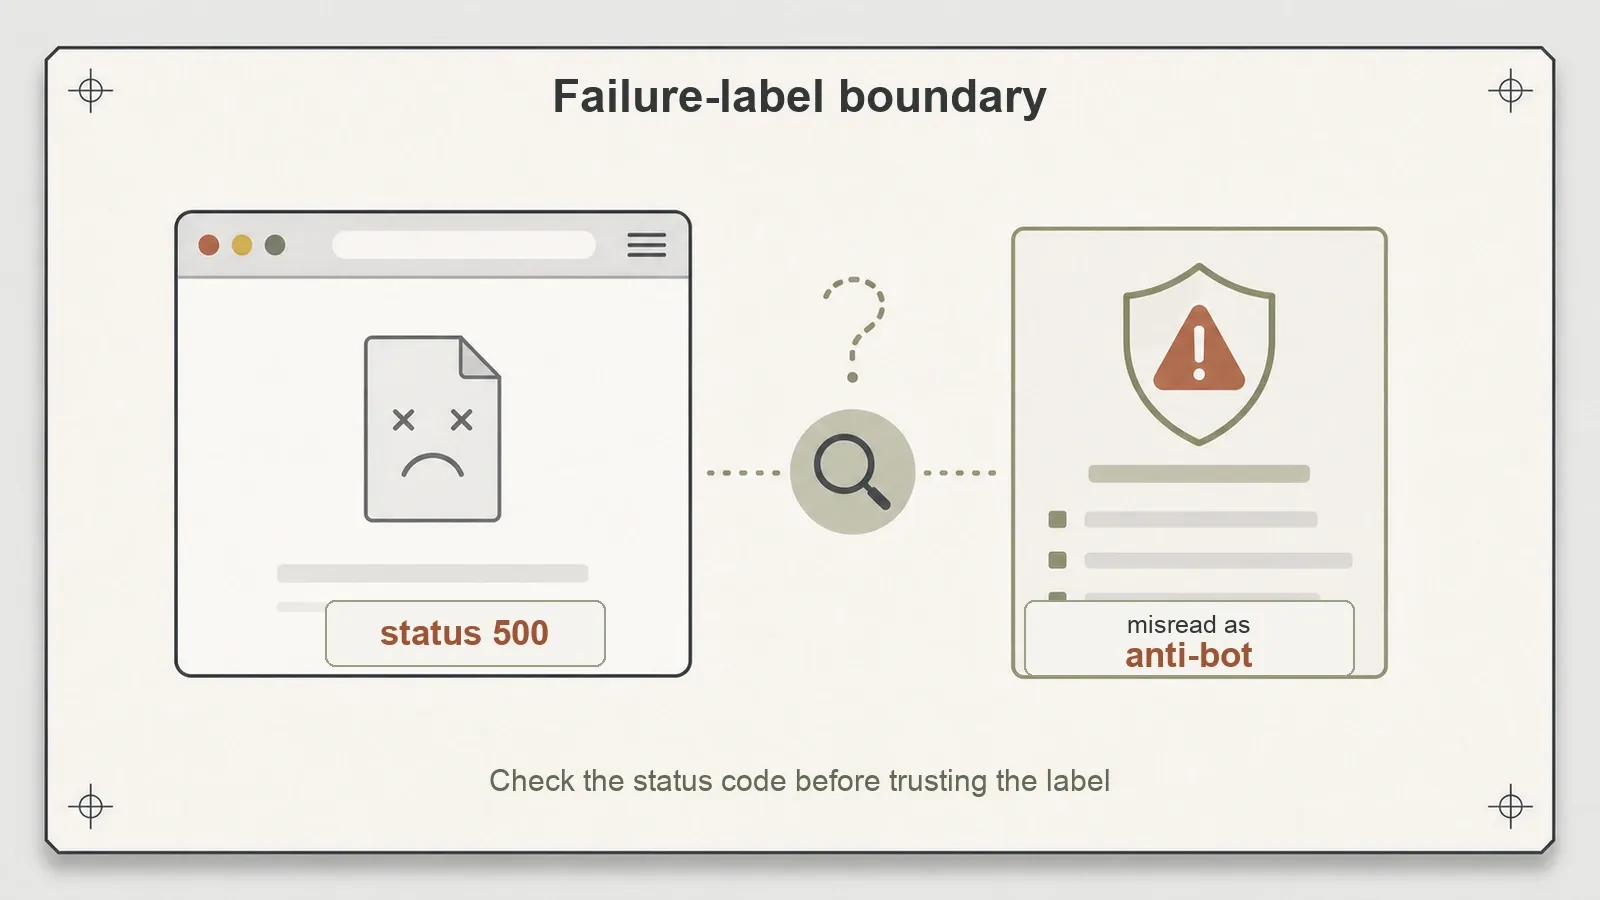
Сломанная страница дала самый показательный результат. Я специально отдал HTTP 500 с очень маленьким телом ответа. Crawl4AI вернул success=false и статус 500 — это правильно — но сообщение об ошибке было сформулировано как «Blocked by anti-bot protection: Structural: minimal_text on small page.» Никакой антибот-защиты там не было. Это была просто маленькая страница ошибки. Структурная эвристика Crawl4AI увидела очень мало видимого текста и сделала вывод в пользу антибот-объяснения. Для тех, кто строит систему поверх этого инструмента, это важно: не доверяй ярлыку «anti-bot» на слово. Сначала проверь код статуса и сам ответ, прежде чем решать, что сайт тебя блокирует. Сырой результат лежит в репозитории бенчмарка: results/local_failure_500.json.
Глубокий обход требует осознанной настройки. Прямой динамический crawl с wait_for отработал чисто, а BFS deep crawl обнаружил динамический каталог и вернул ошибку. Классификация как minimal-text согласуется с тем, что страница была прочитана до рендера карточек, а deep crawl не унаследовал ожидание из прямого сценария. Из пяти страниц три успешно прошли, две — нет. Поскольку здесь не показан повторный запуск с настройкой ожидания, это остаётся выводом по косвенным признакам, а не доказанной причиной.
Куда ложатся цифры
| Тест | Результат | Наблюдаемое время выполнения (один зафиксированный прогон) |
|---|---|---|
Quickstart (example.com) | success, 200 | 1.81s |
| Локальный статический каталог (Markdown) | 6/6 по товарам | 0.731s |
| Локальное CSS-schema извлечение статического каталога | 6 JSON-записей | 0.740s |
Локальный динамический каталог (wait_for) | 8/8 по товарам | 1.559s |
| Локальное CSS-schema извлечение динамического каталога | 8 JSON-записей | 1.561s |
| Markdown статьи | 3/3 абзаца (+ служебная обвязка) | 0.752s |
| Публичная главная Books to Scrape | 13,476 символов Markdown | 2.425s |
| Публичная страница Quotes JS | 1,666 символов Markdown, отрендерено | 3.111s |
arun_many() (6 локальных страниц) | 6/6 по полноте извлечения | 3.760s |
| Локальный BFS deep crawl | найдено 5 страниц, 3 успеха / 2 ошибки | 3.239s |
| Намеренная страница 500 | ошибка, 500 (ошибочно помечено как «anti-bot») | 0.745s |
Это времена smoke test, а не полноценный performance benchmark: в статье не указаны железо, число повторов, тёплое/холодное состояние, состояние кэша, контроль concurrency или разброс. Они показывают, что перечисленные сценарии завершились на этой машине. Полные артефакты прогона лежат в каталоге репозитория бенчмарка.
Для оценки, по которой можно принимать решение, повторяй каждый сценарий в новых и уже использованных браузерных сессиях, публикуй распределения, а не одно десятичное значение, фиксируй версии браузера и записывай CPU, память, состояние кэша и уровень параллельности. Это позволит отделить накладные расходы библиотеки от старта браузера и сетевых колебаний.
| Требование | Насколько подходит в этом обзоре | Главное условие |
|---|---|---|
| Отрисовать страницу и вернуть Markdown | Хороший вариант | Сначала фильтровать служебную обвязку, прежде чем считать результат чистой статьёй |
| Извлечь JSON в виде schema | Хороший вариант | Но CSS-schema всё равно нужно писать и поддерживать самому |
| Ждать асинхронный контент страницы | Поддерживается | Нужен явный wait_for, завязанный на конкретную цель |
| Глубоко обходить динамические страницы | Условно | Нужно передавать правила готовности; в тесте по умолчанию были частичные ошибки |
| Работать как маленький HTTP-парсер без тяжёлых зависимостей | Плохое соответствие | Браузерные ассеты и их поддержка — часть развёртывания |
| Использовать самовосстанавливающиеся селекторы | В этом тесте не поддерживается | Не стоит делать такой вывод из чужих сравнительных текстов |
Плюсы и минусы
Плюсы:
- Одна библиотека делает и сырой Markdown, и структурированный JSON по CSS-schema — не нужно склеивать два инструмента.
- Браузерный рендеринг встроен; для асинхронно загружаемых целей может понадобиться явный
wait_for. - Проверенные сценарии одной страницы уложились в указанные выше времена; сравнительных заявлений о скорости не делается.
- Лицензия Apache-2.0 — удобно для коммерческого использования, без сюрпризов copyleft.
- Активный проект с недавним релизом и большой вовлечённой аудиторией.
Минусы:
- Тяжёлая первоначальная установка (два браузерных стека), что в начале описано слишком мягко.
- Сырой Markdown содержит служебную обвязку, если не настроить content filters.
- Deep crawl не ждёт динамические страницы автоматически — ожидание нужно задавать для каждого обхода, иначе будут ошибки.
- Сообщения об ошибках могут помечать обычную ошибку как «anti-bot», что сбивает с толку в логах.
- Самоадаптирующиеся селекторы не поддерживаются, вопреки некоторым сравнениям — schema пишутся вручную и остаются статичными.
- Браузерную среду нужно разворачивать и обслуживать самому, включая обновления и поломки.
Для кого это подходит, а кому лучше пропустить
Crawl4AI стоит рассмотреть, если ты разработчик, строящий RAG- или agent-пайплайн, тебе комфортно работать с headless-браузерной средой, и ты хочешь получать и Markdown, и структурированный JSON из одного обхода. Тесты не покрывали устойчивость к враждебным сайтам, долгую стабильность, память, сессии, ретраи, прокси и production-развёртывание, поэтому рекомендация относится только к тем сценариям, которые были проверены здесь.
Лучше пропустить — или как минимум сделать паузу — если тебе нужен маленький HTTP-парсер с минимальными зависимостями (это как раз противоположный случай), если ты не готов выделить диск и трафик под загрузку браузера, или если не хочешь брать на себя сопровождение браузерного стека в production. И точно пропусти его, если пришёл за self-healing селекторами: это не тот инструмент, а строить процесс вокруг функции, которой в нём нет, потом выйдет боком. Для чистого извлечения текста статьи с вырезанной служебной обвязкой лучше подойдёт более лёгкий инструмент, заточенный именно под эту задачу.
Альтернативы и место Thunderbit
Честная формулировка такая: Crawl4AI — это бесплатная open-source библиотека, которую ты разворачиваешь и обслуживаешь сам. Ты получаешь полный контроль и отсутствие платы за использование сервиса, но по-прежнему платишь за вычисления, трафик, хранение, обновления браузера, schema и операционную работу.
На другом конце спектра находится managed scraping service вроде Thunderbit, где получение и извлечение данных доступны через API. Thunderbit не прогонялся через эти же фикстуры, поэтому эта статья не делает сопоставимых выводов о рендеринге, антибот-обработке, CAPTCHA, точности или скорости. Здесь важнее сравнение по операционной ответственности: ты либо сам хостишь библиотеку с браузером, либо платишь сервису за обслуживание этого слоя.
Разница в том, кто управляет браузером. С Crawl4AI ты сам отвечаешь за рендеринг, ожидания, schema и поддержку. С managed API ты платишь за вызов и переносишь часть операционной нагрузки на провайдера. Этот эксперимент не сравнивал эти два подхода по результатам.
Связанные обзоры-бенчмарки: полное сравнение open-source скраперов, обзор self-hosted версии Firecrawl и обзор извлечения статей в trafilatura.
Попробуйте Thunderbit для извлечения веб-данных
Итог
Crawl4AI — вполне разумный кандидат, если тебе нужен open-source инструмент с браузерным рендерингом, который выдаёт Markdown и структурированный JSON, и ты готов сам обслуживать браузерную среду. Прямые статические сценарии и динамические сценарии с ожиданием в этих фикстурах успешно отработали. Apache-2.0 — гибкая лицензия, хотя стандартная проверка зависимостей и условий распространения всё равно обязательна.
Закладывай бюджет на браузерные ассеты. Сырой Markdown нужно фильтровать, прежде чем считать его чистой статьёй. Ожидания для deep crawl нужно настраивать вручную, а лог с пометкой «anti-bot» следует сверять со статус-кодом и телом ответа. Schema-селекторы по-прежнему нужно писать и поддерживать самому. Это и есть проверенные границы применимости; масштаб в production и поведение на враждебных сайтах остаются открытыми вопросами.
Попробуйте Thunderbit для извлечения веб-данных Get Started Free
Частые вопросы
Есть ли у Crawl4AI адаптивные или самовосстанавливающиеся селекторы? Нет. Несмотря на то, что некоторые сравнения приписывают ему «adaptive intelligence», Crawl4AI сопоставляет CSS/XPath schema, которую ты сам пишешь, — он не делает fingerprint элементов и не находит их заново после изменения разметки. В тестах структурированное извлечение дало 6/6 и 8/8 по полноте на schema, которые я задал вручную. Если сайт меняет классы, твоя schema ломается, пока ты её не обновишь. Самовосстановление селекторов — это функция другой библиотеки, не этой.
Почему установка такая тяжёлая?
crawl4ai-setup скачивает полноценные браузерные ассеты и для Playwright, и для Patchright — Chrome for Testing, FFmpeg и Headless Shell. Это цена за настоящий браузерный рендеринг. Закладывай место на диске и трафик: это тяжелее, чем чистый HTTP-парсер, и платишь ты за это даже если твой сценарий никогда не использует stealth-слой.
Умеет ли Crawl4AI работать со страницами, которые рендерятся JavaScript-ом?
Да, потому что он управляет настоящим headless-браузером. В тесте динамический каталог с wait_for="css:.product-card" дал полную полноту 8/8, а публичная JS-страница Quotes отрендерилась корректно. Но есть нюанс: deep crawl не применяет это ожидание автоматически к найденным страницам — BFS-обход провалился на динамической странице, потому что не дождался рендера. Ожидание нужно настраивать вручную для каждого обхода.
Crawl4AI отдаёт чистый текст статьи или всю страницу целиком?
По умолчанию — всю страницу. В тесте он захватил все абзацы body, но также сохранил навигацию, связанные ссылки и футер. Для чистого извлечения статьи нужен content filter (например, PruningContentFilter) или целевой селектор, а не только сырой Markdown.
Можно ли доверять сообщениям об ошибках Crawl4AI? С осторожностью. Намеренная страница с HTTP 500 и маленьким телом была помечена как «Blocked by anti-bot protection» только из-за эвристики малого объёма видимого текста — никакой антибот-защиты там не было. Сырой результат лежит в репозитории бенчмарка. Всегда проверяй реальный HTTP-статус и тело ответа, прежде чем решать, что сайт тебя блокирует.




