
Я собрал тестовый сайт, чтобы проверить ту сторону Colly, на которую не отвечают ни количество страниц, ни репутация по скорости: действительно ли его callbacks вытягивают нужные записи, корректно ли обрабатывают HTTP-ошибку, проходят ли по ограниченному графу и умеют ли работать с контентом, которого нет в отрендеренном HTML. Это был разбор на корректность и границы применения, а не benchmark на throughput.
На контролируемых fixture Colly извлёк все ожидаемые статические записи, отправил один ответ 500 в OnError и обошёл 17 URL в заданном графе с ограничением по глубине. На двух страницах, где элементы появлялись только после выполнения JavaScript, он вернул ноль целевых элементов. А вот напрямую доступный JSON-endpoint оставался доступен без браузера — и это важное отличие от рендеринга клиентского интерфейса.
Что такое Colly на самом деле
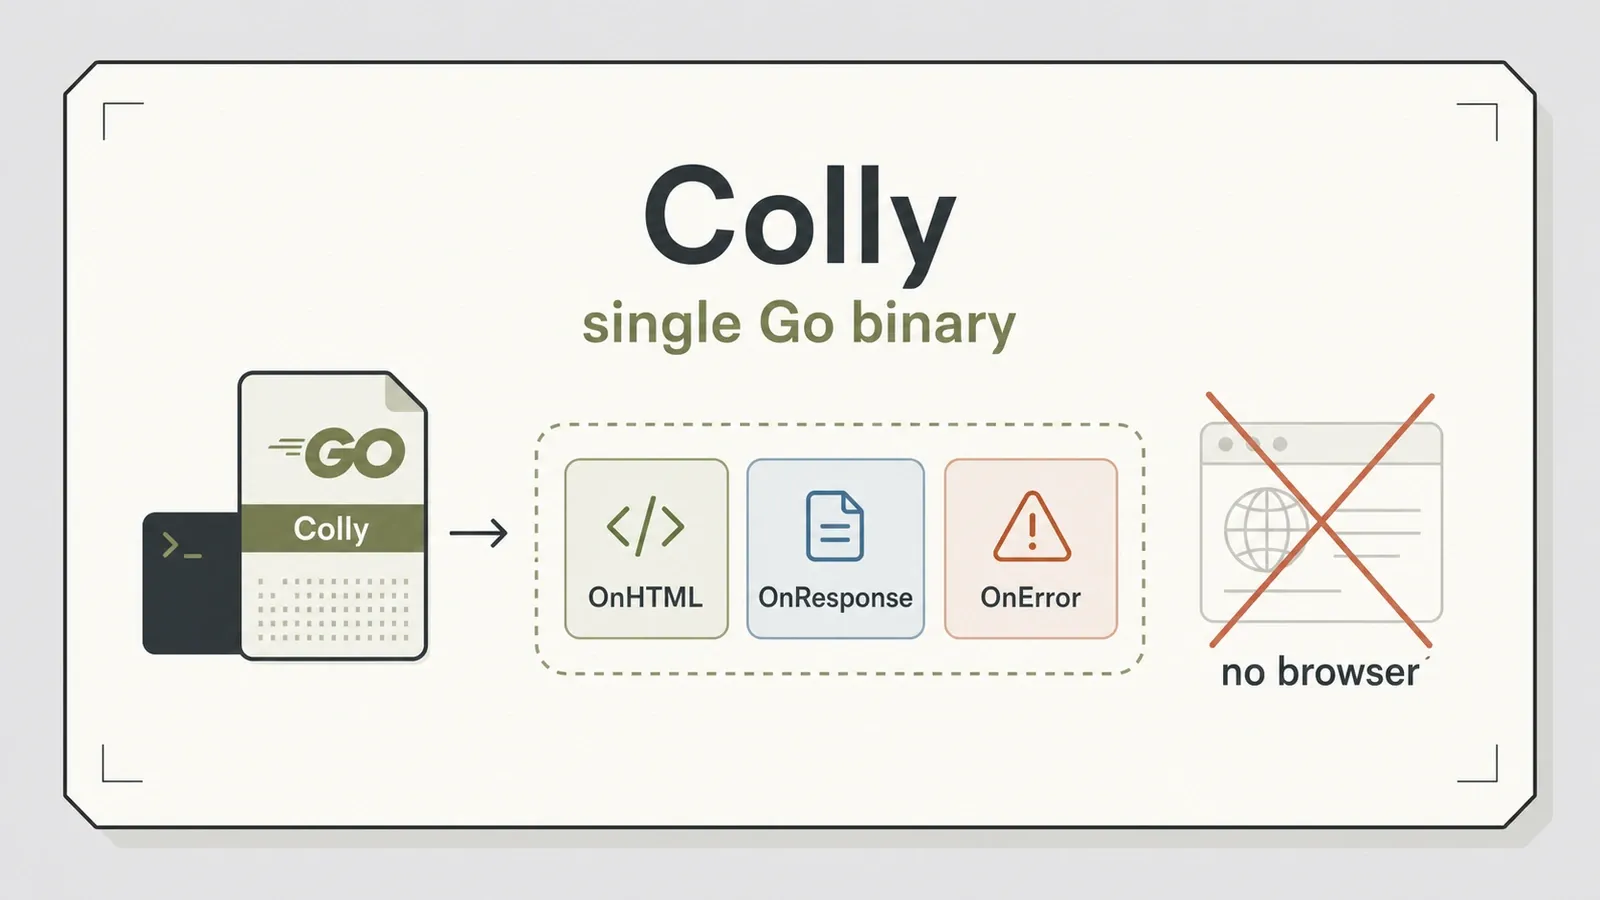
Colly называет себя "elegant scraper and crawler framework for Golang", и эта формулировка точнее, чем кажется. Это Go-библиотека — примерно 25 300 звёзд на GitHub и 1 850 форков — под лицензией Apache-2.0. Это не CLI, который скачал, указал URL и запустил. Ты пишешь код на Go, подключаешь Colly, регистрируешь несколько callbacks и собираешь всё в один исполняемый файл.
Модель здесь событийная. Ты навешиваешь handlers на Collector: OnHTML запускает логику извлечения по совпадающим CSS selectors, OnResponse отдаёт сырое тело ответа, а OnError обрабатывает сбои запросов. Обработчики ссылок вызывают Visit() для найденных URL, а MaxDepth ограничивает обход. Для этих HTTP-only сценариев целевому хосту не нужен отдельно установленный Go runtime или браузер; будет ли итоговый бинарник полностью статическим, зависит от build flags и использования CGO, а это в данном тесте не фиксировалось.
Ключевые возможности и как они работают внутри
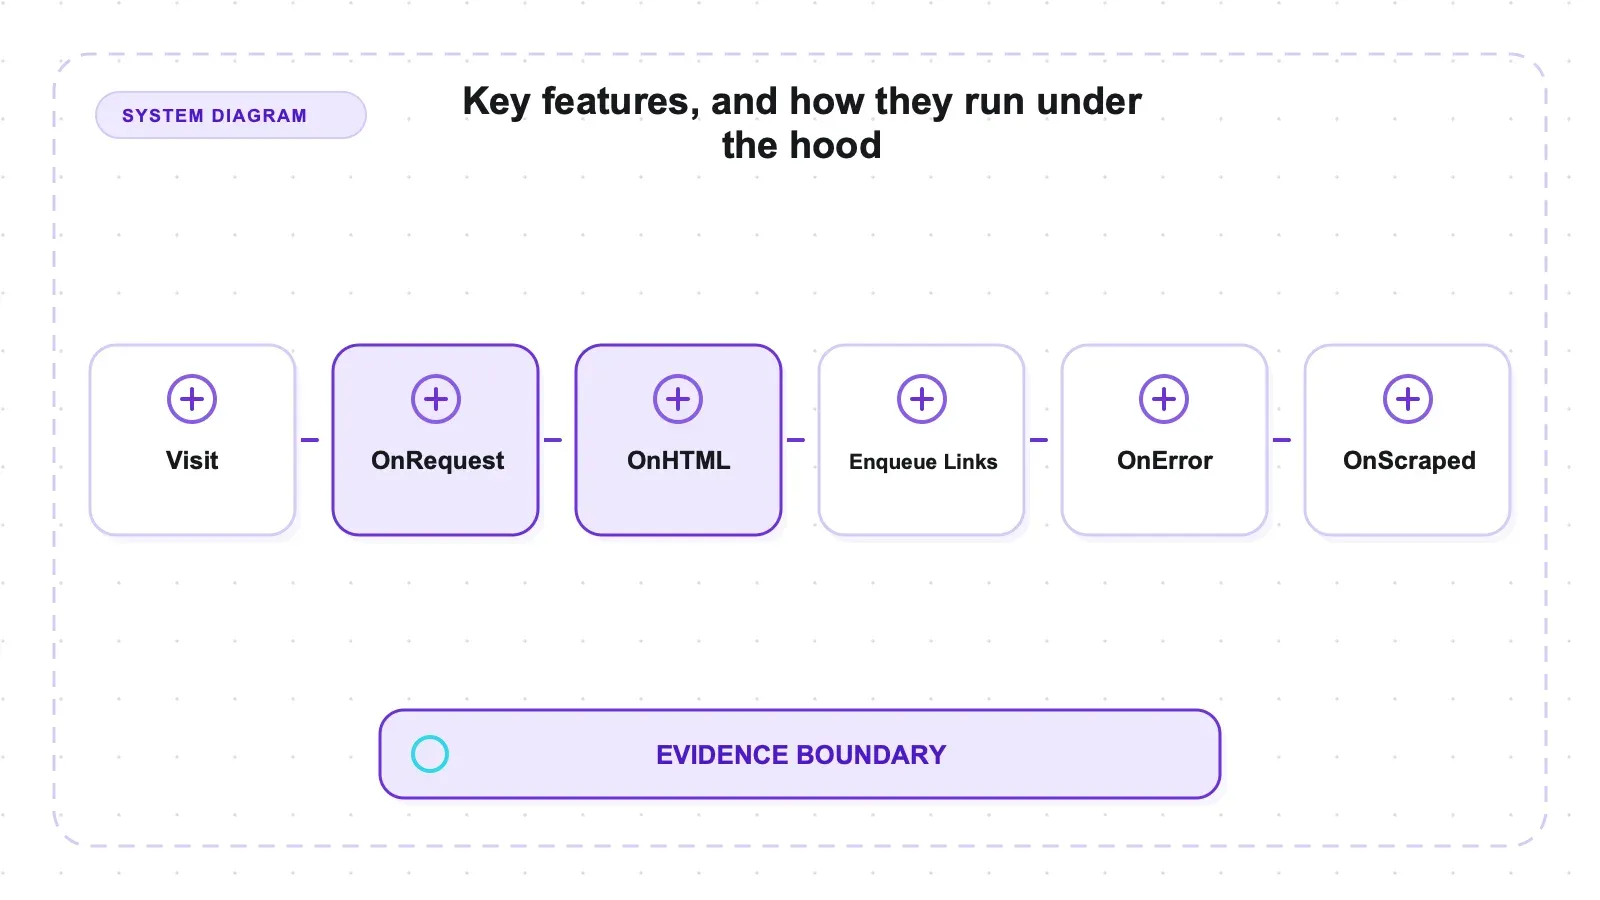
Сначала важно понять модель callbacks — именно она делает Colly не похожим на обычный скрипт "запросил и распарсил". Все тесты, которые я запускал, опирались на три callbacks.
OnHTML(selector, handler) — основной рабочий механизм. Регистрируешь его на .product или article p, и Colly вызывает твой handler для каждого совпавшего элемента по мере разбора DOM. Именно здесь и живёт структурированное извлечение: ты описываешь, что нужно забрать, а не пишешь цикл парсинга.
OnResponse(handler) находится уровнем ниже и даёт тебе сырые байты. Если target возвращает JSON вместо HTML, можно вообще пропустить DOM и самому разобрать тело ответа. Именно этот callback позволил Colly чисто обработать JSON API в моём тесте без какого-либо HTML-парсинга.
OnError(handler) отвечает за сбои запросов и может передавать вызывающему коду статус ответа. В этом тесте один fixture-ответ со статусом 500 дошёл до зарегистрированного callback. Retries, timeouts, DNS failures, connection resets, callback panics, persistence и alerting не тестировались.
Поверх callbacks есть ещё две операционные возможности. MaxDepth ограничивает обход ссылок согласно семантике глубины Colly. А скомпилированный Go-executable избавляет target host от необходимости отдельно устанавливать language runtime. В этом прогоне не фиксировались build flags и статус CGO, поэтому нельзя утверждать, что каждый получившийся бинарник полностью статичен.
Настройка: нужен Go toolchain
История зависимостей короткая, но реальная, поэтому скажу об этом сразу, до установки чего-либо. На машине, где я тестировал, Go не был установлен, а Colly — это Go-библиотека, значит первым шагом стало развёртывание Go toolchain на этой машине (я установил Go 1.26.5 через Homebrew). Если ваша команда не живёт в Go, вот где и возникает трение: не в самом Colly, а в среде, которая нужна ещё до первой компиляции.
После появления Go команда go get github.com/gocolly/colly/v2 подтянула версию v2.3.0. Для протестированных сценариев не понадобились ни браузер, ни headless Chrome.
Здесь есть один момент, который может запутать. Go module резолвился в v2.3.0 (опубликован December 2025), а самая свежая запись в GitHub Releases UI на момент проверки была v2.2.0 (March 2025). Это различие между версией модуля/репозитория и записью релиза GitHub, а не между module и Git tag. Я тестировал v2.3.0.
Практика: извлечение данных и границы применения
Я запускал Colly на автономном fixture-сервере (Go httptest) плюс на двух публичных demo-сайтах. Текущий benchmark directory и results/colly-test-summary.json доступны как артефакты, но обе ссылки ведут на движущуюся ветку. В статье не указан проверенный commit, точная команда, build flags или seed fixture, так что это пока не неизменяемая инструкция по воспроизведению.
| Тест | Target | Результат |
|---|---|---|
| Статический каталог + пагинация | локальный fixture | извлечено 12/12 ожидаемых товаров |
| Извлечение статьи | локальный fixture | заголовок + 3/3 абзаца |
| Прямой JSON-ответ | локальный fixture | 8/8 ожидаемых элементов через OnResponse |
| Обработка HTTP 500 | локальный fixture | отправлено в OnError, статус 500 |
Граф обхода (MaxDepth 2) | локальный fixture | 17 страниц |
| Books to Scrape | публичный demo | 20 товаров |
| Динамическая страница (без JS) | локальный fixture | 0 карточек (ожидаемо) |
| Quotes JS (без рендеринга) | публичный demo | 0 (ожидаемо) |
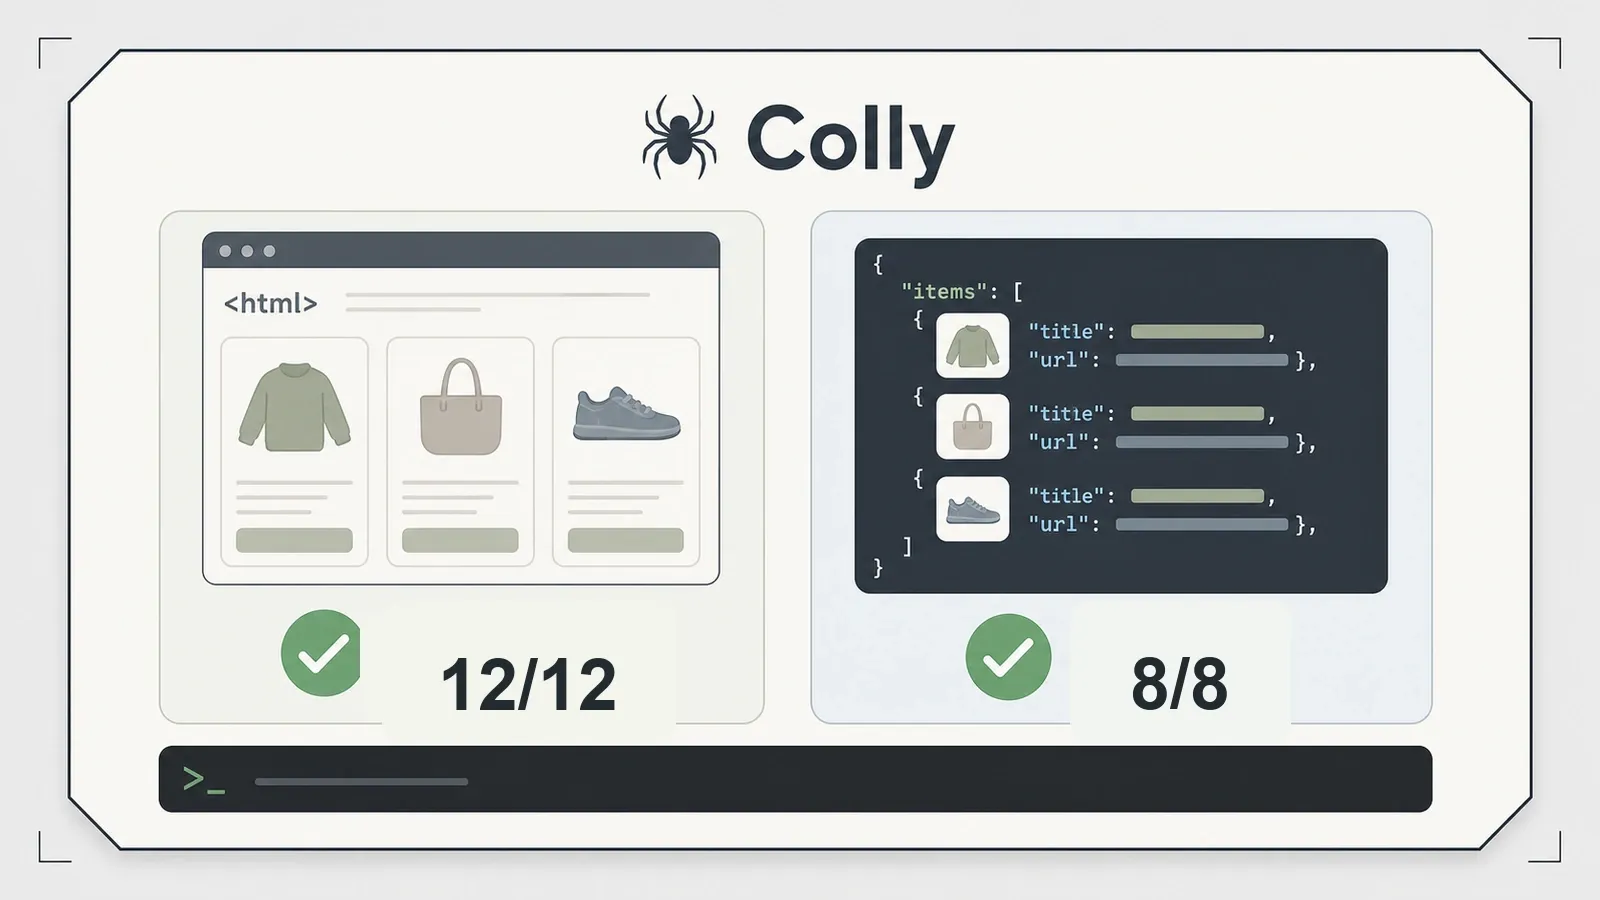
На контролируемых статических fixture заданные selectors извлекли 12 из 12 ожидаемых товарных записей и все три ожидаемых абзаца статьи. Прямой JSON-ответ вообще не затрагивал HTML-parser: OnResponse передал body, а harness разобрал все восемь ожидаемых элементов. Единственный fixture с 500 дошёл до OnError и отдал свой статус без падения процесса; это не доказывает надёжность при unattended-режиме. На публичной странице Books to Scrape selector вернул 20 товаров — как smoke test на публичном сайте.
Для обхода collector был настроен с MaxDepth(2) по seed-depth convention harness’а и посетил 17 URL в fixture-графе. Это результат по охвату обхода, а не по скорости. Зафиксированный trace — а не более широкое утверждение о любых графах — лежит в results/local_crawl_graph.json.
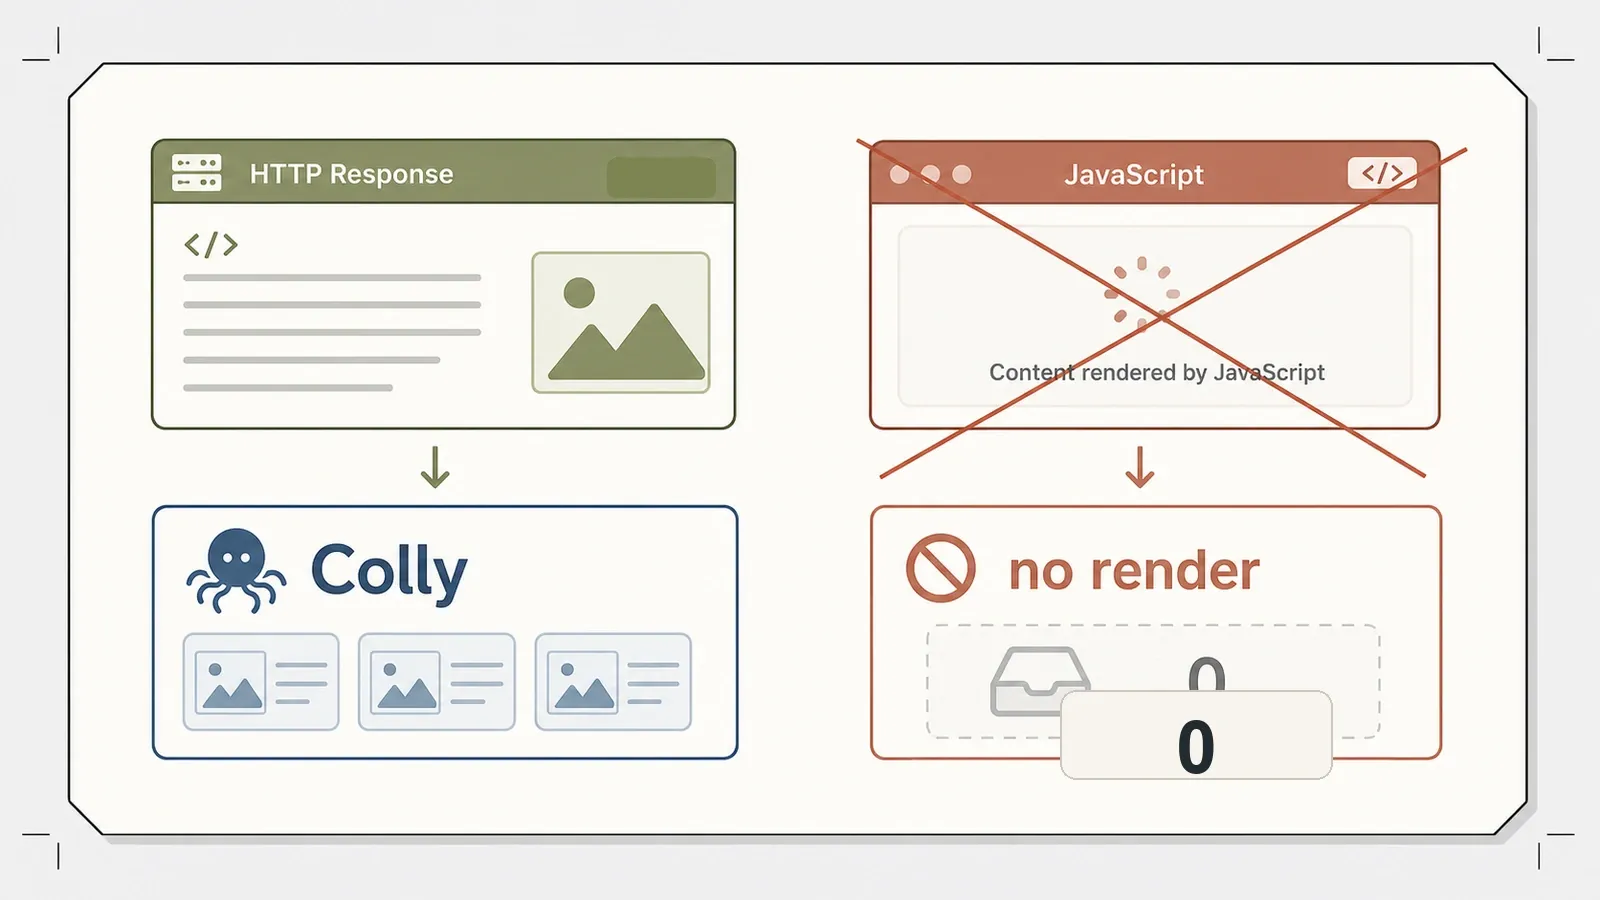
Colly не выполняет JavaScript. На fixture с рендерингом через JS было получено 0 целевых карточек, а на публичной странице Quotes to Scrape JS — 0 целевых цитат. Если элементы существуют только после выполнения кода в браузере и при этом нет доступного backing endpoint, HTTP-only путь эти элементы в виде rendered DOM не увидит. В таком случае нужен либо renderer, либо прямой вызов backing endpoint, если он есть — как показывает JSON fixture.
Я не проверял async collector, rate limiting, politeness-настройки, proxy rotation, retries или queue/storage backends. Не измерялись ни elapsed time, ни throughput, ни concurrency, ни CPU, ни memory, ни target latency, ни сравнительный baseline. Поэтому статья не делает никаких заявлений о скорости или надёжности в unattended-режиме.
Как интерпретировать результаты fixture
Три успешных контентных сценария проверяют разные контракты. Случаи с каталогом и статьёй тестируют CSS selection по HTML, который возвращает сервер. Их знаменатель — заранее прописанные ожидания fixture: двенадцать товарных записей и три абзаца статьи. Формулировка "извлечены ожидаемые записи" здесь намеренная. Этот прогон не определяет fuzzy matching, обработку дублей, tolerance к частично заполненным полям или общую метрику recall по корпусу, поэтому эти результаты нельзя переносить в общую оценку точности извлечения.
JSON-случай вообще обходит DOM selection. Colly получает байты ответа через OnResponse, а harness выполняет JSON decoding. Именно поэтому утверждение "Colly не рендерит JavaScript" не означает, что любой сайт с клиентской логикой недоступен. Если источник данных, который использует клиент, — это endpoint, к которому можно обратиться напрямую, и запрос воспроизводим вне браузера, HTTP crawler вполне может быть достаточным. Но authentication, generated signatures, browser-only state и anti-bot controls могут изменить ответ; здесь ничего из этого не проверялось.
Маршрут с 500 тестирует dispatch, а не recovery. Он показывает, что зарегистрированный OnError получил этот fixture-ответ и его статус. Production crawler всё равно нуждается в явной политике для retryable codes, backoff, terminal failures, persistence и alerting. Этот тест не даёт доказательств в пользу таких решений, и фразу "callback сработал" не следует читать как "задаче можно доверять без присмотра".
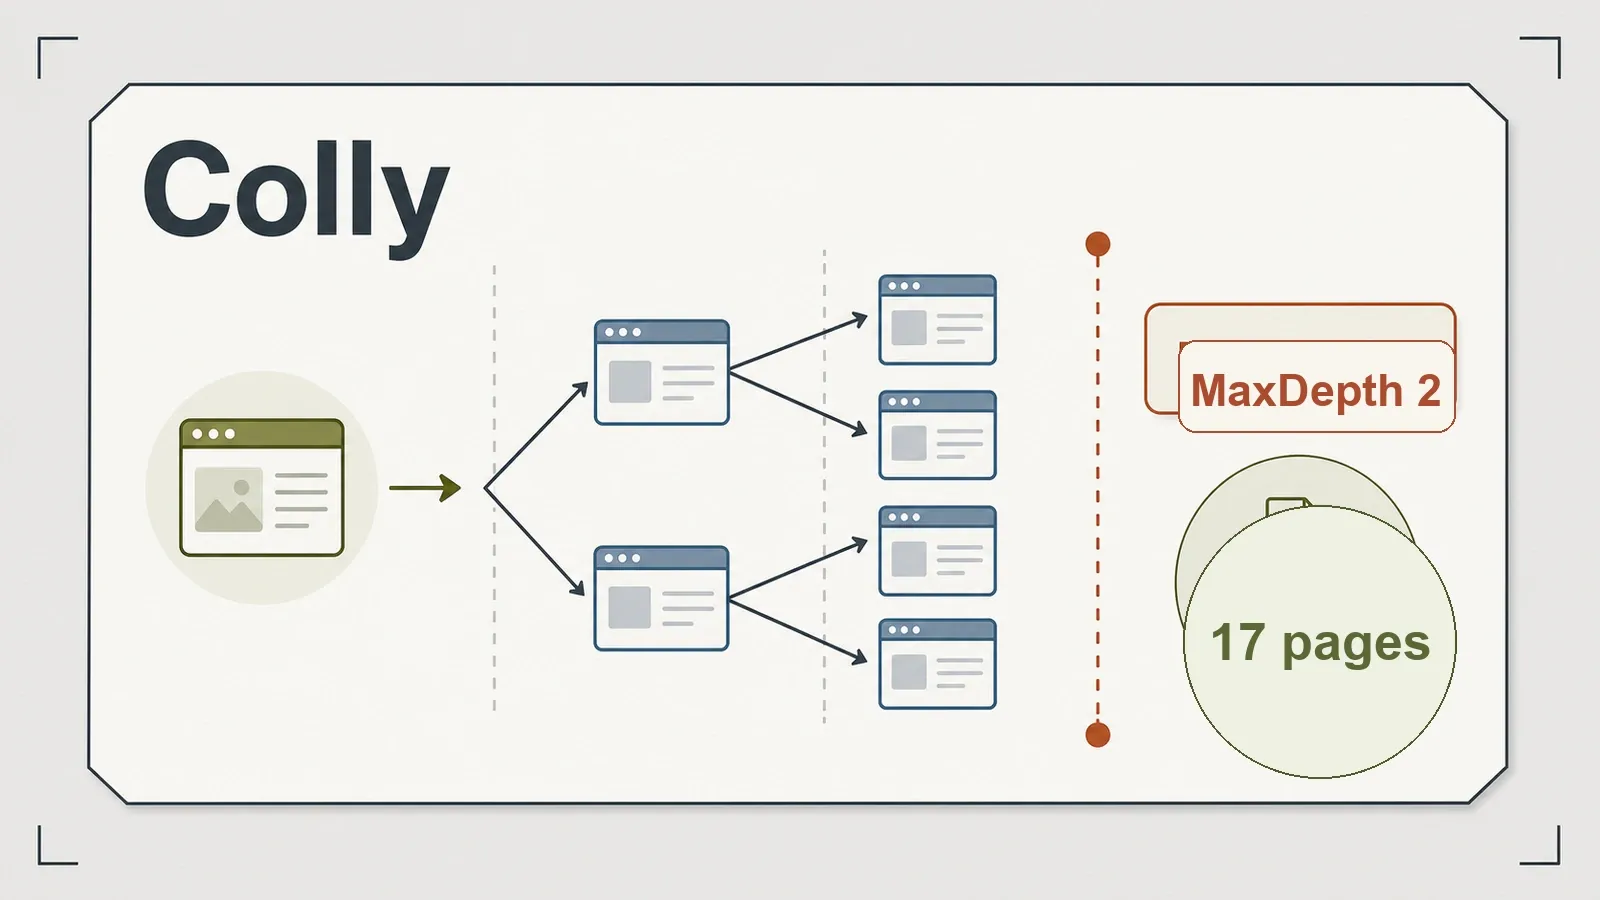
Граф из 17 URL столь же узкий по смыслу. Он подтверждает множество посещённых страниц именно для этого fixture, именно для этой seed-конвенции и именно при MaxDepth(2). Он не показывает pages per second, fairness между хостами, рост памяти или поведение на циклах и дублях URL. Для этого нужны отдельные тесты нагрузки и очередей.
Чеклист выбора, основанный на этом прогоне
Начни с того, что реально возвращает Colly. Если нужные поля уже присутствуют в HTML, который отдаёт сервер, используй OnHTML и проверь количество полей или обязательные ключи до того, как принять запись. Если ответ — JSON, обрабатывай тело через OnResponse и валидируй схему. Если HTML — это только application shell, проверь, нет ли доступного backing request, который содержит данные, прежде чем добавлять браузер.
| Что содержит ответ | Путь в Colly | Проверка на принятие |
|---|---|---|
| Обязательные поля в HTML от сервера | selectors OnHTML | обязательные ключи и ожидаемое количество записей |
| JSON payload, доступный напрямую | OnResponse + JSON decoding | проверка схемы и обязательных полей |
| HTML-shell, за которым стоит воспроизводимый запрос | запрос к backing endpoint | статус ответа, схема и полнота данных |
| Данные создаются только после выполнения в браузере | добавить renderer или выбрать browser crawler | готовность и полнота для конкретного target |
Когда браузерное выполнение действительно необходимо, относись к нему как к отдельному компоненту, а не как к чему-то, что можно включить флагом Colly. Браузер должен определить готовность, отдать отрендеренный контент или backing responses и передать данные дальше по pipeline. В этом обзоре такая интеграция не тестировалась.
Для внедрения зафиксируй версию Go, версию модуля, build flags, статус CGO, точную команду, seed fixture и commit репозитория. В текущих публикациях этих данных нет, а именно они отделяют проверяемые артефакты от устойчивого воспроизведения. Для эксплуатации добавь матрицу отказов и измеряй тот workload, который тебе реально важен, прежде чем называть систему быстрой или надёжной.
Плюсы и минусы
Плюсы:
- Извлёк 12/12 ожидаемых товаров каталога и 3/3 ожидаемых абзаца статьи через
OnHTML. - Чистая работа с JSON через
OnResponse, без необходимости парсить DOM — 8/8 элементов API. - Протестированный ответ 500 дошёл до
OnError, и статус был доступен. - Обход с ограничением по глубине достиг 17 страниц через один collector.
- Компилируется в Go-executable; на целевой машине для протестированных сценариев не нужен отдельно установленный Go runtime.
- Лицензия Apache-2.0 с широкими правами использования.
Минусы:
- Нет выполнения JavaScript — контент, отрисованный на клиенте, возвращает 0, без вариантов.
- Нужен Go toolchain; команды без Go сначала платят за настройку окружения, прежде чем написать хотя бы один scraper.
- Протестированный module (
v2.3.0) опережает самую свежую запись GitHub Release, которую удалось увидеть (v2.2.0). - Colly даёт ваш собственный код — callbacks, а не встроенный датасет или экспортёр feed, как у Scrapy.
- Async, rate limiting, proxy и queue backends существуют, но здесь не тестировались; throughput и масштаб не измерялись.
Для кого он подходит — и кому лучше пройти мимо
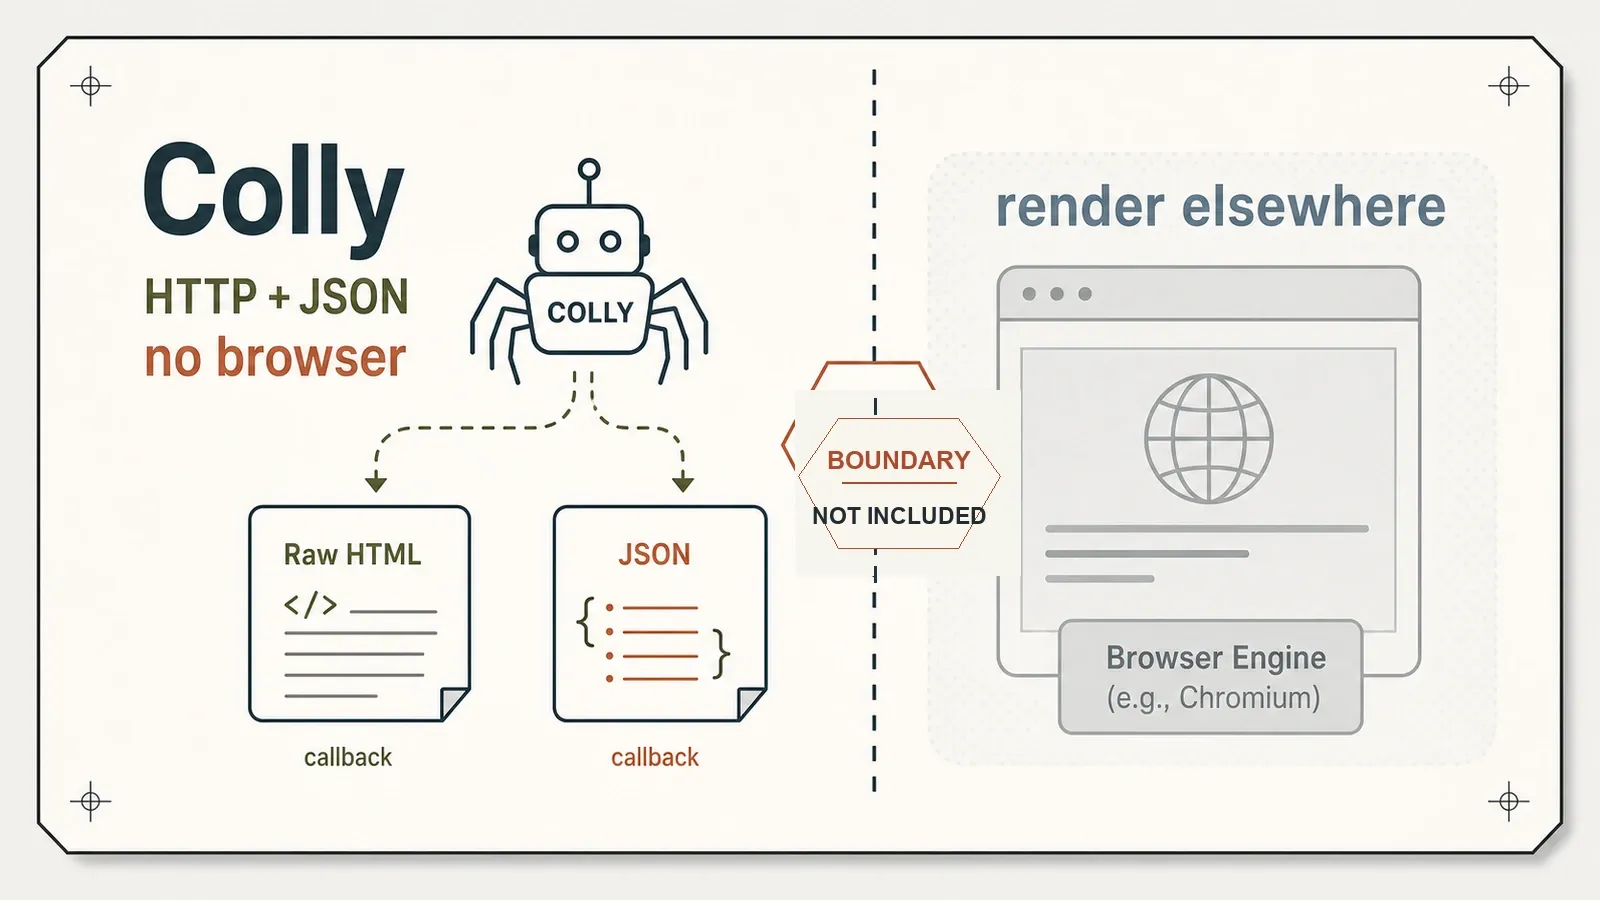
Colly хорошо подойдёт, если ты уже пишешь на Go и работаешь с server-rendered HTML или напрямую доступным JSON. Callback-модель разделяет структурированные совпадения, сырые payload и ошибки запросов. Скомпилированный executable также избавляет от необходимости отдельно устанавливать language environment на целевой машине, хотя полностью статическая линковка здесь не подтверждалась.
Добавляй renderer тогда, когда нужные элементы появляются только после выполнения в браузере и при этом нет пригодного backing endpoint. Прямой JSON-endpoint всё ещё можно запрашивать без рендеринга. Colly также менее удобен для команд, которые не хотят поддерживать Go toolchain, или для тех, кому нужен extraction service, берущий на себя формирование схемы и поддержку selectors.
Альтернативы, включая место Thunderbit
Colly — это open-source software, которое ты запускаешь сам. За само использование лицензия не взимает плату, но compute, bandwidth, proxies, storage, observability и инженерная работа остаются твоими затратами. Ты сам отвечаешь за поведение запросов, callbacks парсинга, логику обхода и интеграцию браузера, если target требует рендеринга.
Managed extraction service переносит часть этих обязанностей к вендору. Мы создаём Thunderbit, но не тестировали его на этих fixture, поэтому в этой статье нет сравнения по рендерингу, anti-bot, качеству, latency или стоимости. Разница в ответственности такова: Colly отдаёт HTTP responses и callbacks в твой Go-процесс; managed service может взять на себя получение данных и формирование схемы за плату за вызов.
Связанные обзоры benchmark: полное сравнение open-source scraper, обзор Python-crawler Scrapy и обзор адаптивных selectors Scrapling.
Попробовать Thunderbit для извлечения веб-данных
Итог
Colly — сильный кандидат для Go-команд, которые работают с server-rendered HTML или прямым JSON и готовы самостоятельно владеть кодом извлечения. Fixture подтверждают извлечение ожидаемых записей, один ограниченный trace обхода и один наблюдаемый callback на 500 — но не скорость, не масштаб и не unattended reliability. Для DOM, отрисованного браузером, нужен другой путь, если только исходный data endpoint нельзя вызвать напрямую.
Попробовать Thunderbit для извлечения веб-данных Get Started Free
FAQ
Измерялся ли в этом обзоре Colly по скорости? Нет. Проверялись извлечение ожидаемых записей, обработка прямого JSON, один callback ошибки и покрытие графа обхода fixture. Время выполнения, throughput, concurrency, CPU, memory и сравнительный baseline не измерялись.
Может ли Colly скрапить страницы с JavaScript-рендерингом? Colly не выполняет JavaScript страницы. Поэтому протестированный HTTP-путь не увидел target elements, которые появлялись только в rendered DOM. Но он всё ещё может напрямую обращаться к доступному backing JSON endpoint, как показывает JSON fixture. Используй renderer, когда выполнение обязательно и никакой воспроизводимый backing request не отдаёт данные.
Нужно ли знать Go, чтобы пользоваться Colly?
Да. Colly — это Go-библиотека, а не самостоятельный CLI: ты подключаешь её, регистрируешь callbacks (OnHTML, OnResponse, OnError) и компилируешь проект. На машине, где я тестировал, Go не было, поэтому настройка началась с установки Go toolchain (1.26.5). Если твоя команда не работает в Go, именно эта среда и есть реальная цена входа.
Почему установленная версия не совпадает с последним релизом Colly на GitHub?
Go module резолвился в v2.3.0 (December 2025), тогда как самой свежей записью GitHub Release, которую удалось увидеть, была v2.2.0 (March 2025). Я тестировал v2.3.0; это различие между версиями на разных поверхностях, а не признак сломанной установки.
Бесплатен ли Colly для коммерческого использования? Да, лицензия Apache-2.0 — permissive и подходит для коммерческих проектов. Как всегда, перед использованием проверь актуальную лицензию в repo.
Перед внедрением в production добавь тесты, которые соответствуют реальному риску, а не просто экстраполируют результаты fixture по аналогии. Прогоняй повторные обходы на representative targets, зафиксируй CPU и peak memory, проверь retryable и terminal failures, а также politeness при concurrency. Если важна persistence, останови и возобнови crawl, наблюдая за обработкой дублей и состоянием очереди. Если важна простота деплоя, зафиксируй точную конфигурацию compiler и linker и проверь runtime dependencies получившегося executable. Всё это не меняет того, что показал текущий fixture; это лишь отвечает, подходит ли та же конфигурация библиотеки для конкретной production-задачи.




