
Где-то между четырнадцатой вкладкой в браузере и третьим калькулятором тарифов я понял, что выбрать сервис веб-скрейпинга в 2026 году сложнее, чем сам скрейпинг. Рынок разросся до огромных размеров: no-code расширения для Chrome, сырые API, корпоративные стеки с прокси, AI-экстракторы и агентства полного цикла — все они борются за одну и ту же строку бюджета.
Я несколько недель тестировал 12 сервисов веб-скрейпинга на реальных задачах: собирал товарные данные с e-commerce сайтов, извлекал лиды из бизнес-каталогов и парсил вакансии с пагинацией и вложенными страницами. Цель была не в том, чтобы сравнить набор функций «в вакууме», а в том, чтобы ответить на один практический вопрос: какой сервис подходит какой команде?
Согласно открытому отчету Bright Data о веб-данных, 82% организаций сегодня считают публичные веб-данные критически важными для своего будущего. В отчете ScrapeOps за 2025 год говорится, что более 65% компаний используют веб-скрейпинг для построения датасетов под аналитику и AI. И все же исследование Apify за 2026 год показывает, что 46,7% специалистов по-прежнему полностью полагаются на внутренний код, вместе с той самой «налоговой» нагрузкой на поддержку, которая с ним идет.
Прежде чем перейти к инструментам, коротко разберем юридическую сторону скрейпинга.
Как я оценивал лучшие сервисы веб-скрейпинга
Вот на что я смотрел. Я выбрал именно эти критерии не по списку характеристик на сайте, а по тому, что обычно ломается после демо-этапа.
- Простота запуска / требуемый уровень технических навыков — сможет ли человек без разработки получить пользу менее чем за 10 минут?
- Антибот-защита и работа с прокси — сервис сам управляет прокси и решает CAPTCHA или это ваша проблема?
- Рендеринг JavaScript — справляется ли он с динамическими страницами с большим количеством JS «из коробки»?
- Форматы экспорта и интеграции — можно ли без написания связующего кода выгрузить данные в Sheets, Airtable или Notion?
- Планирование / автоматический мониторинг — можно ли запускать скрейпинг по расписанию без cron-задач?
- Масштабируемость — работает ли он на 100 страницах и продолжает ли работать на 1 млн?
- Прозрачность цены и стоимость на масштабе — можно ли предсказать счет за следующий месяц или это сюрприз?
- AI-извлечение против ручных селекторов — использует ли сервис AI для определения полей или нужно вручную писать CSS/XPath?
- Сколько поддержки нужно со временем — что произойдет, когда целевой сайт обновит дизайн?
Последний пункт особенно важен. В отзывах пользователей на инструменты вроде Octoparse, Apify, Browse AI и Bright Data снова и снова всплывают одни и те же жалобы: путаница в кредитной модели, поломка селекторов после изменений на сайте, падение облачных запусков на защищенных страницах и крутая кривая обучения после первого демо. «Нагрузка на поддержку» — это не второстепенный критерий. Именно он определяет, будете ли вы пользоваться инструментом через полгода.
Какой тип сервиса веб-скрейпинга подходит вашей команде?
Прежде чем сравнивать отдельные инструменты, полезнее всего помочь вам сразу перейти к правильной категории. Рынок веб-скрейпинга — это не один рынок. Это пять пересекающихся рынков, и выбор неправильной категории отнимает больше времени, чем выбор не того инструмента внутри правильной категории.
| Ваша ситуация | Рекомендуемый тип сервиса | Почему | Хорошие варианты из этого списка |
|---|---|---|---|
| Нетехническая команда (продажи, маркетинг, операционка), которой нужны данные быстро | No-code расширение для Chrome | Самый быстрый путь от сайта к таблице, минимум настройки | Thunderbit, Browse AI, Octoparse |
| Разработчик, встраивающий скрейпинг в приложение или пайплайн | Scraping API | Больше контроля, вебхуки, асинхронные задачи, лучше подходит для CI/CD | ScrapingBee, ScraperAPI, ZenRows |
| Команда, которая подает данные в AI/LLM-воркфлоу | AI-native API для извлечения | Markdown/JSON-first вывод, меньше ручной очистки HTML | Thunderbit API, Firecrawl, Diffbot |
| Enterprise, которому нужны прокси-инфраструктура и большие объемы | Полноценная платформа сбора данных | Встроенные прокси, антибот-защита, SLA, высокая параллельность | Bright Data, Oxylabs, Apify |
| Компания, которой нужны готовые данные, а не управление инструментами | Managed service / агентство | Вендор берет на себя сборку, мониторинг, QA и доставку | ScrapeHero |
Это не теория. Руководство Zyte по выбору между build и buy за 2026 год прямо формулирует компромисс: DIY дает контроль, но создает постоянную поддержку; гибридные стеки превращаются в операционную мозаику; managed services снимают внутреннюю нагрузку, но уменьшают гибкость self-serve.
AI-извлечение против традиционных CSS/XPath-селекторов
Сейчас это главный технический разворот на рынке.
Традиционный скрейпинг — это как идти по карте сокровищ с точными координатами. Вы изучаете страницу, находите селектор вроде .product-title, пишете правило извлечения, тестируете его и надеетесь, что завтра сайт будет выглядеть так же. Если frontend-команда меняет имя класса или оборачивает контент в новый div, скрейпер ломается.
AI-скрейпинг работает скорее как умный помощник, которому вы говорите: «Найди на этой странице название товара, цену и статус наличия». Вместо жесткой фиксации маршрута вы описываете результат.
Вот как это выглядит на практике:
Традиционный сценарий:
- Открыть DevTools и посмотреть элемент
- Найти класс
.product-titleили XPath - Написать правило извлечения
- Протестировать на примерах страниц
- Исправлять каждый раз, когда сайт меняет классы
AI-сценарий (например, Thunderbit):
- Открыть страницу и нажать один раз
- AI сам подбирает колонки — название товара, цена, рейтинг
- При необходимости скорректировать или просто сказать, что нужно
- Иначе оно просто запускается, а вы получаете таблицу
Публикуемые исследования более узкие, чем маркетинговые обещания. В статье Scientific Reports 2025 года сообщается о на 35% более высокой точности извлечения и на 40% большей эффективности обработки у AI-краулера по сравнению с обычными, но тестовая среда там — газетные архивы, а не товарные страницы или бизнес-каталоги, поэтому я бы не переносил эти цифры на сайты из этой статьи. Более полезен обзор Springer 2025 года: AI-модели лучше адаптируются к динамическим структурам, но им все равно нужна дообучаемость или fallback-логика, когда домены или шаблоны заметно меняются.
| Параметр | Традиционный подход (CSS/XPath) | AI-извлечение |
|---|---|---|
| Время настройки | 15–60 мин на сайт | около 30 секунд |
| Технические навыки | Уровень разработчика | Не требуются |
| Работа с изменениями верстки и новыми сайтами | Ломается — новые правила после каждого редизайна, новые правила для каждого нового сайта | Обычно адаптируется — читает страницу заново при каждом запуске |
| Предсказуемость | Детерминированная — одно и то же правило каждый раз забирает одно и то же поле | Вероятностная — может выбрать не то поле, поэтому нужен выборочный контроль |
| Разметка / преобразование данных | Отдельный постпроцессинг | Может размечать, переводить и категоризировать прямо во время скрейпа |
| Лучше всего подходит для | Стабильных, больших, поддерживаемых разработчиками пайплайнов | Длинного хвоста сайтов, разных макетов, нетехнических пользователей |
Самое заметное реальное отличие — это поддержка. Надежной публичной цифры о том, как часто ломаются скрейперы, нет, поэтому я не буду ее придумывать. Но в отзывах G2 и Capterra на инструменты на базе селекторов постоянно повторяется одна и та же форма жалобы: редко то, что инструмент вообще не смог достать данные, и почти всегда то, что он перестал их собирать после изменений на сайте.
Thunderbit — самый чистый пример AI-first модели в этом списке. Его AI сам выбирает, какие поля стоит собрать, после одного клика, либо вы можете описать нужные данные одной строкой, а Field AI Prompts позволяют размечать, переводить, резюмировать или категоризировать данные прямо во время извлечения, а не только после. Его Open API предоставляет эндпоинты Distill и Extract, так что та же модель AI-извлечения доступна и программно.
Попробовать AI-скрейпинг с Thunderbit
Все 12 лучших сервисов веб-скрейпинга в одном обзоре
| Сервис | Тип | Лучше всего для | Антибот / прокси | Рендеринг JS | AI-извлечение | Бесплатный тариф | Стартовая цена (помесячно) | Варианты экспорта |
|---|---|---|---|---|---|---|---|---|
| Thunderbit | No-code расширение Chrome + API | Нетехнические команды | ⚠️ Обработка через облако | ✅ | ✅ AI-сопоставление полей | ✅ 6 страниц бесплатно | Бесплатно; платные от $15/мес | Excel, CSV, JSON, Sheets, Airtable, Notion |
| Bright Data | Полноценная платформа | Enterprise-пайплайны | ✅ Лучшая в классе прокси-сеть | ✅ | ⚠️ Частично / новые AI-слои | ✅ 5K записей/мес | Без минимального месячного платежа | JSON, CSV, API, webhook |
| Oxylabs | Enterprise-прокси + скрейпинг | SERP-скрейпинг, защищенные сайты | ✅ Residential/DC proxies | ✅ | ⚠️ Ограничено | ⚠️ Пробный период | около $49/мес | JSON, CSV, API |
| Apify | Платформа + маркетплейс | Разработчики, automation builders | ✅ Через proxy config | ✅ | ⚠️ Некоторые actors | ✅ $5 бесплатно/мес | $29/мес + расход | JSON, CSV, Excel, API |
| ScrapingBee | API-сервис | Dev-пайплайны | ✅ Встроено | ✅ | ⚠️ Некоторое AI-извлечение | ✅ 1,000 кредитов | $49/мес | JSON, HTML, Markdown, API |
| ScraperAPI | API-сервис | Мониторинг цен на масштабе | ✅ Встроенная ротация | ✅ | ❌ | ⚠️ 7-дневный trial, 5K кредитов | $49/мес | JSON, CSV, API |
| ZenRows | API-сервис | Сайты с сильной антибот-защитой | ✅ Премиум антибот | ✅ | ⚠️ Beta | ✅ 5K кредитов/мес | $19/мес | JSON, API |
| Octoparse | No-code desktop + cloud | Визуальный no-code скрейпинг | ✅ Встроено | ✅ | ⚠️ Ограниченное автоопределение | ✅ Бесплатный план (10 задач) | $39/мес | Excel, CSV, JSON, HTML, XML, DB, Sheets |
| Diffbot | AI/NLP-платформа | Структурированные enterprise-данные | ⚠️ Базовый–умеренный уровень | ✅ | ✅ На базе NLP | ✅ 10K кредитов/мес | $299/мес | JSON, CSV, API |
| Firecrawl | Developer API (AI) | LLM/RAG-пайплайны | ✅ Встроено | ✅ | ✅ Markdown + structured | ✅ 1,000 кредитов/мес | $19/мес | Markdown, JSON, HTML, API |
| Browse AI | No-code monitoring | Обнаружение изменений, нетехнические пользователи | ⚠️ Базовый | ✅ | ⚠️ На шаблонах | ✅ 50 кредитов/мес | $48/мес | CSV, JSON, Sheets, Airtable, API |
| ScrapeHero | Managed service / агентство | Enterprise, которому нужен сервис без операционной нагрузки | ✅ Полностью управляемо | ✅ | N/A | ❌ | От $199/мес | Индивидуальная доставка |
Картина довольно очевидна.
Thunderbit, Browse AI и Octoparse оптимизированы под скорость запуска. ScrapingBee, ScraperAPI и ZenRows — под контроль разработчика. Bright Data, Oxylabs и Apify — под масштаб и инфраструктуру. Firecrawl и Diffbot — под AI-форматы вывода. ScrapeHero — под вариант, где вам вообще не нужно ничего обслуживать самостоятельно.
1. Thunderbit
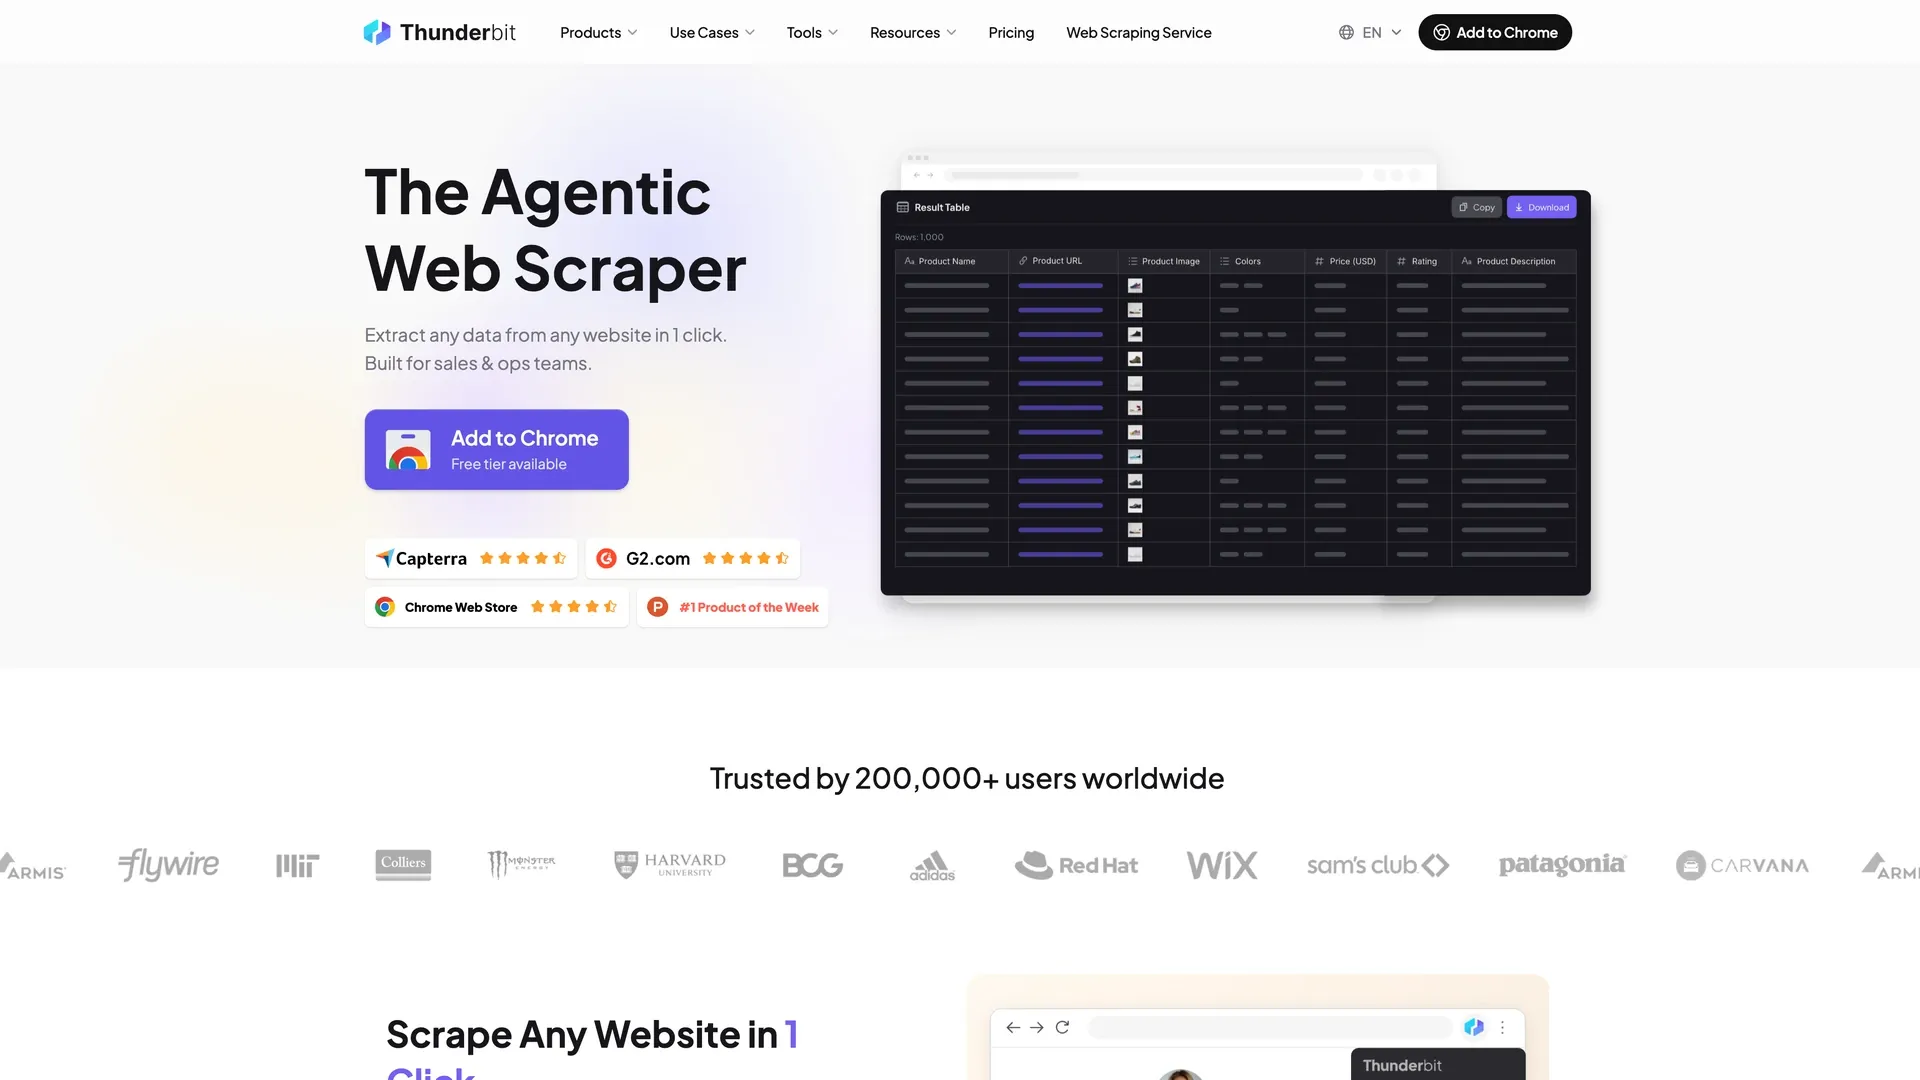 Thunderbit — самый простой продукт в этом списке для нетехнических пользователей, которым нужно перейти от сайта к таблице, не трогая ни одного селектора. Основной сценарий работы здесь необычно прямолинейный: откройте расширение Chrome на любой странице и нажмите один раз — AI сам поймет, какие поля стоит забрать, и выполнит задачу; если нужен конкретный формат, просто опишите его обычным языком. Для большинства страниц это буквально весь процесс. Никаких CSS-селекторов. Никакого XPath. Никакого инспектирования элементов.
Что отличает Thunderbit — это не только извлечение полей. Он также может размечать, переводить, резюмировать, категоризировать и переформатировать данные прямо во время скрейпа с помощью Field AI Prompts. Это важно, потому что реальный bottleneck для бизнес-пользователей часто не в самом извлечении, а в последующей очистке данных после экспорта. С Thunderbit можно собрать, например, французскую товарную страницу и получить английский вывод с метками тональности — за один проход.
Ключевые возможности:
- Настройка без селекторов — один клик, и AI сам подбирает колонки, либо вы просто пишете, что нужно
- Browser mode для страниц с авторизацией и cloud mode (50 страниц за раз) для быстрого скрейпинга публичных страниц
- Сбор подстраниц для автоматического обогащения списковых страниц данными с детальных страниц
- Встроенная поддержка пагинации и бесконечной прокрутки
- Планирование на естественном языке для повторяющегося мониторинга (например, «каждый понедельник в 9:00»)
- Готовые шаблоны скрейперов для популярных сайтов вроде Amazon, Zillow, Google Maps и Indeed
- Open API с эндпоинтами
DistillиExtractдля разработчиков - Поддержка 34 языков, включая перевод во время извлечения
С экспортом у Thunderbit один из самых сильных аргументов. Он бесплатно и нативно экспортирует в Excel, CSV, JSON, Google Sheets, Airtable и Notion — включая работу с изображениями в Airtable и Notion. Для sales-команды, которая живет в Sheets, или маркетинга, который ведет ресерч в Notion, это убирает целый этап преобразования, который в API-first инструментах остается на вас.
Цена: Кредитная модель. Бесплатный тариф включает 6 страниц в месяц и 7-дневный доступ к Pro-функциям. Платные browser-планы начинаются с $15/мес при помесячной оплате или $9/мес при годовой. У API своя цена: 600 бесплатных единиц на старте, затем $29/мес за 6,000 единиц на Starter, $72/мес за 60,000 на Pro 1, $120/мес за 120,000 на Pro 2, а также ползунок до 480,000 единиц в месяц. При годовой оплате — $16/мес за 60,000 единиц в год на Starter и $40/мес за 600,000 на Pro 1.
Плюсы:
- Самый низкий порог входа в этом сравнении
- Нативный экспорт в таблицы, а не схема «сначала JSON, потом разберитесь»
- AI-преобразование прямо во время извлечения, а не только после
- Сильный вариант для sales, e-commerce, исследований и недвижимости
Минусы:
- Две кредитные системы в разных единицах: расширение считает 1 кредит за строку результата (2 при сборе подстраниц), API считает 1 единицу за страницу Distill и 20 за страницу Extract — бюджетировать их нужно отдельно
- Бесплатный тариф — всего 6 страниц в месяц, что заметно меньше, чем дают другие API-провайдеры здесь (Firecrawl 1,000 кредитов/мес, ZenRows 5,000, Diffbot 10,000)
- Self-serve заканчивается раньше enterprise-объемов: верхний публичный browser-план — Pro за $38/мес при помесячной оплате, а выше уже идет индивидуальный Business-расчет
Лучше всего для: генерации лидов для продаж, мониторинга конкурентов в e-commerce, маркетинговых исследований, парсинга вакансий и каталогов, недвижимости.
2. Bright Data
 Bright Data — это выбор enterprise-покупателей, которым нужен один поставщик для прокси, scraping API, датасетов, SERP API и все чаще AI-ассистированного извлечения. Это скорее не один продукт, а полноценный стек для сбора данных.
Цены на Web Scraper API публичны: бесплатный уровень на 5,000 записей в месяц, pay-as-you-go примерно по $1.50 за 1,000 записей и scale-план за $499/мес с 384,000 включенными записями и $1.30 за 1,000 сверх этого. Здесь запись — это один извлеченный объект, одна строка в таблице, а не одна загруженная страница. Residential proxies начинаются с $4/GB. Есть также структурированные датасеты, Scraper Studio, AI scrapers и поддержка MCP.
Ключевые возможности:
- Очень сильная proxy-сеть (residential, datacenter, mobile, ISP)
- Полный browser rendering и CAPTCHA-solving включены в цену Web Scraper API
- Маркетплейс датасетов для уже собранных данных
- Enterprise-подход к комплаенсу с Trust Center и сертификациями
Цена: Pay-as-you-go от примерно $1.50 за 1K записей; scale-план от $499/мес.
Плюсы: Непревзойденный масштаб и прокси-инфраструктура. Широкие enterprise-механизмы управления.
Минусы: Сложнее, чем нужно большинству mid-market-команд. Цена быстро растет при сочетании API, прокси и дополнительных слоев. Платформа по-прежнему подразумевает технического владельца, даже несмотря на новые AI-функции.
Лучше всего для: пайплайнов Fortune 500, команд данных, которые парсят миллионы страниц, скрейпинга между регионами, где важна качество прокси, и компаний с жесткими требованиями к комплаенсу.
3. Oxylabs
 Oxylabs — сильнейший pure enterprise-вариант в категории proxy + scraping для команд, которым прежде всего важна надежность на защищенных сайтах. Он предлагает residential и datacenter proxies, Web Scraper API, SERP Scraper API, Web Unblocker и более новый Headless Browser layer.
Цены начинаются с $49/мес за Web Scraper API, а стоимость за результат зависит и от целевого сайта, и от плана. На плане Micro за $49 обычный сайт — то есть все, кроме Amazon или Google — стоит $1.15 за 1,000 результатов без JS-rendering и $1.35 с ним; на плане Advanced за $249 эти цифры падают до $0.95 и $1.25, а на более высоких уровнях снижаются еще сильнее. Residential proxies стартуют с $6/GB и снижаются до $2.50/GB на 1TB.
Ключевые возможности:
- Очень сильная proxy-инфраструктура с автоматической ротацией и управлением сессиями
- SERP Scraper API, созданный специально для мониторинга поисковиков
- Модель оплаты только за успешные результаты на основных продуктах
- Ясный Trust Center и сильная позиция по комплаенсу
Цена: От $49/мес; без постоянного free-тарифа (только trial).
Плюсы: Надежные прокси, отлично подходит для SERP-скрейпинга, сильная доверенная позиция enterprise.
Минусы: Громкая цифра результата в каждом плане предполагает Amazon без JS-rendering — на обычном сайте при $1.15 за 1,000 плана Micro хватит примерно на 42,600 результатов, а не на 98,000. Поскольку ставка за 1,000 меняется и от типа сайта, и от уровня плана, две команды, парсящие один и тот же объем, могут получить совершенно разные счета.
Лучше всего для: SEO-команд, enterprise-мониторинга поисковой выдачи, крупных workloads с сильной зависимостью от прокси.
4. Apify
 Apify — самая гибкая marketplace-платформа в этом списке. Она объединяет облачное исполнение, хранилище, расписания, логи, API и огромную экосистему готовых «Actors» — в Apify Store сейчас более 59,000 Actors. Вместо того чтобы писать каждый скрейпер с нуля, часто можно начать с уже существующего actor для Google Maps, Amazon, Instagram, TikTok или универсального crawler’а для контента сайтов.
Ключевые возможности:
- Огромный маркетплейс готовых скрейперов
- Apify SDK для разработки собственных actor’ов
- Встроенное управление прокси и облачное исполнение
- Сильные API, хранилище, расписания и логирование
Цены основаны на использовании: free-план с $5 на расход, затем $29/мес Starter, $199 Scale, $999 Business — и поверх этого идет биллинг по compute units. Такая гибкость мощная, но прогнозировать месячные расходы сложнее, чем у более простых API-продуктов.
Плюсы: Большое сообщество, много готовых скрейперов, удобно и для хобби-уровня, и для продакшн-автоматизации.
Минусы: Настройка и отладка actor’ов требует времени. Цена на основе compute units плюс стоимость actor’ов плюс прокси бывает трудно предсказуемой. Лучше для builders, чем для бизнес-пользователей, работающих в первую очередь с таблицами.
Лучше всего для: разработчиков и automation builders, команд, которым нужно переиспользовать готовые скрейперы, гибридных workflows «собери и купи».
5. ScrapingBee
 ScrapingBee — один из самых простых scraping API по логике и интеграции. Он делает ставку на headless Chrome rendering, ротацию прокси и аккуратную API-эргономику вместо того, чтобы быть визуальной платформой.
Цена начинается с $49/мес за 250,000 кредитов и 50 одновременных запросов, а Startup стоит $99/мес за 1,000,000 кредитов и 100 concurrent requests. Новые пользователи получают 1,000 бесплатных API-кредитов. Но есть нюанс: JS-rendering, premium proxies, скриншоты и AI-извлечение расходуют кредиты по более высоким коэффициентам.
Ключевые возможности:
- Очень чистый REST API
- Отдельные эндпоинты для Amazon, Google, YouTube, Walmart и ChatGPT
- Может возвращать HTML, JSON, Markdown или простой текст
- Хорошо подходит для AI/LLM-пайплайнов, потому что Markdown снижает объем очистки
Плюсы: Дружелюбен к разработчикам, надежный JS-rendering, прозрачная базовая цена.
Минусы: План за $49 — это 250,000 кредитов, но только для 250,000 простых запросов: JS-rendering, premium proxies, скриншоты и AI-извлечение каждый стоят больше одного кредита за вызов, поэтому на реальных целях страниц вы получаете заметно меньше, чем кажется по заголовку. Конкурентность привязана к плану (50 параллельных запросов на Freelance), так что throughput может подтолкнуть вас к более высокому уровню раньше, чем объем. По-прежнему нужен код и его поддержка.
Лучше всего для: разработчиков, которые встраивают скрейпинг в backend, команд, которым нужен простой API, и LLM-пайплайнов, где важен текстовый вывод.
6. ScraperAPI
 ScraperAPI по-прежнему остается одним из самых сильных структурированных API-вариантов для мониторинга e-commerce и повторяющегося массового скрейпинга. Продуктовая идея здесь простая: один эндпоинт, который объединяет прокси, повторы, JS-rendering, geo-targeting и структурированный вывод.
Цена начинается с $49/мес за 100,000 кредитов и 20 потоков, а Startup — с $149/мес за 1,000,000 кредитов и 50 потоков. Есть и 7-дневный trial с 5,000 кредитов без привязки карты. Интереснее всего у ScraperAPI структурированный слой: async API, доставка через webhook, DataPipeline для low-code-проектов и structured endpoints для Amazon, eBay, Google, Redfin и Walmart.
Ключевые возможности:
- Сильные структурированные эндпоинты для крупных e-commerce и поисковых доменов
- Хорошая поддержка async и webhook
- Конкурентная цена для высокообъемного мониторинга
- Широкий набор geo-targeting и rendering-опций
Плюсы: Щедрые trial-кредиты, хорошая документация, надежность для мониторинга e-commerce.
Минусы: Мультипликаторы кредитов усложняют модель затрат. Нет настоящего AI-извлечения для произвольных страниц. Только для разработчиков.
Лучше всего для: мониторинга цен в e-commerce, competitive intelligence, поисковых и marketplace-пайплайнов.
7. ZenRows
 ZenRows — специалист по антибот-защите. Он сосредоточен на обходе Cloudflare, DataDome, Akamai, Imperva и похожих защит, при этом сохраняя современный developer experience.
Цена начинается с $19/мес на плане Build (45,000 кредитов, 20 concurrent requests). Сам Build — это еще и ползунок: $29 за 80,000 кредитов, $39 за 120,000; выше находятся Launch за $69/мес с 250,000 кредитов и 50 concurrent requests и Growth за $199/мес с 1.2 млн. Это цены при помесячной оплате, а при годовой — скидка 17%. Модель затрат основана на мультипликаторах: JS-rendering — 5x, premium proxies — 10x, а использование обоих вместе — 25x.
Ключевые возможности:
- Отличный фокус на сильно защищенных сайтах
- Широкая документация и покрытие антибот-сценариев
- Современная экосистема интеграций, включая LangChain, LlamaIndex и MCP
- Оплата только за успешные запросы
Плюсы: Очень высокий процент успешного прохождения на сложных целях.
Минусы: На защищенных нагрузках цена быстро растет. Страница, которой нужны и JS-rendering, и premium proxy, стоит 25 кредитов вместо 1, так что план за $19, который выглядит как 45,000 страниц, на сложных целях превращается примерно в 1,800 страниц.
Лучше всего для: разработчиков, парсящих сложные цели, задач мониторинга с сильной антибот-защитой, команд, которым важнее пройти защиту, чем получить красивый spreadsheet UX.
8. Octoparse
 Octoparse — это классический no-code desktop-скрейпер: визуальный конструктор сценариев, desktop-исполнение, облачное планирование, встроенная навигация в браузере и широкий набор экспортов. Если Thunderbit — AI-first вариант с «одним кликом», то Octoparse — это визуальный flow-builder для пользователей, которые хотят строить логику извлечения шаг за шагом.
Цена сложнее, чем кажется на первый взгляд. В центре помощи указаны месячные тарифы — Basic за $39/мес, Standard от $83/мес и Professional за $299/мес — а на основной странице цены по умолчанию показаны для годовой оплаты, поэтому там основные цифры выглядят как $69/мес за Standard и $249/мес за Professional. Это одни и те же планы при двух разных вариантах биллинга, а не два конфликтующих прайс-листа; единственный реальный пробел — Basic, которого на основной странице вообще нет. Поэтому перед сравнением обязательно проверьте, за какой период указана цена. На странице также выделяются доп.услуги вроде residential proxies, CAPTCHA-solving, настройки crawler’а и полностью управляемого data service.
Ключевые возможности:
- Зрелый визуальный конструктор workflow
- Широкий экспорт: Excel, CSV, JSON, HTML, XML, Google Sheets, базы данных
- Встроенные облачное планирование и автоматизация
- Шаблоны скрейперов для распространенных сайтов
Плюсы: Код не нужен, хорошо подходит для повторяющегося скрейпинга среднего масштаба, много вариантов экспорта.
Минусы: При изменении макетов поддержка требует больше усилий, чем у AI-native инструментов (из-за селекторов). Динамические или защищенные сайты все еще могут создавать трение. Desktop-first UX может ощущаться тяжелее, чем browser-first решения.
Лучше всего для: no-code пользователей, которым нужно больше контроля, чем дает простой AI prompt, повторяющегося скрейпинга среднего масштаба, команд, которым комфортны визуальные workflow.
9. Diffbot
 Diffbot — самая enterprise-ориентированная AI-платформа для извлечения в этом списке. Ее обещание звучит не как «собери эту страницу», а как «пойми тип страницы и преврати его в структурированные данные на масштабе». В продуктовую линейку входят Extract, Crawl, Natural Language и Knowledge Graph.
Цена начинается с бесплатного уровня на 10,000 кредитов, затем $299/мес за Startup (250,000 кредитов), $899 за Plus (1,000,000 кредитов) и индивидуальные enterprise-планы. Обычная извлеченная веб-страница стоит 1 кредит; экспорт записи в Knowledge Graph значительно дороже.
Ключевые возможности:
- Сильное автоматическое понимание типа страницы (статьи, товары, обсуждения)
- Отлично подходит для построения knowledge graph и entity pipelines
- Извлечение на базе NLP — селекторы не нужны
- Премиальная поддержка и enterprise-позиционирование
Плюсы: Мощное AI-понимание структуры страниц, отлично подходит для построения knowledge graph.
Минусы: Дорогой для маленьких или нерегулярных проектов. Workflow на DQL и KG требует времени на освоение. Для простого парсинга в таблицу — избыточен.
Лучше всего для: компаний, строящих структурированные датасеты, проектов knowledge graph и entity resolution, NLP-heavy ingestion-пайплайнов.
10. Firecrawl
 Firecrawl — самый developer-native инструмент ingestion для LLM в этой группе. Он превращает URL в чистый Markdown, HTML, скриншоты или структурированный JSON и построен вокруг простого API, а не визуального приложения.
Цена прозрачна: бесплатно с 1,000 кредитов в месяц, Hobby с 5,000 кредитов, Standard с 100,000, Growth с 500,000, Scale с 1,000,000 и Enterprise выше этого уровня. Стартовый план стоит $19/мес или $16/мес при годовой оплате.
Ключевые возможности:
- Чистый Markdown-вывод для RAG и LLM-пайплайнов
- Поддержка структурированного JSON по схеме или prompt
- Хорошая документация для разработчиков и активное open-source принятие
- Сильные уровни параллельности браузера на более высоких планах
Плюсы: Создан специально для подачи данных в LLM. Доступная стартовая цена. Чистый вывод.
Минусы: Создан для разработчиков. Есть playground и набор бесплатных инструментов для одной страницы, но ни один из них не запускает повторяемую задачу — все, что нужно планировать, пакетно обрабатывать или встраивать в пайплайн, делается через API или SDK. Кредиты на всех планах ниже $749 Scale сгорают в конце месяца. И в линейке планов есть разрыв посередине: ползунок кредитов идет через 5,000, 6,500, 8,000 страниц в месяц, а затем сразу прыгает к 100,000 — это план $99 Standard.
Лучше всего для: RAG-пайплайнов, AI-агентов, ingestion и анализа контента.
11. Browse AI
 Browse AI лучше всего понимать как продукт для мониторинга, который также умеет скрейпить, а не просто как скрейпер, который умеет мониторить. Его сильнейший сценарий — повторяющееся отслеживание изменений: цены, запасы, текст, скриншоты и изменения страницы со временем.
Цена начинается с бесплатного плана на 50 кредитов в месяц, затем Personal за $48/мес с 2,000 кредитов и Professional на ползунке — $87 за 5,000 кредитов, $162 за 10,000 и до $399 за 30,000 — а Premium начинается от $500/мес при годовой оплате. При годовой оплате Personal стоит $19/мес, а Professional — $69. Кредиты расходуются в зависимости от количества строк и сложности задачи: страница, которую вы открываете ради ее собственных данных, — это одна задача с минимумом в один кредит; десять строк тоже стоят один кредит, а премиальные сайты стоят в 2–10 раз дороже.
Ключевые возможности:
- Сильный фокус на мониторинге и оповещениях
- Хорошо подходит для повторяющейся проверки цен или наличия товара
- Интеграции с Sheets, Airtable, webhooks и API workflows
- Быстрая начальная настройка для нетехнических пользователей
Плюсы: Отлично подходит для задач «что изменилось», простая настройка для non-dev пользователей.
Минусы: Менее гибок, чем универсальные скрейперы, на незнакомых или сложных сайтах. Встроенного AI-преобразования заметно меньше, чем у Thunderbit.
Лучше всего для: e-commerce-команд, отслеживающих цены конкурентов, нетехнических пользователей, которым нужны уведомления об изменениях.
12. ScrapeHero
 ScrapeHero — исключение из правила, потому что это не в первую очередь программный инструмент. Это managed scraping service. Вы говорите, какие данные вам нужны, а их команда строит решение, поддерживает его, проводит QA и поставляет готовый датасет.
Цена отражает именно сервисную модель: проекты по запросу начинаются с $550 за сайт, месячный Business — от $199 за до двух сайтов по 1–5K страниц на каждом, Enterprise Basic — от $1,500/мес за до четырех сайтов с общим пулом страниц и доплатой $650–$2,200 за каждый следующий миллион, а Enterprise Premium — от $8,000. В Business и Enterprise Basic есть отдельная одноразовая плата за настройку. Процесс доставки включает выделенные команды проекта, human QA и кастомные форматы.
Ключевые возможности:
- Почти нулевая поддержка со стороны клиента
- Human QA и кастомные форматы доставки
- Хорошо подходит для сложных многосайтовых проектов
- Позиция по комплаенсу под enterprise-требования
Плюсы: Нулевая поддержка, сложные проекты, сервис уровня white-glove.
Минусы: Дороже, чем self-serve инструменты. Дольше старт, чем если делать самому. Это вообще не self-serve.
Лучше всего для: компаний, которые передают скрейпинг наружу, команд, которым важнее доставка, чем владение инструментом, сложных многосайтовых проектов с частыми изменениями.
Реальная стоимость сервисов веб-скрейпинга на 10K, 100K и 1M страниц
Сравнивать эти сервисы по цене неудобно, потому что вендоры считают по-разному — страницы, записи, кредиты, compute time, строки или минимальный проект. Поэтому таблица ниже показывает единственный показатель, который действительно можно перевести в деньги: сколько фактически спишут с карты в конкретном месяце. Все цифры — это месячная list price на самом дешевом плане, который покрывает нужный объем в обычных страницах — без JavaScript-rendering и premium proxies — уже с учетом собственного ежемесячного free-лимита вендора. Расходы на прокси, CAPTCHA-надстройки и время инженеров в число не включены; они описаны в последнем столбце. Если ни один опубликованный тариф не дотягивает до нужного объема, в ячейке стоит Custom quote, а не натяжка верхнего плана. А если вендор не продает «за страницу», то в ячейке указано, что именно он продает.
| Сервис | Бесплатный тариф | Месячный счет на 10K страниц | Месячный счет на 100K страниц | Месячный счет на 1M страниц | Как считается и чего не хватает в цифре |
|---|---|---|---|---|---|
| Thunderbit API | 600 units, один раз | $72 Pro 1 | $120 Pro 2 | Custom quote | Distill считает 1 unit за страницу, Extract — 20. Бесплатные units выдаются один раз, а не ежемесячно, поэтому вычитать нечего. Self-serve заканчивается на 480,000 units в месяц. |
| Bright Data | 5,000 записей/мес | $7.50 за 10K записей | $142.50 за 100K записей | $1,293 за 1M записей | Считает за запись — один извлеченный элемент, одна строка в таблице — а не за загруженную страницу, поэтому одна списковая страница может стоить много записей. 5,000 бесплатных записей вычитаются во всех трех случаях. На 1M Scale выгоднее pay-as-you-go: $499 плюс 611,000 дополнительных записей по $1.30/1K. |
| Oxylabs | Trial, 2K результатов | $49 Micro | $249 Advanced | $999 Business | Считает за успешный результат по ставке, зависящей от сайта и уровня плана. Громкие числа по результатам предполагают Amazon без JS-rendering — на обычном сайте при $1.15 за 1,000 у плана Micro выходит около 42,600 результатов, а не 98,000. Trial-результаты не обновляются, так что вычитать нечего. |
| Apify | $5 использования/мес | От $29/мес + расход | От $29/мес + расход | От $29/мес + расход | Не считается по страницам. Плата за план — это предоплаченный расход: $29 Starter, $199 Scale, $999 Business — он тратится на compute units и на Store Actors, у которых своя цена за результат, так что одной цифры по страницам недостаточно. Прокси — отдельная доплата. |
| ScrapingBee | 1,000 кредитов, один раз | $49 Freelance | $49 Freelance | $99 Startup | 1 кредит за обычный запрос. JS-rendering, premium proxies, скриншоты и AI-извлечение стоят несколько кредитов каждый, так что на реальной цели страниц получается намного меньше, чем по заголовку. Кредиты при регистрации не обновляются, вычитать нечего. |
| ScraperAPI | 7-дневный trial, 5,000 кредитов | $49 Hobby | $49 Hobby | $149 Startup | 1 кредит за обычный запрос, но 5 на Amazon и 25 на Google. На 100K страниц план Hobby оказывается полностью исчерпан, без запаса на повтор. Trial-кредиты не обновляются, вычитать нечего. |
| ZenRows | 5,000 кредитов/мес | $19 Build | $39 Build | $199 Growth | 1 кредит за обычную страницу, 25 — если нужны JS + premium proxy. Бесплатные 5,000 кредитов вычитаются первыми — остается 5,000, 95,000 и 995,000 оплачиваемых страниц — что не меняет выбранный уровень. |
| Octoparse | Бесплатный план, 10 задач | От $39/мес | От $39/мес | От $39/мес | Цена зависит от количества задач и cloud concurrency, а не от страниц, поэтому ни один объем страниц не переводится напрямую в тариф: Basic $39, Standard $83, Professional $299 при помесячной оплате. Residential proxies и CAPTCHA-solving продаются как доп.услуги: $3/GB и $1–1.5 за тысячу решенных CAPTCHA. |
| Diffbot | 10,000 кредитов/мес | $0, free tier покрывает | $299 Startup | $899 Plus | 1 кредит за извлеченную страницу. Бесплатные 10,000 кредитов в месяц вычитаются ровно так же, как и везде: на 10K этого хватает на весь месяц, на 100K остается 90,000 страниц к оплате, на 1M — 990,000. |
| Firecrawl | 1,000 кредитов/мес | $99 Standard | $99 Standard | $749 Scale | 1 кредит за страницу. После вычета бесплатных кредитов на уровне 10K остается 9,000 страниц к оплате, что все еще выше Hobby с 5,000, поэтому тариф не меняется. Кредиты ниже Scale не переносятся. |
| Browse AI | 50 кредитов/мес | $162 Professional | Custom quote | Custom quote | Биллинг в кредитах: детальная страница — одна задача с минимумом в один кредит, и десять строк тоже стоят один кредит, так что пятидесятистрочная списковая страница стоит пять. Премиальные сайты стоят в 2–10 раз дороже. Self-serve заканчивается на 30,000 кредитов в месяц, все что выше — по запросу. |
| ScrapeHero | Нет | От $199/мес | От $1,500/мес | От $1,500/мес | Ценится по сайту, сложности и частоте обновления, а не по страницам: Business покрывает до 2 сайтов по 1–5K страниц на каждом, Enterprise Basic объединяет страницы до 4 сайтов и добавляет $650–$2,200 за каждый дополнительный миллион. Setup fee взимается один раз отдельно. |
Несколько важных замечаний:
- Браузерный продукт Thunderbit считает строки и ориентирован на пользователя, поэтому в таблице выше используется API — и именно endpoint Distill, где 1 unit за страницу Markdown, потому что так устроены остальные API-строки. Структурированный Extract стоит 20 units за страницу, так что 10K страниц обошлись бы в $240, а не в $72.
- Стоимость Apify сильно зависит от времени работы actor’ов, памяти и дополнительных сервисов, например прокси.
- ZenRows, ScrapingBee и ScraperAPI на базовых публичных страницах выглядят дешево, но быстро дорожают, как только появляются JS-rendering, premium proxies или защищенные антиботом цели.
- У ScrapeHero другая экономика, потому что вы платите за инженерную работу, QA и project management, а не только за вычисления.
Скрытая стоимость, которую почти каждая страница с ценами занижает, — это поддержка. Похоже, что proxy-only решения дешевле на бумаге, но если добавить повторы, поддержку парсеров, заблокированные сессии и время инженеров, bundled scraping-сервисы часто выигрывают по total cost of ownership.
Если вы скрейпите лишь иногда, дешевле всего стартовать в no-code-сегменте: бесплатный тариф Thunderbit включает 6 страниц в месяц, а платные browser-планы начинаются с $15/мес, или примерно $9/мес при годовой оплате. API-сервисы не всегда дороже на входе — ZenRows и Firecrawl оба стартуют с $19/мес, — но самый маленький блок, который они продают, это тысячи страниц в месяц, так что вы платите за мощность, которой не воспользуетесь. Для enterprise-пайплайнов на 1M+ страниц полнофункциональные платформы или managed services экономически логичнее, несмотря на более высокий ценник, потому что в них уже включены расходы на прокси.
Куда попадают собранные данные? Сравнение экспортов и интеграций
JSON — это не то же самое, что Google Sheets. Для нетехнических пользователей место назначения данных так же важно, как и само извлечение.
| Сервис | CSV | JSON | Excel | Google Sheets | Airtable | Notion | CRM / API / webhook |
|---|---|---|---|---|---|---|---|
| Thunderbit | ✅ | ✅ | ✅ | ✅ Нативно | ✅ Нативно | ✅ Нативно | Доступен API |
| Bright Data | ✅ | ✅ | ❌ Нет нативного | Косвенно | Косвенно | Косвенно | Сильный API / webhook |
| Oxylabs | ✅ | ✅ | ❌ Нет нативного | Косвенно | Косвенно | Косвенно | Сильный API |
| Apify | ✅ | ✅ | ✅ | Через интеграции | Через интеграции | Через интеграции | Сильный API |
| ScrapingBee | Через сторонние инструменты | ✅ | ❌ | ❌ | ❌ | ❌ | Сильный API |
| ScraperAPI | ✅ на структурированных эндпоинтах | ✅ | ❌ | ❌ | ❌ | ❌ | Сильный API / webhook |
| ZenRows | Ограниченно | ✅ | ❌ | ❌ | ❌ | ❌ | Сильный API |
| Octoparse | ✅ | ✅ | ✅ | ✅ Нативно | ⚠️ Через Zapier | ❌ | API, DB, Zapier |
| Diffbot | ✅ | ✅ | ❌ | Поддерживается в workflows | Косвенно | Косвенно | API |
| Firecrawl | ❌ | ✅ | ❌ | ❌ | ❌ | ❌ | API |
| Browse AI | ✅ | ✅ | ❌ | ✅ Нативно | ✅ Нативно | ❌ | API, webhook, Zapier/Make |
| ScrapeHero | ✅ | ✅ | ✅ | Кастомная доставка | Кастомная доставка | Кастомная доставка | Кастомная доставка через API / DB |
Это одно из самых больших преимуществ Thunderbit. Если вы работаете в Google Sheets или Notion, API-only сервисы добавляют лишние шаги: нужно написать код для преобразования JSON, затем загрузить все вручную, потом повторять. Бесплатный экспорт Thunderbit в Sheets, Airtable и Notion — включая загрузку изображений в Notion и Airtable — полностью убирает это трение. В сочетании с плановым скрейпингом данные могут автоматически попадать в нужное место по расписанию без какого-либо glue-кода.
Что происходит, когда сайт меняется? Поддержка и надежность
Скрейперы ломаются. Это боль №1 на всем рынке.
Рынок делится на три профиля поддержки:
- Инструменты на селекторах (Octoparse, многие actors в Apify, шаблоны Browse AI): ломаются при изменении макета сайта, требуют ручного обновления правил.
- API-сервисы с абстракцией парсеров (ScraperAPI structured endpoints, Bright Data structured datasets): хорошо работают на популярных сайтах, но слабее на длинном хвосте или нишевых страницах, где парсер заранее не готов.
- AI-инструменты (Thunderbit, Firecrawl, Diffbot): читают страницу заново при каждом запуске, поэтому большинство изменений верстки не требует правки правил. Сценарий сбоя меняется с «сломался селектор» на «AI неверно интерпретировал страницу» — а это обычно проще исправить через корректировку prompt, чем переписывать селекторы.
Есть и второй узкий момент надежности помимо дрейфа верстки: антибот-защита.
- Bright Data, Oxylabs и ZenRows здесь сильнее всех.
- ScraperAPI и ScrapingBee отлично подходят для массово защищенных популярных сайтов.
- Browse AI и Octoparse чаще испытывают проблемы на сильно защищенных динамических страницах.
- Browser mode у Thunderbit помогает на страницах с авторизацией и персонализированным контентом, где API-only инструменты часто добавляют лишнюю сложность.
Итог простой: если вам нужен минимальный объем поддержки, AI-извлечение (Thunderbit, Firecrawl, Diffbot) лучше переносит изменения макета, чем инструменты на селекторах. Если главная надежность для вас — антибот-защита, самые сильные варианты это Bright Data, Oxylabs и ZenRows. У большинства команд есть обе проблемы, поэтому решение «какой тип подходит вашей команде» в начале статьи важнее, чем сравнение отдельных характеристик.
Юридические и этические аспекты веб-скрейпинга
Сбор общедоступных данных часто законен, но это не значит, что любой сценарий безопасен. Команды по-прежнему должны уважать robots.txt, где это уместно, проверять условия использования и соблюдать законы о приватности, такие как GDPR и CCPA, если речь идет о персональных данных. Линия дел hiQ против LinkedIn поддерживает идею, что скрейпинг публичных данных в США не является автоматически нарушением CFAA, но вопросы договора, авторского права и приватности остаются отдельными рисками. Enterprise-провайдеры вроде Bright Data, Oxylabs и ScrapeHero прямо продвигают функции комплаенса и governance. Всем остальным: перед массовым скрейпингом обязательно получите юридическую консультацию под ваш конкретный сценарий. Для дополнительного контекста см. наше руководство о юридических последствиях веб-скрейпинга.
Какой сервис веб-скрейпинга выбрать на самом деле?
Хватит сравнительных таблиц. Вот короткая версия после тестирования всех 12:
Нетехнические бизнес-команды (sales, ops, marketing): Thunderbit. AI-скрейпинг в один клик, бесплатный экспорт в Sheets/Airtable/Notion и намного меньше доработок, когда сайт меняет верстку. Он одновременно убирает две главные проблемы — сложность настройки и трение на этапе экспорта.
Разработчики, строящие scraping-пайплайны:
- ScrapingBee, если нужен самый чистый API UX
- ScraperAPI, если нужны структурированные эндпоинты и регулярный мониторинг e-commerce
- ZenRows, если ваша главная проблема — антибот-защита
Команды, подающие данные в AI/LLM workflows:
- Firecrawl, если нужен Markdown или schema-based JSON
- Thunderbit API, если той же команде нужен еще и no-code путь, потому что расширение и API используют одну и ту же модель извлечения
- Diffbot, если вы строите enterprise data layer
Enterprise, которому нужен масштаб + прокси-инфраструктура:
- Bright Data для самого широкого enterprise-стека
- Oxylabs, если важнее всего надежность на защищенных целях
Команды, которым нужен маркетплейс готовых скрейперов: Apify.
Компании, которым нужна доставка под ключ: ScrapeHero.
Бюджетные команды, которым нужен no-code мониторинг: Browse AI.
No-code пользователи, которым нужен визуальный desktop-builder с более ручным контролем: Octoparse.
Для самого широкого круга бизнес-пользователей Thunderbit по-прежнему выигрывает, потому что убирает два барьера, которые чаще всего убивают внедрение: техническую настройку и трение при экспорте. Попробуйте бесплатный тариф или установите Chrome extension, чтобы увидеть все самим. А если Thunderbit вам не подходит, попробуйте несколько других вариантов из этого списка — еще никогда не было лучшего времени, чтобы перестать копировать и вставлять данные вручную. Для видеоразбора того, как эти инструменты работают на практике, загляните на YouTube-канал Thunderbit.
Попробовать расширение Thunderbit для Chrome
Часто задаваемые вопросы
Что такое сервис веб-скрейпинга?
Сервис веб-скрейпинга — это инструмент или managed-провайдер, который собирает данные с сайтов за вас. Одни — это no-code приложения, которые вы запускаете в браузере, другие — API для разработчиков, а третьи — полностью управляемые агентства, которые поставляют уже очищенные данные без необходимости поднимать инфраструктуру.
Нужны ли навыки программирования, чтобы пользоваться сервисами веб-скрейпинга?
Не всегда. Инструменты вроде Thunderbit, Browse AI и Octoparse созданы для нетехнических пользователей. API-сервисы вроде ScrapingBee, ScraperAPI, Firecrawl и ZenRows предполагают участие разработчика. ScrapeHero находится на другом конце спектра — их команда выполняет весь проект за вас.
Какой сервис веб-скрейпинга лучше всего подходит для малого бизнеса?
Для большинства малых компаний самый безопасный выбор — Thunderbit. У него бесплатный тариф без срока действия (6 страниц в месяц), низкий порог входа и прямой экспорт в удобные для бизнеса места вроде Google Sheets, Airtable и Notion. Browse AI тоже хорошо подходит, если главный сценарий — мониторинг изменений во времени.
Сколько стоят сервисы веб-скрейпинга?
Диапазон очень широкий. У некоторых есть бесплатные тарифы или trial-периоды. Developer APIs в этом списке стартуют примерно с $19–$49 в месяц, а enterprise AI-платформы начинаются заметно выше — Diffbot от $299. No-code инструменты обычно стоят от примерно $15 до $48 в месяц. Enterprise и managed services легко уходят в сотни или тысячи долларов в месяц. Большая часть стоимости — это не только подписка, но и мультипликаторы за JS-rendering, premium proxies и внутреннее время, которое нужно, чтобы скрейперы продолжали работать.
Законно ли пользоваться сервисами веб-скрейпинга?
Обычно да, если речь о публичных данных, но законность зависит от сайта, типа данных, вашей юрисдикции и того, что вы делаете с результатом. Вопросы приватности, авторского права и договора остаются важными даже при парсинге публичных страниц. Обратитесь за юридической консультацией под ваш конкретный кейс.
Попробовать Thunderbit для AI-веб-скрейпинга Get Started Free
Узнать больше



