
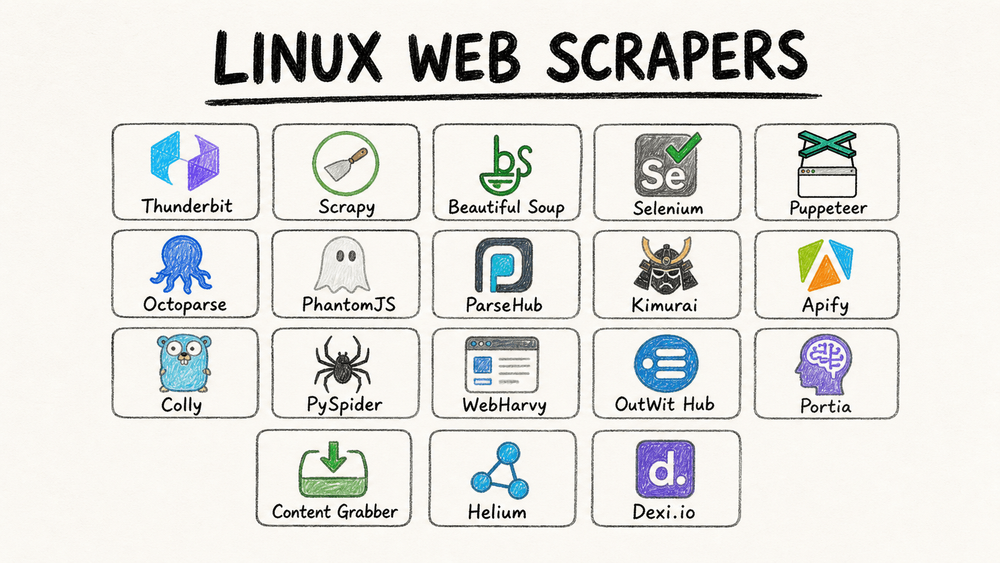
Веб буквально завален данными, и давай честно: у тебя вряд ли есть время вручную копировать тысячи карточек товаров или страниц с ценами конкурентов. Если ты работаешь на Linux (как я — для большей части автоматизации и разработки), ты и так знаешь, что эта платформа — настоящая рабочая лошадка для команд, которым нужны данные. Более того, системы семейства Unix работают на 91,9% сайтов, для которых известна операционная система, а Linux среди них — самый распространённый вариант с большим отрывом. Но есть нюанс: найти подходящий веб-скрапер для Linux, который реально впишется в твой процесс — будь ты нетехническим бизнес-пользователем или опытным разработчиком — иногда сложнее, чем найти иголку в стоге сена.
Именно поэтому я собрал подробный обзор 18 лучших инструментов для веб-скрапинга в Linux в 2026 году. От AI-решений без кода, вроде Thunderbit (да, того самого, который мы с командой и создали), до классических фреймворков для разработчиков, таких как Scrapy и Beautiful Soup, — этот список поможет тебе быстро выбрать лучший веб-скрапер для Linux под свои задачи, без долгих проб и ошибок.
Почему инструменты для веб-скрапинга в Linux важны для бизнеса
Сэкономь часы ручного копипаста, прежде чем выбирать инструмент Thunderbit работает в Chrome на твоём Linux-компьютере — без пакетов, без драйверов, просто структурированная таблица в 1 клик. Get Started Free
Будем честны: ручной сбор данных убивает продуктивность. Исследования показывают, что команды, которые полагаются на копирование и вставку, теряют часы каждую неделю и получают уровень ошибок почти 5% — а это прямой путь к дорогим промахам и упущенным возможностям (Thunderbit Blog). Linux, благодаря своей стабильности, безопасности и гибкости, — идеальная платформа для скраперов, которые должны работать 24/7, будь то рабочий стол, сервер или облако.
Типичные сценарии использования инструментов для веб-скрапинга в Linux в бизнесе:
- Генерация лидов: отделы продаж собирают контакты из каталогов, соцсетей или сайтов с отзывами, минуя рутину ручного поиска (Thunderbit Blog).
- Мониторинг цен: e-commerce-команды автоматически собирают цены конкурентов и данные о наличии товаров, чтобы держать собственные цены актуальными.
- Анализ конкурентов: маркетинг и операционные команды отслеживают запуски продуктов, отзывы и SEO-ключи — больше никакой работы вслепую.
- Маркетинговая аналитика: аналитики агрегируют новости, форумы и соцданные, чтобы замечать тренды в реальном времени.
- Автоматизация рабочих процессов: некоторые инструменты (особенно AI-решения) могут даже автоматизировать веб-операции — например, заполнять формы или проходить по дашбордам — прямо с твоего Linux-устройства.
Главное преимущество в том, что правильный инструмент для веб-скрапинга в Linux может помочь не только разработчикам, но и нетехническим сотрудникам получать и использовать веб-данные для более быстрых и точных бизнес-решений.
Как мы выбирали лучший веб-скрапер для Linux
Не все скраперы одинаково полезны, особенно в Linux. Вот на что я смотрел:
- Совместимость с Linux: каждый инструмент здесь работает нативно, через браузер или с простым обходным вариантом, например через Wine или облачный доступ.
- Простота использования: от AI-подсказок на естественном языке до визуальных интерфейсов с кликами мышью — я отдавал приоритет инструментам, которые позволяют нетехническим пользователям быстро получать результат, но не забывал и о продвинутых пользователях, которым нужен полный контроль.
- Мощность извлечения данных: умеет ли инструмент работать с динамическим контентом, пагинацией, подстраницами и разными типами данных? Способен ли он справляться с антискрапинг-защитой?
- Масштабируемость и автоматизация: планирование запусков, облачный скрапинг, распределённый обход — всё это важно для серьёзных проектов с данными.
- Интеграции и экспорт: CSV, Excel, Google Sheets, API — если ты не можешь нормально выгрузить данные, какой смысл?
- Цена и лицензирование: бесплатные, open-source или платные решения — найдётся вариант на любой бюджет, от соло-фаундеров до корпоративных команд.
- Сообщество и поддержка: активная база пользователей, хорошая документация и отзывчивая поддержка сильно помогают, когда что-то идёт не так.
Я также учитывал реальные отзывы пользователей, отраслевые обзоры и собственный практический опыт работы с этими инструментами. Давай перейдём к списку.
1. Thunderbit
 Thunderbit — мой лучший выбор для бизнес-пользователей, которым нужен веб-скрапер для Linux, и при этом простой в использовании. Как AI-расширение для Chrome, он отлично работает в Linux — просто открой Chrome или Chromium — и позволяет собирать данные с любого сайта буквально в один клик.
Чем Thunderbit выделяется:
- Подсказки на естественном языке: просто опиши, что тебе нужно («Извлеки все названия товаров и цены с этой страницы»), а дальше AI сам разберётся.
- AI Suggest Fields: один клик — и Thunderbit сканирует страницу, предлагает столбцы и типы данных, без ручного выбора полей.
- Скрапинг подстраниц и пагинации: нужны подробности? Thunderbit может перейти на каждую подстраницу (например, на страницы товаров) и автоматически обогатить таблицу.
- Облачный или локальный режим: собирай до 50 страниц одновременно в облаке или используй режим браузера для сайтов, где требуется вход в систему.
- Мгновенный экспорт: выгрузка в Excel, Google Sheets, Airtable, Notion, CSV или JSON в один клик — всегда бесплатно.
- Дополнительные инструменты: извлечение email-адресов, телефонов и изображений одним нажатием. AI autofill даже автоматизирует заполнение форм.
Цена: бесплатный тариф (6 страниц в месяц), платные планы — от $15/месяц за 500 строк (Thunderbit Pricing). Пользователи особенно любят отсутствие порога входа и то, что инструмент «превращает часы работы в минуты» (Product Hunt Reviews). Для больших задач может понадобиться разбивать работу на несколько запусков, но для большинства бизнес-сценариев это огромная экономия времени.
Совместимость с Linux: 100%. Просто запусти Chrome/Chromium на Linux-рабочем столе или сервере.
Лучше всего подходит для: нетехнических бизнес-пользователей — продаж, маркетинга и операционных команд, которым нужна максимально быстрая и простая настройка.
Попробуй Thunderbit бесплатно в Linux Работает в Chrome на любом Linux-компьютере — без сборки пакетов, без установки драйверов, извлечение в 1 клик. Get Started Free
2. Scrapy
 Scrapy — золотой стандарт для Python-разработчиков, которым нужен гибкий и масштабируемый веб-скрапер для Linux. Это open-source решение, которое работает очень быстро благодаря асинхронному обходу и подходит как для простых задач, так и для крупных распределённых сборов данных.
Ключевые возможности:
- Асинхронный высокоскоростной обход — идеально для тысяч страниц.
- Сильная расширяемость: плагины для прокси, CAPTCHA и многого другого.
- Интеграция со стеком Python: экспорт в JSON, CSV, базы данных или pandas.
- Работа с cookie, сессиями и автоограничением скорости.
Цена: 100% бесплатно и open-source.
Совместимость с Linux: нативная (установка через pip). Отлично работает на серверах и в контейнерах.
Лучше всего подходит для: разработчиков, создающих собственные крупные скраперы.
Важный момент: для нетехнических пользователей есть порог входа, но если ты знаешь Python, Scrapy сложно превзойти.
3. Beautiful Soup
 Beautiful Soup — лёгкая библиотека Python для разбора HTML и XML. Это отличный выбор для быстрого и простого скрапинга или очистки плохо структурированных веб-страниц.
Ключевые возможности:
- Простой и понятный API — отлично для начинающих.
- Хорошо сочетается с requests для получения страниц.
- Корректно обрабатывает битый HTML.
Цена: бесплатно и open-source.
Совместимость с Linux: 100% (чистый Python).
Лучше всего подходит для: разработчиков и data scientist’ов, выполняющих небольшие и средние задачи по скрапингу или парсингу.
Ограничения: не работает с JavaScript и динамическим контентом — если это нужно, комбинируй с Selenium или Puppeteer.
4. Selenium
 Selenium — классический фреймворк для автоматизации браузера. Он позволяет управлять Chrome, Firefox и другими браузерами для скрапинга динамических сайтов с большим количеством JavaScript.
Ключевые возможности:
- Автоматизирует реальные браузеры — умеет входить в аккаунты, кликать, скроллить и взаимодействовать почти как человек.
- Поддерживает Python, Java, C# и другие языки.
- Headless-режим для запуска на Linux-серверах.
Цена: бесплатно и open-source.
Совместимость с Linux: полная поддержка (нужно только установить правильный драйвер браузера).
Лучше всего подходит для: QA-инженеров, разработчиков скрапинга и всех, кому нужно имитировать поведение пользователя.
Важный момент: ресурсозатратен и медленнее, чем HTTP-скраперы, но иногда это единственный способ получить нужные данные.
5. Puppeteer
 Puppeteer — это библиотека Node.js от Google для управления headless Chrome/Chromium. По сути, это как Selenium, но с современным JavaScript API и плотной интеграцией с возможностями Chrome.
Ключевые возможности:
- Выполняет JavaScript, работает с динамическим контентом и делает скриншоты.
- Быстрый, стабильный и удобный для разработчиков Node.js.
- Перехватывает сетевые запросы и блокирует ненужные ресурсы.
Цена: бесплатно и open-source.
Совместимость с Linux: Chromium устанавливается автоматически; по умолчанию работает в headless-режиме.
Лучше всего подходит для: разработчиков, которые собирают данные из современных веб-приложений или одностраничных сайтов.
6. Octoparse
 Octoparse — это no-code веб-скрапер с интерфейсом drag-and-drop и большим количеством готовых шаблонов. Хотя десктопное приложение доступно только для Windows и Mac, пользователи Linux могут работать с облачной платформой через браузер или запускать Windows-версию через Wine.
Ключевые возможности:
- Более 100 готовых шаблонов для Amazon, eBay, Zillow и других сайтов.
- Визуальный конструктор сценариев — собирай скрапер кликами мыши.
- Облачный скрапинг и планирование — пусть тяжёлую работу выполняют серверы Octoparse.
- Экспорт в Excel, CSV, JSON и базы данных.
Цена: бесплатный тариф (10 задач, около 50 тыс. строк в месяц). Платные планы начинаются от $69/месяц за Standard при годовой оплате; Professional стоит $249/месяц. (Octoparse Pricing)
Совместимость с Linux: облачный/веб-доступ; десктопное приложение через Wine.
Лучше всего подходит для: нетехнических пользователей, которым нужны данные с e-commerce или маркетплейсов быстро.
7. PhantomJS
 PhantomJS — это headless-браузер на WebKit, который когда-то был стандартом для лёгкой автоматизации браузера. Сейчас он устарел, но всё ещё может запускаться в Linux для старых или простых задач.
Ключевые возможности:
- Скриптуется на JavaScript.
- Обрабатывает умеренно сложный JavaScript и умеет делать скриншоты/PDF.
- Не требует графического интерфейса.
Цена: бесплатно и open-source.
Совместимость с Linux: нативный бинарник.
Лучше всего подходит для: устаревших проектов или сред, где нельзя установить Chrome.
Важно: официально признан устаревшим в 2017 году, разработка прекращена в марте 2018 года; финальный релиз — v2.1.1. Нет патчей безопасности, нет современного JS-движка, на большинстве актуальных сайтов он не работает. Для новых проектов лучше использовать Puppeteer или Playwright. В списке он остаётся потому, что до сих пор встречается в старых Linux-стэках скрапинга, которые тебе могут достаться в наследство.
8. ParseHub
 ParseHub — это визуальный кроссплатформенный веб-скрапер с нативным Linux-приложением. Он отлично подходит для нетехнических пользователей, которым нужно собирать данные со сложных динамических сайтов.
Ключевые возможности:
- Интерфейс point-and-click — выбирай элементы и строй сценарии визуально.
- Работает с динамическим контентом, картами, бесконечной прокруткой и многим другим.
- Облачное выполнение и планирование.
- Экспорт в CSV, JSON или через API.
Цена: бесплатный план (5 проектов), платные — от $189/месяц.
Совместимость с Linux: нативное приложение для Linux, Windows и Mac.
Лучше всего подходит для: аналитиков и пользователей с базовой технической подготовкой, которым нужен контроль без программирования.
9. Kimurai
 Kimurai — это Ruby-фреймворк для веб-скрапинга, который нативно поддерживает Linux. По сути, это аналог Scrapy, но для разработчиков на Ruby.
Ключевые возможности:
- Поддержка нескольких браузеров: headless Chrome, Firefox, PhantomJS или обычный HTTP.
- Асинхронная обработка для высокой параллельности.
- Удобный Ruby DSL для написания пауков.
Цена: бесплатно и open-source.
Совместимость с Linux: 100% (Ruby).
Лучше всего подходит для: Ruby-разработчиков или команд на Rails, которым нужен кастомный высокопараллельный скрапинг.
10. Apify
 Apify — это облачная платформа для веб-скрапинга с open-source SDK и маркетплейсом готовых «actors». Ты можешь запускать скраперы как на Linux-машине, так и в облаке.
Ключевые возможности:
- SDK для Node.js, Python и других языков.
- Маркетплейс готовых скраперов.
- Облачное выполнение, планирование и интеграция через API.
Цена: бесплатный тариф, оплата по мере использования облака.
Совместимость с Linux: CLI/SDK работает на Linux; облачная платформа доступна через браузер.
Лучше всего подходит для: разработчиков, которым нужен баланс между собственным кодом и готовой облачной инфраструктурой.
11. Colly
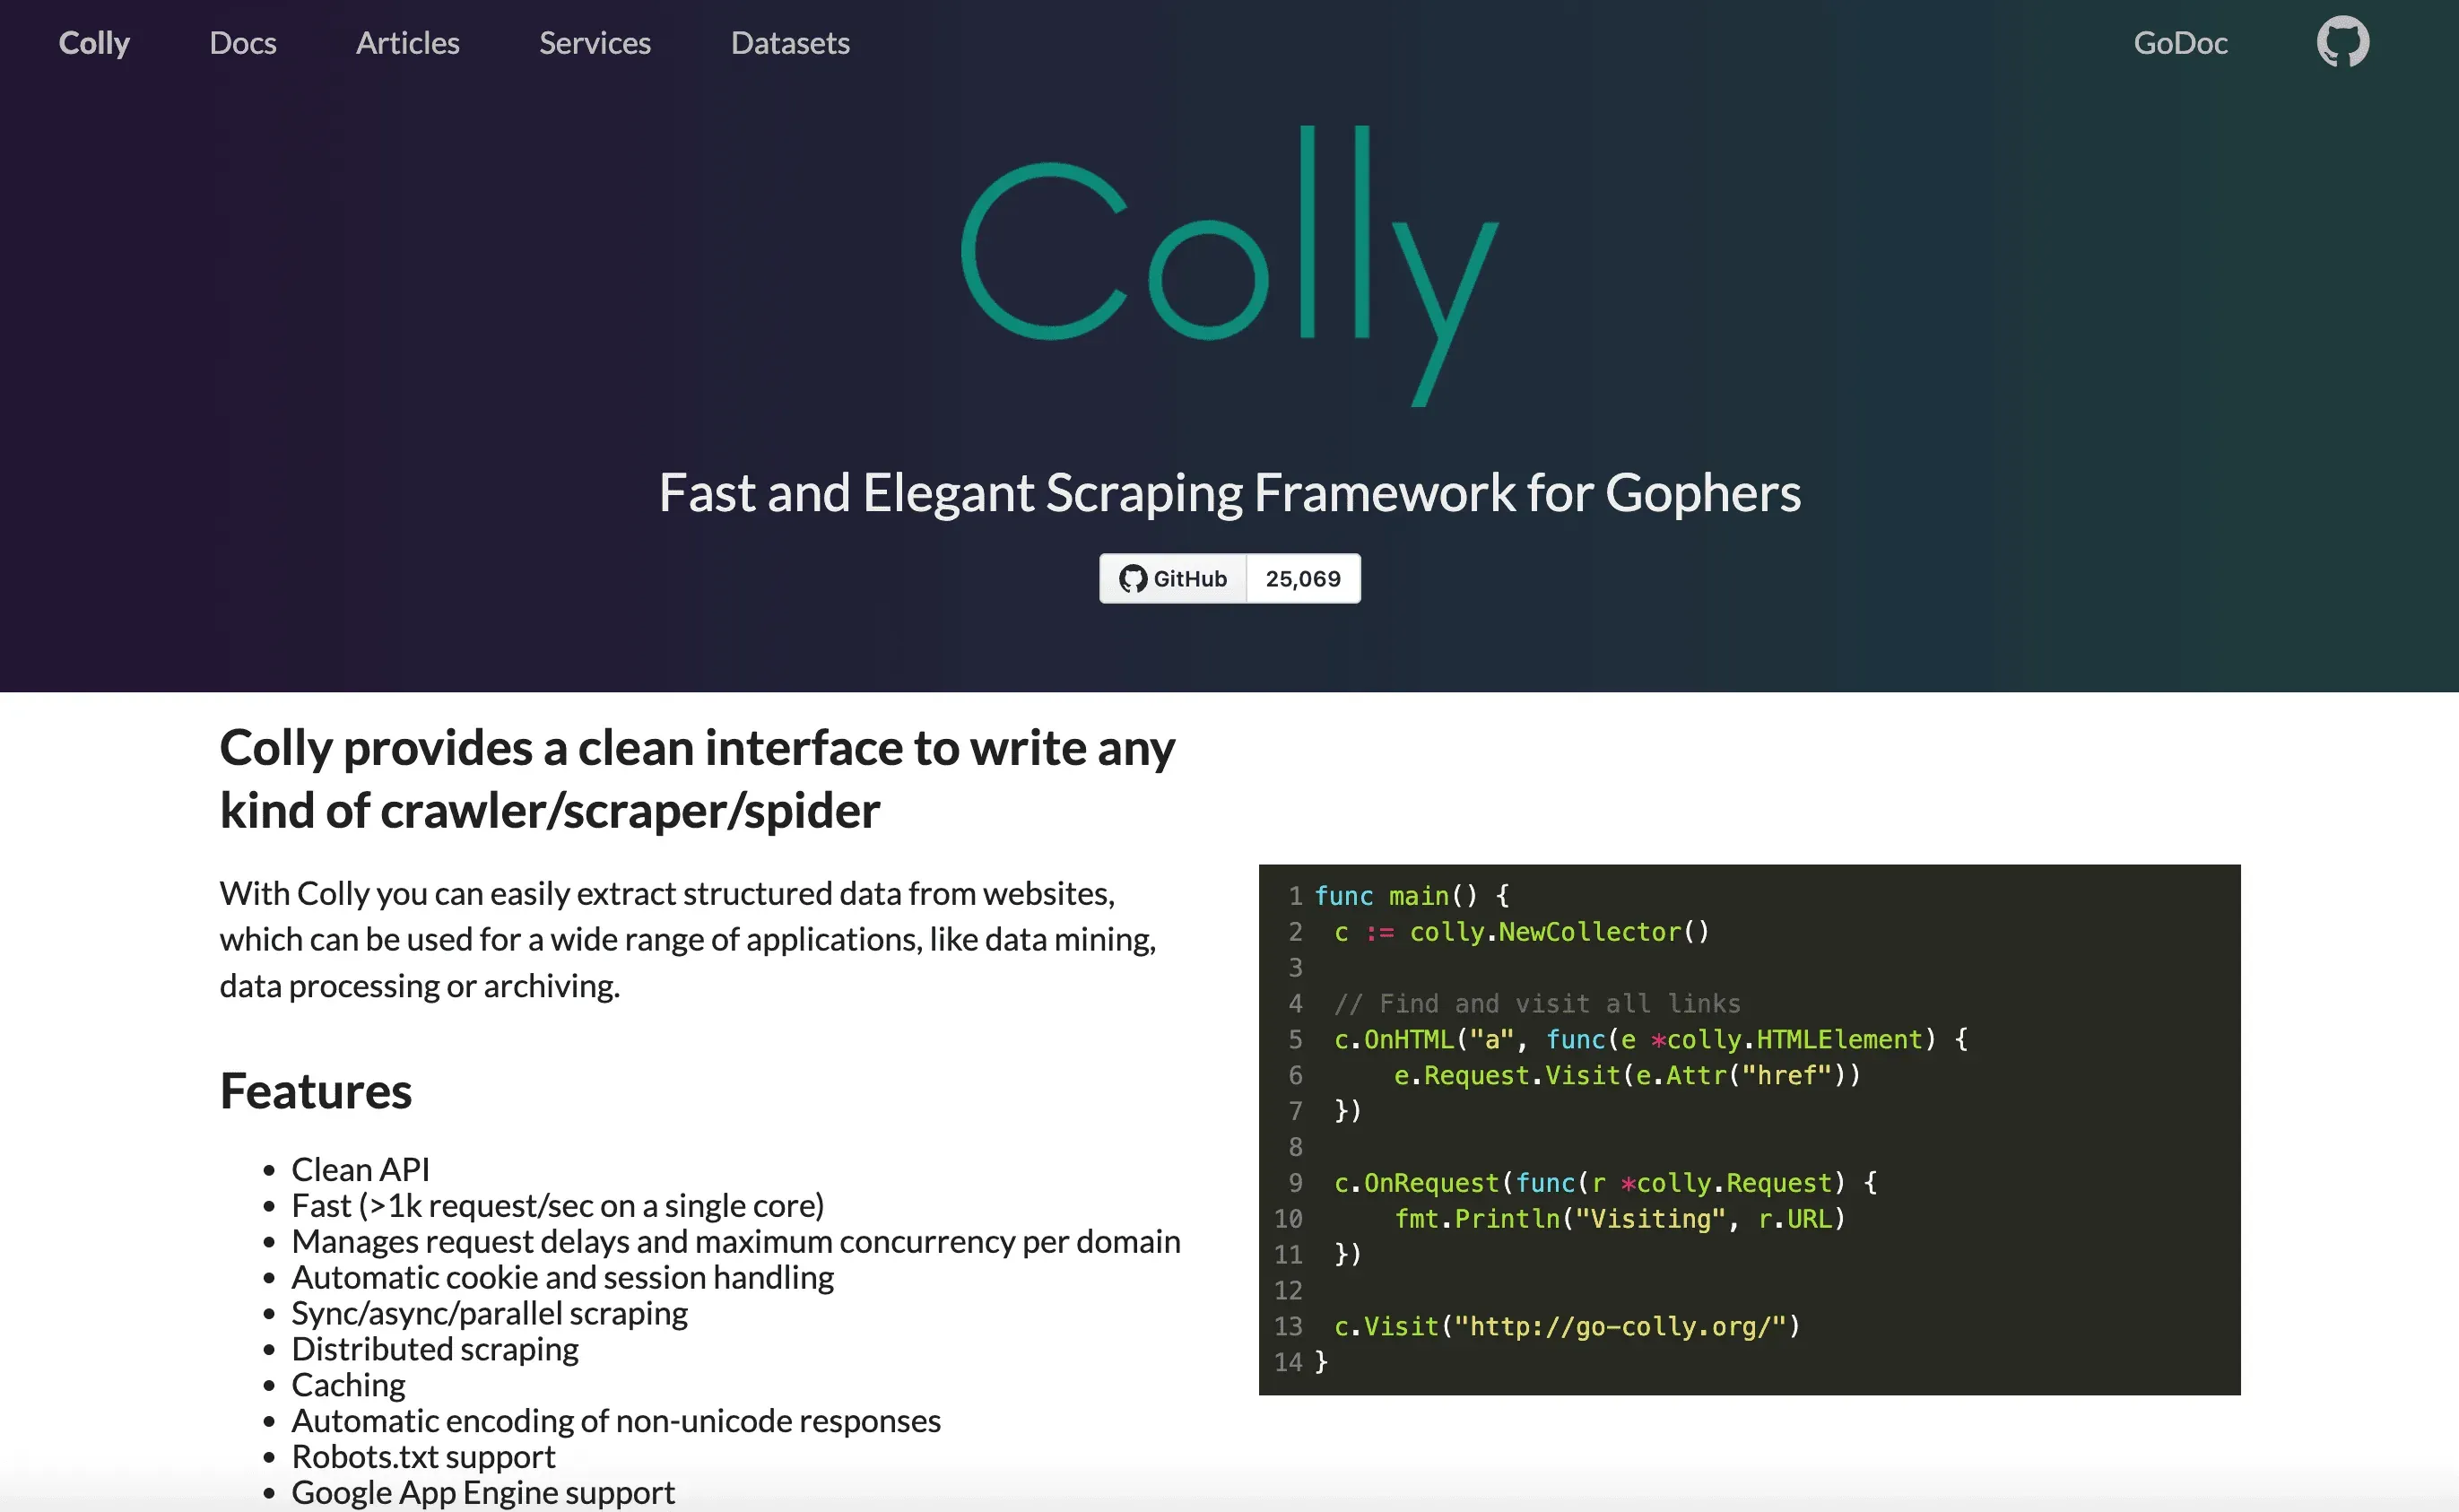 Colly — это Go-фреймворк для веб-скрапинга, созданный ради скорости и эффективности. Если ты Go-разработчик, это твой инструмент.
Ключевые возможности:
- Очень быстрый параллельный скрапинг — более 1000 запросов в секунду на одном ядре.
- Аккуратный обход (с учётом robots.txt), управление сессиями и cookie.
- Низкое потребление памяти.
Цена: бесплатно и open-source.
Совместимость с Linux: нативные бинарники Go.
Лучше всего подходит для: Go-разработчиков, которым нужен высокопроизводительный скрапинг.
12. PySpider
 PySpider — это Python-система для веб-краулинга с веб-интерфейсом: ты можешь управлять обходами, планировать их и отслеживать прямо из браузера. Сразу важное замечание: репозиторий на GitHub помечен как public archive, а оригинальный автор больше не выпускает новые версии, так что нужно воспринимать его как есть. Если тебе нужен только подход с веб-панелью в Linux, он всё ещё работает; но если ты рассчитываешь на долгосрочную зависимость, считай его наследием прошлого.
Ключевые возможности:
- Веб-интерфейс для написания и мониторинга скриптов.
- Распределённый краулинг, планирование и повторные попытки.
- Интеграция с базами данных и очередями сообщений.
Цена: бесплатно и open-source.
Совместимость с Linux: рассчитан на развёртывание в Linux.
Лучше всего подходит для: команд, которые готовы форкать проект и самостоятельно поддерживать веб-интерфейс для многопроектного скрапинга (не жди исправлений от upstream).
13. WebHarvy
 WebHarvy — это визуальный скрапер с point-and-click-интерфейсом для Windows, но пользователи Linux могут запускать его через Wine. Он известен определением шаблонов и моделью разовой покупки.
Ключевые возможности:
- Открывай сайт и кликай, чтобы выбрать данные — без кода.
- Автоматическое распознавание шаблонов в списках.
- Экспорт в CSV, JSON, XML, SQL.
Цена: около $129 за разовую лицензию.
Совместимость с Linux: работает через Wine или в виртуальной машине.
Лучше всего подходит для: новичков или независимых специалистов, которым нужен быстрый визуальный скрапер.
14. OutWit Hub
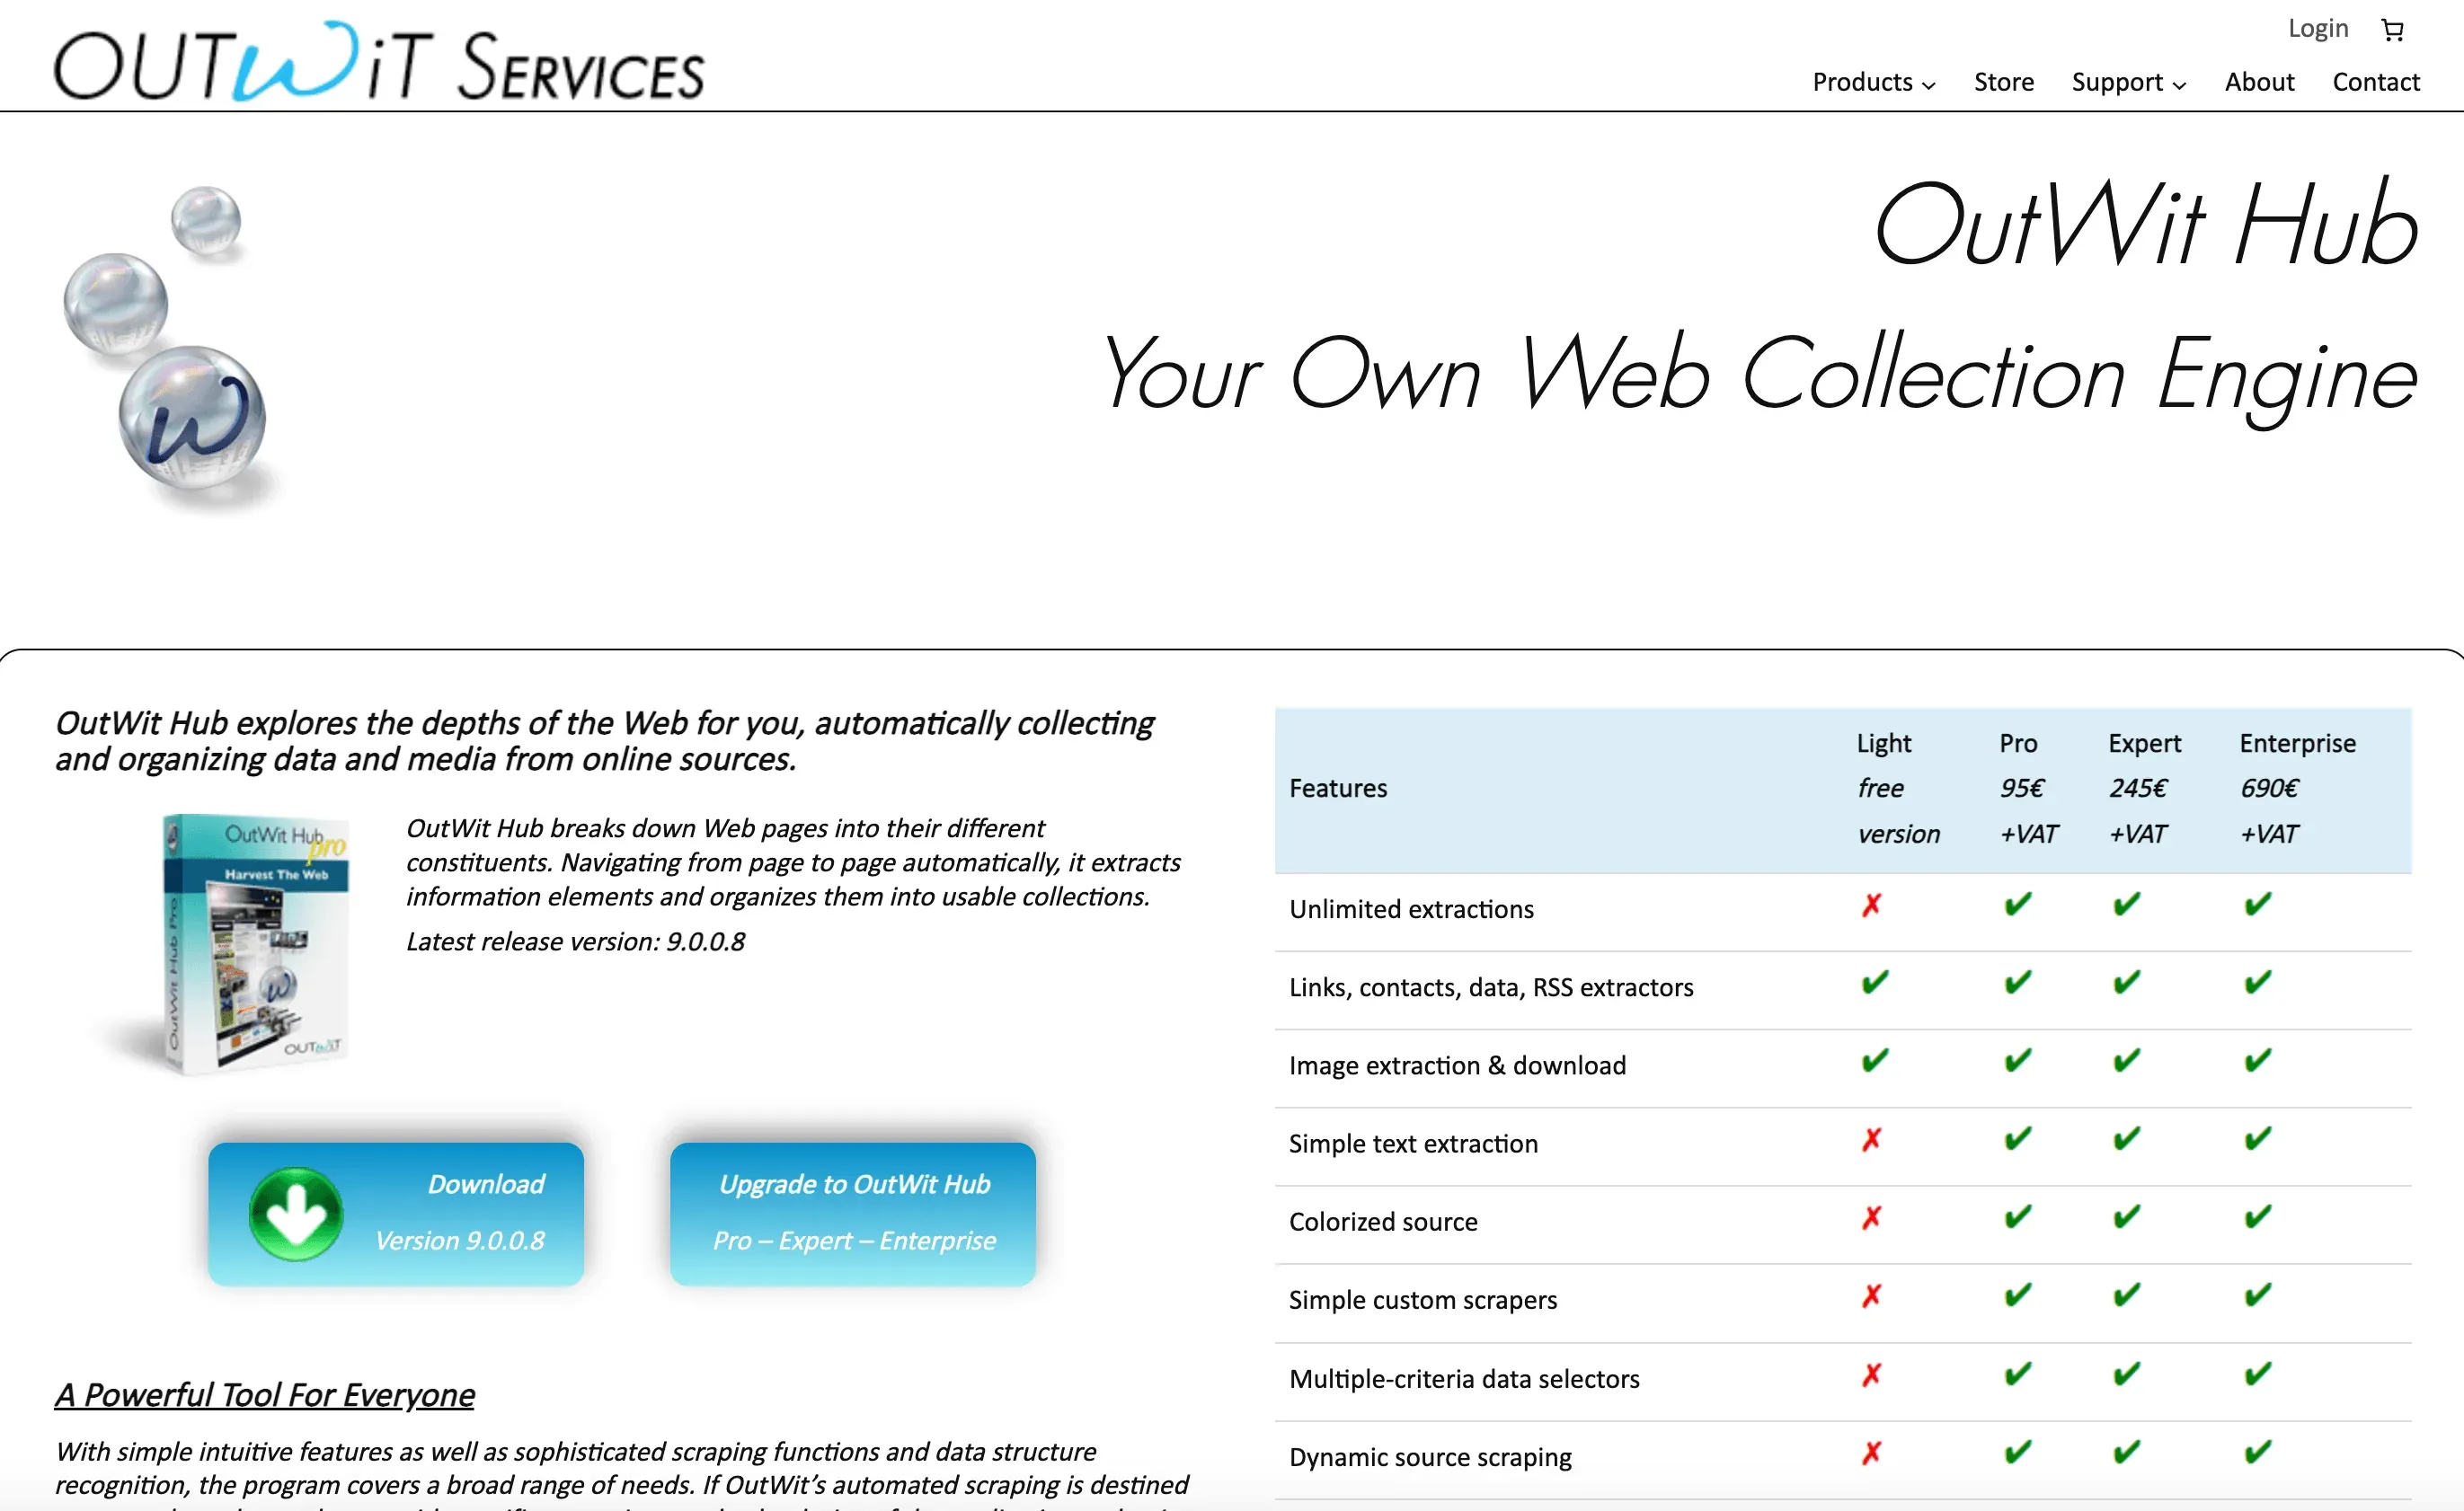 OutWit Hub — это нативное Linux GUI-приложение для веб-скрапинга. Оно автоматически распознаёт шаблоны данных и предлагает мощные возможности извлечения и автоматизации.
Ключевые возможности:
- Автоопределение ссылок, изображений, таблиц, email и многого другого.
- Редактор сценариев для кастомного извлечения.
- Автоматизация через макросы и планирование запусков.
Цена: есть бесплатная версия с ограничениями; платная Pro-лицензия — актуальную цену смотри в магазине вендора.
Совместимость с Linux: нативное приложение для Linux, Windows и Mac.
Лучше всего подходит для: нетехнических пользователей с некоторой технической жилкой, которым нужен десктопный GUI-скрапер.
15. Portia
 Portia — это open-source визуальный веб-скрапер от Scrapinghub. Он работает в браузере и позволяет размечать страницы, чтобы обучать скраперы, — но сразу предупрежу: репозиторий уже больше года почти не развивается, так что использовать его стоит с осторожностью. Если тебе нужна идея визуальной разметки, но при этом важна активная разработка, более чистый выбор — ParseHub или Thunderbit.
Ключевые возможности:
- Браузерный интерфейс для визуального извлечения.
- Интеграция со Scrapy для кастомных проектов.
- Open-source и расширяемость.
Цена: бесплатно и open-source.
Совместимость с Linux: браузерное решение; работает на любой ОС.
Лучше всего подходит для: пользователей, которым нужен open-source визуальный скрапинг с интеграцией Scrapy.
16. Sequentum Enterprise (ранее Content Grabber)
 Sequentum Enterprise — это корпоративный визуальный скрапер для Windows, который можно запускать в Linux через Wine или виртуализацию.
Ключевые возможности:
- Визуальный редактор плюс скриптинг на C# для сложной логики.
- Управление несколькими агентами и планирование.
- Интеграция с базами данных, API и многим другим.
Цена: корпоративное лицензирование, стоимость определяется индивидуально.
Совместимость с Linux: через Wine или VM.
Лучше всего подходит для: агентств и крупных команд, управляющих множеством проектов по скрапингу.
17. Helium
 Helium — это Python-библиотека, которая упрощает автоматизацию Selenium. Она создана, чтобы сделать браузерный скриптинг более человечным и понятным.
Ключевые возможности:
- Интуитивные команды вроде
click("Login")илиwrite("email"). - Автоматизация Chrome и Firefox.
- Отлично подходит для быстрых скриптов и задач автоматизации.
Цена: бесплатно и open-source.
Совместимость с Linux: работает в Linux (построено на Selenium).
Лучше всего подходит для: пользователей Python, которым Selenium кажется слишком громоздким.
18. Dexi.io
 Dexi.io — это облачная платформа для извлечения данных и автоматизации. Она доступна через браузер, поэтому пользователям Linux ничего устанавливать не нужно.
Ключевые возможности:
- Визуальный конструктор сценариев для скрапинга и автоматизации.
- Планирование, преобразование данных и интеграция через API.
- Корпоративный уровень масштабируемости и поддержки.
Цена: сейчас продаётся через Mozenda: бесплатный 14-дневный пробный период, Pilot — $500/месяц, enterprise — по запросу.
Совместимость с Linux: веб-приложение — работает на любой ОС.
Лучше всего подходит для: профессионалов и компаний, которым нужен масштабируемый и интегрированный сбор веб-данных.
Таблица быстрого сравнения: инструменты для веб-скрапинга в Linux
| Инструмент | Тип / ключевые возможности | Кому подходит | Цена | Совместимость с Linux |
|---|---|---|---|---|
| Thunderbit | AI-расширение для Chrome, 1 клик, подстраницы, облако/локально | Нетехническим бизнес-пользователям | Бесплатно, от $15/мес | ✔ Chrome в Linux |
| Scrapy | Python-фреймворк, async, CLI, высокая расширяемость | Разработчикам, крупным кастомным скраперам | Бесплатно | ✔ Нативная |
| Beautiful Soup | Python-библиотека, простой разбор HTML/XML | Разработчикам, data scientist’ам, небольшим задачам | Бесплатно | ✔ Нативная |
| Selenium | Автоматизация браузера, сайты с JavaScript | QA, разработчикам, динамическому контенту | Бесплатно | ✔ Нативная |
| Puppeteer | Node.js, headless Chrome, рендеринг JavaScript | Node-разработчикам, современным веб-приложениям | Бесплатно | ✔ Нативная |
| Octoparse | No-code, drag-and-drop, облачные шаблоны | Нетехническим пользователям, e-commerce | Бесплатно, от $69/мес | ◐ Cloud/Wine |
| PhantomJS | Headless WebKit, JavaScript-скриптинг | Наследию, лёгким задачам, без Chrome | Бесплатно | ✔ Нативная |
| ParseHub | Визуальный, кроссплатформенный, point-and-click | Аналитикам, пользователям с базовой техподготовкой | Бесплатно, от $189/мес | ✔ Нативная |
| Kimurai | Ruby-фреймворк, несколько браузеров, async | Ruby-разработчикам, высокой параллельности | Бесплатно | ✔ Нативная |
| Apify | Облачная платформа, SDK, маркетплейс | Разработчикам, гибридным кастомным/облачным решениям | Бесплатный тариф, по usage | ✔ Нативная/облако |
| Colly | Go-фреймворк, быстрый, параллельный | Go-разработчикам, высокой производительности | Бесплатно | ✔ Нативная |
| PySpider | Python, веб-интерфейс, планирование, распределённость | Командам, нескольким проектам | Бесплатно | ✔ Нативная |
| WebHarvy | Визуальный, распознавание шаблонов, разовая лицензия | Новичкам, независимым профессионалам | ~$129 разово | ◐ Wine/VM |
| OutWit Hub | Нативный GUI, автоопределение данных, скрипты | Нетехническим пользователям, десктопному GUI | Бесплатная версия; платная Pro (см. вендора) | ✔ Нативная |
| Portia | Open-source, визуальный, браузерный | Open-source, интеграция со Scrapy | Бесплатно | ✔ Через браузер |
| Sequentum Enterprise | Корпоративный уровень, визуальный интерфейс, скрипты, несколько агентов | Агентствам, крупным командам | $$$, по запросу | ◐ Wine/VM |
| Helium | Python, упрощённый Selenium, интуитивный API | Пользователям Python, быстрой автоматизации | Бесплатно | ✔ Нативная |
| Dexi.io | Облако, визуальные сценарии, планирование, API | Корпоративной, масштабируемой автоматизации | От $500/мес (через Mozenda) | ✔ Через браузер |
Как выбрать подходящий веб-скрапер для Linux: на что смотреть
Не уверен, какой тариф тебе нужен? Начни с самого простого Если не хочешь поддерживать селекторы вручную, пусть AI сам определит поля за тебя — 1 клик, а затем экспорт в Sheets, Excel, Airtable или Notion. Get Started Free
Выбор подходящего инструмента — это всегда вопрос соответствия твоим задачам и уровню подготовки:
- Уровень технических навыков: нетехническим пользователям лучше смотреть в сторону Thunderbit, ParseHub, Octoparse или OutWit Hub. Разработчики смогут раскрыть больше возможностей в Scrapy, Puppeteer, Colly или Kimurai.
- Сложность данных: для статических страниц подойдут Beautiful Soup или Colly — быстро и просто. Для динамических сайтов с JavaScript лучше использовать Selenium, Puppeteer или визуальный инструмент с поддержкой JS.
- Масштаб и частота: для разовых задач подойдут no-code инструменты или облачные скраперы. Для регулярных, масштабных обходов выбирай Scrapy, PySpider или Apify.
- Потребности в интеграциях: нужно выгружать данные в Excel, Sheets или базу данных? Убедись, что инструмент поддерживает твой рабочий процесс.
- Бюджет: у разработчиков много бесплатных и open-source вариантов. Для бизнеса Thunderbit и ParseHub дают доступный старт, а корпоративные команды могут инвестировать в Dexi.io или Sequentum Enterprise.
- Поддержка и сообщество: open-source-инструменты часто имеют большие сообщества; коммерческие продукты предлагают выделенную поддержку.
Совет: не бойся комбинировать инструменты. Используй Thunderbit для прототипа и поиска шаблонов данных, а затем переходи на Scrapy для промышленного масштаба. Или возьми Selenium для входа в систему и получения cookie-сессии, а затем передай задачу Colly или Scrapy для высокоскоростного скрапинга.
Заключение: найди свой лучший инструмент для веб-скрапинга в Linux в 2026 году
В 2026 году пользователям Linux действительно есть из чего выбрать. Хочешь no-code AI-инструмент, который выдаёт результат за минуты (Thunderbit), надёжный фреймворк для разработчиков (Scrapy, Colly) или корпоративную платформу (Dexi.io) — для Linux найдётся веб-скрапер под твои задачи и рабочий процесс.
Ключевые выводы:
- Linux — основа современной data-инфраструктуры: большинство топовых скраперов работают нативно или через браузер.
- AI и no-code-инструменты делают веб-скрапинг доступным для бизнес-пользователей.
- Фреймворки для разработчиков по-прежнему лидируют по гибкости, скорости и масштабу.
- Перед покупкой обязательно тестируй — у большинства инструментов есть бесплатные тарифы или пробные периоды.
Готов начать? Скачай Thunderbit или загляни в Thunderbit Blog, чтобы узнать больше о веб-скрапинге, автоматизации и росте на основе данных.
Изучи AI Web Scraper от Thunderbit Забудь про скрипты и cron-задачи — пусть AI прочитает страницу и выдаст тебе таблицу в 1 клик. Get Started Free
FAQ
1. Какой веб-скрапер для Linux самый простой, если я не умею программировать?
Thunderbit — лучший выбор для нетехнических пользователей. Он работает как расширение Chrome в Linux, использует AI для автоматизации всего процесса и позволяет собирать данные в один клик.
2. Какой Linux-веб-скрапер лучше всего подходит для крупных кастомных проектов?
Scrapy — стандартный выбор для разработчиков. Он быстрый, масштабируемый и легко настраиваемый — идеально для больших регулярных обходов.
3. Можно ли в Linux собирать данные с сайтов с большим количеством JavaScript или динамическим контентом?
Да! Используй Selenium или Puppeteer, чтобы управлять реальными браузерами и извлекать динамический контент. Визуальные инструменты вроде ParseHub и Thunderbit тоже поддерживают динамические сайты.
4. Есть ли бесплатные инструменты для веб-скрапинга в Linux для бизнеса?
Безусловно. Scrapy, Beautiful Soup, Selenium, Colly, PySpider и Kimurai — все они бесплатные и open-source. Thunderbit и ParseHub тоже предлагают бесплатные тарифы для небольших задач.
5. Как выбрать между no-code и code-based скраперами для Linux?
Если тебе важны скорость и простота, выбирай no-code (Thunderbit, ParseHub, Octoparse). Если тебе нужна гибкость, автоматизация или интеграция с другими системами, лучше подойдут code-based инструменты (Scrapy, Puppeteer, Colly).
Удачного скрапинга — пусть твои data-проекты на Linux работают быстрее и стабильнее, чем свежая установка Ubuntu. Если хочешь больше советов по веб-скрапингу, загляни в Thunderbit Blog или подпишись на наш YouTube-канал, где есть практические туториалы.
Попробуй AI Web Scraper для Linux Get Started Free
Узнать больше



