
Интернет растет быстрее, чем моя зависимость от кофе — и поверьте, это о многом говорит. В 2026 году извлечение веб-данных — это не просто нишевый навык для гиков; это основа бизнес-аналитики, обучения ИИ и автоматизации. Отслеживаете ли вы рыночные тенденции, обучаете свою LLM нового поколения или просто пытаетесь не отставать от цен конкурентов, потребность в актуальных, структурированных веб-данных никогда не была такой высокой. И в основе этой "золотой лихорадки" данных лежит Python. Благодаря своей обширной экосистеме и доступному синтаксису, Python остается основным языком для веб-скрепинга, обеспечивая работу всего: от быстрых одноразовых скриптов до промышленных краулеров.
Но вот в чем загвоздка: выбор правильных пакетов Python для веб-скрепинга может как помочь, так и навредить вашему проекту. Я видел, как команды тратили дни на борьбу с антибот-защитой с помощью неправильного инструмента или часами разбирали "грязный" HTML, когда более умная библиотека справилась бы с этим за считанные минуты. Поэтому, как человек, который провел годы в SaaS, автоматизации и ИИ (и создал Thunderbit, чтобы упростить скрепинг для всех), я собрал 12 лучших пакетов Python для веб-скрепинга на 2026 год — каждый со своими сильными сторонами, особенностями и идеальными сценариями использования. Давайте углубимся и найдем идеальный вариант для вашего следующего приключения с данными.
Почему важен правильный выбор пакетов Python для веб-скрепинга
Собирайте данные с любого веб-сайта с помощью ИИ Get Started Free
Давайте будем реалистами: не все проекты веб-скрепинга одинаковы. Иногда вам просто нужно получить несколько цен на товары со статической страницы. В других случаях вы имеете дело с сайтом, сильно нагруженным JavaScript, который упрямее кошки во время купания. Правильный пакет может сэкономить вам часы (или дни), уменьшить количество ошибок и помочь избежать распространенных ловушек, таких как блокировка антибот-системами или "битый" HTML.
Популярность Python в веб-скрепинге — это не просто шумиха. Библиотеки, такие как requests и urllib3, скачиваются более 1 миллиарда раз в месяц, и почти каждый крупный инструмент для скрепинга ориентирован на Python. Но с большой силой приходит и большая ответственность: выберите неправильный инструмент, и вы можете застрять на проекте, который будет медленнее, чем модемное соединение. Выберите мудро, и вы будете купаться в чистых, структурированных данных еще до того, как ваш кофе остынет.
Как мы выбирали лучшие пакеты Python для веб-скрепинга
Я не просто бросал дротики в диаграмму PyPI. Вот как я оценивал каждый пакет:
- Производительность и параллелизм: Может ли он быстро получать сотни (или тысячи) страниц?
- Простота использования: Подходит ли он для новичков или требует докторской степени по информатике?
- Мощность парсинга HTML: Обрабатывает ли он "битую" разметку, поддерживает ли селекторы XPath/CSS и делает ли извлечение данных безболезненным?
- Поддержка динамического контента: Может ли он работать с сайтами, сильно нагруженными JavaScript, или предназначен только для статических страниц?
- Сообщество и документация: Есть ли активное сообщество пользователей и хорошая документация, или вы застрянете в чистилище Stack Overflow?
- Лучший сценарий использования: Подходит ли он для быстрых скриптов, крупномасштабных краулеров или чего-то среднего?
Я также учитывал реальные отзывы разработчиков, последние бенчмарки и мой собственный (иногда болезненный) опыт в этой области. А теперь давайте познакомимся с претендентами.
1. Thunderbit
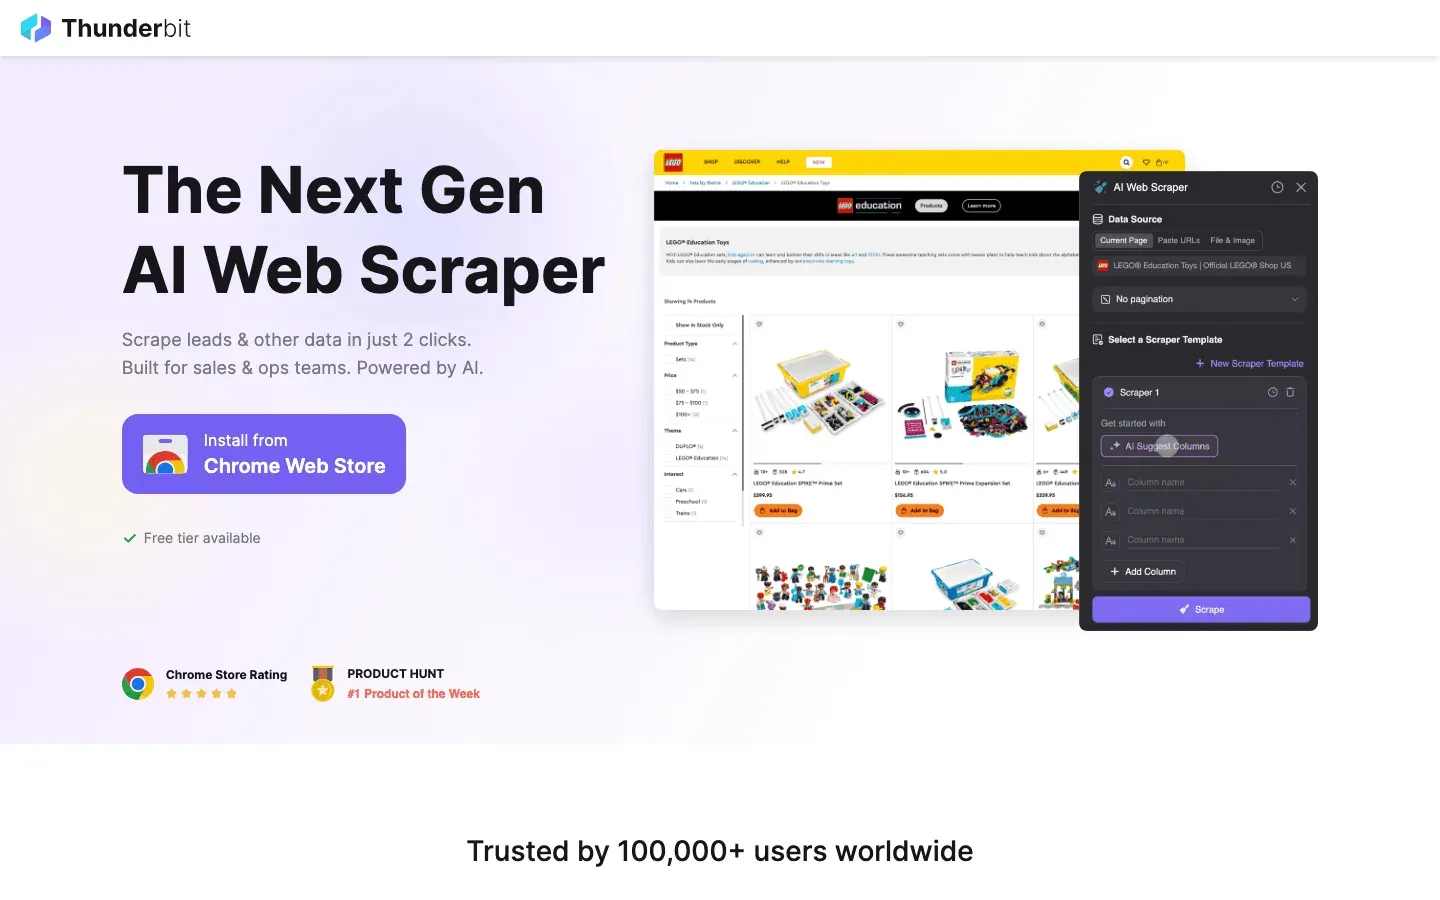 Thunderbit — это не типичная библиотека Python; это расширение Chrome на базе ИИ, которое меняет правила игры в веб-скрепинге, особенно для Python-разработчиков, которым нужна скорость, точность и немного магии ИИ. Что выделяет Thunderbit? Оно позволяет использовать инструкции на естественном языке, чтобы сообщить ИИ, какие данные вам нужны, а затем оно обрабатывает все: предложения по полям, навигацию по подстраницам, пагинацию и даже экспорт в Excel, Google Sheets, Notion или Airtable.
Thunderbit — это спасение для скрепинга сложных, неструктурированных данных — например, "грязных" каталогов, списков товаров или сайтов, где HTML больше похож на "абстрактное искусство", чем на "структурированный документ". Его функция AI Suggest Fields считывает страницу и предлагает лучшие столбцы, а Subpage Scraping позволяет обогатить ваш набор данных, автоматически посещая связанные страницы с деталями. И если вы устали от проблем с антибот-системами, Thunderbit предлагает варианты скрепинга на основе браузера и облачного скрепинга.
Python-разработчики любят Thunderbit за быстрое прототипирование, генерацию лидов и маркетинговые исследования. Вы можете использовать его вывод непосредственно в своем конвейере данных Python или даже автоматизировать рабочие процессы скрепинга с помощью его API. Это не традиционная библиотека кода, но она быстро становится фаворитом для всех, кто хочет тратить меньше времени на кодирование и больше времени на анализ данных.
Ключевые особенности:
- Извлечение данных и предложение полей на основе ИИ
- Обрабатывает подстраницы, пагинацию и даже PDF/изображения
- Экспорт в CSV, Excel, Google Sheets, Notion, Airtable
- Не требует кодирования — идеально подходит как для нетехнических пользователей, так и для профессионалов Python, которые хотят работать быстро
- Доступен бесплатный тариф; платные планы масштабируются в соответствии с вашими потребностями
Лучше всего подходит для: Генерации лидов, маркетинговых исследований, быстрого прототипирования и скрепинга сложных или "грязных" веб-данных.
Попробуйте Thunderbit AI Web Scraper бесплатно
2. Beautiful Soup
 Beautiful Soup — это "старожил" парсинга HTML в Python. Если вы только начинаете или вам нужно извлечь данные со статических веб-страниц, это ваш лучший друг. Beautiful Soup отлично справляется с навигацией и парсингом плохо структурированного HTML ("суп из тегов"), что делает его спасением для скрепинга сайтов, которые не соблюдают правила.
API удобен для новичков — подумайте о .find(), .select() и .text — и он отлично сочетается с requests для получения веб-страниц. Под капотом вы можете выбрать различные парсеры (например, lxml для скорости или html5lib для максимальной совместимости). Документация на высшем уровне, а сообщество огромное.
Ключевые особенности:
- Интуитивно понятный, "питоновский" API для навигации по HTML/XML
- Изящно обрабатывает "битую" или непоследовательную разметку
- Работает с несколькими парсерами для скорости или совместимости
- Огромное сообщество и множество учебных пособий
Лучше всего подходит для: Быстрых скриптов, скрепинга статических страниц и новичков, которые хотят легко освоиться.
Узнайте больше о Beautiful Soup
3. Scrapy
 Scrapy — это тяжеловес для крупномасштабного, автоматизированного веб-краулинга. Если вам нужно собрать сотни или тысячи страниц, управлять конвейерами или планировать повторяющиеся задачи, Scrapy — это фреймворк, на котором останавливаются большинство команд. Он по-прежнему работает на реакторе Twisted, но начиная с версии 2.14 большая часть его асинхронных внутренних компонентов была переписана как нативные сопрограммы
asyncio, и теперь есть точки входа AsyncCrawlerProcess / AsyncCrawlerRunner, которые хорошо сочетаются с остальной частью современной асинхронной экосистемы Python. Он быстрый, поддерживает параллельный краулинг, конвейеры элементов для очистки данных и экспортирует в JSON, CSV или базы данных.
Scrapy расширяем, с плагинами для прокси, кэширования и даже ограниченного рендеринга JavaScript (через интеграцию Splash или Selenium). Кривая обучения круче, чем у Beautiful Soup, но если вы серьезно относитесь к веб-данным в масштабе, Scrapy — это то, к чему вы придете.
Ключевые особенности:
- Асинхронный краулинг через реактор Twisted + нативные сопрограммы
asyncio(Scrapy 2.14+, Python 3.10+) - Встроенные конвейеры для очистки и хранения данных
- Экспорт в несколько форматов (JSON, CSV, DB)
- Большое, активное сообщество и экосистема плагинов
Лучше всего подходит для: Крупномасштабных, повторяющихся проектов скрепинга, конвейеров данных и всех, кому нужна скорость и надежность.
4. Selenium
 Selenium — это основной инструмент для скрепинга сайтов, сильно нагруженных JavaScript или интерактивных сайтов. Он автоматизирует реальные браузеры (Chrome, Firefox и т. д.), позволяя имитировать действия пользователя, такие как клики, прокрутка и отправка форм. Если нужные вам данные появляются только после выполнения JavaScript, Selenium может их получить — независимо от того, насколько упрям сайт.
В чем компромисс? Selenium медленный и ресурсоемкий. Вы запускаете полноценный браузер для каждого скрепинга, поэтому не ожидайте обработки тысяч страниц в минуту. Но для тех сценариев, когда "ни один другой инструмент не может этого сделать", Selenium — это спасение.
Ключевые особенности:
- Полная автоматизация браузера (поддерживает Chrome, Firefox, Edge и т. д.)
- Обрабатывает контент, отображаемый JavaScript, и интерактивные элементы
- Поддерживает безголовый режим для более быстрого скрепинга без пользовательского интерфейса
- Большое сообщество и обширная документация
Лучше всего подходит для: Скрепинга динамических сайтов, сильно нагруженных JavaScript, автоматизации процессов входа в систему и обработки CAPTCHA или сложных взаимодействий с пользователем.
Подробнее о сильных и слабых сторонах Selenium
5. PyQuery
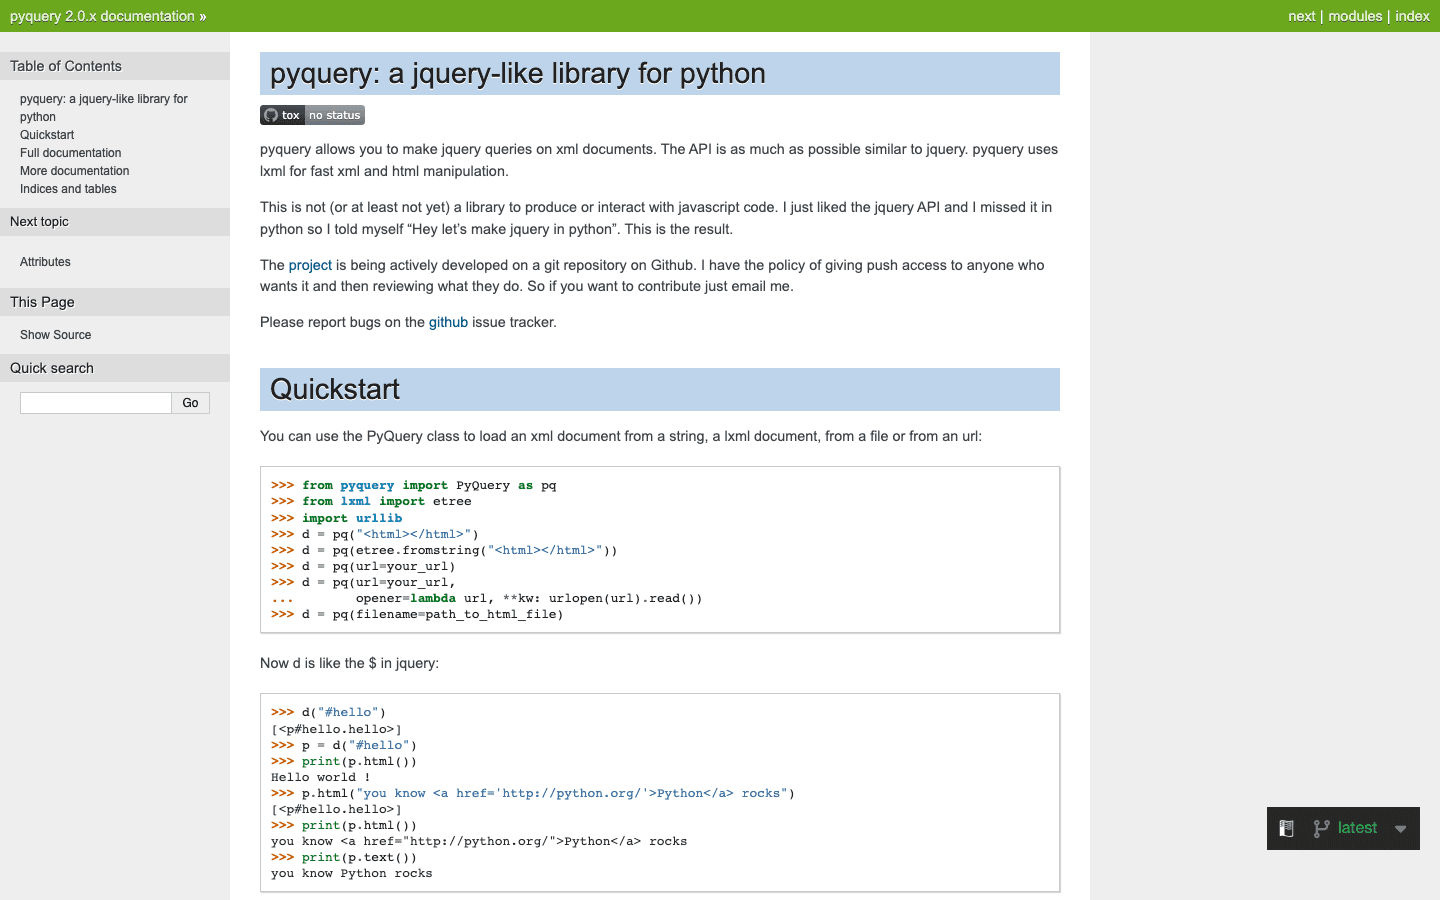 PyQuery привносит синтаксис в стиле jQuery в Python, делая парсинг HTML знакомым для всех, кто работал с jQuery в JavaScript. Он оборачивает быстрый парсер
lxml и позволяет использовать селекторы CSS, такие как $('div.classname'), для поиска элементов.
PyQuery отлично подходит для быстрого прототипирования и для разработчиков, которым нужен лаконичный, читаемый код. Он быстрее Beautiful Soup для сложных запросов и легко интегрируется с асинхронными инструментами или Selenium для более продвинутых рабочих процессов.
Ключевые особенности:
- Селекторы и синтаксис в стиле jQuery в Python
- Быстрый парсинг с использованием бэкенда lxml
- Отлично подходит для разработчиков, переходящих с JavaScript
- Поддерживает цепочки вызовов и лаконичные запросы
Лучше всего подходит для: Прототипирования, поклонников jQuery и всех, кто хочет писать меньше кода для парсинга HTML.
Учебник и сравнение PyQuery
6. LXML
 LXML — это "скоростной демон" парсинга HTML и XML в Python. Созданный на основе библиотек C
libxml2 и libxslt, он известен своей производительностью и мощной поддержкой селекторов XPath и CSS. Если вы имеете дело с большими документами или вам нужно выполнять сложные запросы, lxml — ваш лучший выбор.
Его можно использовать напрямую или в качестве бэкенда для Beautiful Soup или PyQuery. API немного более продвинутый, но скорость и гибкость того стоят для больших задач.
Ключевые особенности:
- Самый быстрый парсинг, доступный в Python
- Полная поддержка селекторов XPath и CSS
- Эффективно обрабатывает большие и сложные документы
- Может использоваться как автономно, так и в качестве парсера для других библиотек
Лучше всего подходит для: Высокопроизводительного парсинга, крупномасштабного скрепинга и проектов, требующих расширенных запросов.
Почему lxml выделяется для парсинга
7. Requests
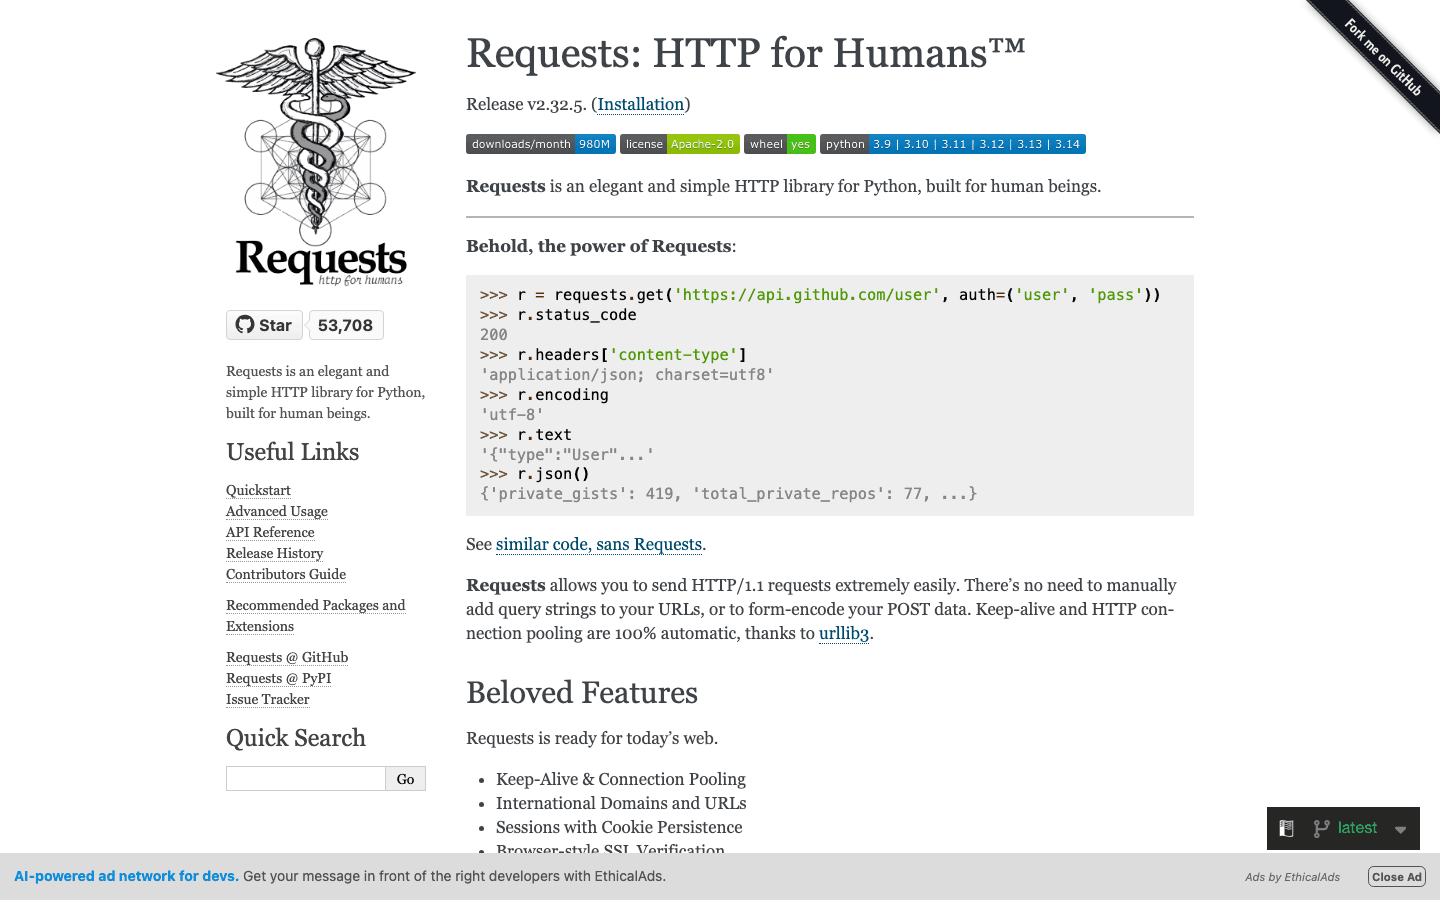 Requests — это де-факто стандарт для выполнения HTTP-запросов в Python. Его чистый, интуитивно понятный API делает получение веб-страниц таким же простым, как
requests.get(url). Он обрабатывает куки, сессии и даже декодирование JSON "из коробки".
Хотя Requests является синхронным (каждый запрос ожидает завершения), он идеально подходит для быстрых скриптов и небольшого скрепинга. Сочетайте его с Beautiful Soup или lxml для классического рабочего процесса скрепинга.
Ключевые особенности:
- Простой, "питоновский" API для HTTP-запросов
- Обрабатывает куки, сессии и перенаправления
- Бесшовно интегрируется с библиотеками парсинга
- Огромное сообщество и документация
Лучше всего подходит для: Простых скриптов, скрепинга статических страниц и новичков, которые хотят быстро начать.
Посмотрите, почему Requests так популярен
8. MechanicalSoup
 MechanicalSoup — это легковесная библиотека, которая автоматизирует простые взаимодействия с браузером — например, заполнение форм или навигацию по многошаговым процессам входа в систему — без запуска полноценного браузера. Она оборачивает
requests и Beautiful Soup, что делает ее намного быстрее и легче, чем Selenium, для сайтов, которые не сильно зависят от JavaScript.
Если вам нужно войти в систему, отправить формы или пройти по нескольким страницам (и сайт не слишком динамичен), MechanicalSoup — отличный компромисс.
Ключевые особенности:
- Автоматизирует заполнение форм и навигацию
- Построен на основе Requests и Beautiful Soup
- Легкий и быстрый (без накладных расходов браузера)
- Прост в использовании для умеренной интерактивности
Лучше всего подходит для: Сайтов, требующих входа в систему или отправки форм, простых задач автоматизации и всех, кто хочет избежать накладных расходов Selenium.
9. Aiohttp
 Aiohttp — это асинхронный "тяжеловес" для высокоскоростных, параллельных веб-запросов. Если вам нужно быстро собрать сотни страниц, aiohttp позволяет отправлять запросы параллельно, значительно сокращая общее время выполнения. В одном тесте сбор 50 страниц занял всего 3 секунды с aiohttp, по сравнению с 16 секундами при использовании синхронных запросов (см. разницу в производительности).
Aiohttp требует написания кода async def и использования await, но прирост скорости того стоит для крупномасштабных задач.
Ключевые особенности:
- Асинхронный клиент/серверный фреймворк HTTP
- Поддерживает сессии, куки и HTTP/2
- Значительное ускорение для параллельных запросов
- Интегрируется с асинхронными библиотеками парсинга
Лучше всего подходит для: Высокоскоростного, крупномасштабного скрепинга, сбора данных API и всех, кто знаком с асинхронным программированием.
10. Twisted
 Twisted — это сетевой движок, управляемый событиями, который лежит в основе Scrapy. Хотя это не библиотека для скрепинга как таковая, продвинутые пользователи могут использовать Twisted напрямую для создания пользовательских краулеров, обработки не-HTTP протоколов или реализации гиперпараллельных "пауков".
Twisted мощный, но имеет крутую кривую обучения. Он лучше всего подходит для очень специфических сценариев или при создании фреймворков с нуля.
Ключевые особенности:
- Сетевое взаимодействие, управляемое событиями, для HTTP, WebSockets, SSH и многого другого
- Поддерживает SSL, параллелизм и пользовательские протоколы
- Лежит в основе асинхронного движка Scrapy
- Высокая гибкость для продвинутых сценариев использования
Лучше всего подходит для: Пользовательских протоколов, создания фреймворков для скрепинга и продвинутых пользователей, которым нужен максимальный контроль.
11. Grab
 Grab — это универсальный набор инструментов для скрепинга, который сочетает в себе HTTP-запросы, парсинг, автоматизацию, ротацию прокси и обработку CAPTCHA. Он похож по духу на Scrapy, но стремится быть проще в освоении и использовании, со встроенной поддержкой прокси, кэширования и асинхронных "пауков".
Выдающаяся особенность Grab — это его система Grab:Spider, которая может выполнять тысячи запросов параллельно с использованием multicurl. Если вам нужно универсальное решение с меньшей настройкой, чем Scrapy, Grab стоит рассмотреть.
Ключевые особенности:
- Встроенная поддержка прокси, ротации user-agent и кэширования
- Асинхронная система "пауков" для высокой параллельности
- Парсинг XPath и модульная архитектура
- Используется в производстве для крупномасштабного скрепинга
Лучше всего подходит для: Универсальных проектов скрепинга, задач, сильно зависящих от прокси, и пользователей, которым нужна мощность без сложности Scrapy.
12. Urllib3
 Urllib3 — это низкоуровневый HTTP-движок, который лежит в основе многих клиентов Python, включая Requests. Он предлагает пулинг соединений, потокобезопасность, повторные попытки и тонкий контроль над HTTP-соединениями. Хотя большинство разработчиков используют его косвенно, urllib3 — это ваш выбор, когда вам нужна максимальная производительность или вы создаете библиотеки более высокого уровня.
Он не так удобен для новичков, как Requests, но он проверен временем и очень надежен.
Ключевые особенности:
- Пулинг соединений и потокобезопасность
- Тонкий контроль над HTTP-соединениями
- Используется как основа для многих других библиотек
- Высокая производительность для повторяющихся запросов
Лучше всего подходит для: Пользовательских HTTP-клиентов, многопоточных краулеров и разработчиков, создающих надстройки над стеком HTTP Python.
Посмотрите роль urllib3 в скрепинге
Сравнительная таблица: Обзор пакетов Python для веб-скрепинга
| Пакет | Простота использования | Производительность | Динамический контент | Мощность парсинга | Сообщество/Документация | Лучше всего подходит для |
|---|---|---|---|---|---|---|
| Thunderbit | ★★★★☆ (GUI/ИИ) | Быстро (облако/локально) | Да (через ИИ) | Автополя, подстраницы | Растет (тренд ИИ) | Генерация лидов, маркетинговые исследования, пользователи без кода |
| Beautiful Soup | ★★★★★ (легко) | Средняя | Нет | HTML/XML, "прощающий" | Огромное | Статические страницы, новички |
| Scrapy | ★★☆☆☆ (сложно) | ★★★★★ (очень высокая) | Только плагины | CSS/XPath, конвейеры | Большое, активное | Крупномасштабный, повторяющийся скрепинг |
| Selenium | ★★☆☆☆ (средне) | ★☆☆☆☆ (медленно) | Да (полностью) | Полный DOM, JS | Зрелое | JS-тяжелые, интерактивные сайты |
| PyQuery | ★★★★☆ (jQuery) | Быстро (lxml) | Нет* | Селекторы jQuery | Умеренное | Прототипирование, разработчики jQuery |
| LXML | ★★★☆☆ (продвинутый) | ★★★★★ (самый быстрый) | Нет | XPath/CSS, XML | Умеренное | Большие документы, продвинутые запросы |
| Requests | ★★★★★ (очень легко) | ★★☆☆☆ (синхронно) | Нет | HTTP, JSON | Огромное | Простые скрипты, статические страницы |
| MechanicalSoup | ★★★★☆ (легко) | ★★☆☆☆ (синхронно) | Нет | Формы, навигация | Небольшое | Процессы входа, автоматизация форм |
| Aiohttp | ★★☆☆☆ (асинхронно) | ★★★★★ (параллельно) | Нет | Асинхронный HTTP | Большое (асинхронное) | Высокоскоростной, параллельный скрепинг |
| Twisted | ★☆☆☆☆ (сложно) | ★★★★★ (пользовательский) | Нет | Сеть, протоколы | Нишевое | Пользовательские фреймворки, продвинутые пользователи |
| Grab | ★★★☆☆ (модульный) | ★★★★☆ (асинхронно) | Нет | Прокси, XPath | Небольшое | Универсальный, сильно зависящий от прокси/captcha |
| Urllib3 | ★★★★☆ (низкоуровневый) | ★★★★☆ (пулинг) | Нет | HTTP, пулинг | Огромное | Пользовательские клиенты, многопоточные краулеры |
*PyQuery можно комбинировать с Selenium для динамических сайтов.
Как выбрать подходящий пакет Python для веб-скрепинга для ваших нужд
Что такое сбор данных и как его выполнять в 2026 году Get Started Free
Итак, какой пакет выбрать? Вот моя шпаргалка:
- Статические страницы, небольшие задачи или вы новичок в скрепинге: Начните с Requests + Beautiful Soup.
- Крупномасштабный, повторяющийся или производственный скрепинг: Scrapy или Grab (для универсальных нужд).
- Сайты, сильно нагруженные JavaScript, или интерактивные сайты: Selenium (или Thunderbit, если вам нужен скрепинг без кода на базе ИИ).
- Высокоскоростной, параллельный скрепинг: Aiohttp (если вы знакомы с асинхронным программированием).
- Автоматизация форм или процессы входа в систему: MechanicalSoup (для простых сайтов), Selenium (для сложных JS).
- Продвинутый парсинг или огромные документы: LXML или PyQuery.
- Пользовательская работа с сетью или протоколами: Twisted.
- Быстрое прототипирование, генерация лидов или "грязные"/неструктурированные данные: Thunderbit.
И не бойтесь смешивать и сочетать — многие рабочие процессы объединяют эти инструменты для максимальной эффективности. Например, вы можете использовать Selenium для рендеринга страницы, а затем передать HTML в Beautiful Soup или PyQuery для парсинга.
Заключение: Ускорьте свой веб-скрепинг с помощью правильных инструментов Python
Веб-скрепинг в 2026 году мощнее — и нужнее — чем когда-либо. С помощью правильных пакетов Python для веб-скрепинга вы можете превратить хаос Интернета в чистые, действенные данные для вашего бизнеса, исследований или следующей большой идеи. Независимо от того, являетесь ли вы опытным разработчиком или только окунаетесь в мир данных, в этом списке найдется инструмент, который соответствует вашим потребностям.
Если вы хотите увидеть, как выглядит скрепинг без кода на базе ИИ, попробуйте Thunderbit. А если вы жаждете больше советов, подробных обзоров и учебных пособий, загляните в Блог Thunderbit, чтобы узнать о последних новостях в области веб-скрепинга, автоматизации и рабочих процессов, основанных на данных.
Попробуйте Thunderbit AI Web Scraper бесплатно
Удачного скрепинга — и пусть ваши селекторы всегда совпадают, ваши прокси никогда не подводят, а ваши данные будут такими же чистыми, как ваш код.
Часто задаваемые вопросы
1. Какой пакет Python для веб-скрепинга лучше всего подходит для новичков? Для большинства новичков комбинация Requests и Beautiful Soup — самый простой способ начать. Оба имеют интуитивно понятные API, множество учебных пособий и справляются с большинством задач по скрепингу статических страниц.
2. Как скрепить веб-сайты, сильно нагруженные JavaScript, с помощью Python? Используйте Selenium для автоматизации реального браузера или попробуйте Thunderbit для скрепинга без кода на базе ИИ, который может обрабатывать динамический контент. Для крупномасштабных нужд Scrapy можно комбинировать со Splash или Selenium.
3. Какой пакет лучше всего подходит для крупномасштабного, высокоскоростного скрепинга? Scrapy создан для крупномасштабного, асинхронного краулинга. Если вам нужна еще большая скорость и вы знакомы с асинхронным кодом, aiohttp — лучший выбор для параллельных запросов.
4. Могу ли я комбинировать эти пакеты в своем рабочем процессе? Конечно! Многие разработчики используют Requests или Selenium для получения страниц, а затем парсят их с помощью Beautiful Soup, lxml или PyQuery. Выводы Thunderbit можно подавать в скрипты Python для дальнейшего анализа.
5. Thunderbit — это библиотека Python или отдельный инструмент? Thunderbit — это расширение Chrome и платформа на базе ИИ, а не традиционная библиотека Python. Однако его вывод (CSV, Excel, Sheets, Notion, Airtable) бесшовно интегрируется в конвейеры данных Python, что делает его мощным компаньоном для Python-разработчиков.
6. Заменяют ли агенты кодирования ИИ библиотеки скрепинга Python в 2026 году? Пока нет, но о них стоит знать. Такие инструменты, как Claude Code и OpenAI Codex, могут генерировать рабочий скрипт Requests + Beautiful Soup или Scrapy из простого запроса на английском языке за считанные секунды, что действительно полезно для одноразовых задач и прототипирования. Для браузерных потоков на естественном языке (входы в систему, динамический JS, многошаговая навигация) Browser Use является открытым исходным кодом, к которому обращаются люди, а Firecrawl популярен, когда цель состоит в подаче чистого markdown в LLM. Ничто из этого не устраняет сложные части — антибот-защита, ограничения скорости и условия использования по-прежнему применяются — и для производственных краулеров в масштабе Scrapy + aiohttp по-прежнему выигрывают по стоимости и контролю. Рассматривайте агентов ИИ как более быстрый способ написать скрепер, а не как прямую замену библиотек из этого списка.
Хотите оставаться в курсе событий в мире веб-скрепинга? Подпишитесь на канал Thunderbit на YouTube и следите за Блогом Thunderbit, чтобы получать больше руководств, сравнений и советов по автоматизации.
Попробуйте Thunderbit AI Web Scraper бесплатно Get Started Free
Узнать больше
- Топ-10 библиотек Python для веб-скрепинга и альтернатива на базе ИИ
- 7 самых популярных инструментов для веб-скрепинга в 2026 году
- Топ-5 лучших программ для сбора веб-данных в 2026 году
- Лучшие инструменты и программное обеспечение для веб-скрепинга в 2025 году
- BeautifulSoup в Python: Руководство для начинающих




