
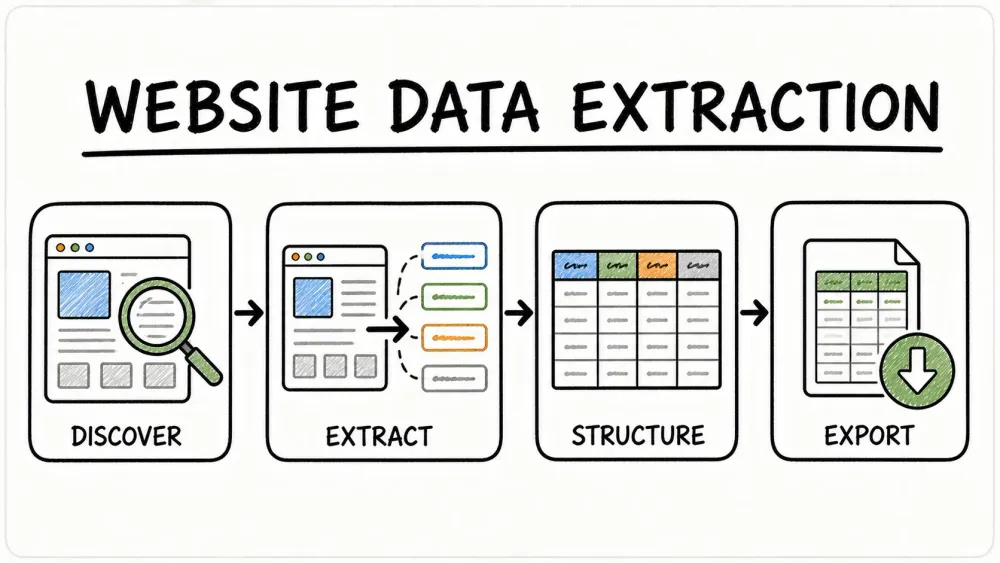
Интернет переполнен информацией, но превратить этот хаос в полезные для бизнеса данные — вот где начинается настоящая работа и открываются возможности. За годы работы над SaaS- и автоматизационными продуктами я видел, как мир уходит от решений «на глазок» к полному управлению на основе данных. И это уже не только история про технологических гигантов: даже небольшие команды спешат извлекать данные с сайтов, чтобы усиливать продажи, маркетинг, ценообразование и продуктовые решения. Но чем более шумным и динамичным становится веб, тем сложнее получать из него чистые, корректные с точки зрения закона и действительно полезные данные.
Давайте без лишней теории: я расскажу, почему извлечение данных с сайтов так важно для современного бизнеса, с какими главными трудностями вы столкнётесь и какие практики помогут делать это правильно — законно, эффективно и в нужном масштабе. Если вы работаете с неструктурированным контентом, переживаете из-за GDPR или просто хотите перестать копировать данные вручную в таблицы, это руководство вам пригодится.
Почему извлечение данных с сайтов важно для современного бизнеса
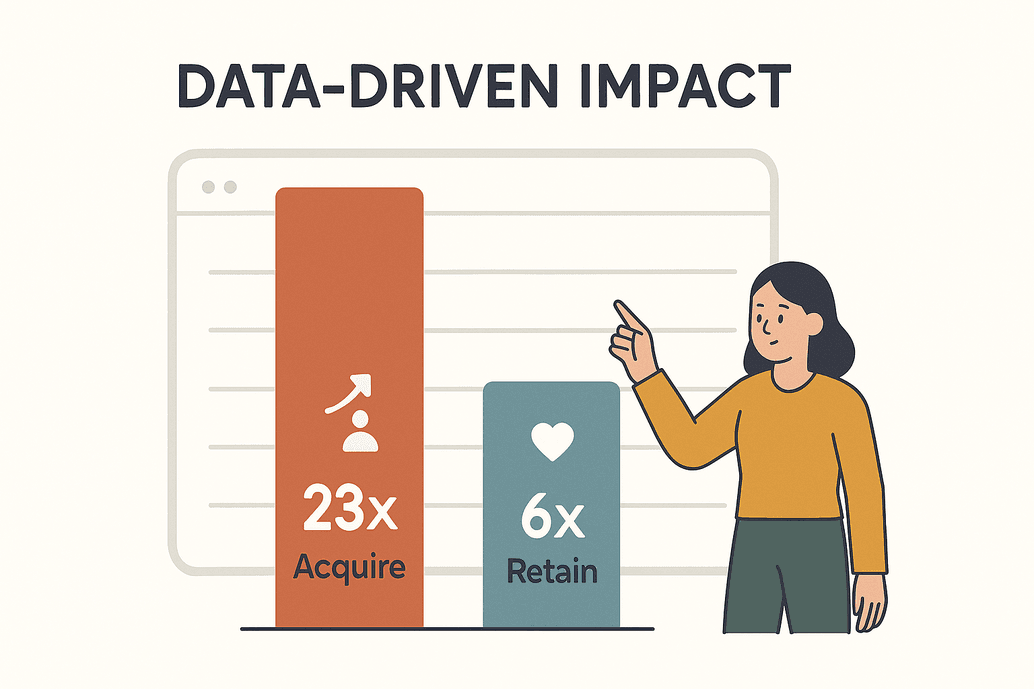 Данные — это не просто модное слово, а топливо для конкурентного бизнеса сегодня. Согласно исследованию McKinsey, компании, которые управляют на основе данных, в 23 раза чаще привлекают клиентов и в 6 раз чаще удерживают их. Это не просто впечатляющая цифра — это вопрос выживания. К 2025 году компании будут ежедневно извлекать миллиарды веб-страниц, чтобы подпитывать аналитику, AI-модели и принятие решений в реальном времени (kanhasoft.com).
Что это значит на практике? Вот лишь несколько сценариев, которые я вижу каждую неделю:
| Бизнес-задача | Описание и выгода | Пример/статистика |
|---|---|---|
| Мониторинг цен | Отслеживайте цены конкурентов, остатки и акции в реальном времени и корректируйте свою стратегию, чтобы оставаться впереди. | Более 80% ведущих интернет-ритейлеров ежедневно собирают цены конкурентов (kanhasoft.com). |
| Лидогенерация | Собирайте свежие лиды и контактные данные из каталогов, соцсетей или сайтов с отзывами. | Автоматическое извлечение данных заполняет CRM быстрее любого ручного ресёрча. |
| Анализ рыночных трендов | Сводите отзывы, форумы и новости в единый массив, чтобы раньше замечать тренды и изменения настроений. | 26% задач по scraping связано с соцсетями ради инсайтов о трендах (blog.apify.com). |
| Агрегация контента | Собирайте новости, карточки товаров или события с разных сайтов в одном удобном месте. | Медиа-команды формируют подборки под свою аудиторию. |
| Данные о продуктах и исследованиях | Сохраняйте характеристики товаров, отзывы и исследовательские данные для анализа и разработки. | 67% инвестиционных консультантов используют альтернативные веб-данные (scrap.io). |
| Данные для обучения AI | Извлекайте большие объёмы текста, изображений или записей для обучения AI-моделей. | Около 70% крупных AI-моделей опираются на данные, собранные в интернете (kanhasoft.com). |
Если вы не извлекаете данные с сайтов, вы не просто отстаёте — вас попросту не видно на рынке. Я видел, как e-commerce-команды утроили ROI всего за шесть месяцев, просто автоматизировав сбор цен конкурентов (kanhasoft.com). Вывод простой: веб-данные — это стратегический актив, и умение правильно их собирать уже стало базовым требованием.
Основные сложности при извлечении данных с любого сайта
Конечно, не всё так радужно и безоблачно. Веб — место хаотичное, и сбор данных с сайтов связан с вполне реальными трудностями:
- Неструктурированные данные: Около 80% онлайн-данных неструктурированы — они спрятаны в запутанном HTML, разбросаны по страницам или скрыты за интерактивными элементами. Превратить это в аккуратную таблицу — непростая задача (scrapingapi.ai).
- Изменения на сайтах: Сайты постоянно обновляют макеты. Я видел, как парсеры ломались 15 раз за один месяц только потому, что целевой сайт слегка поменял дизайн (scrap.io).
- Объём и масштаб: Бизнесу нужно извлекать данные со сотен или тысяч страниц — часто по расписанию. Ручное копирование и вставка здесь уже не работает.
- Антибот-защита: CAPTCHA, лимиты запросов, страницы входа… Сайты всё лучше блокируют ботов. Сейчас более треть всего веб-трафика приходится на ботов (scrap.io), а технологии защиты от них быстро развиваются.
- Ошибки при ручной работе: Копирование вручную медленное и часто приводит к ошибкам. Один неверный селектор — и вы забираете не те данные или вообще ничего.
Традиционные методы просто не масштабируются. Именно поэтому всё больше команд переходят на более умные автоматизированные решения — и почему я так верю в AI-инструменты.
Лучшие практики по законности, соответствию требованиям и безопасности при извлечении данных с сайтов
Сразу обозначим важный момент: то, что вы можете извлекать данные с сайта, не означает, что вы должны это делать — по крайней мере, без учёта юридической и этической стороны. Вот что должен понимать каждый бизнес:
- Публичные и закрытые данные: Сбор общедоступной информации во многих странах обычно законен. Но всё, что находится за логином? Это уже запретная зона. Обход авторизации недопустим (xbyte.io).
- Условия использования: Всегда проверяйте ToS сайта. Если scraping запрещён, вы рискуете получить иск или блокировку. Если сомневаетесь — запросите разрешение или используйте официальные API.
- Законы о конфиденциальности (GDPR, CCPA): Если вы собираете персональные данные, вам нужна законная основа (например, законный интерес), следует ограничивать объём собираемых данных и быть готовыми удалить их по запросу. Нарушения могут привести к огромным штрафам (xbyte.io).
- Уважайте robots.txt: Это не юридически обязательный документ, но соблюдать его — хорошая практика. Следуйте правилам crawl-delay и не перегружайте серверы.
- Безопасность данных: Относитесь к собранным данным как к чувствительной информации. Храните их безопасно, ограничивайте доступ и очищайте перед использованием.
Чек-лист по соответствию требованиям:
| Что проверить | Лучшая практика |
|---|---|
| Законный доступ | Собирайте только публичные данные; никогда не обходите логин (xbyte.io). |
| Условия использования | Изучайте и соблюдайте ToS сайта; используйте API, если scraping запрещён. |
| Персональные данные | По возможности избегайте; если нужны — минимизируйте сбор и соблюдайте GDPR/CCPA. |
| robots.txt и задержки запросов | Следуйте правилам сайта; ограничивайте частоту запросов. |
| Безопасность данных | Шифруйте, ограничивайте доступ и удаляйте данные, когда они больше не нужны. |
Как AI повышает эффективность извлечения данных с сайтов
Вот тут начинается самое интересное. AI полностью изменил подход к извлечению данных с сайтов. Вместо борьбы с селекторами и написания хрупких скриптов вы теперь можете использовать AI-инструменты, которые сами «читают» страницу и понимают, что именно нужно извлечь — часто буквально в пару кликов.
Что это даёт на практике?
- Минимум настройки: AI-скрейперы вроде Thunderbit умеют автоматически находить поля. Просто нажмите «One Click Extract», и инструмент сам предложит подходящие колонки — без кода и без экспериментов.
- Гибкость: AI-скрейперы распознают не только фиксированную верстку, но и закономерности. Если сайт меняется, AI часто подстраивается автоматически. Это значит меньше поддержки и меньше ночных аварий.
- Точность: AI умеет отсекать шум, удалять дубликаты и даже очищать грязные данные прямо во время сбора. Некоторые команды сообщают о точности до 99,5% при использовании AI-экстракторов (scrapingapi.ai).
- Динамический контент: AI-скрейперы справляются с сайтами на JavaScript, бесконечной прокруткой и даже умеют извлекать текст из изображений или PDF.
- Обработка на лету: Нужно перевести, классифицировать или кратко пересказать данные прямо в процессе сбора? AI сделает это за один проход.
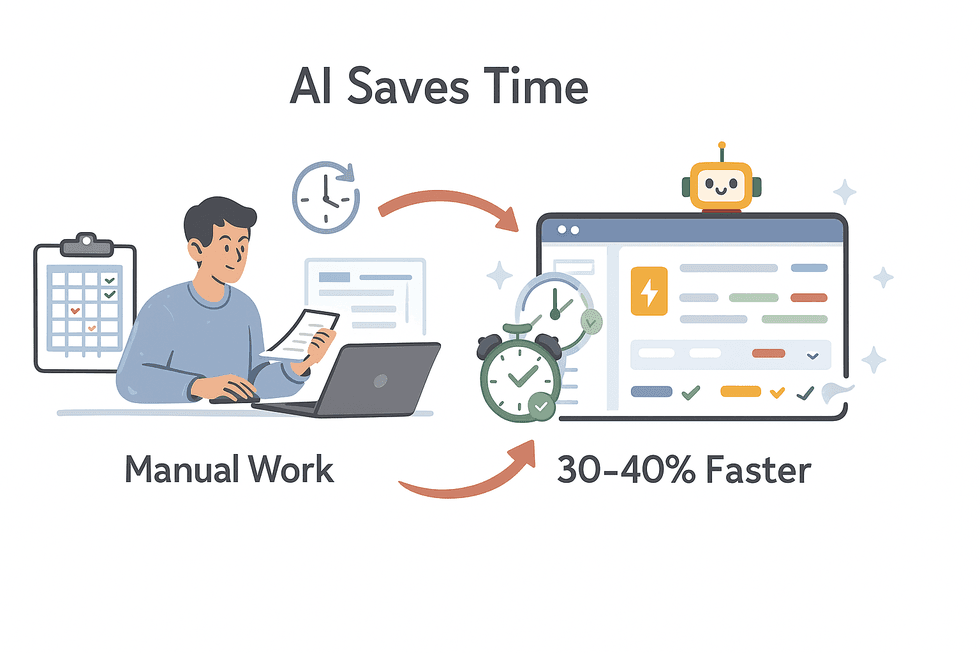 Я видел, как команды экономили 30–40% времени на извлечении данных просто за счёт перехода на AI-инструменты (scrapingapi.ai). Это не просто рост продуктивности — это конкурентное преимущество.
Извлекайте данные с любого сайта с помощью AI Агентный веб-скрейпер Thunderbit сам читает любой сайт и по одному клику выбирает поля для извлечения. Get Started Free
Thunderbit создан для того, чтобы сделать извлечение данных простым, точным и доступным — даже для тех, кто ни разу не писал код. (Да, моя мама тоже может им пользоваться. Правда, с Netflix у неё пока идёт борьба.)
Thunderbit Agentic Web Scraper: ключевые возможности для бизнеса
Позвольте немного похвастаться тем, что мы создали в Thunderbit — ну а как иначе? Thunderbit рассчитан на бизнес-пользователей: продажи, операционные процессы, маркетинг, недвижимость — всем, кому нужен результат без лишней головной боли. Вот что делает его особенным:
- One Click Extract: Один клик — и AI Thunderbit анализирует страницу, предлагает колонки и настраивает скрейпер за вас. Никакой возни с селекторами.
- 2-Click Scraping: Когда поля готовы, просто нажмите «Scrape» и получите чистую таблицу — без кода и без подготовки.
- Сбор данных с подстраниц: Нужны дополнительные детали? Thunderbit может автоматически переходить на каждую подстраницу (например, карточку товара или профиль) и дополнять таблицу новой информацией.
- Готовые шаблоны: Для популярных сайтов (Amazon, Zillow, Instagram, Shopify и т. д.) достаточно выбрать шаблон и начать работу — настройка не нужна.
- Экспорт куда угодно: Бесплатный экспорт в Excel, Google Sheets, Airtable, Notion или CSV. Без скрытых платежей.
- Плановый сбор: Автоматизируйте повторяющиеся задачи — просто укажите интервал («каждый понедельник в 8:00»), и Thunderbit сделает остальное.
- Сбор в облаке или в браузере: Используйте облачные серверы Thunderbit для скорости или свой браузер для сайтов, где нужна авторизация.
- Многоязычная поддержка: Сбор данных доступен на 34 языках, включая английский, испанский, китайский и другие.
Попробуйте Thunderbit Agentic Web Scraper бесплатно Бесплатный тариф покрывает 6 страниц в месяц, кредитная карта не нужна — отличный способ протестировать сбор данных на нужном сайте. Get Started Free
Автоматизация и масштабирование: как использовать расписание и интеграции для извлечения данных
Ручной scraping — это уже прошлое. Настоящая ценность появляется тогда, когда вы встраиваете извлечение данных в свои рабочие процессы и автоматизируете его:
- Сбор по расписанию: Настройте Thunderbit так, чтобы он запускал сбор ежедневно, еженедельно или по любому нужному вам графику. Это идеально для мониторинга цен, лидогенерации или агрегации новостей.
- Прямая интеграция: Выгружайте собранные данные прямо в Google Sheets, Excel, Airtable или Notion. Больше не нужно скачивать и загружать файлы вручную.
- Интеграция с CRM и аналитикой: Передавайте данные в CRM или BI-инструменты для дашбордов в реальном времени, уведомлений и автоматических касаний.
Пример: автоматизированный процесс мониторинга цен
- Настройте Thunderbit на странице товара конкурента.
- Используйте «One Click Extract», чтобы собрать название товара, цену и URL.
- Запланируйте запуск каждый день в 7:00 утра.
- Экспортируйте результаты в Google Sheets, связанный с дашбордом.
- Менеджер по ценообразованию изучает изменения и корректирует стратегию до того, как конкуренты проснутся.
С автоматизацией вы не просто работаете быстрее — вы всегда опираетесь на свежие данные.
Лучшие практики работы с неструктурированными данными при извлечении с сайтов
Признаем честно: большая часть веб-данных далека от аккуратности. Они неструктурированы, непоследовательны и иногда просто странные. Вот как привести их в порядок:
- Пусть AI задаёт структуру: Используйте One Click Extract или шаблон, чтобы навести порядок — AI сам определит колонки и типы данных, а при необходимости вы потом всё подправите.
- AI-подсказки для полей: В Thunderbit можно задавать отдельные инструкции для каждого поля. Хотите классифицировать товары, форматировать телефоны или переводить описания? Просто скажите AI, что нужно.
- Используйте NLP: Для отзывов, комментариев или статей применяйте встроенные NLP-функции, чтобы делать краткие сводки, анализировать тональность или извлекать ключевые слова.
- Нормализуйте данные: Приводите форматы в порядок — даты, цены, телефоны — прямо в процессе сбора, а не после. Последовательность здесь критична.
- Удаляйте дубликаты и проверяйте результат: Убирайте повторы и выборочно проверяйте точность. Если что-то выглядит странно, скорректируйте подсказки или настройки.
AI-подсказки для полей: как настраивать извлечение данных для лучших результатов
Это одна из моих любимых функций. С AI-подсказками на уровне поля вы можете:
- Маркировать и классифицировать: «Отнеси этот товар к категории Electronics, Furniture или Clothing на основе описания.»
- Соблюдать формат: «Выведи дату в формате YYYY-MM-DD.» «Извлеки только числовую цену.»
- Переводить на лету: «Переведи описание товара на английский.»
- Убирать шум: «Извлеки биографию пользователя, игнорируя ссылки “Read more” и рекламу.»
- Объединять поля: «Собери строки адреса в одно поле.»
Это как иметь встроенного младшего аналитика прямо в вашем скрейпере — только он никогда не жалуется на перерывы на кофе.
Как обеспечить качество и единообразие данных при извлечении с сайтов
Хороший сбор данных не заканчивается нажатием кнопки «Export». Вот как сохранить данные чистыми и надёжными:
- Проверки валидации: Используйте проверки диапазонов, обязательные поля и уникальные ключи, чтобы ловить ошибки.
- Выборочный аудит: Вручную сравнивайте образцы собранных данных с исходным сайтом — особенно после настройки или если сайт изменился.
- Обработка ошибок: Логируйте неудачные попытки сбора и настраивайте оповещения о аномалиях, например резком падении числа строк.
- Постоянная очистка: Используйте таблицы или скрипты, чтобы убирать пробелы, исправлять кодировку и нормализовать текст.
- Единая схема: Сохраняйте названия полей и форматы стабильными со временем. Фиксируйте изменения, чтобы команда не гадала, что произошло.
Доверие к данным — это всё. Немного внимания на старте экономит массу проблем потом.
Посмотрите, чем Thunderbit отличается от других Узнайте, где одно кликабельное AI-извлечение Thunderbit занимает место среди других инструментов для веб-скрейпинга на рынке. Get Started Free
Сравнение инструментов для извлечения данных: на что смотреть при выборе решения
Не все инструменты для веб-скрейпинга одинаковы. Вот что важно учитывать:
| Инструмент | Сильные стороны | На что обратить внимание |
|---|---|---|
| Thunderbit | Самый простой вариант для нетехнических пользователей; AI-определение полей; сбор с подстраниц; готовые шаблоны; бесплатный экспорт; доступные тарифы (Thunderbit Blog). | Не рассчитан на сверхкрупные проекты с сильной разработческой нагрузкой; использует кредитную систему. |
| Browse AI | No-code, удобно для отслеживания изменений; интеграция с Google Sheets; массовый сбор. | Более дорогие стартовые тарифы; настройка может занять время. |
| Octoparse | Мощный инструмент, хорошо работает с динамическими сайтами; продвинутые функции для технических пользователей. | Довольно высокий порог входа; выше цена. |
| Web Scraper (webscraper.io) | Бесплатен для небольших проектов; визуальная настройка; сильное сообщество. | Ручная настройка может запутать; ограниченная AI-поддержка. |
| Diffbot | AI-инструмент, который через API разбирает неструктурированные страницы; отлично подходит разработчикам. | Дорогой, работает через API, не для нетехнических пользователей. |
Мой совет: если вы бизнес-пользователь и хотите быстрый и точный результат, Thunderbit — отличный выбор. Для продвинутых пользователей и разработчиков Octoparse или Diffbot могут оправдать дополнительную сложность. В любом случае попробуйте бесплатный тариф или пробный период, прежде чем принимать решение.
Заключение: как применять лучшие практики извлечения данных с сайтов на практике
Извлечение данных с сайтов уже давно не «приятное дополнение» — это необходимость для любого бизнеса, который хочет оставаться конкурентоспособным. Вот что я надеюсь, вы унесёте с собой из этой статьи:
- Ценность: Веб-данные помогают принимать более умные и быстрые решения. Не оставляйте это преимущество без использования.
- Преодолевайте сложности: Используйте AI-инструменты, чтобы справляться с неструктурированными данными, объёмом и изменениями сайтов.
- Соблюдайте закон: Уважайте законы о конфиденциальности, правила сайтов и требования к безопасности данных.
- Автоматизируйте: Планируйте и встраивайте извлечение данных в ежедневные процессы.
- Качество прежде всего: Проверяйте, очищайте и контролируйте данные, чтобы им можно было доверять.
Готовы увидеть, насколько это просто? Скачайте расширение Thunderbit для Chrome и протестируйте его на следующем проекте по работе с данными. А если хотите углубиться ещё больше, загляните в Thunderbit Blog за новыми гайдами, советами и примерами из практики.
Удачного сбора данных — и пусть ваши данные всегда будут структурированными, законными и готовыми к работе.
Начните извлекать данные с Thunderbit Установите бесплатное расширение Thunderbit для Chrome и начните извлекать структурированные данные с любой страницы в один клик. Get Started Free
FAQ
1. Законно ли извлекать данные с любого сайта?
В большинстве юрисдикций сбор общедоступных данных обычно законен, но нельзя обходить логин или механизмы защиты. Всегда изучайте условия использования сайта и соблюдайте законы о конфиденциальности, такие как GDPR и CCPA (xbyte.io).
2. Как AI улучшает процесс извлечения данных с сайтов?
AI-инструменты вроде Thunderbit умеют автоматически находить поля, адаптироваться к изменениям верстки, очищать и форматировать данные, а также работать с динамическим контентом и переводом — и всё это при минимальной настройке и высокой точности (scrapingapi.ai).
3. Какие лучшие практики для работы с неструктурированными данными?
Сразу определяйте структуру данных, используйте AI-подсказки для отдельных полей, приводите форматы к единому виду прямо во время сбора и проверяйте результаты. Инструменты вроде Thunderbit помогают легко классифицировать, форматировать и маркировать данные на лету.
4. Как автоматизировать и масштабировать извлечение данных с сайта?
Используйте планирование, чтобы запускать сбор через нужные интервалы, и подключайте результаты напрямую к таким инструментам, как Google Sheets, Airtable или ваша CRM. Автоматизация помогает держать данные свежими и снижает ручную нагрузку.
5. Как обеспечить качество и согласованность извлечённых данных?
Внедрите проверки валидации, регулярно проводите аудит выборок, корректно обрабатывайте ошибки и сохраняйте единообразие схемы со временем. Постоянный контроль и улучшение — ключ к надёжным данным.
Хотите увидеть эти лучшие практики в деле? Попробуйте бесплатный тариф Thunderbit и убедитесь, насколько простым, законным и масштабируемым может быть сбор веб-данных.
Попробуйте Agentic Web Scraper Get Started Free
Узнайте больше




