
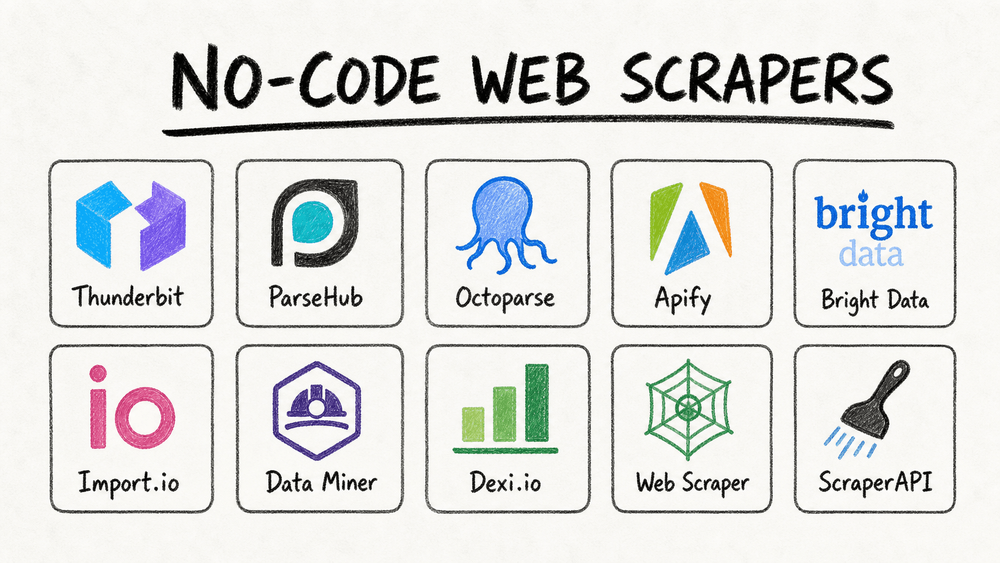
Jeśli kiedykolwiek utknąłeś w tym bez końca kopiowaniu i wklejaniu — na przykład próbując uzupełnić arkusz cenami produktów albo zbudować listę leadów, zanim wystygnie kawa — wiedz, że nie jesteś sam. Ponad 40% pracowników poświęca co najmniej jedną czwartą tygodnia na powtarzalne zadania związane z danymi. To setki godzin miesięcznie na zespół, tracone na cyfrową, żmudną robotę. Dobra wiadomość? No-code web scrapers odwracają ten trend i pozwalają każdemu — tak, nawet osobom „niekodującym” — automatyzować zbieranie danych z internetu w kilka minut.
Jako ktoś, kto od lat tworzy rozwiązania SaaS i narzędzia automatyzujące pracę, widzę z pierwszej ręki, jak takie platformy pomagają zespołom sprzedaży, marketingu i operacji ominąć zgłoszenia do IT i szybko dostać potrzebne dane. Rynek web scrapingu stale rośnie, a narzędzia no-code są na czele tego ruchu. Niezależnie od tego, czy jesteś solowym founderem, marketerem potrzebującym danych, czy po prostu masz dość bólu nadgarstka od Excela, ta lista pomoże Ci znaleźć odpowiedni no-code web scraper do Twojego workflow.
Dlaczego no-code web scraper to dziś narzędzie must-have dla nowoczesnych zespołów
Zbieraj dane z dowolnej strony z pomocą AI Get Started Free
Bądźmy szczerzy: ręczne zbieranie danych zabija produktywność. Przeciętny pracownik biurowy wykonuje ponad 1000 operacji kopiuj-wklej tygodniowo, a w zespole 10-osobowym daje to ponad 400 godzin miesięcznie, których już nie odzyskasz. No-code web scrapers zmieniają zasady gry, ponieważ:
- Oszczędzają czas: Automatyzują godziny ręcznej pracy — to, co kiedyś zajmowało dni, teraz trwa minuty.
- Ograniczają wąskie gardła w IT: Koniec z czekaniem na developerów, aż napiszą własne skrypty.
- Zwiększają elastyczność: Sprzedaż może pobierać świeże leady, marketing monitorować konkurencję, a operacje śledzić dane produktowe — bez barier technicznych.
- Poprawiają dokładność: Automatyzacja oznacza mniej błędów kopiowania i większą spójność danych.
Efekt w praktyce? Badania Slacka pokazują, że właściciele małych firm tracą około 96 minut produktywności dziennie przez zmarnowany czas — to mniej więcej trzy tygodnie rocznie — a technologia pomaga im odzyskać część tej straty.
Jak wybraliśmy najlepsze no-code web scrapery
Przy tak dużym wyborze znalezienie właściwego narzędzia może przypominać wybór nowej platformy streamingowej — każdy obiecuje „łatwość” i „moc”, ale nie każdy dowozi. Oto kryteria, które zastosowałem, wybierając top 10:
- Łatwość obsługi: Czy osoba nietechniczna może zacząć szybko? Duży plus dawały intuicyjny interfejs, selektory point-and-click oraz wsparcie AI.
- Automatyzacja i inteligencja: Funkcje takie jak automatyczne wykrywanie pól, przechodzenie do podstron, harmonogramy i uruchamianie w chmurze.
- Skalowalność: Czy narzędzie poradzi sobie zarówno z małymi, jednorazowymi zadaniami, jak i dużymi, cyklicznymi projektami?
- Eksport i integracje danych: Obsługa eksportu do Excela, Google Sheets, JSON albo bezpośredniej integracji z API.
- Wsparcie i społeczność: Szablony, dokumentacja i szybka pomoc, gdy pojawi się problem.
- Cena i dostępność: Darmowe plany do testów, przejrzyste ceny i opcje dla osób indywidualnych oraz zespołów.
Przejdźmy więc do dziesięciu najlepszych no-code web scraperów na 2026 rok — każdy ma własne mocne strony, ograniczenia i idealne zastosowania.
1. Thunderbit
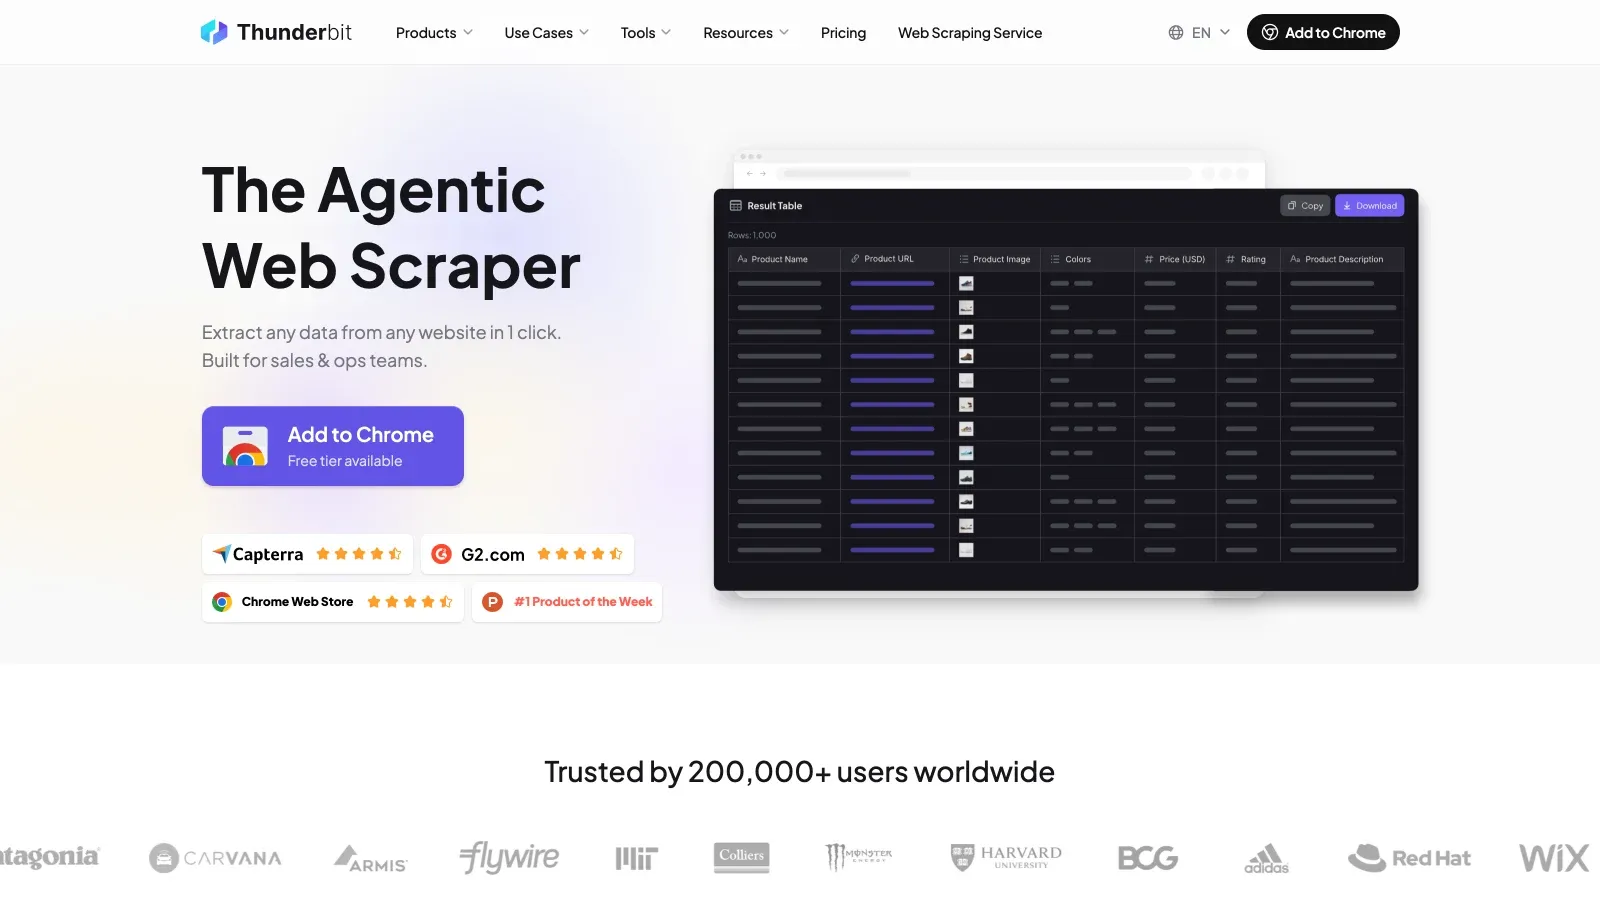 Thunderbit to moja podstawowa rekomendacja dla każdego, kto chce przejść od „potrzebuję tych danych” do „oto mój arkusz” w dwa kliknięcia. Jako współzałożyciel jestem trochę stronniczy — ale naszą misją od zawsze było sprawienie, by web scraping był tak prosty jak zamawianie jedzenia na wynos.
Co wyróżnia Thunderbit?
- Prostota napędzana AI: Wystarczy kliknąć „AI Suggest Fields”, a AI Thunderbit przeanalizuje stronę, zasugeruje, co pobrać (np. nazwy, ceny, e-maile) i zbuduje scraper za Ciebie. Bez kodowania, bez grzebania w selektorach.
- Scraping w 2 kliknięciach: Akceptujesz sugestie AI, klikasz „Scrape” i gotowe. To najszybszy sposób, jaki znam, by przejść ze strony WWW do uporządkowanych danych.
- Automatyzacja podstron i paginacji: Potrzebujesz więcej szczegółów? Thunderbit może automatycznie odwiedzać każdą podstronę (np. kartę produktu lub profil) i wzbogacać tabelę — idealne do leadów sprzedażowych albo specyfikacji produktów.
- Scraping w chmurze i w przeglądarce: Uruchamiaj zadania w przeglądarce (świetne dla stron wymagających logowania) albo w chmurze (do 50 stron naraz, bardzo szybko).
- Darmowy eksport danych: Eksport do Excel, Google Sheets, Airtable, Notion albo pobranie jako CSV/JSON — bez paywalla za własne dane.
- AI Autofill: Automatyczne wypełnianie formularzy webowych z pomocą AI, całkowicie za darmo.
- Harmonogram: Ustaw cykliczne scrapowanie prostym językiem („każdy poniedziałek o 9:00”) i pozwól agentowi działać samodzielnie.
Thunderbit cieszy się zaufaniem ponad 200 000 użytkowników na całym świecie, od zespołów sprzedaży po agentów nieruchomości i niezależne sklepy e-commerce. Darmowy plan pozwala pobrać 6 stron miesięcznie na próbę, a płatne plany zaczynają się od 15 USD miesięcznie (model oparty na kredytach, więc płacisz tylko za to, czego używasz).
Jeśli chcesz zobaczyć, jak proste może być web scraping, pobierz rozszerzenie do Chrome i przetestuj je samodzielnie.
Wypróbuj Thunderbit AI Web Scraper za darmo
2. Parsehub
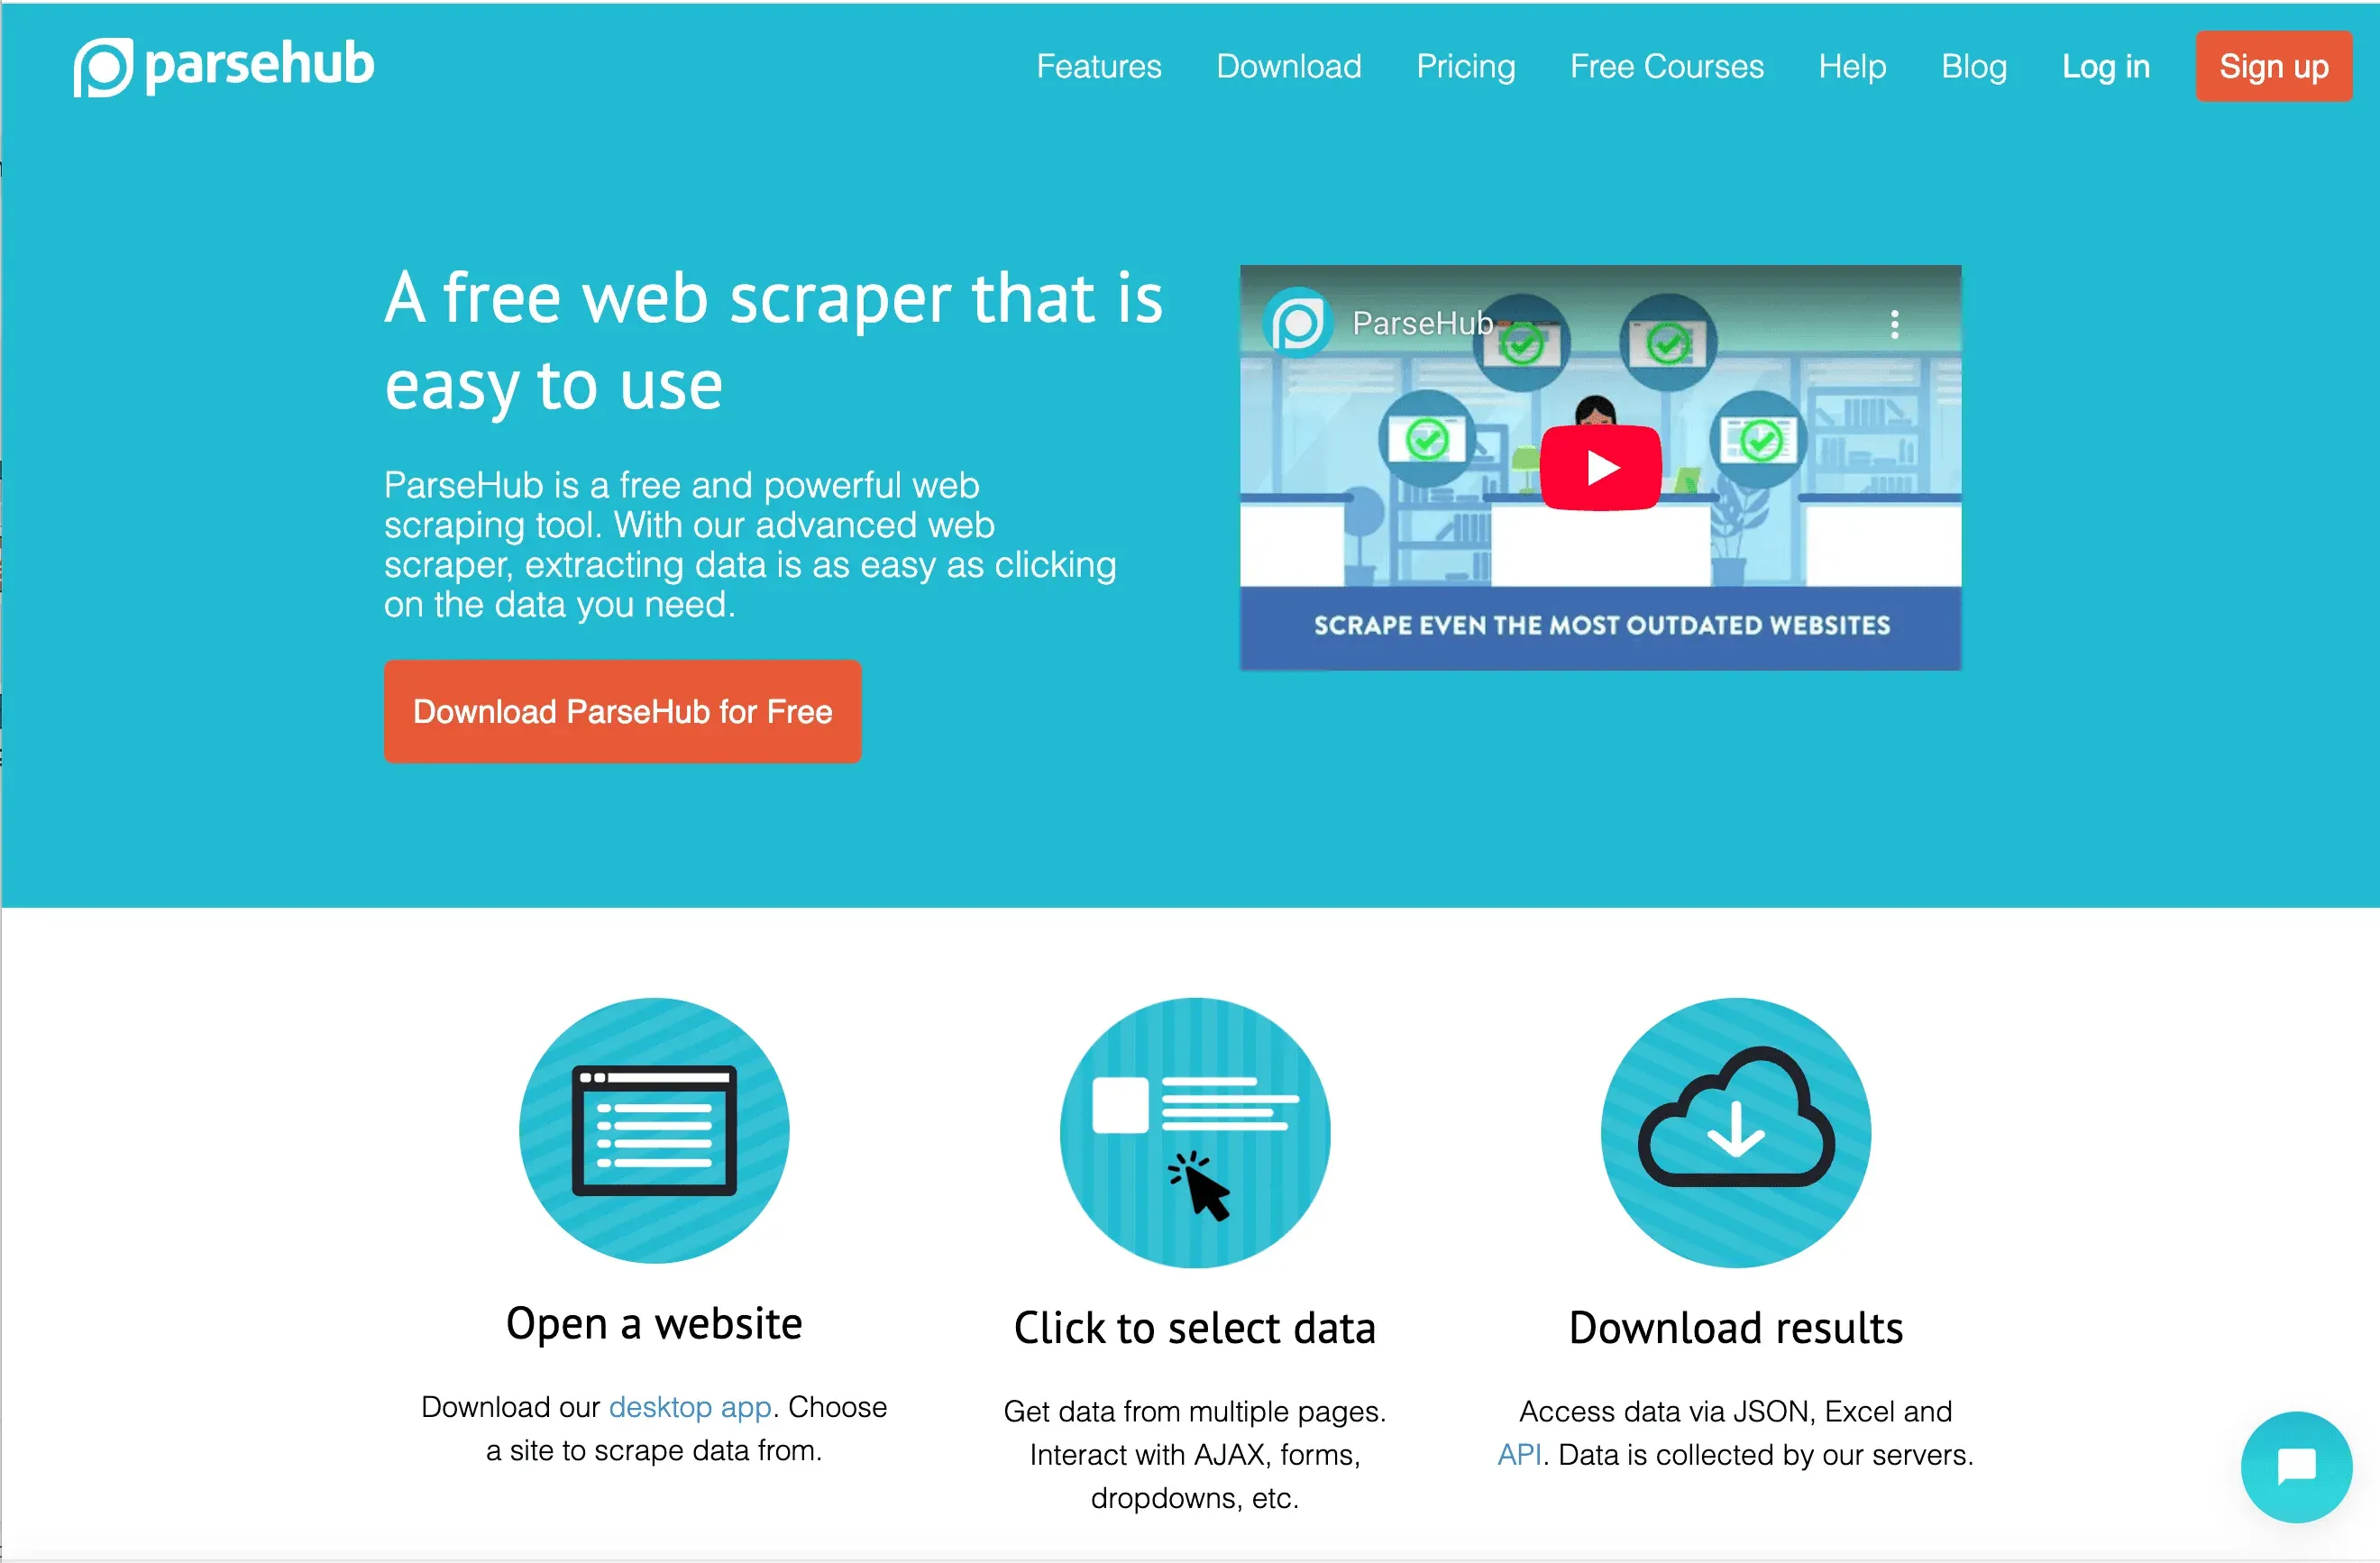 Parsehub to weteran świata no-code scrapingu, znany z wizualnego kreatora workflow i umiejętności radzenia sobie z rozbudowanymi, dynamicznymi stronami.
- Wizualny workflow: Budujesz scraper, klikając w działający widok przeglądarki — Parsehub zapisuje Twoje działania i zamienia je w krok po kroku ułożony „przepis”.
- Obsługa dynamicznych treści: Świetny do stron z JavaScriptem, wyskakującymi okienkami lub trudną nawigacją (np. e-commerce, portale pracy czy nieruchomości).
- Logika warunkowa i pętle: Możesz tworzyć wieloetapowe procesy, obsługiwać logowanie i pobierać listy stronicowane albo zagnieżdżone szczegóły.
- Uruchamianie w chmurze i harmonogram: Zadania działają na serwerach Parsehub i mogą być uruchamiane cyklicznie (w planach płatnych).
- Integracja z API: Pobieraj dane programowo do bardziej zaawansowanych workflow.
Parsehub to dobry wybór dla analityków i badaczy, którzy chcą mieć dużą kontrolę bez pisania kodu. Darmowy plan obejmuje małe zadania (do 200 stron na uruchomienie), a płatne plany zaczynają się od 189 USD miesięcznie, oferując wyższe limity i harmonogramy. Przy bardziej złożonych projektach trzeba liczyć się z pewną krzywą uczenia, ale to prawdziwa maszyna do trudnych zadań scrapingowych.
3. Octoparse
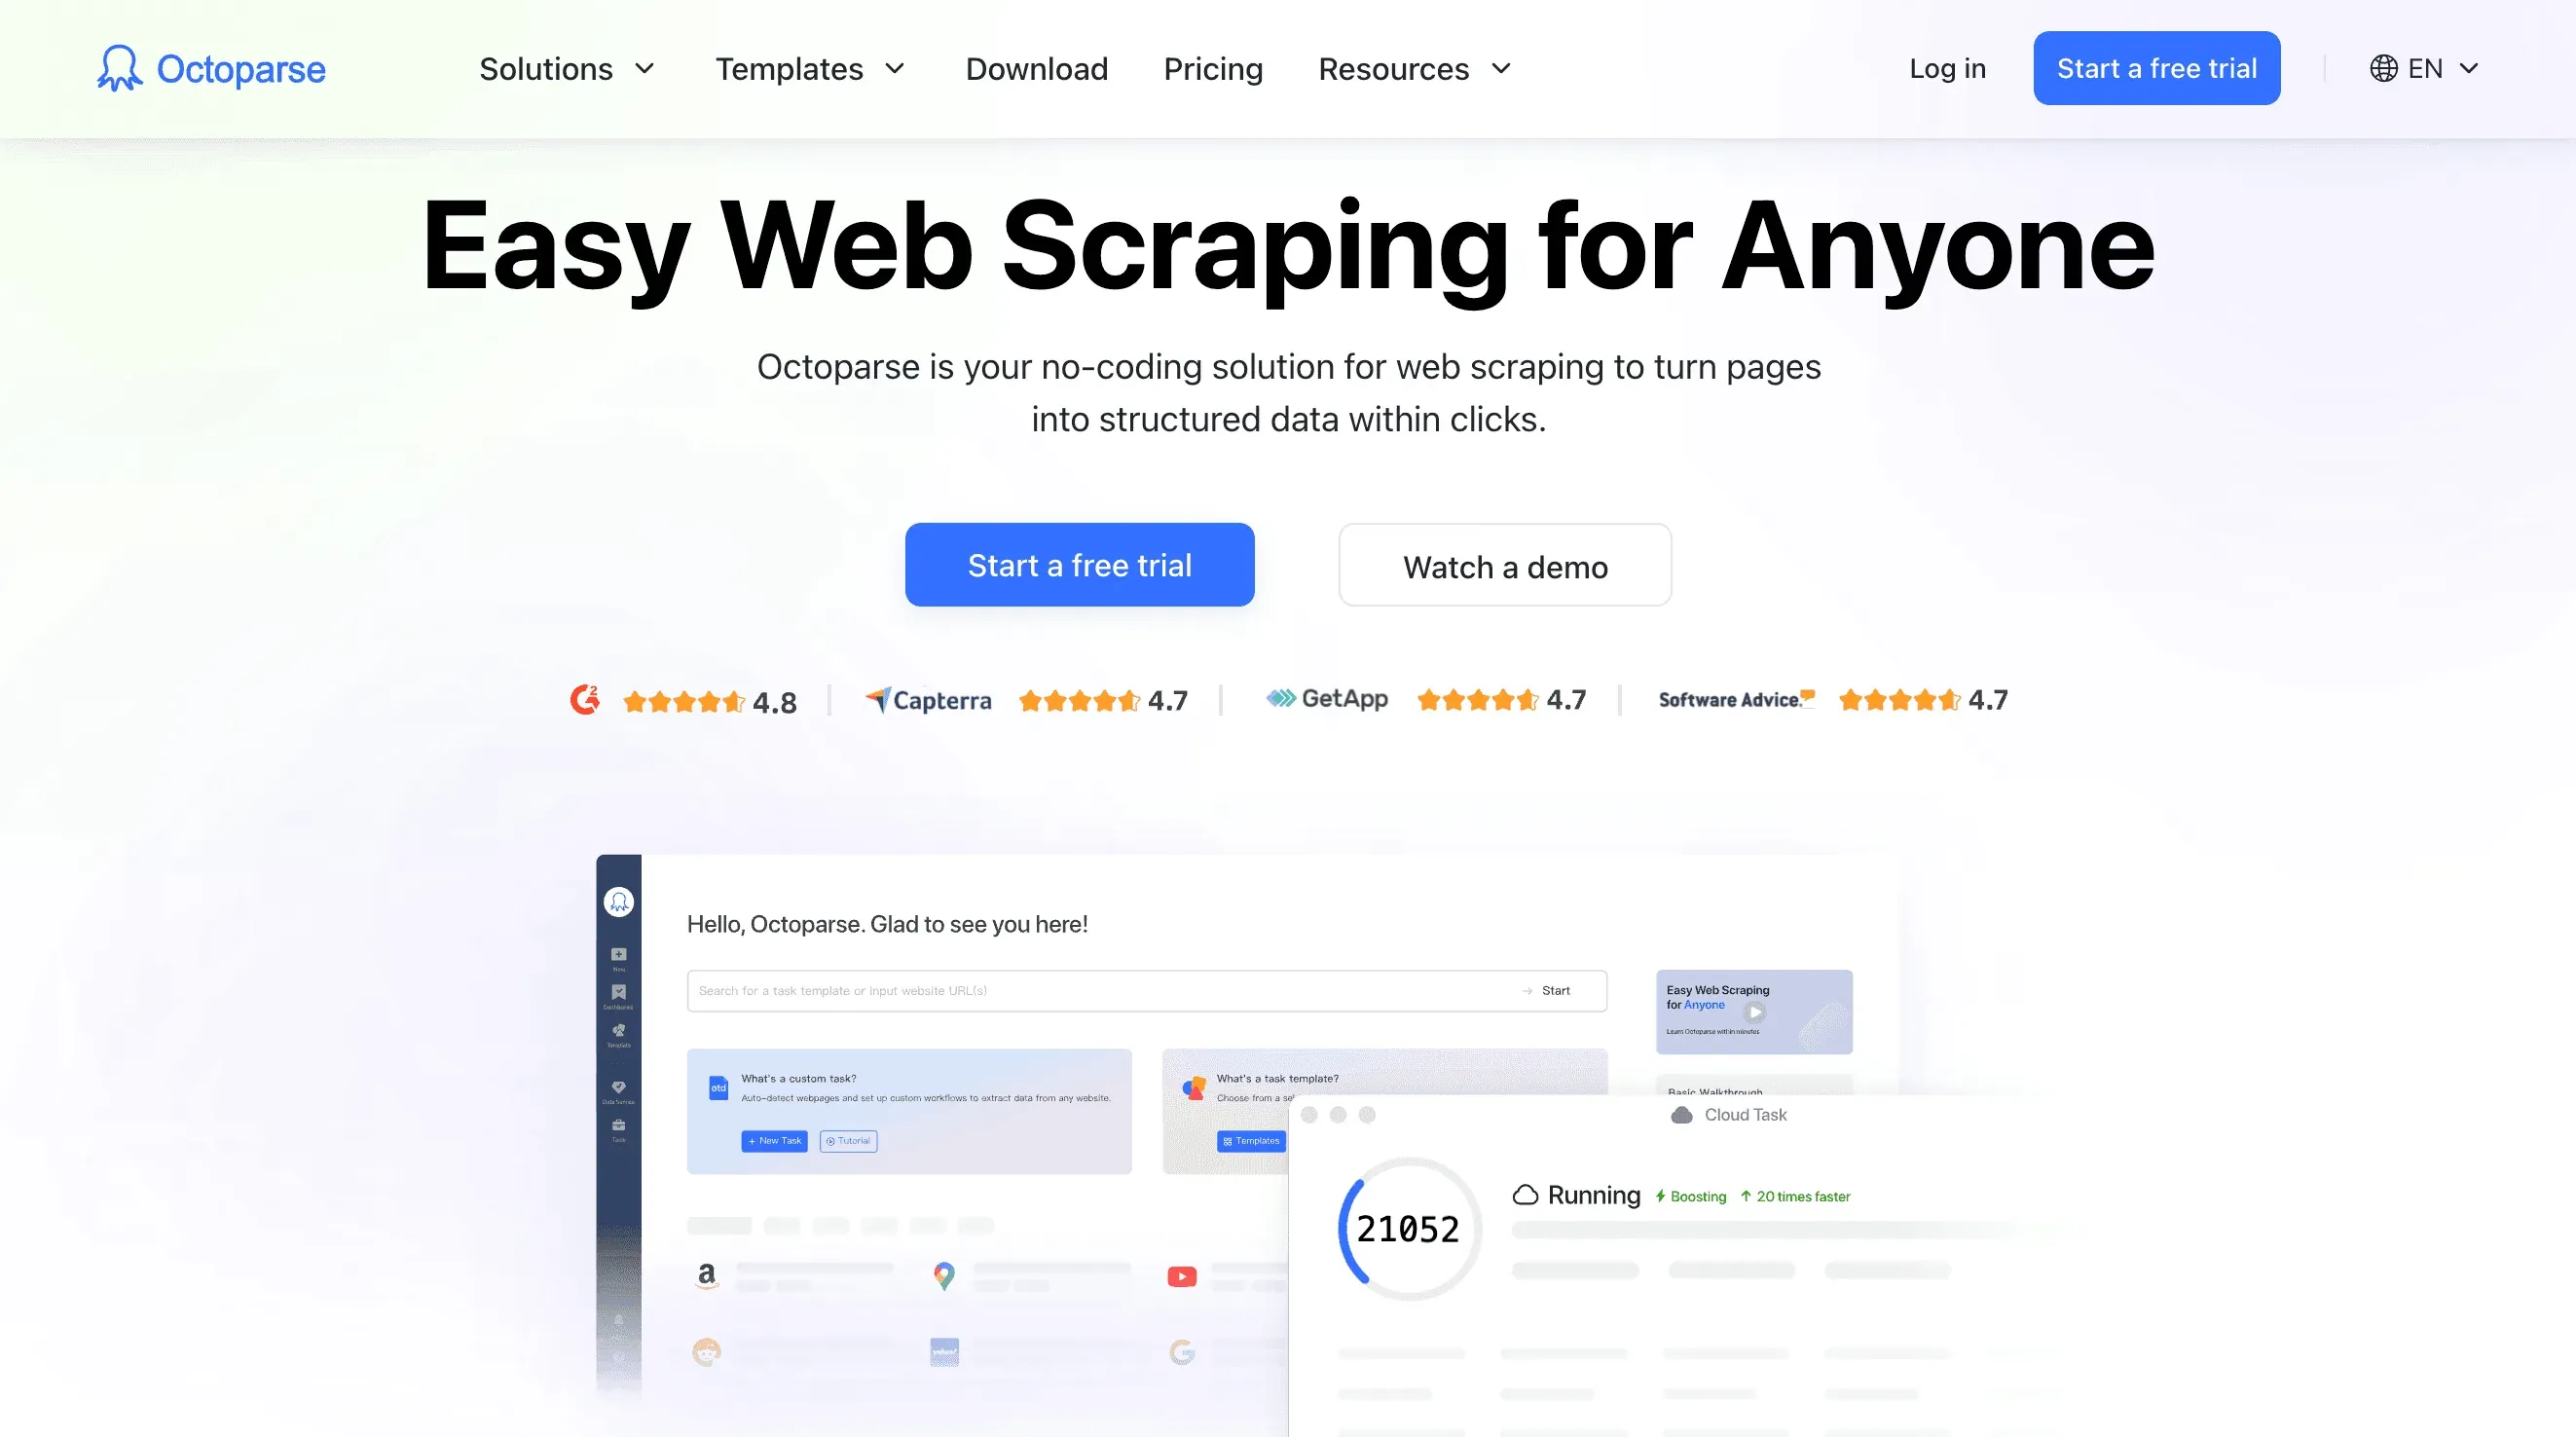 Octoparse stawia na obietnicę „pozyskania danych z internetu w 10 minut” — i dzięki interfejsowi drag-and-drop oraz ogromnej bibliotece szablonów faktycznie to dowozi.
- Prostota point-and-click: Klikasz elementy na stronie, a Octoparse automatycznie wykrywa listy, tabele i przyciski następnej strony.
- Ponad 100 gotowych szablonów: Przygotowane scrapery dla Amazon, LinkedIn, Twittera, Zillow i wielu innych — wystarczy wpisać URL i uruchomić.
- Scraping w chmurze i harmonogram: Uruchamiaj wiele zadań równolegle, planuj powtarzalne procesy i pozwól Octoparse obsługiwać rotację IP oraz zabezpieczenia antyblokujące.
- Czyszczenie danych i eksport: Porządkuj dane za pomocą wbudowanych filtrów i eksportuj je do CSV, Excel, JSON lub przez API.
Octoparse jest chętnie wybierany przez marketerów, małe firmy i entuzjastów danych. Darmowy plan jest całkiem hojny do testów, a płatne plany zaczynają się od 69 USD miesięcznie (Standard) i 249 USD miesięcznie (Professional), oferując więcej danych i większą współbieżność. Jeśli zależy Ci na szybkim efekcie i minimalnej konfiguracji, Octoparse to mocny kandydat.
4. Apify
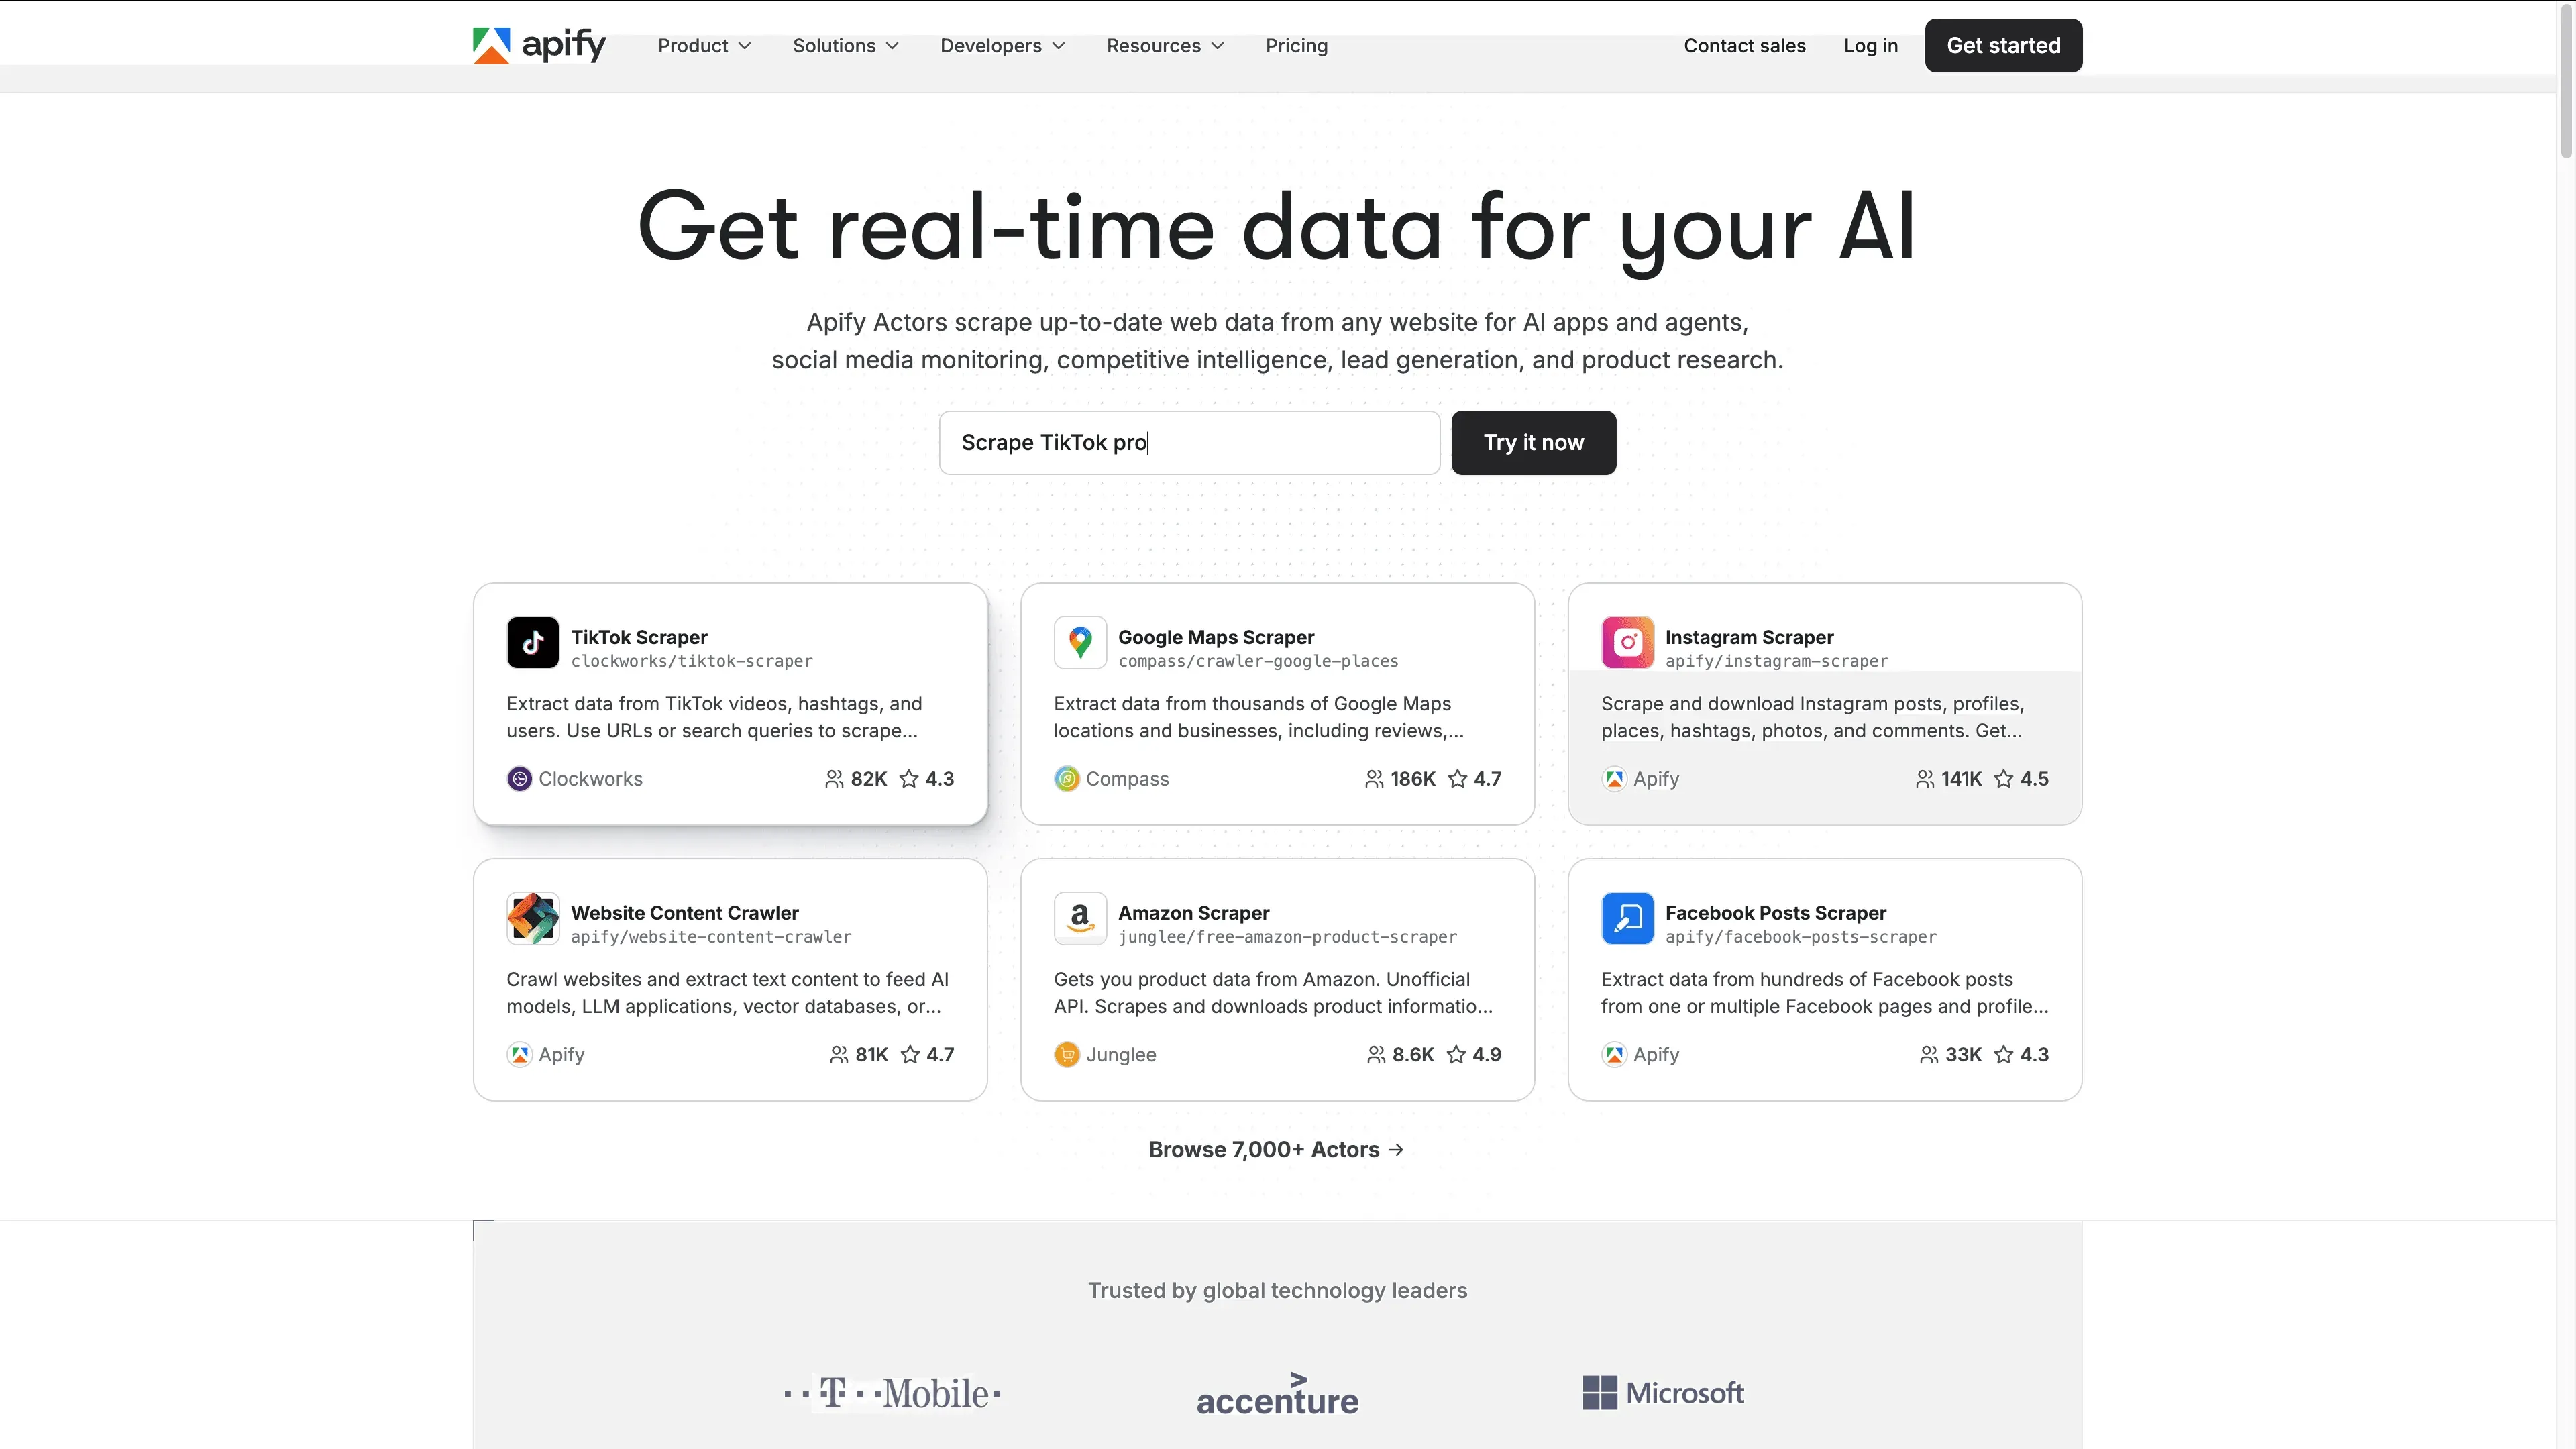 Apify to szwajcarski scyzoryk web scrapingu — oferuje platformę w chmurze z ponad 5000 gotowych „Actorów” (scraperów) oraz elastyczność budowania własnych workflow.
- Marketplace Actorów: Znajdziesz scrapery do Google Maps, Amazon, social mediów i niszowych serwisów — wystarczy podać parametry i uruchomić.
- Niestandardowe workflow: Buduj scrapery wizualnie albo z kodem (dla bardziej zaawansowanych użytkowników) i automatyzuj procesy wieloetapowe.
- Infrastruktura chmurowa: Uruchamiaj zadania na dużą skalę, z wbudowaną rotacją proxy, zabezpieczeniami antyblokującymi i harmonogramami.
- Współpraca zespołowa: Udostępniaj projekty, zarządzaj dostępami i monitoruj uruchomienia dzięki logom oraz dashboardom.
- API i integracje: Eksportuj dane do JSON, CSV albo podłącz je do baz danych, narzędzi BI czy aplikacji przez webhooki.
Apify świetnie sprawdza się w zespołach danych, u developerów i wszędzie tam, gdzie potrzebny jest skalowalny, współdzielony scraping. Dostępny jest darmowy plan (miesięczne kredyty), a płatne plany startują od 29 USD miesięcznie, skalując się wraz z potrzebami enterprise.
5. Bright Data
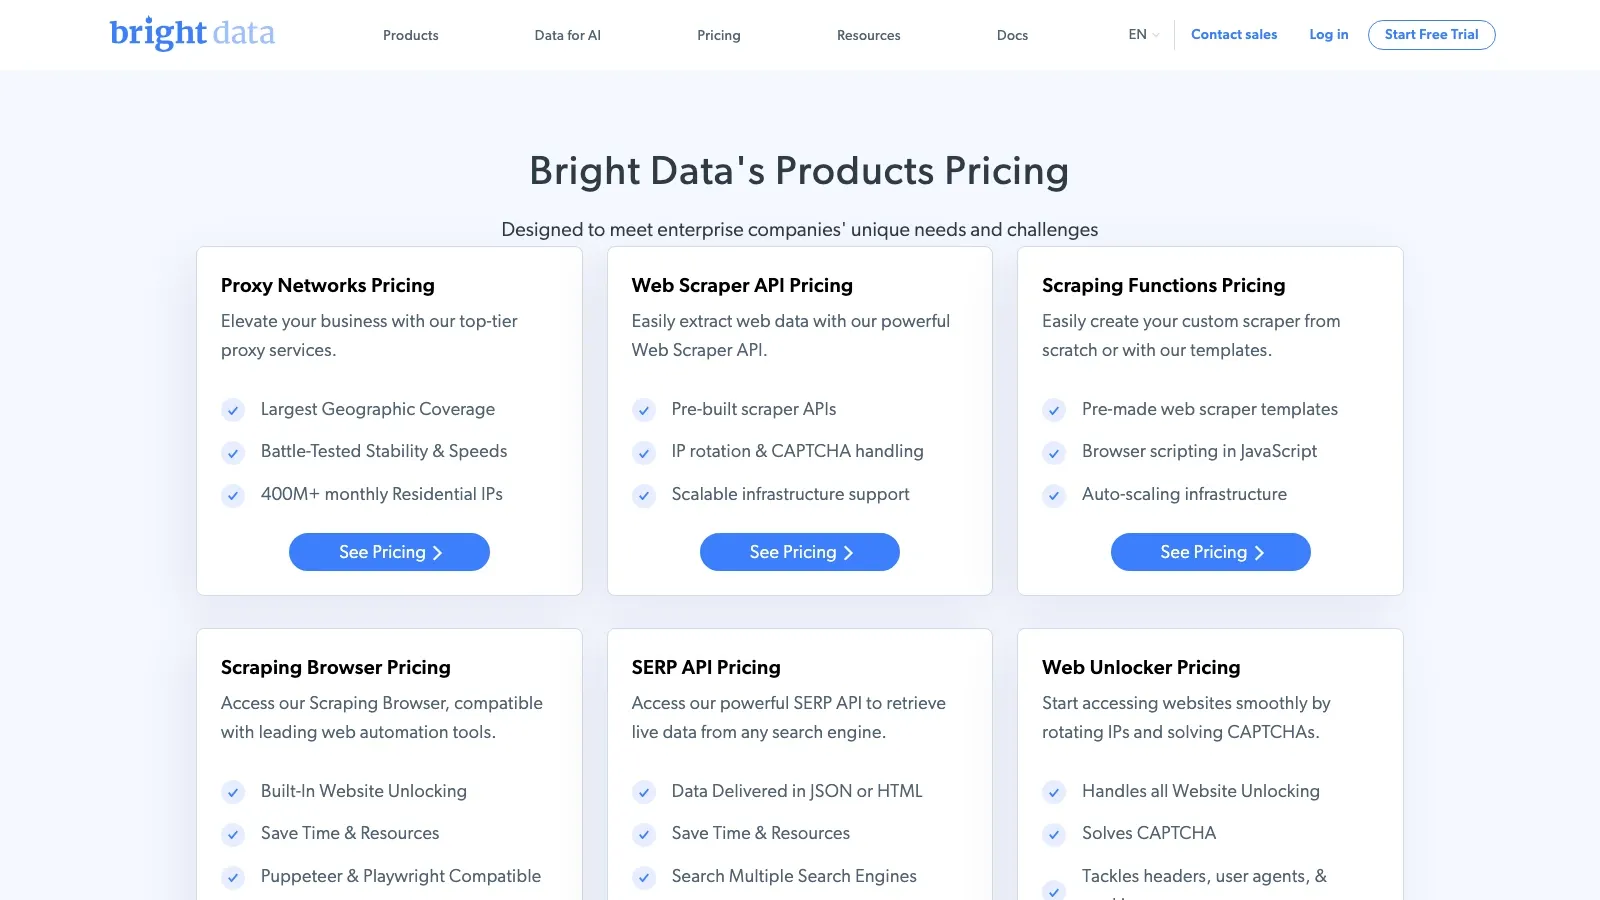 Bright Data jest dla zespołów, które wyrosły już z jednorazowego scrapingu w przeglądarce, ale nadal nie chcą budować całego stosu scrapingowego od zera. Biblioteka Web Scraper API i gotowe szablony pozwalają zacząć od popularnych źródeł bez samodzielnego składania proxy, automatyzacji przeglądarki i infrastruktury ekstrakcji.
- Gotowe scrapery: Zacznij od predefiniowanych scraperów dla popularnych stron i typów danych zamiast pustego workflow.
- No-code jako punkt startu: Skorzystaj z interfejsu no-code Web Scraper API, gdy pełne, własne rozwiązanie byłoby przesadą.
- Zarządzana infrastruktura: Rotacja proxy, obsługa przeglądarki i walka z botami są częścią platformy, a nie kolejnym systemem, który zespół musi utrzymywać.
- Skalowalne dostarczanie danych: Przesyłaj uporządkowane dane webowe do systemów, w których odbywa się dalsza analiza lub automatyzacja.
- Kontrole enterprise: To lepszy wybór, gdy liczą się wolumen, niezawodność i zgodność, a nie tylko szybka konfiguracja.
Bright Data nie jest najlżejszym rozwiązaniem do szybkiego zrzutu do arkusza, ale to praktyczna opcja no-code, gdy workflow wymaga zarządzanej infrastruktury w tle. Ceny zależą od produktu i użycia, a dostępność triala zależy od konkretnego rozwiązania, więc przed decyzją warto sprawdzić aktualne warunki.
6. Import.io
 Import.io to ciężka artyleria dla enterprise’owych, no-code pipeline’ów danych webowych.
- Wizualny ekstraktor point-and-click: „Ucz” scraper na przykładach — kliknij kilka elementów, a Import.io rozpozna wzorzec.
- Strukturalne crawl’e i harmonogramy: Przeszukuj całe serwisy, obsługuj paginację i konfiguruj automatyczne, cykliczne strumienie danych.
- Transformacja i integracja danych: Czyść, normalizuj i eksportuj dane bezpośrednio do narzędzi BI, baz danych lub przez API.
- Zgodność i wsparcie: Ścieżki audytu, dedykowana pomoc i funkcje wspierające zgodność prawną — kluczowe dla dużych organizacji.
Import.io jest projektowane dla firm i dużych zespołów danych o krytycznych potrzebach biznesowych. Ceny startują od 199 USD miesięcznie przy rozliczeniu rocznym albo 249 USD miesięcznie w modelu month-to-month, ale w zamian dostajesz premium support i mocną automatyzację. Dostępny jest darmowy okres próbny.
7. Data Miner
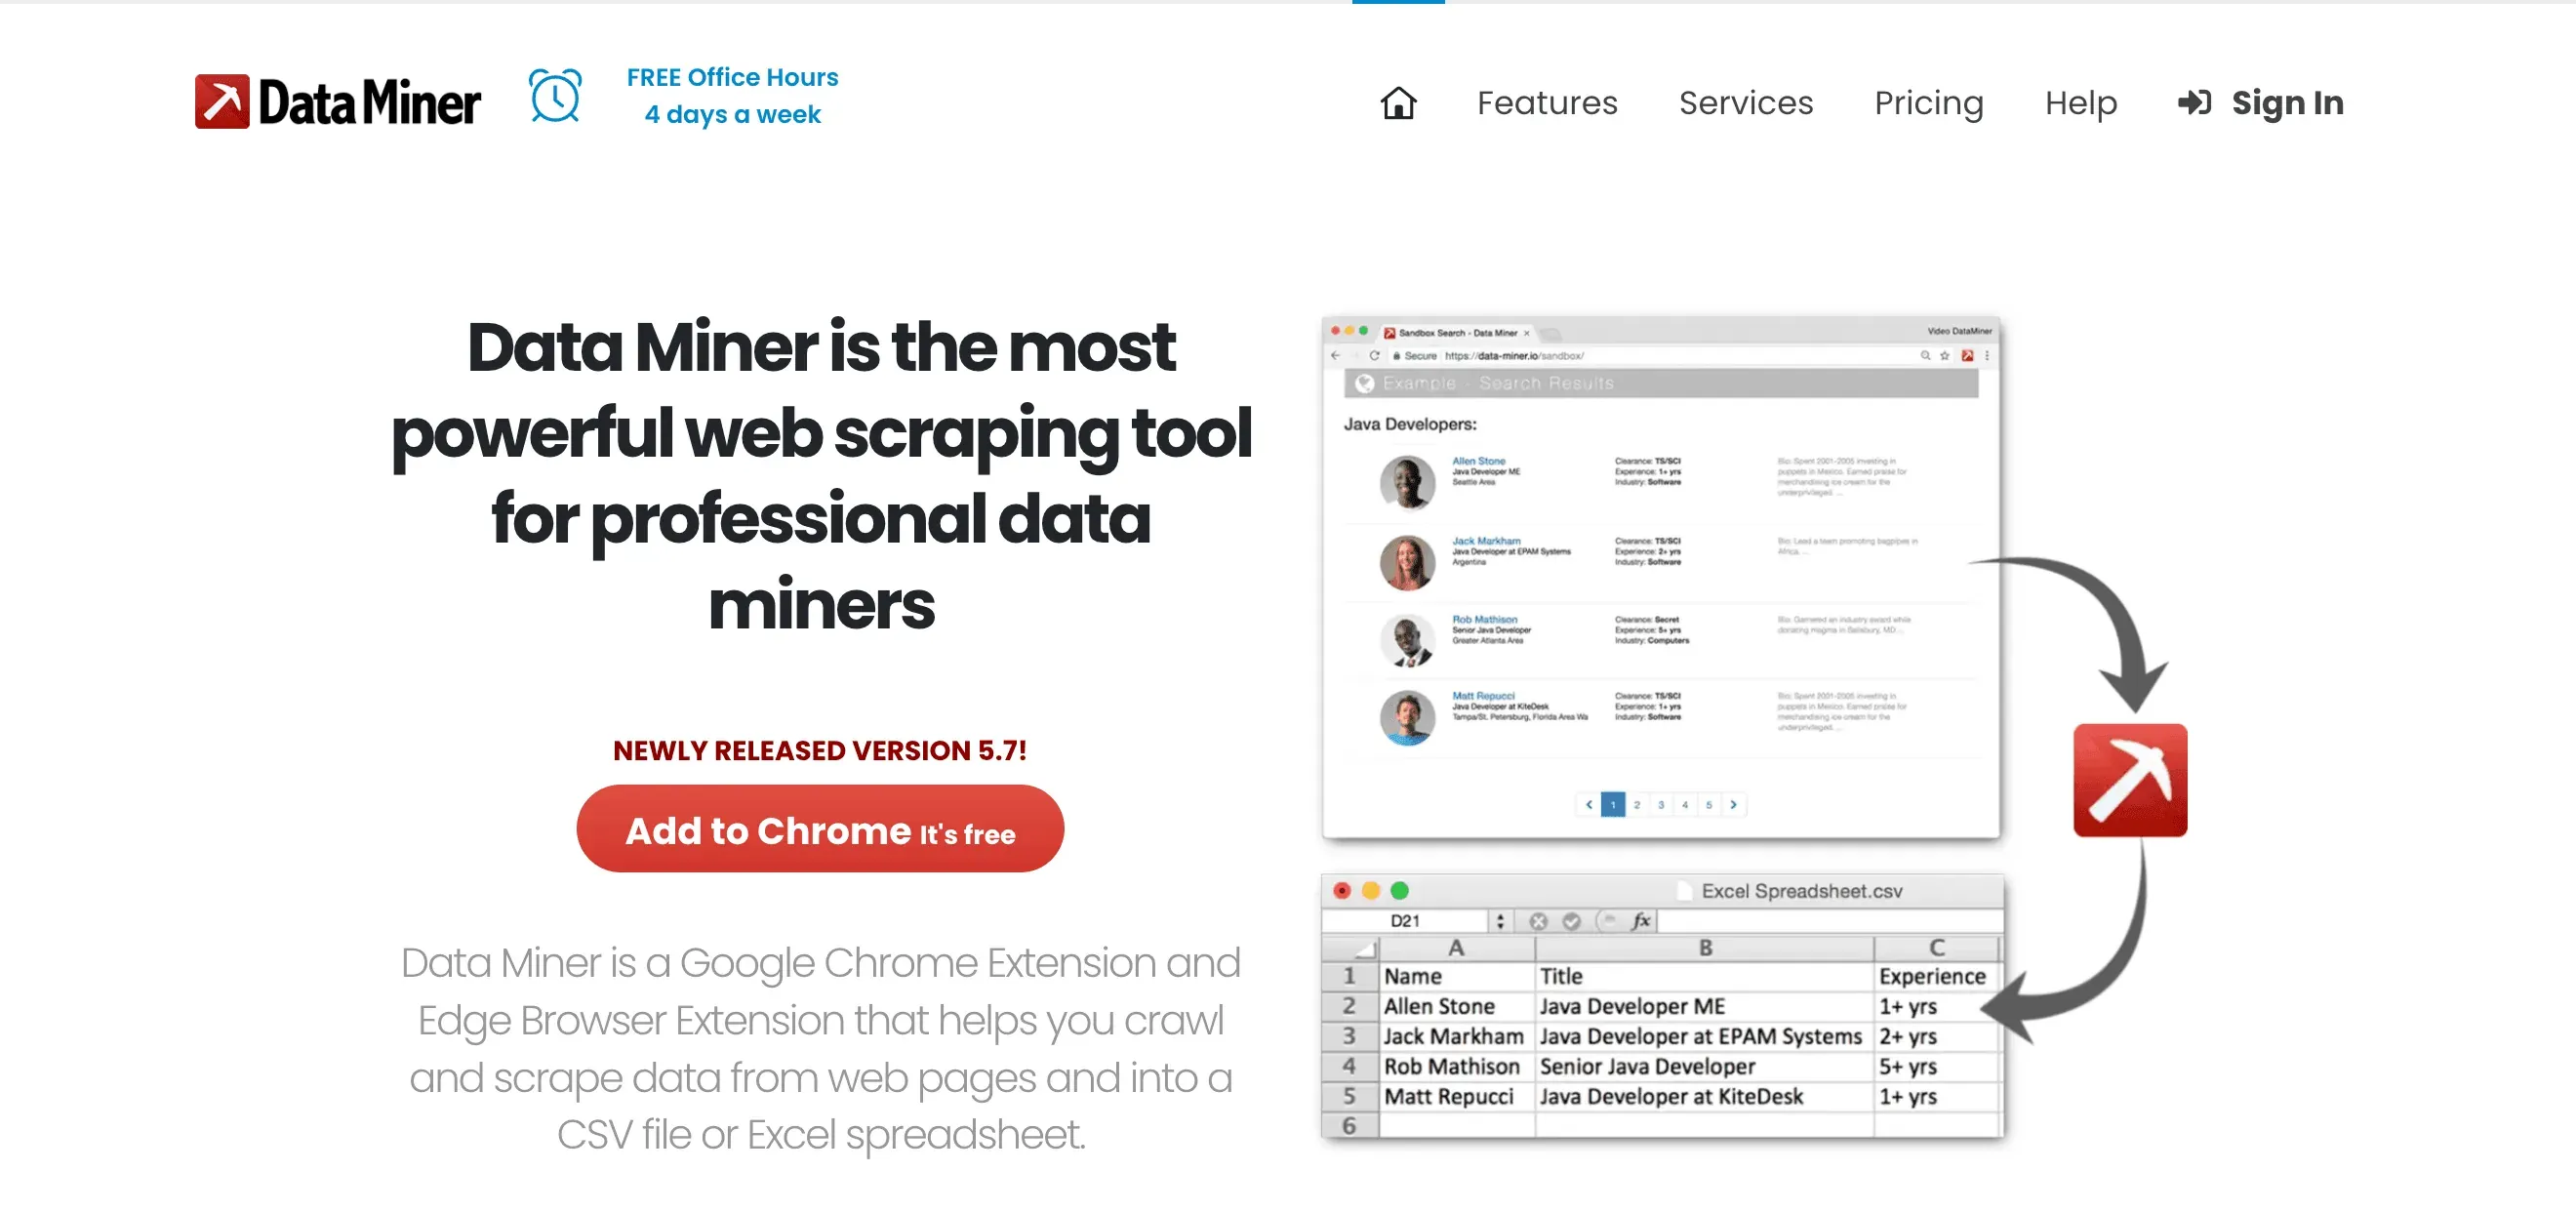 Data Miner to rozszerzenie do przeglądarki (Chrome/Edge), które sprawia, że szybki no-code scraping jest tak prosty jak kliknięcie przycisku.
- Natychmiastowe wykrywanie tabel i list: Automatycznie pobiera tabele lub listy z dowolnej strony.
- Ponad 60 000 gotowych przepisów: Gotowe scrapery do popularnych serwisów — wystarczy wyszukać i zastosować.
- Paginacja i sekwencje crawl: Obsługa przycisków „Next”, scrapowanie wielu stron albo wczytanie listy URL-i do automatycznego pobierania.
- Eksport do CSV, Excel lub Google Sheets: Pobieraj dane albo wysyłaj je bezpośrednio do ulubionego arkusza.
Data Miner jest uwielbiany przez handlowców, rekruterów i badaczy za prostotę i szybkość. Darmowy plan obejmuje 500 stron miesięcznie, a płatne plany startują od 19,99 USD miesięcznie, oferując więcej funkcji i wyższe limity.
8. Dexi.io
 Dexi.io (dawniej CloudScrape) to platforma chmurowa do budowania złożonych, zautomatyzowanych workflow scrapingu — bez kodowania.
- Wizualny kreator robotów: Twórz wieloetapowe procesy scrapingu z logiką warunkową, pętlami i transformacją danych.
- Uruchamianie w chmurze i harmonogram: Uruchamiaj roboty w chmurze, planuj cykliczne zadania i skaluj je dzięki wielu „workerom”.
- Integracje: Wysyłaj dane do chmury, baz danych lub API; łącz się z usługami zewnętrznymi.
- Funkcje enterprise: Korzysta z niego 1/3 sprzedawców z Fortune 500 do bieżącej analityki danych, monitoringu i raportowania.
Dexi.io najlepiej sprawdza się u zaawansowanych użytkowników i w firmach, które potrzebują ciągłego scrapingu na dużą skalę. Obecnie sprzedawany przez Mozenda: 14-dniowy darmowy trial, a potem Pilot za 500 USD miesięcznie.
9. Web Scraper
 Web Scraper to darmowe, open-source’owe rozszerzenie do przeglądarki (Chrome/Firefox), idealne dla początkujących i małych projektów.
- Scraping oparty na sitemapie: Definiujesz nawigację i reguły ekstrakcji, klikając elementy — świetne dla uporządkowanych serwisów.
- Paginacja i wielopoziomowy crawling: Pobieraj listy, podążaj za linkami i wyciągaj szczegóły z podstron.
- Eksport danych: Pobieraj wyniki jako CSV lub JSON.
- Usługa chmurowa opcjonalnie: Uruchamiaj większe zadania, planuj scrape’y i uzyskuj dostęp do danych przez API (płatne plany od około 50 USD miesięcznie).
Web Scraper jest idealny dla studentów, hobbystów i każdego, kto chce zacząć przygodę z web scrapingiem bez wydawania ani grosza.
10. ScraperAPI
 ScraperAPI działa inaczej: to usługa scrapingowa oparta na API, która automatycznie obsługuje proxy, CAPTCHA i headless browsery.
- No-code DataPipeline: Konfiguruj zadania scrapingowe, planuj uruchomienia i zarządzaj danymi z poziomu dashboardu — bez kodowania.
- Automatyczna obsługa proxy i anty-botów: Pobieraj dane nawet z najsilniej chronionych serwisów, na dużą skalę.
- Strukturalne endpointy danych: Otrzymuj przeanalizowany JSON dla popularnych serwisów (Amazon, Google, Walmart itd.).
- Ogromna skalowalność: Obsługa milionów requestów miesięcznie z szybkim, równoległym przetwarzaniem.
ScraperAPI to świetny wybór dla developerów, zespołów danych i każdego, kto potrzebuje niezawodnego scrapingu w dużym wolumenie. Ceny zaczynają się od 49 USD miesięcznie za 100 000 kredytów API, a wyższe plany są przeznaczone do większych projektów.
Tabela porównawcza no-code web scraperów
| Narzędzie | Najważniejsze funkcje | Najlepsze dla | Darmowy plan | Płatne plany (od) |
|---|---|---|---|---|
| Thunderbit | Scraping AI w 2 kliknięciach, podstrony, eksport do Sheets | Sprzedaż, operacje, osoby nietechniczne | Tak (6 stron/mies.) | 15 USD/mies. (kredyty) |
| Parsehub | Wizualny workflow, dynamiczne strony, harmonogram w chmurze | Analitycy, badacze, złożone projekty | Tak (200 stron) | 189 USD/mies. (Standard) |
| Octoparse | Drag-and-drop, 100+ szablonów, chmura, harmonogram | Marketerzy, MŚP, szybka automatyzacja | Tak (ograniczony) | 69 USD/mies. (Standard) |
| Apify | Chmura, 5000+ actorów, współpraca zespołowa, API | Zespoły danych, developerzy, skalowalność | Tak (kredyty) | 29 USD/mies. (kredyty) |
| Bright Data | Web Scraper API, gotowe szablony, zarządzana infrastruktura proxy | Zespoły potrzebujące niezawodnej skali bez budowania własnego stosu | Darmowy trial | W zależności od produktu i użycia |
| Import.io | Wizualny ekstraktor, zgodność, integracje BI | Enterprise, duże zespoły danych | Darmowy trial | Od 199 USD/mies. |
| Data Miner | Rozszerzenie do przeglądarki, 60 tys. przepisów, Google Sheets | Sprzedaż, rekruterzy, szybkie zadania | Tak (500 stron) | 19,99 USD/mies. (Solo) |
| Dexi.io | Wizualny kreator robotów, chmura, automatyzacja workflow | Enterprise, ciągły monitoring | Darmowy trial | 500 USD/mies. (przez Mozenda) |
| Web Scraper | Darmowe rozszerzenie, sitemap-based, eksport CSV | Początkujący, studenci, małe zadania | Tak (bez limitu) | 50 USD/mies. (chmura, opcjonalnie) |
| ScraperAPI | API, anty-bot, DataPipeline, endpointy JSON | Developerzy, zespoły danych, duży wolumen | Darmowy trial | 49 USD/mies. (100 tys. kredytów) |
Jak wybrać odpowiedni no-code web scraper do swoich potrzeb
Czym jest data scraping i jak robić to w 2025 roku Get Started Free
Oto moja ściągawka, która pomoże dopasować narzędzie do konkretnego scenariusza biznesowego:
- Dopiero zaczynasz i chcesz szybkich efektów? Wypróbuj Thunderbit z konfiguracją wspieraną przez AI albo Octoparse z szablonami i tutorialami.
- Musisz scrapować złożone, dynamiczne strony? Parsehub i Dexi.io dobrze radzą sobie z trudną nawigacją i wieloetapowymi workflow.
- Regularne projekty na dużą skalę? Wybierz Apify, Bright Data, ScraperAPI albo Import.io ze względu na uruchamianie w chmurze, zarządzaną infrastrukturę, harmonogramy i integracje.
- Szybkie, jednorazowe pobrania? Data Miner albo Web Scraper świetnie nadają się do wyciągania tabel i list bezpośrednio w przeglądarce.
- Potrzeby enterprise, zgodność i wsparcie? Bright Data, Import.io i Dexi.io oferują zarządzaną infrastrukturę, obsługę premium i rozbudowaną automatyzację.
Zawsze zaczynaj od darmowego triala lub planu — przetestuj swój przypadek użycia, sprawdź jakość danych i zobacz, który interfejs najbardziej Ci odpowiada. I pamiętaj: najlepsze narzędzie to takie, którego Twój zespół faktycznie będzie używać.
Podsumowanie: jak no-code web scrapers tworzą wartość biznesową
No-code web scrapery to coś więcej niż skrót — to supermoc dla każdego zespołu, który potrzebuje danych z internetu do podejmowania decyzji. Dzięki narzędziom takim jak Thunderbit, Octoparse, Apify i Bright Data możesz zautomatyzować nudne zadania, ograniczyć liczbę błędów i skupić się na tym, co naprawdę ważne: analizie, strategii i wzroście.
Korzyści są oczywiste: oszczędność czasu, wyższa produktywność i swoboda dostępu do potrzebnych danych dokładnie wtedy, gdy są potrzebne. Niezależnie od tego, czy budujesz listę leadów, monitorujesz konkurencję, czy zasilasz swój kolejny duży projekt, istnieje no-code web scraper dopasowany do Ciebie.
Gotowy, by pożegnać maraton kopiuj-wklej? Pobierz rozszerzenie Thunderbit do Chrome albo przetestuj kilka narzędzi z tej listy. A jeśli chcesz więcej wskazówek i pogłębionych analiz, zajrzyj na blog Thunderbit.
Zacznij automatyzować z Thunderbit
FAQ
1. Czym jest no-code web scraper?
No-code web scraper to narzędzie, które pozwala pobierać dane ze stron internetowych bez pisania kodu. Takie platformy korzystają z interfejsów wizualnych, AI lub szablonów, dzięki czemu każdy może zautomatyzować zbieranie danych — bez programowania.
2. Skąd mam wiedzieć, który no-code web scraper będzie dla mnie odpowiedni?
Weź pod uwagę swój poziom techniczny, stopień złożoności stron docelowych, ilość danych i potrzeby integracyjne. Zacznij od darmowego triala, aby sprawdzić, które narzędzie pasuje do Twojego workflow i dostarcza potrzebne dane.
3. Czy no-code web scrapery radzą sobie ze stronami dynamicznymi lub zabezpieczonymi logowaniem?
Wiele z nich tak! Narzędzia takie jak Thunderbit, Parsehub i Octoparse obsługują dynamiczne treści, logowanie i paginację. W przypadku mocno chronionych serwisów ScraperAPI oferuje zaawansowaną obsługę anty-botów.
4. Czy web scraping jest legalny?
Web scraping jest legalny, jeśli pobierasz publicznie dostępne dane i respektujesz regulamin strony. Zawsze unikaj pobierania danych osobowych lub wrażliwych i sprawdź politykę serwisu, zanim zaczniesz.
5. Jak mogę eksportować dane z no-code web scrapera?
Większość narzędzi pozwala eksportować dane do CSV, Excel, Google Sheets, Airtable, Notion albo przez API. Thunderbit i Data Miner oferują bezpośredni eksport do popularnych narzędzi arkuszowych, co ułatwia natychmiastowe wykorzystanie danych.
Gotowy, by zautomatyzować zbieranie danych z internetu? Wypróbuj no-code web scraper z tej listy i zobacz, ile czasu możesz zaoszczędzić. Miłego scrapowania!
Dowiedz się więcej
- Najlepsze 15 scraperów stron internetowych, które warto znać w 2025 roku
- Top 8 najlepszych AI web scraperów do inteligentniejszego pozyskiwania danych
Wypróbuj AI Web Scraper Get Started Free




