Zautomatyzowany ruch botów odpowiada już za ponad 53% całego ruchu w sieci — więcej niż generują ludzie. Jeśli zbierasz dane, zarządzasz kontami albo weryfikujesz reklamy w różnych regionach, działasz w środowisku, w którym systemy anty-botowe są stworzone właśnie po to, by cię wykryć.
A jednak większość poradników o „proxy statycznych vs rotacyjnych” sprowadza cały temat do dwukolumnowej tabelki i na tym kończy. Pomijają trzecią kategorię (sticky sessions), ignorują realne mechanizmy wykrywania i nigdy nie liczą kosztów przy większej skali. Poświęciłem sporo czasu na analizę dostawców proxy i API do AI scraping w ramach pracy nad Thunderbit, a rzeczywistość jest bardziej złożona — i ciekawsza — niż sugerują typowe rankingi. W tym poradniku omawiam prawdziwe trójstronne rozróżnienie, które większość artykułów myli, pokazuję, jak systemy anty-botowe faktycznie wykrywają ruch proxy, ile kosztuje przepuszczenie 50 tys. stron dziennie przez różne typy proxy oraz 9 narzędzi, które naprawdę rozważyłbym do użycia. Część to klasyczni dostawcy proxy, część to API scrapingowe, a jedno (nasze) całkowicie pomija zarządzanie proxy.
Wypróbuj Thunderbit do AI Scraping
Proxy statyczne, rotacyjne i sticky: trzy rozróżnienia, które większość poradników pomija
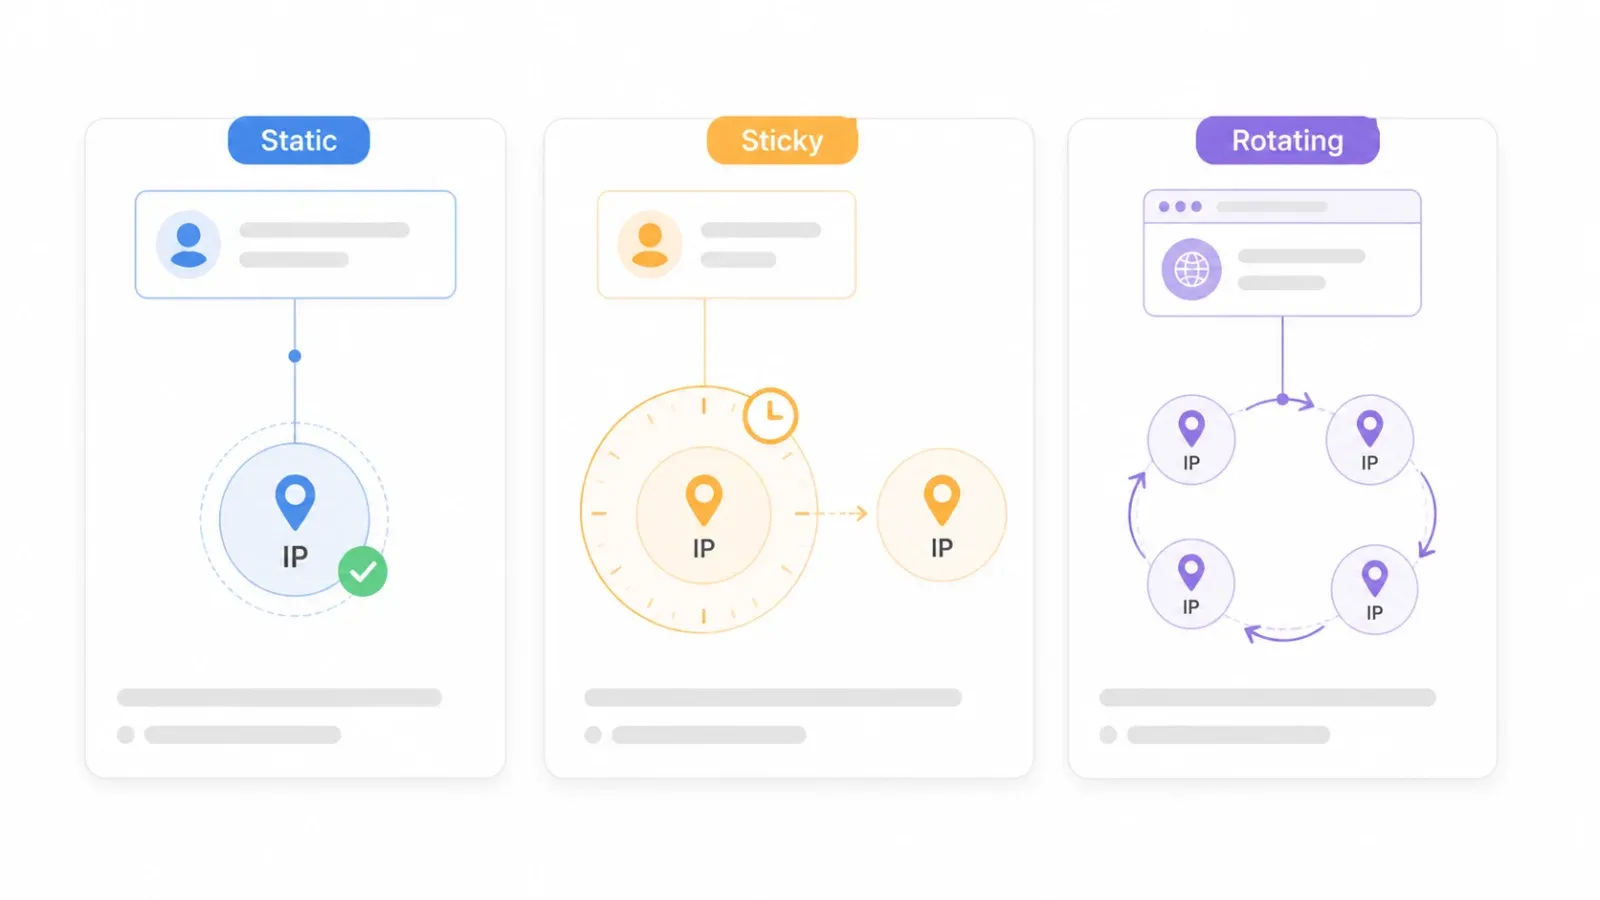
Większość artykułów porównujących proxy traktuje temat binarnie: statyczne albo rotacyjne. To uproszczenie jest niepełne i prowadzi do błędnych decyzji zakupowych. Istnieją trzy różne zachowania proxy i każde służy innemu zastosowaniu.
Proxy statyczne: ten sam adres IP bez zmian, dopóki nie wymienisz go ręcznie albo nie wygaśnie dzierżawa. Można je porównać do domowego internetu — ten sam adres każdego dnia. Przydatne tam, gdzie platforma oczekuje tej samej tożsamości w czasie (zarządzanie kontami, treści z blokadą geograficzną, monitoring pozycji).
Sticky session: ten sam adres IP przez konfigurowalny okres — może to być 10 minut, 30 minut, a czasem nawet 24 godziny, zależnie od dostawcy — a potem następuje zmiana na nowy. Sticky session daje tymczasową ciągłość; proxy statyczne daje ciągłość trwałą. Decodo (dawniej Smartproxy) opisuje sticky sessions jako utrzymanie jednego IP przez 1, 10, 30, 60 minut lub w niestandardowych odstępach do 24 godzin.
Proxy rotacyjne: nowy IP przy każdym żądaniu albo co kilka sekund. Maksimum anonimowości przy dużej skali pracy, ale brak ciągłości sesji — chyba że dołożysz warstwę sticky sessions.
Różnice w formie tabeli:
| Atrybut | Proxy statyczne | Sticky session | Proxy rotacyjne |
|---|---|---|---|
| Czy IP się zmienia? | Nigdy (to samo IP bezterminowo) | Po ustalonym czasie (np. 10–30 min) | Przy każdym żądaniu albo co kilka sekund |
| Utrzymanie sesji | Trwałe | Tymczasowe (konfigurowalny TTL) | Brak |
| Typowe zastosowanie | Zarządzanie kontami, treści z blokadą geograficzną | Scrapowanie wieloetapowe (logowanie → nawigacja → ekstrakcja) | Scrapowanie na dużą skalę, weryfikacja reklam |
| Ryzyko wykrycia | Rosnące z czasem (ten sam fingerprint zbiera historię) | Umiarkowane | Najniższe przy wykrywaniu po IP (jeśli residential) |
| Model kosztowy | Zwykle za IP/miesiąc | Część planów residential/mobile rozliczanych za GB | Za GB, za żądanie albo ryczałt |
Dlaczego to ma znaczenie przy wyborze narzędzia? Jeśli logujesz się do platformy, dodajesz produkty do koszyka albo wypełniasz wieloetapowy formularz, potrzebujesz sticky sessions — nie czystej rotacji (bo sesja się urwie) i niekoniecznie permanentnego statycznego IP (bo to przerost formy nad treścią i zwykle większy koszt). Użytkownicy na r/proxies regularnie mylą te kategorie, pytając, czy sticky sessions działają jak „zwykłe rotacyjne proxy residential” czy jak statyczne IP. Odpowiedź: ani jedno, ani drugie. To trzecia opcja.
Jak systemy anty-botowe naprawdę wykrywają proxy statyczne i rotacyjne
Każdy artykuł porównujący proxy wspomina o „ryzyku wykrycia” w komórce tabeli. Prawie żaden nie wyjaśnia, jak to wykrywanie działa. A to ważne, bo metoda detekcji decyduje o tym, czy zmiana IP w ogóle pomoże.
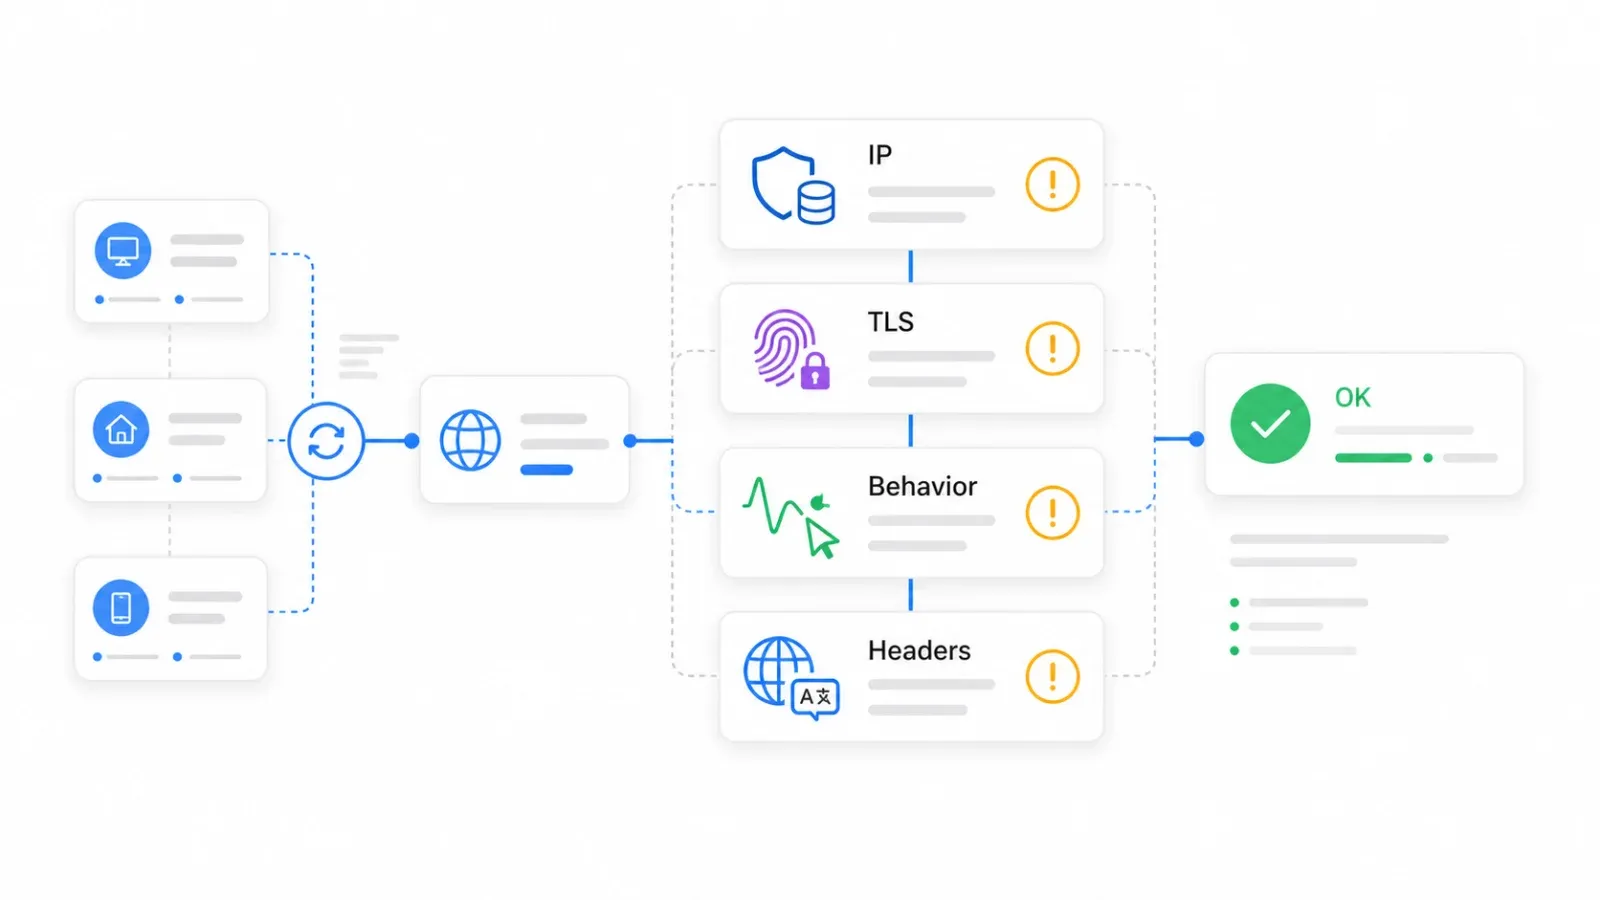
Nowoczesne systemy anty-botowe korzystają co najmniej z czterech warstw, a rotacja IP dotyczy tylko jednej z nich.
Warstwa 1: bazy reputacji IP
Adresy z sieci data center pochodzą z chmur i hostingowych ASN-ów — Amazon, Google, DigitalOcean itd. Dostawcy anty-botowi utrzymują bazy, które z wyprzedzeniem oznaczają takie zakresy jako podejrzane. IP residential i mobile zaczynają z wyższym poziomem zaufania, bo wyglądają jak zwykły ruch konsumencki. Dokumentacja Cloudflare dotycząca botów opisuje to za pomocą bot score w skali od 1 do 99, gdzie niskie wyniki oznaczają wysokie prawdopodobieństwo automatyzacji. Jeśli twoje IP pochodzi ze znanego zakresu data center, startujesz z niskim zaufaniem jeszcze zanim wyślesz pierwsze żądanie.
Warstwa 2: fingerprint TLS/JA3/JA4
To element, którego większość kupujących proxy w ogóle nie zna. Gdy klient inicjuje połączenie HTTPS, handshake TLS ujawnia cechy oprogramowania, które wysyła żądanie. Dokumentacja Cloudflare o JA3/JA4 wyjaśnia, że te fingerprinty identyfikują klientów TLS na podstawie cech połączenia i działają jak stabilne identyfikatory niezależnie od docelowego IP. Prościej: jeśli twoje żądanie twierdzi, że pochodzi z Chrome na macOS, ale handshake TLS wygląda jak biblioteka Python requests, zmiana IP tego nie naprawi. Fingerprint idzie za tobą.
Warstwa 3: sygnały behawioralne
Tempo wysyłania żądań, kolejność nawigacji, ruch myszy (albo jego brak), wzorce logowania i to, czy sesja rozwija się jak zachowanie człowieka. Dokumentacja DataDome dotycząca detekcji opisuje modele behawioralne, które wykrywają nienaturalne wzorce, takie jak zbyt wiele prób logowania albo nieludzko szybka nawigacja. Badanie arXiv z 2026 roku dotyczące agentów AI przeglądających sieć wykazało, że fingerprinty behawioralne lepiej odróżniały agentów AI od ludzi niż fingerprinty przeglądarki.
Warstwa 4: spójność nagłówków i środowiska
Badanie pomiarowe z 2026 roku obejmujące 10 tys. witryn wykazało, że 75% blokad opartych wyłącznie na Chromium-headless wynikało jedynie z sygnałów na poziomie nagłówków. Jeśli nagłówek Accept-Language ma wartość en-US, a twoje IP geolokalizuje się w São Paulo, to taka niespójność jest sygnałem. Jeśli user agent nie pasuje do fingerprintu TLS, to kolejny sygnał.
Wniosek: rotacja IP zmniejsza limity oparte na adresach i akumulację złej reputacji IP. Nie rozwiązuje jednak niezgodności fingerprintów TLS, anomalii behawioralnych ani niespójności nagłówków. Właśnie dlatego narzędzia do scraping API-first — które obsługują renderowanie, spójność fingerprintów i rozwiązywanie CAPTCHA na poziomie infrastruktury — stały się praktyczną alternatywą dla samodzielnego zarządzania wszystkimi czterema warstwami.
Pomiń zarządzanie proxy dzięki AI scraping Get Started Free
Realny koszt proxy statycznych i rotacyjnych przy większej skali
Cennik to część, którą większość poradników o proxy pomija albo zbywa ogólnikami typu „przystępne ceny”. Ale model rozliczeń + ciężar strony + wskaźnik blokad potrafią drastycznie zmienić całkowity koszt.
Web Almanac 2025 HTTP Archive podaje, że mediana strony głównej waży 2,86 MB na desktopie. Jeśli renderujesz pełne strony przez rozliczane proxy residential przy 50 000 stron dziennie, to daje około 143 GB dziennie, czyli mniej więcej 4,29 TB miesięcznie. Przy stawce $5–$15/GB za rotacyjne proxy residential mówimy o $21 450–$64 350 miesięcznie zanim doliczysz ponowienia i zablokowane żądania.
To liczba, która za pierwszym razem szokuje większość osób.
Dlatego doświadczeni scraperzy blokują obrazy, fonty, wideo i zbędne skrypty w przeglądarkach headless — to praktyczna optymalizacja, która może obniżyć transfer o 60–80%. Nawet po takim cięciu nadal mówimy o 858 GB–1,72 TB miesięcznie, czyli przy stawkach residential o $4 290–$25 740 miesięcznie.
Bezpośrednie zapytania HTTP albo scraping na poziomie API są dużo lżejsze. Szacunek praktyków mówi o 50–200 KB na stronę przy zwykłym HTTP wobec 1,5–8 MB przy pełnym renderowaniu headless. Przy 200 KB/stronę, 50 tys. stron dziennie to tylko około 300 GB miesięcznie.
| Typ proxy | Model rozliczeń | Typowy zakres cen | Szacowany koszt dla 50 tys. stron/dzień (pełny render) | Uwagi |
|---|---|---|---|---|
| Data center (statyczne) | Za IP/miesiąc | ~0,50–2 USD/IP | Niski (ryczałt, bez liczenia GB) | Duże ryzyko blokad na chronionych celach |
| ISP / statyczne residential | Za IP lub za GB | ~3–8 USD/GB | Średnio-wysoki | Najlepsze dla ciągłości i trudniejszych celów |
| Rotacyjne residential | Za GB | ~5–15 USD/GB | Bardzo wysoki, chyba że mocno zoptymalizujesz transfer | Złoty standard anonimowości; koszty gwałtownie rosną przy skali |
| Rotacyjne data center | Za żądanie lub za GB | ~0,50–3 USD/GB | Niski-średni | Dobre dla mniej chronionych targetów |
| AI scraping API (np. Thunderbit) | Za żądanie / kredyty | Zależnie od planu | Przewidywalny (bez licznika transferu) | Zwraca dane strukturalne, nie surowy HTML |
Właśnie dlatego użytkownicy na forach pytają o ręczne rotowanie statycznych proxy ISP jako tańszą alternatywę dla rozliczanego transferu residential. Kompromis między anonimowością a kosztem jest realny, a właściwa odpowiedź zależy od poziomu zabezpieczeń celu i skali pracy.
Wybierz typ proxy w mniej niż 60 sekund
Zero z sześciu najwyżej pozycjonowanych artykułów konkurencji zawiera prosty flowchart decyzyjny. Oto logika w formie drzewa:
-
Czy potrzebujesz tego samego IP przez długie sesje? → Tak → Proxy statyczne (ISP/statyczne residential dla trudnych celów, data center dla prostszych)
-
Nie → Czy scrapujesz 10 tys.+ stron? → Tak → Proxy rotacyjne (residential dla trudnych celów, data center dla mniej wymagających)
-
Czy potrzebujesz utrzymania sesji przy zadaniach wieloetapowych (logowanie, koszyk, formularze)? → Tak → Sticky session (residential, z konfigurowalnym TTL)
-
Czy chcesz całkowicie pominąć zarządzanie proxy? → Tak → AI scraping API (np. Thunderbit API/MCP)
To samo w formie tabeli scenariuszy:
| Twój scenariusz | Najlepsze podejście |
|---|---|
| Potrzebujesz dostępu do surowego IP (zarządzanie kontami, testy geo) | Samodzielnie zarządzane proxy statyczne lub rotacyjne |
| Scraping danych strukturalnych z serwisów ciężkich w JS | AI scraping API (np. Thunderbit /extract) |
| Crawlowanie dużej liczby stron do RAG / indeksowania | AI distill API (np. Thunderbit /distill) + batch |
| Scrapowanie wieloetapowe z logowaniem | Proxy do przeglądarki ze sticky sessions |
| Niski budżet, mniej chronione serwisy | Proxy data center (najtańsze) |
Większość czytelników wpada do jednej z tych pięciu grup. Ustal, do której należysz, zanim przejdziesz do listy narzędzi.
Według jakich kryteriów ocenialiśmy te 9 narzędzi
Każde narzędzie z tej listy oceniłem według siedmiu kryteriów:
- Dostępne typy proxy: czy obejmuje statyczne, rotacyjne, ISP, residential, mobile — czy też całkowicie ukrywa warstwę proxy?
- Wielkość puli IP: większa pula zwykle oznacza lepszą jakość rotacji i mniejsze ryzyko ponownego użycia. Ale deklaracje o wielkości puli to marketing, nie niezależnie audytowane dane.
- Model cenowy: za IP, za GB, za żądanie, ryczałt albo kredyty. Model rozliczeń ma tak samo duże znaczenie jak cena jednostkowa.
- Obsługa anty-bot / detekcji: wbudowane rozwiązywanie CAPTCHA, zarządzanie fingerprintami albo nic poza różnorodnością IP.
- Obsługa sticky sessions: konfigurowalny TTL, maksymalny czas trwania, niezawodność.
- Najlepsze dopasowanie do zastosowania: scraping, zarządzanie kontami, SEO, weryfikacja reklam — każde narzędzie ma własną specjalizację.
- Łatwość integracji: jakość API, dostępność SDK, wygoda panelu, opcje no-code, wsparcie MCP/CLI.
Lista zaczyna się od Thunderbit (naszego podejścia opartego na AI scraping API), a następnie obejmuje dziewięciu dostawców proxy w mniej więcej malejącej kolejności pod względem skali i głębokości funkcji.
1. Thunderbit: pomiń zarządzanie proxy dzięki AI scraping API
Thunderbit nie jest dostawcą proxy. To opcja dla tych, którzy rozumieją, że proxy są środkiem do celu — a tym celem są dane strukturalne.
Zbudowaliśmy Thunderbit jako AI scraping API, które obsługuje proxy, mechanizmy anty-botowe, CAPTCHA i renderowanie JavaScript na poziomie infrastruktury. Opisujesz, jakich danych potrzebujesz, a dostajesz czysty, uporządkowany wynik. Bez konfiguracji puli proxy, bez logiki rotacji, bez spoofingu fingerprintów.
Dla developerów (główny przypadek użycia):
- Otwarte API:
POST /distillzamienia stronę w czysty Markdown.POST /extractprzyjmuje schemat JSON i zwraca pola strukturalne. Oba wspierają opcjerenderModei zadania batchowe (do 100 URL-i asynchronicznie z webhookami). - Serwer MCP: Claude, Cursor i inne agenty AI mogą wywoływać
thunderbit_extractithunderbit_distillw trakcie pracy. Warstwa proxy jest niewidoczna — agent po prostu dostaje dane. - CLI:
npx @thunderbit/thunderbit-cli extract <url> --schema <json>do terminala, CI i workflowów cron. Batch obsługuje do 100 URL-i dla distill / 50 dla extract. - Cennik kredytowy: Distill = 1 kredyt/URL. Extract = 20 kredytów/URL. Bez liczenia transferu za GB. Plan Starter zaczyna się od $15/miesiąc i obejmuje 500 kredytów.
Dla użytkowników nietechnicznych rozszerzenie Chrome oferuje scrapowanie w 2 kliknięciach z AI Suggest Fields, eksport do Excel, Google Sheets, Airtable lub Notion. Bez konfiguracji proxy — cloud scraping w Thunderbit sam obsługuje rotację IP i renderowanie.
Najlepsze do: ekstrakcji danych strukturalnych z serwisów ciężkich w JS, pipeline’ów RAG / indeksowania, workflowów agentów AI i wszystkich, którzy wolą poświęcić czas analizie, a nie infrastrukturze proxy.
Ograniczenia: nie jest to surowy dostawca proxy. Jeśli potrzebujesz bezpośredniego dostępu do IP do zarządzania kontami, testów geolokalizacji lub botów sneakerowych, lepsze będzie tradycyjne proxy.
Cena: dostępny plan darmowy; Starter od około $15/miesiąc. Aktualne plany znajdziesz na Thunderbit Pricing.
Więcej o tym, jak działa AI web scraping pod maską, znajdziesz w naszym poradniku o AI web scraping.
2. Bright Data: największa pula IP dla proxy statycznych i rotacyjnych

Bright Data to jeden z najstarszych i najbardziej rozbudowanych pakietów proxy na rynku. Ich główny atut to ponad 400 mln rotacyjnych IP residential w 195 krajach, z targetowaniem na poziomie miasta/regionu/kodu ZIP/ASN, plus ponad 1,3 mln statycznych proxy ISP.
- Typy proxy: residential (rotacyjne), ISP/statyczne residential, data center (statyczne i rotacyjne), mobile
- Pula IP: 400M+ residential, 1.3M+ ISP — największa publicznie deklarowana pula
- Obsługa anty-bot: produkt Web Unlocker z CAPTCHA solving i zarządzaniem fingerprintami; Browser API do renderowania headless
- Sticky sessions: tak, konfigurowalne (zwykle 10–30 min dla residential)
Cena: residential w modelu PAYG od $8/GB, z promocyjnymi stawkami około $4/GB przy większych zobowiązaniach. Data center od około $0,90/IP. ISP od około $1,30/IP. Model cenowy jest elastyczny, ale przy skali szybko robi się drogo.
Najlepsze do: przedsiębiorstw potrzebujących ogromnej różnorodności IP, precyzyjnego targetowania geograficznego i pełnego zestawu produktów. Dla zespołów z budżetem i zapleczem technicznym do obsługi złożonego panelu.
Minusy: panel ma stromą krzywą nauki. Przy mniejszych zespołach ceny mogą być wysokie — jeśli scrapujesz 50 tys. stron dziennie przez proxy residential, rachunek za transfer szybko rośnie. Użytkownicy na portalach opinii często narzekają na złożoność cennika.
3. Oxylabs: premium proxy rotacyjne i statyczne do scrapowania na dużą skalę
Oxylabs to kolejny dostawca klasy enterprise, mocno nastawiony na infrastrukturę do web scrapingu. Oferują residential, statyczne residential/ISP, data center, mobile, Web Unblocker oraz produkty Scraper API.
- Typy proxy: residential (rotacyjne), ISP/statyczne residential, data center (statyczne i rotacyjne), mobile
- Pula IP: duża pula enterprise (dokładna liczba zależy od produktu i zmienia się w czasie)
- Obsługa anty-bot: Web Unblocker i Scraper API z renderowaniem oraz wsparciem CAPTCHA
- Sticky sessions: standardowy czas sesji residential to 10 minut, dostępne są też inne konfiguracje; niektóre ustawienia obsługują nawet do 24 godzin
Cena: Residential od $6/GB na wejściu, spadając do $3,50/GB przy wolumenie 1 TB. Proxy ISP wyceniane za IP/miesiąc. Pozycjonowane jako rozwiązanie premium.
Najlepsze do: dużych przedsiębiorstw z istotnymi potrzebami zbierania danych oraz zespołów, które chcą mieć zarządzane rozwiązania scrapingowe obok surowego dostępu do proxy.
Minusy: wyższa cena niż u alternatyw ze średniego segmentu. Może być zbyt rozbudowane dla małych i średnich projektów.
4. Smartproxy (Decodo): budżetowe proxy rotacyjne z łatwą konfiguracją
Smartproxy, obecnie działający pod marką Decodo, to popularny dostawca z segmentu mid-market, znany z konkurencyjnych cen i przyjaznego panelu. Wielu użytkowników nadal szuka hasła „Smartproxy”, więc obie nazwy funkcjonują w obiegu.
- Typy proxy: residential (rotacyjne), ISP/statyczne residential, data center, mobile
- Pula IP: ponad 115 mln IP residential
- Obsługa anty-bot: dostępny Site Unblocker oraz produkty scraping API
- Sticky sessions: 1, 10, 30, 60 minut lub niestandardowe interwały do 24 godzin dla residential, data center, ISP i mobile
Cena: Residential od $2/GB w progu 3 GB, zniżki przy większym wolumenie. Statyczne residential/ISP od około $3,33/IP w najniższym progu. Konkurencyjne jak na ten zestaw funkcji.
Najlepsze do: małych i średnich zespołów szukających dobrego balansu ceny i funkcji, a także osób kupujących proxy po raz pierwszy i oczekujących prostego wdrożenia.
Minusy: mniejsza pula IP niż u Bright Data czy Oxylabs. Część użytkowników zgłasza niestabilne prędkości zależnie od celu i puli.
5. IPRoyal: niedrogie proxy statyczne i rotacyjne z elastycznym cennikiem
IPRoyal wypracował swoją niszę jako budżetowa opcja z unikalną propozycją wartości: niewygasający transfer residential. Kupujesz pasmo i wykorzystujesz je, kiedy chcesz.
- Typy proxy: residential (rotacyjne), ISP/statyczne residential, data center, mobile, sneaker proxy
- Pula IP: rosnąca; dokładny obecny rozmiar zależy od źródła
- Obsługa anty-bot: podstawowa — opiera się głównie na jakości IP, bez wbudowanego CAPTCHA solving czy fingerprint management
- Sticky sessions: do 7 dni dla residential
Cena: Residential od $7/GB, zniżka do $1,75/GB przy zakupie hurtowym. Model niewygasającego transferu oznacza, że niewykorzystane pasmo nie przepada na koniec miesiąca.
Najlepsze do: użytkowników z ograniczonym budżetem, zmiennego lub sezonowego wykorzystania oraz zastosowań w sneaker/e-commerce.
Minusy: mniejsza pula IP niż u dostawców premium. Ograniczone wbudowane funkcje anty-detekcji. Mniej odpowiednie do mocno chronionych targetów.
6. SOAX: proxy rotacyjne z precyzyjnym targetowaniem geograficznym
SOAX najmocniej błyszczy tam, gdzie potrzebujesz bardzo lokalnego targetowania. Ich filtracja schodzi do poziomu kraju, regionu, miasta, ISP i ASN — to przydatne przy weryfikacji reklam i badaniach rynkowych, gdzie liczy się dokładność lokalizacji.
- Typy proxy: residential (rotacyjne), ISP/statyczne, data center, mobile
- Pula IP: ponad 155 mln IP w 195+ lokalizacjach
- Obsługa anty-bot: czyste pule IP z niskim wskaźnikiem banów; dostępne Web Data API
- Sticky sessions: tak, z możliwością ustawienia częstotliwości odświeżania; wsparcie protokołów HTTP(S), SOCKS5, UDP i QUIC
Cena: Plan Business za $4,00/GB z 800 GB w pakiecie ($3 200/miesiąc). Stawki enterprise zaczynają się od $0,32/GB przy dużych, indywidualnych kontraktach.
Najlepsze do: zespołów badania rynku potrzebujących danych mocno lokalnych oraz weryfikacji reklam w konkretnych geografii i u konkretnych ISP.
Minusy: może wydawać się złożone przy prostych zastosowaniach. Maksymalny czas sticky session zależy od produktu — warto to potwierdzić przed zakupem.
7. ScraperAPI: rotacyjne proxy w formie API do scrapingu
ScraperAPI nie jest klasycznym dostawcą proxy. Podobnie jak Thunderbit, abstrahuje warstwę proxy — ale zwraca surowy HTML zamiast danych strukturalnych. Wysyłasz URL i dostajesz wyrenderowany HTML. ScraperAPI sam zajmuje się wyborem proxy, rotacją, ponowieniami i anty-botami w tle.
- Jak to działa: jeden endpoint API; doklejasz docelowy URL, a ScraperAPI zajmuje się resztą
- Obsługa anty-bot: wbudowane CAPTCHA solving, renderowanie JS i targetowanie geograficzne
- Sticky sessions: w klasycznym sensie nie dotyczy — API zarządza sesjami wewnętrznie
Cena: 1 000 darmowych kredytów API/miesiąc. Standardowa strona = 1 kredyt. Amazon = 5 kredytów. Google/Bing = 25 kredytów. LinkedIn = 30 kredytów. Serwisy chronione przez Cloudflare/DataDome/PerimeterX doliczają 10 kredytów za żądanie. Płatne plany od około $49/miesiąc za 100 tys. kredytów.
Najlepsze do: developerów, którzy chcą pominąć infrastrukturę proxy i po prostu dostać HTML. Małe i średnie projekty scrapingowe.
Minusy: zwraca surowy HTML — nadal musisz go samodzielnie parsować i strukturyzować. Przy bardzo dużej skali może być drogie ze względu na mnożniki kredytów dla chronionych stron. Porównując z Thunderbit: ScraperAPI daje HTML; Thunderbit /extract zwraca dopasowany do schematu JSON.
8. Webshare: proste data center i rotacyjne proxy w niskiej cenie
Webshare to opcja bez fajerwerków. Bardzo tanie proxy data center, darmowy plan z 10 proxy i proste narzędzia dla developerów. (Webshare został przejęty przez Oxylabs w 2024 roku, co może wpłynąć na przyszły kierunek produktu.)
- Typy proxy: data center (statyczne i rotacyjne), residential (rotacyjne), ISP
- Pula IP: deklarowane ponad 80 mln residential, duża flota data center
- Obsługa anty-bot: minimalna — brak wbudowanego CAPTCHA solving; opiera się na różnorodności IP
- Sticky sessions: tak, dla proxy residential
Cena: Rotacyjne residential od $1,40/GB. Statyczne residential od $0,23/IP. Darmowy plan obejmuje 10 proxy. To jedne z najtańszych dostępnych opcji.
Najlepsze do: developerów z ograniczonym budżetem, narzędzi wewnętrznych, scrapowania mniej chronionych serwisów, prototypowania.
Minusy: IP data center są często blokowane przez duże serwisy. Ograniczona anty-detekcja. Jakość puli residential bywa zmienna.
9. Storm Proxies: proste proxy rotacyjne z cennikiem ryczałtowym
Storm Proxies to jeden z niewielu dostawców oferujących ryczałtowe plany proxy rotacyjnych z nielimitowanym transferem. Model cenowy jest prosty: płacisz za port proxy miesięcznie i korzystasz z dowolnego transferu.
- Typy proxy: rotacyjne residential, rotacyjne data center, dedykowane statyczne data center
- Pula IP: oficjalna strona deklaruje ponad 20 mln reverse backconnect residential proxy; niezależne recenzje sugerują, że realna pula jest mniejsza
- Obsługa anty-bot: minimalna — brak wbudowanego CAPTCHA i fingerprint management
- Sticky sessions: rotacja przy każdym żądaniu albo co 3 lub 15 minut
Cena: ryczałt miesięczny zależny od liczby portów proxy. Źródła zewnętrzne opisują np. 5 portów residential za około $50/miesiąc z nielimitowanym transferem. Przed zakupem sprawdź aktualną ofertę na stronie checkout.
Najlepsze do: osób, które chcą przewidywalnych miesięcznych kosztów bez licznika GB. Lekkie i średnie scrape’y, gdzie ważniejsza jest przewidywalność kosztu niż wielkość puli.
Minusy: bardzo mała efektywna pula IP (duże ryzyko ponownego użycia). Ograniczone targetowanie geo. Przestarzały panel. Nie nadaje się do mocno chronionych serwisów.
Proxy statyczne vs rotacyjne: porównanie narzędzi obok siebie
| Narzędzie | Typ proxy / API | Szacunkowy rozmiar puli | Model cenowy | Obsługa anty-bot | Wsparcie sticky session | Najlepsze zastosowanie |
|---|---|---|---|---|---|---|
| Thunderbit | AI scraping API, MCP, CLI, Chrome Extension | Batch do 100 URL-i | Kredyty (Distill 1/URL, Extract 20/URL) | Pełna: renderowanie, anty-bot, CAPTCHA | Nie dotyczy (zarządzane) | Ekstrakcja danych strukturalnych, RAG, agenci AI |
| Bright Data | Residential, ISP, data center, mobile | 400M+ residential, 1.3M+ ISP | Za GB + za IP + za żądanie | Web Unlocker, Browser API | Tak (10–30 min) | Skala enterprise, targetowanie geo |
| Oxylabs | Residential, ISP, data center, mobile | Duża pula enterprise | Residential $6→$3.50/GB | Web Unblocker, Scraper APIs | Tak (standardowo 10 min, konfigurowalne) | Scraping enterprise, rozwiązania zarządzane |
| Smartproxy/Decodo | Residential, ISP, data center, mobile | 115M+ residential | Residential ok. $3.75/GB; ISP ok. $3.33/IP | Site Unblocker | Tak (1–60 min, do 24h) | Mid-market, pierwszy zakup |
| IPRoyal | Residential, ISP, data center, mobile, sneaker | Rosnąca pula | Residential $7→$1.75/GB, niewygasający transfer | Podstawowa (jakość IP) | Tak (do 7 dni) | Budżetowi użytkownicy, sezonowe użycie |
| SOAX | Residential, ISP, data center, mobile | 155M+, 195+ lokalizacji | Business $4/GB; enterprise $0.32/GB | Czyste pule, Web Data API | Tak (niestandardowe odświeżanie) | Precyzyjne targetowanie lokalne, badania rynku |
| ScraperAPI | API do scrapingu z rotacją proxy | Na poziomie usługi (nie surowa pula) | Za kredyt; standard 1, Amazon 5, Google 25 | Wbudowane CAPTCHA, renderowanie, geo | Zarządzane wewnętrznie | Developerzy chcący dostać z powrotem HTML |
| Webshare | Data center, residential, ISP | 80M+ residential | Rotacyjne res $1.40/GB; statyczne $0.23/IP | Minimalna | Tak (residential) | Budżetowi devowie, prototypowanie |
| Storm Proxies | Rotacyjne residential/data center, statyczne DC | Deklarowane 20M+ | Ryczałt miesięczny za port, bez limitu BW | Minimalna | Przy każdym żądaniu / co 3 / 15 min | Przewidywalny koszt, lekki scraping |
NetNut został usunięty z tego porównania: na sierpień 2026 netnut.io wyświetla komunikat o zajęciu domeny przez władze federalne USA zamiast strony produktu.
Narzędzia grupują się w trzy kategorie. Surowa infrastruktura proxy (Bright Data, Oxylabs, Smartproxy, IPRoyal, SOAX, Webshare, Storm Proxies) daje ci dostęp do IP, a całą resztę zarządzasz samodzielnie. API scrapingowe (ScraperAPI) abstrahują warstwę proxy, ale nadal zwracają surowy HTML. API do ekstrakcji AI (Thunderbit) abstrahują zarówno warstwę proxy, jak i parsowanie, zwracając bezpośrednio dane strukturalne.
Kiedy proxy nie są odpowiedzią: AI scraping API kontra samodzielnie zarządzane proxy
To część, której nie obejmuje żaden konkurencyjny artykuł: większość osób czytających o „proxy statycznych vs rotacyjnych” nie jest entuzjastami proxy. Chcą pobierać dane, a proxy to tylko środek do celu.
W wielu przypadkach zarządzanie pulami proxy, logiką rotacji, spoofingiem fingerprintów i rozwiązywaniem CAPTCHA jest narzutem, który narzędzie API-first po prostu eliminuje. Ale nie zawsze. Oto kiedy które podejście ma sens:
Samodzielnie zarządzane proxy mają sens, gdy potrzebujesz surowego dostępu do IP do zarządzania kontami, testów geograficznych lub botów sneakerowych; pełnej kontroli nad ASN, operatorem lub zachowaniem exit IP; albo własnego stosu przeglądarka/proxy, który twój zespół już utrzymuje.
Ekstrakcja API-first ma sens, gdy potrzebujesz danych strukturalnych (list produktów, danych kontaktowych, cen), a nie surowego HTML; czystego Markdown dla pipeline’ów RAG; workflowów agentów AI, w których dostęp do stron w trakcie zadania ma być niewidoczny; albo po prostu chcesz mniej czasu spędzać na infrastrukturze proxy, a więcej na danych.
API Thunderbit obsługuje renderowanie, anty-bot i CAPTCHA po stronie serwera. Developerzy dostają czysty Markdown (/distill) albo JSON dopasowany do schematu (/extract) bez konfiguracji pul proxy czy spójności fingerprintów. Serwer MCP pozwala Claude lub Cursor scrapować w trakcie zadania przez thunderbit_extract — warstwa proxy jest naprawdę niewidoczna.
Szersze omówienie tematu web scraping bez kodowania znajdziesz w osobnym materiale.
Które narzędzie do proxy statycznych lub rotacyjnych będzie dla ciebie najlepsze?
Rekomendacje według scenariusza, bo „to zależy” jest trafne, ale mało pomocne:
- Najlepsze dla enterprise potrzebującego ogromnych pul IP: Bright Data, Oxylabs
- Najlepsze dla zespołów pilnujących budżetu: IPRoyal, Webshare, Storm Proxies
- Najlepsze do łatwego wdrożenia w segmencie mid-market: Smartproxy/Decodo, SOAX
- Najlepsze do całkowitego pominięcia zarządzania proxy: Thunderbit (dane strukturalne), ScraperAPI (surowy HTML)
- Najlepsze do workflowów agentów AI i MCP: Thunderbit
Systemy anty-botowe stają się coraz sprytniejsze — łączą reputację IP, fingerprinting TLS, analizę behawioralną i spójność nagłówków — a koszt samodzielnego zarządzania proxy rośnie wraz z nimi. Dla zespołów, których celem końcowym są czyste, uporządkowane dane z sieci, narzędzia API-first, które abstrahują całą warstwę proxy, są coraz częściej wyborem po prostu najbardziej praktycznym.
Ta zmiana nie jest hipotetyczna. Ona już się dzieje.
Jeśli chcesz zobaczyć, jak wygląda to w praktyce, rozszerzenie Thunderbit do Chrome to dobry punkt startowy dla użytkowników nietechnicznych, a dokumentacja API opisuje workflow dla developerów. Dla szerszego kontekstu o rynku narzędzi scrapingowych sprawdź nasze porównanie najlepszych AI web scraperów. Możesz też obejrzeć instruktaże na kanale Thunderbit na YouTube.
Wypróbuj Thunderbit AI Web Scraper Get Started Free
FAQ
1. Kiedy powinienem używać proxy statycznych zamiast rotacyjnych?
Używaj proxy statycznych, gdy potrzebujesz tego samego IP przez wiele sesji — zarządzanie kontem, dostęp do treści z blokadą regionalną, monitoring pozycji albo każda platforma, która uznaje zmianę IP za podejrzaną. Jeśli cel oczekuje tej samej tożsamości w czasie, statyczne proxy są właściwym wyborem. W przypadku trudniejszych targetów bezpieczniejsze od data center są proxy ISP/statyczne residential.
2. Jaka jest różnica między sticky session a proxy statycznym?
Sticky session utrzymuje ten sam IP przez określony czas (np. 10 minut, 30 minut, do 24 godzin zależnie od dostawcy), a potem przechodzi na nowe. Proxy statyczne zachowuje ten sam IP bezterminowo, dopóki nie wymienisz go ręcznie. To nie są te same rzeczy, mimo że część dokumentacji dostawców używa tych terminów zamiennie.
3. Dlaczego proxy rotacyjne nadal bywają blokowane na niektórych stronach?
Bo nowoczesne systemy anty-botowe wykrywają automatyzację wielowarstwowo, nie tylko po adresie IP. Fingerprinting TLS/JA3, analiza behawioralna (wzorce żądań, ścieżki nawigacji) oraz kontrola spójności nagłówków mogą oznaczyć ruch automatyczny niezależnie od rotacji IP. Rotacja IP ogranicza blokady oparte na IP, ale nie usuwa tych innych warstw detekcji.
4. Ile kosztują na dużą skalę rotacyjne proxy residential?
Publiczne ceny self-serve zaczynają się od około $1,40/GB (Webshare) do $8/GB w standardowym PAYG (Bright Data), a dla większych wolumenów dostępne są rabaty enterprise. Przy pełnym renderowaniu stron (50 tys. stron dziennie po ~2,86 MB/stronę) sam transfer może przekroczyć 4 TB miesięcznie — czyli kosztować potencjalnie dziesiątki tysięcy dolarów. API oparte na kredytach lub opłacie za żądanie (np. Thunderbit lub ScraperAPI) oferują bardziej przewidywalne ceny bez rozliczania transferu.
5. Czy AI scraping API może całkowicie zastąpić proxy?
W przypadku ekstrakcji danych strukturalnych i web scrapingu — często tak. Narzędzia takie jak Thunderbit obsługują rotację proxy, mechanizmy anty-botowe, CAPTCHA i renderowanie JS na poziomie infrastruktury, więc dostajesz czyste dane bez zarządzania infrastrukturą proxy. W zastosowaniach wymagających surowego dostępu do IP (zarządzanie kontami, testy geo, boty sneakerowe) tradycyjne proxy nadal są potrzebne.
Dowiedz się więcej



